Имя модели в коде устаревает в день выхода следующей модели. Если у вас десять сервисов, вы перепишете его десять раз и десять раз разнесёте по конфигам ключи вендоров.
Keystone. The Model Switchboard. (KTMS) убирает это из кода. Сервис говорит, насколько сложна задача, а шлюз решает, какую модель позвать, с каким ключом и не отдать ли запрос вашей собственной GPU. В простое он занимает 7 МиБ памяти, а с версии 1.0 его API в пределах 1.x не ломается.
Вместе со шлюзом 1.0 вышли веб‑консоль ktms‑admin и учёт расходов light‑tokenmeter, все три на Go и под Apache 2.0. Возможности ниже описаны по актуальной версии 1.3.
Что такое Keystone за минуту
Keystone — self‑hosted шлюз между вашими сервисами и LLM‑вендорами. Сервисы обращаются к одной точке, а KTMS:
хранит ключи вендоров в Postgres, зашифрованные AES-256-GCM, и не показывает их клиентам;
выбирает модель по правилам, а не по имени в коде;
переключается на следующую модель, если вендор лежит или ограничивает запросы;
ограничивает запросы, токены и деньги на ключ, пользователя и команду;
отправляет событие о каждом вызове в сервис учёта.
 ваши сервисы ──gRPC / HTTP /v1──▶ Keystone ──▶ OpenAI / Anthropic / Gemini / DeepSeek / Bedrock / ...
                                     │   │  └──▶ ваши GPU-ноды (Ollama, vLLM, TGI, llama.cpp)
                            Postgres ┘   └ Redis (лимиты, кэш)       └──▶ light-tokenmeter (учёт)
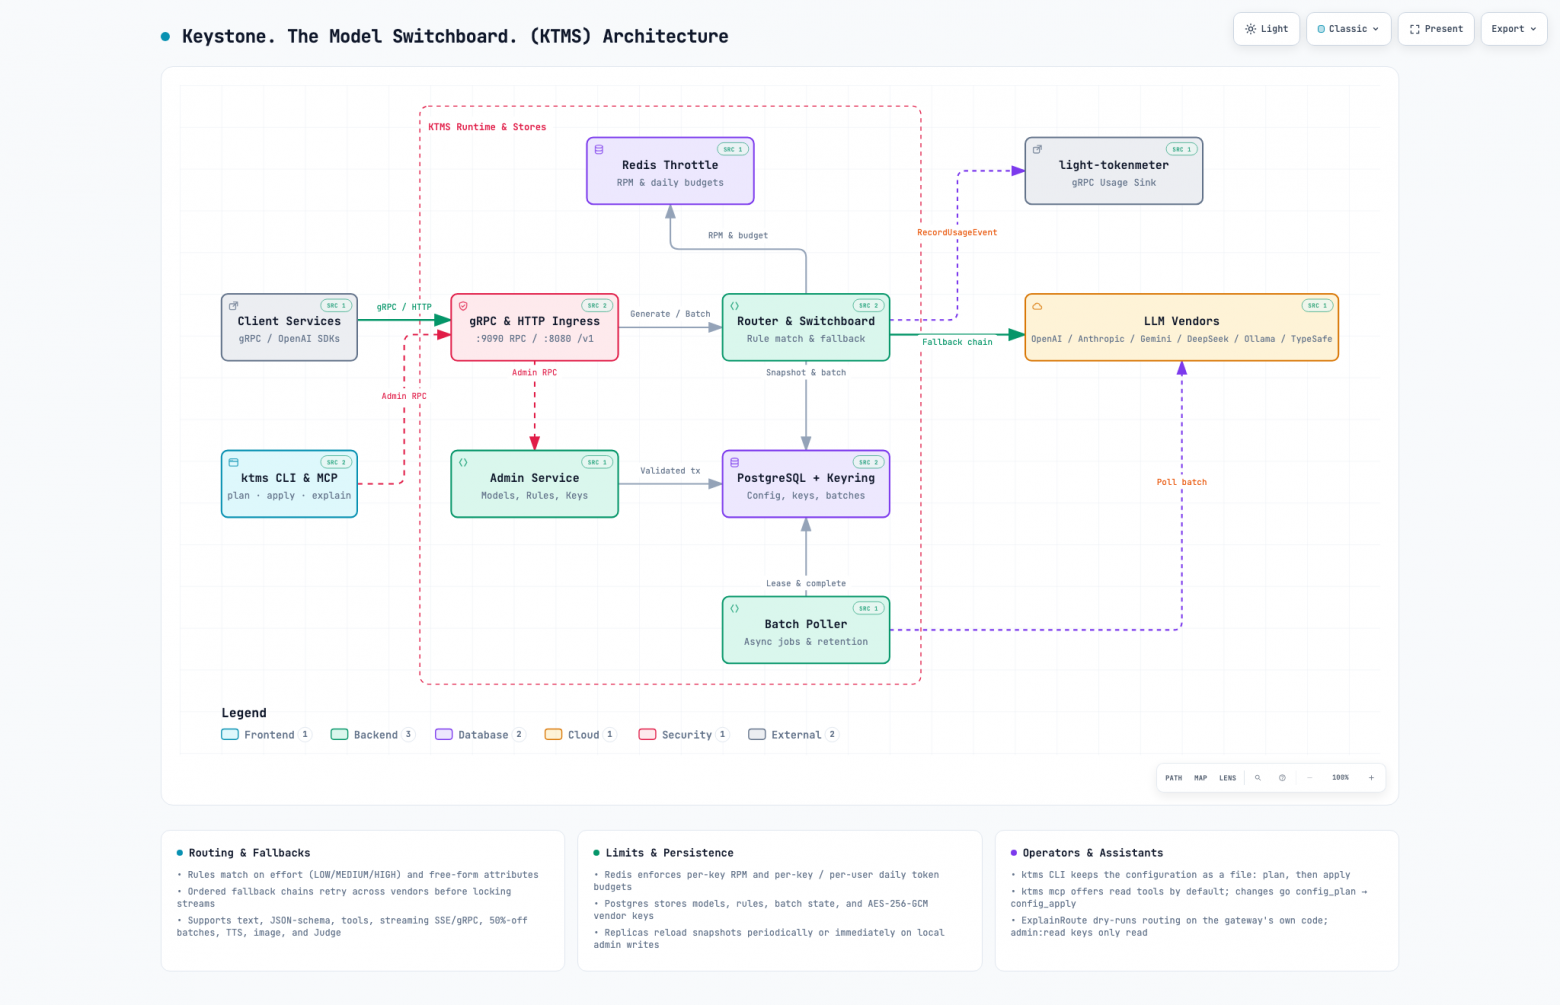
Сервис не пишет gpt-4o. Он просит сложность: LOW, MEDIUM или HIGH, и добавляет произвольные атрибуты (language, task, user_id). Упорядоченный список правил превращает это в цепочку моделей с фолбэками:
grpcurl -plaintext -H "authorization: Bearer $ADMIN_KEY" -d '{"rules":[
  {"name":"spanish-high", "priority":30, "effort":"EFFORT_HIGH",
   "attributes":{"language":"es"}, "use":["gemini-2.5-pro","gpt-4o"], "enabled":true},
  {"name":"low-default", "priority":20, "effort":"EFFORT_LOW",
   "use":["deepseek-chat","gpt-4o-mini"], "enabled":true},
  {"name":"anything-else", "priority":1, "use":["gpt-4o-mini"], "enabled":true}
]}' localhost:9090 ktms.v1.AdminService/ReplaceRules
Правила меняются на лету, без релиза сервисов. Вышла новая модель — правите правило, а не сорок микросервисов.
Подключение без переписывания кода
Есть типизированный gRPC (ktms.v1) и OpenAI‑совместимый HTTP. Существующий код на OpenAI SDK переключается сменой base_url:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8080/v1", api_key="ktms_<ваш ключ>")
reply = client.chat.completions.create(
    model="auto",
    messages=[{"role": "user", "content": "Say hi in three words."}],
)
print(reply.choices[0].message.content, reply.model)
В ответе заголовки X-KTMS-Vendor, X-KTMS-Rule и X-KTMS-Placement показывают, кто и по какому правилу ответил.
Что умеет (на версии 1.3)
Маршрутизация: effort LOW/MEDIUM/HIGH и атрибуты, правила с приоритетами, которые меняются на лету, цепочки фолбэков,
model: "auto"с судьёй (250 мс, откат на MEDIUM), канарейки с привязкой к пользователю, shadow‑трафик с оценкой, сухой прогонktms route explain.Надёжность: circuit breaker, пауза модели по
Retry-After, одна попытка — один вызов, работа при отказе Postgres и Redis.Деньги и лимиты: RPM/TPM и allowlist моделей на ключ, дневные и месячные лимиты расходов на ключ и пользователя, месячный бюджет команды, цены prompt cache, Batch API вендоров.
Свои GPU: агент ноды для Ollama, vLLM, TGI и llama.cpp, допуск по реальной очереди, placement «только свои ноды», уровни мощности и расписание нагрузки, локальный журнал
ktms-node stats.Безопасность: ключи вендоров в Postgres под AES-256-GCM и их ротация, маскирование PII, детекция prompt injection, латентные guardrails и семантический кэш (экспериментально).
API: gRPC
ktms.v1и OpenAI‑совместимый HTTP, стриминг, tool calling, JSON Schema без потерь, embeddings, TTS, картинки, Judge.Управление: CLI
ktmsс контекстами иktms init, конфигурация в YAML (plan/apply), MCP‑серверktms mcpдля ИИ‑ассистентов, плагин для Claude Code, scopeadmin:read, веб‑консоль ktms‑admin.Эксплуатация: метрики
ktms_*с готовыми алертами, Helm‑чарт в OCI, подписанные образы с SBOM и SLSA, тест обновления на каждом PR.
Сколько это стоит по ресурсам
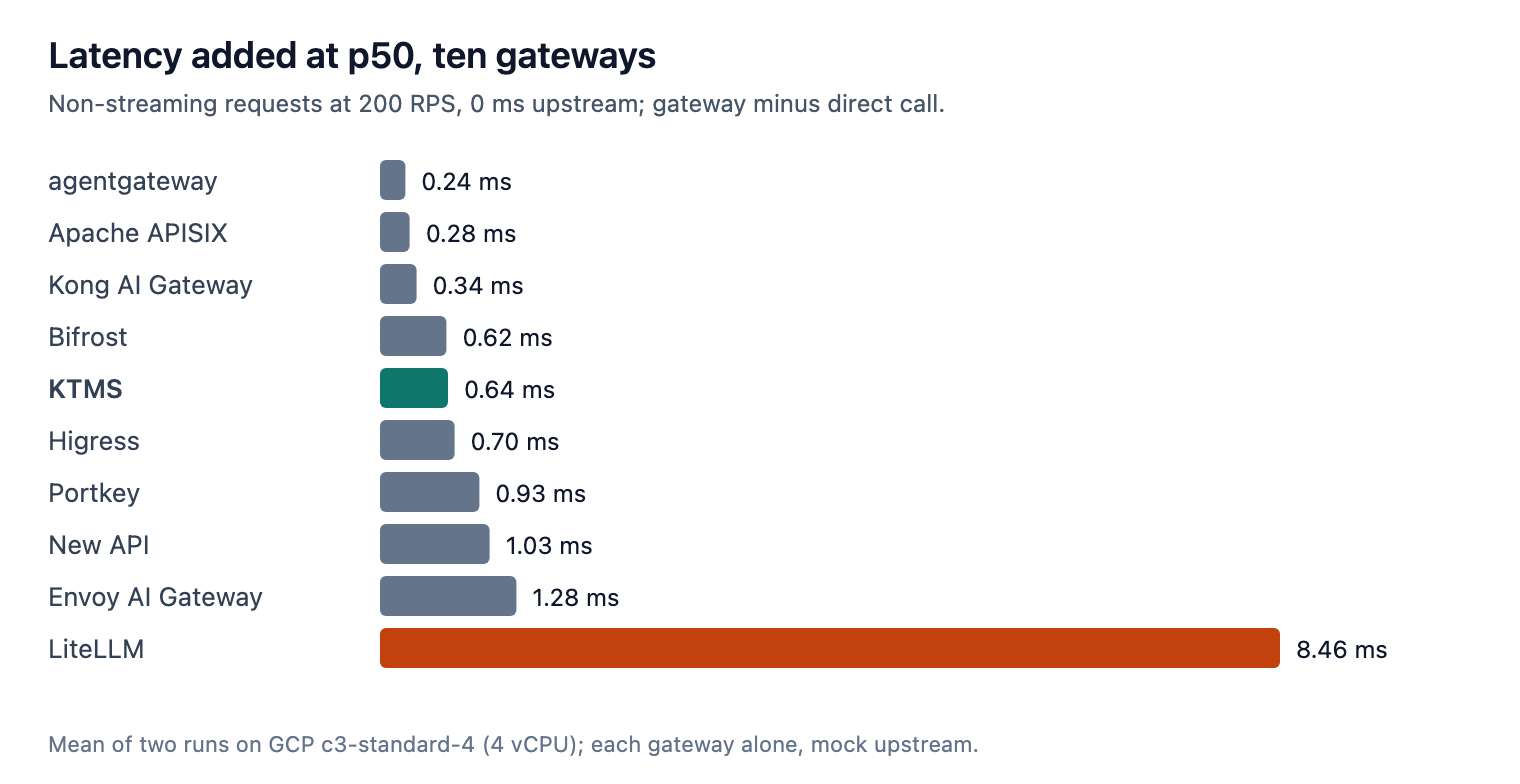
Keystone — один Go‑процесс без интерпретатора. На стенде из 11 шлюзов (Google Cloud c3-standard-4, 4 vCPU, mock‑апстрим, два прогона):
~7 МиБ памяти в простое и ~20 МиБ при 200 RPS (Postgres и Redis не считаются);
~0,64 мс добавленной задержки на p50 и ~1,1 мс на p99;
не меньше 4000 RPS на 4 vCPU без ошибок;
~170 мс от
docker startдо первого ответа;образ ~21 МБ на скачивание.
Мы не самые быстрые: agentgateway, Apache APISIX и Kong добавляют меньше задержки и тратят меньше CPU на запрос. Зато по сочетанию памяти, старта и возможностей Keystone в верхней группе.
Что вошло в релиз
Что появилось на пути от 0.13 к 1.0.
Организации и команды. Ключи группируются в организации и команды. У команды свой список разрешённых моделей и месячный бюджет на все её ключи. ListModels показывает команде только её модели.
Надёжность вызовов вендоров. Встроенные ретраи SDK отключены, поэтому одна попытка роутера — ровно один вызов вендора. Шлюз читает Retry-After (и аналоги у Gemini) и ставит модель на паузу для конкретного ключа вендора, а цепочка идёт дальше. Плюс circuit breaker на пару (вендор, модель).
Поведение при отказах зависимостей. Описано и проверено для каждого случая. При отказе Postgres ключи, проверенные за последние 5 минут, продолжают работать, а маршрутизация идёт из последнего снимка конфигурации. При отказе Redis лимиты не блокируют трафик (для денег режим выбирается отдельно). События учёта копятся в очереди и доставляются ровно один раз.
Структурированный вывод без потерь. JSON Schema передаётся вендорам вместе с enum, format, nullable и additionalProperties. Если вендор не умеет структурированный вывод, шлюз сам проверяет ответ, один раз повторяет запрос и переходит к следующей модели.
Локальные ноды по реальной очереди. Агент ноды передаёт глубину очереди движка (vLLM, TGI, llama.cpp), и шлюз не отправляет запрос на ноду, где он будет ждать дольше допустимого.
Ротация ключей шифрования. Безопасная процедура: новые записи шифруются новой версией ключа, RotateEncryption перешифровывает ключи вендоров и токены нод в одной транзакции. Последовательность прогоняется на Postgres в CI.
Подписанные релизы. Образы и checksums.txt подписаны cosign в режиме keyless, у образов есть SBOM и SLSA‑provenance, у архивов SPDX SBOM. govulncheck запускается на каждом pull request.
Лицензия Apache 2.0 вместо MIT: явная патентная лицензия для тех, кто встраивает шлюз в свои продукты.
Недавняя компрометация релиза одной популярной Python‑библиотеки напомнила, что шлюз хранит ключи ко всем вендорам сразу. Подробный разбор того инцидента и что из него следует — в отдельной статье.
Два соседних проекта
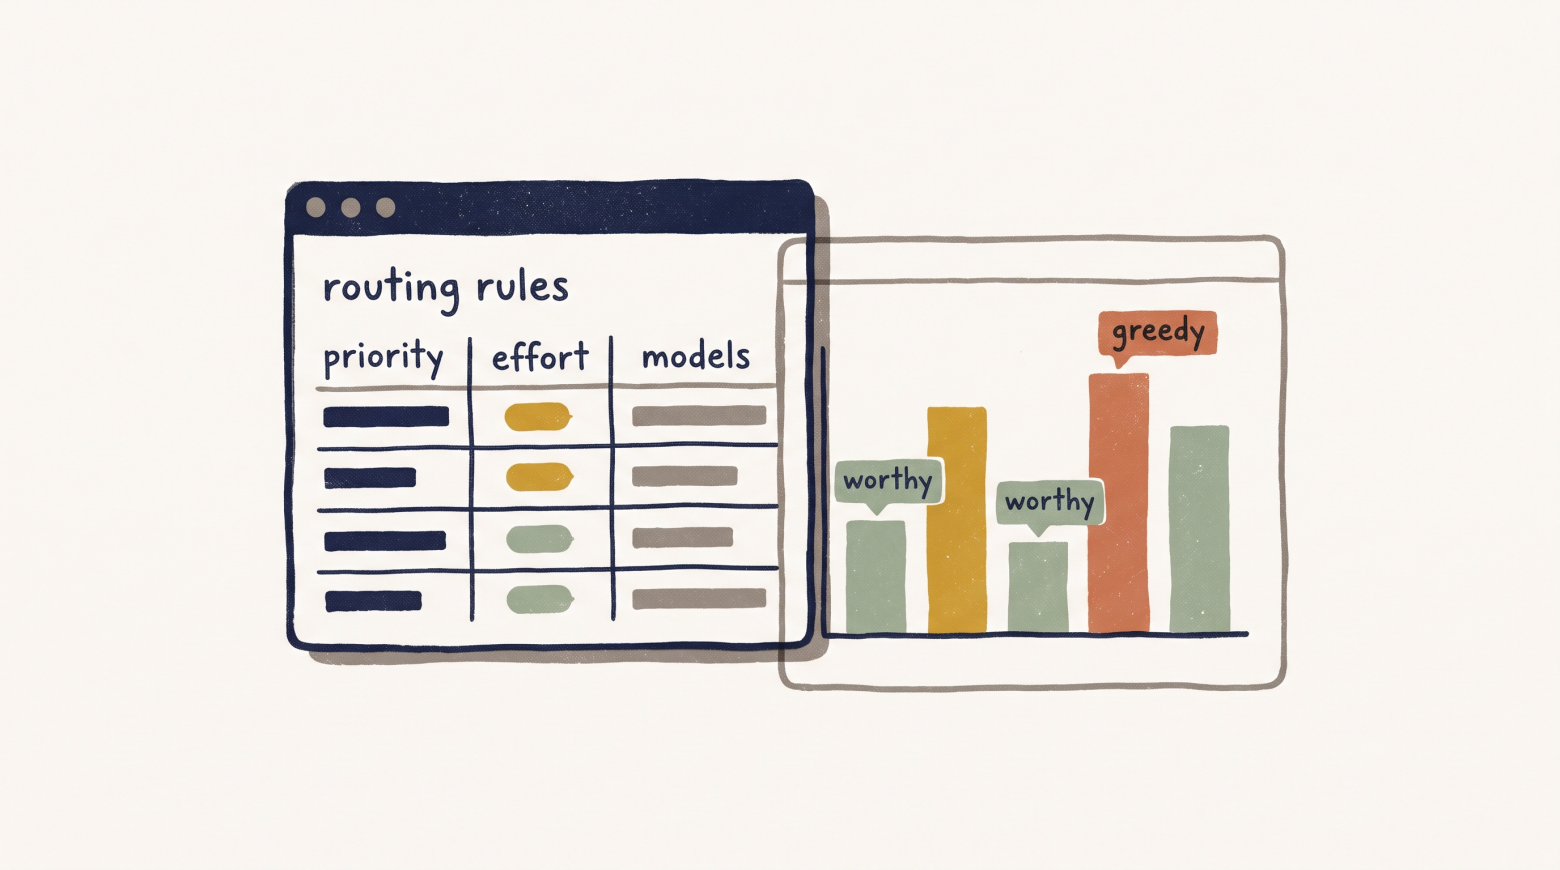
ktms‑admin — веб‑консоль: модели, правила, ключи, учётные данные вендоров и песочница для запроса через ваши правила. Вход по паролю, через Google или любой OpenID Connect, GitHub или ваш access‑прокси (oauth2-proxy, Authelia, Authentik, Pomerium, Cloudflare Access) со списком разрешённых адресов. Один бинарник, интерфейс встроен, сборки фронтенда нет.
light‑tokenmeter — отвечает на вопрос «кто тратит токены и стоит ли оно того». Принимает событие на каждый вызов и отдаёт сводки по проектам, пользователям, действиям, вендорам и моделям. Консоль по этим сводкам помечает группы как greedy или worthy. Один бинарник, одна таблица Postgres, ClickHouse по желанию.
Как попробовать
git clone https://github.com/ai-process/ktms.git && cd ktms
OPENAI_API_KEY=sk-... docker compose up -d --build
curl -s http://localhost:8080/v1/chat/completions \
  -H "Authorization: Bearer ktms_dev_default_key" -H "Content-Type: application/json" \
  -d '{"model":"auto","messages":[{"role":"user","content":"Say hi in three words."}]}'
Compose поднимает Postgres, Redis и шлюз с готовыми моделями, правилами и ключом для разработки.
Что значит 1.0
До 1.0 мы ничего не обещали. С 1.0 в пределах 1.x несовместимо не меняется:
Поверхность | Что сохраняется в 1.x |
|---|---|
gRPC | RPC, поля, enum и номера полей. |
HTTP | Пути, поля запросов и ответов, имена заголовков |
Переменные окружения | Имена, значения по умолчанию и смысл |
База данных | Любой 1.x сам обновляет базу предыдущего, без ручного SQL |
Метрики | Имена, метки, совместимость в обе стороны |
Коды и причины ошибок | Смысл сохраняется, новые причины могут появиться |
Что помечено экспериментальным и может поменяться в минорном релизе: выбор effort судьёй, shadow‑трафик, семантический кэш и латентные guardrails, JudgeStream и EvaluateRollouts, формат YAML‑конфигурации и команда ktms до версии формата v1. Полный список — в README, а в proto такие поля отмечены комментарием Experimental:.
Обещание проверяется автоматически. На каждом pull request и перед каждым релизом тест обновления поднимает базу предыдущего релиза и самого старого релиза той же мажорной версии, мигрирует её новой сборкой и снова запускает старую версию на мигрированной базе. Так проверяется и обновление, и rolling‑деплой. Релиз публикуется только после этого теста и buf breaking.
Что дальше
После 1.0 в планах: маршрутизация чувствительных данных только на свои ноды, hedged‑запросы, корректирующий повтор для JSON, Grafana‑дашборд и рецепты в документации. Ничто из этого не ломает API 1.x
Репозиторий: github.com/ai‑process/ktms
Документация: ai‑process.dev
Консоль: github.com/ai‑process/ktms‑admin
Учёт расходов: github.com/ai‑process/light‑tokenmeter
Буду рад вопросам в комментариях, особенно неудобным.