Обновить
256K+

DevOps *

Методология разработки программного обеспечения

370,86
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Вышел Cozystack v1.7.0: поддержка ARM, Proxmox как альтернатива KubeVirt, автоматическая миграция с VMware и другое

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели7.4K

Бывают релизы, а бывают релизы. Cozystack 1.7.0 из вторых. В нем не просто набор новых фичей, а такие фичи, которые снимают сразу несколько блокеров миграции на это решение. Этот релиз понравится тем, кто уже использует Proxmox, собирается переезжать с VMware, не хочет выставлять базы данных в мир без шифрования, а бэкапить планирует не только PostgreSQL. Но обо всем по порядку.

Читать далее

Envoy Tap Filter: перехватываем и анализируем HTTP-трафик в Istio Service Mesh

Уровень сложностиСредний
Время на прочтение17 мин
Охват и читатели5.3K

Привет, Хабр!

Меня зовут Валентин, я DevOps-инженер команды Platform V Kintsugi. Мы развиваем облачный сервис и часто сталкиваемся с задачами эксплуатации распределённых систем, созданных на основе Kubernetes и Istio/Platform V Synapse Service Mesh.

Одна из самых неприятных задач — поиск проблем в обработке запроса внутри Service Mesh на базе Envoy. Типичная ситуация: один из сервисов внезапно начинает получать 503, появляются неожиданные повторы, запросы перестают проходить из-за AuthorizationPolicy или уходят не в тот upstream. При этом само приложение работает нормально, в его журналах нет ошибок, а конфигурация Istio, на первый взгляд, выглядит корректной.

Мы начинаем разбираться и смотрим access-журналы. Видим результат обработки запроса, но не всегда понимаем, что именно Envoy получил, какие заголовки и тело запроса он увидел, какие фильтры уже успели его изменить и почему в итоге запрос пошёл именно по этому пути. Сетевой дамп тоже не всегда помогает. При включённом mTLS на уровне сети мы можем увидеть зашифрованный трафик, но не тот HTTP-запрос, который уже расшифровал и обрабатывает Envoy. Получается неприятный диагностический разрыв, когда приложение видит одно, сеть показывает другое, а решение принимает Envoy. Возникает главный вопрос, что на самом деле видит Envoy и приложение в момент обработки HTTP-запроса?

В этой статье разберём, как с помощью Envoy Tap Filter заглянуть внутрь этого процесса — перехватить HTTP-запрос и ответ уже после расшифровки mTLS, отфильтровать только нужный трафик и сохранить результат в файл. На практике посмотрим, как подключить Tap Filter к Istio через EnvoyFilter, настроить точечный отбор запросов, выбрать формат сохранения тела и проанализировать полученные JSON-файлы. В результате получим инструмент для тех случаев, когда стандартных журналов недостаточно, а сетевой дамп показывает только зашифрованный транспорт.

Читать далее

Переезд инженера в Испанию: что проверить в IAM, VPN и on-call до вылета

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели4.3K

В пятницу вечером дежурному приходит алерт. PagerDuty работает, но облачная консоль возвращает отказ при входе: Conditional Access не пропускает подключение из новой страны. В этот момент бесполезно выяснять, почему уведомление доставлено — нужно понять, кто сможет открыть дашборд вместо primary. Это пример возможного сбоя, а не история из моей практики.

Я собрал технический чек-лист по документации Microsoft Entra и типовым задачам IAM/SRE. Проверим модельный сценарий: инженер с иностранным работодателем переезжает из Тбилиси в Барселону и продолжает пользоваться Entra ID, корпоративным VPN, GitHub, облачной консолью и PagerDuty. Таблицу ниже можно скопировать в задачу на подготовку переезда и заполнить вместе с владельцами систем.

Читать далее

Как оценить зрелость безопасной разработки своими силами? Сравниваем четыре методологии

Время на прочтение7 мин
Охват и читатели5.1K

Безопасная разработка сейчас — одна из самых горячих тем в российском ИТ. Чаще всего к ней подталкивают внешние обстоятельства: требования регуляторов, предстоящие проверки или инцидент, после которого процессы приходится пересматривать. Самый редкий, но самый честный повод — руководство действительно хочет разрабатывать безопасное ПО.

Но прежде чем внедрять новые для компании практики безопасной разработки, нужно честно посмотреть на текущие процессы: что из практик уже внедрено и работает, где пробелы и какие есть проблемы. Только тогда станет понятно, в каком направлении двигаться и как строить план внедрения.

Как же оценить зрелость процессов? На глаз? По одной из западных методологий? По ГОСТу? Если звать внешнего аудитора не хочется, вариантов, на самом деле, четыре: BSIMM, DSOMM, SAMM и ГОСТ Р 56939-2024. Какому из них отдать предпочтение, не очевидно: методологии по-разному устроены, по-разному ложатся на российские реалии, и не каждая доводит от оценки до понятного плана действий. Где-то есть готовый опросник с расчетом, где-то его придется собирать самому, а где-то практики рассчитаны на очень зрелые компании и для большинства российских слишком затратны. 

Я прогнал все четыре методологии через имитацию аудита на одной вымышленной компании и проверил, с какой проще пройти весь путь — от оценки зрелости до рекомендаций и дорожной карты. 

Материала набралось на три статьи. В этой сравню все четыре методологии, разберу их преимущества и недостатки и сделаю вывод, для каких задач годится каждая. Во второй на примере BSIMM, DSOMM и SAMM покажу, как провести оценку, какими инструментами воспользоваться и с какими ограничениями придется столкнуться. В третьей разберу оценку по ГОСТ Р 56939-2024.

Заваривайте кофе и устраивайтесь поудобнее — отправляемся в путешествие по внутреннему аудиту!

Читать далее

А я ни разу не была в малинках: запихиваем Cozystack в три Raspberry Pi с 8Гб RAM

Время на прочтение16 мин
Охват и читатели4.5K

Три платы Raspberry Pi 5 на столе, а на них — кластер, в котором крутятся контейнеры и виртуальные машины, есть мультитенантность, managed базы данных и всё остальное, что дает Cozystack.

Зачем это нужно? Cozystack обычно ставят на стойку серверов в дата-центре, и чтобы просто пощупать платформу, приходится арендовать железо или поднимать виртуалки в облаке. А три малинки стоят как один вечер в ресторане, помещаются в рюкзак и работают от обычной розетки. На них можно учиться, показывать Cozystack на конференциях, отлаживать автоматизации или держать дома маленькое облако.

Читать далее

Как восстановить потерянные коммиты и ветки в Git

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели4.9K

Иногда после git reset --hard, rebase или удаления ветки кажется, что несколько часов работы исчезли. Но Git часто не удаляет коммиты, а просто перестаёт на них ссылаться. Разбираем, как найти потерянное через reflog и fsck, восстановить ветку или stash и в каких случаях вернуть данные уже нельзя.

Разобрать по шагам →

СКД, DevOps и тестирование 1С: пять курсов на первое полугодие 2027 года

Время на прочтение2 мин
Охват и читатели4.6K

Инфостарт Обучение опубликовал расписание пяти курсов со стартами с января по май 2027 года. До 31 декабря 2026 года участие можно оформить и оплатить по текущей стоимости: с 1 января цены на эти программы вырастут. В подборке - управление ИТ-проектами, разработка отчётов, DevOps, нагрузочное и автоматизированное тестирование.

Читать далее

Сервер жив, сайт лежит: разбираем Linux, сети и DevOps на 18 бесплатных уроках

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели5.5K

Сайт недоступен, хотя сервер работает, сетевые задержки растут, а алерты не помогают вовремя обнаружить сбой. В таких ситуациях важно быстро локализовать проблему и понимать, на каком уровне искать причину. Собрали 18 открытых уроков OTUS, посвящённых диагностике Linux и Docker, сетевой инфраструктуре, автоматизации CI/CD и мониторингу.

Смотреть подборку

Как я заставляю Linux ломаться одинаково для каждого нового пользователя

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели5.1K

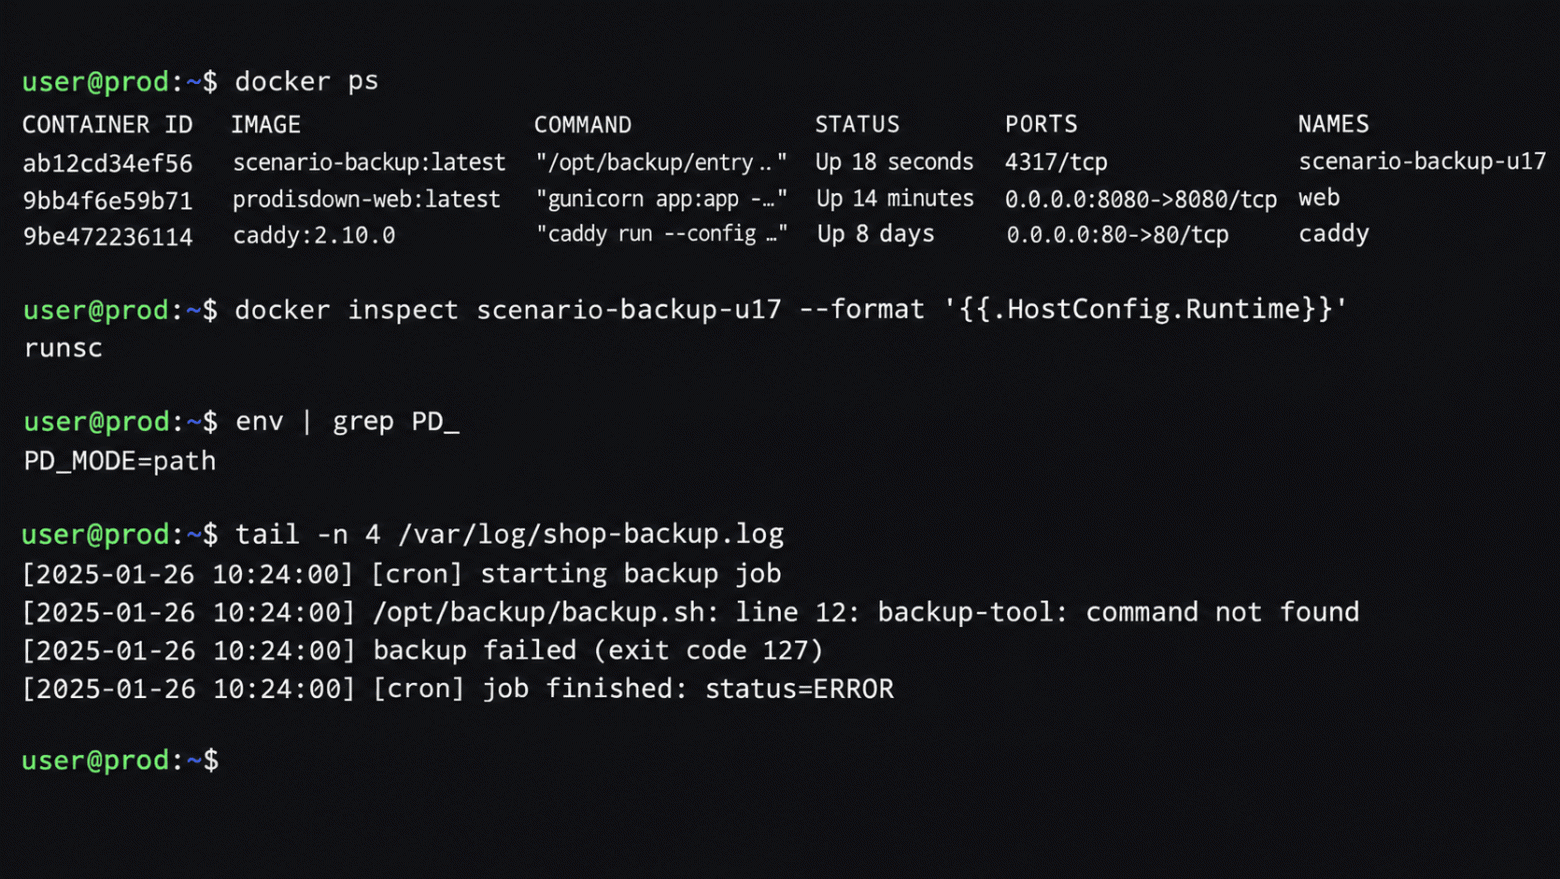
В моем проекте реализованы кейсы с неисправностями системы. Сами неисправности довольно привычные: не запускается приложение, не работает резервное копирование, заканчиваются файловые дескрипторы, Nginx отдаёт ошибку.

Сложность оказалась не в том, чтобы сломать сервис. Нужно сделать так, чтобы каждый новый запуск начинался с предсказуемого состояния, независимо от того, что делал предыдущий пользователь.

При этом не хотелось сводить прохождение к запоминанию одной команды. Например, если резервная копия не создаётся, причина не обязана каждый раз быть одинаковой.

Расскажу, как сейчас устроена подготовка таких окружений, на примере сценария с cron.

Читать далее

Я написал мониторинг, который никогда не падает. Полгода он не падал и ни разу не сработал

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели3.9K

14 октября в логах нашего API нашлась строка «relation “message_watchdog” does not exist». Таблицы сторожа потерянных сообщений не было ни на dev, ни на проде, хотя код, который в неё пишет, жил в репозитории с апреля и на каждый вызов отвечал success: true. Рассказываю, как переименование миграции в V10b спрятало её от Flyway и почему мой мониторинг полгода докладывал, что всё спокойно.

Читать далее

Когда Hadoop начал тормозить бизнес: как мы перестроили платформу данных в Lenta Tech

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели4.5K

Привет, Хабр! На связи Владимир Бибичев, инженер больших данных, и Илья Кисляков, старший инженер больших данных Lenta Tech. Мы занимаемся развитием и сопровождением корпоративной платформы больших данных.

На старой платформе Hadoop ETL-процессы могли часами ждать свободных ресурсов, аналитики не успевали выполнять запросы, а бизнес — вовремя получать данные. С ростом нагрузки ситуация становилась всё сложнее, и в какой-то момент мы поняли: простым расширением кластера проблему не решить.

Пришлось серьезно пересмотреть подход к работе с платформой данных. Что именно мы изменили, с какими трудностями столкнулись и к каким результатам пришли — рассказываем в статье.

Читать далее

Что если автоматически создать 1035 Pull Request в одном репозитории?

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели4.6K

Я хотел автоматизировать работу с GitHub через локального ИИ‑агента, в итоге пришлось написать PowerShell‑конвейер для создания Pull Request. В какой‑то момент стало интересно: выдержит ли GitHub больше тысячи автоматически создаваемых PR с обязательным CI и Auto Merge.

В этой статье разбираю, почему первые версии конвейера постоянно ломались и чем закончился эксперимент с 1035 Pull Request подряд.

Читать далее

Почему ваш CI/CD медленный: профилирование пайплайнов и устранение узких мест

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели4.7K

Разбираем профилирование CI/CD на GitLab: как вытащить queued_duration, почему кэш иногда замедляет сборку, и как посчитать критический путь (6 + max(4, 8) = 14), чтобы понять, какую джобу оптимизировать первой. С конфигами и замерами 👇

Читать далее

Ближайшие события

Отказоустойчивость Kubernetes-кластера: практика тестирования

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели7.2K

Про отказоустойчивость распределенных систем обычно говорят на уровне архитектурных схем: несколько реплик, несколько серверов, резервное хранилище, Kubernetes-кластер. На схеме все выглядит убедительно. Но у инженеров возникает более практичный вопрос: Что произойдет, если прямо сейчас взять и выключить часть инфраструктуры? Именно это мы и проверяем.

Читать далее

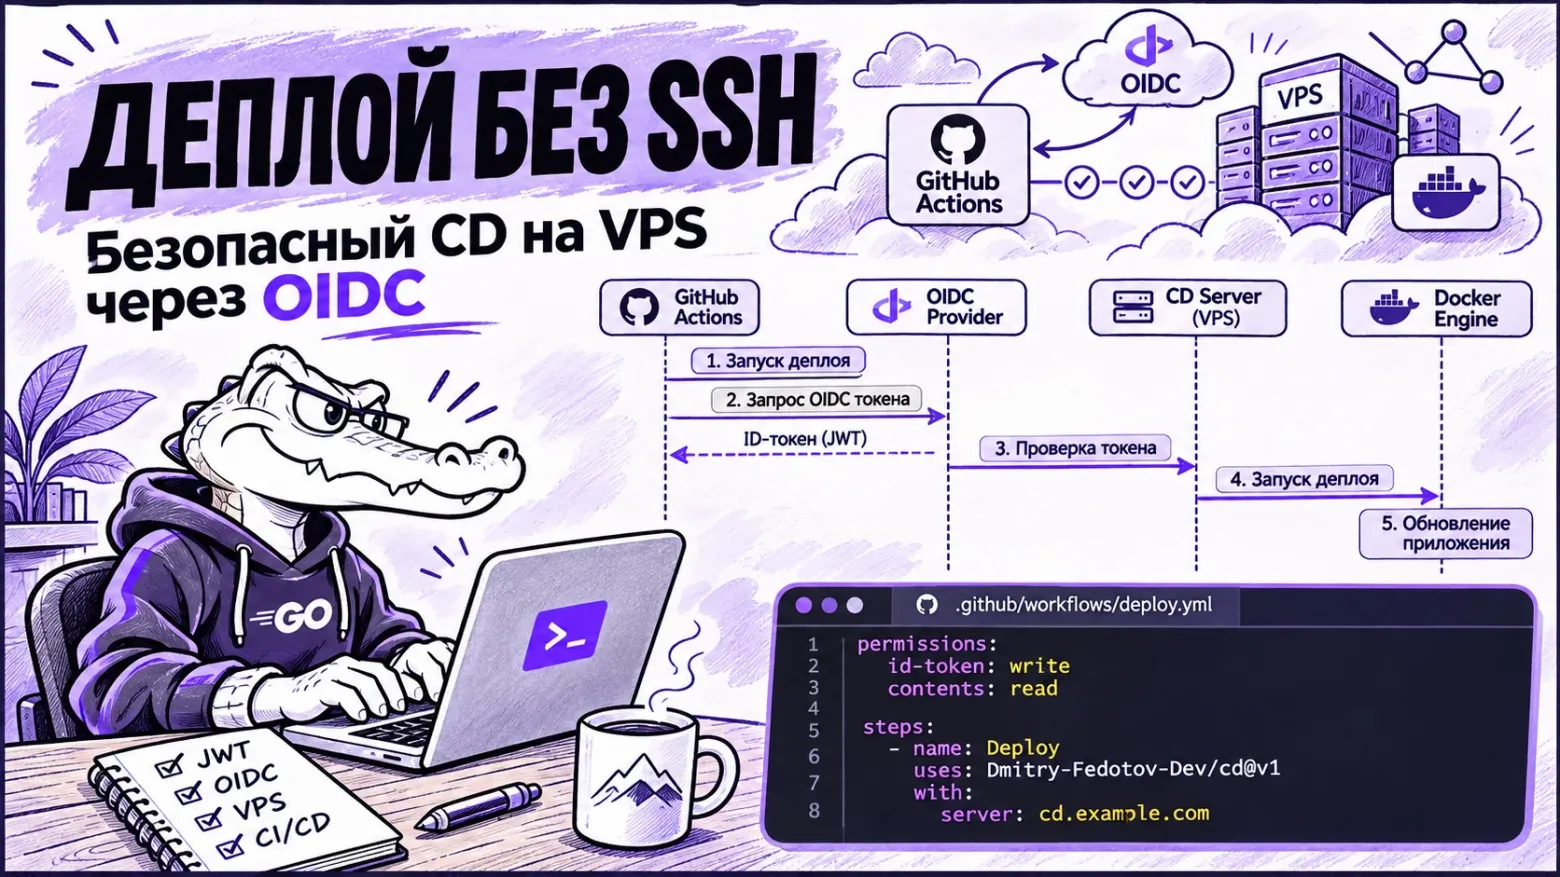
Деплой на VPS по push без SSH-ключей в CI: архитектура cd, механика OIDC и границы применимости

Время на прочтение12 мин
Охват и читатели11K

В практике системного администрирования малых и средних проектных контуров распространен сценарий, при котором на одном виртуальном выделенном сервере под управлением ОС Linux разворачивается несколько нетребовательных сервисов, таких как серверная часть приложений (), боты или статические веб-страницы. Инфраструктура хоста обычно включает Docker-демон и обратный прокси-сервер, представленный Caddy или Nginx. Стандартное требование к автоматизации процессов непрерывной интеграции и доставки заключается в выкатке новой версии сервиса на сервер при выполнении операции отправки изменений (git push) в основную ветку репозитория.

Развертывание приложений на собственном VPS традиционно выполняется по одной из трех ключевых схем, каждая из которых имеет выраженные технические компромиссы и уязвимости:

Прямой доступ из CI по протоколу SSH предполагает сохранение приватного ключа в настройках секретов репозитория. В ходе выполнения задачи workflow-раннер подключается к серверу по SSH и исполняет последовательность команд git pull && docker compose up -d --build. Подобный подход характеризуется высокой уязвимостью контура безопасности: приватный SSH-ключ является долгоживущим компрометируемым секретарем, а учетная запись на целевом сервере чаще всего обладает избыточными системными полномочиями. Компрометация секрета в любом из подключенных репозиториев предоставляет злоумышленнику неограниченный доступ к хост-системе, а не только к изолированному приложению.

Применение специализированных PaaS-панелей, таких как Coolify или Dokploy, обеспечивает удобный веб-интерфейс, однако приводит к разворачиванию крупного программного комплекса с собственной базой данных, модулями авторизации и расширенной поверхностью атаки исключительно ради задачи перезапуска нескольких контейнеров.

Читать далее

Зачем я написал ещё один Patroni: PostgreSQL HA на Go со встроенным Raft

Уровень сложностиПростой
Время на прочтение13 мин
Охват и читатели11K

Отказоустойчивый PostgreSQL — задача с неожиданно большим количеством инфраструктурных зависимостей. Patroni требует внешнего DCS, Stolon строит кластер вокруг keeper/sentinel/proxy и тоже опирается на внешнее хранилище, CloudNativePG ориентирован на Kubernetes, а repmgr оставляет часть задач обеспечения HA на стороне пользователя.

Мне хотелось другое: один бинарник на узел, который сам управляет PostgreSQL, сам обеспечивает консенсус и одинаково работает на обычных серверах, виртуальных машинах и в Kubernetes. Готового решения с такими свойствами я не нашёл — и написал tembo, HA-агент для PostgreSQL на Go со встроенным Raft и локальным хранилищем на bbolt.

В статье разберу, как устроены архитектура, fencing, failover и switchover, как это проверено тестами и — не менее важно — где проходят границы гарантий, которые нужно понимать до того, как доверить системе production.

Читать далее

Пересборка статического блога раз в 15 минут: rsync-зеркало, flock и запасная версия сборщика

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели8.9K

Я расскажу, как у меня устроена пересборка статического блога, который живёт на одном сервере, а собирается на другом. Главная страница, RSS и sitemap пересобираются по таймеру systemd каждые 15 минут, и за полтора месяца эта схема прошла 3 907 прогонов. Ниже конфиги и куски скриптов: как тянуть с удалённого сервера только нужное через фильтры rsync, как не дать двум прогонам наложиться друг на друга, как не затереть правку, сделанную руками во время сборки, и что делать, когда сборщик сломан. Отдельно про файлы, которые незаметно утекали наружу из вебрута.

Читать далее

Потери, которых не было видно на алертах: как мы автоматизировали поиск проблем в production с AI

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели9.4K

Сервис может работать, алерты — молчать, а пользователи — всё равно теряться на отдельных шагах. Рассказываем, как мы поручили ночную диагностику мультиагентной системе, почему не стали скармливать LLM все логи сразу и к какой архитектуре пришли после нескольких итераций.

Читать далее

Инфраструктура, управляемая стоимостью

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели8.1K

Почему аренда GPU часто оказывается избыточной и как спроектировать модель оплаты в Infracost

Типичная задача выглядит так — команда ML‑платформы получает бюджет и, чтобы не зависеть от доступности мощностей, арендует GPU‑кластер на год. Решение кажется разумным: цена за час ниже, чем у on‑demand, очередей нет, инженеры спокойны, стоимость спрогнозирована и включена в бюджет. Через полгода кто‑то из аудита видит, что кластер занят примерно треть времени, остальное время узлы стоят включёнными, ничего не обучают и при этом ровно так же стоят денег. Счёт приходит за все часы месяца, а полезная работа выполнена лишь в части из них.

Важно, что никто в этой истории не ошибся в техническом смысле. Кластер настроен корректно, задания запускаются, модели обучаются. Ошибка архитектурная: стоимость инфраструктуры считалась как фиксированная строка бюджета, а не как функция реального профиля нагрузки. Мы привыкли проектировать надёжность через SLA, резервирование и отказоустойчивость, безопасность через модель угроз и контроль доступа. Стоимость же слишком часто остаётся побочным эффектом, который обнаруживается постфактум.

Я предлагаю относиться к стоимости как к проектируемому свойству системы. Тезис простой: нагрузка на GPU при обучении моделей принципиально неравномерна, поэтому постоянная аренда мощностей с длинными обязательствами в большинстве случаев неоправданно дорога. Разумнее планировать не далее чем на месяц вперёд, выделять минимально необходимую базу под обязательство, а пики докупать по запросу. Решение при этом принимается не интуитивно, а по расчёту, причём расчёт делается на инфраструктуре, описанной как код. Инфраструктура управляется через контролируемые изменения и мы всегда имеем базу для расчёта стоимости и контроля изменений стоимости в ретроспективе. Одним из самых популярных инструментов такого контроля выступает Infracost.

Такой подход я называю инфраструктурой, управляемой стоимостью (cost-driven infrastructure) и процесс пересмотра стоимости и её прогноза должен стать таким же регулярным процессом проекта как оценка техдолга или контроля дрейфа показателей.

Читать далее

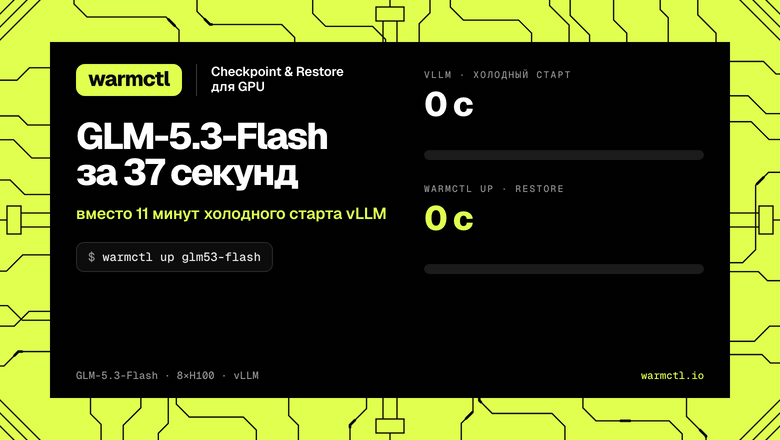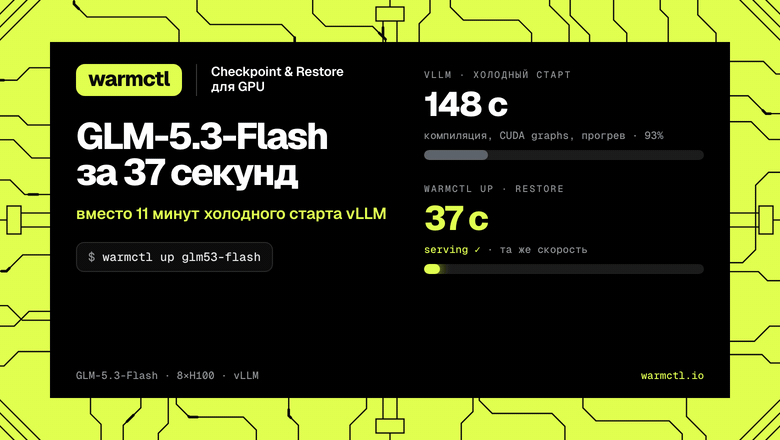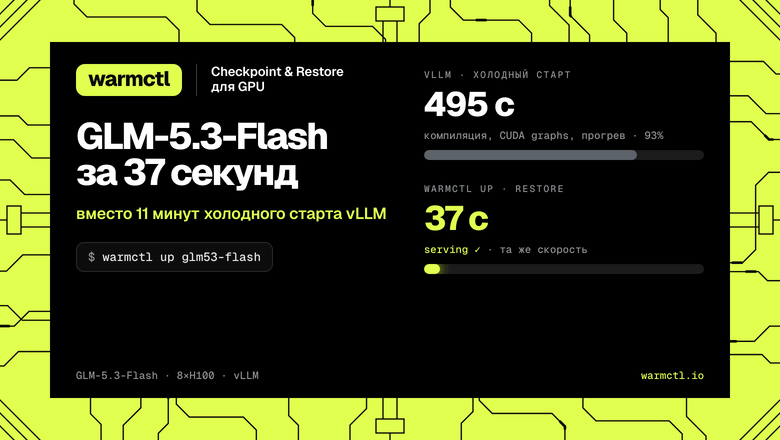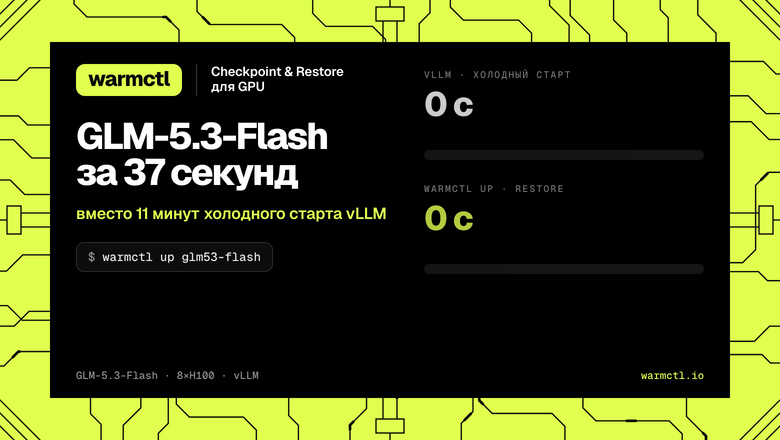
Оптимизация холодного старта vLLM: собираем прогретый OCI образ Deepseek и GLM и запускаем за 30 секунд

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели6.9K

Всем привет!

Меня зовут Кирилл, я больше десяти лет разрабатываю облака и инфраструктуру. Но последние пару месяцев в рамках R&D я достаточно много занимаюсь инференсом: платформами для него и оптимизацией всего, что вокруг, в частности проектом Serverless GPU с механиками примерно как у Modal или RunPod FlashBoot.

Одна из самых болезненных вещей здесь - холодный старт моделей. Каждый MLOps инженер, кто ждал перезапуск пода с vLLM / SGLang по 30 минут знает о чем я говорю.

Это особенно актуально, если вы делаете инференс на нескольких облачных провайдерах и спотовом GPU рынке, где может случиться прерывание vm или контейнера, так что способность быстро запускаться - must have в таких условиях.

Хорошие новости - чтобы решить эту проблему около месяца назад я начал работу над open-source проектом warmctl, о нём сегодня в посте.

Читать далее
1
23 ...