На записи слышен короткий щелчок. Голос местами теряется за гитарой, а в следующей фразе оказывается слишком громким. После сведения песня звучит тише соседнего трека. Всё это проблемы одной записи, но исправлять их приходится на разных этапах: сначала убрать дефект, затем настроить дорожки и только после этого довести готовый микс.
У iZotope для этих этапов есть четыре знакомых семейства. RX помогает восстановить запись. Nectar занимается вокалом. Neutron используют при сведении инструментов и групп дорожек. Ozone готовит уже сведённую фонограмму к выпуску: это этап мастеринга. Поэтому внешне похожие эквалайзеры и компрессоры оказываются в продуктах с разными задачами.
У компрессоров Nectar и Neutron я нашёл общий вычислительный узел DynamicsCore. В Nectar он работает с одной полосой сигнала, а Neutron строит вокруг него многополосную обработку. Это позволило проследить, где заканчивается общий код и начинаются настройки конкретного продукта.
Начну с различий, которые важны и пользователю, и разработчику:
Продукт | С какой задачей его открывают | Что это означает для обработки |
|---|---|---|
Убрать щелчок, шум или нежелательный звук из записи | Нужны поиск дефекта, анализ его окружения и восстановление сигнала; есть редактор и потоковые плагины | |
Подготовить вокальную дорожку: уровень, тембр, высоту, пространство | Несколько разных обработчиков должны работать как одна понятная вокальная цепочка | |
Настроить инструменты и развести конфликтующие дорожки | Нужны многополосная обработка, анализ динамики и взаимодействие с другими дорожками | |
Довести готовый микс: баланс частот, динамику, громкость | Обработка оценивается в контексте всей фонограммы; особенно важны работа с пиками и выбранные режимы качества |
Внутреннюю цифровую обработку сигнала дальше буду называть DSP. Небольшие фрагменты C++ показывают отдельные механизмы; схемы и снимки интерфейса помогают увидеть, где они оказываются в продукте. Детальные замеры относятся к Nectar 4.0.1.
Где у семейства общая кодовая база
Плагин загружается внутрь программы записи, например Logic или REAPER. Такая программа выступает хостом: передаёт ему звук, изменения настроек и команды жизненного цикла. Между хостом и алгоритмом находится оболочка формата AU, VST3 или AAX.
У установленных Nectar, Neutron и RX повторяется один механизм. В оболочке AU есть файл iZCore.path, указывающий на библиотеку обработки. Для трёх семейств это iZNectar4Core.bundle, iZNeutron5Core.bundle и iZRX12Core.bundle. Оболочка обращается к библиотеке через функции PluginCoreCallback и PluginCoreInterfaceVersion. Этот набор точек входа и есть контракт загрузки. Так код интеграции с форматом отделяется от конкретного эффекта.
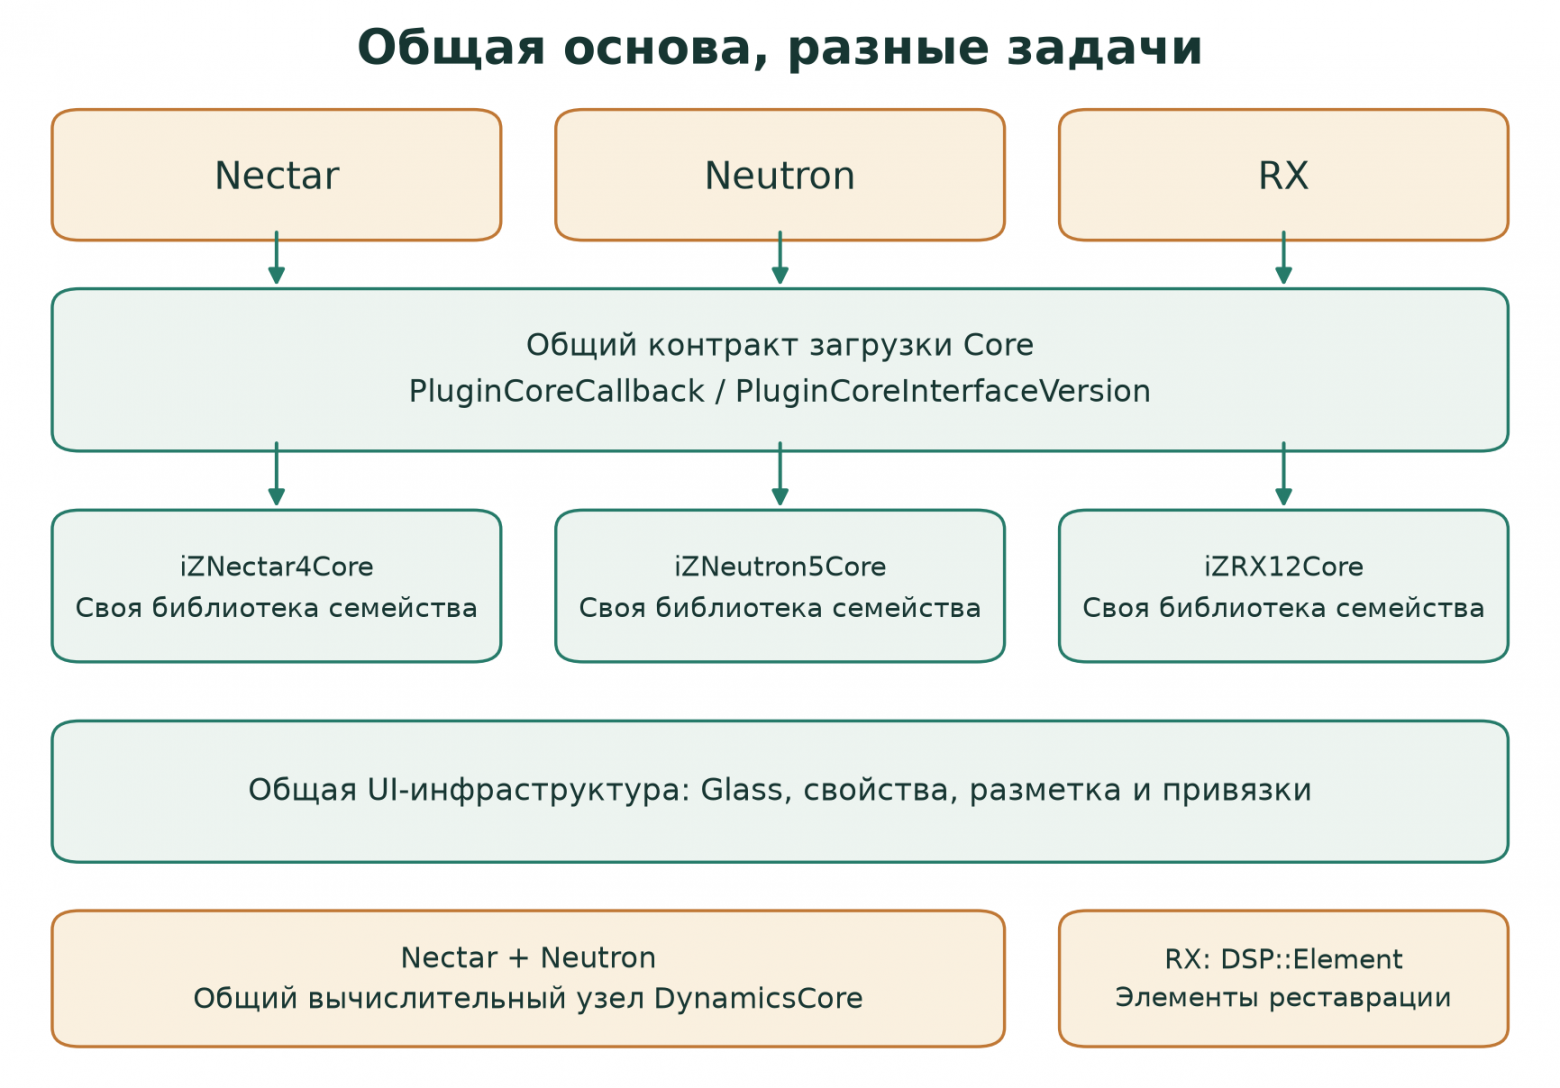
Внутри одного семейства повторное использование ещё заметнее. Я сравнил iZNectar4Core у Auto-Level, Backer и Breath Control: файлы совпали побитно. При этом для хоста это отдельные плагины. В Nectar Advanced 13 компонентных плагинов можно использовать самостоятельно, а в основном Nectar модули собраны в одну цепочку.
Nectar и Neutron используют общий класс DSP::Dynamics::DynamicsCore. У них совпадают части вычислительного ядра, включая логику переключения режимов. Neutron строит вокруг этого ядра многополосный процессор: сигнал делится по частотам, полосы получают собственные настройки, затем результат собирается обратно. У вокального компрессора Nectar другая конфигурация и свой набор режимов.
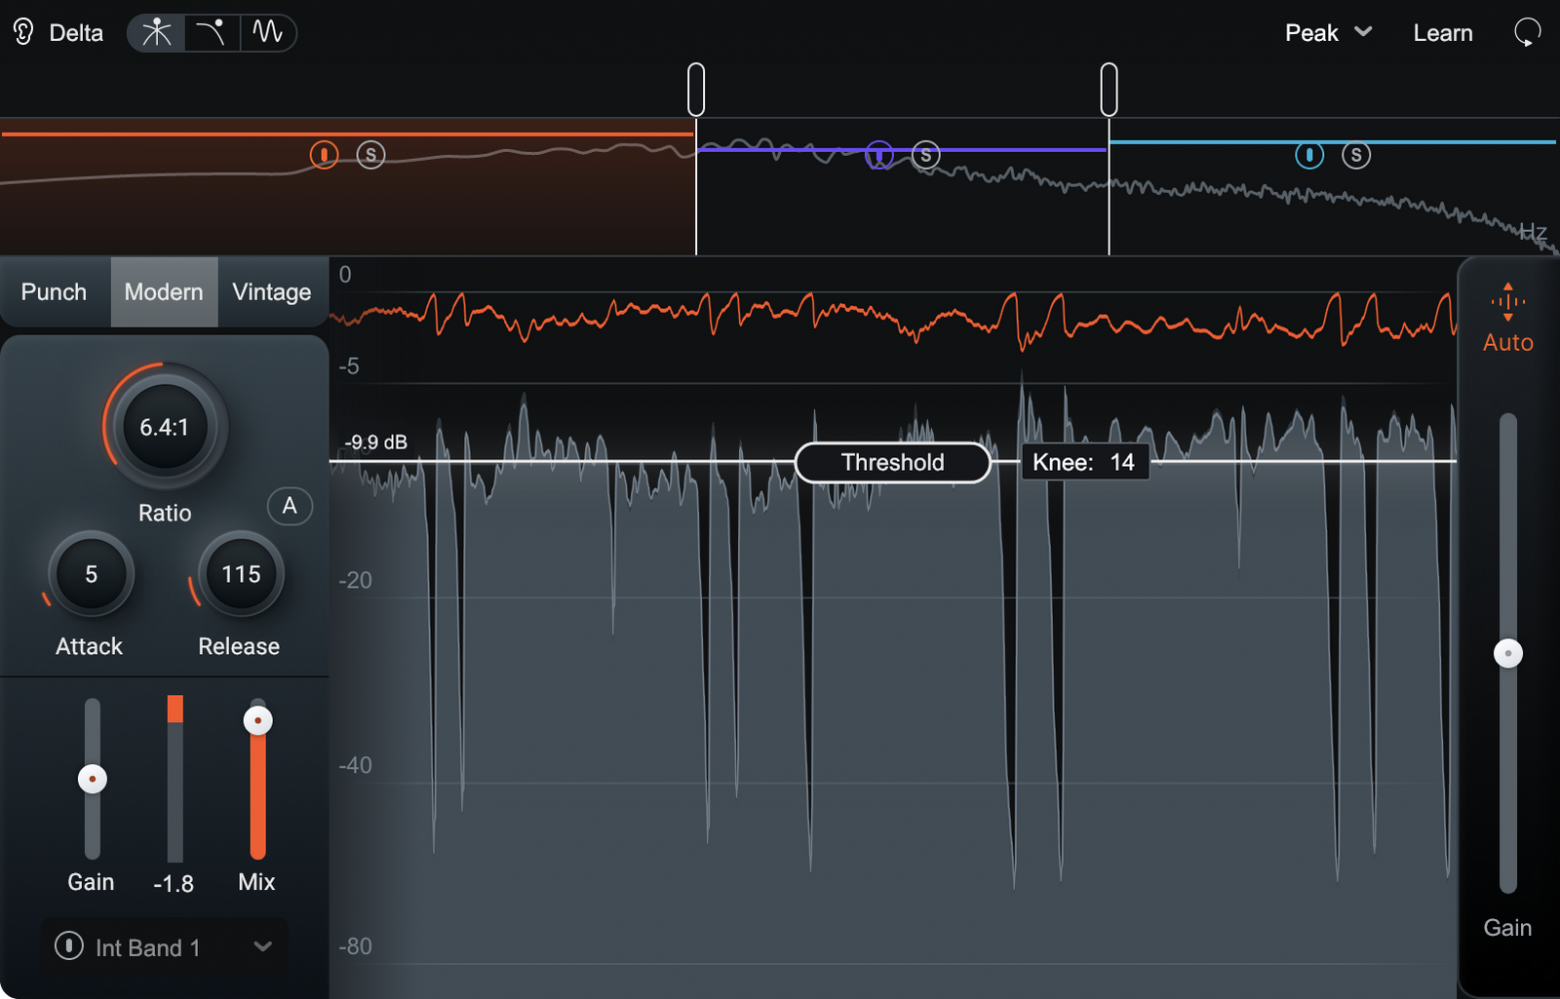
Рис. 2. Compressor в Neutron 5. Разделение по полосам добавляет управление границами диапазонов, отдельную динамику и сборку результата. Сходство вычислительного ядра сохраняет место для разного поведения продуктов. Источник: iZotope, Neutron 5.
Это и есть практический смысл общей кодовой базы: готовый узел включают в разные схемы, задают ему другие параметры и окружают другими алгоритмами. Одинаковые названия Attack и Release не обещают одинакового характера двух компрессоров. Влияют детектор уровня, режим, частотное разделение и закон изменения усиления.
RX продолжает эту архитектуру в сторону реставрации. В его Core есть объекты DSP::Element, диспетчер обработки и ElementOfflineHost для работы с фрагментом. Для удаления щелчка или восстановления участка спектра важен доступ к окружающему материалу. Отсюда другой способ организации расчёта, хотя загрузчик, параметры и часть интерфейсной инфраструктуры относятся к тому же семейству.
Плагины могут учитывать соседние дорожки
Предположим, голос теряется за гитарой. Можно сделать его громче, но причина может быть в совпадении частотных областей двух инструментов. Здесь обработчику полезно знать о второй дорожке.
Для этого у iZotope есть Inter-plugin Communication. Совместимые экземпляры передают данные для анализа маскирования и управления уровнями. Например, Nectar может работать с Neutron или Relay на конфликтующей дорожке, а Tonal Balance Control предоставляет доступ к совместимым эквалайзерам Neutron и Ozone. Для пользователя это возможность решить задачу из одного окна; внутри появляется связь между экземплярами плагинов.
При этом расчёт звука у каждого экземпляра остаётся своим. Обмен данными добавляет ещё одно требование: обновления с соседней дорожки должны доходить до нужного обработчика и не путать состояния разных экземпляров.
Параметры связывают весь продукт
Теперь можно открыть один из продуктов и проследить эти связи на экране. У Nectar есть страница Assistant с крупными общими регуляторами. Площадка FX управляет несколькими эффектами, хотя для пользователя это одно движение точки.
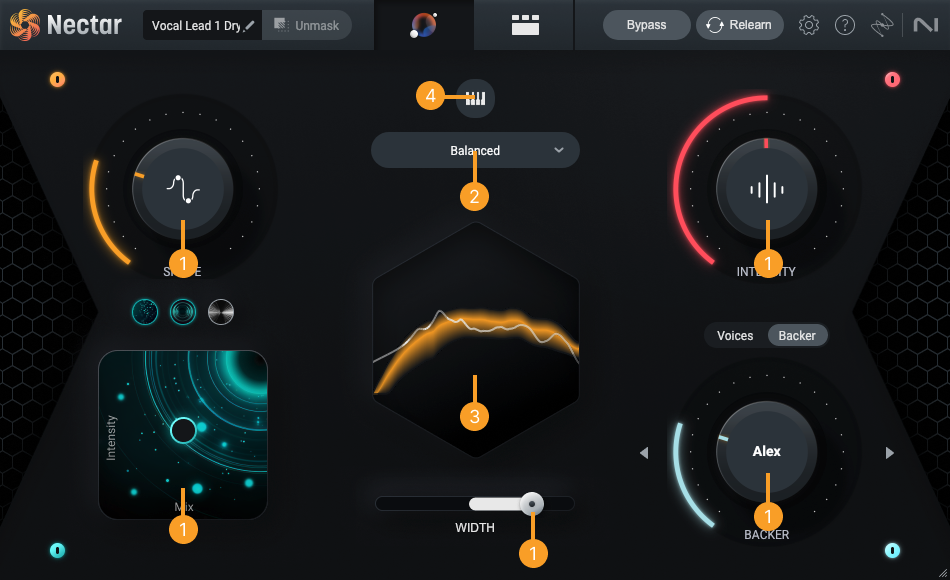
Рис. 3. Assistant в Nectar. Intensity справа и площадка FX слева управляют более подробными настройками модулей. Оранжевые номера добавлены авторами руководства. Источник: iZotope, Vocal Assistant.
В изученной сборке основной Nectar открывает хосту 689 параметров автоматизации. Это позволяет записывать изменение настроек вместе с музыкой. У одного порога компрессора, Threshold, при этом несколько источников: мышь, пресет, автоматизация и Vocal Assistant. Все они должны менять одно состояние, иначе ручка покажет одно число, а звук будет обрабатываться с другим.
В Nectar есть система параметров и привязок по ключам. В интерфейсных ресурсах встречаются отдельные пространства имён:
dsp.Leveler.EnableTargetLevelLearning
Global UI.Leveler View Expanded
meter.Input Smooth Audio Streamer.SmoothAudioDataStream
Первый ключ относится к обработке, второй к состоянию окна, третий к измерителю. Раскрытая панель не меняет звук. Движение уровня на экране не нужно записывать как автоматизацию ручки. По этой причине у визуального состояния и настроек DSP разные пути обновления.
Теперь вернёмся к экрану Assistant. Его Intensity связан с четырьмя настройками Compressor 1: порогом, отношением компрессии, атакой и восстановлением. А одна из координат FX, обозначенная в документации как X, управляет уже 11 параметрами трёх эффектов:
Эффект | Что меняет ось X | Что меняет ось Y |
|---|---|---|
Reverb | Ширину, предварительную задержку, время затухания | Долю обработанного сигнала, Wet Mix |
Delay | Rate, Depth, обратную связь левого и правого каналов, Amount | Wet Mix |
Dimension | Depth, Feedback, Width | Wet Mix |
Эти привязки опубликованы в руководстве. Пользователь выбирает выраженность эффекта и его долю в сигнале. Внутри меняются настройки нескольких обработчиков. При переходе в подробный режим он должен увидеть те же значения; при сохранении проекта они должны попасть в его состояние.
Допустимые значения тоже зависят от контекста. Например, в Optical-режиме компрессора Ratio фиксирован на 4:1, а диапазоны атаки и восстановления отличаются от других режимов. При переключении режима интерфейс должен показать допустимые настройки, и DSP должен получить именно их.
Строковые ключи удобны для разметки и пресетов. К моменту расчёта звука лучше уже иметь готовое значение с известными единицами, например порог в децибелах. Искать его по строке на каждом сэмпле незачем.
Фрагменты C++ ниже сокращены для объяснения механизмов. Это учебные реализации, а не полный код продукта; отдельно отмечен пример опубликованного API Glass.
Собственный интерфейс Glass
Кнопке нужны не только цвет и надпись. Она должна получать фокус, реагировать на клавиатуру, менять связанный параметр и правильно работать после открытия второго окна плагина. Такие механизмы выгодно поддерживать в общей библиотеке.
У iZotope эту роль выполняет собственная C+±библиотека Glass. Её классы присутствуют в Core Nectar, Neutron и RX. Roth Michaels рассказывал об устройстве библиотеки на CppCon в докладе A Case-study in Rewriting a Legacy GUI Library for Real-time Audio Software in Modern C++. Часть системы свойств опубликована как Glass Properties. Это демонстрационная часть библиотеки с зависимостями от внутренней сборки iZotope.
В ресурсах Nectar это устройство видно на кнопке Learn в Auto-Level. Она запускает обучение целевому уровню. У неё отдельно описаны тип, надпись, оформление и действие.
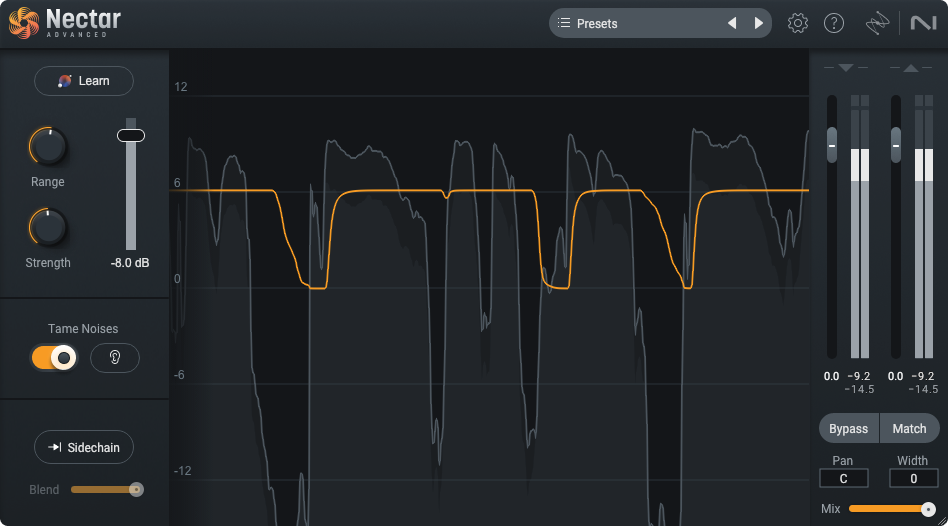
Рис. 4. Отдельный Auto-Level. Кнопка Learn находится слева сверху; её действие видно в разметке ниже. По центру показаны история уровня и управляющая кривая. Источник: iZotope, Auto-Level.
Сокращённая разметка этой кнопки:
<NewChild Name="Learn" Type="Glass::Button">
    <Property Name="Text" Type="Optional: std::string"
              Value="Learn" />
    <Property Name="Class" Type="Class"
              Value="SecondaryButtonColors" />
    <Property Name="Interaction"
              Type="Optional: Glass::ButtonInteraction"
              Value="toggle: dsp.Leveler.EnableTargetLevelLearning" />
</NewChild>
Разметка связывает элемент с действием через ключ параметра. Цвета и состояния кнопки можно описать в таблице стилей, расположение контейнеров задаётся flex-свойствами. В тех же ресурсах есть имена для доступности, ограничения размеров и отдельные изображения состояний контролов.
У отдельного Auto-Level и встроенного блока в большом Nectar разные панели. Кнопка Learn в обеих обращается к механизму обучения целевому уровню через параметр dsp.Leveler.EnableTargetLevelLearning.
Glass также проверяет часть работы со свойствами при компиляции C++. В опубликованном API текст кнопки можно задать так:
// Фрагмент API Glass Properties, iZotope, Apache-2.0.
button->SetProperty<ButtonProperties::Text>("Learn");
Шаблон проверяет, что свойство входит в список свойств класса, а аргумент имеет нужный тип. После изменения система может вызвать обработчик, пересчитать расположение или перерисовать элемент. Часть ошибок со свойствами так обнаруживается ещё при сборке.
В ресурсах сосуществуют iZCanvasLayout, Glass и web-представление Voices. У большого продукта интерфейс обновляется частями: новый экран должен продолжать работать с прежними параметрами и сохранёнными проектами.
Своё UI-ядро позволяет менять ручки, графики и привязки во всём семействе. При этом окно плагина живёт внутри чужого приложения. В release notes Nectar есть показательное исправление: кнопки Voices перехватывали горячие клавиши хоста, в том числе пробел для запуска транспорта. Звуковой алгоритм мог работать правильно, а привычная кнопка воспроизведения переставала действовать.
Ручка не должна останавливать аудиопоток
При буфере 64 сэмпла и частоте 48 кГц новая порция звука приходит каждые:
64 / 48 000 ≈ 1,33 мс.
Это бюджет всей работы, которую хост должен успеть выполнить для соответствующего блока. Плагин получает часть этого времени. Окно может ждать перерисовки, аудиопоток должен вовремя отдать результат.
Для передачи одного независимого значения из UI можно обойтись атомарной переменной. Ниже пример именно для одной ручки, без публикации связанных с ней объектов:
#include <algorithm>
#include <atomic>
#include <cmath>

struct GainTarget {
    static_assert(std::atomic<float>::is_always_lock_free);
    std::atomic<float> db {0.0f};

    void setFromUI(float value) noexcept {
        if (std::isfinite(value))
            db.store(std::clamp(value, -60.0f, 12.0f),
                     std::memory_order_relaxed);
    }

    float readAtBlockStart() const noexcept {
        return db.load(std::memory_order_relaxed);
    }
};
Для одного числа здесь достаточно relaxed: атомарная переменная передаёт только новое значение ручки. Несколько связанных настроек нужно передавать согласованно, чтобы аудиопоток не получил часть старых и часть новых. При замене графа обработки старые объекты нельзя удалять, пока аудиопоток ими пользуется. События автоматизации с позицией внутри блока тоже требуют обработки их временных смещений.
Полученное число ещё нельзя резко применить ко всему сигналу. Мгновенный скачок усиления создаст разрыв волны. Добавим сглаживание:
struct OnePole {
    float value = 1.0f;
    float alpha = 1.0f;

    // fs > 0; timeMs конечное и неотрицательное.
    void prepare(double fs, double timeMs) noexcept {
        alpha = timeMs > 0.0
            ? float(-std::expm1(-1.0 / (fs * timeMs * 0.001)))
            : 1.0f;
    }

    float tick(float target) noexcept {
        value += alpha * (target - value);
        return value;
    }
};
В начале блока переводим децибелы в линейный множитель: target = pow(10, db / 20). Затем на каждом сэмпле вызываем tick(target) и умножаем звук на результат. value сохраняется между блоками.
Коэффициент зависит от частоты дискретизации и времени. Для постоянной времени 5 мс при 48 кГц получится примерно 0,004158. Через 5 мс переход пройдёт около 63,2% расстояния до цели. Это постоянная времени, а не обещание полностью закончить переход за 5 мс.
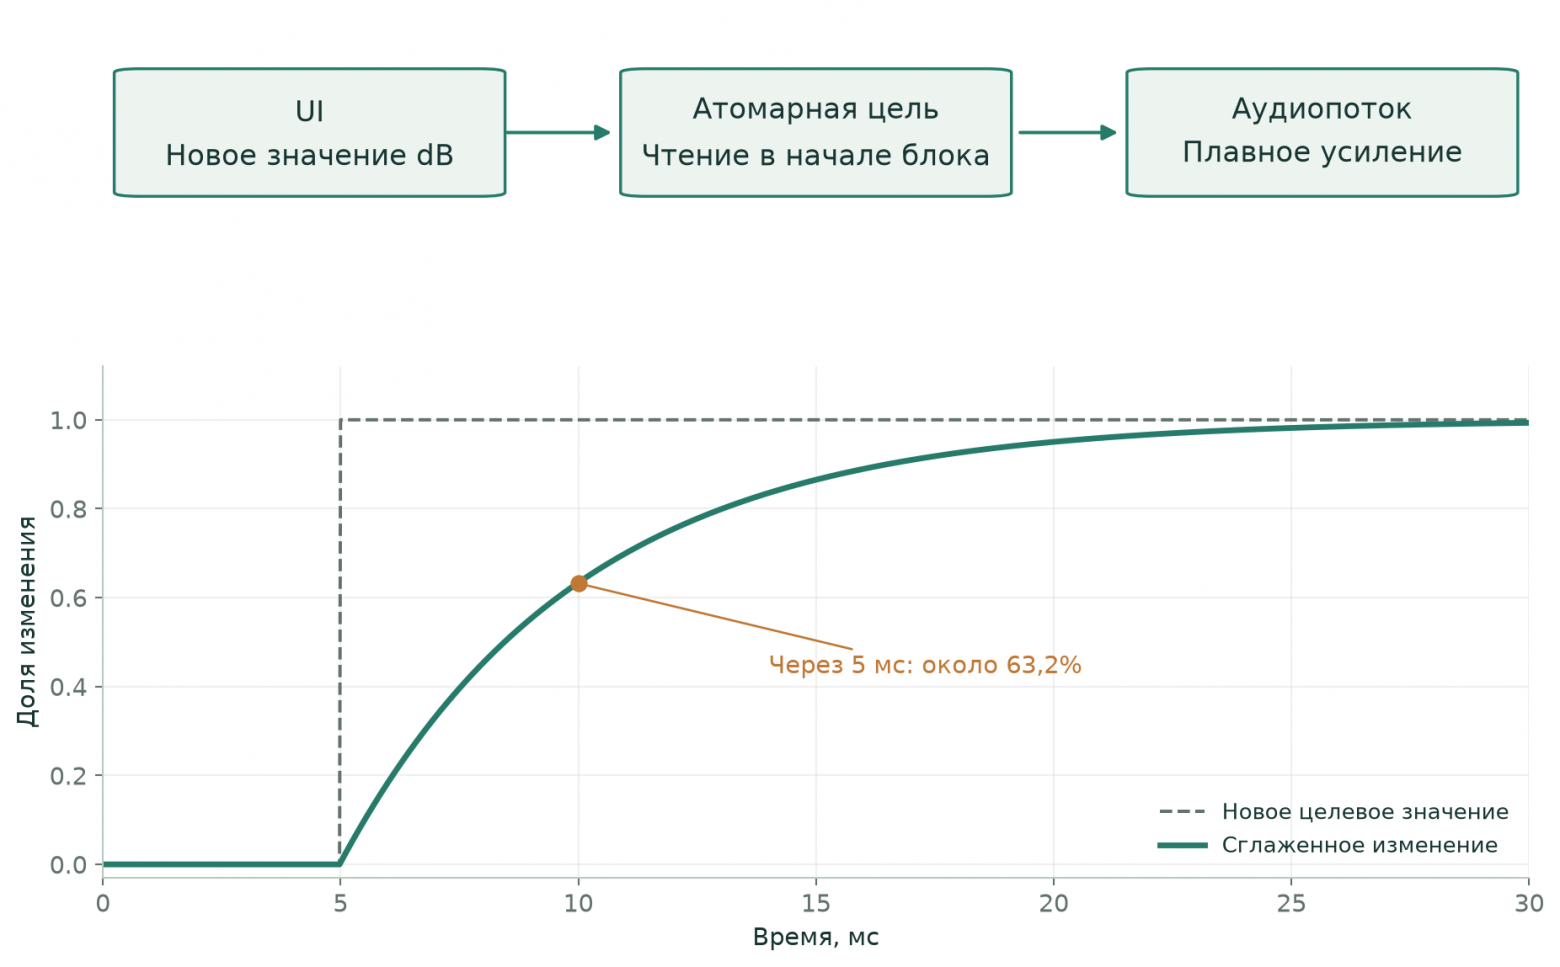
Я проверил этот пример при частотах от 16 до 192 кГц: время перехода сохраняется в секундах. Если оставить коэффициент от 48 кГц на другой частоте, переход займёт другое время. Когда FX одновременно меняет несколько эффектов, каждый из них должен получить новую цель и продолжить переход со своего текущего значения.
Те же требования к аудиопотоку действуют и в открытых проектах. Например, спецификация формата LV2 hardRTCapable прямо исключает управление кучей и потенциально блокирующие операции из аудиофункций.
Где получается zero-latency
Под zero-latency обычно понимают отсутствие добавочной буферной задержки алгоритма. Текущий входной сэмпл можно обработать сразу, используя уже накопленную историю. У простого усилителя или рекурсивного IIR-фильтра, использующего прошлые значения, такой путь возможен.
Вот фильтр второго порядка в форме с двумя переменными состояния. Коэффициент a0 заранее нормирован к единице:
struct Biquad {
    double b0 = 1, b1 = 0, b2 = 0, a1 = 0, a2 = 0;
    double z1 = 0, z2 = 0;

    double tick(double x) noexcept {
        const double y = b0 * x + z1;
        z1 = b1 * x - a1 * y + z2;
        z2 = b2 * x - a2 * y;
        return y;
    }
};
Для расчёта y не нужен следующий сэмпл. Это и позволяет не добавлять очередь ожидания входа. У фильтра при этом остаётся фазовая характеристика, а у аудиоинтерфейса и хоста свои буферы. Нулевая добавочная буферная задержка не означает, что весь тракт от микрофона до наушников мгновенный.
Ситуация меняется, если обработчику нужен будущий участок записи: например, для lookahead или анализа окна. Быстрый процессор сократит время вычислений, но будущий звук всё равно должен сначала поступить. Поэтому zero-latency относится к конкретному тракту и режиму, а не ко всем возможностям Nectar сразу.
Почему у RX и Ozone другой бюджет задержки
В редакторе RX можно выделить дефект и восстановить его по окружающему материалу. У Spectral Repair для этого есть Surrounding region length и Before/after weighting: насколько далеко искать подходящий сигнал и какую сторону от выделения учитывать сильнее. Запись уже существует целиком. Обработчик может использовать то, что находится после дефекта, до выдачи готового результата.
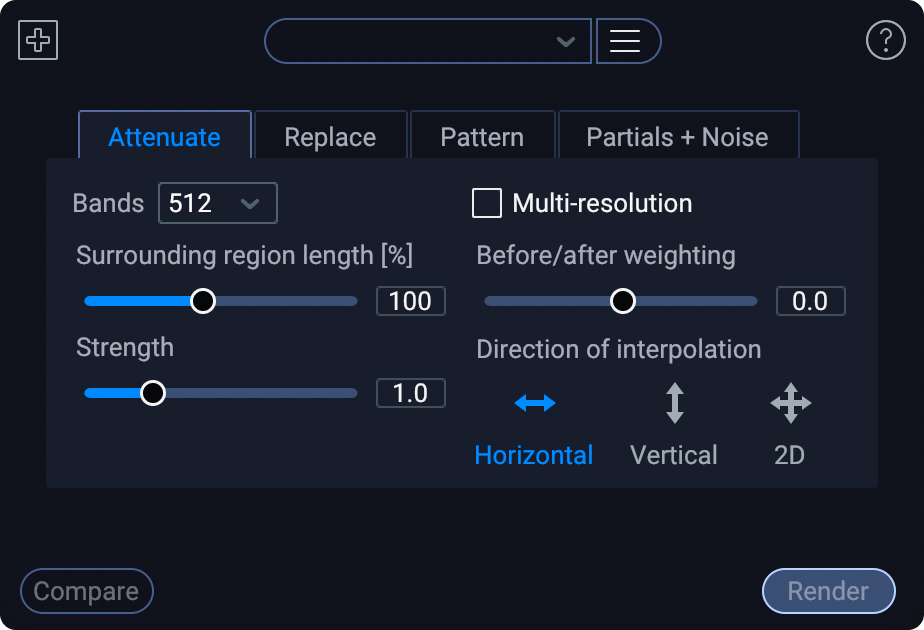
Рис. 6. Spectral Repair в RX. Настройки окружающей области и баланса before/after прямо показывают, что алгоритм использует контекст вокруг выделения. Источник: iZotope, Spectral Repair.
В том же RX есть Voice De-noise с нулевой добавочной задержкой, рассчитанный на потоковую работу с речью и вокалом. Его можно поставить на дорожку и очищать звук по мере поступления. Spectral Repair восстанавливает выбранный фрагмент по уже записанному окружению.
У Ozone задача ещё другая: обработать готовый микс. В его EQ Analog использует минимально-фазовые IIR-фильтры, а Digital предоставляет FIR-фильтры и управление фазовой характеристикой. Выбор режима меняет вычислительную работу и поведение тракта. При мастеринге можно принять дополнительную задержку, если она помогает получить нужную обработку; при мониторинге голоса музыкант почувствует её сразу.
В Maximizer для уменьшения задержки предусмотрен отдельный IRC Low Latency. В документации для него указаны наименьшая задержка и нагрузка на CPU среди режимов IRC. Здесь тоже выбирают конкретный режим под задачу, а не приписывают всему продукту одну постоянную задержку.
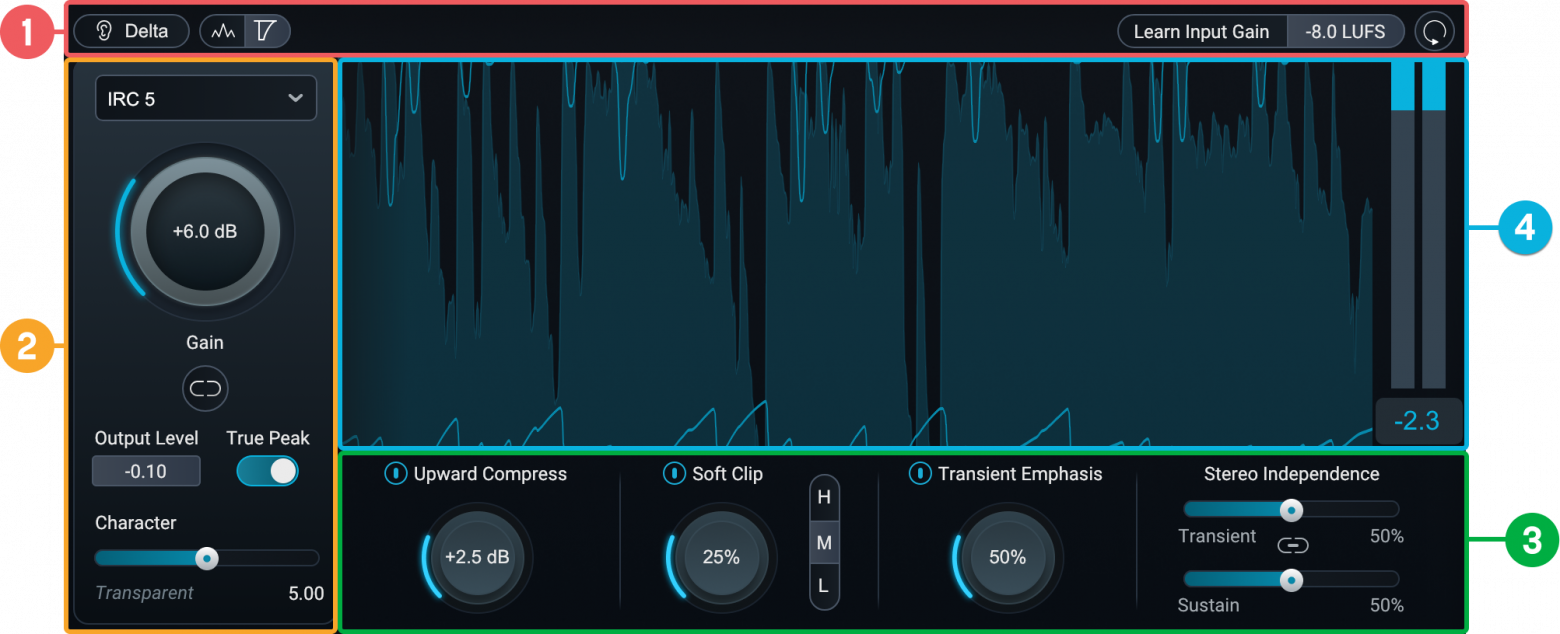
Рис. 7. Maximizer в Ozone 12. Здесь контролируют усиление, выходной предел и пики всей фонограммы. Обратите внимание на True Peak и выбор алгоритма IRC: требования к такому узлу отличаются от простой ручки громкости. Источник: iZotope, Maximizer.
Один сэмпл, который не виден при 48 кГц
После сравнения режимов я проверил установленный Nectar 4.0.1 Compressor через Audio Unit API. Подал одиночный импульс с амплитудой 0,25 на позиции 2048. Рендер был офлайн: два канала, 8192 сэмпла, блок 512. Настройки: Digital, Ratio 1:1, Threshold 0 dB, Auto Gain выключен, входное и выходное усиление 0 dB. При Mix = 0 выход должен показать, что происходит с исходной веткой.
При 48 кГц импульс вышел на позиции 2095, то есть на 47 сэмплов позже. Нулевой Mix сохранил задержку плагина. Это позволяет смешивать исходный сигнал, dry, с обработанным, wet, без разницы во времени.
Дальше возникает соблазн сохранить «47 сэмплов при 48 кГц» и для другой частоты пересчитать пропорцией: round(fs * 47 / 48000). На части частот это сработает. Вот что получилось в измерениях:
Частота | Измеренная задержка, сэмплы | Пересчёт от 47 сэмплов |
|---|---|---|
44,1 кГц | 43 | 43 |
48 кГц | 47 | 47 |
88,2 кГц | 87 | 86 |
96 кГц | 95 | 94 |
192 кГц | 191 | 188 |
Со всеми девятью проверенными частотами, от 22,05 до 192 кГц, совпало другое правило: floor(fs / 1000) - 1. Оно соответствует примерно одной миллисекунде с поправкой на целое число сэмплов. В C++ расчёт можно выразить так:
// fs положительная и конечная; вызывается при подготовке.
int compressorDelaySamples(double fs) noexcept {
    return std::max(0, int(std::floor(fs / 1000.0)) - 1);
}
Обе формулы дают правильный ответ при 48 кГц. Проверка только на этой частоте не помогла бы их различить. На 96 кГц разница уже один сэмпл. Для выравнивания параллельных веток это разные позиции сигнала.
При 48 кГц я также проверил Mix = 25, 50 и 100%. Во всех случаях пик остался на позиции 2095. Максимальное отличие выхода от просто задержанного импульса составило около 1,49 × 10⁻⁸. Это ожидаемо для данной настройки без компрессии; измерение показывает временное выравнивание, а не качество звучания компрессора.
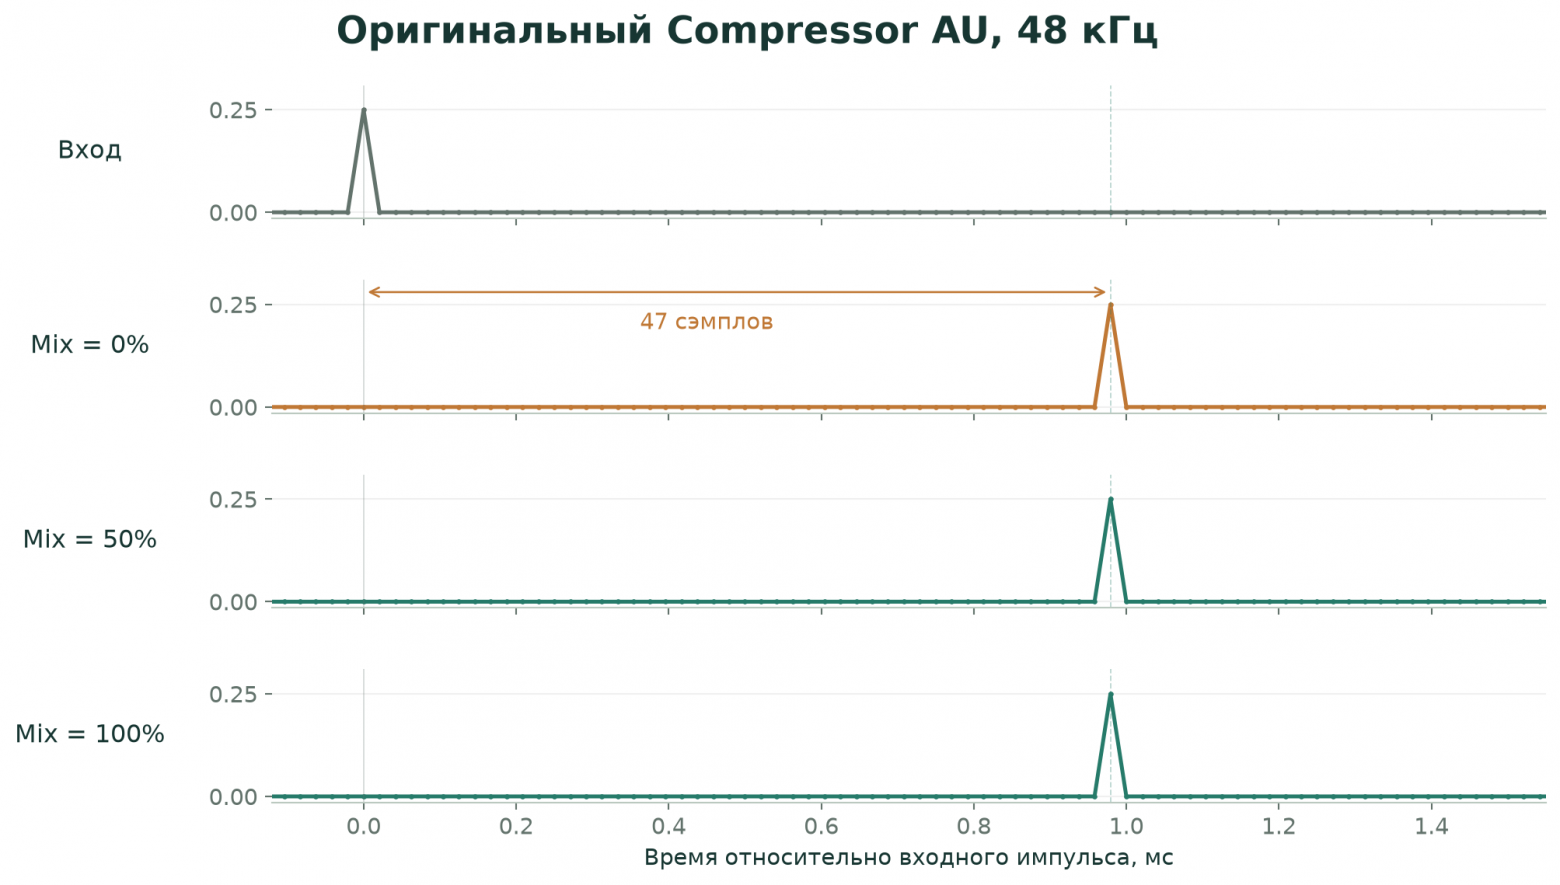
Рис. 8. Собственный офлайн-замер Nectar Compressor AU, 48 кГц. Во всех трёх выходных трассах импульс находится на 47 сэмплов позже входа, около 0,98 мс. Mix = 0 тоже сохраняет эту задержку. Параметры проверки указаны выше.
Если wet-ветка задержана на D сэмплов, dry перед смешиванием тоже нужно задержать на D. Иначе появится гребенчатая фильтрация: одни частоты усилятся, другие ослабнут из-за сложения сдвинутых копий. Такая ошибка слышна как изменение тембра при повороте Mix.
Ниже простая линия задержки. Память выделяется в prepare, во время обработки массив не растёт:
#include <cstddef>
#include <vector>

struct DryDelay {
    std::vector<float> ring;
    std::size_t pos = 0;

    void prepare(std::size_t delaySamples) {
        ring.assign(delaySamples, 0.0f);
        pos = 0;
    }

    float tick(float x) noexcept {
        if (ring.empty()) return x;
        const float delayed = ring[pos];
        ring[pos] = x;
        if (++pos == ring.size()) pos = 0;
        return delayed;
    }
};
После выравнивания можно вычислить dryAligned + mix * (wet - dryAligned). Даже при нулевом Mix линия должна продолжать обновляться. Иначе включение обработки вернёт старые данные из буфера. Резкую смену самого Mix тоже нужно сгладить.
Хосту сообщают добавочную задержку, чтобы он мог согласовать дорожки при воспроизведении. Такая компенсация сохраняет синхронность проекта, но не убирает ожидание при живом мониторинге.
Два способа встроить машинное обучение
Кнопки Assistant есть у нескольких продуктов iZotope. Они помогают получить начальную настройку: в Nectar для вокальной цепочки, в Neutron для дорожки, в Ozone для мастеринга, в RX для реставрации. После анализа пользователь может перейти к подробным регуляторам и изменить предложенный результат.
Для архитектуры полезно различать подбор настроек и преобразование самого сигнала. В первом случае результат анализа становится параметрами обычных эффектов. Во втором выход модели участвует в получении нового звука на протяжении обработки.
Vocal Assistant оценивает уровень, характеристики вокала, регистр, резонансы и свистящие звуки. Затем настраивает EQ, компрессию, деэссер и другие части цепочки. Анализ отделён от последующей работы эффектов: громкостью продолжает управлять обработчик динамики, частотной характеристикой EQ. Поворот Intensity меняет настройки компрессора, как видно в таблице привязок выше.
В файле классификатора Vocal Assistant из Nectar находятся две свёрточные группы весов и полносвязные слои. Вместе с нормировочными массивами это около 5,3 млн числовых значений. Они нужны для этапа анализа, после которого настройки становятся обычными параметрами цепочки. Плагин показывает их в подробном режиме, и пользователь может продолжить настройку вручную.
В RX машинное обучение используется и в самом тракте реставрации. Music Rebalance разделяет фонограмму на вокал, бас, ударные и остальные инструменты. Модели анализируют спектрограмму: карту изменения частотного состава звука во времени. Они оценивают маски источников. Маска задаёт, какую долю каждого участка спектра оставить в выделяемом голосе или инструменте. Это ближе по месту в тракте к Backer, чем к регулятору Intensity: модель участвует в изменении аудио. При этом RX также содержит обычные детекторы щелчков, интерполяцию и спектральные обработчики. Под одной панелью могут работать несколько разных методов.
У Backer другая задача: превратить входной вокал в голос выбранного профиля. Доступны восемь профилей, обученных на разных голосах, и загрузка своего референса. Декодер получает отдельно фонетические признаки, высоту и громкость. Особенности целевого голоса задаются выбранным декодером или дополнительным вектором из референса.
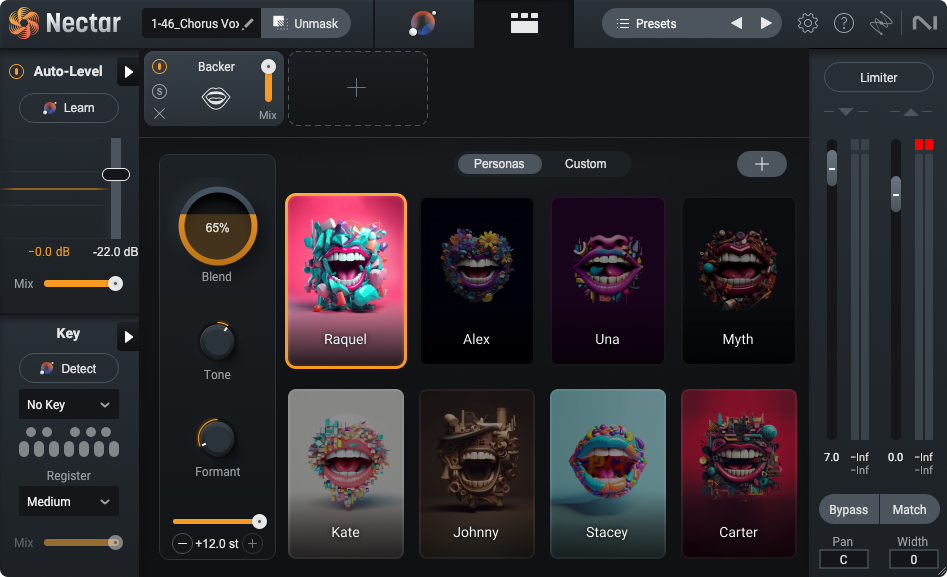
Рис. 9. Backer: профили в центре, регуляторы Blend, Tone, Formant и Pitch слева от них. Выбор регистров исходного и целевого голоса может добавить сдвиг на октаву. Источник: iZotope, Backer.
Внутри тракт можно проследить по ходу сигнала. Сначала короткий участок звука раскладывается по частотам. Из 80 mel-полос, распределённых с учётом особенностей слуха, получаются 40 кепстральных коэффициентов: компактное описание формы спектра. Кодер переводит их в фонетические признаки. Декодер выбранного голоса получает эти признаки вместе с высотой и громкостью и возвращает 80 mel-значений уже для нового тембра.
Embedding-модель работает с референсом. Её 256 чисел описывают особенности голоса-образца. У готовых профилей свои декодеры; у референсного декодера есть дополнительный вход для такого вектора. Поэтому количество файлов моделей не равно числу сетей, которые надо запускать на каждом кадре.
На выходе модели ещё нет массива звуковых сэмплов. В изученном тракте вокруг неё работают спектральные преобразования, оконная обработка и синтез с перекрытием фрагментов. Преобразование Фурье (FFT) и кольцевые буферы остаются нужны даже после обучения сети.
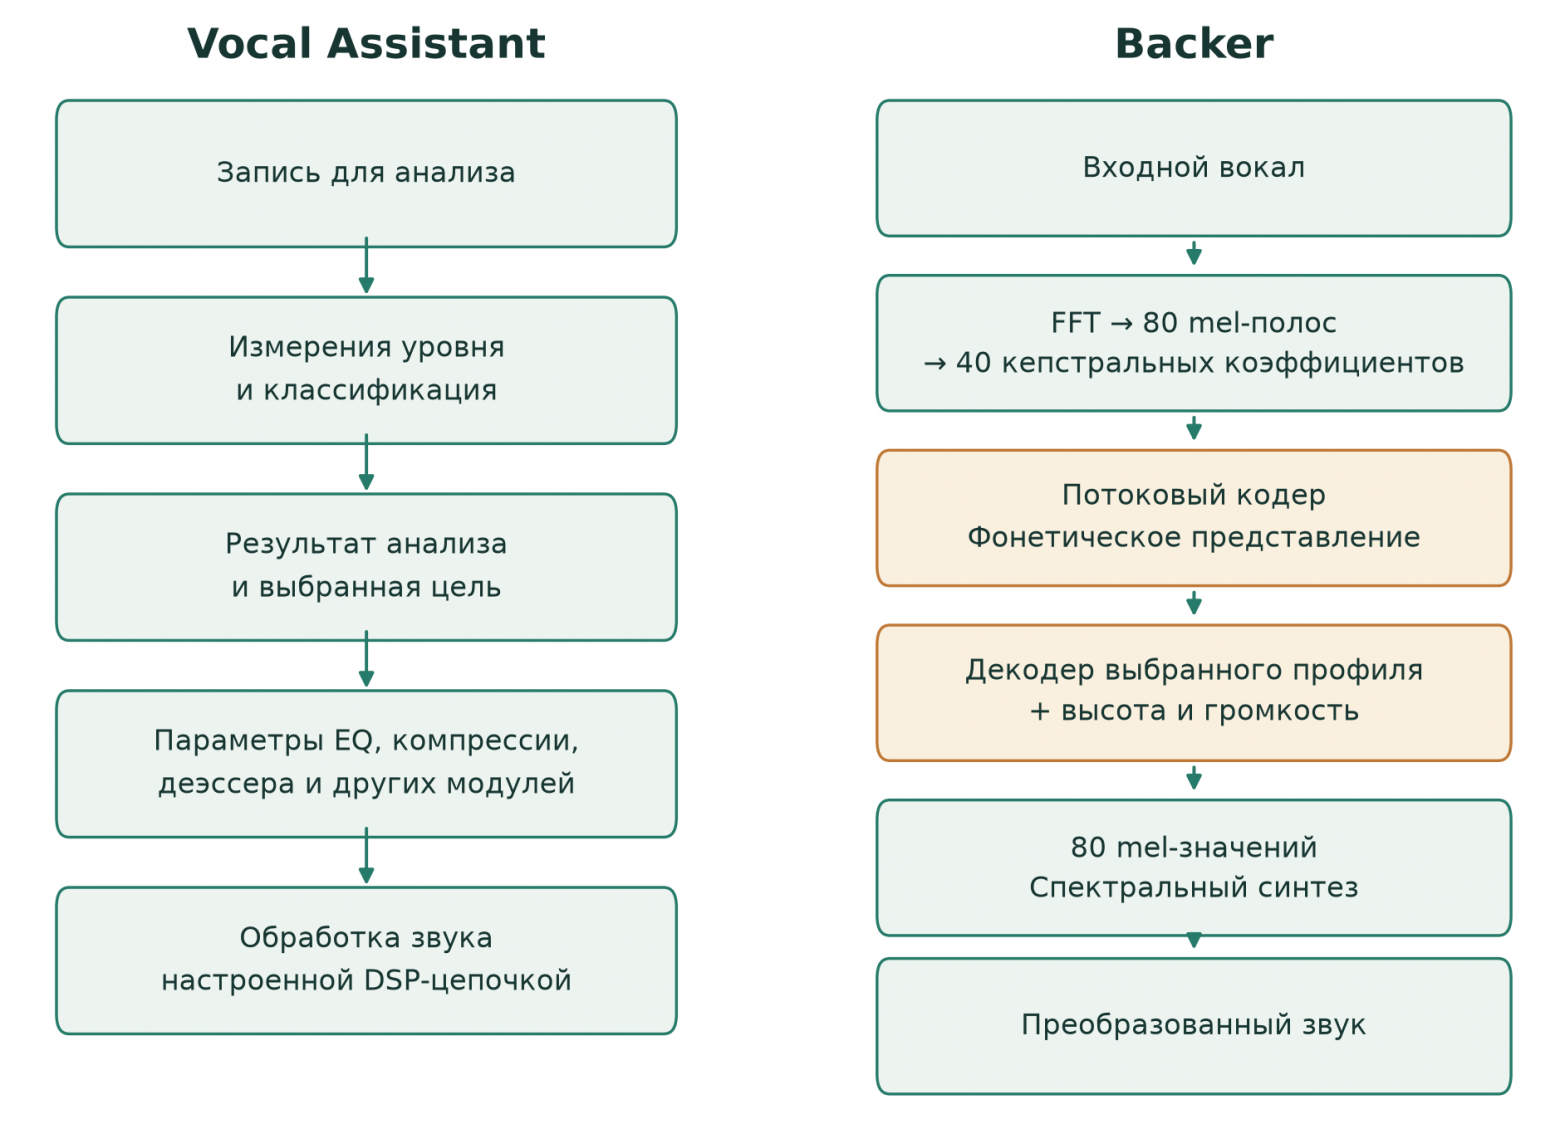
Рис. 10. Два места для ML в аудиопродукте. Assistant передаёт результат анализа в настройки. Backer возвращает представление нового звука, из которого ещё нужно восстановить волну. Некоторые стадии и служебные связи опущены.
В ML-части Backer есть 11 TFLite-файлов:
Часть | Что получает и возвращает | Задача |
|---|---|---|
Кодер | Кадр из 40 кепстральных коэффициентов и предыдущее состояние; на выходе 61 активация и новое состояние | Представление фонетического содержимого |
Embedding-модель | Окно из 160 кадров по 40 коэффициентов; на выходе вектор из 256 значений | Представление референсного голоса |
Восемь персональных декодеров | Фонетические признаки, информация о высоте и громкости, состояние; на выходе 80 mel-значений | Выбранный голосовой профиль |
Референсный декодер | Те же виды признаков и дополнительный embedding | Преобразование с пользовательским референсом |
Что делать с «с» и «ш», у которых нет ноты
На гласной высоту можно описать числом в герцах. На шумном согласном единой устойчивой высоты может не быть. Декодеру нужно передать и значение частоты, и признак наличия периодической голосовой составляющей, voiced.
В frontend Backer этот признак сравнивается с порогом 0,5. Для voiced-участка частота переходит в логарифмическую шкалу. Для unvoiced-участка передаётся конечное нижнее значение и отдельный нулевой флаг. Сокращённая реализация этой развилки:
struct PitchFeatures {
    float logF0;
    float voiced;
};

// f0Hz конечная и неотрицательная: это результат анализа.
PitchFeatures encodePitch(float f0Hz, float strength) noexcept {
    if (strength > 0.5f)
        return {std::log(f0Hz + 1e-6f), 1.0f};
    return {-13.815510749816895f, 0.0f}; // ln(1e-6)
}
Ровно 0,5 относится к unvoiced-ветке. При нулевой частоте в ней получается конечное число, а не log(0). Подъём частоты voiced-участка с 220 до 440 Гц сдвигает первый признак примерно на 0,6931, то есть на ln(2). Я отдельно проверил нулевую частоту, значение на пороге и подъём на октаву.
Нейросеть тоже помнит прошлый звук
У потокового кодера Backer есть четыре входных вектора состояния по 256 значений: h0, c0, h1, c1. Выход текущего кадра становится состоянием следующего. Только эти четыре массива занимают 4 × 256 × 4 = 4096 байт; веса и остальные буферы сюда не входят.
В обвязке нужно связать соседние кадры: передать модели прошлое состояние и сохранить новое после успешного расчёта. В учебном примере invoke обозначает вызов заранее подготовленной модели:
#include <array>

using Cepstrum = std::array<float, 40>;
using Phonemes = std::array<float, 61>;

struct EncoderState {
    std::array<float, 256> h0{}, c0{}, h1{}, c1{};
};

struct EncoderFrameResult {
    Phonemes phonemes{};
    EncoderState next{};
};

// invoke читает frame и state, заполняет result, возвращает успех.
template<class Invoke>
bool processEncoderFrame(const Cepstrum& frame, EncoderState& state,
                         Phonemes& output, Invoke&& invoke) noexcept {
    EncoderFrameResult result{};
    if (!invoke(frame, state, result))
        return false;
    state = result.next;
    output = result.phonemes;
    return true;
}
EncoderState принадлежит одному экземпляру обработчика. Первый кадр получает нулевое состояние, второй получает результат первого, третий результат второго. Обнуление на каждом аудиоблоке разорвёт эту последовательность. Общее состояние на две дорожки свяжет их обработку между собой.
Если расчёт завершился ошибкой, функция возвращает false и оставляет прошлое состояние и выход без изменений. Вызывающий код должен отдельно решить, что отдать в аудиовыход при такой ошибке. Незавершённый результат не заменяет последний корректный.
Модели и интерпретаторы подготавливают до обработки. Затем проверяют поведение конкретного графа: внутренние выделения памяти, число потоков, первый вызов, смену конфигурации. Отсутствия new в собственной функции ещё недостаточно, чтобы весь вызов ML был пригоден для короткого аудиоколбэка.
Зачем эквалайзеру система уравнений
Узкая подавляющая полоса EQ, notch, должна убрать определённый участок спектра и сохранить соседние частоты. В её расчётном узле Nectar целевая характеристика задана в 129 частотных точках. В разобранной конфигурации под неё подбирается каскад из четырёх фильтров второго порядка. На этапе подбора возникает система размером 17 × 17: сложная часть находится в поиске коэффициентов. После этого звук проходит через готовые секции, каждая из которых устроена подобно Biquad выше.
Такой расчёт объясняет, почему за ручкой частоты бывает больше кода, чем в самом цикле обработки звука. Ещё нужно корректно перейти от старых коэффициентов к новым: фильтр хранит историю предыдущих сэмплов. Именно работе с изменяющимися фильтрами посвящены открытые код и данные iZotope к статье Time-Varying Filters for Musical Applications.
Где проходит работа над краевыми случаями
В Saturation один из вариантов мягкого ограничения можно записать через x / (1 + abs(x)). В соответствующей ветке вычисление организовано через модуль, обратную величину и восстановление знака. Два выражения математически эквивалентны:
float softClipA(float x) noexcept {
    return x / (1.0f + std::abs(x));
}

float softClipB(float x) noexcept {
    const float magnitude = std::abs(x);
    const float y = 1.0f - 1.0f / (1.0f + magnitude);
    return std::copysign(y, x);
}
Я собрал обе функции с выключенным fast-math и подал x = 10⁻⁸. Первая вернула примерно 10⁻⁸, вторая ноль: сумма 1 + magnitude округлилась до единицы, а вычитание убрало остаток. Это не демонстрация слышимого дефекта. Зато при сравнении двух реализаций даже такая короткая формула требует сохранять порядок операций.
Более длинные цепочки добавляют другие условия. Коэффициенты могут рассчитываться в double, затем переходить в float; размер окна или задержки округляется к целому числу сэмплов. Один и тот же параметр при 44,1 и 48 кГц может задавать разное целое число сэмплов.
Характер ручки тоже задаётся расчётом. В рассмотренных режимах Saturation усиление для дробного Amount интерполируется в логарифмической шкале. Середина между множителями 1 и 4 тогда равна 2; линейная интерполяция дала бы 2,5. При одинаковом положении ручки получатся разные усиления. Выбранный закон должен одинаково действовать при ручном управлении, автоматизации и загрузке пресета.
Поэтому проверка плагина не заканчивается синусом при настройках по умолчанию. У неё как минимум несколько независимых направлений:
Ситуация | Что может сломаться | Что проверять |
|---|---|---|
Меняется размер блока | Теряется история, неверно продвигается кольцевой буфер | Один сигнал с разным разбиением на блоки |
Меняется частота дискретизации | Уезжают время атаки, задержка или частота фильтра | Временные и частотные характеристики в нужных единицах |
Mix или Bypass меняется во время звука | Разрыв волны, несовпадение dry и wet | Переход и временное выравнивание обеих веток |
Загружается пресет или новый профиль | Сохраняется чужое состояние, первая порция данных некорректна | Сброс, подготовка и первый обработанный блок |
Открываются несколько окон | Путаются экземпляры, фокус и подписки | Независимость дорожек и жизненный цикл UI |
Четыре частоты, четыре размера блока и две конфигурации каналов дают 32 сочетания ещё до перебора настроек. В проверке Compressor различие двух формул обнаружилось только после смены частоты. У нейросетевого кодера своя проверка: следующий кадр должен получить состояние предыдущего, а ошибка расчёта не должна его испортить.
Что можно взять из открытых проектов
Чтобы сделать свой плагин, не обязательно начинать с разработки аналога Glass. У JUCE есть AudioProcessorValueTreeState: состояние параметров, связи с UI и доступ к текущим числам для аудиопотока. При этом документация отдельно предупреждает, что copyState() и replaceState() используют блокировки. Потокобезопасность этих функций не делает их подходящими для аудиоколбэка.
Для плавных переходов есть SmoothedValue, с линейным и мультипликативным вариантами. Последний подходит для отношений частот и усилений, но не доходит до нуля. Даже готовому классу нужно правильно выбрать единицы и способ применения.
Задача | Что видно в Nectar | Что доступно разработчику |
|---|---|---|
Связать ручку, автоматизацию и пресет | Система параметров; общие регуляторы Assistant управляют несколькими модулями | JUCE AudioProcessorValueTreeState и привязки к контролам |
Менять значение без скачка | Сглаживание в DSP; несколько обработчиков получают новые цели | JUCE SmoothedValue или собственный сглаживающий фильтр |
Сохранить dry/wet на одной позиции | В замере Compressor при разных Mix пик остаётся на одном сэмпле | Линия задержки и сообщение задержки хосту |
У открытого CHOW Tape Model есть показательная деталь. При небольшой доле wet его компенсация выбирает целочисленную задержку dry, чтобы интерполяция дробной задержки не меняла частотную характеристику почти исходного сигнала. Согласование двух веток требует внимания и в открытом плагине.
Общая библиотека интерфейса, параметры, загрузчики и вычислительные узлы позволяют развивать несколько продуктов. Затем задача определяет их сборку: вокальная цепочка Nectar, многополосная обработка Neutron, мастеринг Ozone или реставрация RX.