Обновить
128K+

Алгоритмы *

Все об алгоритмах

187,1
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как набор грязных хаков добавил мультиплеер в легендарную игру: разбираем архитектуру SAMP

Время на прочтение20 мин
Охват и читатели6.5K

Осторожно: эта статья — не просто очередная ретроспектива с воспоминаниями, а конкретный разбор сетевой архитектуры и хаков, благодаря которым стал возможен мультиплеер в GTA аж на 1.000 человек одновременно. Если вам интересен геймдев и то, как работают игры под капотом — статья обязательна к прочтению!

GTA: San Andreas запомнилась нам как легендарная игра с немыслимым, по меркам 2004 года, масштабом. В ней был и огромный бесшовный мир, состоящий из трех городов, и массивный автопарк аж из 213 транспортных средств, и длинная интересная история с кучей сайд‑активностей, прохождение которых занимает как минимум несколько дней, и даже элементы RPG с базовой прокачкой персонажа.

И вот всё в ней было идеально, кроме одного — мультиплеера. Rockstar не успела доделать полноценный режим сетевой игры, оставив лишь подачку в виде локального кооперативного режима на PS2, в котором даже миссии проходить было нельзя. Однако группа моддеров под руководством Kalcor смогла воплотить то, что не удалось сделать Rockstar — реализовать мультиплеер в GTA SA аж на 1.000 человек одновременно. И о том, как им удалось это сделать, я расскажу в рамках сегодняшней статьи!

Читать далее

Новости

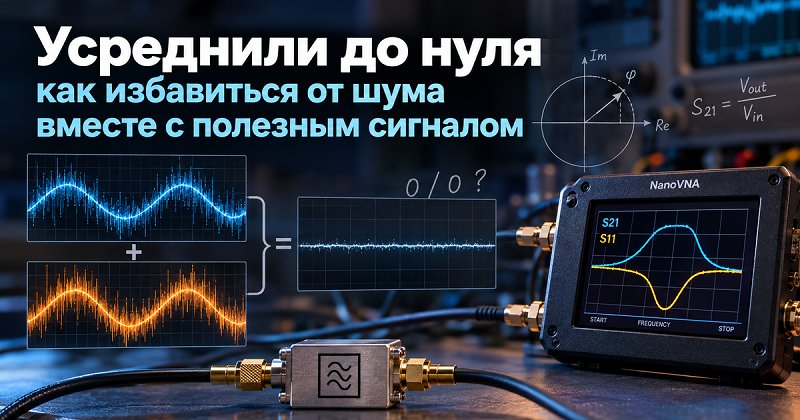
Усреднили до нуля, или как избавиться от шума вместе с полезным сигналом

Время на прочтение18 мин
Охват и читатели8K

Обычно несколько измерений усредняют, чтобы уменьшить влияние шума. Но если складывать сигналы без учета их фазы, можно погасить и сам полезный сигнал.

При работе над прошивкой NanoVNA на Rust мне понадобилось разобраться, как продолжать измерение после паузы (ради обслуживания экрана и USB).

Расскажу, почему прежний способ накопления подходил для непрерывного захвата и что пришлось изменить в новой прошивке.

Читать далее

Внутри диаграммы Ганта: холст 480 на 360, палитра на 30 цветов и число без последнего бита

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели8.6K

Я собираю файл конфигурации из XML так, чтобы он совпал с платформенным с точностью до бита. Диаграммы Ганта в типовых конфигурациях пустые, и на них ушло шесть дней. Внутри нашлись обычная диаграмма, воображаемый холст 480 на 360, число, у которого платформа теряет последний бит, и палитра, где серия номер -1 получает 15-й цвет. Рассказываю, как это устроено и как добывалось: дизассемблер, Frida и серия загрузок платформой.

Читать далее

Заменяем базу данных SQLite на 3 ГБ конечным автоматом‑преобразователем на 10 МБ

Время на прочтение7 мин
Охват и читатели12K

Примечание для любителей чисел: все значения в статье округлены до первого значимого разряда, потому что я фанат метода «zequals» Роба Истэуэя, который позволяет сразу переходить к сути при выполнении оценочных расчётов. Гораздо полезнее запомнить такую эвристику: «Один парень сократил потребление памяти в 300 раз, заменив самодельную базу данных на крошечную статическую специализированную структуру данных, которая делает именно то, что ему нужно, и ничего лишнего».

В одни выходные мне представилась невероятно редкая возможность поработать с Taskusanakirja, часто называемым tsk — финско‑английским словарём с инкрементальным поиском в процессе набора1. Принципиально эта задача сводится к префиксному поиску, а каноническое решение префиксного поиска с автозавершением — это реализация префиксного дерева.

Она замечательно работала в первой реализации tsk, написанной на Go (о которой я уже много раз рассказывал). В ней используется несколько базовых оптимизаций. Чтобы не выполнять поиск по нескольким процентам от общего числа слов (а их было несколько сотен тысяч), которые мы встраивали непосредственно в исполняемый файл (с самого начала одной из целей проектирования было поставлять всю программу в виде одного файла .exe, одного файла .app или одного статически скомпонованного исполняемого файла), мы установили ограничение: например, возвращать только первые 50 или 100 совпадений. Кроме того, мы просто заранее кэшировали все комбинации из 1, 2 и 3 символов. После этого за целый год интенсивного личного использования я больше ни разу не замечал сколько-нибудь ощутимых задержек в работе программы. При помощи подобных простых оптимизаций мы смогли сжать префиксное дерево примерно в 60 МБ.

Однако финский язык отличается чрезвычайно развитой агглютинацией. Одно-единственное исходное слово может иметь более сотни возможных окончаний, если учитывать все их комбинации. Причём эти комбинации не образуются по какому-то простому регулярному правилу!2 Кроме того, чрезвычайно последовательная орфография финского языка означает, что написание слов точно отражает то, как носители языка действительно их произносят. Поэтому по мере добавления окончаний исходные слова причудливым образом удлиняются, изменяются и трансформируются, приобретая благозвучные формы. Всё это кажется совершенно естественным, если ты уже пару лет погружён в изучение языка. Но новичок, увидев предложение вроде «Opiskelijassammekin on leijonan sydän», с большой вероятностью споткнётся об одно конкретное слово. Одна из задач этой программы — помочь изучающему понять, где именно нужно правильно разделить слово на составляющие, и для этого она тоже включает в себя всю необходимую информацию.

Здесь префиксное дерево даёт сбой...

Читать далее

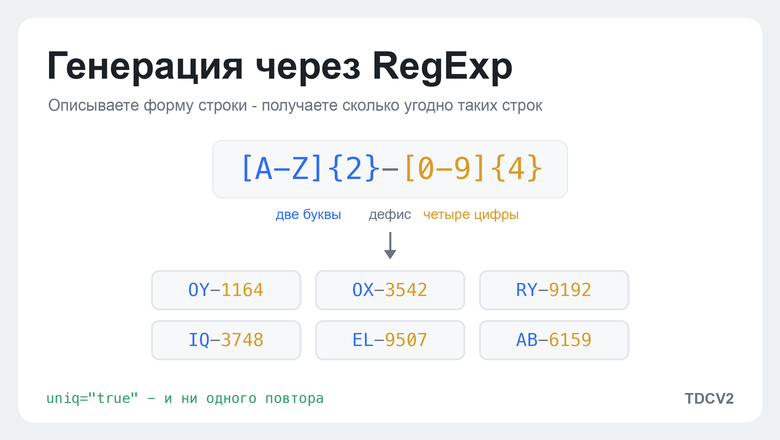
Данные без противоречий: генерация через RegExp

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели4.4K

Идея не новая. Генерировать строки по регулярке умеют randexp в JavaScript, Xeger в Java, exrex и Hypothesis в Python. В TDCV2 я добавил это тоже, и первая половина статьи будет знакома тем, кто ими пользовался. Своё начинается дальше: уникальность, которая заранее знает, хватит ли места; точные доли прямо внутри выражения; условие, при котором одна часть строки следует из другой. Последние две вещи живут в расширенном генераторе advanced_regex, и в таком виде я их больше нигде не встречал.

И про слова. RegExp здесь - это синтаксис регулярных выражений, который TDCV2 использует как язык описания строки: конечное подмножество привычного синтаксиса плюс несколько своих конструкций. В конфиге генераторы называются regex и advanced_regex.

Читать далее

Реверс-инжиниринг алгоритма тангенса в процессоре Intel 8087

Время на прочтение27 мин
Охват и читатели9.2K

Это ещё одна моя статья о чипе арифметики с плавающей запятой Intel 80871. В 1980 году компания Intel представила процессор 8087, который сильно повысил скорость выполнения операций с плавающей запятой в IBM PC и других системах. В этой статье мы рассмотрим алгоритм, лежащий в основе команды вычисления тангенса. Один из распространённых подходов к реализации тригонометрических функций — это алгоритм CORDIC. Второй — это аппроксимация при помощи многочленов. Для обеспечения высокой точности и высокой производительности 8087 сочетал в себе оба этих подхода, создав огромный прирост скорости по сравнению с микропроцессором 8086: тангенс в нём вычислялся всего за 90 микросекунд вместо 13 тысяч микросекунд2.

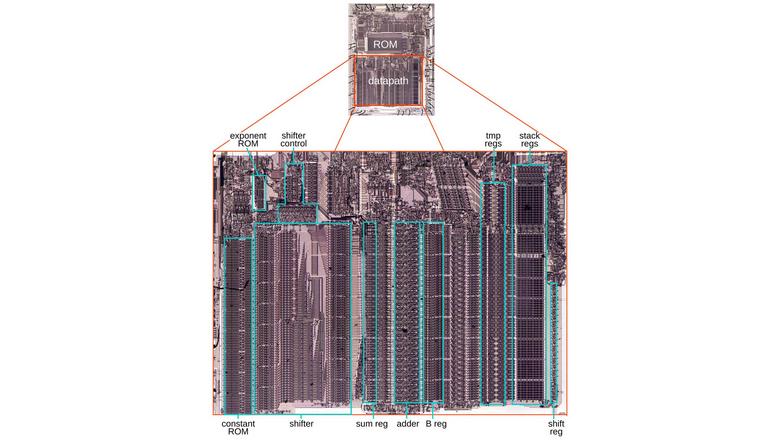
Изучив цепи и микрокод 8087, я смог объяснить алгоритм команды вычисления тангенса FPTAN. Для исследования электросхемы 8087 я при помощи стамески снял с чипа крышку и сделал микроскопом снимок высокого разрешения. ROM микрокода — это большая прямоугольная область в центре кристалла, содержащая 1 648 управляющих чипом микрокоманд. Нижняя часть чипа (в красном прямоугольнике) — это тракт данных: цепь, выполняющая вычисления с плавающей запятой над 80-битными значениями3.

На увеличенном снимке тракта данных видны соответствующие функциональные блоки. В exponent ROM хранятся значения экспонент, необходимые алгоритму. В constant ROM содержатся константы, в том числе и используемые алгоритмом CORDIC. Shifter (блок сдвига) — это большой компонент, выполняющий сдвиг 64-битного значения влево или вправо на произвольную величину. Adder (сумматор) — это ядро вычислений 8087; наряду с реализацией сложения и вычитания он применяется в цикле для умножения, деления и квадратных корней. В регистре B (B reg) хранится один из аргументов сумматора, а второй аргумент может браться из нескольких источников. В sum register хранится вывод сумматора. В восьми стековых регистрах и временных регистрах хранятся числа с плавающей запятой. Наконец, в сдвиговом регистре (shift reg) хранятся 16 бит состояния для вычислений CORDIC.

Читать далее

Полоски, квадратики и точки. Как работают штрихкод, QR и Data Matrix

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели7.7K

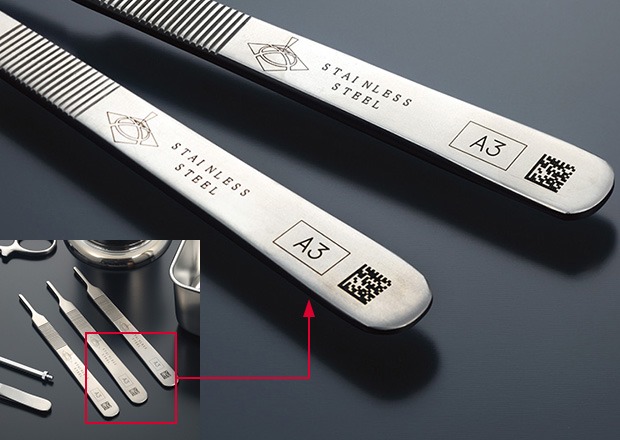
Несколько десятков черных полос когда-то изменили мировую торговлю: кассиру больше не нужно было вручную вводить цену каждого товара, а магазины впервые получили возможность автоматически учитывать огромные потоки продукции. Потом полоски превратились в квадраты, информации стало помещаться значительно больше, а поврежденный код научился восстанавливаться буквально по оставшимся кускам. К торговле добавилась логистика, медицина, реклама и еще сотня разных отраслей. Разберемся, как устроены линейные штрихкоды, QR и Data Matrix, чем они отличаются и какие задачи решают.

И почему на молоке именно Data Matrix? Все ответы ниже.

Читать далее

Как алгоритмы строят рекламные кампании: правила и геопривязка в медиапланировании

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели5.1K

Привет, Хабр! С вами команда Russtech — разработчики IT-решений ведущего российского оператора рекламы вне дома Russ (входит в RWB).

В этой статье мы детально разберем процесс автоматизации подбора рекламных поверхностей — и объясним, какую пользу это дает. Вы узнаете о различных алгоритмах формирования рекламных кампаний, особенностях составления адресной программы с учетом локации, а также о том, как выбор метода расчета расстояния между объектом рекламодателя и рекламной конструкцией зависит от конкретного сценария медиапланирования. Для удобства объекты рекламодателя будем называть объекты POI (Points Of Interest, т. е. «точки интереса»). К ним будут относиться магазины, офисы продаж, пункты выдачи заказов, сервисные центры и другие локации, куда рекламодатель планирует привести свою целевую аудиторию.

Читать далее

Тормозит? Полярный шаг в сторону сверхбыстрых линейных вычислений и антивирусов

Уровень сложностиСложный
Время на прочтение9 мин
Охват и читатели5.1K

Современная ИТ‑индустрия уперлась в итерационный тупик. Мы сжигаем гигаватты энергии на серверных фермах, забиваем ядра процессоров тяжелыми legacy‑алгоритмами сложности O(N²) и бесконечно плодим прослойки абстрактного софта. Как результат — интерфейсы и игры умудряются тормозить даже на мощном флагманском железе. Но что, если поток данных — это не просто мертвый набор байт, а физическое поле векторов давления среды?

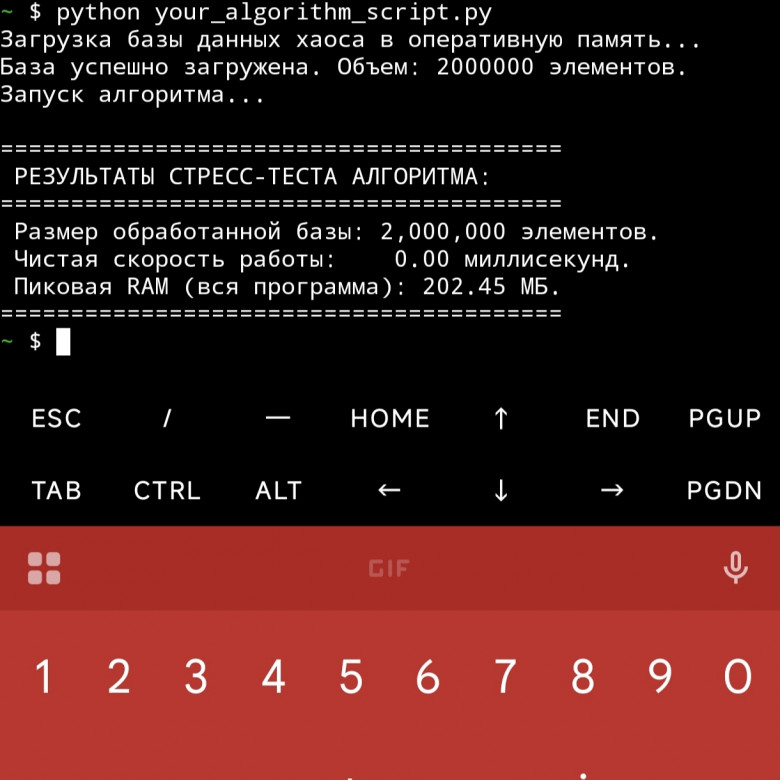
В этой статье представлен полный разбор неделимого 4-элементного вычислительного конвейера, работающего по принципу децентрализованного сжатия хаоса на базе фрактальной формулы 2N+1. Весь контур — от считывания контекста до финального действия — спроектирован, оптимизирован и протестирован в консоли Termux на обычном Android‑смартфоне, доказывая: для реализации автономных сверхбыстрых систем безопасности и обработки медиапотоков больше не нужны датацентры.

Читать далее

Когда Python становится слишком медленным: пишем C‑расширение с нуля и сравниваем с pybind11 (бонус JIT‑компилятор)

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели5.7K

Недавно я прочел статью про pyrusmorph — python обёртку над 30-летним с++ ядром libmorph/rus. Бенчмарки удивили: в 30 раз быстрее PyMorphy3 при обработке текста. После я задумался. Как это вообще работает? Почему мы пишем import pyrusmorph и получаем доступ к нативному с++ коду и функциям прямо внутри python.

В статье я предлагаю пройти этот путь с нуля. Разобраться, как устроен Python «под капотом», написать своё расширение на чистом C‑API, а потом посмотреть, как эту боль лечит pybind11. В конце — бенчмарки и практические советы, когда вообще стоит лезть в c++ для оптимизации. Бонус — немного о компиляторе python кода (JIT‑компилятор)

Читать далее

Бинауральный звук с фронтальной АС

Уровень сложностиСложный
Время на прочтение1 мин
Охват и читатели4.5K

Принято считать, что воспроизведение бинаурального звука через фронтальные колонки требует сложных алгоритмов взаимного подавления каналов (Crosstalk Cancellation). В этой заметке я хочу уйти от привычных догм «равностороннего треугольника» в 60° и предложить альтернативный дифференциальный метод. Вместо математического подавления сигналов мы можем рассмотреть физику волнового фронта относительно природной 180-градусной базы слуха человека и просто компенсировать возникающее фронтальное маскирование.

Читать далее

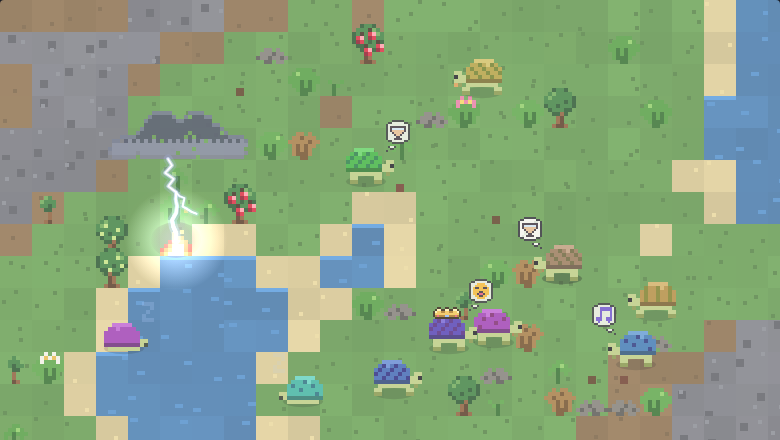
Спрайтшит на 0 байт: процедурный пиксель-арт

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели4K

Этот проект начинался как песочница для социальных экспериментов: персонажи взаимодействуют и принимают решения, играя в дилемму заключённого, имеют память, наследуемые черты характера, ограниченные ресурсы для выживания и прочие проблемы, которые мешают счастливо существовать. Графика должна была успевать за всем этим разнообразием, а художника в проекте нет. Тут я решил поделиться как решал эту проблему: все объекты и анимация сделаны кодом прямо в браузере, на обычном 2D canvas. Заходите под кат - расскажу, как это устроено, и покажу код.

Читать далее

Под капотом iZotope: что общего у Nectar, Neutron, Ozone и RX

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели5.9K

У iZotope есть плагины для вокала, сведения, мастеринга и реставрации записи. Снаружи они выглядят как отдельные продукты. Внутри обнаруживаются общие вычислительные узлы, интерфейсные механизмы и способы передачи параметров.

Я разобрал, как устроено это семейство: что связывает компрессоры Nectar и Neutron, зачем iZotope собственный интерфейсный движок Glass и где в обработке участвуют ML-модели. Отдельно проверил задержку компрессора Nectar: при 48 кГц сигнал сдвигается на 47 сэмплов даже при Mix 0%.

В статье покажу схемы, примеры C++ и результаты измерений. Заодно сравню эти решения с открытыми проектами и разберу, сколько работы скрывается за привычными ручками Attack, Release и Mix.

Читать далее

Ближайшие события

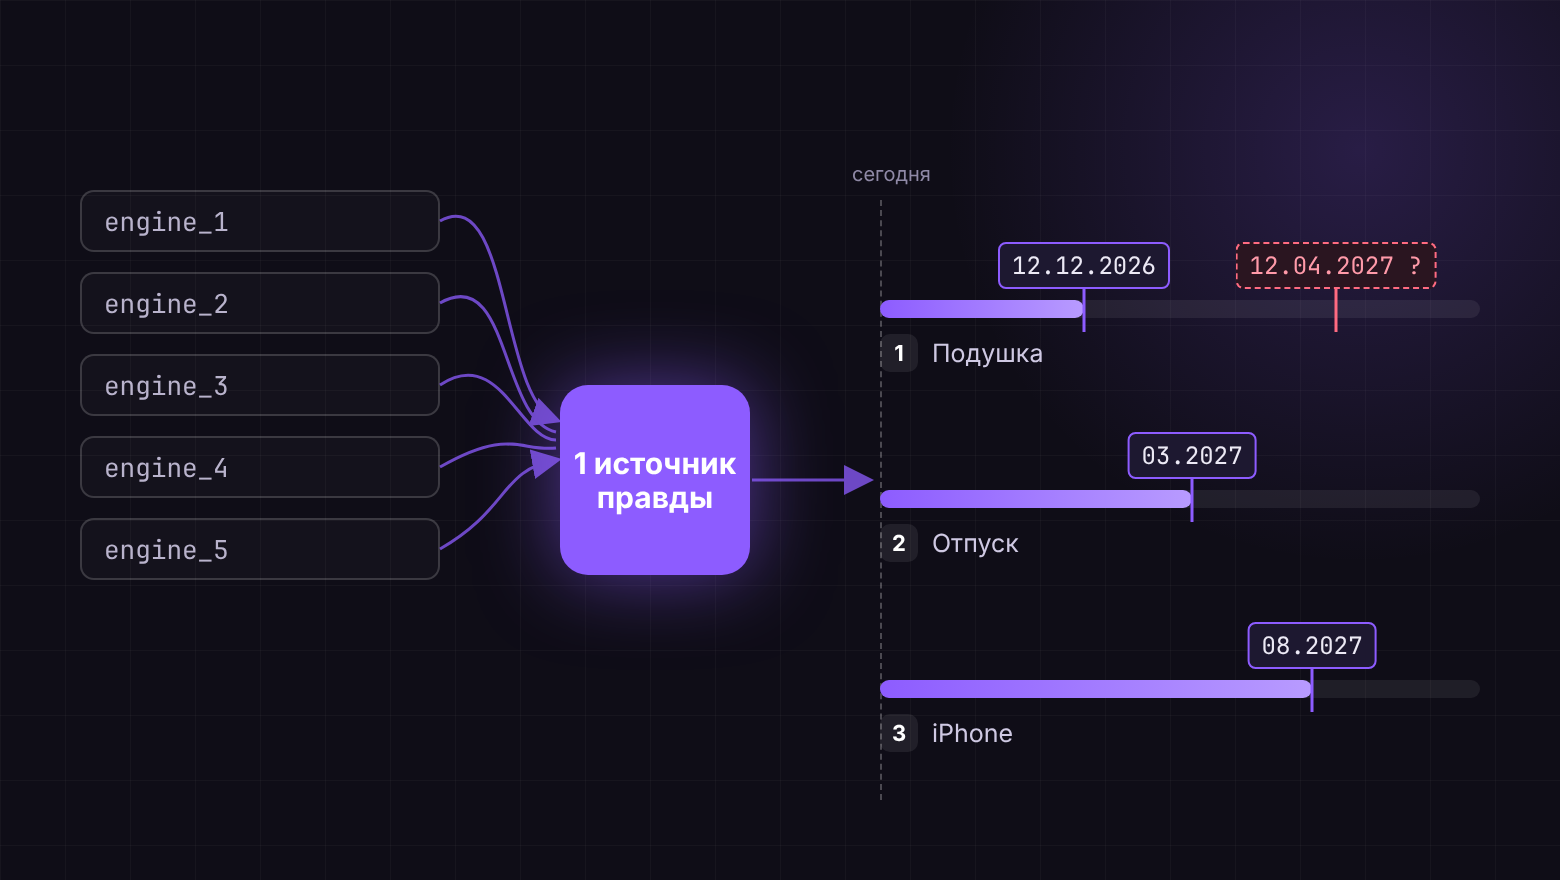
Приоритеты и прогнозные даты нескольких целей: что я бы не стал строить второй раз

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели4.5K

Входная задача звучит вроде просто: У человека стабильная зарплата и несколько целей: подушка, ремонт, телефон, отпуск. Нужно для каждой цели показать дату, к которой она соберется, и пересчитывать даты после каждой получки или распределения накоплений. Я полгода делал такую модель для своего приложения и несколько раз переписывал. Ниже мой опыт, который может пригодится тем, кто считает даты из денежного потока.

Читать далее

Автотюн по кусочкам: как Auto-Tune и Nectar пересобирают голос

Уровень сложностиСредний
Время на прочтение17 мин
Охват и читатели10K

Певец держит одну ноту, а обработанный голос на мгновение перескакивает на октаву. Такое случается, когда плагин принимает сильную гармонику за основной тон. Чем быстрее коррекция, тем заметнее может стать этот промах.

Разберу, как Auto-Tune Artist 9.x и модуль Pitch из Nectar 4 определяют высоту и что делают с волной после выбора ноты. Здесь есть интересные различия: как удержать оценку на ровном звуке, прочитать запись между сэмплами, перенести фрагмент без щелчка. На этих деталях и остановлюсь.

Для начала возьмём одну вокальную дорожку. С хором или аккордом задача была бы другой. Небольшие функции на C++ покажут отдельные расчёты, а пример на Python можно запустить целиком: он меняет высоту звука, сохраняя длину записи.

Как работает автотюн

ИИ‑спам и обновление Google: как найти у себя почти одинаковые страницы, если порога похожести Google не называет

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели6.4K

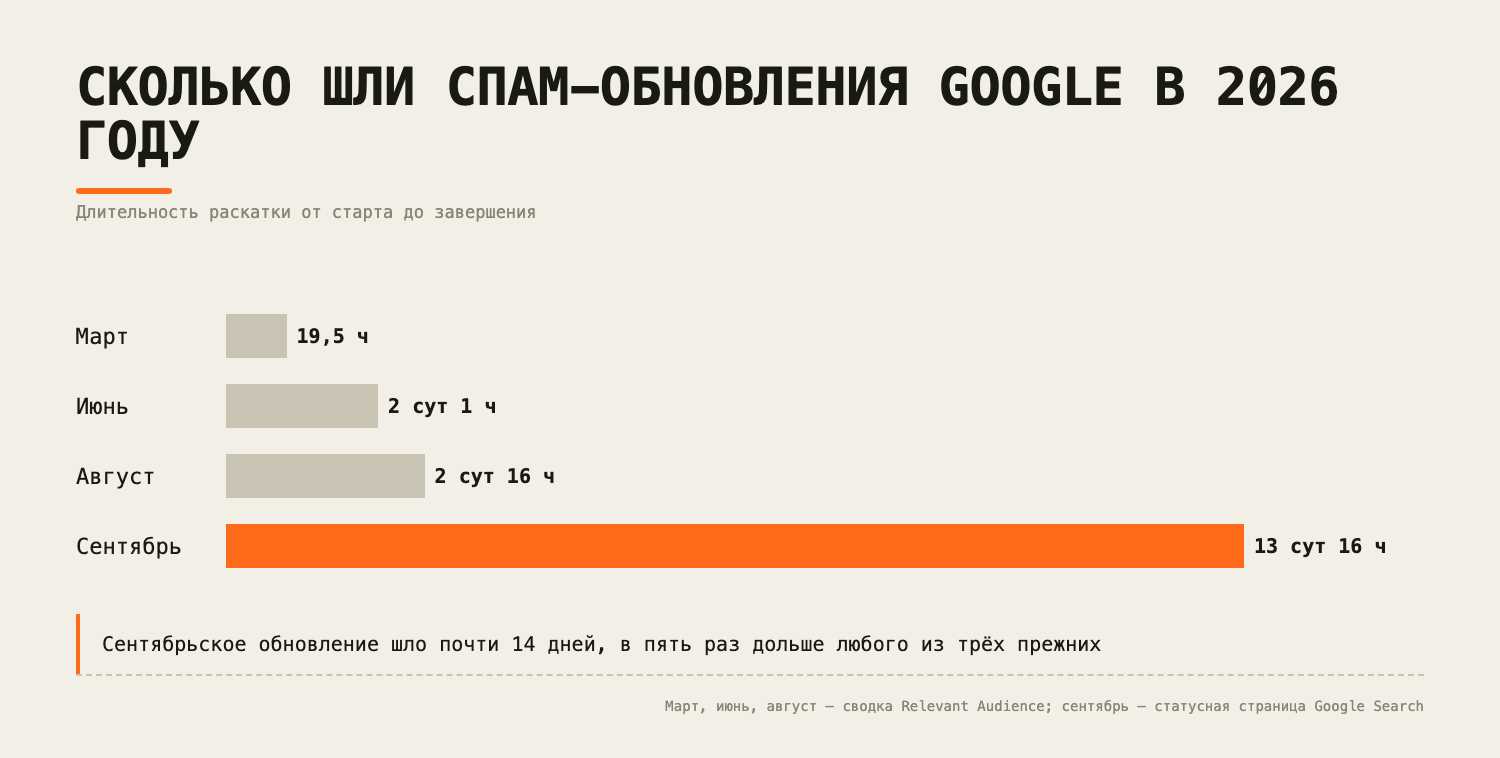
Сентябрьское обновление Google против спама шло с 24 сентября по 8 октября, почти 14 дней, для всех языков. Это в пять раз дольше любого из трёх прошлых спам-обновлений 2026 года (сводка Relevant Audience). Если часть страниц сайта написана нейросетью, вопрос в том, не выглядят ли они массовым производством. Я проверяю это коротким скриптом на Python, а порог похожести выбираю сам: у Google его нет.

Читать далее

Hutter Prize 2026: трансформер на 6 млн параметров, Claude Code и самый большой скачок за 20 лет

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.8K

Двадцать лет Hutter Prize двигался со скоростью ледника: около процента в год. Летом 2026 года официальный рекорд за месяц улучшился почти на 10%, причём 7,5% дал один шаг — трансформер на 6 млн параметров внутри классического context mixing. Разбираемся, что сделал автор рекорда, почему это не «победа LLM над архиваторами», и как Claude Code и Codex завалили судей заявками.

Читать далее

«Диплом Гарварда не открывает дверей»: поступление, сотни откликов и Quant Finance — интервью с Арсением Звягинцевым

Уровень сложностиСредний
Время на прочтение51 мин
Охват и читатели6.3K

Можно окончить Гарвард, получить за четыре года бакалаврский и магистерский дипломы, быть одним из сильнейших студентов на курсе – и два года подряд не найти в США ни одной стажировки. Можно отправить сотни заявок, семь раз собеседоваться в одну компанию и обнаружить, что строчка «Harvard» в резюме даёт лишь небольшое преимущество, а гораздо важнее оказывается школьный «Всерос». А после всего этого – попасть в Quant Finance, где выпускникам предлагают компенсации в сотни тысяч долларов в год, а на интервью проверяют теорию вероятностей, статистику, программирование и задачи, напоминающие олимпиады.

Я, Александр, автор телеграм-канала «Shulepov Code», поговорил с Арсением Звягинцевым – выпускником Гарварда, который изучал статистику и Data Science, живёт в Филадельфии и работает квантом в одной из крупных американских компаний. Арсению 22 года. Сам Гарвард он называет не «святой землёй», а просто хорошим университетом, считает, что часть его курсов можно было бы уместить в минутный ролик, скептически относится к магической силе нетворкинга и не думает, что искусственный интеллект завтра оставит сильных специалистов без работы. Своими наблюдениями и опытом он делится в телеграм-канале: «Arseniy Zvyagintsev».

В разговоре мы обсудили, как школьнику из СНГ поступить в американский университет, почему российская математическая школа даёт заметную фору на первом курсе, как устроены гарвардские Final Clubs, почему при поиске работы непонятный фильтр HR иногда важнее диплома, чем квант отличается от трейдера, зачем рынку маркетмейкеры, откуда берутся зарплаты в $250-400 тысяч, почему Арсений собирается вернуться в Россию – и чем заканчивается приложение, полностью написанное через вайб-кодинг человеком, который не знает его технологический стек.

Читать далее

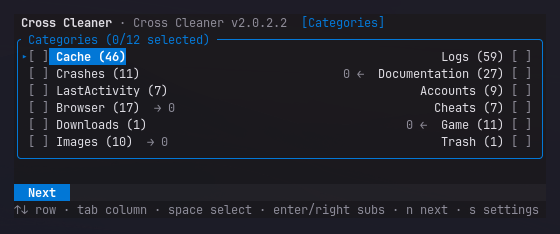
Cross‑Cleaner: стриминг JSON частями вместо загрузки всей базы очистки в память

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели8.1K

Cross-Cleaner уже проделал большую часть работы по снижению памяти — но не на уровне парсинга, а на уровне представления данных:

Читать далее

Пишем высокопроизводительный rate-limiter на golang

Уровень сложностиСредний
Время на прочтение20 мин
Охват и читатели8K

Недавно я познакомился с Golang и в качестве практики решил реализовать алгоритмы rate limiting'а из статьи с arxiv. Сегодня мы рассмотрим написание rate-limiter'а в виде отдельно-стоящего сервиса и в виде middleware, используя in-memory кэш или Redis, добавим поддержку REST и gRPC, подключим Prometheus и поймём как добиться атомарности операций с минимальными задержками.

Читать далее
1
23 ...