Обзор
Convex – это новый, но набирающий популярность фреймворк для реактивных веб-приложений, который позволяет писать транзакционные квери (queries) и мутации (mutations) на TypeScript с гарантиями консистентности.
Вся статья ниже относится к self-hosted версии Convex: convex-backend, а точнее, к моей пропатченной версии оного, так как “официальная” версия не пригодна к работе в продакшене и вряд ли тестировалась на сколь-нибудь нагруженном кейсе. Моя версия работает на виртуальном сервере с 32 ядрами и 64Гб памяти и обрабатывает до 15 тысяч Convex-кверей и мутаций в минуту.
Я навайбкодил convex-wasm-compiler, который компилирует Convex-квери и мутации в WebAssembly, и соответствующий патч для convex-backend, позволяющий выполнять скомпилированные в Wasm Convex-функции на файберах Wasmtime прямо в Tokio рантайме convex-backend.
TLDR: квери и мутации в среднем работают в 2 раза быстрее, хвосты задержек сократились втрое. Объём памяти, который сервер удерживает под готовые к выполнению окружения (V8-контексты или Wasm-окружения), уменьшился на 80%.
До этого для быстрого выполнения Convex-функций приходилось активно кешировать и переиспользовать V8-контексты. Без переиспользования каждая Convex-функция стартует в новом контексте: модули ещё не загружены, JIT не прогрет. Начинается загрузка модулей приложения, необходимых для выполнения функции, и интерпретация её JS-кода. Даже относительно простые Convex-функции в среднем выполняются за 100–150 мс.
По мере роста приложения и размера модулей проблема усугубляется. Convex-компоненты помогают сдерживать бесконтрольный рост модулей, но сами добавляют столько накладных расходов и обвязки, что для многих приложений, на мой взгляд, от них больше вреда, чем пользы. Особенно для приложений, которые разрабатывает один человек или пара разработчиков: там нет вопросов разделения ответственности за подсистемы, стабильности API и так далее. Своё отношение к разработке на Convex в стиле «majestic monolith» и к подходу с большим количеством компонентов я описал в посте о своём приложении.
Если выполнять Convex-функцию в уже прогретом V8-контексте, где все модули загружены, а код функции скомпилирован в машинный код через TurboFan, время выполнения часто сокращается очень заметно — вплоть до 10 раз. Например, со 100–150 мс до 10–15 мс, при условии, что строки базы данных, которые читает функция, уже закешированы в памяти.
Так что переиспользование V8-контекстов было и остаётся необходимым для быстрых и эффективных Convex-приложений. Но у него есть две проблемы.
Потребление памяти закешированными V8-контекстами
Во-первых, чтобы больше 99% вызовов использовали уже готовые V8-контексты, каждому V8-изоляту (V8 isolate) в рантайме convex-backend нужно держать не один контекст. Нужен отдельный контекст для каждого модуля — точнее, группы инициализации модулей, — который convex-backend часто назначает на выполнение этому конкретному изоляту. В конфигурации self-hosted convex-backend для моего приложения сейчас используются TinyLFU-кеши размером до 6+1 контекстов (на момент публикации поста о моей конфигурации self-hosted Convex было 5+1). Всего кешируется до 400 контекстов, хотя даже на пике нагрузки одновременно выполняется гораздо меньше 400 Convex-функций. Главная причина такой неэффективности — V8-контексты привязаны к V8-изолятам, и использовать один контекст в разных изолятах нельзя.
Каждый V8-контекст занимает около 35 МБ памяти, и эта цифра тоже растёт вместе с приложением: два месяца назад я писал, что в моём приложении один V8-контекст удерживал в среднем 30 МБ.
В сумме эти контексты занимают около 14 ГБ памяти на моём сервере convex-backend.
Волны инициализации V8-контекстов после деплоя Convex-приложения
Вторая проблема переиспользования V8-контекстов в том, что при деплое Convex-приложения часть закешированных контекстов инвалидируется. Это может запустить по всему серверу волну загрузки и компиляции модулей, которая длится около минуты: сотни V8-контекстов приходится создавать и прогревать заново. V8-изоляты не делятся друг с другом оптимизированным машинным кодом. Даже если сериализованный байткод закеширован, инициализация модулей всё равно выполняется отдельно в каждом V8-контексте.
Масштаб инвалидации зависит от того, какие модули изменились при деплое. Но если обновились именно ключевые модули с «горячими» Convex-функциями, на которые приходится значительная доля всей серверной нагрузки, большая часть V8-контекстов может пойти под снос и потребовать повторной инициализации. Ведь с каждым таким модулем связано множество V8-контекстов в TinyLFU-кешах разных V8-изолятов.
Эта волна повторного прогрева V8-контекстов совпадает с другой волной работы, которую вызывает деплой Convex-приложения: кеш результатов кверей из обновлённых модулей инвалидируется, а квери, на которые у клиентов открыты реактивные подписки, выполняются заново. Это происходит, даже если данные в read set не менялись. То есть серверу приходится не только компилировать код и загружать модули, но ещё и выполнять больше кверей, чем в обычном режиме.
На практике из-за этих волн работы после деплоя квери и мутации могут какое-то время выполняться медленнее, а при сильной перегрузке серверу приходится отклонять часть вызовов.
Рабочие потоки Tokio рантайма Convex конкурируют с рабочими потоками V8-изолятов и фоновыми потоками V8
Это более общая проблема выполнения Convex-функций в V8-изолятах, не специфичная для переиспользования контекстов. convex-backend ограничивает число воркеров V8-изолятов, которые могут активно выполнять код, через переменную FUNRUN_ISOLATE_ACTIVE_THREADS. Под активным выполнением здесь понимается работа без блокировки на чтении или записи в базу данных и другом I/O. Эту переменную следует выставлять равной CPU-лимиту контейнера convex-backend или чуть ниже.
При этом изолировать эти потоки от собственного Tokio рантайма convex-backend и фоновых потоков V8, как правило, не получится без существенного снижения максимальной пропускной способности сервера при длительной нагрузке. Число потоков ОС у Tokio рантайма задаётся переменной RUNTIME_WORKER_THREADS. Фоновые потоки движка V8 отвечают за компиляцию и сборку мусора в V8-контекстах; их число задаётся переменной V8_THREADS.
В моей конфигурации сервера CPU-лимит convex-backend составляет 28.5 CPU, FUNRUN_ISOLATE_ACTIVE_THREADS=28, RUNTIME_WORKER_THREADS=28 и V8_THREADS=16. Кроме того, у меня есть несколько пулов выполнения Node, в каждом из которых по 1–2 активных потока. Получается, что теоретически в процессах контейнера с лимитом 28.5 CPU может быть как минимум 75 активных потоков ОС.
Такой oversubscription — не катастрофа, но до оптимума далеко. За последнюю неделю, когда Convex-квери и мутации на моём сервере выполнялись в V8, в пятиминутном интервале с наибольшим контеншеном CPU pressure достигал 29%. Разумеется, это пришлось на время деплоя приложения.
Практический эффект этого CPU pressure: когда сервер занят — из-за деплоя или просто роста нагрузки, — Convex-функции выполняются медленнее, чем при умеренной нагрузке. И это отдельный эффект, помимо замедления чтения и записи в базу данных, более частого вытеснения записей из кеша результатов кверей, кеша индексов и кеша V8-контекстов. Сама база под Convex, например MySQL или PostgreSQL, при росте транзакционной нагрузки тоже может испытывать повышенный CPU pressure, а её контейнер — попадать под троттлинг.
Зачем компилировать TypeScript-функции Convex в Wasm
Перенести выполнение горячих функций из V8 в WebAssembly-рантайм вроде Wasmtime, встроенный в Tokio рантайм Convex, — очевидный ответ на описанные проблемы. В начале 2026 года команда Convex объявила, что Wasm-рантайм есть в планах. В августе Wasm-рантайм добавили в репозиторий convex/convex-backend. Однако на следующий день его удалили, и с тех пор он не возвращался. В той реализации использовался интерпретатор QuickJS, скомпилированный в Wasm: сами Convex-функции интерпретировались внутри Wasm, а не компилировались в него. Поэтому реализация была очень медленной и не предназначалась для продакшена.
Обычно предполагается — и руководство Convex озвучивало это на разных Q&A-сессиях начиная с августа, — что ради производительности WebAssembly-рантайма разработчики будут писать Convex-функции на компилируемом языке с Wasm-таргетом, прежде всего на Rust.
Я начал разрабатывать компилятор обычных Convex-функций, написанных на TypeScript, в байткод WebAssembly с помощью Static Hermes — AOT-компилятора JavaScript с поддержкой Wasm-таргета — в конце июля. Тогда ещё не было известно, что команда Convex собирается ускорить работу над Wasm-рантаймом: до августа Jamie Turner говорил лишь, что тот, скорее всего, появится только в 2027 году.
За весь проект, который начался в июле и занял почти три месяца, встраивание Wasmtime в convex-backend оказалось сравнительно небольшой частью работы — возможно, около 10% всех усилий. То есть само по себе добавление Wasm-рантайма в convex-backend — задача относительно простая, и это было мне более-менее понятно с самого начала. Правда, некоторые другие части задачи я сильно недооценил: возможно, я рассчитывал, что на Wasm-рантайм в convex-backend уйдёт 50% усилий. В итоге оказалось только 10%, а весь проект занял в пять раз больше времени, чем я ожидал.
Так что вариант переписать части моего Convex-приложения на Rust я рассматривал уже тогда. Но не пошёл по этому пути по нескольким причинам:
В приложении было около 350 тысяч строк продакшен-кода только в Convex, причём значительная часть логики была общей с другими частями системы, работавшими на Node.js. Вместе с ними объём продакшен-кода превышал полмиллиона строк. Переписать всё это казалось примерно такой же сложной задачей, как сделать компилятор существующих Convex-функций в WebAssembly.
Оглядываясь назад, даже переписывание полумиллиона строк с TypeScript на Rust, вероятно, заняло бы меньше времени, чем трёхмесячная разработка компилятора. Но тогда я этого не предвидел. С другой стороны, у такого проекта наверняка были бы свои существенные риски, о которых я сейчас не знаю, потому что не пробовал. И он точно нарушил бы привычный темп выпуска фич.
Меня беспокоило время компиляции Rust и то, насколько оно может замедлить цикл разработки. Эти опасения отчасти подтвердились: с тех пор я полностью написал одну часть приложения на Rust, используя добавленную мной в convex-backend функциональность native resident. Это не Convex action, кверя или мутация, а фоновый Rust-процесс, который деплоится вместе с Convex-приложением и сам вызывает Convex-квери и мутации через loopback. В этой части приложения всего 30 тысяч строк Rust, но каждый раз, когда её код меняется, я ощущаю всю боль медленной компиляции.
Мне не хотелось придумывать API для работы с Convex на Rust — аналоги
ctx.db.query(),insert(),defineSchema()и так далее, — которые потом вытеснят официальные API команды Convex. В целом я хотел сделать что-то, что могло бы дополнить будущие разработки Convex, а не разойтись с ними или конкурировать.Наконец, делать компилятор мне просто казалось интереснее, чем переписывать приложение на Rust!
Устройство convex-wasm-compiler и Wasm-рантайма convex-backend
Код Convex-приложения не меняется: это по-прежнему TypeScript с SDK convex-js.
Компиляция TypeScript-кода Convex-приложения в Wasm
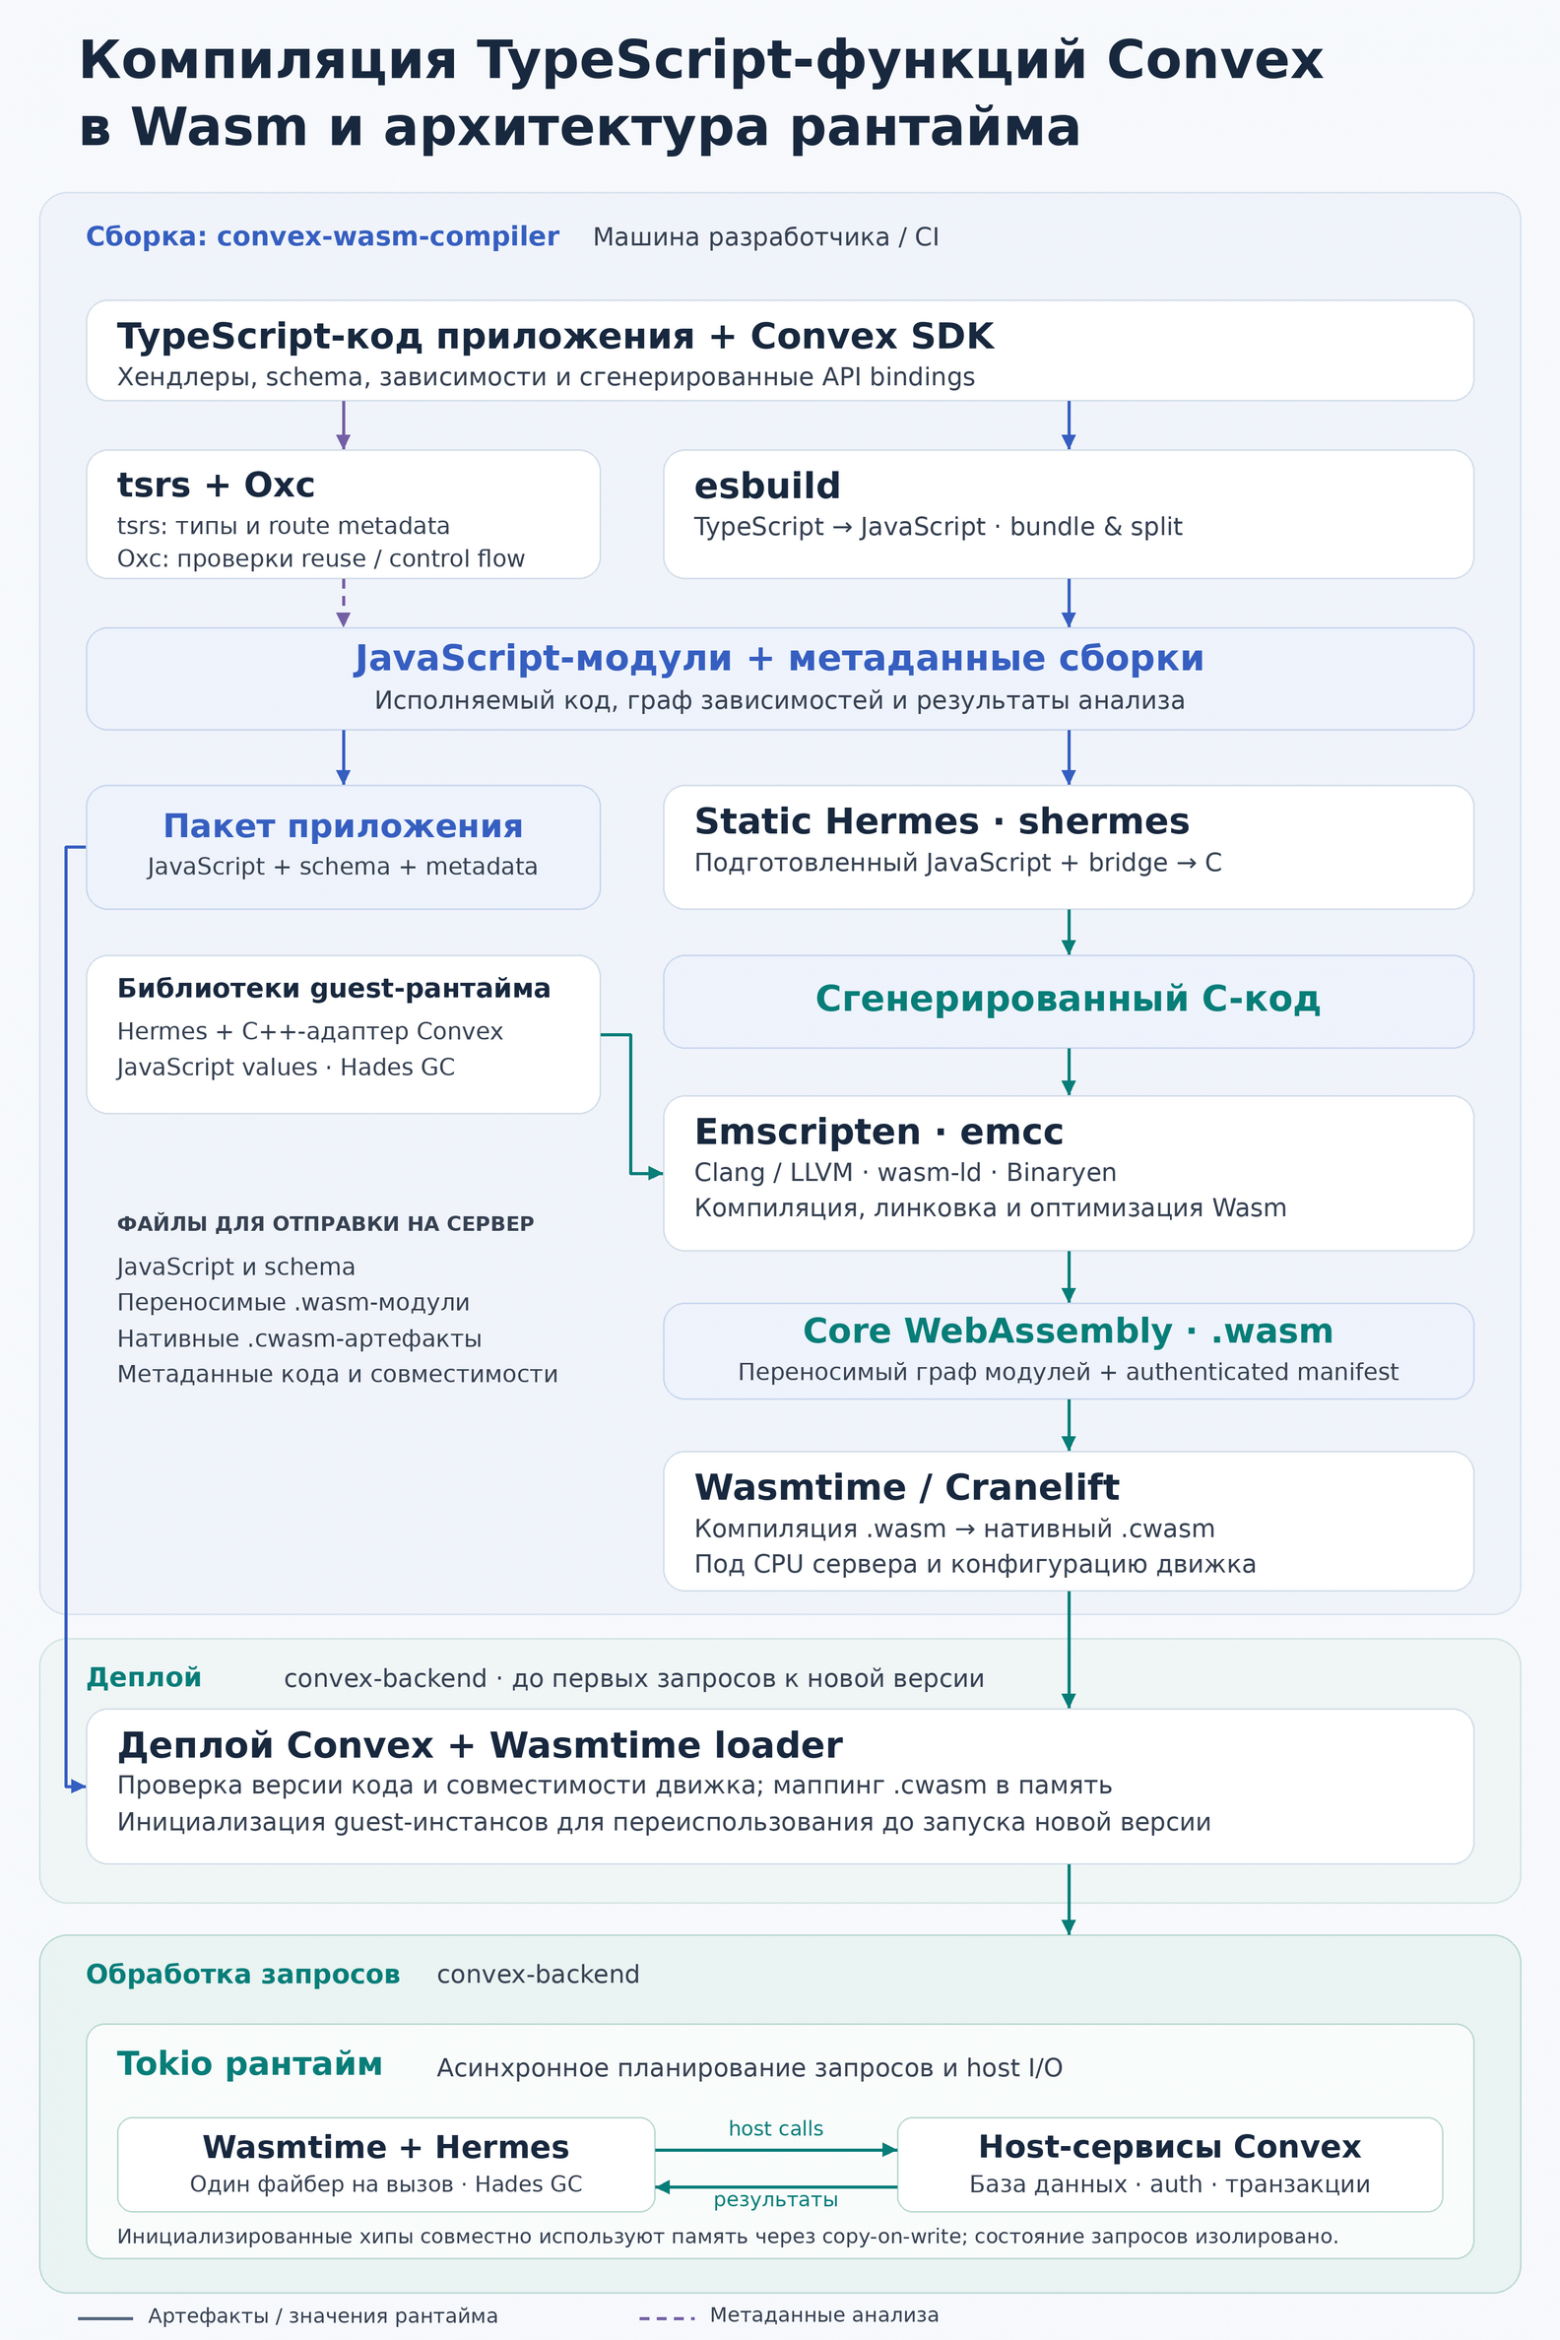
convex-wasm-compiler управляет анализом исходников, сборкой JavaScript-бандлов и нативной компиляцией. С помощью tsrs он находит регистрации Convex-функций и связывает экспортируемые маршруты с исходным кодом, а с помощью esbuild разрешает зависимости и преобразует TypeScript-код приложения в JavaScript-бандлы. Написанный на Rust анализатор использует Oxc, чтобы проверить исходники и граф зависимостей на небезопасное сохранение состояния между запросами и определить, можно ли переиспользовать инициализированные модули. Результаты анализа определяют, что можно допустить к выполнению и как это упаковать; исполняемый код приложения берётся из JavaScript, который генерирует esbuild.
Затем компилятор подготавливает этот JavaScript в виде модулей приложения, добавляет bridge к host-операциям Convex и вызывает (Static) Hermes. Здесь и далее «host» — это операции рантайма convex-backend, такие как чтение и запись в базу данных, а «guest» — выполнение функций приложения. Компилятор shermes генерирует C-код, который тулчейн Clang/LLVM из Emscripten компилирует вместе с Hermes рантаймом и нативным адаптером Convex. wasm-ld линкует эти компоненты, а Binaryen оптимизирует полученный Core WebAssembly. Прилинкованный Hermes рантайм обеспечивает внутри Wasm-guest JavaScript-объекты, строки, промисы, исключения и сборку мусора.
Асинхронные JS-функции на файберах Wasmtime
Static Hermes компилирует асинхронные JavaScript-функции в конечные автоматы, которые могут приостанавливаться и продолжать выполнение с опорой на промисы. Патч для Hermes переносит основную механику промисов в C++: состояние промиса хранится в объектах JSPromise, которыми управляет GC, а реализация Promise на C++ отвечает за resolve, reject и учёт continuations. Это сокращает количество операций с JavaScript-объектами и аллокаций колбэков при асинхронном выполнении. Некоторые высокоуровневые операции Promise по-прежнему используют внутреннюю JavaScript-реализацию Hermes.
C+±адаптер Convex, скомпилированный в WebAssembly вместе с Hermes и приложением, содержит цикл, который доводит каждый вызов до завершения. Он вызывает хендлер, обрабатывает очередь микротасок Hermes, выполняя готовые continuations, ждёт чтения и записи в базу данных и других host-операций, а по мере поступления результатов делает resolve или reject соответствующих промисов. Если нужно дождаться асинхронной работы на стороне host, Wasmtime приостанавливает файбер вызова, освобождая рабочий поток Tokio для других задач. Когда результаты готовы, выполнение продолжается в том же файбере. Таким образом, экспортируемая точка входа Wasm возвращает итоговый статус вызова через обычный интерфейс «вызов — возврат»; JavaScript-промисы и continuations остаются внутри guest.
Tokio рантайм Convex поллит call_async из Wasmtime, который выполняет точку входа guest в одном файбере Wasmtime. Проверки fuel и epoch обеспечивают соблюдение лимитов выполнения и дают CPU-bound коду внутри guest возможность делать yield.
Компиляция Wasm в нативный код и деплой
В этой схеме нативная компиляция происходит на машине разработчика или в CI. Компилятор Cranelift из Wasmtime переводит .wasm-модули — приложение, Hermes рантайм и адаптер Convex — в машинный код под целевую архитектуру сервера и конфигурацию Wasmtime. Wasmtime сохраняет этот код и метаданные для его загрузки в .cwasm-файлах. При деплое они отправляются на сервер вместе с переносимыми .wasm-файлами, обычным JavaScript-бандлом Convex и схемой.
На сервере convex-backend проверяет, что скомпилированные файлы совместимы с его движком Wasmtime и соответствуют той версии JavaScript-приложения, которая сейчас деплоится. Сохранённые хеши содержимого не позволяют случайно совместить новый JavaScript со старой скомпилированной сборкой. convex-backend загружает скомпилированный код в память и подготавливает изолированные окружения для повторного использования, каждое со своим Hermes рантаймом и JavaScript-состоянием приложения. Инициализация модулей — выполнение кода верхнего уровня, который создаёт объекты модулей и регистрирует экспортируемые функции, — завершается для начального пула окружений ещё до того, как новая версия приложения начинает обслуживать квери и мутации. Позже пул может расти вслед за нагрузкой. Именно эта часть решает описанную выше проблему «Волны инициализации V8-контекстов после деплоя Convex-приложения», характерную для выполнения в V8.
Wasm-окружения и управление памятью
Wasm-рантайм экономит память по сравнению с V8 за счёт того, что изолированные окружения в пуле совместно используют скомпилированный код и инициализированную память приложения. Эти окружения похожи на V8-изоляты в рантайме Convex, но у них нет выделенных потоков ОС. Их количество ограничено общим бюджетом памяти и жёстким лимитом числа инстансов; число одновременно активных выполнений ограничивается отдельно, исходя из CPU.
Каждое окружение управляется Wasmtime Store. В нём есть Hermes рантайм и собственное JavaScript-состояние, и в каждый момент оно обслуживает один вызов Convex-функции. Окружения с одинаковыми скомпилированными модулями совместно используют их машинный код. На Linux convex-backend также сохраняет инициализированную Wasm-память окружения, включая JavaScript-хип, в неизменяемый снапшот в файле. Это происходит после инициализации модулей приложения, но до выполнения в этом окружении первой квери или мутации. Другие окружения мапят этот снапшот с copy-on-write: неизменённые страницы используют общую физическую память, а при записи создаются приватные копии. Каждое окружение заново создаёт собственные таблицы функций и ссылки рантайма, а состояние конкретного вызова Convex-функции хранит отдельно. Перед переиспользованием окружения convex-backend проверяет, что конфигурация и другие зависимости, прочитанные при инициализации, всё ещё актуальны.
В сборщик мусора Hermes, Hades, внесён патч, который сохраняет это совместное использование памяти. В данной Wasm-сборке Hades работает в одном потоке внутри guest-вызовов. Подготовленные области хипа исключены из последующих аллокаций и компактизации: это уменьшает количество записей в общую исходную память. При этом сохраняются обычные механизмы обхода графа объектов (tracing), очистки памяти от недостижимых объектов (sweeping) и финализации. В безопасных точках между вызовами сборка мусора и анализ состояния аллокатора находят пустые области nursery и заведомо свободные страницы с данными, чью приватную физическую память host может освободить. Бэкенд учитывает общую физическую память только один раз и резервирует память под приватное состояние и рост каждого окружения. Хуки Wasmtime отслеживают записи и рост памяти, поэтому общий бюджет Wasm-памяти соблюдается как при выполнении вызовов, так и при добавлении окружений в пул.
Wasmtime также использует сборщик с отложенным подсчётом ссылок для объектов, которыми владеет сам движок, в том числе перехваченных Wasm-исключений. Это отдельный механизм, не связанный с Hades, который управляет JavaScript-объектами в линейной памяти. Вместе с ограничением числа сохраняемых инстансов и освобождением страниц эти механизмы позволяют переиспользовать инициализированные рантаймы после успешных вызовов, не удерживая бесконечно всю память, которую затрагивали предыдущие выполнения Convex-функций в этом окружении.
Wasm vs. V8: результаты замеров производительности
В целом среднее время выполнения кверей и мутаций в Wasm сократилось почти на 50% относительно V8:
Рантайм | Среднее | p90 | p99 | Максимум |
|---|---|---|---|---|
V8 | 38.53 мс | 62 мс | 329 мс | 7 463 мс |
Wasm | 19.61 мс | 34 мс | 139 мс | 2 242 мс |
В среднем каждое Wasm-окружение удерживает 12 МБ полностью приватной памяти, не разделяемой с другими окружениями. Это на 66% меньше, чем 35 МБ у V8-контекста. Кроме того, держать в памяти нужно гораздо меньше Wasm-окружений: 130 против примерно 400 V8-контекстов. Почему V8-контекстов нужно больше, чем одновременно выполняющихся вызовов, я объяснил выше в разделе «Потребление памяти закешированными V8-контекстами».
В пятиминутном интервале с наибольшим контеншеном CPU pressure достигал 15%, когда основным рантаймом был Wasm, против 29% для V8. Даже эти 15%, вероятно, отчасти связаны с сохранившимся выполнением в V8. Как я расскажу ниже, я компилирую в Wasm не всё Convex-приложение, а лишь примерно 20% самых горячих модулей, на которые приходится 90% всей нагрузки. Это экономит время компиляции и уменьшает размер артефактов. Остальные 80% модулей по-прежнему выполняются в V8, поэтому для них всё ещё актуальны инвалидация и инициализация контекстов, работа фоновых потоков V8 и так далее.
В следующих двух таблицах показано среднее относительное снижение метрик mean/p90/p99/max для отдельных кверей и мутаций в разных группах. Эти средние не взвешены по числу вызовов или суммарному времени выполнения каждой функции.
Время выполнения целиком:
Группа | Среднее | p90 | p99 | Максимум |
|---|---|---|---|---|
Все квери | −57.6% | −56.3% | −65.3% | −82.2% |
Квери: 20% с наибольшим числом host-операций | −39.3% | −37.6% | −48.4% | −82.2% |
Квери: 20% с наименьшим числом host-операций | −69.0% | −61.3% | −78.0% | −84.0% |
Все мутации | −51.5% | −33.7% | −60.6% | −75.1% |
Мутации: 20% с наибольшим числом host-операций | −39.4% | −43.6% | −48.9% | −70.5% |
Мутации: 20% с наименьшим числом host-операций | −51.2% | −55.7% | −61.5% | −70.6% |
«User» time — оценка времени, которое функции провели непосредственно в guest-рантайме, без ожидания чтения и записи в базу данных и других асинхронных host-операций:
Группа | Среднее | p90 | p99 | Максимум |
|---|---|---|---|---|
Все квери | −70.6% | −66.9% | −76.1% | −79.8% |
Квери: 20% с наибольшим числом host-операций | −43.5% | −41.0% | −56.6% | −89.0% |
Квери: 20% с наименьшим числом host-операций | −89.5% | −82.9% | −86.6% | −69.8% |
Все мутации | −67.7% | −46.5% | −72.5% | −59.9% |
Мутации: 20% с наибольшим числом host-операций | −41.0% | −41.2% | −47.7% | −39.0% |
Мутации: 20% с наименьшим числом host-операций | −76.9% | −78.6% | −82.2% | −55.0% |
«20% с наибольшим числом host-операций» и «20% с наименьшим числом host-операций» — это функции, которые в среднем выполняют больше или меньше асинхронных операций, например чтений и записей в базу данных, по сравнению с остальными. Например, функция с единственным ctx.db.get(id) делает одну асинхронную операцию и попадёт в группу «20% с наименьшим числом». А функция, которая в среднем выполняет сотни операций ctx.db, ctx.scheduler и так далее, — в группу «20% с наибольшим числом».
Из таблиц видно, что относительное преимущество Wasm перед V8 обычно уменьшается для функций, которые делают очень много асинхронных операций. Возможно, это указывает на слабое место в обработке JS Promise внутри файбера Wasmtime, описанной выше в разделе «Асинхронные JS-функции на файберах Wasmtime». И это несмотря на то, что оптимизации этой части уже уделено много внимания и я не знаю — ладно-ладно, GPT-Astra не знает, — как ускорить её ещё. Другая возможная причина: частые yield из файберов Wasmtime и переключения потока на другие задачи Tokio приводят к тому, что Convex-вызов чаще мигрирует между ядрами CPU, а значит, чаще получает промахи L1-кеша или TLB. А возможно, дело в чём-то ещё. Причина пока не установлена.
Преимущество по «user» time тоже не универсально. Есть одна Convex-мутация, у которой среднее user time в Wasm-рантайме на 14% выше, чем в V8, хотя по полному времени выполнения она всё равно быстрее в Wasm. Эта мутация в цикле выполняет численные операции над Float64Array размером более 100 тысяч элементов. Возможно, в V8 для этого есть интринсики или векторизация, которых пока не хватает в пайплайне Hermes → Wasm.
Операционные аспекты AOT-компиляции в Wasm
Теневое выполнение для постоянного тестирования
Я добавил в convex-backend целую сложную подсистему для дифференциального тестирования и теневого выполнения (shadow execution) Convex-функций в рантаймах V8 и Wasm. Она поддерживает основное (primary) и теневое выполнение — в каждой роли может быть как V8, так и Wasm. Заданная доля вызовов, например 5%, случайным образом отбирается для теневого выполнения, после чего система проверяет, что результаты совпадают.
Теневые вызовы не блокируют основные. Теневое выполнение работает и для кверей, и для мутаций. В случае мутаций записывается трейс вызовов, меняющих состояние, таких как db.insert(), но сами строки в базе, конечно, не перезаписываются второй раз. Поменять местами основной и теневой рантаймы можно без повторного деплоя приложения.
Эта система позволила мне уверенно переключить продакшен на Wasm и найти несколько багов в convex-wasm-compiler. Правда, большинство багов оказалось в самой подсистеме теневого выполнения, сравнения и проверки трейсов. Даже после переключения основного выполнения на Wasm я продолжаю выполнять 5% вызовов в V8 в теневом режиме, чтобы замечать расхождения, если они появятся в будущем.
Выборочная компиляция в Wasm
И компилятор, и convex-backend поддерживают выборочную компиляцию: в Wasm компилируется и выполняется только часть модулей. Это помогает сократить время компиляции и объём данных, передаваемых при деплое. В своём приложении я выбираю лишь около 20% модулей, на которые приходится более 90% всех вызовов кверей и мутаций. Однако ни объём передачи, ни время компиляции не уменьшаются впятеро: из-за транзитивных зависимостей компилировать и передавать всё равно приходится около 70% всех модулей приложения. Так что, возможно, выигрыш не так уж велик.
Время компиляции и объём передачи
Выбранные 20% модулей моего Convex-приложения — это 57 модулей и 631 Convex-функция для компиляции в Wasm: 145 кверей и 486 мутаций. Всего компилируется 528 отдельных JS-модулей: 57 выбранных плюс их зависимости.
Для этого набора холодная компиляция — когда нужно перекомпилировать большую часть кода или весь код, например после очистки кеша компиляции, — с 16 воркерами AOT-компиляции и лимитом памяти 12 ГБ занимает около 6 минут. Тёплая компиляция, когда часть модулей изменилась, но большинство уже есть в кеше, занимает около 2 минут. До идеала далеко, и я продолжаю над этим работать.
Когда я начинал проект, я не ожидал, что именно скорость компиляции, инкрементальность и кеширование окажутся главными инженерными проблемами. Из примерно трёх месяцев работы над проектом AI-агенты суммарно потратили около трёх недель календарного времени исключительно на это направление.
При деплое с таким набором скомпилированных модулей на мой self-hosted сервер Convex передаётся около 50 МБ сжатых артефактов. Без Wasm — около 15 МБ, то есть Wasm примерно втрое увеличивает объём данных при деплое. Без выборочной компиляции он, вероятно, был бы примерно в пять раз больше, чем при деплое одного JS-бандла.
Эта статья — перевод из моего блога про работу с Convex в продакшене.