Представим обычный интернет‑банк: пользователь открывает выписку, смотрит историю операций, переводит деньги, проверяет статус платежа. Всё работает корректно. Но если таких пользователей вдруг станет в десять раз больше, то нагрузка на CPU увеличится, база станет отвечать медленнее, а внешние зависимости могут не справиться с возросшим потоком трафика.
Заранее предвидеть такие ситуации помогает нагрузочное тестирование. В статье расскажу про реальные случаи из практики, когда нагрузочные тесты помогли найти и устранить неочевидные проблемы.
Почему функциональных тестов недостаточно
Функциональные тесты помогают убедиться, что сервис работает правильно: бизнес‑логика выполняется, ответы приходят, пользовательские сценарии обрабатываются без ошибок. Проще говоря, они отвечают на вопрос: «Работает ли функция?».
Но на практике этого недостаточно. Представим, что пользователь нажал на кнопку «Скачать выписку». Функциональный тест подтвердил, что сценарий работает корректно. Но он не показывает, что произойдёт, если выписки одновременно запросят сотни тысяч пользователей.
При росте нагрузки система начинает расходовать гораздо больше ресурсов: растёт потребление CPU и памяти, увеличивается количество соединений, база данных может отвечать дольше, а внешние зависимости не справляются с потоком запросов. На любом из этих уровней может возникнуть «бутылочное горлышко».
Поэтому нагрузочное тестирование дополняет функциональное: оно показывает, как сервис ведёт себя не только при обычном сценарии, но и когда количество запросов резко увеличивается.
Что именно проверяем под нагрузкой
Обычно в нагрузочном тестировании используют несколько типов проверок:
Обычный нагрузочный тест — создаёт ожидаемую нагрузку, чтобы посмотреть, как сервис работает в течение заданного промежутка времени. Такой тест удобно использовать, чтобы сравнить две версии: выросла ли задержка, увеличилось ли потребление ресурсов, изменилось ли количество ошибок.
Тест на стабильность — берётся нагрузка, близкая к пиковой, и удерживается в течение продолжительного периода времени (4–8 часов). Короткий прогон может показать, что всё хорошо, но за несколько часов проявляются проблемы другого класса: например, утечки памяти или постепенное накопление очередей.
Стресс‑тест — резкое увеличение количества запросов. Показывает, где находится предел системы и позволяет понять, что произойдёт при неожиданном всплеске трафика.
Chaos‑тестирование — во время нагрузки специально ухудшается состояние отдельных компонентов. Например, увеличивается задержка внешней системы или полностью отключается зависимость. Это позволяет проверить, умеет ли сервис переживать отказ соседнего компонента и насколько корректно деградирует.
На практике эти подходы часто пересекаются. Например, можно одновременно создать нагрузку и отключить базу, чтобы проверить отказоустойчивость. Или увеличить задержку внешней системы и посмотреть, не закончится ли у приложения пул потоков.
Что необычного можно найти при проведении нагрузочных тестов
Мы в Точка банк используем нагрузочные тесты уже около двух лет. За это время накопилось достаточно кейсов, чтобы увидеть главное: под нагрузкой ломается не обязательно то, что со стороны кажется самым слабым звеном. Иногда проблемы находятся в довольно неожиданных местах.
Рассмотрим самые интересные кейсы.
Кейс 1. Отказ базы и разделение потоков
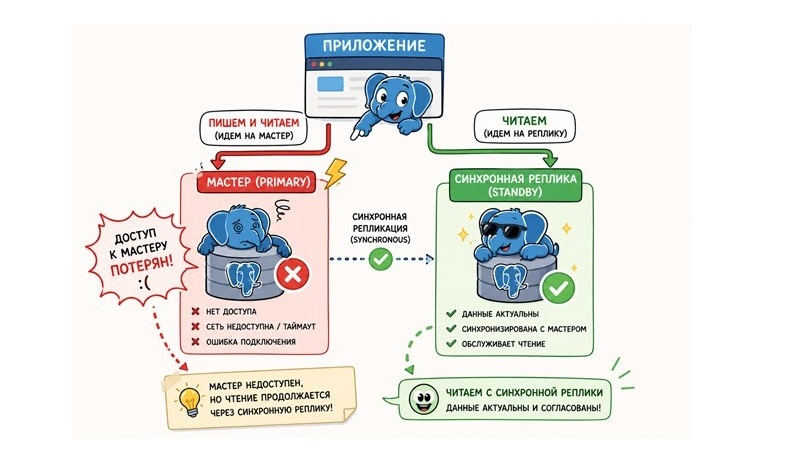
У нас есть сервис CoreView, который возвращает данные и отрисовывает главную. Основная нагрузка приходится на чтение, поэтому чтение и запись работают через разные пулы соединений.
Чтобы проверить поведение системы при отказе зависимости, во время нагрузочного теста мы отключили базу данных. Это можно сделать, например, с помощью DBA или через прокси.
Очевидно, что операции записи перестали работать, так как база оказалась недоступна. Но запросы на чтение продолжили выполняться. Это важный результат, который показывает, что отказ одного компонента не обязательно должен превращаться в полный отказ сервиса.
Кейс 2. Чрезмерное логирование ошибок
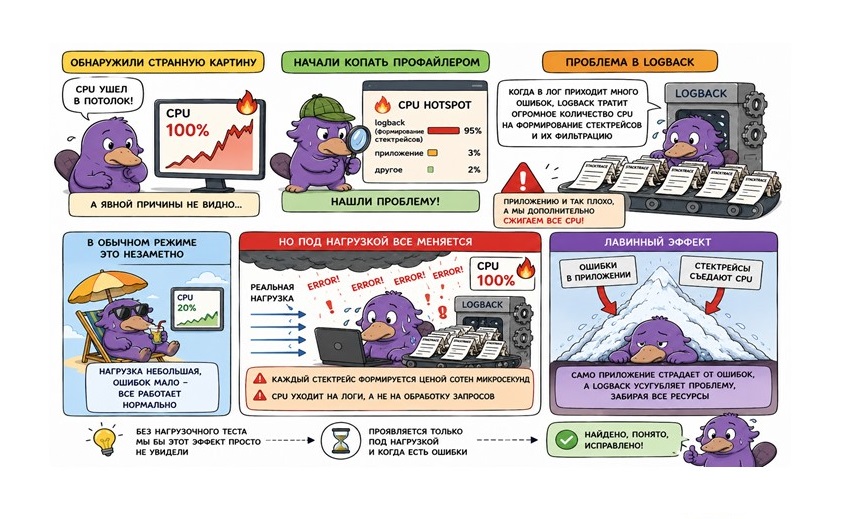
Этот случай начался с безобидной метрики: во время нагрузочного тестирования у сервиса резко выросла загрузка CPU в Kubernetes. При этом само приложение не делало ничего необычного.
При профилировании обнаружили интересную связь с Logback. Оказалось, что при ошибке интеграции сервис начал активно писать один и тот же stack trace.
Когда запросов немного, это почти незаметно. Но под нагрузкой ситуация меняется: если внешняя система начинает отвечать ошибкой, каждый входящий запрос может порождать новую запись в лог. В результате процессор тратится уже не на обработку пользовательских запросов, а на обработку ошибок и запись логов.
Чтобы избежать этого, мы ограничили количество одинаковых stack trace: если одна и та же ошибка повторяется больше 50 раз в минуту, её не выводят в таком объёме.
Кейс 3. Адаптивные лимиты пропускной способности
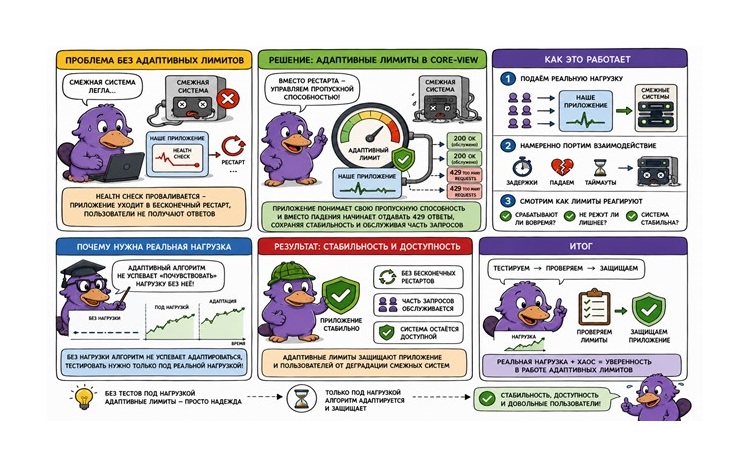
Сервисы редко существуют изолированно. Они обращаются к другим системам, и если одна из зависимостей начинает работать хуже или вовсе отваливается, это может повлиять на работоспособность.
Что обычно происходит в таких ситуациях: пропускная способность падает, время ожидания ответов растёт, а входящие запросы при этом никуда не исчезают. В результате собственные ресурсы постепенно заканчиваются.
Мы разрабатывали механизм адаптивных ограничений, чтобы сервис мог учитывать состояние зависимости и динамически менять количество отправляемых запросов. Если зависимость стала медленнее, система должна не продолжать наращивать очередь бесконечно, а снижать давление.
В основе такого подхода используется обратная связь — по смыслу близкая к PID‑регулятору: система смотрит на фактическое состояние и корректирует интенсивность запросов. В итоге получает full tolerance‑приложение, которое продолжает работать даже при деградации зависимостей и не падает целиком.
Кейс 4. Новая интеграция и кратный рост нагрузки
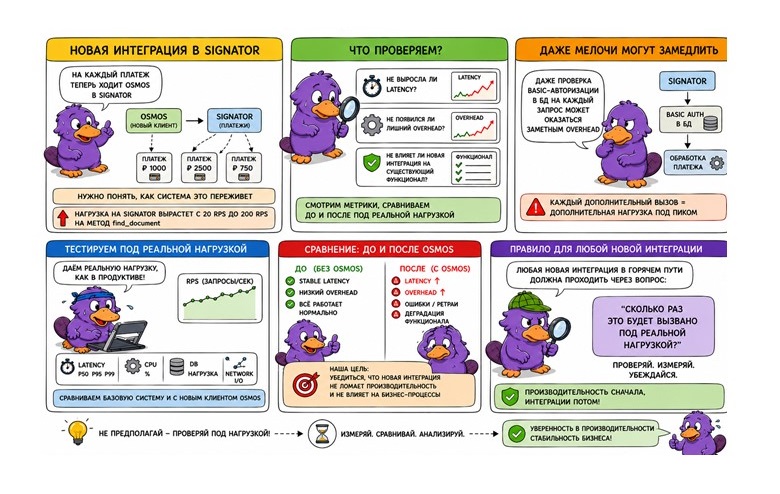
Иногда нагрузочное тестирование используют не потому, что сервис падает, а потому что ему предстоит серьёзно вырасти. Одна из таких задач у нас появилась, когда существующая функциональность должна была перейти с 20 RPS до 200 RPS (количество запросов в секунду).
Тест показал, что требуемую нагрузку система выдерживает. Но параллельно удалось найти место для оптимизации. Оказалось, что при каждом запросе приложение обращается к базе, чтобы проверить авторизацию. Такой результат легко не заметить при небольшом трафике, так как один дополнительный запрос к базе почти ничего не меняет.
Но при 200 RPS картина другая: один лишний запрос превращается в сотни обращений в секунду. Чтобы не выполнять одну и ту же работу заново для каждого запроса, мы решили кэшировать результат авторизации.
Кейс 5. Ограничения Undertow
Мы проверяли MVP матриц сервисов — функционала, который в дальнейшем будет доступен большинству клиентов интернет‑банка. Поэтому важно заранее убедиться, что сервис выдержит необходимое количество соединений.
При нагрузочном тестировании начали возникать проблемы. После анализа выяснилось, что узкое место связано с настройками Undertow — сервера, который используется в Java‑приложении. Система упиралась в ограничения буферов.
В итоге мы подобрали максимальную конфигурацию, и теперь можем безопасно держать необходимые SE‑коннекты.
Кейс 6. Обновление библиотеки телеметрии
Это кейс особенно показателен для тех, кто привык связывать проблемы производительности только с собственным кодом.
В одном из наших сервисов трафик постепенно переводили с Python на Go. Перед переключением решили повторно провести тестирование. При нагрузке, которая была лишь немного выше текущей, начали появляться ошибки. При этом бизнес‑логика практически не менялась.
В истории изменений мы обнаружили, что между двумя тестами обновилась библиотека телеметрии. Получалась парадоксальная ситуация: разработчик не менял код, который непосредственно обрабатывает пользовательский запрос, но поведение системы под нагрузкой изменилось.
Кейс 7. Утилизация CPU из‑за рекурсивных запросов AsyncPG
Похожая история произошла и с Python‑сервисом. Под нагрузкой менеджер пользователей начал упираться в 100% загрузки CPU. При этом само приложение работало корректно — проблема была на уровне базы данных.
Подключили DBA и стали разбираться, что происходит. Выяснилось, что выполняется рекурсивный запрос, который создаёт избыточную нагрузку. Дальнейшее расследование привело к библиотеке AsyncPG, которая используется для работы с PostgreSQL. После обновления библиотеки проблема исчезла.
Кейс 8. Конфигурация HPA
Однажды нам нужно было настроить HPA — механизм Kubernetes, который автоматически увеличивает или уменьшает количество экземпляров приложения в зависимости от нагрузки.
Изначально параметры для HPA задавали на глаз: ориентировались на доступные ресурсы и предполагали, при какой нагрузке сервису понадобится дополнительный экземпляр. Но без тестов сложно понять, насколько эти значения соответствуют реальному поведению приложения.
Мы провели нагрузочное тестирование и посмотрели, как сервис расходует ресурсы при разном количестве запросов. На основании этих данных скорректировали настройки HPA и привязали их к фактическому поведению системы.
Что объединяет все эти случаи
За этими кейсами стоят самые разные проблемы — от отказа базы и роста нагрузки до обновления библиотеки и настроек HPA. На первый взгляд они никак не связаны. Но во всех случаях есть общий элемент: проблема становится заметной или воспроизводимой только при определённой нагрузке.
Важно отметить, что нагрузочное тестирование — это не попытка намеренно «положить» сервис. Его задача обратная:
заранее понять, где находится реальный предел системы;
подтвердить, что система выдерживает ожидаемый рост;
найти конкретную точку оптимизации;
понять, как сервис поведёт себя при отказе зависимости.
Именно поэтому нагрузочные тесты полезны не только перед большим релизом. Они помогают увидеть ограничения системы в контролируемых условиях и исправить их до того, как с ними столкнутся реальные пользователи.
С чего начать нагрузочное тестирование
На практике далеко не каждому сервису нужно нагрузочное тестирование. Обычно его применяют, когда:
сервис участвует в критическом бизнес‑процессе;
ожидается рост нагрузки или появляется новый массовый сценарий;
меняется архитектура или переносится функциональность;
появляется новая интеграция или меняется работа с БД;
были инциденты, связанные с производительностью;
команда не знает реальную пропускную способность сервиса.
Не обязательно сразу строить сложную систему нагрузочного тестирования. Для первого этапа достаточно выбрать один‑два критичных сценария и сформулировать, что именно нужно проверить: пропускную способность, время отклика, потребление ресурсов, поведение при росте нагрузки, устойчивость к сбоям.
Дальше можно постепенно усложнять тесты: добавлять больше запросов, увеличивать длительность нагрузки, проверять разные сценарии и искать узкие места.
А чтобы было проще начать, мы сделали репозиторий с готовыми нагрузочными скриптами, инструментами и тестовой системой. Параметры можно менять и запускать эксперименты, а результаты смотреть через локальный Grafana.