Введение
Обычно стек для RAG‑систем и AI‑агентов строится вокруг облачных API (OpenAI, Anthropic) и управляемых векторных баз. Но для ряда задач критически важна полная автономность: устойчивость к санкциям и независимость от внешних провайдеров.
В этой статье я расскажу, какие архитектурные решения и инженерные компромиссы позволили мне построить такую систему полностью на локальных моделях. Мы пройдем путь от сбора RSS‑лент до умного агента, который сам вызывает инструменты, и разберём грабли, на которые я наступил.
Стек: Python 3.12, FastAPI, PostgreSQL + pgvector, Celery, LangGraph, Ollama (Qwen 2.5 14B, BGE‑M3), Streamlit, Langfuse, Docker.
Архитектура
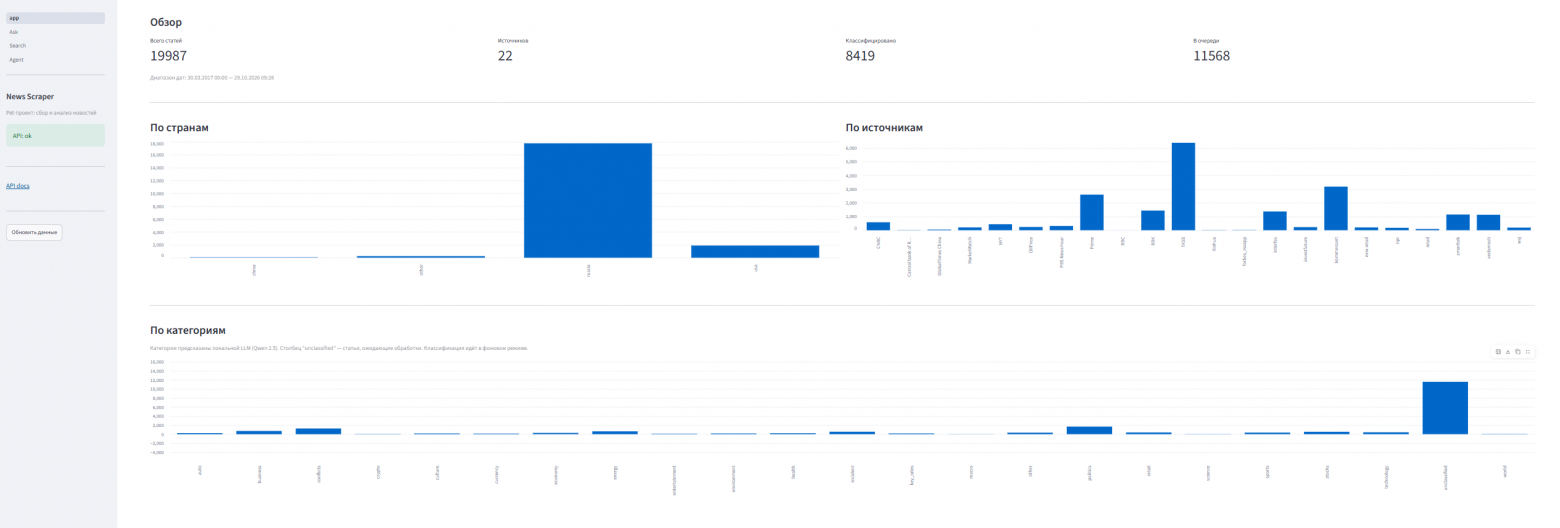
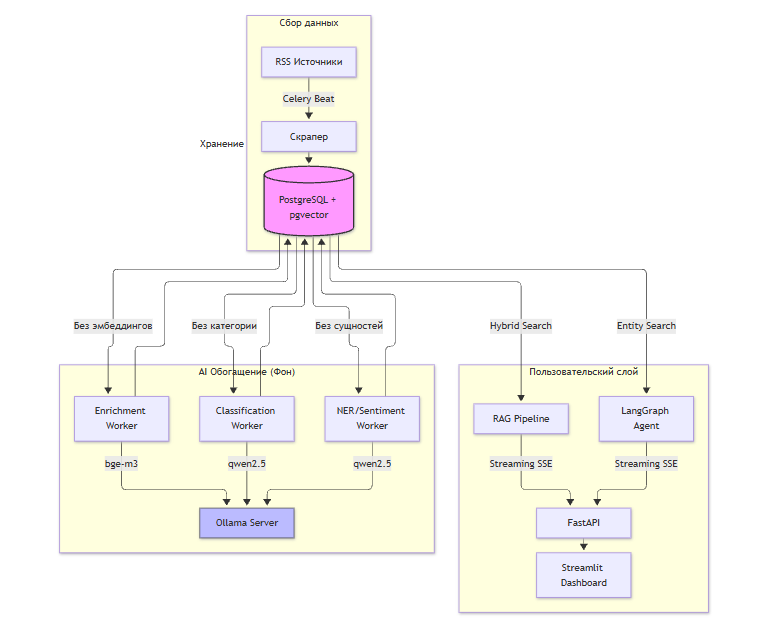
Проект разделен на слои (domain, db, scraper, rag, agents, api). Главный принцип — изоляция доменной логики от фреймворков. Это позволяет легко менять LLM или фреймворк, не переписывая бизнес‑логику.
Выбор поиска
Мы собрали 12 000+ статей. Закинули их в эмбеддинги (BGE‑M3) и стали искать по косинусному расстоянию.
На простых запросах всё работало. Но на сложных (например, «ключевая ставка ЦБ») векторный поиск выдавал мусор. Самым наглядным стал запрос «золото»: система честно находила статьи, где фигурист «взял золото» на соревнованиях, а не новости о ценах на металл. Классическая проблема омонимии.
Решение — Hybrid Search: мы объединили семантический поиск (векторы) с точным лексическим (BM25 на PostgreSQL tsvector) через алгоритм RRF (Reciprocal Rank Fusion). BM25 отлично ловит точные термины («золото», «ОПЕК», «ставка»), а векторы — синонимы. Благодаря этому Recall@5 вырос с 0.2 до 0.53.
Проблема «кучи мусора»: как LLM пряталась в категории Other
Мы попросили LLM классифицировать статьи. Первый результат: 74% статей улетели в категорию other. Модель боялась ошибиться.
Решение: мы переписали промпт, добавили четкие описания для каждой категории (включая retail, macro, incident) и убрали фразу «если сомневаешься — other».
Результат: other сократился до 0.03%. Теперь у нас структурированный датасет, а не куча текста.
Но это не финальная точка. После завершения фоновой обработки я провел раунд ручной оценки качества (Data‑Centric AI): взял случайную выборку статей из разных категорий и проверил, действительно ли LLM разметила их корректно. Точность классификации составила 85%, что подтвердило работоспособность подхода.
LangGraph: агент, который умеет считать
Обычный RAG отвечает на вопросы «Что пишут про нефть?». Но нам нужна аналитика. Мы написали State Machine на LangGraph с тремя инструментами:
search_articles: обычный гибридный поиск.get_metrics: SQL‑агрегация (сколько статей про энергетику за 3 дня).search_by_entity: поиск по извлеченным именам компаний и тональности (NER/Sentiment).
Теперь на вопрос «Есть ли негативные новости про ЦБ?» агент сам решает вызвать нужный инструмент.
Observability: как мы видим, что происходит внутри
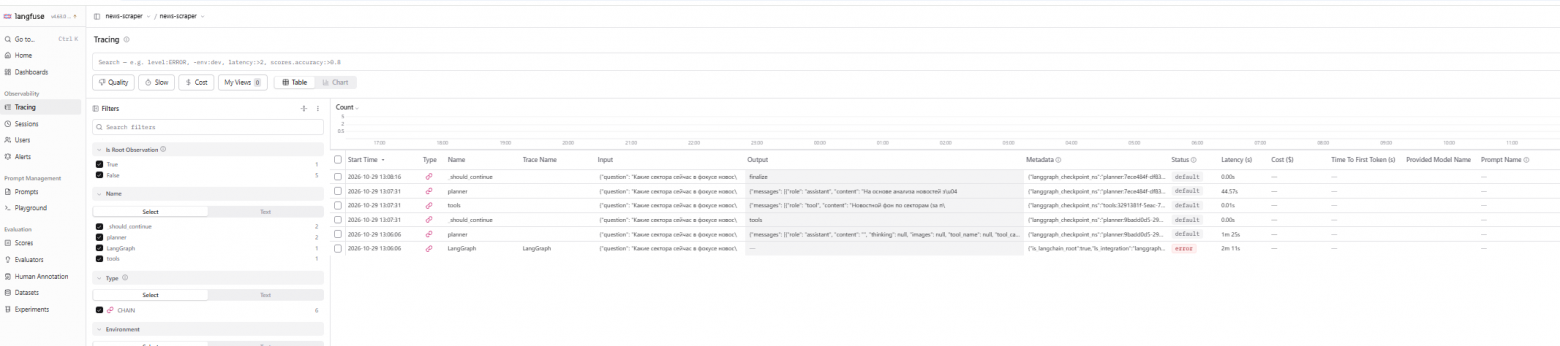
Мы развернули self‑hosted Langfuse. Мы видим каждый шаг агента (Planner → Tools → Finalizer), сколько токенов сожгли, и какие аргументы LLM передала в инструменты. Это бесценно при отладке.
Главные грабли (и как мы их обошли)
VRAM Ping‑Pong: Ollama выгружала модели при переключении. Запрос занимал 60 секунд. Лечится установкой
OLLAMA_MAX_LOADED_MODELS=2.LangChain Overhead:
ChatOllamaвнутри себя использует streaming aggregation, что давало 9 x замедление. Мы выкинули LangChain из RAG‑пайплайна и перешли на прямойollama.AsyncClient.Celery + Async: SQLAlchemy привязывает пул соединений к event loop. Когда Celery убивал задачу, соединения «зомбировали». Лечится через
await engine.dispose()после каждой задачи.Ollama обрабатывала запросы последовательно. Классификация довольно длительная процедура, на моём железе это было примерно 10 секунд на статью, увеличив значение
OLLAMA_NUM_PARALLEL=1до 2, я ускорил процесс минимум в 1.5 раза (здесь есть с чем ещё поиграть).
Что дальше?
Сейчас проект находится в стадии Public MVP. Это отличная база для демонстрации экспертизы в AI‑инженерии. Следующим шагом (уже в закрытом режиме) станет переход от «общего новостного фона» к персональной биржевой аналитике: привязка компаний к тикерам Мосбиржи (SBER, GAZP), извлечение конкретных рыночных фактов и построение прогнозных дашбордов по конкретным акциям. Архитектура (ADR-001) специально спроектирована так, чтобы это расширение не потребовало переписывания ядра.
Код проекта открыт и доступен на GitHub: [https://github.com/tzar26/news_scrapper].
Вывод
Построить production‑ready AI‑систему на локальных моделях — реально. Это не только экономит деньги, но и дает полный контроль над данными. Проект полностью контейнеризирован (docker compose up -d) и покрыт тестами (GitHub Actions).