Кодирование, SC-декодирование и немного симуляции
Тема данной статьи относится к помехоустойчивому кодированию в системах передачи информации, и предполагает знакомство с базовыми понятиями общей теории связи.
Целью статьи является подробный разбор полярного кодирования и SC-декодирования.
Полярные коды придумал Эрдал Арикан в 2008 году, и это, пожалуй, редкий случай, когда код с математическим доказательством достижимости пропускной способности канала доехал до стандарта связи 5G NR (3GPP TS 38.212).
Теории по полярным кодам много, и она сравнительно тяжёлая: мартингалы, эволюция плотностей, теорема о поляризации. Но устроены полярные коды на удивление просто — настолько, что полный рабочий код (кодер + декодер + симуляция канала) укладывается в сотню строк без единой внешней библиотеки.
Эта статья — про механику. Мы возьмём достаточно короткий полярный код (8, 4), и, условно говоря, потрогаем его руками: разберем маску, процедуру кодирования, два сценария SC-декодирования (в одном ошибка исправляется, в другом — нет), а потом сверимся с симуляцией. Все числа в таблицах декодирования целые — их можно посчитать в уме.
Статья опирается на авторский учебный материал по алгебре LLR, где разобрана база мягкого приёма (то, откуда происходит Log-Likelihood-Ratio, LLR), модуляция КАМ-16, коды Рида-Маллера, полярные коды и методика расчёта полярной последовательности. Здесь мы сосредоточимся на логике кодера и SC-декодера, принимая формулы для LLR как данность.
1. Поляризация в миниатюре: бабочка из двух бит
Пусть у нас есть результат мягкого приёма двух битов в виде двух LLR,  и
 , соответственно. Напомним: если
 — скорее был передан бит ноль, если
 — скорее был передан бит единица,
 — степень уверенности приемника. Величина
 вычисляется в процессе оптимальной обработки принятого сигнала, и, можно сказать, прямо пропорциональна коэффициенту корреляции между принятым импульсом и переданным.
Пусть исходные биты  были переданы не напрямую, а с помощью кодирования, которое называют "бабочкой":
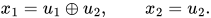
Декодирование таких битов происходит в два этапа: сначала оценивается первый бит, затем — второй:
Шаг 1. Из-за кодирования информация о декодируемом бите  содержится в обоих принятых битах, потому что верно равенство:
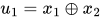 . Известно, что метрика (т.е. LLR) декодируемого таким способом бита — это «мягкая сумма» (она же box-plus, равенство ниже является строгим):
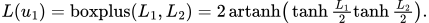
Шаг 2. Пусть бит уже декодирован (т.е. по вычисленной LLR принято решение  ). Тогда, с одной стороны,
 , а с другой —
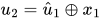 , то есть наблюдение (приём)
 также как и наблюдение
 несёт информацию о бите
 , но правда с условием, зависящим от принятого решения :
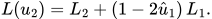
Записанная выше сумма и есть "исключение" (cancellation): мы исключили из метрики правого бита уже принятое решение по левому. Отсюда и название алгоритма декодирования — Successive Cancellation, SC. Однако, арифметически же здесь будет сложение: либо двух положительных чисел, либо двух отрицательных, причем знак суммы будет зависеть от знака . То есть по модулю сумма будет больше модулей входящих в нее слагаемых. Именно поэтому в таблице ниже для наглядности берутся только положительные LLR, и для правого канала они только складываются — это необходимо и достаточно, чтобы проанализировать надёжности подканалов.
Посчитаем. Пусть для простоты  :
Подканал | Метрика | Значение | Что это значит |
|---|---|---|---|
|
| 1.33 | хуже исходного |
|
| 4.00 | лучше исходного |
 (левый,
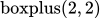
 (правый,

За счёт кодирования каналы поляризовались: левый стал хуже, правый — лучше.
Чтобы сконструировать более длинные коды, к вышеописанной процедуре кодирования применяется рекурсия. Для получения  подканалов, кодирующую "бабочку" применяют не к двум битам, а в общем случае к двум половинам некоторого вектора: складывают их поэлементно, результат пишут в левую половину (правую при этом не трогают), после чего "бабочку" независимо повторяют внутри каждой половины — и так пока не дойдут до одного элемента.
Описанной выше рекурсивной процедуре можно сопоставить m-уровневое дерево, причем на каждом уровне выполняется  сложений XOR, т.е. в итоге
 операций XOR. Доказано, что при больших длинах кода
 часть подканалов (после всех трансформаций) окажется очень плохой, часть — очень хорошей. В плохие позиции пишутся замороженные биты (нули, известные декодеру), в хорошие — информационные биты. Отсюда и происходит полярный код: он построен на факте поляризации каналов, а не на геометрии кодовых расстояний, как, например, коды Рида-Маллера или Хэмминга.
Кстати, полярный код является близким родственником кода Рида-Маллера: у них одна и та же рекурсивная конструкция (конструкция Плоткина — способ гарантированного наращивания кодового расстояния), только базовая матрица ( размером 2x2, смотри ниже) транспонирована, а строки для порождающей матрицы
 отбираются по-разному: у кода Рида-Маллера — по весу Хемминга, у полярного кода — по надёжности подканала.
2. Матрица Арикана и рекурсивный кодер
Всё полярное кодирование — это по сути умножение на базовую матрицу
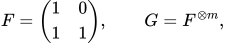
где  — кронекерово произведение,
 . Для
 имеем
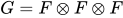 — порождающая матрица размером 8×8, у которой строки
 весят как
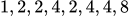 , соответственно. Правило такое: вес строки с индексом
 равен
 , где
 — число единиц в двоичной записи (скажем,
 — это две единицы, значит вес строки равен 4). Причина удвоения в том, что строка порождающей матрицы кода
 — тензорное произведение строк , отобранных битами : у базовой матрицы строк две и весят они по 1 и 2, а вес при тензорном произведении перемножается.
Строки с малым весом как правило попадают в "плохие" подканалы, и замораживаются именно они. Но это всего лишь ориентир, а не правило, потому что вес Хэмминга одинаков у всех строк с равным числом единиц, а надёжность внутри такой группы строк различается на порядки. Это видно в таблице раздела 3. Поэтому маску кода формируют по надёжности, и именно поэтому нужны специальные методы её расчёта. Для кода с параметрами  и
 так получилось, что четыре самые "тяжёлые" строки и есть четыре самых надёжных.
У рассматриваемой матрицы есть замечательное свойство над полем GF(2): матрица обратна самой себе. Это значит, что в отсутствии шума процесс декодирования заключается в умножении принятого вектора на . Вся сложность декодирования появляется только из-за наличия шума, и решается она не только алгеброй, но и мягкими метриками (т.е. LLR).
За кронекеровым произведением на самом деле стоит рекурсия по половинам:
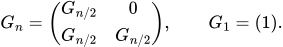
Если умножить вектор типа 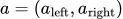 на такую матрицу слева, то окажется, что левая половина этого вектора складывается с правой, правая не трогается. Обозначим такую операцию как
 . Затем операция независимо применяется к каждой половине вектора, и т. д.
В таблице ниже показана схема так называемых соединений: в предпоследней колонке перечислены номера позиций (какие два бита складываются), в последней — что при этом получается из вектора u = 0001 0011 (здесь рассмотрен тот же вектор, что и в разделе 4):
Уровень | Бабочек | Длина блока | Складываем позиции | Вектор после уровня |
|---|---|---|---|---|
0 | 1 | 8 | (0,4) (1,5) (2,6) (3,7) |
|
1 | 2 | 4 | (0,2) (1,3) и (4,6) (5,7) |
|
2 | 4 | 2 | (0,1) (2,3) (4,5) (6,7) |
|
Читается так: на уровне 0 позиция 0 складывается с позицией 4, позиция 1 — с позицией 5, и так далее; левая половина превращается в 0010, а правая 0011 не меняется. Уровней  , на каждом ровно
 сложений — итого
 операций XOR.
Полярное кодирование просто реализуется через рекурсию (in-place), без расхода лишней памяти:
// Рекурсивное ядро: левая половина = u1 ^ u2, правая = u2, затем рекурсия.
void polar_encode_core(std::span<int> x) {
    const std::size_t n = x.size();
    if (n <= 1) return;
    const std::size_t h = n / 2;
    for (std::size_t i = 0; i < h; ++i) x[i] ^= x[h + i];
    polar_encode_core(x.subspan(0, h));
    polar_encode_core(x.subspan(h, h));
}

Bits polar_encode(const Bits& info, const Bits& mask) {
    Bits u(mask.size(), 0);   // замороженные позиции = 0
    for (std::size_t i = 0, j = 0; i < mask.size(); ++i)
        if (mask[i]) u[i] = info[j++];
    polar_encode_core(u);
    return u;
}
Полтора десятка строк и кодер готов. Сложность  , и она не зависит от того, сколько битов заморожено (т.е. от скорости кода
 ): вычисляется всегда полная "бабочка". Заметим: в отличие от рекурсивного кодера Рида-Маллера (смотри пособие Алгебра LLR), полярный кодер не подрезает ветви дерева по параметру
 — ему это не нужно, маска уже всё определила.
3. Откуда берётся маска
Маска, которая следует из полярной последовательности, — это ответ на вопрос "какие позиции надёжнее". В стандарте 5G NR (TS 38.212, Table 5.3.1.2-1) задана универсальная последовательность индексов (1024 индекса), упорядоченная по надёжности. Её начало:
0, 1, 2, 4, 8, 16, 32, 3, 5, 64, 9, 6, 17, 10, 18, 128, …
Первый индекс — самый ненадёжный, последний — самый надёжный. Для  берём только индексы , сохраняя порядок:
0, 1, 2, 4, 3, 5, 6, 7. Четыре лучших позиции — это  , значит маска:
   позиция:  0 1 2 3 4 5 6 7
   маска:    0 0 0 1 0 1 1 1   ->  "00010111"
Маска — это  единиц (информационные биты) в
 позициях; скорость кода
 .
Откуда берутся сами числа? В стандарте последовательность задана не расчётом "в лоб", а эмпирической формулой для так называемого веса:
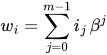 ,
где  ,
 , а
 — это
 -й бит двоичной записи индекса , считая от младшего:
 даёт младший бит (вес
 ),
 — старший. Индексы сортируются по возрастанию
 : чем больше вес, тем надёжнее подканал. Метод называется Polarization Weight, PW.
Для  получается:
 ,
 ,
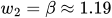 ,
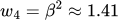 ,
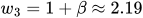 ,
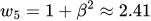 ,
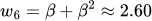 ,
 —
порядок 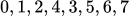 в точности как в таблице выше.
Константу подбирали по расчётам надёжности:
 — компромисс, при котором порядок ближе всего к точному расчёту — Density Evolution (DE, "эволюция плотностей") — и к его упрощению, гауссовской аппроксимации (Gaussian Approximation, GA), сразу для всех длин и скоростей. В учебном пособии Алгебра LLR разобран метод GA.
Строго говоря, таблица 5G — не дословный результат формулы: окончательный порядок доводили моделированием, с учётом кодового расстояния и списочного декодирования (SCL), и от чистой сортировки по он отличается примерно в 1% пар индексов. Вложенность при этом сохраняется точно.
Что такое вложенность
Вложенность (nested property) таблицы из 1024 индексов в 5G — это свойство универсальной последовательности надежности полярных кодов (Polar Sequence) в стандарте 3GPP 5G NR (спецификация TS 38.212), которое позволяет использовать одну и ту же таблицу для построения полярных кодов любой меньшей длины (N = 32, 64, 128, 256, 512) без необходимости хранить в памяти устройства отдельные таблицы для каждого размера блока.
Вот, например, что выдаёт расчёт надёжностей методом GA для  ,
 , проектный SNR 2 дБ (значения в таблице — десятичный логарифм вероятности ошибки в подканале, взятый со знаком минус; чем показатель больше, тем лучше):
Канал | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|---|
| 0.49 | 0.87 | 0.99 | 1.91 | 1.14 | 2.23 | 2.47 | 4.76 |

Канал | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 |
|---|---|---|---|---|---|---|---|---|
| 1.35 | 2.63 | 2.86 | 5.52 | 3.13 | 6.04 | 6.62 | 12.27 |
Жирным отмечены информационные позиции. Видно, что поляризация — это не "на пару процентов лучше", а разброс на много порядков по вероятности ошибки: канал 0 имеет  , а канал 15 —
 . Ровно на этом эффекте и строится выигрыш длинных полярных кодов.
Для  из этой же таблицы (ограничившись каналами 0…7) получаем те же четыре лучших позиции
 , что и по стандартной 5G-последовательности.
4. Кодирование (8, 4) по шагам
Возьмём информационные биты 1011 и расположим их в соответствии с уже известной маской:
   маска:  0 0 0 1 0 1 1 1
   u    :  0 0 0 1 0 0 1 1     <- 1011 попало в позиции 3, 5, 6, 7
Теперь прогоняем рекурсию:
левая половина = левая половина
 правая,
правая не меняется,
рекурсия в обе половины.
Уровень | Вектор до | Что делаем | Вектор после |
|---|---|---|---|
0 (n=8) |
|
|
|
1A (n=4) |
|
|
|
2A (n=2) |
|
|
|
1B (n=4) |
|
|
|
2B (n=2) |
|
|
|
Кодовое слово: x = 1 0 1 0 0 1 0 1.
Проверка на прочность: у этого кода  (перебраны все 16 кодовых слов: 14 слов веса 4 и одно веса 8). Это в точности спектр расширенного кода Хэмминга
 — он же самодвойственный Рида-Маллера RM(1, 3). Приятный факт: для
 ,
 полярный код совпал с классикой, и это лучшее, что вообще можно сделать при таких параметрах.
5. SC-декодер: две функции и одна маска
Декодер идёт по тому же кодовому дереву, что и кодер, но помимо битовых XOR выполняются "мягкие" операции:
f-функция ("мягкая" сумма, для левого поддерева) — точный box-plus и его практичная аппроксимация min-sum:
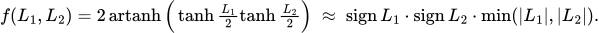
Min-sum теряет по итогу 0.1–0.2 дБ, но считается на целочисленной арифметике и без трансцендентных функций — на практике в железе и в симуляционном коде ниже используется именно он. Точное значение при  , как мы помним, 1.33, а min-sum даст 2.0 — видно, что приближение "оптимистично".
g-функция (cancellation, для правого поддерева), где буквой 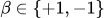 обозначен уже принятый бит в формате знака (биту 0 соответствует
 , биту 1 соответствует
 ):
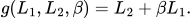
Лист дерева. Если позиция заморожена, то пишем 0 и не смотрим на LLR вообще (это эквивалентно подстановке  — идеальной априорной информации); если позиция информационная, то принимаем жёсткое решение по знаку текущего LLR:
// f (мягкая сумма, min-sum): знак = произведение знаков, модуль = минимум.
static double f_llr(double a, double b) {
    const double s = ((a >= 0.0) == (b >= 0.0)) ? 1.0 : -1.0;
    return s * std::min(std::abs(a), std::abs(b));
}
// g (cancellation): beta -- уже принятый бит ±1 (beta = +1 для нуля).
static double g_llr(double a, double b, double beta) { return b + beta * a; }

// beta -- кодовое слово (partial sums) поддерева, в формате ±1.
void sc_core(const double* l, std::size_t n, const Bits& mask, std::size_t off,
             Bits& u, double* beta) {
    if (n == 1) { // достигли листа: инф. бит -> решение; замороженный бит -> 0.
        const int bit = mask[off] ? (l[0] >= 0.0 ? 0 : 1) : 0;
        u[off] = bit;
        beta[0] = bit ? -1.0 : 1.0;
        return;
    }
    const std::size_t h = n / 2;
    Vec lu1(h), lu2(h);
    for (std::size_t i = 0; i < h; ++i) lu1[i] = f_llr(l[i], l[h + i]);
    sc_core(lu1.data(), h, mask, off, u, beta);  // левая половина
    for (std::size_t i = 0; i < h; ++i) lu2[i] = g_llr(l[i], l[h + i], beta[i]);
    sc_core(lu2.data(), h, mask, off + h, u, beta + h);    // правая половина
    for (std::size_t i = 0; i < h; ++i) beta[i] *= beta[h + i]; // Восстанавливающий XOR
}
Двадцать с лишним строк — и декодер готов. Обратите внимание на тонкость, на которой легко споткнуться: в  -функцию подставляется не декодированный информационный бит левого поддерева, а его кодовое слово (partial sums), восстановленное по этому поддереву. Именно поэтому в конце каждого узла считается
beta[i] *= beta[h+i] — это XOR половин в формате ±1, то есть обратное преобразование Арикана для уже принятых битов.
Сложность та же, что у кодера:  , памяти
 на рекурсию.
6. Сценарий декодирования: одна ошибка в канале
Пусть передали уже рассмотренный ранее вектор x = 10100101, а приняли следующие LLR (рассматриваем ФМн-2 в АБГШ, где  , знак: плюс — бит ноль, минус — бит единица):
   x   :   1    0    1    0    0    1    0    1
   LLR :  -2    4   -3    2    2    5    6   -3
Смотрите на позицию по индексу 5: передавали единицу, а LLR положительный — в канале произошла ошибка. Посмотрим, что сделает декодер (все числа для взяты целыми, что удобно для алгоритма "min-sum").
Столбец "Узел" в таблице ниже содержит адрес узла в дереве рекурсии (том же дереве, что и у кодера). Строка из нулей и единиц — маршрут от корня: 0 — ушли в левую половину, 1 — в правую; число в скобках — длина блока, который в этом узле обрабатывается. Скажем, "01 (2)" читается так: корень → налево (блок 0…3) → направо, то есть пара позиций 2–3. У корня маршрут пустой, поэтому он так и подписан — "корень (8)". Биты в этом столбце — не декодированные данные, а именно маршрут; информационные биты появляются только в листьях, в колонке "Результат". Дерево то же, что в разделе 4, только там узлы подписаны по уровням (1A, 2B), а здесь — маршрутом от корня.
Обратите внимание, что один и тот же узел встречается дважды — это не дубль, а два разных захода: сначала декодер входит в узел и считает  для левого ребёнка, а второй раз — вернувшись из левого поддерева — считает для правого (узел "0 (4)" — строки 2 и 5, и узел "00 (2)" — строки 3 и 4). Номера в первом столбце — просто порядок операций.
# | Узел | Вход | Вход | Операция | Результат |
|---|---|---|---|---|---|
1 | корень (8) | −2, 4, −3, 2 | 2, 5, 6, −3 | f | −2, 4, −3, −2 |
2 | 0 (4) | −2, 4 | −3, −2 | f | 2, −2 |
3 | 00 (2) | 2 | −2 | f | −2 → лист |
4 | 00 (2) | 2 | −2 | g, | 0 → лист |
5 | 0 (4) | −2, 4 | −3, −2 | g, | −5, 2 |
6 | 01 (2) | −5 | 2 | f | −2 → лист |
7 | 01 (2) | −5 | 2 | g, | −3 → лист |
8 | корень (8) | −2, 4, −3, 2 | 2, 5, 6, −3 | g, | 4, 1, 9, −5 |
9 | 1 (4) | 4, 1 | 9, −5 | f | 4, −1 |
10 | 10 (2) | 4 | −1 | f | −1 → лист |
11 | 10 (2) | 4 | −1 | g, | 3 → лист |
12 | 1 (4) | 4, 1 | 9, −5 | g, | 13, −4 |
13 | 11 (2) | 13 | −4 | f | −4 → лист |
14 | 11 (2) | 13 | −4 | g, | −17 → лист |
 : заморожен → 0


 : инф. → 1
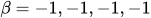
 : заморожен → 0
 : инф. → 1

 : инф. → 1
Получили 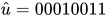 , считываем информационные позиции : 1011. Ошибка канала исправлена.
Обратите внимание на два места.
Строка 10. LLR на листе равен −1, то есть канал "говорит" единицу. Но позиция 4 заморожена, декодер ставит 0 и не спорит. Это и есть та самая подстановка : замороженный бит — гарантированная опора, которая "чистит" метрики справа от себя.
Строка 11. Здесь ошибка и была (позиция 5). Сырой LLR +5 после -функции превратился в +3: правый подканал "сложил" два независимых свидетельства и уверенно дал 0.
Откуда в строке 8 четыре  . Это кодовое слово (частичная сумма, partial sum) левой половины, восстановленное из уже принятых битов
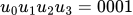 . Внутри узла 0 дважды сработало
beta[i] *= beta[h+i]: узел 00 (биты 0, 0) дал кодовое слово 00, узел 01 (биты 0, 1) — кодовое слово 11. После XOR половин в узле 0 получаем 1111, то есть 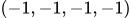 . Тот же результат даёт прогон 0001 через кодер из раздела 2 — можете проверить на бумаге. Отсюда и арифметика строки 8:
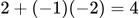 ,
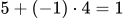 ,
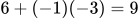 ,
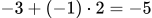 .
7. Когда шума больше, чем кода
Испортим ещё один бит: пусть канал сломал и позицию 1 (там заморозка), и позицию 5:
LLR : -2 -4 -3 2 2 5 6 -3
Прогон по тому же дереву даёт:
# | Узел | Операция | Результат |
|---|---|---|---|
1 | корень (8) | f | −2, −4, −3, −2 |
2 | 0 (4) | f | 2, 2 (было 2, −2) |
5 | 0 (4) | g, | −5, −6 (было −5, 2) |
6 | 01 (2) | f | 5 (было −2) |
7 | 01 (2) | g, | −11 → |
8 | корень (8) | g, | 4, 9, 9, −5 |
9 | 1 (4) | f | 4, −5 |
10 | 10 (2) | f | −4 → |
11 | 10 (2) | g, | −1 → |
 ✓ (угадали)
 : заморожен → 0 ✓
Декодировали 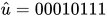 , информация — 1111 вместо 1011. Ошибка в одном бите.
Что произошло: замороженный бит ошибку "съел" (он всё равно ноль по построению кода), но его мягкая метрика протекла в правую ветвь: на листе  было +3, стало −1. Порог пересечён — и всё, что декодировалось после, уже строилось на неверном решении. Здесь мы наблюдаем размножение ошибок (error propagation), принципиальное свойство SC-декодера: алгоритм последовательного исключения жаден, он никогда не возвращается назад и не пересматривает решения.
Отсюда два практических следствия:
Замороженные биты надо ставить так, чтобы они образовывали сплошные блоки в начале (слева) — там, где подканалы хуже всего. Тогда к моменту первого информационного бита метрики уже "накачаны" суммированием, и вероятность "свалиться" меньше.
"Ванильный" SC — не предел. Основные улучшения: SCL (списочный декодер, хранит
гипотез и выбирает лучшую), CRC-aided SCL (CRC-11 как внешний отбор гипотез — именно это в 5G для данных), Fast-SSC (терминальные узлы Rate-0, Rate-1, Rep, SPC, чтобы не спускаться до отдельных битов), SCAN (итеративное распространение доверия, ближе к LDPC по духу).
Отдельно стоит упомянуть PAC-коды (Polarization-Adjusted Convolutional, Арикан, 2019, arXiv:1908.09594): перед полярным преобразованием в них стоит rate-1 свёрточное, а декодируют их последовательным декодером Фано. На коротких блоках они почти достигают дисперсионной границы (что это такое смотри в выводах в конце статьи).
8. Симуляция: что это даёт в децибелах
Соберём код (он в конце статьи) и прогоним 200 000 блоков по каналу АБГШ с ФМн-2,  = 0…6 дБ. Скорость кода
 , так что энергия на символ
 .
Сравнивать по BER неудобно: BER — промежуточная величина, которая зависит от того, сколько бит испорчено внутри неудачного блока, а системе связи важен сам факт срыва блока — именно по этому факту запрашивают повторную передачу. Поэтому фиксируем Block Error Rate, BLER — долю блоков, где испорчен хотя бы один бит (или Frame Error Rate, FER), — и смотрим, при каком он достигается с кодом и без.
Сравнение делается при равной средней энергии на один информационный бит. Без кода 4 бита занимают 4 такта (скорость 1,  ), с кодом — 8 тактов (скорость 1/2,
 ): код платит скоростью передачи — в том же диапазоне частот он отдаёт вдвое меньше битов в единицу времени. Всё, что мы дальше называем выигрышем, — это уже после такой платы.
Вероятность ошибки на бит без кода 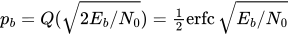 , поэтому блок из 4 бит срывается с вероятностью
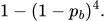
| BLER с кодом (8, 4) | BLER без кода (4 бита) | BER (8, 4) — справочно |
|---|---|---|---|
0 | 1.74e-1 | 2.79e-1 | 9.66e-2 |
1 | 1.10e-1 | 2.07e-1 | 6.12e-2 |
2 | 5.93e-2 | 1.42e-1 | 3.30e-2 |
3 | 2.69e-2 | 8.84e-2 | 1.50e-2 |
4 | 1.02e-2 | 4.91e-2 | 5.71e-3 |
5 | 2.77e-3 | 2.36e-2 | 1.57e-3 |
6 | 5.25e-4 | 9.52e-3 | 2.95e-4 |
Колонку BER оставили только для справки — по ней мы ничего не сравниваем. А по BLER видно главное: код выигрывает уже при 0 дБ (0.174 против 0.279), и с ростом ОСШ разрыв растёт — при 4 дБ это 1.02e-2 против 4.91e-2, при 6 дБ — 5.25e-4 против 9.52e-3.
Пересчитаем, используя интерполяцию, разницу BLER в энергетический выигрыш при фиксированном BLER:
Целевой BLER |
|
| Выигрыш, дБ |
|---|---|---|---|
1e-1 | 1.15 | 2.76 | 1.6 |
1e-2 | 4.02 | 5.95 | 1.9 |
1e-3 | 5.61 | 7.82 | 2.2 |
Точность здесь — десятые доли дБ: на 200 000 блоков относительная погрешность BLER около 10%, а это примерно ±0.1 дБ по ОСШ.
Выигрыш растёт по мере ужесточения требования: 1.6 → 1.9 → 2.2 дБ. Потолок для такого кода — асимптотический выигрыш 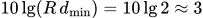 дБ; 2.2 дБ при BLER
 — это то, что остаётся после потерь min-sum и того, что SC в принципе не оптимален. Никакого чуда: полярный код длины 8 — это фактически расширенный Хэмминг, который гарантированно исправляет одну ошибку.
Важно понимать, откуда берётся выигрыш у длинных кодов. Полярная последовательность — характеристика статистическая: она расставляет подканалы по надёжности, и с ростом длины кода разрыв между хорошими и плохими подканалами растёт экспоненциально (см. таблицу из раздела 3). Поэтому длинный полярный код выигрывает не за счёт  , а за счёт того, что доля "почти идеальных" подканалов стремится к пропускной способности канала. Побочный эффект: у полярных кодов с SC-декодером бывает error floor из-за кодовых слов малого веса, и именно поэтому в 5G для данных применяют CRC-aided SCL, а не чистый SC.
9. Полный листинг
Всё вместе: кодер, SC-декодер и симуляция. Собирается одним g++ -std=c++20 -O2 polar.cpp -o polar, внешних зависимостей нет. Листинг ниже выдаёт ту самую таблицу из раздела 8:
Симуляция на С++
#include <algorithm>
#include <cmath>
#include <cstdio>
#include <cstdlib>
#include <random>
#include <span>
#include <vector>

using Bits = std::vector<int>;
using Vec = std::vector<double>;

// ---------------------- Кодер ----------------------
void polar_encode_core(std::span<int> x) {
    const std::size_t n = x.size();
    if (n <= 1) return;
    const std::size_t h = n / 2;
    for (std::size_t i = 0; i < h; ++i) x[i] ^= x[h + i];
    polar_encode_core(x.subspan(0, h));
    polar_encode_core(x.subspan(h, h));
}

Bits polar_encode(const Bits& info, const Bits& mask) {
    Bits u(mask.size(), 0);
    for (std::size_t i = 0, j = 0; i < mask.size(); ++i)
        if (mask[i]) u[i] = info[j++];
    polar_encode_core(u);
    return u;
}

// ------------------- SC-декодер -------------------
static double f_llr(double a, double b) {
    const double s = ((a >= 0.0) == (b >= 0.0)) ? 1.0 : -1.0;
    return s * std::min(std::abs(a), std::abs(b));
}
static double g_llr(double a, double b, double beta) { return b + beta * a; }

void sc_core(const double* l, std::size_t n, const Bits& mask, std::size_t off,
             Bits& u, double* beta) {
    if (n == 1) {
        const int bit = mask[off] ? (l[0] >= 0.0 ? 0 : 1) : 0;
        u[off] = bit;
        beta[0] = bit ? -1.0 : 1.0;
        return;
    }
    const std::size_t h = n / 2;
    Vec lu1(h), lu2(h);
    for (std::size_t i = 0; i < h; ++i) lu1[i] = f_llr(l[i], l[h + i]);
    sc_core(lu1.data(), h, mask, off, u, beta);
    for (std::size_t i = 0; i < h; ++i) lu2[i] = g_llr(l[i], l[h + i], beta[i]);
    sc_core(lu2.data(), h, mask, off + h, u, beta + h);
    for (std::size_t i = 0; i < h; ++i) beta[i] *= beta[h + i];
}

Bits sc_decode(const Vec& llr, const Bits& mask) {
    Bits u(mask.size(), 0);
    Vec beta(mask.size(), 1.0);
    sc_core(llr.data(), llr.size(), mask, 0, u, beta.data());
    return u;
}

// ---------------------- Симуляция ----------------------
int main() {
    const int n = 8, k = 4;
    const Bits mask = {0, 0, 0, 1, 0, 1, 1, 1};    // (8,4), R = 1/2
    const double rate = double(k) / n;
    const long blocks = 200000;

    std::mt19937 rng(12345);
    std::normal_distribution<double> gauss(0.0, 1.0);
    std::uniform_int_distribution<int> bit(0, 1);

    std::printf("\n Eb/N0, dB     FER     BLER(без кода)      BER\n");
    for (int ebn0 = 0; ebn0 <= 6; ++ebn0) {
        const double es_n0 = rate * std::pow(10.0, ebn0 / 10.0);
        const double sigma = std::sqrt(1.0 / (2.0 * es_n0));
        const double scale = 2.0 / (sigma * sigma);
        long fe = 0, be = 0, tb = 0;
        for (long blk = 0; blk < blocks; ++blk) {
            Bits info(k);
            for (int i = 0; i < k; ++i) info[i] = bit(rng);
            const Bits cw = polar_encode(info, mask);
            Vec llr(n);
            for (int i = 0; i < n; ++i)
                llr[i] = scale * ((1 - 2 * cw[i]) + sigma * gauss(rng));
            const Bits u = sc_decode(llr, mask);
            int e = 0;
            for (int i = 0, j = 0; i < n; ++i)
                if (mask[i]) e += (u[i] != info[j++]);
            fe += (e > 0);
            be += e;
            tb += k;
        }
        const double eb = std::pow(10.0, ebn0 / 10.0);
        const double p = 0.5 * std::erfc(std::sqrt(eb));      // BER ФМн-2 без кода
        const double bler0 = 1.0 - std::pow(1.0 - p, k);      // срыв блока из k бит
        std::printf(" %5d      %8.2e    %8.2e       %8.2e\n", ebn0,
                    double(fe) / blocks, bler0, double(be) / tb);
    }
    return 0;
}
10. Итоги
Полярный код — это рекурсивная "бабочка" из
 операций XOR у кодера и такая же бабочка из
 мягких операций у декодера
Вся "полярность" — в маске: плохие подканалы замораживаются нулями, и эти нули работают как "бесплатная" априорная информация, подставляемая вместо канальных LLR
SC-декодер — это жадный обход дерева:
(box-plus/min-sum) влево, (cancellation) вправо с подстановкой кодового слова левого поддерева. Ошибка в одном бите, в целом, ломает всё, что справаПолярный код (8, 4) побитово совпадает с расширенным кодом Хэмминга. По BLER полярный код даёт энергетический выигрыш (по сравнению с некодированной ФМн-2) около 1.6 дБ при
 , 1.9 дБ при
 и 2.2 дБ при — и это на блоке длиной всего 8 бит, где коду почти негде развернуться. Настоящая магия классических полярных кодов начинается с длин в тысячи бит и с использованием SCL/CRC — там они почти доезжают до предела Шеннона. А достаточно новые так называемые PAC-коды с декодером Фано вплотную подходят к дисперсионной границе (границе Полянского — Пур — Верду, PPV) уже на сотне-другой бит:
Дело в том, что граница PPV более практична, потому что она уточняет классический предел Шеннона для кодов конечной длины
. Максимально достижимая скорость передачи при целевой вероятности ошибки на блок оценивается примерно как: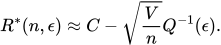
Если пропускная способность
 — это математическое ожидание взаимной информации (средняя "ёмкость" канала при
 ), то дисперсия канала
 — её статистический разброс,
 — обратная
 -функция (функция "хвоста" стандартного нормального распределения). Сама функция
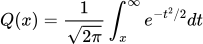
показывает вероятность того, что гауссовский шум превысит порог
 , а её обратное значение задаёт, на сколько стандартных отклонений нужно отступить от среднего, чтобы уложиться в заданную вероятность ошибки
 . Для коротких кодов случайные выбросы шума не успевают усредниться, и именно эта дисперсия накладывает неустранимый "штраф" пропорционально
 . Приближение к этой кривой означает, что PAC-код выжимает из короткого блока практически всё, что позволяют законы физики.
Интересно отметить, что ядро Арикана (базовая матрица
) может быть использована для вероятностного формирования созвездия модуляции (Probabilistic Constellation Shaping, PCS), целью которого является более экономное расходование мощности передатчика при той же помехоустойчивости (это к теме разработки мобильной связи поколения 6G).Помимо классического ядра Арикана, в исследованиях используют смешанные ядра: на некоторых уровнях используют матрицы размером 3x3 и 5x5 — это позволяет более гибко задавать длину кода наподобие
 , и дополнительно ускоряет поляризацию каналов (приближение к границе PPV будет лучше при фиксированной длине кода). Математика при этом усложняется не сильно (это также относится к разработке стандарта 6G, где данный подход конкурирует с PAC-кодами).
Полная версия (Fast-SSC, Рид-Маллер, КАМ-16, расчёт полярной последовательности методом GA) — в репозитории: https://github.com/nawww83/rm_soft. Там же и учебный материал по алгебре LLR, из которого выросла эта статья.