

Мне тут подкинули задачку: оценить возможности карточек Mellanox ConnectX-6. Эти карты относятся к классу умных (SmartNIC), поэтому могут не просто считать контрольные суммы и сегментировать пакеты, им по силам трансляция IP-адресов (NAT), L4-балансировка и L3-маршрутизация. Обычно эти функции выполняются в ядре Linux на центральном процессоре, но в теории с помощью умной карты их можно перенести в железо, высвободив вычислительные ресурсы CPU.
Я решил сравнить производительность двух сред (процессор общего назначения и специализированный ASIC) и узнать насколько можно ускорить работу сетевого стека. В этой статье сразу расскажу, чего намерил, подробно опишу свои злоключения по сборке стенда, ну а начну с короткого обзора умных карт Mellanox ConnectX. Надеюсь, материал поможет коллегам-архитекторам трезво оценить возможности карты в своих проектах, а инженерам-сетевикам подобрать рабочие конфигурации, обойдя набитые мной шишки.
Ну и кто знает, может кто-то из вас подскажет мне, почему кое-что не взлетело.
Long story short:
DOCA показала ускорение в 16 раз для UDP и в 10 раз для TCP относительно system.
TCP-балансировка: ускорение в 3,5 раза.
UDP NAT и UDP-балансировка: корректной работы в этой конфигурации добиться не удалось.
Результаты относятся к ConnectX-6 Lx (25 Гбит/с) и описанным ниже условиям тестирования. Сначала стенд, затем — подробную установку и конфигурацию для воспроизведения.
Что именно я сравнивал: system и DOCA
Отличительной чертой умных карт от Mellanox является наличие множества специализированных модулей для обработки трафика: шифрование/дешифрация, модуль RDMA-транспорта и модуль обработки пакетов (Accelerated Switching and Packet Processing — ASAP2). Меня больше всего привлек модуль ASAP2, потому что он может инкапсулировать/декапсулировать VXLAN/Geneve туннели, тегировать VLAN-трафик, отслеживать соединения (conntrack) и содержит аппаратный match-action конвейер. Именно этот модуль позволяет развернуть нужные мне сетевые сущности (NAT, балансировщик и маршрутизатор) прямо на сетевой карте.
Для управления этим аппаратным комплексом компания-производитель создала отдельный фреймворк DOCA. Он состоит из драйверов, библиотек и готовых сервисов. Чтобы сконфигурировать аппаратный конвейер ASAP2 для обработки трафика, можно воспользоваться библиотекой DOCA Flow и написать свой собственный конвейер обработки. Или поступить как я — воспользоваться готовым сервисом OVS-DOCA.
OVS-DOCA — это полнофункциональный Open vSwitch, в который добавлен новый тракт данных (datapath) — DOCA, обрабатывающий пакеты на самой карточке. Сервис также поддерживает и классические тракты:
netdev (он же DPDK) — обрабатывает пакеты в пространстве пользователя;
system — обрабатывает пакеты в пространстве ядра Linux.
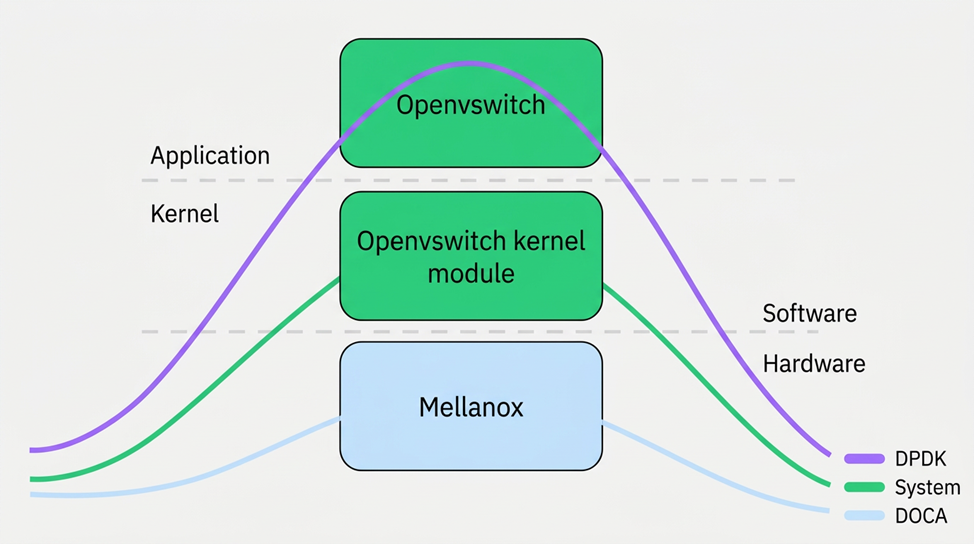
Mellanox считает DPDK-тракт устаревшим, вместо него официально рекомендуют использовать DOCA. Это только усилило мой интерес: захотелось на практике проверить, как логический маршрутизатор, NAT и балансировщик работают под нагрузкой на базе этой технологии.
Сразу оговорюсь, что в этой работе я сравнивал только system и DOCA. DPDK буду исследовать в следующий раз, заодно и узнаем: такой ли уж он устаревший.
Одной из самых сложных задач в этой работе было собрать сам стенд для измерений. Я покажу, к чему пришел в итоге, а самые любопытные ниже смогут узнать почему это выглядит именно так, как выглядит.
Стенд: серверы, сети и финальная схема
Для тестирования у меня было три сервера:
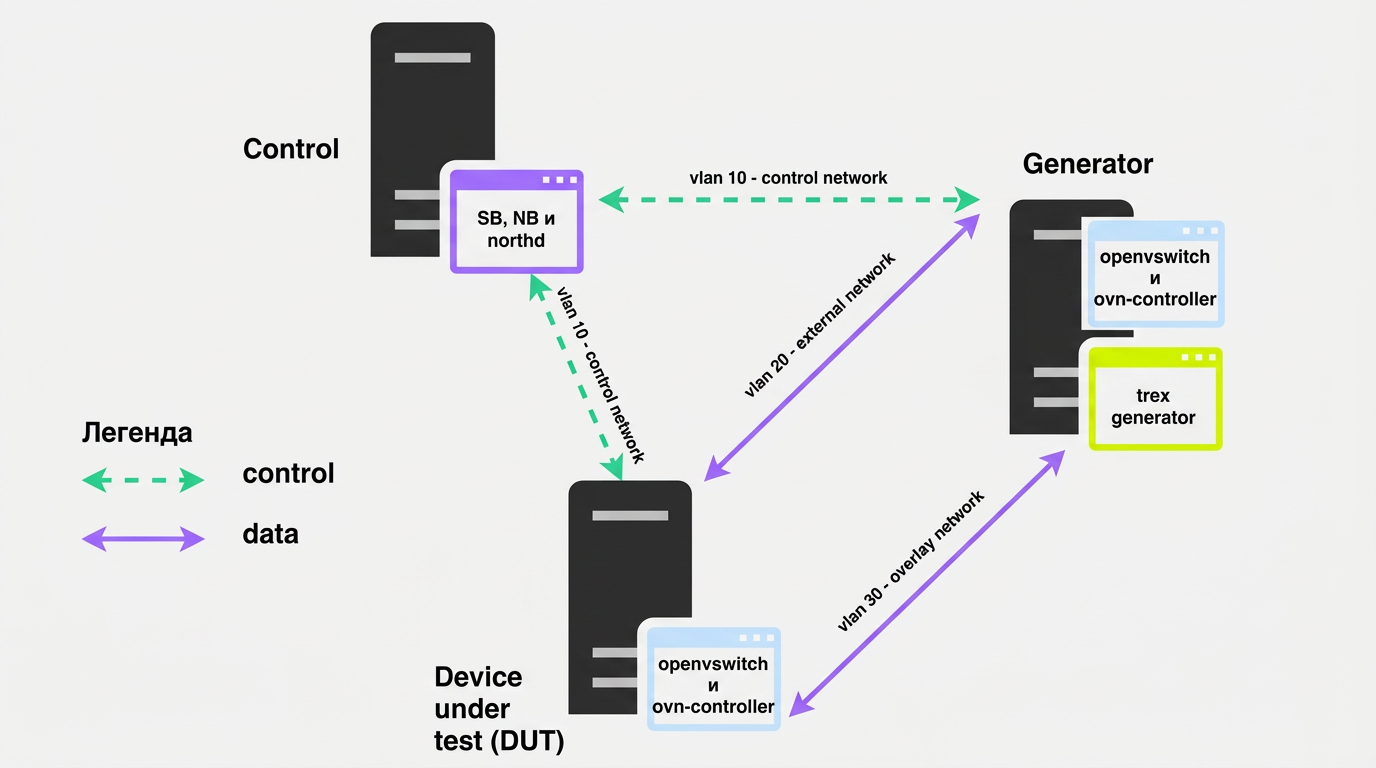
Управляющий — на нем были запущены северная и южная OVN базы.
Устройство под тестированием (DUT он же Device under test) — на нем был запущен Open vSwitch сконфигурированными логическими сетевыми функциями (NAT, балансировщик и маршрутизатор),
Генератор пакетов — отдельный сервер с запущенным Trex. Он эмулировал облако пользователей и облако серверов обработки.
Спецификация у всех серверов одинаковая:
CPU: 2 processors x 16 cores x 2 threads;
RAM: 768GB;
Сетевая карта: Mellanox Technologies MT2894 Family [ConnectX-6 Lx], firmware-version: 26.47.1026, Speed: 25000Mb/s;
ОС: SberLinux 9.4;
Ядро Linux: 5.14.0-611.47.1.sl9_7^2.x86_64.
Физических сетей у меня было всего две: одна для подключения к серверам по SSH, вторая полностью под тестирование. Но чтобы максимально приблизится к продуктовому окружению, нужно три сети:
External — внешняя сеть. Тут трафик от пользователя идет к моим сервисам.
Overlay — наложенная сеть. Тут трафик от моих сервисов идет к бэкенд серверам.
Control — сеть управления. Трафик идет между базами OVN и Open vSwitch.
Выкрутился я тем, что реализовал три сети с помощью VLAN тэгов, получились:
VLAN 10 — сеть управления.
VLAN 20 — внешняя сеть.
VLAN 30 — наложенная сеть.
Финальная схема стенда: на генераторе работает OVS, который добавляет и снимает VLAN/Geneve-заголовки. На DUT используются tap-порты, а Trex на генераторе подключен через VF.
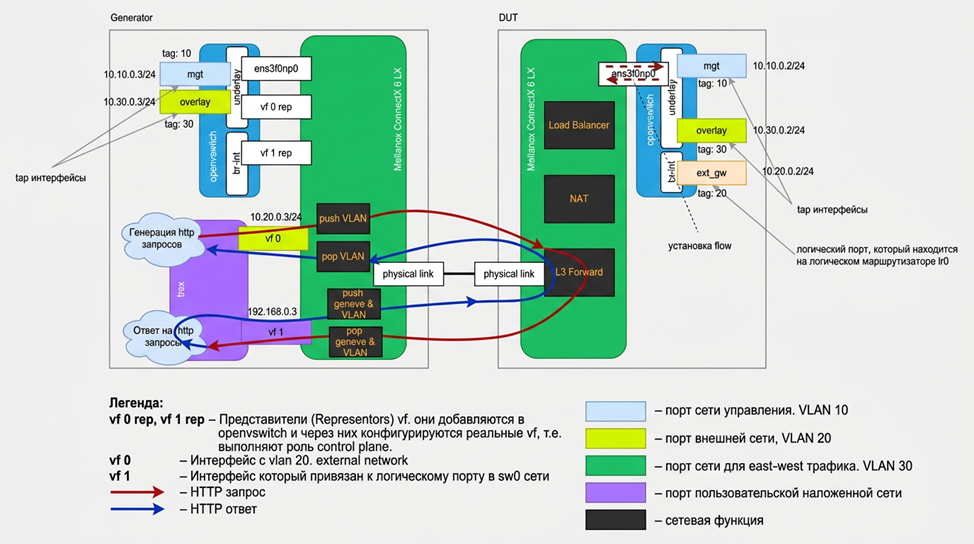
Для тестирования Trex требует два интерфейса: один для сети клиентов (генерация трафика с HTTP-запросами), второй интерфейс для сети бэкенд-серверов (обработка клиентских запросов). Между этими двумя сетями ставится сетевая функция, которую надо протестировать, при этом сетевая функция получает трафик с разнообразными src/dst IP. Это позволяет максимально реалистично протестировать логические сетевые сущности. В моей схеме, трафик из пользовательской сети до DUT идет по VLAN 20, а от DUT до сети бэкенд серверов через VLAN 30 + Geneve. Добавление VLAN и Geneve заголовков лежало полностью на плечах OVS. Trex генерировал чистый IP-трафик.
Выглядит избыточно? Штош, сейчас поясню...
Почему стенд устроен именно так
It's a long story, guys
Как я пытался подружить Trex с Geneve
В начале план был надежен как швейцарские часы:
Генератор с одного интерфейса отправляет HTTP-запросы, завернутые в VLAN 20.
Запрос попадает на интерфейс внешней сети DUT, затем в Open vSwitch, где выполняется сетевая функция (трансляция, маршрутизация или балансировка).
После трансформации пакет инкапсулируется в Geneve, помещается в VLAN 20 и отправляется через второй интерфейс DUT-сервера к генератору.
Трафик попадает на второй интерфейс Trex.
Trex снимает 20 VLAN-тег и декапсулирует Geneve.
Trex эмулирует web-сервер и отвечает на HTTP-запрос.
Наконец, пакет летит в обратную сторону по тому же пути.
Выглядеть все это должно было изящно и незамысловато:
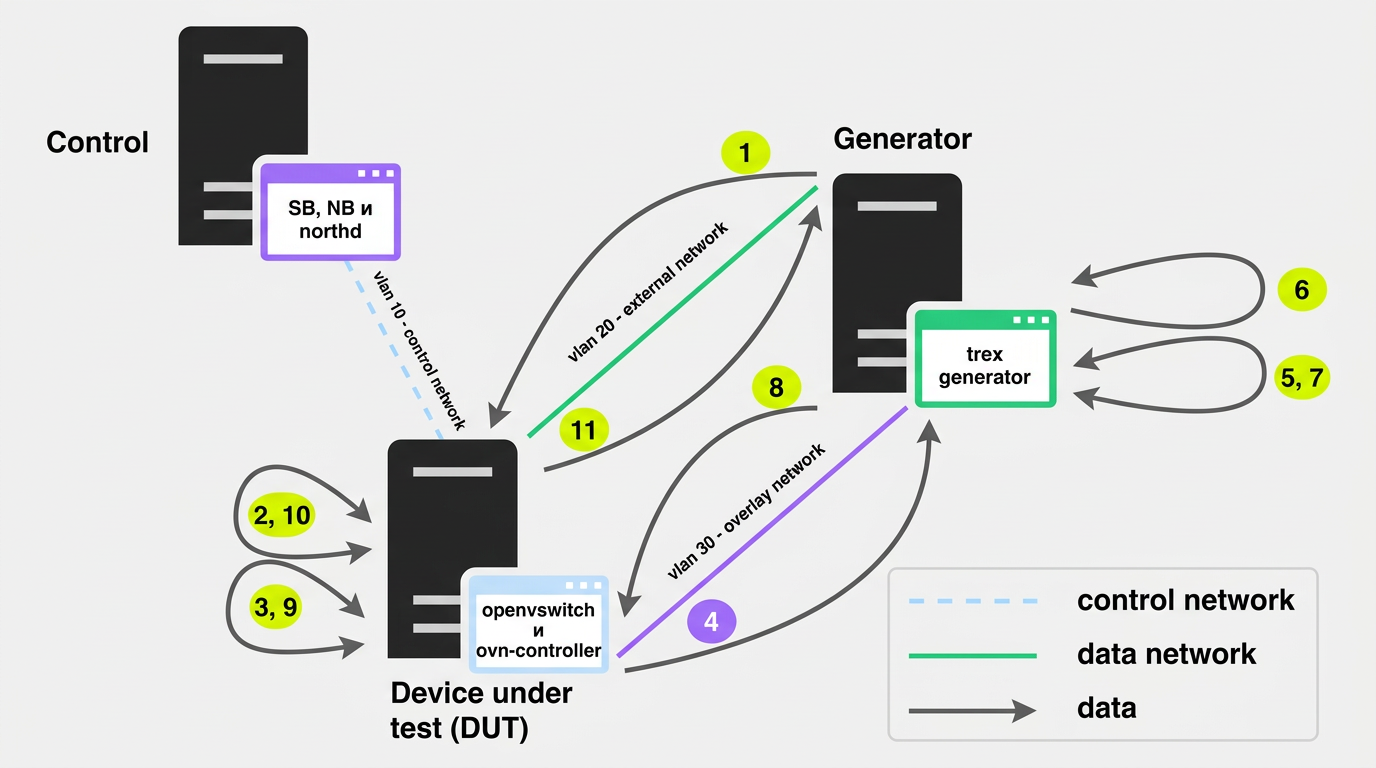
Но в процессе развертывания стенда выяснилось, что у Trex нет готовых профилей для работы с Geneve. А мне нужен был Geneve поверх VLAN, что усложняло задачу. Я прекрасно понимал, что на сервере установлены умные карты, и такую задачу, как добавление заголовков VLAN+GENEVE, можно организовать прямо на них. Я взял Open vSwitch из пакета DOCA и сконфигурировал два интерфейса для Trex. После этого от Trex требовалось только генерация IP-трафика, а добавление VLAN и Geneve заголовков легло на Open vSwitch. Поэтому после манипуляций схема вышла уже следующей:
Можно было, конечно, и без наложенной сети (overlay) организовать тестирование, но очень уж хотелось поставить карточку в максимально неудобное положение и проверить ее возможности по работе с Geneve. Я приступил к реализации схемы на OVS.
Как я пытался совместить управление и пользовательский трафик
Больше всего меня беспокоило то, что физический интерфейс карточки нужно было полностью отдать в DOCA-OVS. А это userspace-приложение, которое забирает весь трафик из карточки, минуя ядро Linux. При этом на хосте был еще один потребитель, ожидавший пакеты с того же физического интерфейса — ovn-controller. Ему требовалось соединиться с базами OVN и считать конфигурацию через сеть управления (VLAN 10).
Другими словами, у Linux должен был быть сетевой интерфейс с назначенным IP-адресом из этой сети, при этом все приходящие на него данные должны заворачиваться в VLAN 10. Тогда ovn-controller сможет открыть обычный Linux-socket и работать с ним в стандартном режиме.
Короче: сетевую карту нужно было использовать и в ядре Linux, и в userspace-приложении. Но как это сделать?
Первое, что пришло в голову, — создать на карте два виртуальных интерфейса (VF) и поручить самой карте фильтровать пакеты по VLAN. При этом тегированный трафик будет уходить в ядро Linux, а весь остальной в OVS.
Для этого в Open vSwitch пришлось создать два моста: underlay и br-int. Мост underlay — для физической сети и br-int для сетевой логики. Оба они управляются с помощью Openflow-правил с той лишь разницей, что в underlay всегда прописывается общее правило: в секции match прописанно «все пакеты», в секции action — NORMAL. Это правило делает мост традиционным с заучиванием всех MAC-адресов. Мост br-int тоже управляется Openflow-правилами, но правила он получает из ovn-controller и их там могут быть тысячи, в зависимости от реализуемой логики.
В мост underlay я добавил следующие интерфейсы:
Физический интерфейс (ens3f0np0). Это обязательный шаг, без него Open vSwitch не будет сгружать свои правила на карточку. В опции я поставил trunk=10,20,30, чтобы он пропускал только тегированный трафик с заданными VLANами.
Представителя (representor) виртуальной функции 0 (VF 0 REP) подсоединил в мост с тэгом 10.
Представителя виртуальной функции 1 (VF 1 REP) подсоединил в мост с тэгом 30.
Что такое представитель и зачем он нужен, я расскажу чуть позже, а сейчас продолжим конфигурировать сервер. Назначаем IP-адреса VF 0 и VF 1 интерфейсам: 10.30.0.3/24 и 10.10.0.3/24 соответственно.
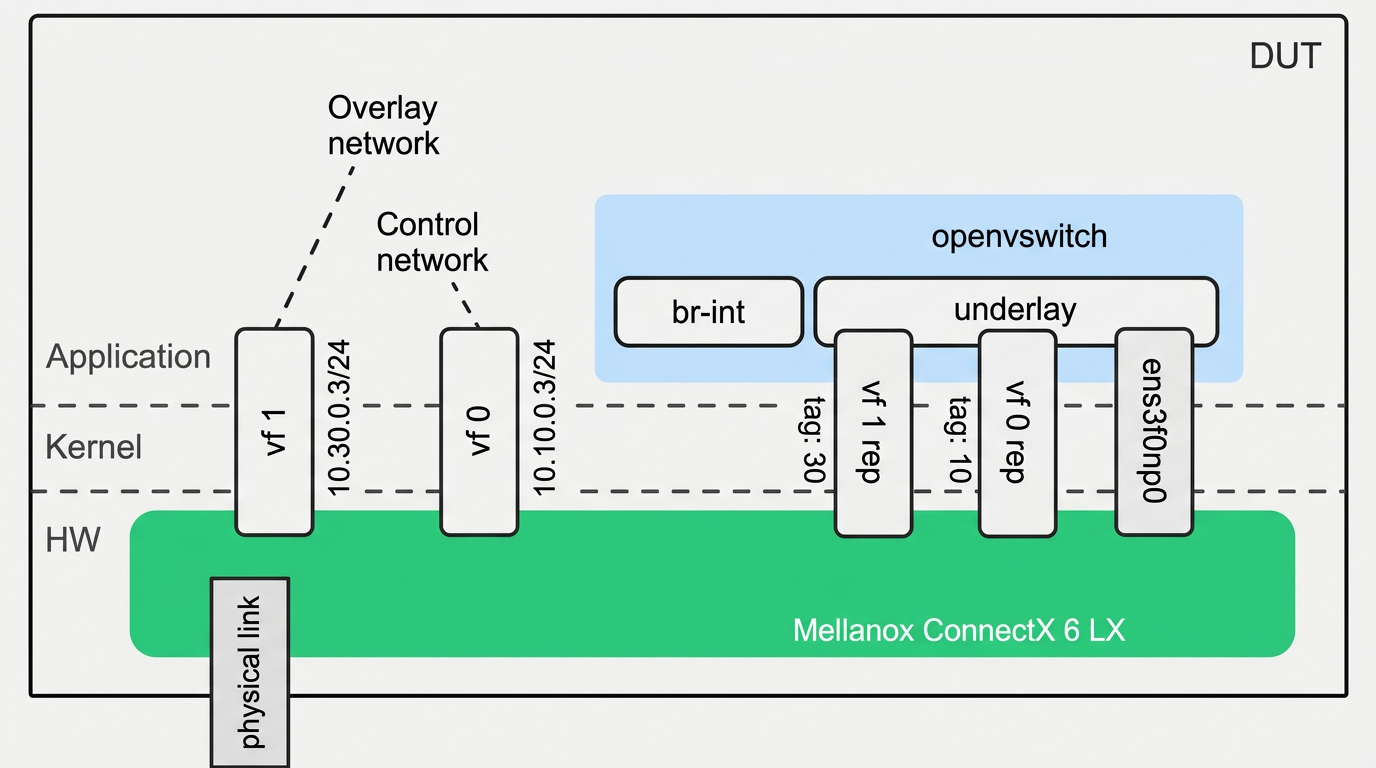
С такой конфигурацией, весь трафик с 10 и 30 VLAN-тэгами (control and overlay networks), пошел в ядро Linux, а весь остальной трафик остался на мосте underlay. При этом про VLAN-тэги знала только сетевая карточка, а Linux работал с виртуальными функциями как с обычными интерфейсами. Трафик с 20 VLANом оставался в Open vSwitch и далее обрабатывался c помощью Openflow правил на br-int.
Почему на DUT — internal-порты, а на генераторе — VF
Схема получилась рабочая, но избыточная. В процессе исследований я нашел еще один способ вывода трафика из userspace в ядро Linux. Для этого не надо использовать VF — можно просто с помощью ovs-vsctl add-port добавить порт в мост и поставить этому порту тип internal. При добавлении internal-порта Open vSwitch создает в Linux обычный tap-интерфейс с таким же названием, как и наш новый порт. Мне осталось только перевести этот порт в состояние up и назначить IP-адрес.
Потом я проверил, какие flow были установлены в карточку как offloaded. Обнаружил там и VLAN-теги c tap-интерфейсов, и даже правила Geneve-туннелирования. Сравнил скорость работы с предыдущей реализацией на SR-IOV и был приятно удивлен: на tap-интерфейсах Open vSwitch работает на 7% быстрее. В итоге я поднял DUT на tap’ах, а генератор на SR-IOV (так как на генераторе был потребитель трафика Trex и ему лучше проводить трафик по аппаратным интерфейсам). В DUT пользовательский трафик не покидал карточку, поэтому ему подошли tap-интерфейсы. Таким образом я и пришел к той схеме стенда, что обозначил в самом начале.
А теперь детально расскажу, как я ее настраивал.
Настройка: через тернии к DOCA
На сайте производителя есть инструкция по установке, но, так как у меня дистрибутив Linux не совсем обычный, то пришлось поработать с приземлением DOCA на SberLinux. Если вашего дистрибутива также нет в списке совместимых, этот раздел – для вас.
Преодолеваем особенности национальных дистрибутивов
Так как SberLinux использует RPM, для установки DOCA я выбрал пакеты семейства rhel.
Скачиваем пакет DOCA и устанавливаем его
wget https://www.mellanox.com/downloads/DOCA/DOCA_v3.3.0/host/doca-host-3.3.0-088000_26.01_rhel9.x86_64.rpm

sudo rpm -Uvh doca-host-3.3.0-088000_26.01_rhel9.x86_64.rpm
Тут у меня возник вопрос: а причем тут host в названии doca? Оказывается, DOCA выпускается в двух вариантах:
host — для x86 процессора,
bluefield bundle — для arm комплекса на Bluefield карточке.
Приятно то, что кодовая база для ConnectX и Bluefield одинаковая. Немного поковыряв по верхам данный вопрос, я пришел к выводу, что ConnectX — это, по сути, урезанный Bluefield без ARM-части. Поправьте, если ошибаюсь, о разнице между ConnectX (SmartNic) и Bluefield(DPU) читал здесь и здесь.
В системе не хватило пакета jsoncpp. Поставил:
sudo yum install jsoncpp
Далее команды из руководства:
sudo yum makecache
sudo yum install -y doca-openvswitch
sudo yum install -y doca-networking
sudo yum install -y doca-extra
sudo yum install kernel
sudo reboot
Теперь компилируем модули DOCA для нашего ядра.
sudo /opt/mellanox/doca/tools/doca-kernel-support
И… И тут на, казалось бы, банальном шаге, я застрял на два дня и много ИИ-токенов.
О чем может говорить сообщение Illegal char '^'? Безобидно ли оно, или сборка не удалась? Увы, оказывается, такой символ в названии версии ядра ломает обновление модулей ядра на rpmbuild.
Для собратьев по несчастью фикс под катом.
Чтобы исправить это, надо поменять одну строку в /opt/mellanox/doca/tools/doca-kernel-support файле на 173 линии:
vi /opt/mellanox/doca/tools/doca-kernel-support +173
и меняем строкуKVERS_PACK = " ${KVERS //[ _- ]/ . } "
на KVERS_PACK ="${KVERS//[\^_-]/. }"
Следующая попытка компиляции модулей ядра завершилась удачно. В конце скрипт проинформировал меня какие команды надо дальше выполнять и… Я промучался с исправлением злополучного символа еще и в названиях репозиториев:
[doca-kernel-5.14.0-611.47.1.sl9_7.2.x86_64]
name = DOCA kernel (kernel 5.14.0-611.47.1.sl9_7.2.x86_64)
baseurl = file:///usr/share/doca-host-26.01-1.0.0.0/Modules/5.14.0-611.47.1.sl9_7^2.x86_64
enabled = 1
gpgcheck = 0
Выполнил еще раз
dnf makecache
На этот раз без ошибок.
После этих шагов появился новый репозиторий на локальной машине, и осталось только установить пакеты оттуда согласно рекомендациям предыдущего скрипта.
dnf install doca-ofed-userspace
dnf install --disablerepo=doca doca-kernel-5.14.0.611.47.1.sl9.7.2.x86.64
Теперь загружаем драйвера и перезапускаем MST согласно руководству с сайта производителя.
sudo /etc/init.d/openibd restart
sudo mst restart
Сервис, конечно же, упал с ошибкой, но на этот раз система явно попросила обновить firmware карточек.
Обновляем firmware
Чтобы свежая DOCA запустилась, нужно обновить прошивку карты. Стоит учитывать, что карточки одной модели (например, ConnectX-6 LX) могут иметь несколько линеек, и у каждой своя прошивка. Чтобы найти подходящую, нужно узнать PSID карточки с помощью ethtool.
$ ethtool -i ens3np0f0
Ищем запись вида LNV0000000XXX (это OEM карточка для Lenovo) или MT_0000000XXX. Firmware для Lenovo лежит здесь, для остальных здесь. Больше деталей в инструкциии.
У меня была карточка Lenovo, так что я скачал firmware, распаковал его и запустил:
$ ./mlxfwmanager_LES_25B_DOCA_3.2.0_build3
Приложение само нашло все сетевые карты и обновило их. Теперь можно попробовать запустить сервисы еще раз:
$ sudo /etc/init.d/openibd restart

$ sudo mst restart
Обновляем аргументы ядра
DOCA-тракт — это модифицированный DPDK, поэтому он также требует hugepages и изолированные ядра. Я выделил 32 ГБ hugepages и ядра со второго по 15-е включительно (вместе с их siblings). Ядра изолировал с избытком, чтобы иметь запас мощности CPU. В тестах я использовал меньше ядер, но у меня была возможность поменять настройки Open vSwitch и Trex, чтобы они воспользовались этими ядер. Siblings изолировать надо обязательно, без этого производительность у меня падала на 15%.
# выделяем 32 GB hugepages
sudo grubby --update-kernel=ALL --args='intel_iommu=on iommu=pt default_hugepagesz=1G hugepagesz=1G hugepages=32 hugepagesz=2M hugepages=0'
# изолируем 2-15,34-47 CPUs
sudo grubby --update-kernel=ALL --args="nohz_full=2-15,34-47 rcu_nocbs=2-15,34-47"
sudo reboot
Запускаем Open vSwitch и ovn
Конфигурировать логические сетевые сущности в Open vSwitch можно двумя способами. Можно вручную настроить сетевую логику правилами OpenFlow, либо поднять OVN и доверить эту задачу ему. OVN уже содержит такие сущности, как NAT, балансировщик и маршрутизатор. Я выбрал второй вариант, и тут выяснилось, что OVN не входит в пакет поставки DOCA. OVN пришлось собрать вручную.
Для запуска OVS я выполнил:
$ sudo /usr/share/openvswitch/scripts/ovs-ctl start --system-id=random
Для сборки OVN нужны исходники OVS. Их можно найти в хранилище DOCA, но они лежат только в папке для платформы Ubuntu, а вот в папке для RHEL исходников нет. Скачиваем нужную версию OVN и собираем его согласно официальной инструкции.
# устанавливаем компилятор и зависимости прямо на сервере где я собрался запускать OVN.
sudo dnf install -y gcc gcc-c++ make autoconf automake libtool openssl-devel libcap-ng-devel unbound-devel python3-devel python3-pip python3-setuptools
# Не уверен, что libatomic нужен всем платформам, но SberLinux его запросил.
sudo dnf install libatomic
# создаем папку для исходников
mkdir /opt/git
cd /opt/git
Для постройки OVN я использовал официальную версию OVS из github, при этом подобрал максимально близкую версию к DOCA-OVS. Исходники DOCA-OVS, которые лежат в папке для платформы Ubuntu на сайте производителя, я нашел слишком поздно, когда все было построено.
# clone ovn and ovs
git clone https://github.com/ovn-org/ovn.git
git clone https://github.com/openvswitch/ovs.git
# Собираем ovs. Устанавливать его не надо, т.к. уже стоит OVS-DOCA. Нужны только бинарники для компиляции OVN.
cd ovs
git checkout v3.3.8
./boot.sh
mkdir _build
cd _build
../configure
../configure --prefix=/usr --sysconfdir=/etc --localstatedir=/var
make
# компилируем и устанавливаем OVN
cd /opt/git/ovn/
git checkout v24.03.8
./boot.sh
./configure --prefix=/usr --with-ovs-source=/opt/git/ovs --with-ovs-build=/opt/git/ovs/_build
make
sudo make install
# Запускаем контролер на генераторе и на DUT
/usr/share/ovn/scripts/ovn-ctl start_controller
# Запускаем северную и южную базу и northd на control node.
OVN_LOGDIR="/var/run/ovn" OVN_RUNDIR="/var/run/ovn" OVN_DBDIR="/var/run/ovn" sudo -E /usr/share/ovn/scripts/ovn-ctl --db-sb-create-insecure-remote=yes --db-nb-schema=/opt/git/ovn/ovn/ovn-nb.ovsschema --db-sb-schema=/opt/git/ovn/ovn/ovn-sb.ovsschema restart_northd
Настраиваем eswitch и виртуальные функции (VF) на генераторе
Чтобы задействовать аппаратное ускорение, карту нужно перевести в режим switchdev. В этом режиме появляется возможность выполнять правила OVS на карте. Например, можно сконфигурировать SR-IOV устройства, чтобы они получали трафик только с определенным VLAN.
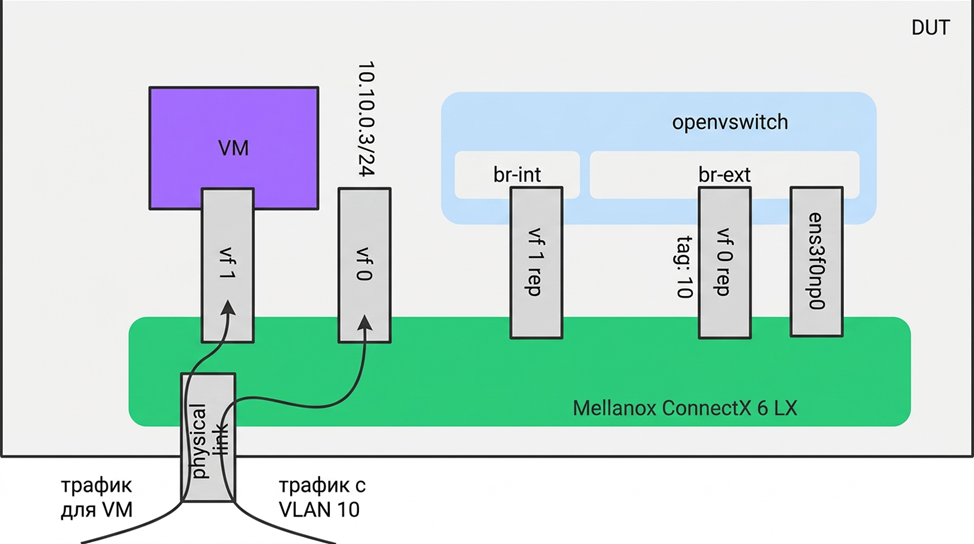
В Mellanox подумали и о том, что SR-IOV устройства могут быть переданы в виртуальную машину или новый network namespace в Linux. В этом случае устройство исчезает из корневого пространства сетевых устройств и Open vSwitch может потерять доступ к нему. Для этого каждое SR-IOV устройство имеет два интерфейса в Linux:
Представитель (он же representor) — точка конфигурации, основной трафик через него не ходит, его можно добавить в OVS.
Непосредственно SR-IOV устройство (оно же Virtual Function) — виртуальное сетевое устройство, через которое ходит трафик.
На схеме ниже пример конфигурации, где одна VF отдана виртуальной машине, а другая просто имеет IP-адрес на хосте и доступна всем приложениям хоста. При этом на хост трафик приходит из 10 VLAN, а в виртуальную машину пакеты попадают по правилам openflow в br-int. Вся эта конфигурация скрыта от потребителей интерфейсов — она реализована внутри OVS и внутри карточки. Для приложений это обычное SR-IOV устройство.
Начинаем настройку. Чтобы перевести устройство в режим switchdev, нужно, чтобы не было активных SR-IOV устройств, иначе система будет ругаться на то, что устройство занято.
echo 0 > /sys/class/net/ens3f0np0/device/sriov_numvfs
Потом находим адрес устройства на PCI-шине.
ip -d link show ens3f0np0
Адрес устройства выглядит вот так ‘parentdev 0000:32:00.0’.
Теперь можно поменять режим карточки.
devlink dev eswitch set pci/0000:32:00.0 mode switchdev
После этого я поставил нужное мне количество SR-IOV устройств.
echo 8 > /sys/class/net/ens3f0np0/device/sriov_numvfs
Далее обнаружилась забавная особенность: до сих пор не уверен баг это или фича. Каждая VF имеет два MAC-адреса. Они настраиваются разными способами и используются в разных сценариях. Первый MAC хранится в родительской физической функции и настраивается так:
ip l set ens3f0np0 vf 0 mac 50:54:00:00:00:06
ip l set ens3f0np0 vf 1 mac b2:23:54:c4:4c:cf
Второй мак хранится на самом SR-IOV интерфейсе и настраивается так:
ip l set ens3f0v0 address 50:54:00:00:00:06
ip l set ens3f0v1 address b2:23:54:c4:4c:cf
MAC на физической функции использует сам eswitch для коммутации пакетов. Маки на SR-IOV устройствах зачитывает Trex и генерирует пакеты с таким SRC. Чтобы это выяснить, у меня ушла где-то неделя, причем то, что они отличаются, я сразу увидел в выводе команды ip link, но не сразу это принял.
Далее перевел устройства в состояние UP:
ip l set ens3f0v0 up
ip l set ens3f0v1 up
Но даже после установки двух MAC система периодически переставала работать. И это была не единственная проблема: я проверил логи dmesg и ovs-vswitchd.log. и обнаружил, что с периодичностью в одну минуту повторяются сообщения:
# dmesg -T:
[Sat Jul 14 18:26:30 2026] mlx5_core 0000:32:00.0 mlx5_2: Port: 0 Link DOWN
[Sat Jul 14 18:26:30 2026] mlx5_core 0000:32:00.0 mlx5_2: Port: 0 Link ACTIVE
[Sat Jul 14 18:26:30 2026] mlx5_core 0000:32:00.1 ens3f0v0: Link up
[Sat Jul 14 18:26:30 2026] mlx5_core 0000:32:00.2 ens3f0v1: Link down
[Sat Jul 14 18:26:30 2026] mlx5_core 0000:32:00.0 mlx5_2: Port: 1 Link DOWN
[Sat Jul 14 18:26:30 2026] mlx5_core 0000:32:00.0 mlx5_2: Port: 1 Link ACTIVE

# cat ovs-vswitchd.log
2026-07-14T10:12:45.425Z|00025|backtrace(pmd-c11/id:7)|ERR|lib/vlog.c:1297 backtrace:
ovs-vswitchd(log_backtrace_at+0x52) [0x56452690b952]
ovs-vswitchd(vlog_abort_valist+0x27) [0x564526812037]
ovs-vswitchd(+0xaea0fa) [0x5645268120fa]
ovs-vswitchd(ovs_assert_failure+0x3b) [0x564526802b4b]
ovs-vswitchd(+0xb47f7a) [0x56452686ff7a]
ovs-vswitchd(+0xb583ba) [0x5645268803ba]
ovs-vswitchd(+0xb482a2) [0x5645268702a2]
ovs-vswitchd(+0xb4e6f9) [0x5645268766f9]
ovs-vswitchd(+0xa8dcff) [0x5645267b5cff]
/lib64/libc.so.6(+0x8b2ea) [0x7fb92cc8b2ea]
/lib64/libc.so.6(+0x1103d0) [0x7fb92cd103d0]
2026-07-14T10:12:45.425Z|00026|util(pmd-c11/id:7)|EMER|lib/dpif-doca.c:5521: assertion pmd->n_output_batches > 0 failed in dp_doca_pmd_flush_output_on_port()
2026-07-14T10:12:46.535Z|00030|vlog(monitor)|INFO|opened log file /var/log/openvswitch/ovs-vswitchd.log
2026-06-24T10:12:46.535Z|00031|daemon_unix(monitor)|ERR|10 crashes: pid 9866 died, killed (Aborted), core dumped, restarting
Я уже порядком подустал и сгрузил в логи в нашего внутреннего ИИ-агента. Одной из его гипотез было, что всему виной конфликт userspace-драйверов и NetworkManager’a. Значит если перестать отслеживать эти интерфейсы, проблема должна решиться?
vi /etc/NetworkManager/conf.d/99-disable-vf.conf
добавляем эти строки:
"""

[keyfile]

unmanaged-devices=interface-name:ens3f0*

"""
Перезапускаем менеджер.
systemctl restart NetworkManager
Проверяем, что устройства находятся в unmanaged состоянии — nmcli d.
Пример правильного устройства, с которым все заработало:
ens3f0npf0vf0 ethernet unmanaged
Настраиваем OVS на генераторе
Здесь мы снова возвращаемся к исходной схеме из начала статьи. Теперь, надеюсь, понятно почему она получилась именно такой. Займемся финальными штрихами. Для работы моих сценариев нужно два моста:
underlay — сюда я добавил все интерфейсы с vlan-тэгом;
br-int — интеграционный мост.
Чтобы использовать новый тракт DOCA, во время создания мостов я его явно указал datapath_type=doca.
ovs-vsctl add-br br-int
ovs-vsctl  set Bridge br-int datapath_type=doca
ovs-vsctl add-br underlay
ovs-vsctl set Bridge underlay datapath_type=doca -- set bridge underlay fail-mode=standalone
ovs-vsctl set open . external-ids:ovn-bridge=br-int

ovs-vsctl set Open_vSwitch . other_config:default-datapath-type=doca
ovs-vsctl set open . other_config:hw-offload-ct-size=1M
ovs-vsctl --no-wait set Open_vSwitch . other_config:doca-init=true
Чтобы вся наша сетевая логика из OVS переехала в карту, указываем hw-offload=true.
ovs-vsctl set Open_vSwitch . other_config:hw-offload=true
Подсоединяемся к OVN базам, замените 10.10.0.4 на mgt ip control хоста.
ovs-vsctl set open . external_ids:ovn-remote="tcp:10.10.0.4:6642"
ovs-vsctl set open . external_ids:ovn-nb="tcp:10.10.0.4:6641"
# 10.30.0.3 это ip генератора в overlay сети (vlan 30)
ovs-vsctl set open . external_ids:ovn-encap-ip="10.30.0.3"
ovs-vsctl set open . external_ids:ovn-encap-type=geneve
# сопоставляем физическую сеть и мост
ovs-vsctl set open . external_ids:ovn-bridge-mappings="physnet1:underlay"
В underlay-мост я воткнул:
Физическую функцию (ens3f0np0) — это обязательное требование DOCA-тракта.
Репрезентера виртуальной функции (ens3f0npf0vf0) — порт, представляющий генератор в external сети (vlan 20). IP этому порту я назначил в конфиге Trex.
Mgt, overlay порты с типом internal. В данном случае OVS создает TAP-интерфейсы в системе, и на них можно назначить IP. При этом правила добавления VLAN-тэгов все равно сгружаются на сетевую карту.
ovs-vsctl add-port underlay ens3f0np0 -- set Interface ens3f0np0 type=doca -- set port ens3f0np0 vlan_mode=trunk trunk=10,20,30
ovs-vsctl add-port underlay ens3f0npf0vf0 tag=20 -- set Interface ens3f0npf0vf0 type=doca
ovs-vsctl add-port underlay mgt tag=10 -- set interface mgt type=internal
ovs-vsctl add-port underlay overlay tag=30 -- set interface overlay type=internal
ip l set dev mgt up
ip link set dev overlay up
ip a a dev mgt 10.10.0.3/24
ip add add dev overlay 10.30.0.3/24

# br-int
# привязываем пользовательский порт port1 к vf 1. port1 это логический порт, который я потом создам в OVN.
ovs-vsctl add-port br-int ens3f0npf0vf1 -- set Interface ens3f0npf0vf1 type=doca -- set interface ens3f0npf0vf1 external_ids:iface-id=port1

# привязываем 2 – 7 ядра для Poll Mode драйверов (PMD) на генераторе.
# одно ядро может генерировать 8Mpps. C шестью ядрами потенциальная мощность генератора получилась 48 Mpps.
ovs-vsctl set Open_vSwitch . other_config:pmd-cpu-mask="0xfc"
ovs-vsctl set Interface ens3f0np0 options:n_rxq=6
ovs-vsctl set interface ens3f0np0 other_config:pmd-rxq-affinity="0:2,1:3,2:4,3:5,4:6,5:7"
# проверяем назначенные ядра
ovs-appctl dpif-doca/pmd-rxq-show
Конфигурация выше применима к генератору пакетов, а на DUT она немного отличается. DUT был настроен с n_rxq=1 для физического порта, чтобы понять, какую производительность можно получить с одного ядра.
Создаем логическую топологию
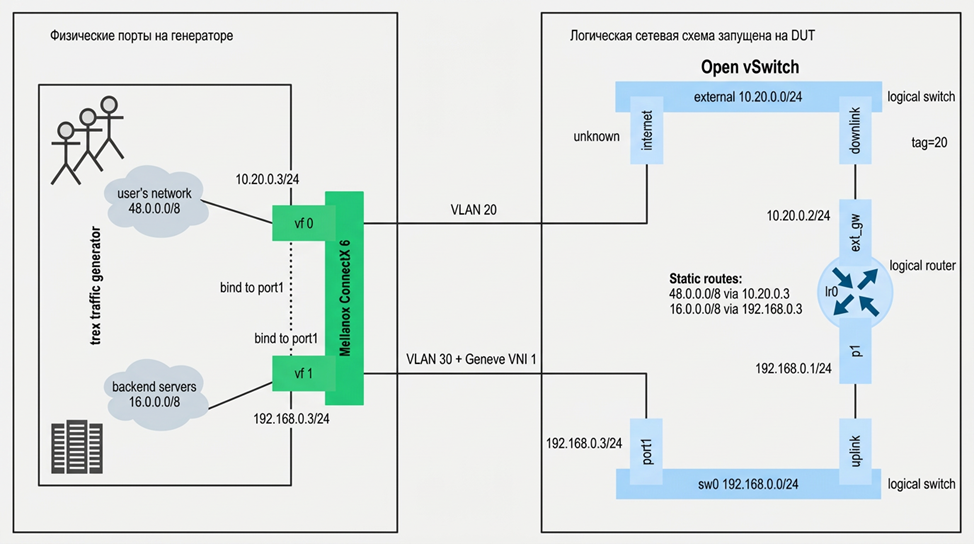
Для тестирования нам понадобятся обычный логический маршрутизатор и минимальная обвязка: логическая сеть пользователя и логическая внешняя сеть. Сеть пользователя имеет два порта:
uplink к маршрутизатору;
пользовательский порт, за которым будет запущен trex генератор. Ставим IP 192.168.0.3. За ним trex будет генерировать пакеты из сети 16.0.0.0/8.
Внешняя сеть тоже имеет два порта:
downlink к маршрутизатору с тегом внешней сети VLAN 20;
внешний порт, адрес которого выставлен как unknown: весь трафик с неизвестным получателем будет уходить на него.
На маршрутизаторе я добавил правила маршрутизации из генерируемой внешней сети (48.0.0.0/8) в генерируемую пользовательскую сеть (16.0.0.0/8).
# cоздаем внешний порт с адресом unknown для связи с внешним миром
ovn-nbctl lsp-add external internet
ovn-nbctl lsp-set-type internet localnet
ovn-nbctl lsp-set-addresses internet unknown
ovn-nbctl lsp-set-options internet network_name=physnet1
# cоздаем порт во внешней сети с 20 VLAN ID для линка с маршрутизатором.
ovn-nbctl lsp-add external downlink "" 20
ovn-nbctl lsp-set-type downlink router
ovn-nbctl lsp-set-addresses downlink router
ovn-nbctl lsp-set-options downlink router-port=ext_gw gateway-chassis=<chassis id> networks="10.20.0.0/24"
# создаем сеть пользователя
ovn-nbctl ls-add sw0
ovn-nbctl lsp-add sw0 port1
ovn-nbctl lsp-set-addresses port1 "50:54:00:00:00:01 192.168.0.3"
# создаем порт для связи с логическим маршрутизатором
ovn-nbctl lsp-add sw0 uplink
ovn-nbctl lsp-set-type uplink router
ovn-nbctl lsp-set-addresses uplink router
ovn-nbctl lsp-set-options uplink router-port=p1
# логический маршрутизатор с установленным gateway chassis
ovn-nbctl lr-add lr0
ovn-nbctl lrp-add lr0 p1 00:00:00:00:ff:01 192.168.0.1/24
ovn-nbctl lrp-add lr0 ext_gw 00:00:00:01:ff:01 10.20.0.2/24
ovn-nbctl lrp-set-gateway-chassis gw  <chassis id. see in 'ovn-sbctl show'>
И вот теперь наконец-то, наше окружение настроено и готово к запуску тестов.
Тестирование DOCA vs System: сравнение производительности
Я проводил три теста: маршрутизация, NAT, Load balancer. Тестировал только два тракта: DOCA и system. Тесты DOCA проводились только с одной RX очередью, чтобы удобно было сравнивать с system-трактом. Размеры пакетов выбирал как можно меньше от 64 до 100 байт, чтобы померить производительность системы в PPS (packets per second). Более подробно о методологии тестирования с помощью Trex, можно посмотреть в моей предыдущей статье.
Маршрутизация
Чтобы проверить скорость маршрутизации, я использовал всего два статических маршрута на логическом маршрутизаторе lr0:
ovn-nbctl lr-route-add lr0 48.0.0.0/16 10.20.0.3
ovn-nbctl lr-route-add lr0 16.0.0.0/16 192.168.0.3
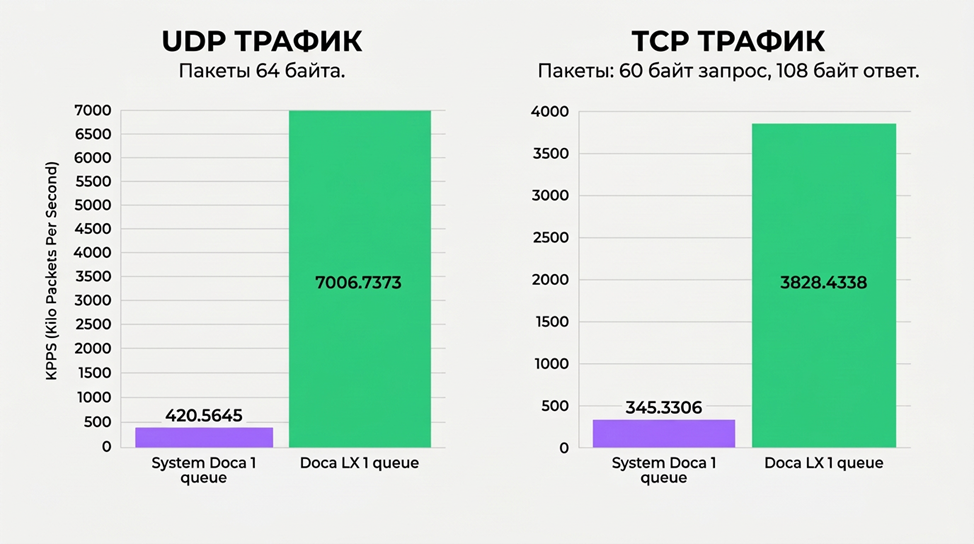
Результаты получились очень оптимистичные.
UDP-трафик обрабатывается на DOCA в 16 раз быстрей, чем kernel Open vSwitch. Для TCP-трафика отрыв меньше — в 10 раз DOCA быстрей.
NAT
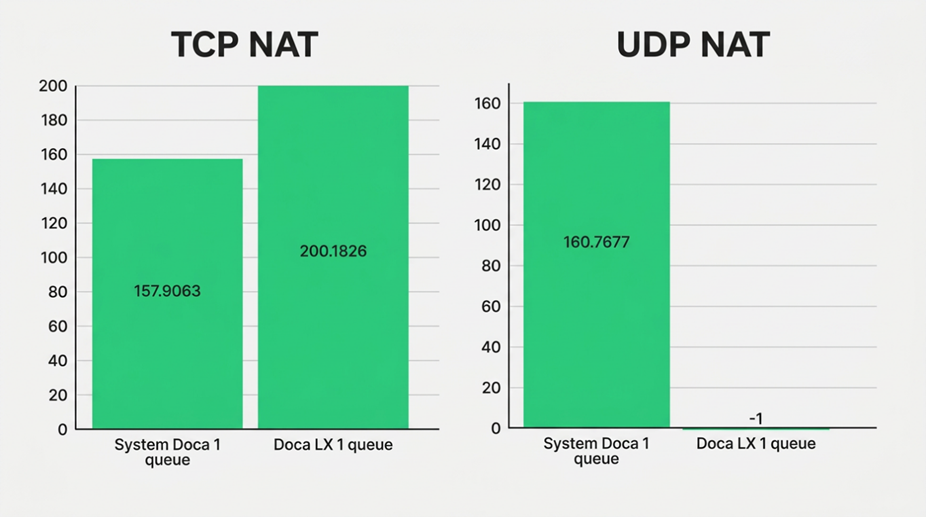
Для тестирования NAT я добавил правило и запустил трафик на 18.0.0.188:
ovn-nbctl lr-nat-add lr0 dnat_and_snat 18.0.0.188 16.0.0.188
Результат оказался не таким впечатляющим. При этом UDP-трафик DOCA вообще отказалась обрабатывать: даже при минимальной нагрузке в 100 пакетов в секунду терялось 20% трафика. Не могу сказать, что пациент однозначно мертв, но признаков жизни тоже не заметно. Напишите, может быть я чего-то не учел?
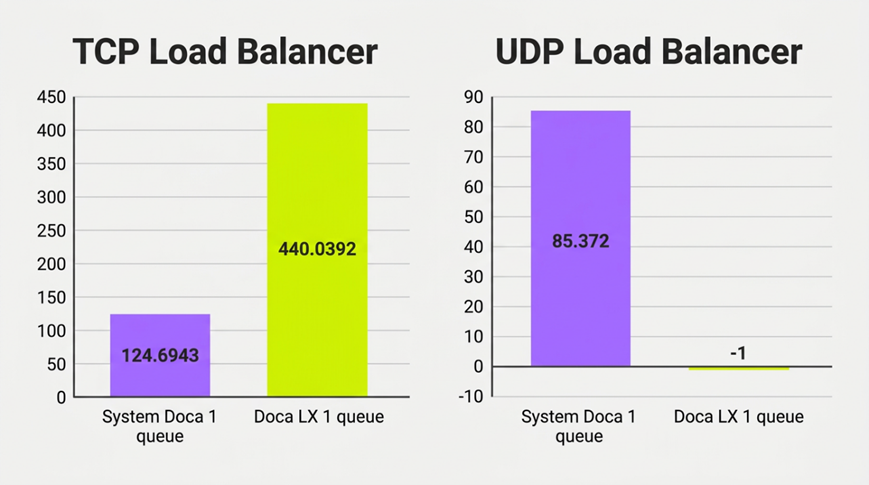
Load Balancer
Для тестирования балансировщика я поднял три пользовательских логических порта и подсоединил их к VF сетевой карты. Также пришлось запустить два приложения Trex, так как у него нет возможности сконфигурировать разное количество CPU-ядер для разных портов. Я предполагал, что на клиентском порту будет нагрузка больше, чем на бэках, так как он один пытается нагрузить сразу три бэка. Поэтому запустил один Trex для клиентского порта и отдал ему 4 CPU и второй Trex c тремя портами по одному CPU для каждого порта.
Добавил следующее правило на логический маршрутизатор:
ovn-nbctl lb-add lb-web 18.0.0.172:80 192.168.0.3:80,192.168.0.4:80,192.168.0.5:80 tcp
ovn-nbctl lb-add lb-udp 18.0.0.172:8080 192.168.0.3:8080,192.168.0.4:8080,192.168.0.5:8080 udp
TCP трафик прошел быстрей через DOCA в 3,5 раза. А вот UDP вообще не прошел — та же проблема, что и с NAT.
Выводы: когда SmartNIC оправдывает ожидания, а когда нет
Завершилась первая часть исследований. В ней я отлаживал методологию тестирования, дружил Trex с Geneve, SberLinux с DOCA и в итоге проверял основные возможности system-тракта и DOCA на ConnectX-6 Lx (25 Гбит/с). DOCA показала себя перспективно в маршрутизации и ускорила TCP-балансировку. С UDP NAT и UDP-балансировкой в этом стенде возникли проблемы, причину которых пока не локализовали. Если вы смелый, ловкий, умелый — можете сделать свои предположения в комментариях.
Следующим этапом станет исследование DPDK-тракта и DOCA на адаптере ConnectX-6 Dx (100 Гбит/с). Я возлагаю на него большие надежды: производитель заявляет, что аппаратный conntrack работает в 19 раз быстрее программного. Да, тесты проводились на Bluefield, но ConnectX-6 DX — это старшая модель в линейке SmartNIC, и я ожидаю, что она оснащена аналогичным модулем ASAP². Если интересно узнать, насколько это близко или далеко от реальности — дайте знать в комментариях, и я опубликую результаты.