


Сначала клиент перезагрузил узел.
Под Prometheus не смог переехать после рестарта, в событиях висело Multi-Attach error, и человек сделал единственное, что казалось надёжным: ребутнул узел, к которому том якобы был привязан. Помогло. Когда та же ошибка случалась второй раз за день, он пришёл в поддержку.
Диалог в треде был простой:
А что было?
Там застрял ресурс
volumeattachments, поэтому и ошибка. Я просто удалил старый.Интересно.
Инженер удалил один объект VolumeAttachment, и под поехал за секунды.
Разница между «перезагрузить узел» и «удалить один объект» — в понимании того, кто в Kubernetes читает поле accessModes и что именно он с ним делает. Это понимание не берётся из документации по PersistentVolumes: там написано, что означают режимы, но не написано, кто и когда их проверяет.
В статье разберёмся, кто это делает: проверка происходит в трёх местах, и лишь в двух из них решение принимает сам Kubernetes. По пути выясним, почему:
два пода спокойно пишут в один ReadWriteOnce-том;
ReadWriteOnce на NFS не защищает ни от чего;
у одного тома в живом кластере могут оказаться три активных аттача сразу;
один и тот же ReadOnlyMany на Ceph запрещает запись, а на NFS вообще бесполезен.
В конце — правило, как не убить данные, леча Multi-Attach error, пять типовых граблей и пять экспериментов, которые за 15 минут покажут, как ведёт себя ваше хранилище.
Четыре режима (внимание, один из них с подвохом!)
Access modes в Kubernetes четыре:
ReadWriteOnce (RWO) — чтение и запись с одного узла;
ReadOnlyMany (ROX) — только чтение с многих узлов;
ReadWriteMany (RWX) — чтение и запись с многих узлов.
ReadWriteOncePod (RWOP) — ровно один под во всём кластере (появился в 1.22, включён по умолчанию с 1.27, стабилен с 1.29).
Главное недопонимание кроется в первом же режиме, и на этом спотыкаются все новички. ReadWriteOnce ограничивает узел, а не под. Хоть два, хоть десять, хоть сто подов на одном узле спокойно примонтируют такой том, и ни один компонент Kubernetes на это не пожалуется. Слово «Once» относится к узлу.
Именно поэтому потребовался отдельный режим ReadWriteOncePod — закрыть дыру, которую RWO никогда и не был предназначен закрывать.
Еть ещё два свойства поля, о которых часто забывают.
Первое — это список, но написать туда можно не любую комбинацию (ниже увидим, какую из них отвергает сам CSI).
Второе — поле неизменяемо после создания. API-сервер отвечает прямо: spec: Forbidden: spec is immutable aft er creation except resources.requests and volumeAttributesClassName for bound claims.
Kubernetes как бы говорит: «Вы создали PVC с определёнными настройками, и теперь менять их нельзя. Единственное, что вам разрешено изменить у уже работающего и привязанного тома — это запросить больше места (ресурсы) или сменить класс атрибутов. Менять режимы доступа (accessModes), storageClassName или другие параметры запрещено». Если приложению понадобилось больше режимов, придётся либо создавать новый PVC и мигрировать данные, либо заранее закладывать нужный набор режимов на этапе создания.
Путь тома
Прежде чем данные попадут в файл, заявка на том — PersistentVolumeClaim (PVC) — проходит через несколько компонентов. Access mode влияет на решение только в трёх местах, и лишь в двух из них решение принимает сам Kubernetes.
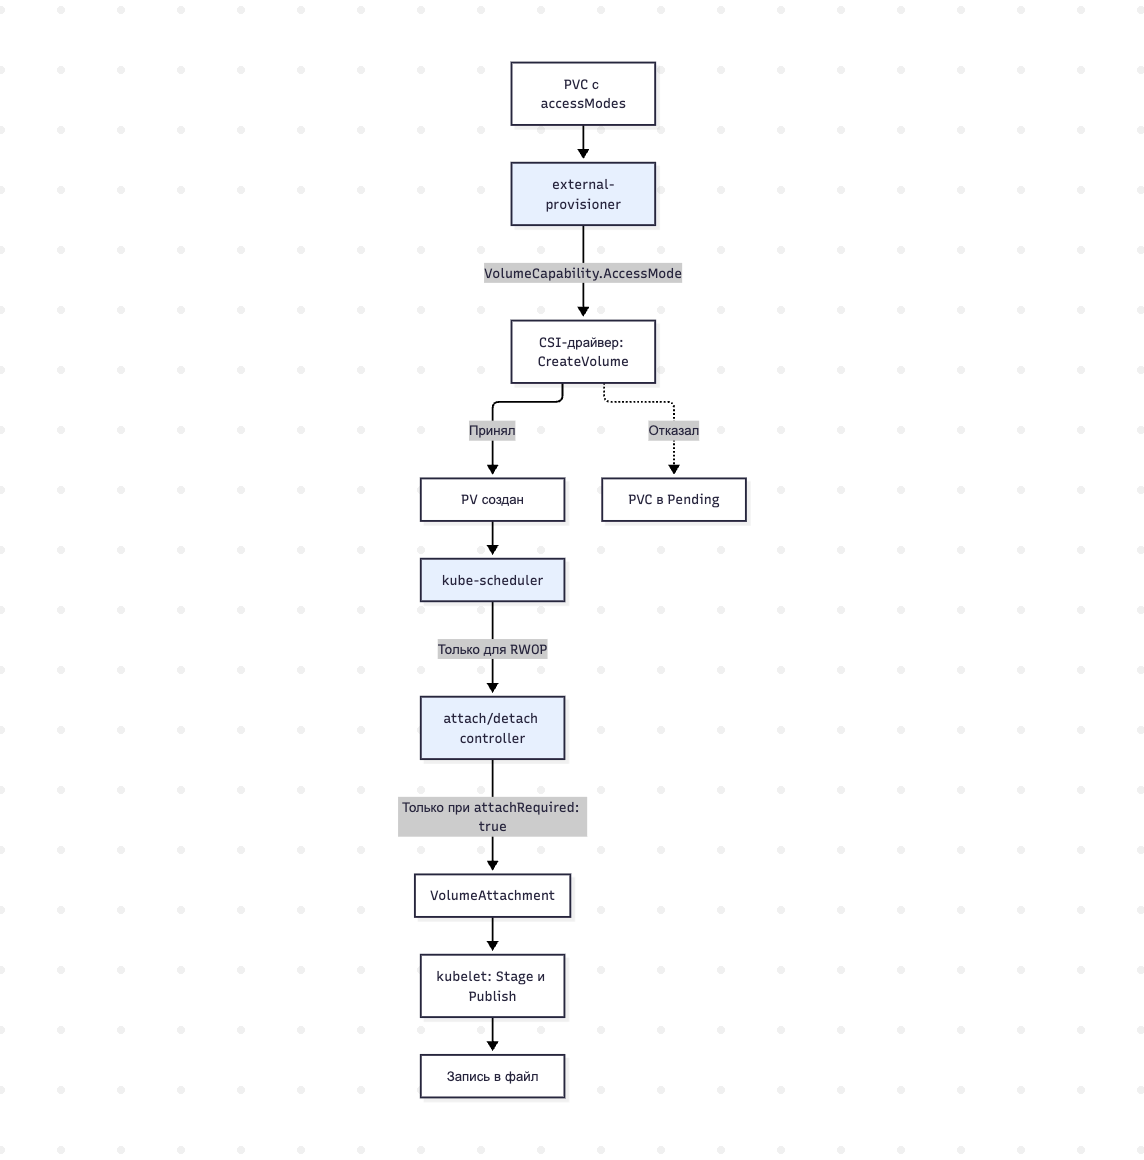
Отдельно (голубым цветом) отмечены три места, где режим влияет на исход. Разберём каждое.
Первое место: провижининг
external-provisioner переводит режимы Kubernetes в перечисление CSI и отдаёт драйверу в вызове CreateVolume. Делает это он через общую библиотеку csi-lib-utils, функция ToCSIAccessMode. Она принимает список режимов и смотрит флаг «умеет ли драйвер SINGLE_NODE_MULTI_WRITER»:
Режим Kubernetes | Драйвер без capability | Драйвер с SINGLE_NODE_MULTI_WRITER |
|---|---|---|
RWO |
|
|
RWOP |
|
|
ROX |
|
|
RWX |
|
|
Первое следствие: если драйвер не объявил capability, RWOP неотличим от RWO на стороне драйвера. Оба приезжают как SINGLE_NODE_WRITER, и гарантия «один под» остаётся целиком на совести Kubernetes.
Второе следствие — два запрета, зашитые в библиотеку:
RWO вместе с ROX отвергаются:
CSI does not support ReadOnlyMany and ReadWriteOnce on the same PersistentVolume.RWOP вместе с любым другим режимом:
Kubernetes does not support use of ReadWriteOncePod with other access modes on the same PersistentVolume.
Запрет срабатывает при провижининге, а не при создании PVC: сам PVC создастся, а потом застрянет в Pending с этой ошибкой в событиях. Запомним первую комбинацию (RWO + ROX) — она ещё всплывёт.
Само же перечисление CSI больше, чем набор режимов Kubernetes:
CSI | Смысл | Аналог в Kubernetes |
|---|---|---|
| Один узел, запись | RWO |
| Один узел, чтение | Нет |
| Много узлов, чтение | ROX |
| Много узлов, пишет один, остальные читают | Нет |
| Много узлов, пишут все | RWX |
| Один узел, одна нагрузка | RWOP |
| Один узел, много нагрузок | нет |
Отдельно стоит MULTI_NODE_SINGLE_WRITER. Это ровно то, что нужно живой миграции виртуальной машины (ВМ): диск виден двум узлам, пишет только один. В Kubernetes такого режима нет, поэтому миграция ВМ обходится через RWX, а запрет на запись со второго узла обеспечивает уже слой виртуализации.
Каждый раз, когда к нам приходят с вопросом про RWX в вендорских CSI, мы честно отвечаем: «Для виртуализации мы это разрешаем, но вопросы с запретом записи там решаются костылями самой виртуализации».
Дальше по ходу дела решение за драйвером, а драйверы ведут себя очень по-разному.
Драйвер может проверять не то, что вы думаете. В csi-driver-nfs валидация запроса перебирает переданные VolumeCapability и отказывает, только если среди них есть Block. Access mode она не смотрит вообще, так что любой режим, включая RWX и ROX, будет принят. Впрочем, для NFS множественная запись как раз не проблема.
Может отказывать по делу. ceph-csi для RBD отказывает в RWX, если том файловый, и разрешает, если блочный:
rbd: RWX access mode request is only valid for volumes with access type block
Логика прямая: RBD — блочное устройство, а ext4 или XFS поверх него — это не кластерная файловая система (ФС). Два узла с таким томом, подключённым на запись — гарантированная порча данных, и драйвер говорит «нет» ещё на этапе создания.
Молча соглашается. Драйвер локальных LVM-томов физически не может отдать один том двум узлам. Но если он не отказывает в CreateVolume, PVC с RWX создастся и будет выглядеть работающим — до первой попытки переезда пода. Такое мы по недосмотру допустили при разработке своего драйвера: RWX у модуля локальных томов был, нам это принесли пользователи, пришлось отвечать: «Это баг, который будет исправлен, будет запрещено создавать PVC с RWX». (А чуть дальше будет пример, почему такой баг опаснее, чем кажется.)
А ещё здесь есть момент, который просто надо запомнить: StorageClass не умеет ограничивать access modes — в нём просто нет такого поля. Единственный предохранитель на этапе создания — либо отказ драйвера, либо admission-вебхук.
Отступление: вебхук, который запретил RWX и сломал экспорт диска
Вебхук как предохранитель — это не теория, а история из практики.
Например, в модуле реплицируемых томов Deckhouse Platform RWX разрешён только для дисков виртуальных машин. Реализовано это валидирующим вебхуком, который смотрит на имя пользователя, создающего PVC: в белом списке лежат сервис-аккаунты контроллера виртуализации, всем прочим RWX на этом провижинере запрещён. Проверили руками — работает как задумано: для виртуалки RWX PVC создаётся, руками — нет.
А потом перестал работать экспорт данных виртуального диска. Ресурс DataExport, который за это отвечает, залипал в Pending, и в логах контроллера было:
admission webhook "d8-sds-replicated-volume-pvc-validation.storage.deckhouse.io" denied the request:
Creating PVC with accessMode ReadWriteMany using StorageClass "rv-thin-r1"
(provisioner "replicated.csi.storage.deckhouse.io") is not allowed for user
"system:serviceaccount:d8-storage-volume-data-manager:controller"
Сообщение говорит «Creating PVC», но никто никакого PVC не создавал. Контроллер экспорта всего лишь добавлял аннотацию к уже существующему PVC диска.
Дело в том, что вебхук был зарегистрирован не только на CREATE, но и на UPDATE. Поэтому любой патч чужого RWX-тома от пользователя не из белого списка получал отказ — даже патч, который к access mode не имел вообще никакого отношения.
Закономерный вопрос от пользователя экспорта: «А зачем в вебхуке оставлен UPDATE? Разве RWO/RWX не immutable?»
А он immutable. Проверка на UPDATE была косяком с самого начала: сменить режим у существующего PVC всё равно нельзя. Зато она ломала операции, о которых автор вебхука не подумал, а на ревью упустили, — экспорт диска, а при более широком матчинге сломала и расширение тома, потому что ресайз — тоже патч PVC.
Мораль проста: если вы ограничиваете вебхуком неизменяемое поле, вам нужен только CREATE. Проверка на UPDATE не добавляет защиты, но добавляет отказов в местах, которые вы не проверяли. Да и в целом, чем меньше операций задевает вебхук, тем лучше.
Второе место: аттач. Единственное место, где стреляет RWO
Вот здесь живёт та самая Multi-Attach error. Отвечает за неё attach/detach controller внутри kube-controller-manager: перед тем как прикрепить том к одному узлу, он смотрит, не прикреплён ли он уже к другому.
Решение принимает функция с говорящим названием IsMultiAttachAllowed, и логика у неё такая: если среди режимов PV есть RWX или ROX — мультиаттач разрешён. Не «если запрошен именно RWX», а «если хоть один из них есть в списке». Функция давно не менялась, а комментарии в ней честно говорят, что она полагается на драйверы, которые «не разрешают неподдерживаемые режимы».
Вот и вторая половина той истории про «молча соглашается». Если драйвер принял RWX на томе, который физически RWX не умеет, то у PV в списке режимов оказывается RWX. Дальше IsMultiAttachAllowed видит RWX и отключает единственную защиту, которая у вас была. Никакой Multi-Attach error не будет: контроллер честно прикрепит локальный том к двум узлам, потому что PV сказал, что так можно.
Это не гипотетический риск — это прямое следствие того, что проверка режима на этапе создания необязательна, а проверка на этапе аттача доверяет результату первой.
Ту же дыру можно прокопать руками. Комбинацию RWO плюс ROX провижинер отвергнет, но PV, созданный статически, никакой библиотекой в процессе не проверяется: напишите в манифесте оба режима — и получите PV, на котором мультиаттач разрешён. Выглядит это так: статический PV с обоими режимами и PVC, который к нему привязывается.
apiVersion: v1
kind: PersistentVolume
metadata:
  name: static-rwo-rox
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadWriteOnce
    - ReadOnlyMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: ""
  csi:
    driver: <имя драйвера>
    volumeHandle: <идентификатор существующего тома>
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: static-rwo-rox
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: ""
  volumeName: static-rwo-rox
  resources:
    requests:
      storage: 10Gi
PVC просит только RWO, но проверка при аттаче смотрит на режимы PV, а там есть ROX. Запустите с этим PVC два пода на разных узлах: Multi-Attach error не будет, а kubectl get volumeattachments покажет два аттача тома static-rwo-rox, оба с attached: true. Реальному драйверу понадобятся ещё его volumeAttributes и секреты, но на режимы это не влияет.
Теперь про два разных текста ошибки, которые часто считают одним и тем же.
«Volume is already exclusively attached to one node and can't be attached to another». Том привязан к другому узлу, но подов, которые его используют, там уже нет. Обычно это застрявший VolumeAttachment после падения узла или сбоя драйвера. Именно этот случай был у Prometheus из начала статьи. Лечится он просто удалением зависшего объекта — но с оговоркой, о ней ниже.
«Volume is already used by pod(s) …». На другом узле есть живой под, который держит том. Это штатное поведение: ждём завершения старого пода. Ничего удалять не нужно категорически.
Разница принципиальная: в первом случае система рассказывает вам о собственном рассогласовании, во втором — о нормальной очерёдности.
А ещё Multi-Attach error бывает совершенно нормальным явлением. В одном из обращений человек недоумевал, почему видит её на csi-ceph, и прислал события пода:
Warning  FailedAttachVolume      86s   Multi-Attach error for volume "pvc-..."
Normal   SuccessfulAttachVolume  75s   AttachVolume.Attach succeeded for volume "pvc-..."
Одиннадцать секунд между «НЕ ОК» и «ОК». Под переезжал, старый аттач ещё не отпустили, контроллер попробовал, получил отказ, подождал, повторил и прикрепил. Тревожиться тут не о чем — тревожиться надо, когда отказ повторяется снова и снова.
Почему переезд с мёртвого узла занимает минуты
Если узел не отвечает, контроллер не отцепляет том мгновенно. Он ждёт ReconcilerMaxWaitForUnmountDuration — по умолчанию шесть минут — и только потом делает принудительный детач. Отсюда типовая жалоба «Под переезжает десять минут»: сначала шесть минут ожидания, затем аттач на новом узле, потом монтирование.
Кстати, принудительный детач — компромисс, и не всегда желанный: для хранилища, где старый узел может быть жив и просто отрезан от API-сервера, это прямой путь к двум монтированиям. Поэтому в контроллере есть отдельный переключатель disableForceDetachOnTimeout, отключающий это поведение. Однако при нём том никогда не уедет сам с мёртвого узла и переезд становится полностью ручным.
Три аттача на один том
Теперь самое интересное. В том же контроллере есть комментарий:
In theory, these arrays should have always only one element — the controller does not allow more than one attachment. But use array just in case…
«На всякий случай» оказался пророческим. Вот живой кластер:
$ kubectl get volumeattachments | grep pvc-0cf4916a-...
csi-286dc9...   csi.dvp.deckhouse.io   pvc-0cf4916a-...   worker-1   true   34d
csi-6bf6ed...   csi.dvp.deckhouse.io   pvc-0cf4916a-...   worker-2   true   10d
csi-9dd61c...   csi.dvp.deckhouse.io   pvc-0cf4916a-...   worker-3   true   28d
Один PV, три VolumeAttachment, все три в состоянии attached: true, на трёх разных узлах, возрастом 34, 10 и 28 дней. Проблему заметили только тогда, когда под Prometheus отказался переезжать.
Наш инженер драйвера воспроизвёл сценарий по коду:
Заехал кластер, поднялась нагрузка.
Узел упал с ошибкой или был корректно удалён.
NodeUnpublishVolumeувидел «инстанса нет», не обработал этот случай и вернул ошибку.Следующий
Publishсделал новый аттач.
Повторяем пару раз — и получаем тот самый массив.
Контроллер Kubernetes при этом ведёт себя корректно: он не создаёт второй аттач сам. Но он и не является источником истины о том, что реально подключено к узлу. Истину знает драйвер, а VolumeAttachment — это только его отчёт. Драйвер, который на ошибку отвечает ошибкой вместо идемпотентной обработки «уже нет», накапливает в API мусор, который потом блокирует переезд подов.
Отсюда практическое правило: прежде чем удалять VolumeAttachment руками, убедитесь, что старый узел действительно не держит том. На локальном LVM цена ошибки будет невелика. На SAN-массиве, где путь до LUN может быть живым, а узел просто не отвечает API-серверу, вы своими руками создаёте двух писателей в одну файловую систему.
По шагам это выглядит так.
Сначала найдите аттачи конкретного тома:
PV=$(kubectl -n <неймспейс> get pvc <имя PVC> -o jsonpath='{.spec.volumeName}')
kubectl get volumeattachments -o custom-columns=\
NAME:.metadata.name,NODE:.spec.nodeName,ATTACHED:.status.attached,PV:.spec.source.persistentVolumeName \
  | grep -E "^NAME|$PV"
Затем проверьте узел из колонки NODE: нет ли на нём подов с этим PVC и не числит ли kubelet том в используемых:
NODE=<узел из вывода выше>
kubectl get pods -A --field-selector spec.nodeName=$NODE -o json \
  | jq -r '.items[] | select(.spec.volumes[]?.persistentVolumeClaim.claimName=="<имя PVC>") | .metadata.namespace+"/"+.metadata.name'
VH=$(kubectl get pv $PV -o jsonpath='{.spec.csi.volumeHandle}')
kubectl get node $NODE -o jsonpath='{.status.volumesInUse}' | grep -F $VH
Если до узла можно достучаться, проверьте на нём самом, не смонтирован ли том. Вторая команда — для блочных томов:
findmnt -rn | grep <имя PV>
ls /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/ | grep <имя PV>
Если узел не отвечает, убедитесь, что он действительно выключен (через консоль гипервизора или IPMI), а не просто отрезан от API-сервера. Только когда все проверки пусты, удаляйте аттач:
kubectl delete volumeattachment <NAME из первого шага>
Чем это заканчивается, видно по другому обращению: после серии таких переездов там пришлось собирать e2fsck из исходников, потому что версия в дистрибутиве не понимала фич файловой системы, а повреждено было почти всё:
Free blocks count wrong for group #18 (32768, counted=16150).
Fix? yes
Данные в итоге восстановили. Но начиналось всё с невинного маленького залипшего аттача.
Когда никто не смотрит
Вся защита из предыдущего раздела работает только для драйверов, которые объявили attachRequired: true в своём объекте CSIDriver. Если там false, attach/detach controller такие тома вообще не обрабатывает: нет аттача — нет VolumeAttachment, нет проверки, нет Multi-Attach error.
Поле опциональное, и по умолчанию API подставляет true. То есть «в манифесте ничего не написано» означает «аттач нужен».
Посмотрим на наши модули:
Драйвер | attachRequired |
|---|---|
Локальные LVM-тома | true |
Реплицируемые тома | true |
Ceph RBD | true |
CephFS | false |
NFS | false |
S3 | false |
SAN через iSCSI/FC | true |
NetApp | Поле не задано, значит true по умолчанию |
Вот и третья иллюзия, довольно массовая: ReadWriteOnce на NFS не защищает ни от чего. Вы написали RWO, Kubernetes ничего не проверил, драйвер не возражал, и два пода на двух разных узлах пишут в один каталог. Работать это будет — NFS на то и рассчитан. Но если вы выбрали RWO в расчёте на то, что кто-то не даст запуститься второму писателю, вы ошиблись адресом.
Есть и обратный эффект. Симптом из ещё одного обращения: persistentvolume pvc-29ed2fab-... is still attached to node node-1.
При этом VolumeAttachment для этого PV в кластере нет. Помогает перезапуск kubelet на том узле, где том «якобы» прикреплён: состояние аттачей живёт не только в объектах API, но и в памяти компонентов, и эти две картины расходятся.
Тот же вопрос кто-то в канале задал в самой правильной форме: «А если PVC невозможно подключить к узлу — мы как об этом узнаем? Там что-то в volumeattachment написано? Есть там какой-то терминальный статус, типа “невозможно”?»
Терминального статуса нет. В VolumeAttachment появляется status.attachError, и контроллер продолжает пытаться — бесконечно. Выглядит это так:
status:
  attachError:
    message: 'CSINode node-1 does not contain driver ebs.csi.aws.com'
    time: "2026-04-09T11:32:09Z"
  attached: false
Здесь причина вообще не в access mode: драйвер не зарегистрировался на узле. Но узнать об этом можно, только заглянув в объект, ни один статус не скажет вам: «Сдаюсь, это невозможно».
Третье место: планировщик, и только для RWOP
RWOP — единственный режим, о котором знает kube-scheduler. Плагин VolumeRestrictions отказывает узлу, если на нём уже есть под с тем же PVC: node has pod using PersistentVolumeClaim with the same name and ReadWriteOncePod access mode.
Проверка дублируется в kubelet — на случай подов, которые попали на узел мимо планировщика, через nodeName.
Драйвер получит SINGLE_NODE_SINGLE_WRITER, только если объявил capability; иначе от режима останется ровно эта проверка на стороне Kubernetes, и она, в отличие от всего остального, работает на уровне пода.
Отдельно стоит знать про вытеснение: под с RWOP может вытеснить под с меньшим приоритетом, который держит тот же PVC. Для остальных режимов планировщик вообще не смотрит access mode.
Кстати, я поискал ReadWriteOncePod по всей нашей переписке с клиентами за время существования канала поддержки — ни одного упоминания. Ни вопроса, ни жалобы, ни инцидента. Единственный режим с внятной гарантией — и он же, судя по нашей практике, самый невостребованный.
Особенности поведения ROX
Вот это место в документации не описано никак, а различие принципиальное. Возьмём два драйвера и посмотрим в код.
ceph-csi смотрит на access mode. Функция IsReaderOnly проверяет именно режим — MULTI_NODE_READER_ONLY или SINGLE_NODE_READER_ONLY, — и её результат используется при монтировании тома, а ещё для того, чтобы не пытаться создать файловую систему на томе, куда писать нельзя. То есть ROX на PVC действительно делает монтирование доступным только для чтения.
csi-driver-nfs смотрит на флаг пода. Опция ro добавляется, только если в запросе NodePublishVolume стоит Readonly, а этот флаг kubelet выставляет из readOnly в спецификации тома пода. Access mode на монтирование не влияет совсем. ROX на PVC здесь не запрещает ничего.
Практический вывод: если вам нужно, чтобы том не принимал запись, пишите readOnly: true в поде. Это работает всегда и не зависит от драйвера. ROX на PVC — заявка о намерении, а повезёт ли вам с драйвером, который туда вообще смотрит, — неизвестно.
В манифесте пода для этого есть два поля:
spec:
  containers:
    - name: app
      image: busybox:1.36
      volumeMounts:
        - name: data
          mountPath: /data
          readOnly: true
  volumes:
    - name: data
      persistentVolumeClaim:
        claimName: shared-data
        readOnly: true
readOnly в volumeMounts монтирует каталог в контейнер только для чтения силами container runtime, драйвер о нём не узнаёт, поэтому оно и не зависит от драйвера. readOnly в persistentVolumeClaim kubelet передаёт драйверу флагом Readonly в NodePublishVolume — именно по нему csi-driver-nfs добавляет опцию ro.
Block против Filesystem
Таблица из разбора одного красного прогона тестов — падало всё, что файловое, и работало всё, что блочное:
StorageClass | Режим | volumeMode | Результат |
|---|---|---|---|
NFS (immediate/wffc) | RWX | Filesystem | Ошибка |
Реплицируемый тонкий | RWX | Block | ОК |
Локальный тонкий | RWO | Block | ОК |
Вывод автора разбора: «Падают ровно и только volumeMode: Filesystem. Access mode отпадает — RWX есть и среди успешных». NFS попал под подозрение только потому, что блочных томов по NFS не бывает в принципе, он всегда файловый.
Смысл двух вариантов RWX разный настолько, что по-хорошему надо было их разносить в разные режимы:
RWX с файловой системой означает сетевую или кластерную ФС: NFS, CephFS. Согласованность обеспечивает сама ФС.
RWX с блочным устройством означает только то, что два узла видят одно устройство. Согласованность — целиком на приложении. Массовый потребитель лично в нашем случае один — живая миграция виртуальных машин, где приёмник открывает диск, но не пишет в него до переключения.
В манифестах PVC разница — одна строка:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: shared-files
spec:
  accessModes:
    - ReadWriteMany
  volumeMode: Filesystem
  storageClassName: nfs
  resources:
    requests:
      storage: 10Gi
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: vm-disk
spec:
  accessModes:
    - ReadWriteMany
  volumeMode: Block
  storageClassName: rv-thin-r1
  resources:
    requests:
      storage: 10Gi
Зато в поде её видно сразу. Файловый том подключается через volumeMounts и появляется в контейнере каталогом, блочный — через volumeDevices и появляется устройством, с которым приложение должно уметь работать само:
volumeMounts:
  - name: files
    mountPath: /shared
volumeDevices:
  - name: disk
    devicePath: /dev/xvda
Поэтому вопрос «поддерживает ли драйвер X режим RWX» некорректен без уточнения. В канале его задали в самой полезной формулировке — про модуль для SAN-массивов: «Когда будет в продукте, будет ли поддержка RWX или только RWO? Я так понимаю, что для контейнеров будет RWO, для виртуалок — RWX. Хотелось бы, кстати, такие вещи где-то в доке видеть в виде таблицы по всем CSI».
Кстати, требование справедливое, так что вот сводка по документации наших модулей в Deckhouse Platform:
Модуль | Заявленные режимы |
|---|---|
Локальные LVM-тома | RWO |
Реплицируемые тома | RWO; RWX только для виртуализации |
Ceph RBD | RWO и RWX |
CephFS | RWO и RWX |
NFS | RWO и RWX, включая RWX в виртуализации |
S3 | RWO и RWX |
SAN: Huawei, HPE, NetApp, Yadro, scsi-generic | RWO; RWX только для виртуализации |
Два наблюдения по этой таблице.
Первое: формулировка «RWX только в виртуализации» встречается у шести модулей из десяти. Это RWX над блочным устройством для живой миграции ВМ, а не файловый RWX для приложений. Ставить такой том в Deployment с двумя репликами и ждать общего каталога — верный способ потерять данные.
Второе: ReadOnlyMany не заявлен ни одним модулем. Во всей документации он встречается один раз, и то в сноске про проверку, которая для ROX-томов не выполняется. Это неплохо описывает востребованность режима.
Пять способов гарантированно создать проблемы
Ставить RWX «на всякий случай». Часть драйверов откажет сразу, и это лучший исход. Часть молча выдаст том, который развалится при первом переезде пода, — и попутно снимет защиту от мультиаттача, потому что в PV будет стоять RWX.
Ждать, что RWO защитит от второго писателя. На драйвере с attachRequired: false не защитит. И даже на драйвере с аттачем не защитит от второго пода на том же узле — для этого нужен RWOP.
Писать в манифесте PV сразу RWO и ROX. Через провижинер такая комбинация не пройдёт, а в статическом PV пройдёт и отключит проверку на мультиаттач.
Лечить Multi-Attach удалением VolumeAttachment, не проверив узел. Сначала убедитесь, что старый узел мёртв или том действительно отпущен. Иначе вы своими руками организуете двух писателей.
Считать ROX запретом записи. На одном драйвере это сработает, на другом — нет. Запрет записи — это readOnly: true в поде.
Как проверить своё хранилище за 15 минут
Не верьте таблицам (включая мою). Проверьте свой драйвер:
# Что драйвер о себе заявил:
kubectl get csidriver -o custom-columns=\
NAME:.metadata.name,ATTACH:.spec.attachRequired,FSGROUP:.spec.fsGroupPolicy
Дальше пять экспериментов:
Создайте PVC с каждым из четырёх режимов. Смотрите события: отказ в CreateVolume, отказ библиотеки на недопустимой комбинации или подтверждение.
Два пода на разных узлах с RWO-томом. Есть
Multi-Attach errorили нет.Два пода на одном узле с RWO-томом. Пишут оба или нет. (Спойлер: пишут оба.)
То же с RWOP. Планировщик обязан отказать со ссылкой на ReadWriteOncePod.
ROX-том без
readOnly: trueв поде. И попробуйте что-нибудь записать из пода. Результат зависит от драйвера, и гарантированно знать это про своё хранилище может быть полезнее, чем прочитать в статье или документации. («Все врут», помните ведь?)
Пятнадцать минут работы дадут вам точную картину по вашему хранилищу — вместо чужой таблицы или документации, которая могла устареть на прошлом релизе.
Манифесты для пяти экспериментов
Всё создаётся в отдельном неймспейсе. Вместо <sc> подставьте проверяемый StorageClass, вместо <node-1> и <node-2> — имена узлов из kubectl get nodes.
kubectl create namespace am-lab
Эксперимент 1. Четыре режима и одна запрещённая комбинация:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: am-rwo
  namespace: am-lab
spec:
  accessModes: [ReadWriteOnce]
  storageClassName: <sc>
  resources:
    requests:
      storage: 1Gi
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: am-rox
  namespace: am-lab
spec:
  accessModes: [ReadOnlyMany]
  storageClassName: <sc>
  resources:
    requests:
      storage: 1Gi
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: am-rwx
  namespace: am-lab
spec:
  accessModes: [ReadWriteMany]
  storageClassName: <sc>
  resources:
    requests:
      storage: 1Gi
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: am-rwop
  namespace: am-lab
spec:
  accessModes: [ReadWriteOncePod]
  storageClassName: <sc>
  resources:
    requests:
      storage: 1Gi
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: am-rwo-rox
  namespace: am-lab
spec:
  accessModes: [ReadWriteOnce, ReadOnlyMany]
  storageClassName: <sc>
  resources:
    requests:
      storage: 1Gi
Проверка: kubectl -n am-lab get pvc, затем kubectl -n am-lab describe pvc <имя> для тех, что остались в Pending: в событиях будет ProvisioningFailed с текстом отказа драйвера или библиотеки. Если у StorageClass volumeBindingMode: WaitForFirstConsumer, провижининг начнётся только после появления пода с этим PVC — возьмите под writer-a из следующего шага и поменяйте в нём claimName.
Эксперимент 2. Два пишущих пода с одним RWO-томом на разных узлах:
apiVersion: v1
kind: Pod
metadata:
  name: writer-a
  namespace: am-lab
spec:
  nodeSelector:
    kubernetes.io/hostname: <node-1>
  containers:
    - name: writer
      image: busybox:1.36
      command: ["sh", "-c", "while true; do date >> /data/$(hostname).log; sleep 5; done"]
      volumeMounts:
        - name: data
          mountPath: /data
  volumes:
    - name: data
      persistentVolumeClaim:
        claimName: am-rwo
---
apiVersion: v1
kind: Pod
metadata:
  name: writer-b
  namespace: am-lab
spec:
  nodeSelector:
    kubernetes.io/hostname: <node-2>
  containers:
    - name: writer
      image: busybox:1.36
      command: ["sh", "-c", "while true; do date >> /data/$(hostname).log; sleep 5; done"]
      volumeMounts:
        - name: data
          mountPath: /data
  volumes:
    - name: data
      persistentVolumeClaim:
        claimName: am-rwo
Проверка: kubectl -n am-lab describe pod writer-b — есть ли в событиях Multi-Attach error.
Эксперимент 3. Удалите writer-b (kubectl -n am-lab delete pod writer-b), замените в его манифесте <node-2> на <node-1> и создайте заново. Проверка: kubectl -n am-lab exec writer-a -- ls /data — если там лежат и writer-a.log, и writer-b.log, пишут оба пода.
Эксперимент 4. Удалите оба пода, замените в обоих манифестах claimName на am-rwop, оставьте оба на <node-1> и создайте снова. Проверка: второй под остаётся в Pending, а в событиях FailedScheduling есть текст про ReadWriteOncePod.
Эксперимент 5. Под без readOnly пытается записать на ROX-том:
apiVersion: v1
kind: Pod
metadata:
  name: rox-probe
  namespace: am-lab
spec:
  containers:
    - name: probe
      image: busybox:1.36
      command: ["sh", "-c", "touch /data/probe && echo WRITE OK || echo WRITE DENIED; sleep 3600"]
      volumeMounts:
        - name: data
          mountPath: /data
  volumes:
    - name: data
      persistentVolumeClaim:
        claimName: am-rox
Проверка: kubectl -n am-lab logs rox-probe. Пустой ROX-том блочного драйвера может не смонтироваться вовсе: файловую систему на томе только для чтения драйвер не создаёт. Тогда создайте am-rox из снимка или клона заполненного тома через dataSource.
Уборка:
kubectl delete namespace am-lab
Вывод
Access mode — это трёхсторонний контракт, где каждая из сторон работает с ним по-разному.
Пользователь заявляет режим в PVC. Kubernetes проверяет ровно два места: аттач тома ко второму узлу, и только для драйверов с attachRequired: true, плюс планирование пода, и только для ReadWriteOncePod. Всё остальное решает драйвер — от честного отказа до молчаливого согласия на некорректное поведение.
Самое неприятное в этой схеме то, что решения могут быть завязаны друг на друга. Проверка при аттаче доверяет тому, что записано в PV, а записано там то, с чем согласился драйвер. Драйвер, принявший некорректный режим, не просто выдаст неработающий том: он отрубит единственную защиту, которая предполагалась.
Если вам нужна гарантия одного писателя, это ReadWriteOncePod и драйвер, который умеет сказать «нет». Если нужны несколько писателей, требуется файловая система или приложение, которые к этому готовы. Буква X в названии режима сама по себе ничего не гарантирует.
Источники
Исходники Kubernetes:
Исходники драйверов:
P. S.
Читайте также в нашем блоге:
