
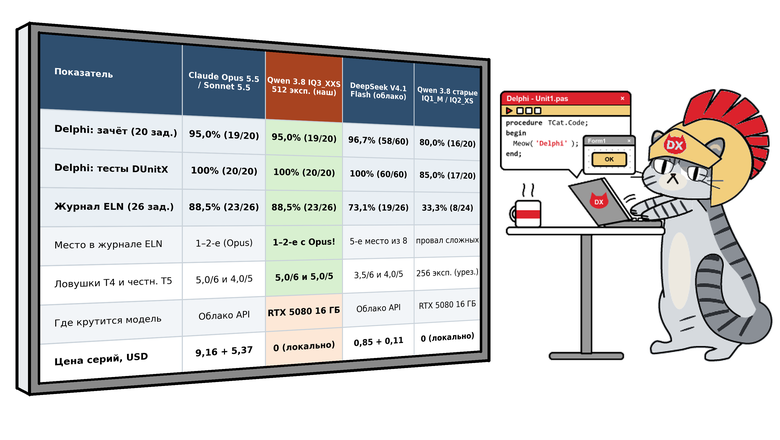
В двух предыдущих статьях мы проверяли языковые модели на наших повседневных задачах: работе с данными в электронном лабораторном журнале и исправлении ошибок в трёх закрытых проектах на Delphi — от программы рентгеновской рефлектометрии X‑Ray Calc до нашей системы управления лабораторией.
В обоих тестах локальные модели на моей рабочей станции (одна карта RTX 5080 на 16 ГБ и 62 ГБ оперативной памяти) заметно отставали от облачных лидеров. На вопросах по журналу ранняя сборка Qwen 3.8 IQ2_XS набрала жалкие 33% (8 из 24), а gpt‑oss-20b — 40%. На задачах Delphi специализированная Qwen 3.8 Coder IQ1_M взяла 16 задач из 20 (80%). Результат уже вполне рабочий, но до Claude Sonnet 5.5 (19/20) она всё‑таки не дотянула.
Конечно, можно было на этом успокоиться и списать отставание на скромные 16 гигабайт видеопамяти. Но мне не давал покоя вопрос: модель действительно упёрлась в свой потолок или мы сами подрезали ей крылья настройками и капризными инструментами? Сели разбираться — и довольно быстро нашли узкие места. Поменяли урезанную сборку весов на полную, поправили конфигурацию сервера, научили инструменты спокойно относиться к мелким огрехам сериализации — и на том же самом железе локальная Qwen 3.8 взяла реванш!
Куда делась половина экспертов?
Начнём с того, почему Qwen 3.8 Flash Next Coder IQ1_M в первом тесте Delphi остановилась на 16 задачах из 20.
Чтобы ужать модель в 23,4 ГБ, авторы этой сборки применили жёсткое квантование (~1,6 бита на вес) и вырезали половину маршрутизируемых экспертов в каждом слое — оставили 256 из 512. На простых и средних правках подмены почти не видно. Проблемы вылезают там, где нужно удерживать в голове сразу несколько подсистем: вложенные транзакции FireDAC в ELN-03, пересчёт интерфейса трибометра в TRB-06, перепаковку архивов проекта в XRC-06 и фоновую проверку обновлений со сверкой SHA-256 в XRC-09. На этих четырёх задачах урезанная модель раз за разом промахивалась.
Поэтому полумеры отбросили и взяли полную 512-экспертную версию Qwen3.8-Flash‑Next‑GSQ‑RCO‑IQ3_XXS (2,84 бита на вес, 40,0 ГиБ экспертов) от австрийской лаборатории ISTA‑DASLab. В недавнем хабра‑обзоре «Впихнуть невпихуемое» как раз подробно разбирали иерархию памяти движка Strata и эти сборки: по таблицам теоретического сохранения точности младший квант IQ2_XS (85,0% от BF16) и IQ3_XXS (87,3%) отличаются всего на 2,3 процентных пункта. Но одно дело — замер перплексии на коротком тексте, и совсем другое — многоходовый агент с контекстом под сто тысяч токенов, где каждая мелкая неточность в маршрутизации экспертов или вызове инструмента накапливается от шага к шагу.
Как уложить 40 ГиБ экспертов в 16 ГБ видеопамяти и 62 ГБ ОЗУ
Арифметика вроде бы простая: в машине стоит 62 ГБ оперативной памяти, так что 40 ГиБ экспертов должны поместиться без труда. Запускаем проверку на сложной задаче ELN-03 — и агент снова упирается в 45-минутный таймаут! Полезли в логи движка Strata и нашли две неочевидные ловушки:
1. Двойное резервирование памяти (‑resident‑experts). При старте сервер загружает 4323 самых ходовых экспертных слота (7,0 ГиБ) прямо в видеопамять RTX 5080. Но по умолчанию он одновременно пытается заблокировать (page‑lock) в системной памяти все 40,0 ГиБ экспертов целиком. В итоге свободной ОЗУ в системе оставалось всего 0,7 ГиБ, и сервер молча отключал кэш диалогов (conversation‑cache). А без этого кэша на каждом шаге длинной сессии агенту приходилось заново перечитывать по 60–100 тысяч токенов истории, теряя по минуте на ровном месте. Флаг ‑resident‑experts решает проблему радикально: в оперативной памяти блокируется только дополнение к видеопамяти — 33,5 ГиБ вместо 40,0 ГиБ. Освободившиеся гигабайты позволили отдать 5,4 ГиБ под кэш сессий (‑conversation‑cache‑mib 5376 ‑conversation‑cache‑min‑free‑mib 0), а подкачка редких экспертов в видеокарту пошла напрямую из ОЗУ, вообще без обращений к диску.
2. Обрыв мысли на полуслове (answer_room и maxTokens). Перед тем как трогать код в большом репозитории, модель пишет внутри тега <think> подробный план действий на 6–9 тысяч токенов. В настройках нашего агента OMP стоял привычный потолок maxTokens: 8192, а на стороне сервера была включена настройка «answer_room»: true. Что происходило на практике? Как только рассуждение доходило до 6144 токенов, сервер принудительно закрывал тег </think>, оставляя 2048 токенов под сам ответ. Мысль обрывалась на середине фразы. Недодумавшая модель выдавала куцый комментарий без единого вызова инструмента, и на следующем ходу всё начиналось сначала. Кстати, в точности на те же грабли недавно наступили авторы бенчмарка художественного перевода BookTrans: у них рассуждающие модели (Qwen 3.8, DeepSeek, GLM) сжигали весь дефолтный лимит роутера на внутренние размышления и получали баранку просто потому, что на сам ответ токенов уже не оставалось. Подняли лимит до maxTokens: 16 384 в models.yml, поставили «answer_room»: false в профиле сервера — и холостые обороты исчезли как по волшебству.
Вот рабочий профиль strata‑iq3_xxs.json, на котором модель уверенно держит 70–81 токен в секунду при контексте 131 072 токена:
{
   "args": [
     "--pack", "D:\\Program Files\\Strata-data\\packs\\iq3_xxs",
     "--native", "D:\\Program Files\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00001-of-00002.gguf",
     "--ple-gguf", "D:\\Program Files\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00002-of-00002.gguf",
     "--expert-cache", "auto",
     "--prefill", "auto",
     "--spec", "4",
     "--max-context", "131072",
     "--kv", "int8",
     "--kv-resident", "32768",
     "--resident-experts",
     "--conversation-cache-mib", "5376",
     "--conversation-cache-min-free-mib", "0",
     "--vram-reserve-mib", "1200"
   ],
   "answer_room": false
 }
Кстати, ещё одна мелочь для Windows. Разметка 33,5 ГиБ page‑locked памяти при старте занимает около полминуты, поэтому перезапускать сервер между задачами — только время терять. Лучше поднять один постоянный процесс на всю серию. А когда понадобится его остановить, посылайте SIGTERM родительскому процессу Python (он держит Windows Job Object). Если просто убить процесс через taskkill /F /IM strata.exe, обвязка решит, что движок упал, и тут же поднимет его заново.
Итоги: реванш на обоих бенчмарках
1. Кодинг‑агент для Delphi (20 задач)
Напомню условие из статьи про Delphi: задача считается решённой, только если проект собирается в RAD Studio без единого нового предупреждения компилятора (warnings <= warning_baseline) и проходит все скрытые тесты DUnitX. Чтобы не перегружать таблицу, я оставил в ней только лидеров рейтинга и обе локальные сборки Qwen.
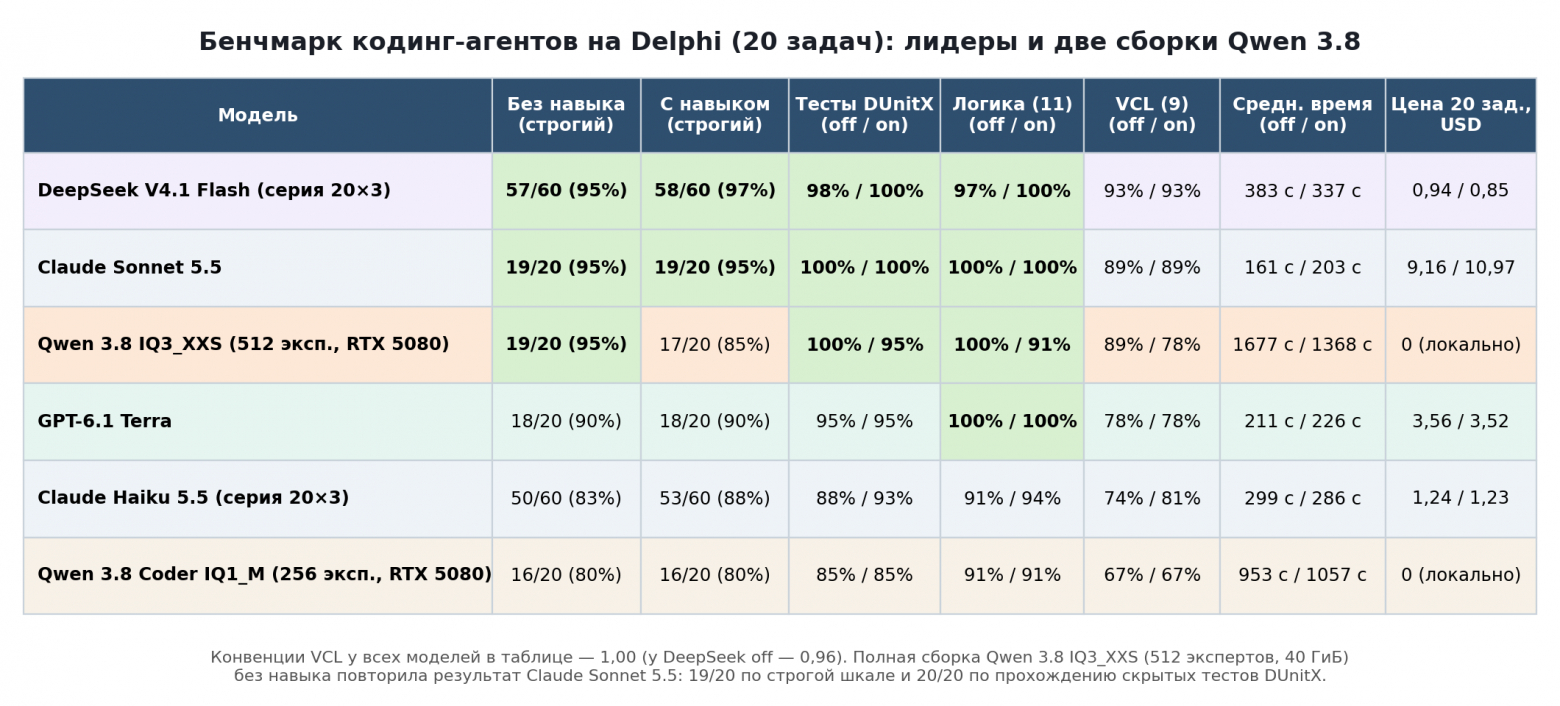
Модель | Без навыка (строгий зачёт) | С навыком delphi‑development | Тесты DUnitX (off / on) | Логика (11) (off / on) | VCL (9) (off / on) | Среднее время (off / on) | Цена 20 задач |
DeepSeek V4.1 Flash (20×3) | 57/60 (95%) | 58/60 (97%) | 98% / 100% | 97% / 100% | 93% / 93% | 383 с / 337 с | $0,94 / $0,85 |
Claude Sonnet 5.5 | 19/20 (95%) | 19/20 (95%) | 100% / 100% | 100% / 100% | 89% / 89% | 161 с / 203 с | $9,16 / $10,97 |
Qwen 3.8 IQ3_XXS (локально, 512 эксп.) | 19/20 (95%) | 17/20 (85%) | 100% / 95% | 100% / 91% | 89% / 78% | 1677 с / 1368 с | $0 |
GPT-6.1 Terra | 18/20 (90%) | 18/20 (90%) | 95% / 95% | 100% / 100% | 78% / 78% | 211 с / 226 с | $3,56 / $3,52 |
Claude Haiku 5.5 (20×3) | 50/60 (83%) | 53/60 (88%) | 88% / 93% | 91% / 94% | 74% / 81% | 299 с / 286 с | $1,24 / $1,23 |
Qwen 3.8 Coder IQ1_M (локально, 256 эксп.) | 16/20 (80%) | 16/20 (80%) | 85% / 85% | 91% / 91% | 67% / 67% | 953 с / 1057 с | $0 |
Без дополнительного навыка полная Qwen 3.8 IQ3_XXS один в один повторила результат Claude Sonnet 5.5: 19 задач из 20 по строгой шкале (95%) и все 20 из 20 по скрытым тестам DUnitX! За соблюдение правил оформления VCL она тоже получила максимальную единицу во всех 18 интерфейсных запусках. Все три задачи, на которых прежде спотыкалась урезанная Coder IQ1_M (ELN-03, TRB-06 и XRC-09), полная модель взяла в обоих режимах. А единственный потерянный балл в строгом зачёте без навыка пришёлся на ту самую злополучную XRC-06, где точно так же срезалась и Sonnet 5.5. Все 37 тестов перепаковки zip‑архива там прошли, но скопированная из соседней процедуры проверка TFileAttribute.faReadOnly добавила второе платформенное предупреждение W1002 сверх базового одного.
Любопытно, что с подключённым навыком delphi‑development счёт у полной модели оказался чуть ниже — 17 из 20 (одна ошибка в тестах на TRB-04 и лишние предупреждения компилятора в XRC-06 и XRC-08), хотя среднее время решения сократилось с 28 до 23 минут. Причина та же, что и у старших облачных моделей. Сильная модель и без шпаргалки читает соседние модули и перенимает стиль проекта, а лишние инструкции в системном промпте на единичных попытках вносят обычный статистический разброс. Ну и разумеется, токены при этом жрет.
2. Агент электронного лабораторного журнала ELN (26 задач)
Второе испытание — обновлённый набор ELN Suite 1.1 из 26 задач поверх живого сервера MCP (подробно я описывал его в октябрьской статье). Здесь мало просто вытащить числа из базы, логов напыления.tsv или файлов рентгеновской подгонки.xrcx. В задания зашиты настоящие лабораторные капканы: путаница в таблице источников питания, прыгающие коды неисправной термопары в сырых строках лога, безымянные участки записи без меток технологических стадий и прикреплённый к образцу чужой файл подгонки 1284 с противоречивой историей. За безупречный ответ даётся 1 балл, за верные цифры с огрехом в строгости формулировки — 0,5 балла.
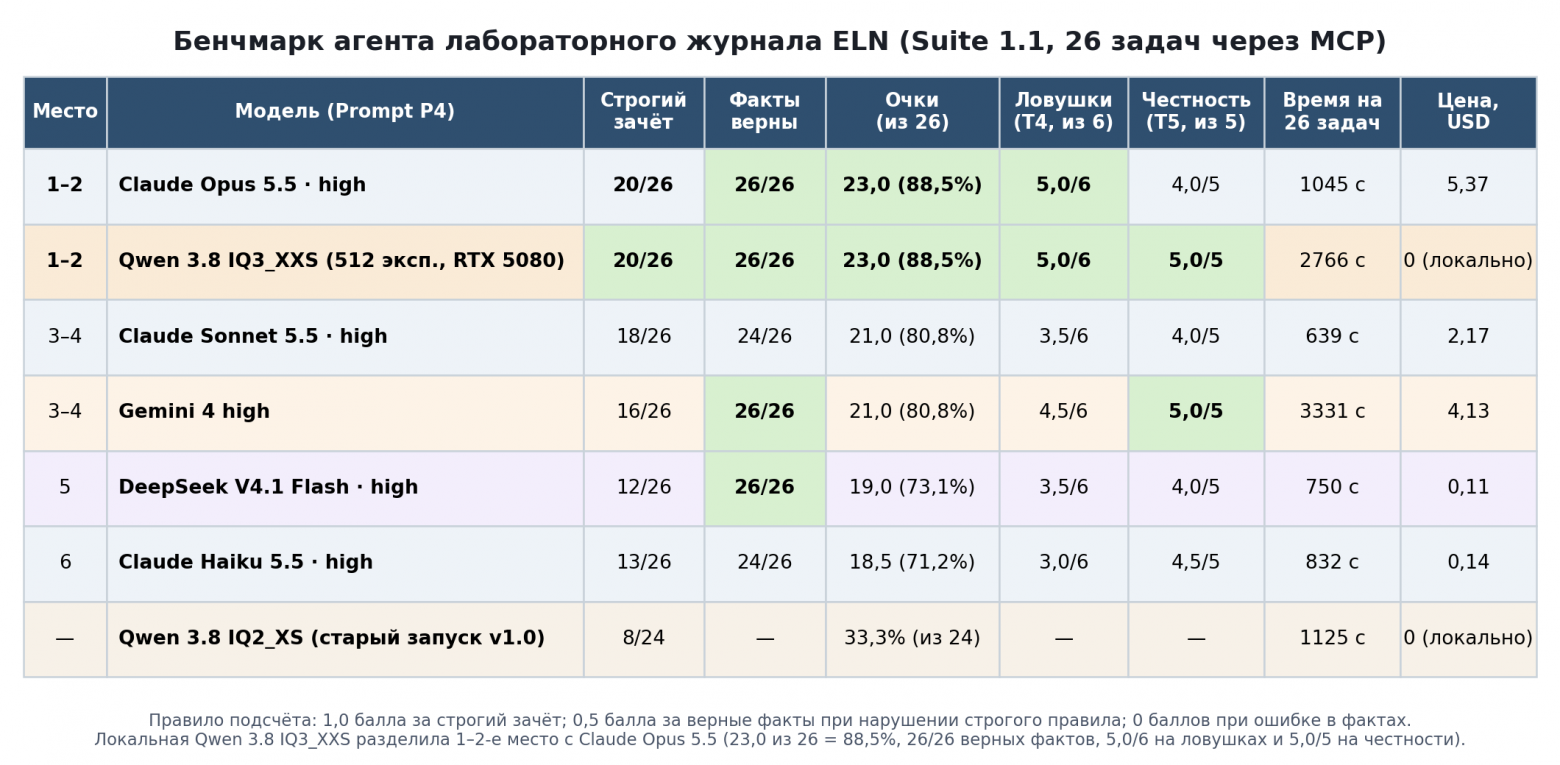
Место | Модель | Строгий зачёт | Факты верны | Очки (из 26) | Ловушки (T4, из 6) | Честность (T5, из 5) | Время на 26 задач | Цена |
1–2 | Claude Opus 5.5 | 20/26 | 26/26 | 23,0 (88,5%) | 5,0/6 | 4,0/5 | 1045 с | $5,37 |
1–2 | Qwen 3.8 IQ3_XXS (локально) | 20/26 | 26/26 | 23,0 (88,5%) | 5,0/6 | 5,0/5 | 2766 с | $0 |
3–4 | Claude Sonnet 5.5 | 18/26 | 24/26 | 21,0 (80,8%) | 3,5/6 | 4,0/5 | 639 с | $2,17 |
3–4 | Gemini 4 high | 16/26 | 26/26 | 21,0 (80,8%) | 4,5/6 | 5,0/5 | 3331 с | $4,13 |
5 | DeepSeek V4.1 Flash | 12/26 | 26/26 | 19,0 (73,1%) | 3,5/6 | 4,0/5 | 750 с | $0,11 |
6 | Claude Haiku 5.5 | 13/26 | 24/26 | 18,5 (71,2%) | 3,0/6 | 4,5/5 | 832 с | $0,14 |
— | Qwen 3.8 IQ2_XS (старый запуск v1.0) | 8/24 | — | (33,3%) | — | — | 1125 с | $0 |
Тут скачок вышел ещё заметнее. Вместо прежних 33% локальная Qwen 3.8 IQ3_XXS набрала 23,0 балла из 26 (88,5%), уложилась в 46 минут на всю серию и разделила первое место с Claude Opus 5.5 — опередив и Sonnet 5.5, и Gemini 4, и DeepSeek Flash! Во всех 26 задачах она выдала безупречно точные цифры (26/26 по фактам), а на самых зубодробительных проверках — технологических ловушках четвёртого уровня (5,0 из 6) и научной честности пятого уровня (5,0 из 5) — домашняя модель выступила наравне с лучшими облачными флагманами или даже чуть аккуратнее них.
Правда, последний, двадцать третий балл достался ей не сразу — и эта история отлично показывает, как легко загубить работу толковой локальной модели излишним формализмом в самих инструментах. В первом полном запуске с новым профилем Qwen 3.8 набрала 22,0 балла из 26, а единственный ноль схватила на самом первом, разминочном вопросе B01 («Сколько проектов в журнале и в каком больше всего записей?»). Обидно до смешного: первым же вызовом list_projects без аргументов модель получила готовый список из 27 проектов и уже знала правильный ответ. Но перед тем, как написать текст, решила проявить усердие — проверить, нет ли скрытых архивных проектов, — и передала в булев параметр include_archived строку «True» с большой буквы в кавычках вместо JSON‑литерала true.
Самое смешное, что харнесс OMP такие мелочи спокойно переваривает и на лету приводит «True» к булеву true. Но в стенде бенчмарка перед отправкой запроса стоял наш собственный строгий валидатор JSON‑схемы ReadGuard, а внутри самого сервера ELNMCPServer.exe функции разбора параметров GetOptBool и GetOptInt исторически дублировались в пяти разных модулях Delphi. В модуле записи и в модуле тегов строка «True» и пустой null на необязательных полях давно обрабатывались штатно, а вот в модуле навигации осталась старая проверка V is TJSONBool, которая просто игнорировала строку или падала на null. Мы вычистили это дублирование на стороне Delphi, свели разбор скалярных параметров («true»/«false», «1»/«0» и необязательных null) в единый модуль и синхронизировали правила валидатора ReadGuard с поведением хоста. Стоило убрать эту искусственную подножку, как на повторном полном запуске локальная модель без единой запинки закрыла все 26 задач и догнала Opus 5.5. Недавно в статье «Путь к ИИ‑сингулярности» очень точно подметили болезнь современных агентных систем: когда модель ошибается, разработчики первым делом дописывают новые грозные правила капслоком в CLAUDE.md или AGENTS.md, даже не проверяя, который из слоёв обвязки на самом деле виноват. Наш случай с B01 и проверка навыка delphi‑development (где лишняя шпаргалка не добавила сильным моделям ни балла, а локальную сборку даже чуть отвлекла) наглядно показывают: вместо того чтобы бесконечно раздувать системный промпт, куда полезнее починить саму обвязку и сделать инструменты чуть терпимее к формату аргументов.
Короткая памятка напоследок
Если вы тоже поднимаете локального агента для работы с кодом или базой данных на машине с 16 ГБ видеопамяти и 64 ГБ ОЗУ, вот четыре вещи, которые сэкономят вам кучу нервов:
Не гонитесь за урезанными сборками (pruned MoE). Вырезанная половина экспертов в Coder IQ1_M действительно экономит память, но расплачиваться за неё приходится именно на сложных многоходовых задачах. Полная 512-экспертная IQ3_XXS спокойно вытягивает то, на чём обрезанная сборка буксует.
Включайте ‑resident‑experts вместо полной блокировки весов в ОЗУ. Когда ходовые эксперты уже сидят в видеопамяти, незачем дублировать их в заблокированной оперативке. Держите в ОЗУ только оставшиеся 33,5 ГиБ из 40,0 ГиБ, а освободившееся место отдайте под кэш диалогов (‑conversation‑cache‑mib 5376).
Не жадничайте с maxTokens: 16 384 и отключайте «answer_room»: false. Дайте модели спокойно дописать длинную цепочку рассуждений <think> до конца. Иначе сервер оборвёт её мысль на 6144 токенах, и вы будете часами смотреть, как агент впустую перечитывает стотысячный контекст.
Делайте инструменты снисходительнее к формату входных аргументов (закон Постела для MCP). Компактные и квантованные модели отлично справляются со сложной предметной логикой, но при генерации JSON для вызовов инструментов иногда оборачивают булевы флаги или числа в кавычки («True», «0») или явно передают null в необязательных полях. Если ваш MCP‑сервер и валидатор на входе приводят такие однозначные литералы к нужному типу вместо того, чтобы рвать сессию ошибкой схемы, маленькая локальная модель начинает работать на уровне лучших облачных гигантов.
UPD. Память на 6400 МТ/с и прощание с подкачкой с диска
Как метко подметил @Agubigubaga : «у вас кстати какой то странный объём ОЗУ, куда то 2гб украли.» После этого я полез в BIOS рабочей станции — и точно: почти два гигабайта оперативной памяти молча отъедало встроенное видеоядро процессора, а сама память работала на штатных 4800 МТ/с. Отключил лишний резерв под встройку, поднял доступный объём в Windows с 61,7 до 63,7 ГиБ и заодно включил профиль EXPO на 6400 МТ/с. В прежней 46-минутной серии (2766 с) из-за фоновых программ и четырёхгигабайтного защитного резерва в заблокированную ОЗУ помещалось только 25,3 ГиБ экспертов. Оставшиеся 8,5 ГиБ вытеснялись на диск, и за 26 задач движок успевал перечитать с SSD почти семь терабайт весов (6985 ГБ)! С возвращёнными двумя гигабайтами 7,5 ГиБ (4615 слотов) легли в видеопамять RTX 5080, а все остальные 32,8 ГиБ экспертов целиком вошли в page-locked ОЗУ. Время обсчёта промахнувшегося эксперта на процессоре упало вдвое — с 82–94 мкс (18,6–21,2 ГБ/с) до 41–44 мкс (40,1–42,4 ГБ/с). Средняя скорость генерации выросла с 52,6 до 71,0 ток/с, а вся серия из 26 задач заняла 1976 с (32,9 мин, на 28,6% быстрее) с тем же самым счётом: 20 из 26 в строгом зачёте, 26 из 26 по фактам и 23,0 балла (88,5%).
В логах этого запуска всплыла ещё одна тонкость. Во время чтения длинного промпта Strata временно одалживает у видеокарты 2180 экспертных слотов (3,5 ГиБ) под кольцевой буфер. Из-за стандартного четырёхгигабайтного запаса свободной ОЗУ копии в оперативной памяти сохранялись только для 211 таких слотов из 2180. Поэтому на контекстах за 50 тысяч токенов движку всё ещё приходилось дочитывать с диска 401,6 ГБ. Мы добавили в strata-iq3_xxs.json настройку "env": {"STRATA_RESIDENT_HEADROOM_GIB": "0.5"} и подняли размер заблокированного дополнения в ОЗУ до 36,0 ГиБ. Все 2176 из 2176 одалживаемых слотов остались в оперативной памяти, а обращения к диску после старта исчезли полностью — ноль чтений из файлов за всю серию. Средняя скорость чтения промпта выросла до 2115 ток/с (+44,5% к исходному запуску), генерация ускорилась до 76,0 ток/с, а 26 задач прошли за 1955 с (32,6 мин) при 22,5 балла из 26 (86,5%, 19/26 строго и все 26/26 по фактам) — полбалла разницы пришлось на формулировку примечания о чужом файле подгонки 1284.
UPD 2
Следом читатели резонно спросили, почему в конфиге выключен полноценный нейросетевой черновик ("mtp": false), хотя его веса (mtp/rt, 786 МиБ) уже лежат на диске, а движок пользуется только поиском суффиксов по тексту промпта (--spec 4). Включили полный MTP ("mtp": true, --mtp "D:\Program Files\Strata-data\mtp\rt" --spec-min-p 0.5): черновик занял около гигабайта видеопамяти (кэш экспертов на карте ужался с 4583 до 2975 слотов, а заблокированное дополнение в ОЗУ выросло до 38,6 ГиБ со всеми 2145 одалживаемыми слотами). Взамен средняя скорость генерации подскочила с 76,0 до 99,6 ток/с (медиана — 100,7 ток/с, в пике — 131,6 ток/с), вся серия из 26 задач лабораторного журнала пролетела за 1478 с (24,6 мин — почти вдвое быстрее вчерашних 46 минут!), уже почти на уровне клода, а итоговый счёт снова составил 23,0 балла из 26 (88,5%, 20/26 в строгом зачёте и 26/26 по фактам).
UPD 3
мы проверили старший квант Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S (3,33 бита на эксперт, 3,78 бита в целом, 46,84 ГиБ экспертов вместо 40,0 ГиБ). Раньше установщик Strata отсекал его автоматически, поскольку порог для IQ3_S зашит на отметке 62,0 ГиБ, а со включённым видеоядром система видела только 61,7 ГиБ. На освобождённых 63,7 ГиБ ОЗУ старшая модель встала без единого обращения к диску за весами экспертов: 5,33 ГиБ (2782 слота) и слой MTP разместились в видеопамяти RTX 5080, а все оставшиеся 44,32 ГиБ (включая все 1478 одалживаемых слотов промпта) целиком поместились в заблокированную оперативную память при 6,0 ГиБ свободного запаса. Со включённым полным MTP IQ3_S выдала в среднем 87,3 ток/с на генерации (медиана — 87,7 ток/с, пик — 116,8 ток/с), прошла все 26 задач за 1578 с (26,3 мин), ни разу не ошиблась даже в типах JSON-аргументов (ноль автоисправлений на 237 вызовов), аккуратно выделила спорный файл 1284 в отдельный блок с неразрешённой принадлежностью на сводной задаче B13 и набрала 24,0 балла из 26 (92,3%, 22/26 в строгом зачёте и 26/26 по фактам) — выйдя на чистое первое место впереди Claude Opus 5.5!

