
Хабр Курсы для всех
РЕКЛАМА
Большая витрина: от крупнейших школ до частных авторов. Сравнивайте по цене, длительности, формату и выбирайте самый подходящий курс!

Наконец то хоть какая то статья про страту, а то тут некоторые до сих пор qwen3.5-9b запускают и удивляются чё она такая глупая. IQ3_XXS с 200к контекста стала моей постоянной моделью, быстрее iq3_s, но как будто бы не тупее. И у вас кстати какой то странный объём ОЗУ, куда то 2гб украли.

А почему тесты проходят на delphi? Или это ваш рабочий стек?

Люди добрые неделю как разбираюсь с этими моделями. Упёрся в тяжелую модель стоит qwen 3.5 27 она жутко тормознутая ..B rtx4070 super 12 ddr5 32 nvme 5 7600x ollama 8k питон . Что мне поставить по максимуму что было приемлемые 20-30 токенов и более .. Посоветуйте ..лёгкая Gemma 4b быстрая но для легкой норм

У меня похожий сетап для эксперимента, но хост ос проксмокс, а страта уже в вм отдельной. Работает, но я бы не сказал, что это аналог сонета по вайбам (что бы там ни было по объективным замерам).

Отличный материал, спасибо большое !

Qwen3.6-35B-A3B UD-Q4_K_XL сильно будет хуже чем Qwen 3.8 Flash Next IQ3_XXS?

Подскажи есть ли для связки 24 + 32 что то лучшее чем qwen3.8-27b q4km для кодинга?
Она относительно неплоха, но просто даже с kv cache q8_0 влезает максимум 60-70k токенов.

Думаю стоит попробовать, может под ваши задачи подойдет: https://huggingface.co/peculiar-ragdoll/Tiel-Coder-35B-A3B-GGUF-MTP

я тут прибарахлил железку на 256гб оперативы пропускной способностью 100 гигабайт в секунду, правда видяха только 2060 на 6 gb есть. Надо будет потестить что-нибудь такое

наступил на грабли, в страте 2.10 гайки закрутили по безопасности, в итоге dsh desktop не вызывал инструменты некоторые - они выходили как текст и остановка, например skill. вот патч для frontend.py в инит class OutputParser
declared_only = False
deferred = True
if "skill" not in self.schemas:
self.schemas["skill"] = {"name": "skill", "parameters": {"type": "object", "properties": {}}}
if "compress" not in self.schemas:
self.schemas["compress"] = {"name": "compress", "parameters": {"type": "object", "properties": {}}}
там вроде какие-то флаги, но решил так сделать
кстати compress это tools от billion-context - ставится как прокси между агентом и локальным движком, благодаря ему контекст практически бесконечный и правильно жмется, попадание в кеш обеспечивает стабильно 80-95%
по ощущениям модель лучше 27-ой, по скорости точно (у меня две карты по 16)
да кстати страта с двумя картами лучше сделали работу (если карты разных поколений). А 3.8 некст хорошо понимает 1С специфику из коробки, в 27 такого нет и рядом.

А можно и на самом Delphi запустить Qwen. https://github.com/HemulGM/QuickNN при чем на GPU c Vulkan. Я и клиент сделал, тоже на Delphi
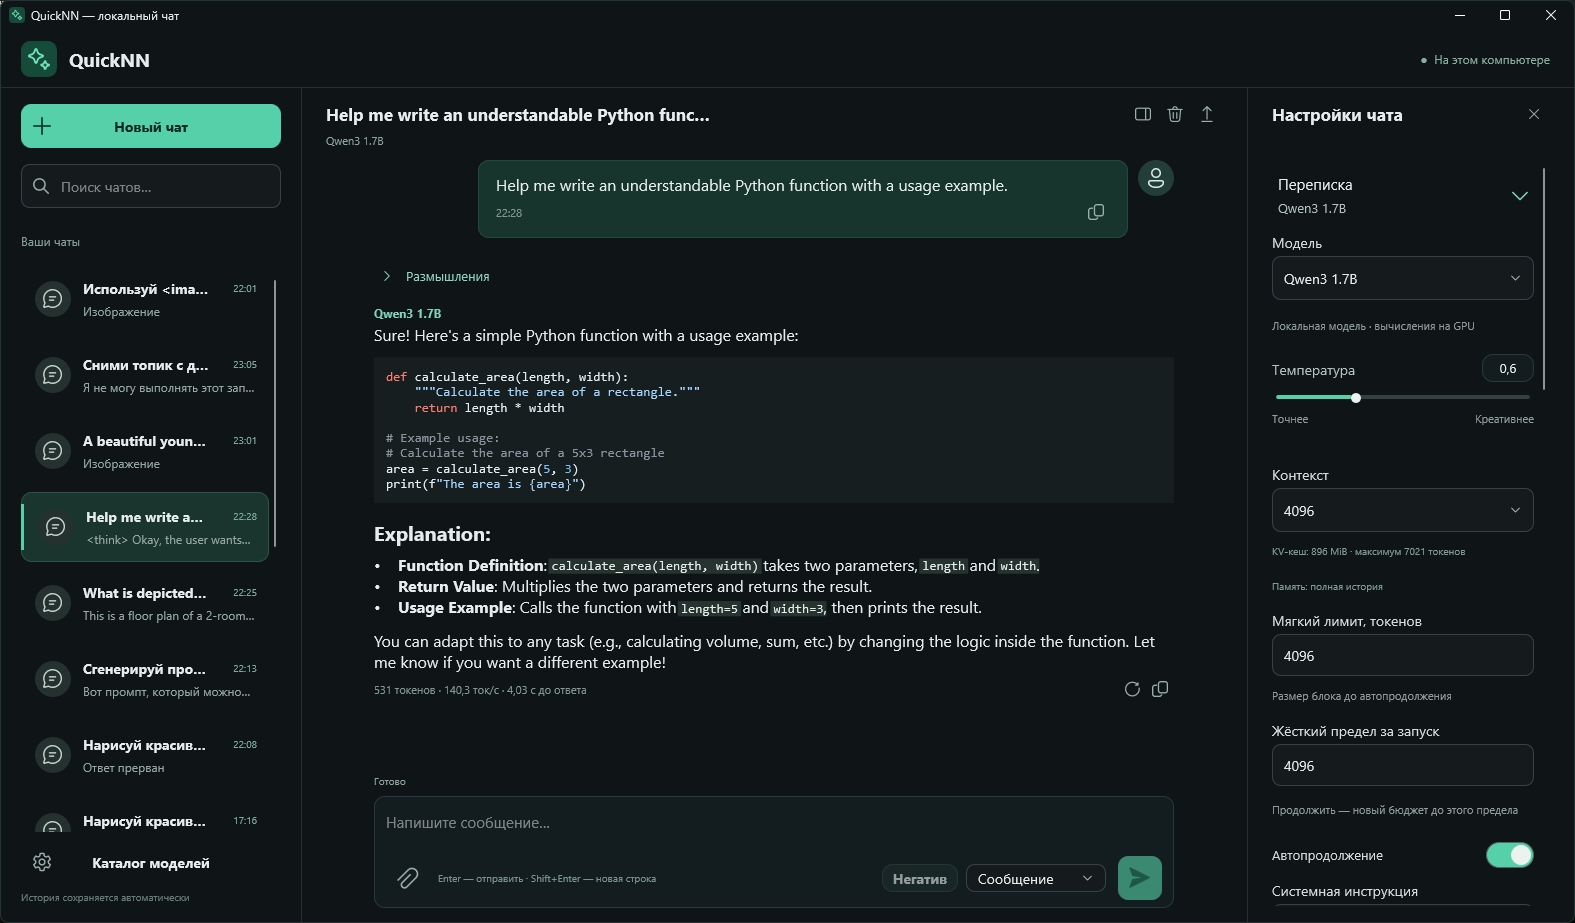
Один ехе на 20мб ну и поддержка многих Qwen. Не всех, но поправить не долго

Как и Вы использую strata. Лучшая модель для такой конфигурации как у Вас (и у меня тоже rtx 5080 + 64ГБ RAM + m.2), это Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S.gguf (это примерно 3.4 бита, вместо Ваших 3.04). Плюсы: умнее во всех задачах, не сильно больше по размеру, выдает те же 70-80 т.с. (при условии использования полного mtp, а не как у Вас частичного). У меня работает в 256к контекстного окна. Использую вместе с kilo code, в режиме использования субагентов может самостоятельно, по плану, работать сутками над сложными задачами.

Спасибо за разбор — история с -resident-experts ровно тот класс проблем, который в отчётах о производительности не виден: сервер формально жив, а кэш диалога молча отключается, и потом ищешь причину в железе.
Один вопрос по методике. Переход у вас сразу по двум переменным: 256 экспертов при ~1,6 бита на вес сменились на 512 экспертов при 2,84 бита. Значит выигрыш на ELN-03, TRB-06 и XRC-06 сейчас нельзя однозначно отнести к возврату вырезанных экспертов — часть эффекта могла дать и сама точность квантования. Если прогон на полных 512 экспертах с IQ2_XS ещё подъёмен по железу, он бы разделил вклад двух факторов. Понимаю, что 40 ГиБ экспертов на 16 ГБ видеопамяти — уже другой режим подкачки, и цена эксперимента во времени высокая.
И второе, из любопытства: при --kv int8 и контексте 131k в многошаговом агенте не пробовали отдельно мерить дрейф на длинной сессии? На коротком тексте int8-кэш почти незаметен, а на сотне шагов с вызовами инструментов накопление ошибки проявляется именно как выпадающие шаги, а не как деградация отдельного ответа — то есть выглядит как проблема агента, а не квантования.

Пару слов про Strata на Windows
1 - лучше зарегистрировать службу и прописать при ее остановке/запуске и перезапусках
сохранение и загрузку KV через файл.
“slot_save_path”: “D:\KV”
2 - если работать со Strata через OpenCode то можно заметить что происходят попытки запуска субагента.
На этот случай можно указать “parallel”: 2
это снизит скорость работы но хотя бы создаст для субагента возможность нормально работать
( вообще-то, я собираюсь настроить правила для субагентов - ходить на другие сервера инфернеса, но пока хоть так, в два потока на ту же Strata )
3 - винда слишком много берет на себя VRAM памяти под рабочий стол и программы, причем, даже если есть несколько видеокарт, полностью отдать одну из карт под страту будет трудно ( или я не разобрался).
Проще на линукс такое провернуть.
4 - контекст я немного увеличил
“–max-context”, “393216”
“–rope-scaling”, “yarn”
“–rope-scale”, “1.5”
5 - модель взял в таком кванте Qwen3.8-Flash-Next-UD-IQ4_XS
на rtx 3060 - 12gb получил около 27 t/s для “parallel”: 1
на rtx 4090 - 24gb получил около 65 t/s для “parallel”: 1
и около 37 t/s для “parallel”: 2
6 - поскольку Strata позволяет запускать
deepseek-v4.1-flash-ist-das-2.25bpw
то попробовал и ее с контекстом на миллион.
на rtx 4090 - 24gb получил около 15 t/s ( при занятых моделью 20gb, остальные 4 gb держит винда, не отдает)
цифры не окончательные идет подбор режима запуска.
Сразу скажу что deepseek мне кажется многословным.
Там где Qwen3.8 решает задачу за 150 тыс токенов,
deepseek успевает наболтать на 250 тыс токенов.
Это все - примерно, по ощущениям, не делал точных тестов.
Оправдано ли это более высоким качеством работы ?
- еще не очень понятно, тесты не завершены.
Хорошо хоть, Strata не сильно роняет скорость на длинном контексте.
Например, при 500 тыс контекста, скорость около 12 t/s.
Главное агентам в OpenCode таймеры выкрутить на максимум ожидания, и можно ставить на ночь работать :)"timeout": 86400000, "headerTimeout": 86400000, "chunkTimeout": 86400000
Пару слов про Strata на ubuntu
Работа карт p102-100 подтверждена, на ней
успешно работает модель qwen36-UD-Q4_K_XL

На этот случай можно указать “parallel”: 2
НЕЕЕЕЕТ! Ну зачем же так?
Для субагентов надо указывать –conversation-cache-mib и –conversation-cache-slots. Страта в этом случае будет кэшировать KV-кэш агентов в RAM и быстро загружать их в VRAM при переключении на запрос от другого агента/субагента, вместо того, чтобы делать префилл заново. Скорость при этом не упадёт, потому что лишняя VRAM не используется.
Понятно, что параллельного инфенса при этом не получится. Страта будет отрабатывать запросы от разных агентов/субагентов последовательно. Для домашнего использования этого более чем достаточно.


Помогаем малышке стать сильной: локальная Qwen против облачных флагманов на 16 ГБ видеопамяти