Долгое время считалось, что презентация отчета с результатами — финальный этап работы исследователя. Но это верно только для классического агентского формата — внешнего или внутреннего. А in‑house исследователи в последние годы все больше движутся к симбиозу с продуктовыми командами. Нам тоже не хотелось измерять свой вклад только количеством отчетов: хотелось видеть, как результаты применяются дальше в продуктовом цикле, понимать, к каким изменениям они привели. Двигаться в эту сторону нам помогает главная метрика направления UX‑исследований в T2 — оценка влияния исследований (далее — ОВИ). В этой статье расскажем, как она устроена, и разберем несколько альтернативных подходов к измерению вклада исследований.
Предпосылки создания метрики ОВИ.
Илья Внуков, руководитель направления UX‑исследований:
Сейчас в Digital трудятся три исследователя на 10+ продуктовых стримов. Мы работаем в гибридном формате: с приоритетными для бизнеса командами — в тесной связке (в формате discovery‑клубов, о которых расскажем отдельно), а с остальными — по запросу. Функция исследований сейчас представляет собой полноценное интегрированное в продукт направление с выстроенными процессами. Но в 2023 году все было иначе: не было ни метрик, ни процессов, ни даже второго исследователя.
Я пришел в T2 на роль менеджера по исследованиям абсолютно без менеджерского опыта — до этого работал линейным исследователем и в мои обязанности входило только качественное выполнение задач. Никаких формальных исследовательских KPI у меня не было. Когда настало время формулировать годовые цели, ко мне пришла моя руководительница с вопросом: «А как нам оценивать твою работу?». Сам я себе на тот момент не задавал этот вопрос, так как полностью был погружен в операционные задачи, и на выстраивание системы метрик и локальных KPI не хватало ни ресурсов, ни знаний, ни опыта.
Первым, что пришло в голову, была количественная оценка продуктивности: количество входящих запросов и завершенных проектов, масштаб и тип задач. Но решили, что это весьма поверхностная метрика для ключевого показателя направления — ее, безусловно, нужно отслеживать, чтобы понимать свою пропускную способность, основных заказчиков и так далее, но не в качестве главного KPI. Потому что при целеполагании на количество фокус с качества смещается на объем — для такого KPI неважно, какая глубина, проработанность и польза от результатов скрывается за галочкой о проведенном исследовании. Абьюз этой метрики может приводить к более глобальным последствиям на дистанции: отказ от масштабных исследований — триангуляция, смешанные и трудоемкие методы отметаются в угоду скорости и количества закрытых проектов; применимость результатов также теряет актуальность, так как ее поддержание и отслеживание требуют дополнительного времени на коммуникацию и совместную работу с командой. Все это способствует макдональдизации исследований и снижению значимости ресерч‑функции.
Следующая мысль была про отслеживание удовлетворенности заказчиков. Но с ней тоже не сложилось — так как заказчиков в то время было сильно меньше, чем сейчас (из‑за меньшего штата дирекции и новизны функции исследований), смущало, что это может плохо повлиять на анонимность, а значит и на объективность обратной связи. Несмотря на то, что мы работаем в гибридном формате, а не прикреплены к конкретному продукту, отношения у нас со всеми заказчиками очень тесные и хорошие — это было еще одним слабым местом: думал, что коллеги из вежливости не будут писать критику, даже если для нее будут основания. Поэтому удовлетворенность заказчиков также отслеживаем, но менее формально — нам хватает банальных слов благодарности, повторных запросов и упоминаний исследований.
Целью было определить показатель, который оценивал и транслировал бы пользу и применимость исследований, так как нам не хотелось, чтобы направление исследований было просто сервисной функцией. Мы стремились увеличивать нашу важность и значимость, масштабироваться и влиять на работу и продукты компании.
На следующем этапе решили, что единицей анализа могут быть гипотезы, так как результаты их проверки легко отслеживать, но существует много исследований без гипотез на старте (например, генеративные или разведывательные исследования), поэтому тоже не стали останавливаться на таком подходе.
Честно говоря, на этапе формирования ключевой метрики направления мы не опирались на опыт коллег и лучшие практики — согласен, не очень по‑исследовательски. Поэтому захотелось исправиться и дать некий контекст перед более подробным описанием нашей оценки влияния исследований (ОВИ) — подготовили краткий обзор нескольких альтернативных подходов к измерению эффективности и влияния исследовательских функций.
Обзор альтернативных подходов
Дарья Рогачёва, UX‑исследователь:
Я присоединилась к команде год назад, на тот момент ОВИ уже существовала, но была далеко не в итоговом виде. Мне стало интересно, неужели на рынке нет оптимального зарекомендовавшего себя подхода для оценки эффективности исследований. Вот что привлекло мое внимание при изучении лучших (и не очень) практик:
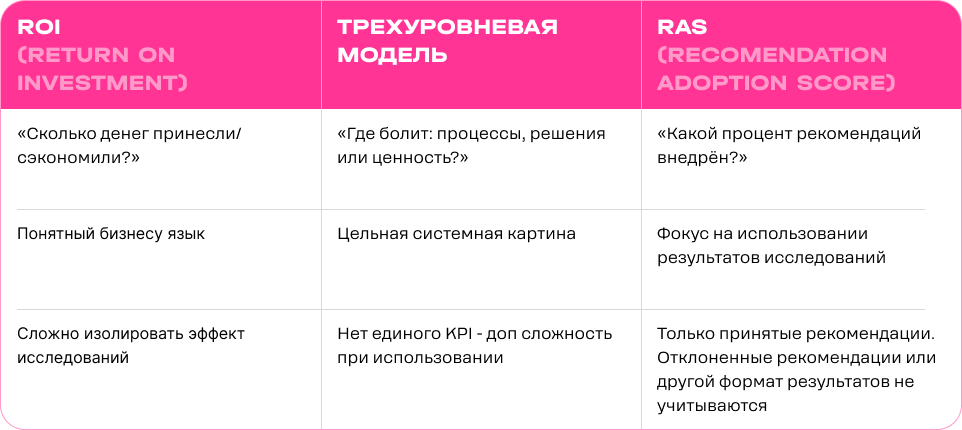
ROI (Return on Investment)
Одной из первых вполне очевидных по своим преимуществам была оценка ROI исследований (Return on Investment). Здесь эффективность UX‑исследований измеряется в денежном выражении: затраты на исследование сопоставляются с финансовыми выгодами от внедренных улучшений (рост конверсии, снижение затрат на поддержку, увеличение удержания, ускорение разработки).
Расчет тут может строиться на прогнозных моделях или пострелизных данных. Ключевой вопрос для данной оценки: «какую прибыль принесли исследования?» (или какую экономию обеспечили).
ROI дает понятный бизнесу язык и выглядит достаточно прозрачно. Появляется возможность обосновать бюджет и проиллюстрировать ценность исследований для продукта и руководства. Среди минусов можно отметить сложность в изолировании эффекта исследований от других факторов (маркетинг, цена, конкуренты). Также есть результаты, которые трудно монетизировать напрямую и сразу, но от этого они не становятся бесполезными. Кроме того, нужно выделить дополнительные ресурсы и инфраструктуру для проведения подобной аналитики и запастись серьезным терпением, потому что процесс до финальной оценки довольно продолжительный.
Если через ROI мы пытаемся все измерить в деньгах, то следующие две методики как раз и будут смещать фокус с того, «сколько мы заработали» на «как исследования влияют на процессы и решения».
Многоуровневая модель оценки
Первую из них часто называют «трехслойным пирогом». В многоуровневой модели эффективность раскладывают по трем этажам: операционный, решенческий и ценностный.
На операционном уровне все просто — здесь мы отвечаем на вопрос «а есть ли у нас вообще процессы?». Зафиксировали ли мы факт проведения исследований, обеспечены ли ресурсами, есть ли у команды нужные инструменты? Метрики тут максимально приземленные — количество запущенных проектов, набор применяемых методов, наличие софта.
Второй этаж — решенческий, уже интереснее. Он оценивает, насколько наши исследования реально влияют на то, что делает команда. Сколько решений было принято на основе данных, а не на основе «интуиции»? Какой процент рекомендаций дошел до прода и как часто заказчики (внутренние или внешние) принимают наши выводы?
И наконец, вершина — ценностный уровень. Это самый важный и одновременно самый размытый слой. Он пытается измерить, помогают ли исследования улучшать пользовательский опыт и способствуют ли развитию бизнеса. Тут уже появляются привычные CSI, NPS, конверсия и показатели доступности.
Многоуровневая модель дает цельную картину, за счет которой мы видим не только итоговый результат, но и здоровье процессов на каждом этапе. Это помогает понять, где именно возникает бутылочное горлышко: то ли исследования не проводятся, то ли их игнорируют, то ли они не приносят пользы бизнесу. Но важно, что рост на одном уровне не гарантирует улучшение показателей следующего уровня. Еще одним недостатком является отсутствие единого итогового значения — то есть формально это не KPI и при использовании данного подхода придется локально оценивать и замерять каждый уровень, что опять требует серьезного аналитического арсенала.
RAS (Recommendation‑Adoption Score)
Другой подход, который мы изучили — это RAS (Recommendation‑Adoption Score), он же индекс внедрения рекомендаций, популяризированный командой Nielsen Norman Group. Этот метод нас подкупил своей прагматичностью. Суть в том, чтобы превратить разрозненные отчеты в ориентир для проведения дальнейшей работы наших заказчиков над продуктом. Процесс выглядит так: исследователи фиксируют каждую рекомендацию, присваивая ей статус и степень влияния. Затем происходит оценка не только самого процента внедрения (это и есть RAS), но и динамики — растет ли скорость генерации идей, улучшается ли показатель внедрения. И на основе этих данных формируются четкие инвестиционный и культурный сигналы: продолжать финансировать исследования, работать с осторожностью или вовсе остановиться. При этом критерии оценки можно гибко пересматривать под текущие задачи.
RAS прекрасно смещает фокус исследователей с «красивых отчетов» на реальное внедрение, создает прозрачность и налаживает обратную связь с продуктовыми командами. Но фокус только на рекомендациях ограничивает результаты исследовательской работы.
Каждый из этих методов требует порядка в ведении артефактов каждого из исследований, постоянной актуализации статусов по учету рекомендаций, отслеживания внедрения изменений и причин условной стагнации. Да и, как мы уже подчеркнули выше, сложно оценить вклад каждого исследования, а также дать ему оценку с точки зрения монетизации (соотношения финансовой выгоды и совершенных затрат). И наконец, краткосрочные сигналы по такой оценке могут вводить в заблуждение, которое требует регулярного исследовательского разъяснения или же вообще приводит к неверным решениям. Эти инструменты раскрывают свой потенциал только на дистанции и требуют терпения и системности, что, согласитесь, в нашем быстром мире бывает роскошью.
Оценка влияния исследований
Теперь, когда у вас есть набор разных оптик для анализа работы отдела исследований, мы хотим наконец перейти к нашей — ОВИ.
Как в итоге пришли к текущей концепции? В процессе одной из презентаций результатов юзабилити‑теста обсуждали с командой список найденных проблем — каждую разбирали и прорабатывали дальнейшие шаги — берем/не берем в работу, что и когда делаем. После этого поняли, что для оценки влияния надо смотреть не на весь проект целиком и даже не на гипотезы, а отслеживать судьбу каждого отдельного артефакта: найденные проблемы, рекомендации, инсайты, стратегические контексты и другие формы информации и данных, на которые можно опираться и использовать при принятии решений. Вот примеры артефактов разного типа и решений, к которым они привели:
Проблема: пользователи путались в действующих акциях, указанных на карточке тарифа, и неправильно считывали условия. Итоговое решение: одну из конфликтующих акций вынесли из карточки тарифа в отдельный блок
Рекомендация: убрать экран подтверждения при отказе от оффера, так как исходя из аналитики с задачами удержания он не справляется и вызывает раздражение у пользователей. Итоговое решение: сократили флоу отказа от оффера — отказались от экрана подтверждения
Инсайт: пользователи голосового ассистента считают самой полезной функцией в продукте избранные контакты (чьи звонки не попадают на ассистента). Итоговое решение: продвигать платного голосового ассистента через возможность указать избранные контакты; убрать лимит избранных контактов
Статистика: среди ЦА — людей с несколькими номерами в ЛК, необходимость в push‑уведомлениях от доп. номеров есть у 16%. Итоговое решение: в ближайшее время не тратить ресурсы на разработку невостребованной фичи
Каждому артефакту присваивается тег в таблице:
Отклонено. Самый нежелательный статус для результатов исследований. Так отмечаются артефакты, которые были проигнорированы, а дальнейшее решение либо не учитывает их, либо вообще противоречит. Работа в стол давняя боль всех исследователей, а фокус на случаях отклонения результатов помогает сокращать их количество. В следующей статье мы расскажем, как работаем с этой категорией и стараемся уменьшать количество бесполезных исследований.
На холде. Такой тег получают артефакты, которые не были использованы по объективным причинам, на которые чаще всего не может повлиять даже сам заказчик, а исследователи — тем более. Это может быть: возникновение юридических или регуляторных барьеров; заморозка проекта в связи со сменой стратегии или вектора развития продукта и тому подобное
Принято к сведению. Самый неоднозначный тег из всех — он ставится, когда у стейкхолдеров нет идейных противоречий с результатами, они согласны с критичностью найденной проблемы или важностью рекомендованной доработки, но из‑за нехватки ресурсов или имеющихся технологий, либо из‑за загруженного бэклога, работа с артефактом откладывается на неопределенный срок. Но мы не забрасываем такие артефакты, а периодически напоминаем о них заказчикам и узнаем про их планы.
Взято в работу. В эту категорию попадают артефакты, на основании которых уже сформированы задачи в бэклоге. Также этот статус получают артефакты разведывательных исследований, которые на старте не планировалось использовать для конкретного решения — у нас много таких артефактов появляется в рамках наших диско‑клубов (рабочая группа, регулярно занимающаяся product discovery). Но когда такие контекстные артефакты в будущем используются для продуктовых решений, мы меняем их на следующий статус. Также мы особенно внимательно следим за продолжительностью нахождения артефактов в этом статусе, чтобы избежать формального добавления доработки в бэклог без фактических действий по ней.
На проде. Целевой сценарий использования результатов исследований. Этот тег получают артефакты, поучаствовавшие в решении, которое в итоге дошло до конечного пользователя.Также сюда попадают артефакты, которые помогли НЕ делать что‑то, на ранних этапах подсветив невостребованность продукта (да‑да артефакты отменившие выход решения на прод тоже имеют тег «На проде» — так сложилось исторически 🙃)
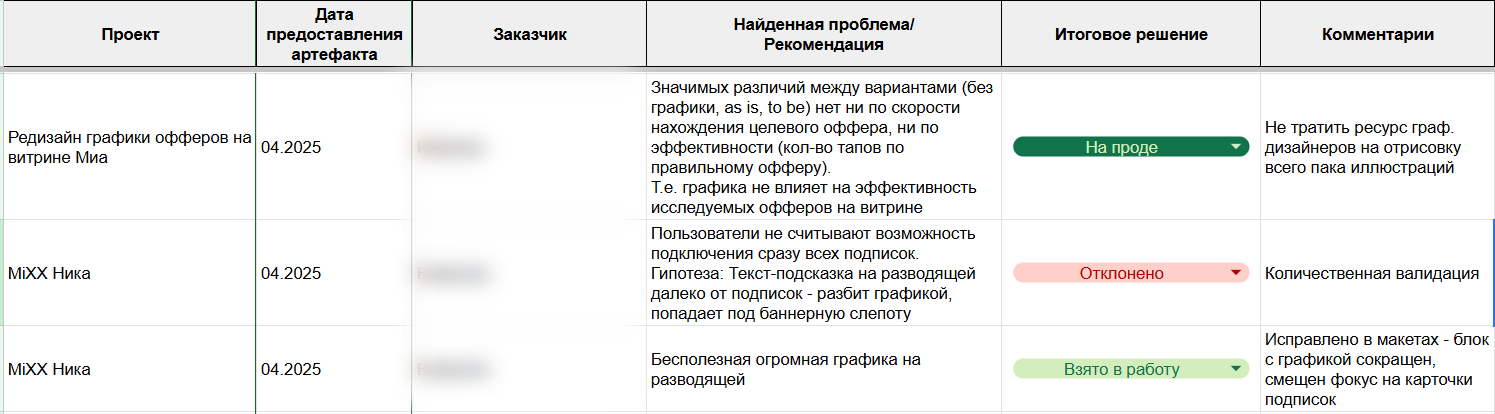
Пример таблицы с артефактами исследований для расчета ОВИ Может показаться, что мы просто адаптировали подход RAS, о котором писали ранее, но на момент выхода материала от NNg, мы замеряли ОВИ уже год. Действительно, основная механика практически идентичная, но мы видим ценность нашей работы не только в конкретных рекомендациях: снижать неопределенность и помогать командам принимать решения — вот более масштабная задача нашей команды. Еще одно ключевое различие — внимание к отклоненным результатам. У NNg отклоненные рекомендации просто не идут в расчет метрики, а значит метрика не обязывает разбираться в причинах отказов, теряя системность и формальность «работы над ошибками». В ОВИ же наоборот — отклоненные артефакты несут в себе огромный диагностический потенциал: разбирая каждый кейс индивидуально, мы находим причины в зрелости культуры, процессах или ресурсах на стороне команд, недоверии к нашим данным. Это позволяет нам работать с барьерами на разных уровнях, что также усиливает наше влияние внутри компании.
Важно, что для годовой итоговой оценки мы берем результаты, представленные с 1 августа прошлого года по 31 июля текущего года — это сделано для того, чтобы у всех артефактов было окно для разработки и выхода в прод до конца календарного года. Поэтому во втором полугодии мы уделяем больше сил и времени сопровождению предоставленных ранее результатов — регулярно синхронимся с заказчиками, подключаемся к обсуждениям.
Все статусы динамичные — в теории один артефакт за расчетный год может примерить все теги. Целевой сценарий — после получения результатов заказчик формирует по каждому артефакту (если речь про конкретные рекомендации или найденные проблемы) задачу и кладет в бэклог. Через какое‑то время, желательно до конца года, все эти улучшения доезжают до прода и мы смотрим их влияние на продукт и пользователей. Результаты, судьба которых решается дольше расчетного года, не выпадают из нашего поля зрения: мы продолжаем актуализировать их статусы в исторической метрике (за все время существования ОВИ). Это позволяет видеть накопленную динамику и не терять проекты с длинным циклом внедрения.
Для расчета итогового значения, которое в декабре заносится в формы годовых целей, собрали следующую формулу (коэффициенты условные и обозначают лишь вес соответствующих статусов):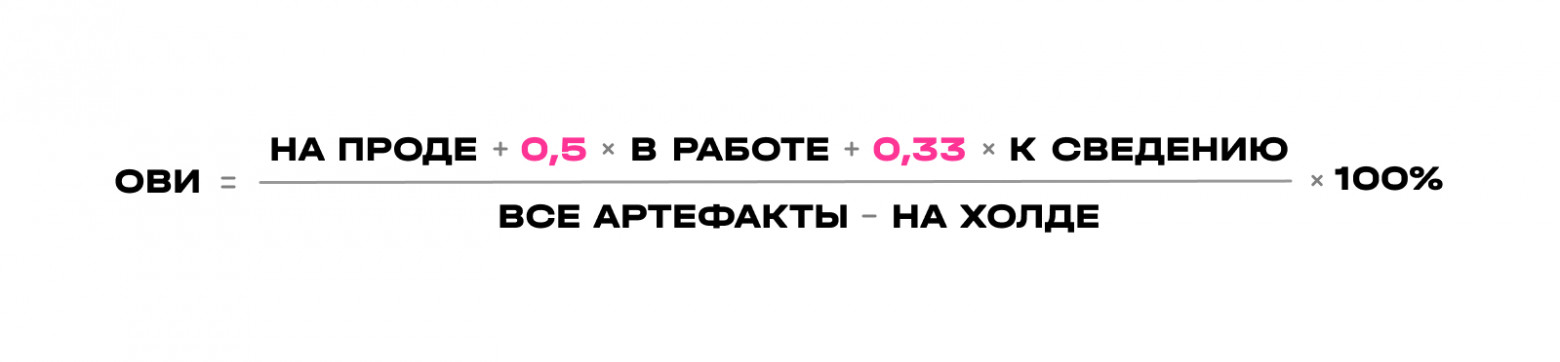
ОВИ мы рассчитываем уже второй год, 2025 закончили с цифрой 79% — сложно сказать, хорошо это или плохо, потому что для нас эта метрика в первую очередь инструмент. Аналогия с метрикой SUM для качественных юзабилити‑тестов хорошо объясняет подход к использованию ОВИ: финальная цифра для нас нужна для общего сигнала и формальной части KPI, а вот причины этой цифры — для практической. Как и в SUM мы углубляемся в «сценарии» и барьеры, снижающие итоговое значение, и работаем с конкретными запросами и результатами. Т.е. для нас цифра 79% менее интересна, чем детали и процессы, стоящие за «недостающими» 21%.
Метрика гибкая и продолжает изменяться: в этом году дополняем факт применения результатов итогами этого применения (где можно выделить вклад исследований наиболее явно) — смотрим не только на использование наших исследований, но и на эффект от него. Потому что внедрение результатов само по себе не гарантирует улучшение показателей: множество внешних факторов размывают вклад исследований. Важно, что текущая метрика справляется со своей задачей — помогает продвигать исследовательскую культуру, формировать привычку у команд и укреплять позиции исследований в компании.
Также думаем, что делать с артефактами, напрямую не привязанными к конкретным решениям (а с развитием discovery‑инициатив таких артефактов становится все больше). Очевидна польза от подобных разведывательных исследований — они являются источником новых знаний (которые необязательно должны быть использованы в задачах текущего спринта) и контекстов, позволяют генерировать новые гипотезы и идеи для развития продукта. Но оцифровать их в рамках нашей метрики — задача на будущее.
Еще один вектор развития — заход на подсчет ROI проведенных исследований. В нашей идеальной картине должна выстраиваться следующая цепочка «артефакт исследования ➜ решение на основе артефакта ➜ результаты продуктовых и клиентских метрик после релиза ➜ бизнес‑результат + ROI исследования».
Заключение
Мы рассказали, как в T2.Digital пришли к ОВИ: от поиска ключевого KPI и обзора альтернатив до отслеживания статусов и первых результатов. Наша метрика не универсальна — коэффициенты условны, импакт внедренных артефактов только начинаем отслеживать, а часть артефактов пока плохо поддается оцифровке. Но она работает: помогает нам видеть судьбу результатов, договариваться с командами и укреплять наши позиции. Универсального рецепта нет — отталкивайтесь от вышеназванных метрик, изучайте подходы других коллег, а может даже придумывайте что‑то абсолютно новое. Главное — начать выходить за рамки итогового отчета и уделять больше внимания судьбе ваших исследований. Мы убеждены: партнерство и влияние начинается, когда работа не заканчивается на презентации результатов, а эффективно встраивается в продуктовый процесс и принятие решений. Во второй части статьи расскажем, как работаем с полученными значениями ОВИ, выстраиваем работу со стейкхолдерами и на что еще косвенно влияем.
P. S. Метрика все еще развивается, поэтому если у вас будут какие‑то замечания или дополнения — обязательно делитесь, будем вам очень благодарны.