
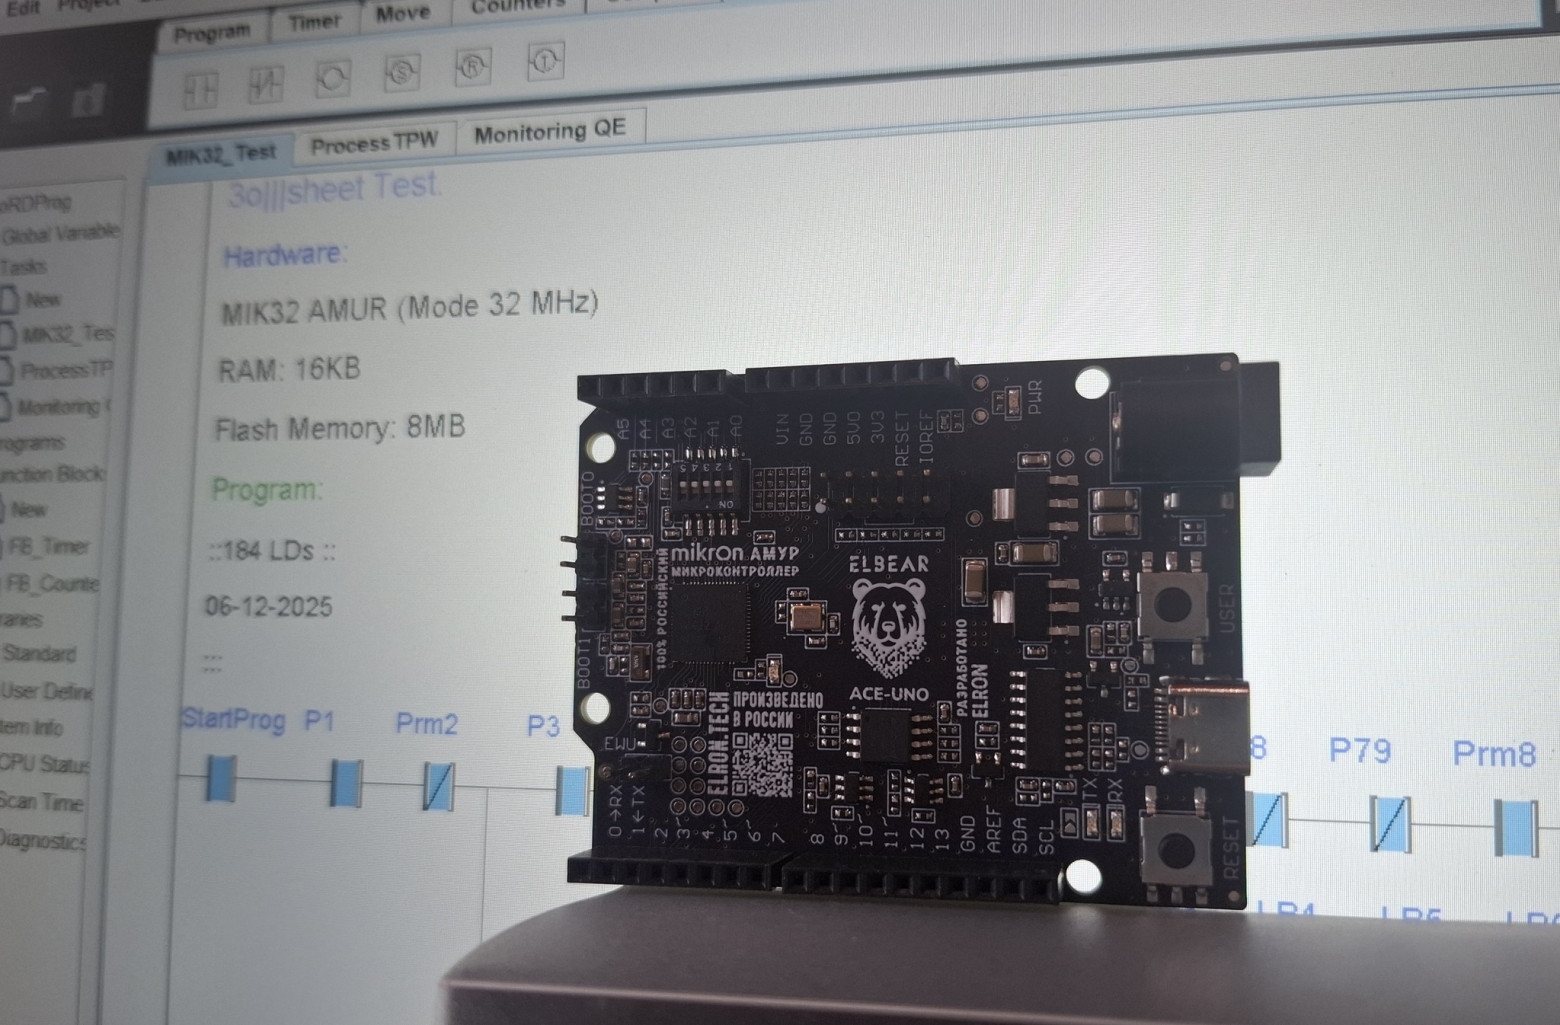
В разные периоды я тестировал свою среду разработки, компилятор и рантайм на разных МК — от STM32G030 до FPGA Altera Cyclone 4. Минимальные требования к рантайму — это 5 КБ ОЗУ и не менее 32 КБ Flash, либо 3000 LUT, если это FPGA. Мой основной тестовый стенд — это системы с относительно ограниченными ресурсами. Не 8-битные микроконтроллеры, но и не обязательно ESP32. ОЗУ от 12–20 КБ — это уровень, на базе которого можно создать настоящий ПЛК с вытесняющей многозадачностью, заменой кода на лету, RS-485 и онлайн-отладкой.
Классически я тестировал все МК на Ladder-программе, так как различные бренды — производители ПЛК часто публикуют данные выполнения дискретной логики в документации, что очень удобно для сравнения.
Методика тестирования.
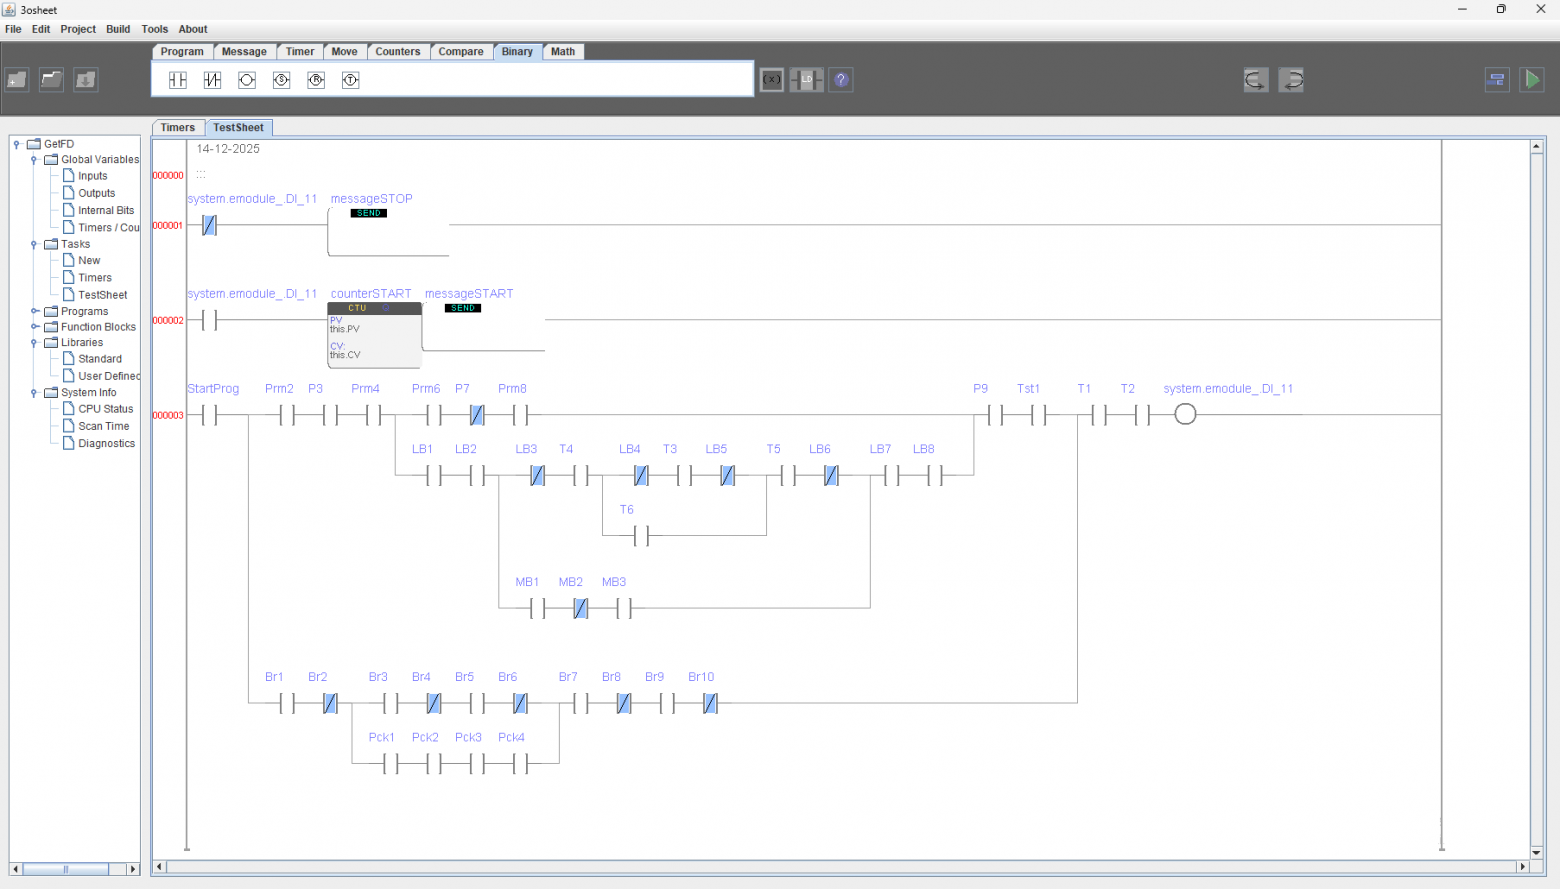
Дискретная логика оценивается по среднему времени выполнения контактов и катушек в сложном ранге. Под сложным понимается ранг со множеством ветвлений: здесь, помимо обработки самих контактов, компилятор неявно вставляет дополнительные инструкции для сохранения промежуточных результатов вычисления цепей.
При разработке среды я ориентировался на Allen-Bradley, поэтому те, кто знаком с их ПО, сразу узнают знакомый дизайн — неограниченные сложные ветвления в рангах и характерный функционал.
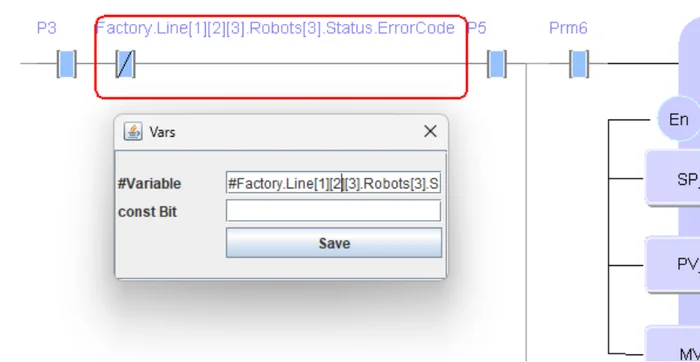
Однако есть и отличия. Поскольку я ориентировался на языки высокого уровня (такие как ST), то создавал полноценный собственный компилятор, и встроенной поддержке сложных типов данных. Прямо в цепях Ладдера можно использовать следующие конструкции (можно делать короткие псевдонимы, аналоги #define на СИ):
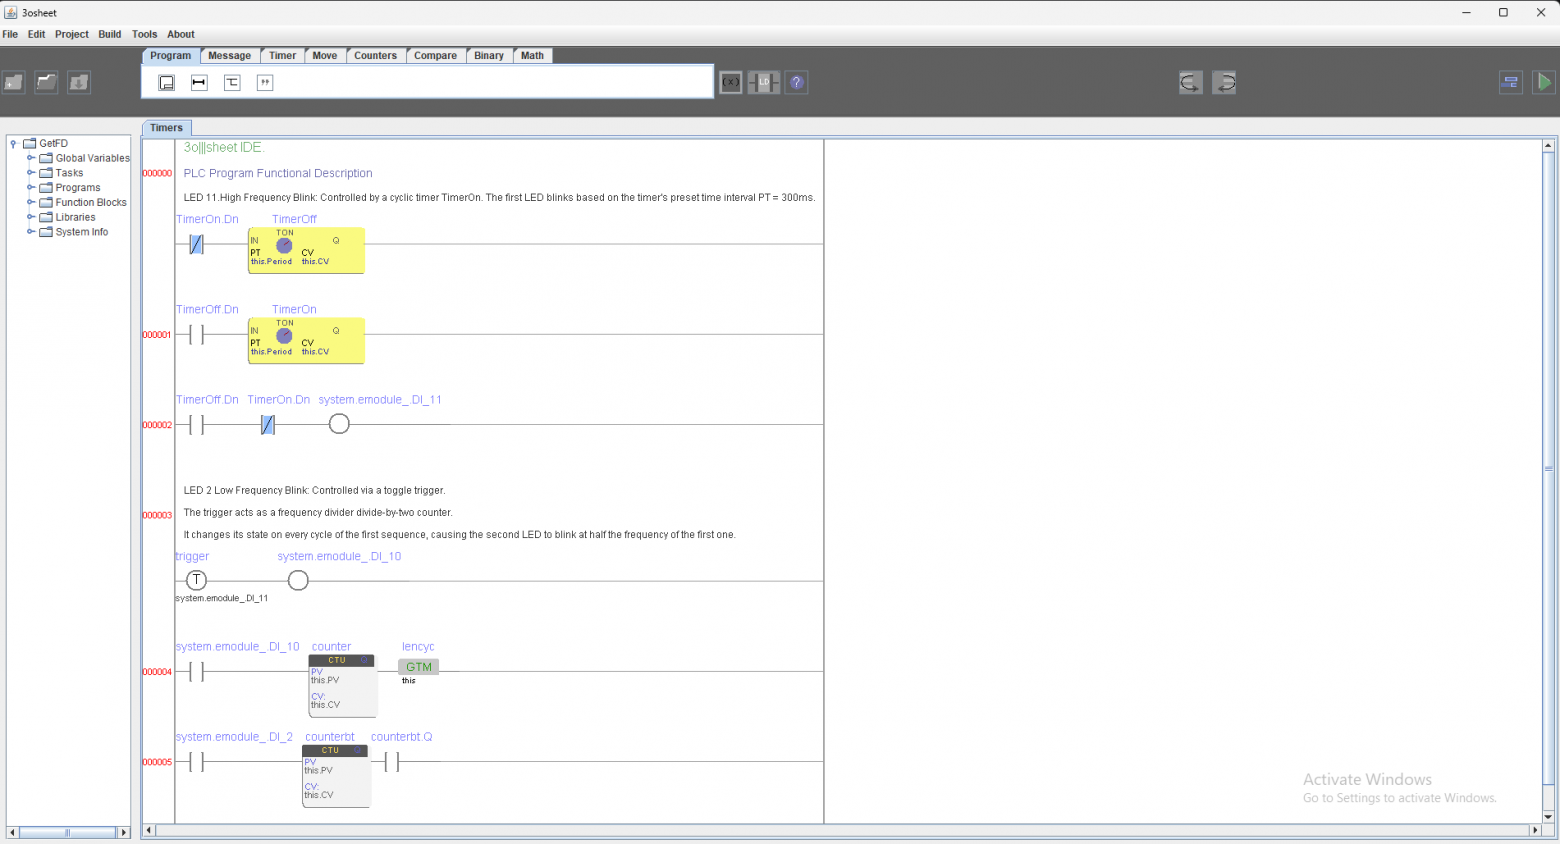
Второй тип тестов - наиболее часто используемые функциональные блоки: таймеры, триггеры, счетчики.
Сам рантайм представляет собой софт-процессор (виртуальное ядро с программными регистрами R0–R32). Это обеспечивает полную абстракцию от железа и позволяет мне всего за два часа развернуть ПЛК на любом микроконтроллере. Из минусов — производительность в 3–5 раз ниже, чем у нативной программы, однако в 5–10 раз выше, чем у Lua или MicroPython (а самое главное — выполнение строго детерминировано по времени).
С точки зрения нативной части внутри МК, в которой содержатся программа ПЛК, данные, стек и прочее, представляет собой единый массив:
__attribute__((aligned(512))) uint8_t memory[SIZE_MEMORY];
SIZE_MEMORY - размер который можно выделить под программу для ПЛК. В данный момент, у меня единая область, нет разделения на память инструкций или данных: больше программа/меньше данных, меньше данных тогда влезет больше программа. Сам мк тестировался давно, код может не соответствовать местами, но принцип тот же, глобальный массив и указатели на обработчики.
Из IDE прошивка попадает в МК по UART. После сверки хешей, начинается выполнение. В цикле идет чтение программы:
dec.ui = __builtin_bswap32(*(uint32_t*)&memory[PC]);

void (*instruction_handler)(void) = (void (*)(void))cpu.instruction[dec.b[3]];

instruction_handler();
cpu.instruction - это массив указателей на обработчики.
PC - это один из 32 софт-регистров, является адресом инструкции.
Производительность
Один ранг с 40 булевыми инструкциями и шестью ветвлениями (как на скриншоте выше) выполняется за 0,5 миллисекунды. Здесь важно иметь в виду, что, помимо этих 40 инструкций, компилятор(вернее транслятор Ladder) неявно добавляет около 25 инструкций для сохранения промежуточных результатов вычислений в ветках( 3-4 инструкции на ветку ).
Время выполнения функциональных блоков:
Таймер: 80–320 мкс.
Счётчик: 80–390 мкс.
Триггер: 20–120 мкс.
Максимальное значение соответствует полному циклу работы функционального блока, когда сработали все условия. Если, к примеру, таймер не активирован,или таймер уже ранее сработал, то его выполнение занимает всего 20–25 мкс, пик времени только в момент завершения и обновления данных.
Таким образом, за цикл в 10 миллисекунд будет отработано около 10 таких сложных рангов с учётом накладных расходов на чтение/запись портов. Отправку 128 байт данных в кадре, на хост по 4400 bod\sec может добавить в несколько сотен мсек, если блокирующий режим. Тут зависит от реализации выполнения и скорости передачи.
Процесс онлайн мониторинга в среде, на момент работы с MIK32 еще не был готов, но сейчас это выглядит так:
Зная точное время выполнения таймеров, счётчиков и триггеров, можно легко рассчитать общее время обработки программы, если добавить в эти ранги необходимое количество указанных функциональных блоков. Так же можно рисовать, и создавать собственные функциональные блоки, добавлять их в библиотеку. Детальнее можно посмотреть в моих прошлых постах, или в этом видео чтоб не искать:
Это не коммерческая разработка, я не провожу каких то оптимизаций под конкретный микроконтроллер для производительности. Мне важнее пока легкая переносимость на разные чипы и быстрые изменения. Для этого создавал собственный компилятор - иметь завершенный полный стек, от IDE до рантайма на железе, который позволяет устанавливать и отлаживать все несколькими кликами мышки , без всяких настроек путей, каких то портов, ввода консольных команд, и прочее.


