

Всем привет! Меня зовут Виктор Юрченко. Я руковожу в Яндексе группой, которая создаёт и развивает CV‑технологии для симуляции сенсоров в автономном транспорте. А ещё организую в Школе анализа данных два курса «Глубинное зрение и графика» и «Автономные автомобили» и преподаю на них.
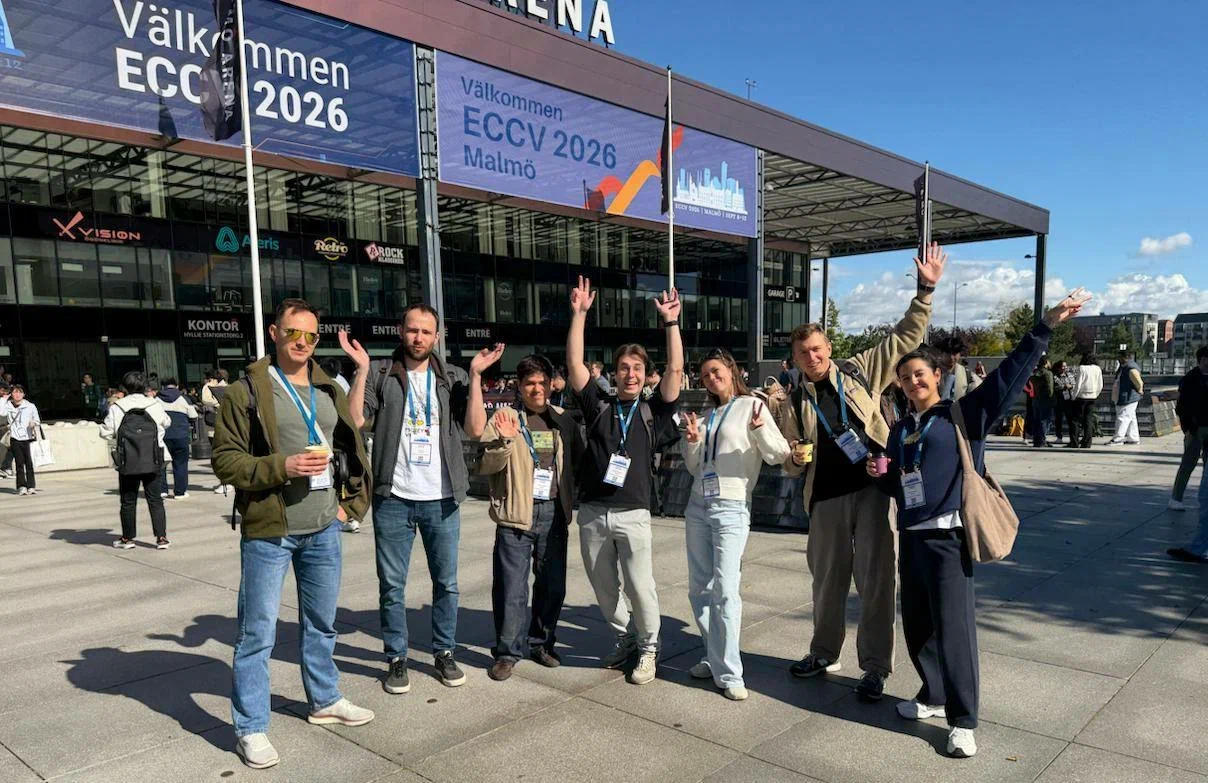
В сентябре мне и моим коллегам удалось побывать на ECCV 2026 — European Conference on Computer Vision, которая проходила в шведском городе Мальмё. В этом году место проведения особенно повлияло на атмосферу — скандинавский вайб ощущался и в общем настрое, и в визуальных решениях, и даже в атмосфере экспозоны, о чём ещё расскажу.
Также порассуждаю о тенденциях, которые заметила наша делегация, поделюсь кое‑какими идеями и разберу несколько полезных работ на тему автономного транспорта.
Погнали!
Чем интересна ECCV и почему мы её не пропускаем
Конференцию ECCV проводит Европейская ассоциация компьютерного зрения (European Computer Vision Association). Первая конференция прошла в далёком 1990 году во французском Антибе.
На сегодняшний день ECCV — одна из топовых конференций по компьютерному зрению и машинному обучению. Она проходит по чётным годам и собирает исследователей и представителей индустрии со всего мира.
Круг тем, представленных на конференции, с каждым годом расширяется вслед за эволюцией области. Сейчас есть и классические задачи из компьютерного зрения, вроде 3D и распознавания, и более хайповые темы, вроде генеративок, мультимодальности, робототехники и world models. Например, в программе этого года были отдельные туториалы по посттрейну диффузионных моделей, генерации видео, visual foundation models, а среди воркшопов — Physical AI, безопасность генеративных моделей и многое другое.
Круто и то, что на одной площадке оказываются ведущие исследователи из академии и индустрии. В этом году заметным событием программы стало выступление Яна Лекуна — учёного, который стоял у истоков deep learning, основал FAIR и до конца 2025 года был Chief AI Scientist в Meta*, а сейчас развивает world models.
Главные цифры, Best Paper Awards и кейноут Лекуна
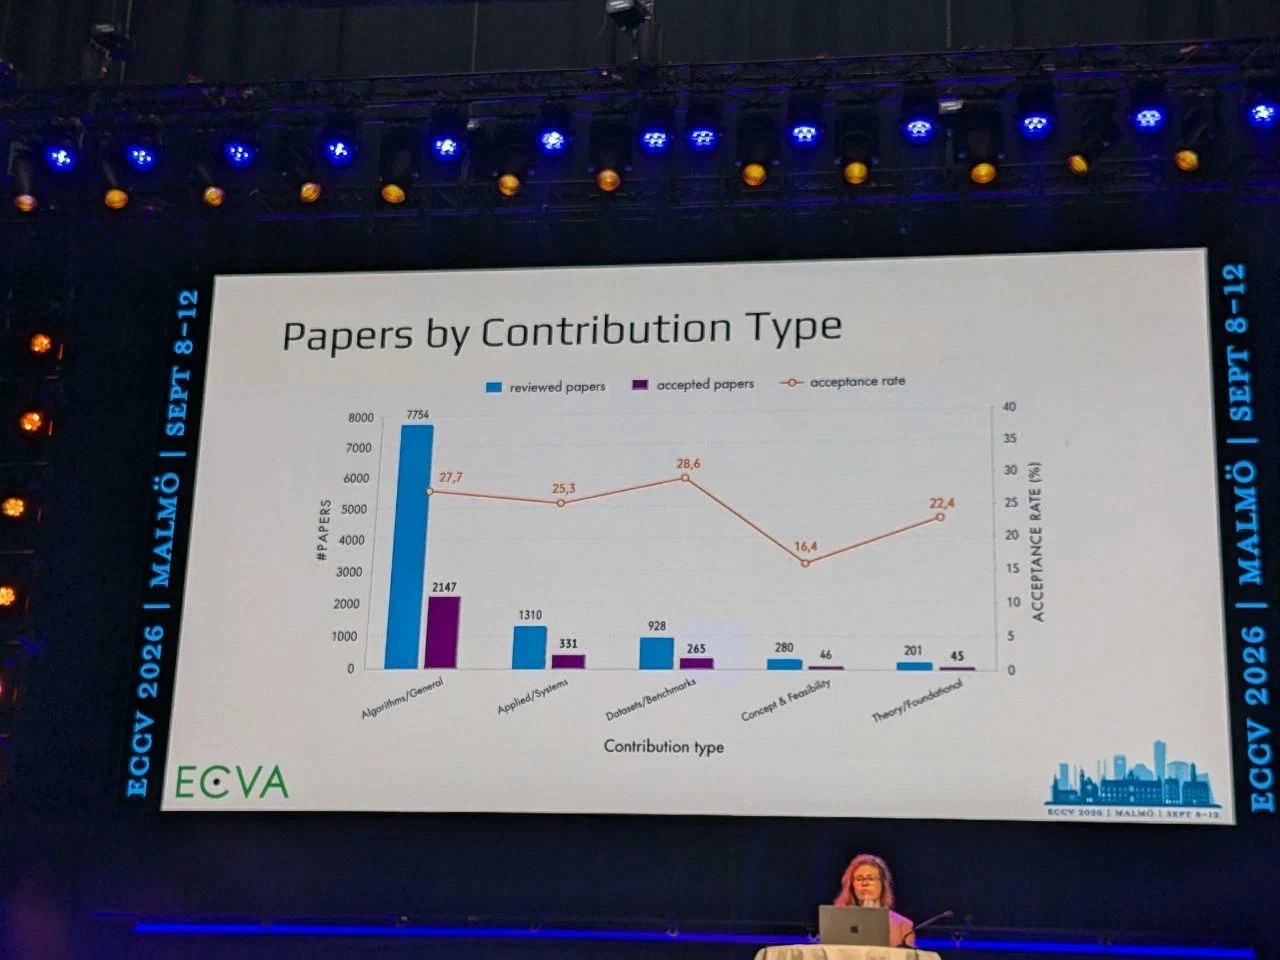
Всего на конференцию было подано 10 473 работы от 37 тысяч авторов, а приняли 2 834 статьи. Oral при этом получили всего 163 работы (1,6%).
Самая большая тема с заметным отрывом — генерация картинок и видео. Следом шли vision‑language & reasoning и 3D. По этой статистике видно, что генерация и мультимодальность всё ещё остаются в топе.
На церемонии открытия конференции проходило награждение лучших работ.
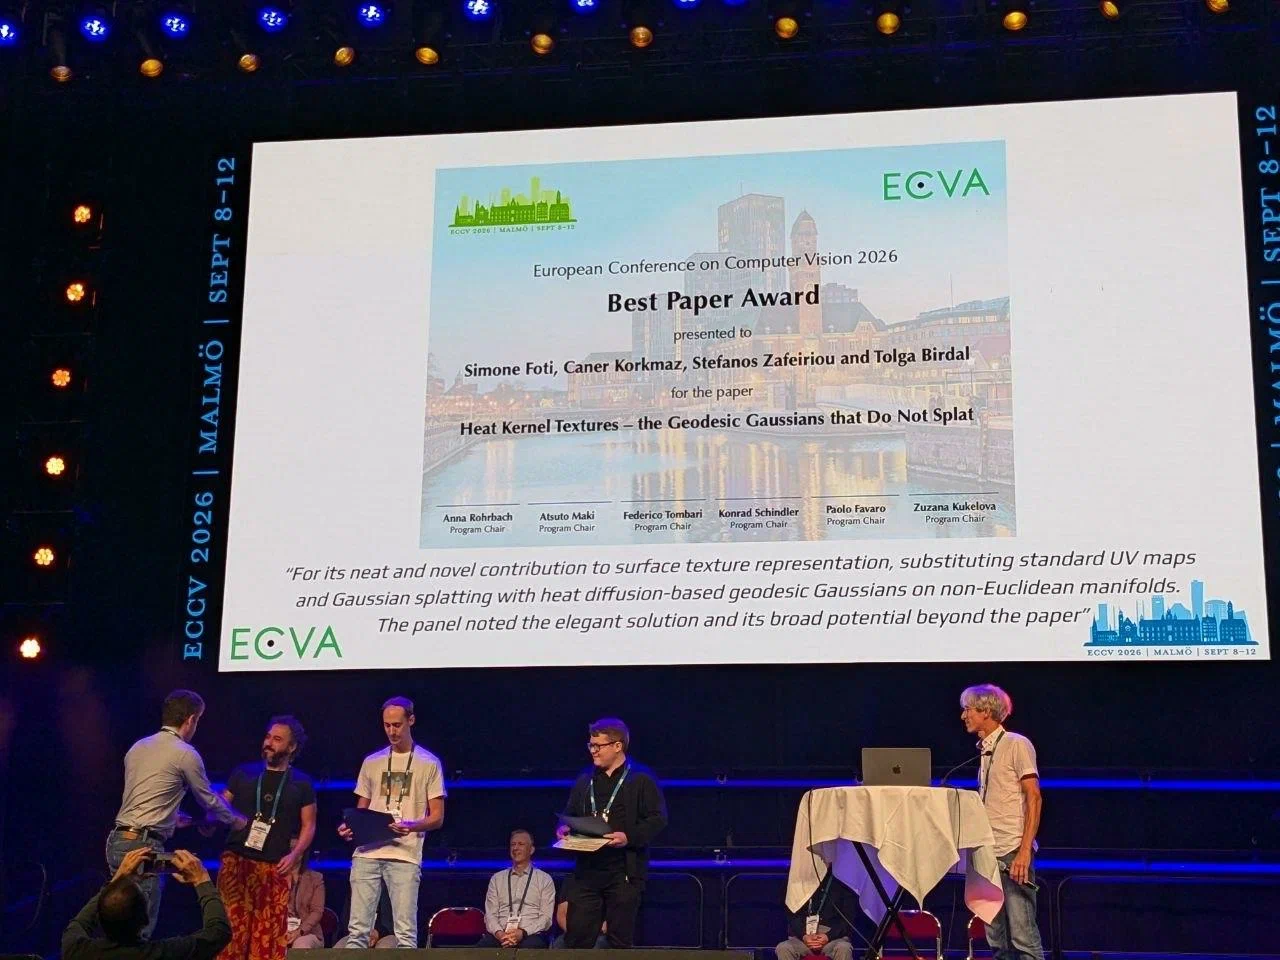
Heat Kernel Textures — the Geodesic Gaussians that Do Not Splat — статья, получившая Best Paper Award, была представлена как Long Oral. Авторы из Имперского колледжа Лондона (Imperial College London) предложили новый способ накладывать текстуры на 3D‑объекты без UV‑развёртки и представлять текстуру прямо на поверхности 3D‑меша с помощью геодезических аналогов гауссиан.
Награды Test of Time Awards вручили за работы, первые версии которых вышли в далёком 2016 году. Вот две из них:
Learning Without Forgetting — одна из первых и заметных работ по continual learning. Авторы предложили дообучать нейросеть на новых задачах без доступа к старым обучающим данным, сохраняя её прежние способности за счёт дистилляции предсказаний исходной модели.
Perceptual Losses for Real‑Time Style Transfer and Super‑Resolution — статья, которая сильно повлияла на задачи генерации и восстановления изображений. Вместо сравнения изображений только на уровне пикселей авторы используют perceptual loss, сравнивая признаки из предобученной VGGNet.
На следующий день, 11 сентября, выступил с кейноутом легендарный Ян Лекун.
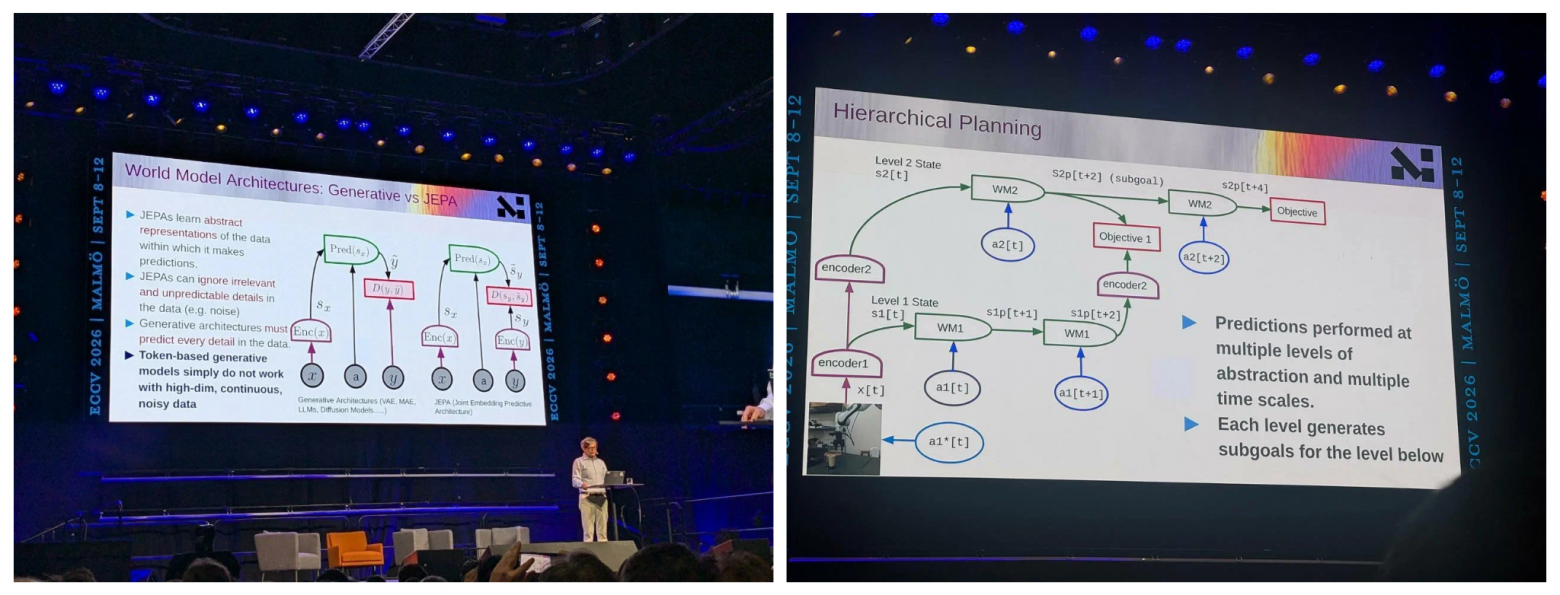
В начале своего выступления Лекун подчеркнул контраст между успехами AI в программировании и математике и его способностью действовать в физическом мире. Среди проблем назвал работу с высокоразмерными непрерывными данными (сырым видео, аудио и сигналами с датчиков), зависимость агентов от большого числа демонстраций и слабую адаптацию к новым задачам. Дальше — несколько тезисов из его доклада:
Интеллект — это способность решать новые задачи с минимальным обучением. Лекун отделяет его от накопления знаний и освоения фиксированного набора навыков. Термин AGI он критикует: человеческий интеллект тоже специализирован, а ключевое свойство — быстрая адаптация к незнакомым ситуациям.
Моделировать мир через предсказание следующего кадра — неверный путь. По мнению Лекуна, будущее на уровне пикселей неоднозначно, а такая детализация часто не нужна для выбора действий. Вместо этого он предлагает обучать абстрактные представления и предсказывать изменения в их пространстве.
На этом принципе построена архитектура JEPA (Joint Embedding Predictive Architecture), предложенная Лекуном в 2022 году: энкодер кодирует целевые данные, а предиктор по контексту предсказывает их представление. В модели мира предсказание также учитывает действие. Ошибка считается между представлениями, что позволяет игнорировать несущественные и непредсказуемые детали исходного сигнала.
Модель мира позволяет планировать действия. Предсказывая последствия разных действий, система может искать последовательность, которая приводит к цели. Поэтому основным механизмом выбора действий Лекун предлагает сделать model‑predictive control. RL при этом отводится роль корректировки модели мира или критика, когда фактический результат расходится с прогнозом.
Для сложного планирования нужна иерархия моделей мира. В показанной архитектуре на каждом уровне работают своё представление состояния и своя модель динамики. Верхние уровни предсказывают более абстрактные изменения на длинных временных масштабах и задают подцели нижним. Нижние — планируют более конкретные действия на коротком горизонте. Иерархия здесь относится и к задачам, и к самим моделям, которые обеспечивают планирование.
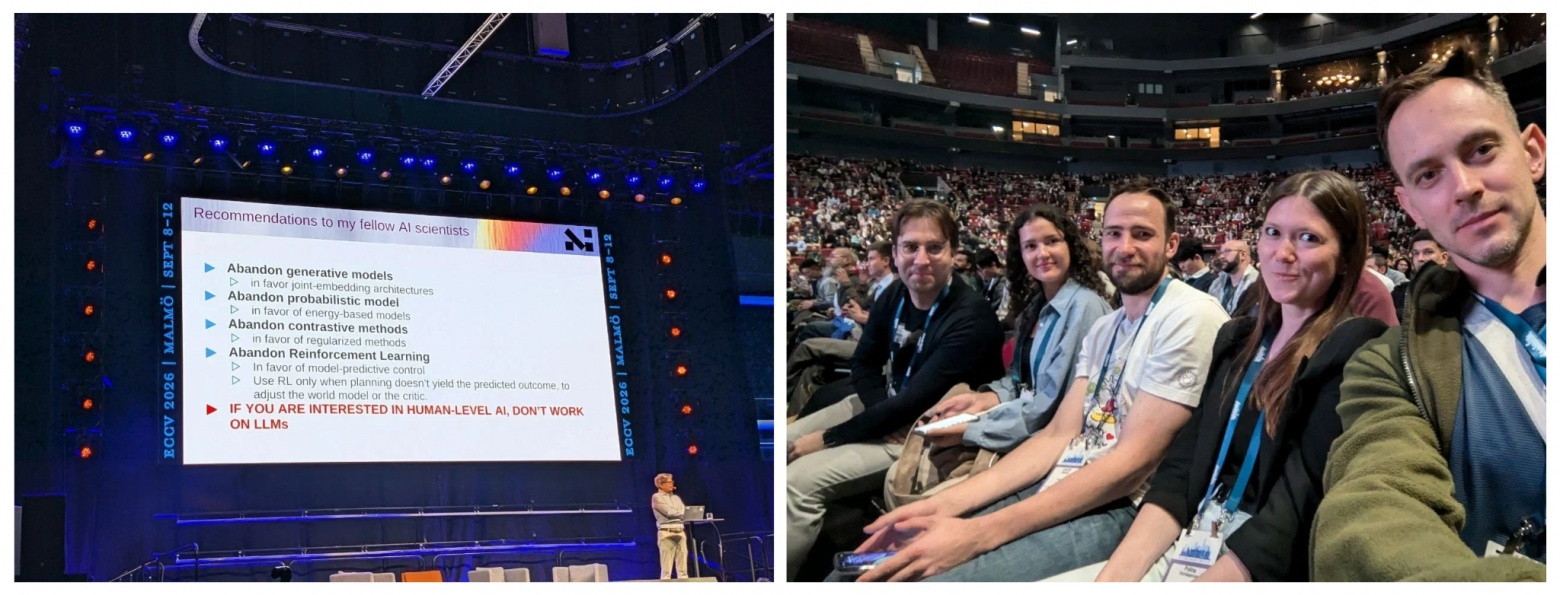
В финале Лекун обратился к исследователям, чья цель — AI человеческого уровня, и рекомендовал им сменить исследовательский фокус: с генеративных архитектур на joint‑embedding, с вероятностных моделей на energy‑based‑модели, с контрастивного обучения на методы с регуляризацией, с RL на управление на основе прогнозирующих моделей. По его мнению, именно в этих направлениях стоит искать путь к таким системам. В этом же контексте прозвучал призыв сместить внимание с LLM на обучение представлений и моделей мира.
Какие статьи привезли исследователи Яндекса
В этом году наши исследователи и инженеры привезли на конференцию три работы. В одной изучили, как авторегрессионки справляются с классификацией изображений (оказалось, что неплохо), в другой — изучали переключение между генерацией и редактированием для image editing, в третьей — сделали большой разбор Classifier‑Free Guidance. Кратко о каждой статье.
Revisiting Autoregressive Models for Generative Image Classification
Что изучаем
Ребята из Yandex Research по‑новому посмотрели на потенциал авторегрессионных моделей в классификации изображений. Метод на основе RandAR оценивает изображение при разных случайных порядках визуальных токенов и агрегирует результаты. Это снижает зависимость от конкретного порядка и помогает модели учитывать разные области и свойства объекта.
Какие результаты
На проверенной выборке ImageNet‑Val RandAR‑XL получил 81,3% top-1 accuracy против 77,2% у DiT‑XL и 82,7% у DINOv2-XL. Все модели предобучали на ImageNet-1K; для DINOv2 использовали линейный классификатор. На тестах со сдвигом распределения результаты неоднородны: например, на ImageNet‑A RandAR уступил DINOv2. Ускорение до 25 раз авторы измерили относительно DiT‑классификатора на одной A100, варьируя число вычислений модели.
Код выложили на GitHub.
DuET: Dual Expert Trajectories for Diffusion Image Editing
Что изучаем
Yandex Research и Alice AI ART объединились, чтобы представить DuET — training‑free‑метод улучшения качества редактирования в unified‑моделях генерации и редактирования картинок. Он основан на интуиции: если мы учим одну модель делать и генерацию, и редактирование, то и на инференсе можно попробовать использовать оба режима.
Какие результаты
Оказывается, что в середине генерации можно временно отключить привязку к исходному изображению и перевести модель в режим text‑to‑image, а затем вернуть её к редактированию. Это позволяет более эффективно использовать генеративные способности модели.
Усиление правки может менять детали исходника. У FLUX2-Klein 4B с переключением на шагах [25,35) из 50 оценка perceptual quality на GEdit растёт с 7,46 до 8,01, а SSIM на GIE‑Bench падает с 0,815 до 0,749. Selective DuET выбирает переключение по attention к исходному изображению. Для 4B он удерживает сохранность в пределах эмпирического порога VLM‑оценщика, но это не человеческая оценка и не гарантия для любых правок.
Revisiting Classifier‑Free Guidance Methods in Latent Diffusion Models
Что изучаем
Работа от авторов из Yandex Research и НИУ ВШЭ. Classifier‑Free Guidance — повсеместно используемый метод улучшения качества визуальной генерации в диффузионных моделях. За последние четыре года вышло огромное количество статей, предлагающих улучшение исходного подхода. При этом в большинстве статей предложенные методы недостаточно тщательно сравнивают с конкурентами, оценивают на неинформативных бенчмарках или проверяют на устаревших моделях.
Цель работы — актуализировать представление о том, где область находится сейчас. Для этого исследователи сравнили восемь методов на основе Classifier‑Free Guidance, не требующих дополнительного обучения, на моделях Stable Diffusion 3.5 Medium и FLUX.2 4B Base. Все методы тестировались в одинаковых условиях на задачах композиции объектов, соответствия текстовому запросу, генерации текста и рассуждения на основе знаний.
Какие результаты
В статье собрали результаты бенчмарков и примеры генераций, поэтому методы можно сравнить не только по числам, но и визуально. Спойлер: страшные руки тоже присутствуют.
Немного роботов и красоты с экспо
На выставке конференции свои главные наработки представили 34 компании. Было и немало интересного на тему АТ.
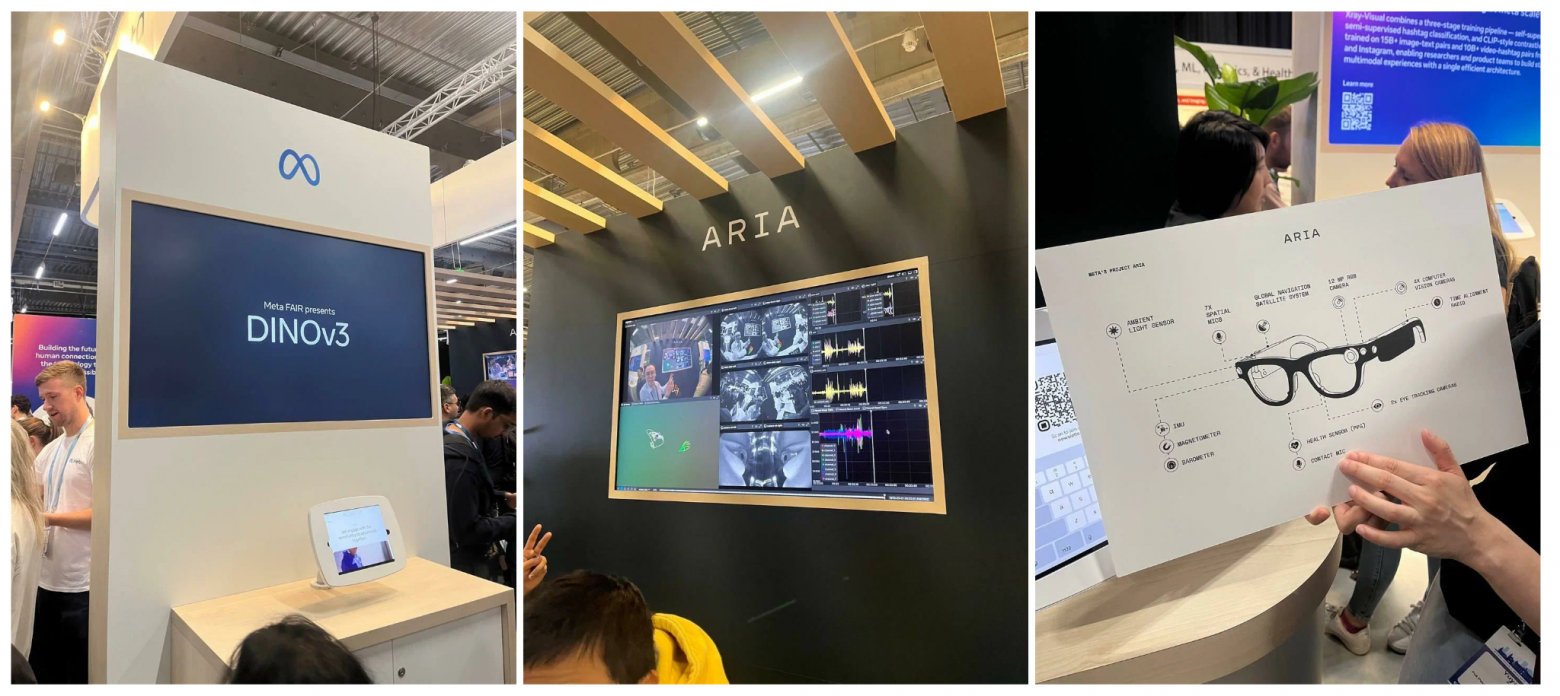
Meta* показали DINO v3 и дали примерить очки ARIA. Внутри несколько камер, трекинг глаз, распознавание кистей рук, SLAM, микрофоны, измерение медицинских показателей, запись данных, возможность блюрить лица и многое другое. Продавать не планируют, предлагают использовать для разнообразного ресёрча.
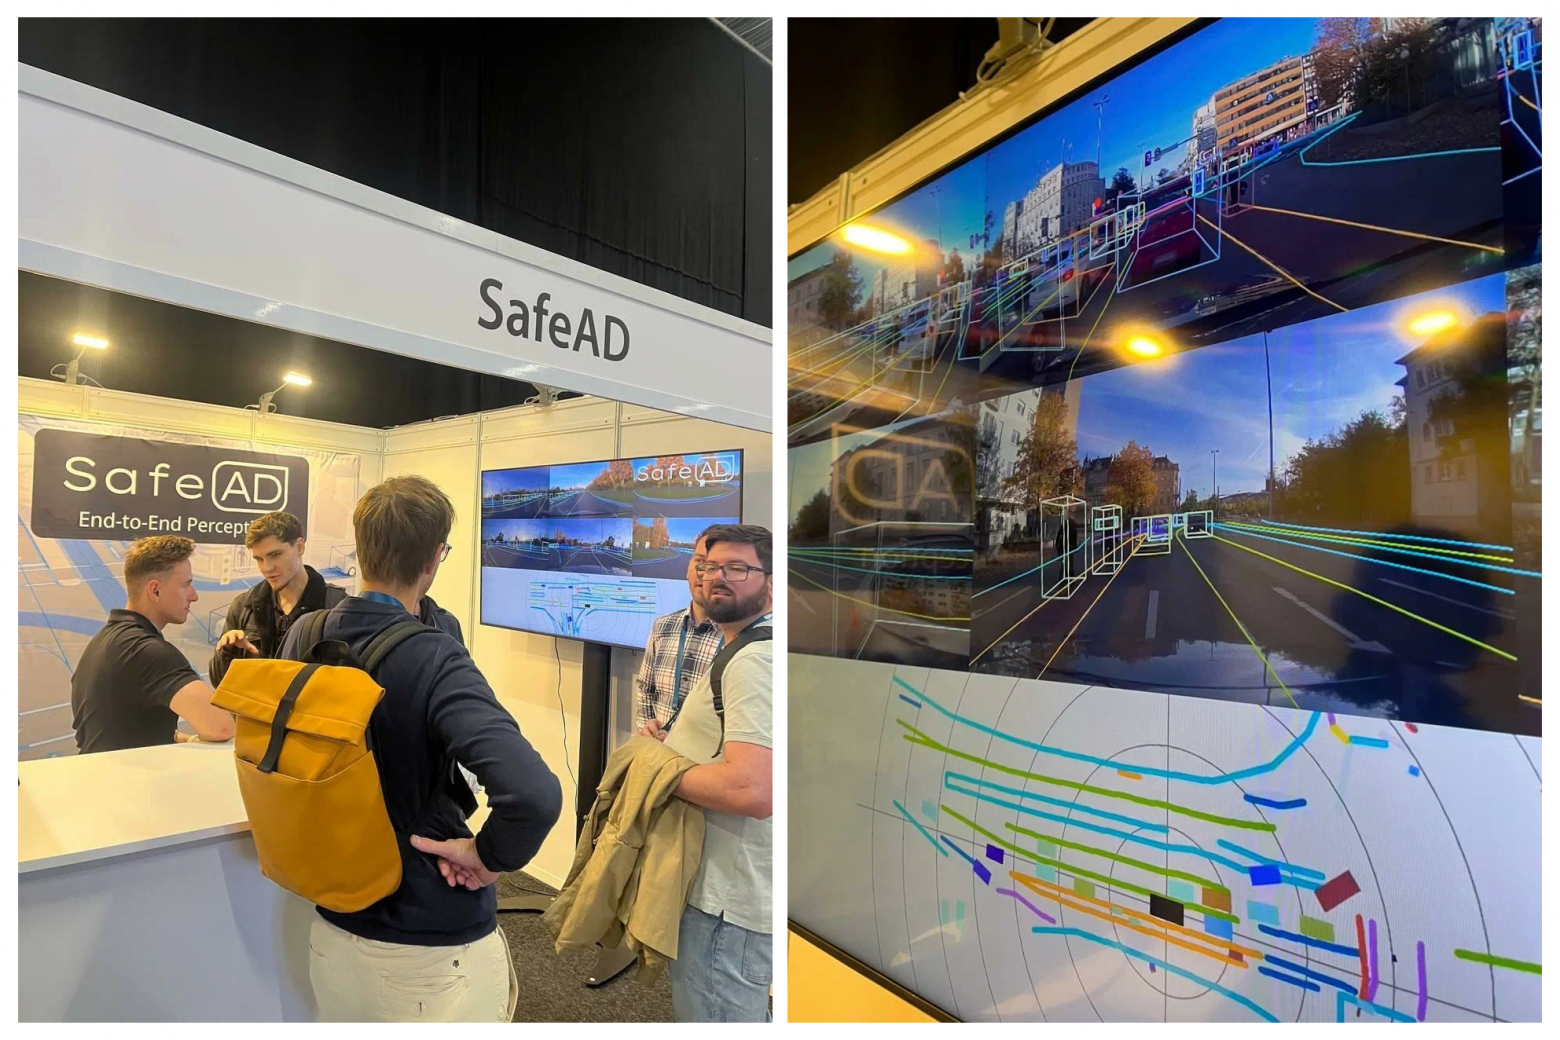
SafeAD — немецкий стартап, который делает софт для L4 АТ. Сначала попробовали модульный подход, но сейчас переходят к e2e. Говорят, научились довольно хорошо строить HD‑карты по данным с сенсоров с помощью VLM. На вход VLM подают что‑то вроде GeoTIFF. По крайней мере, точно проецируют картинки в BEV до подачи в сетку.
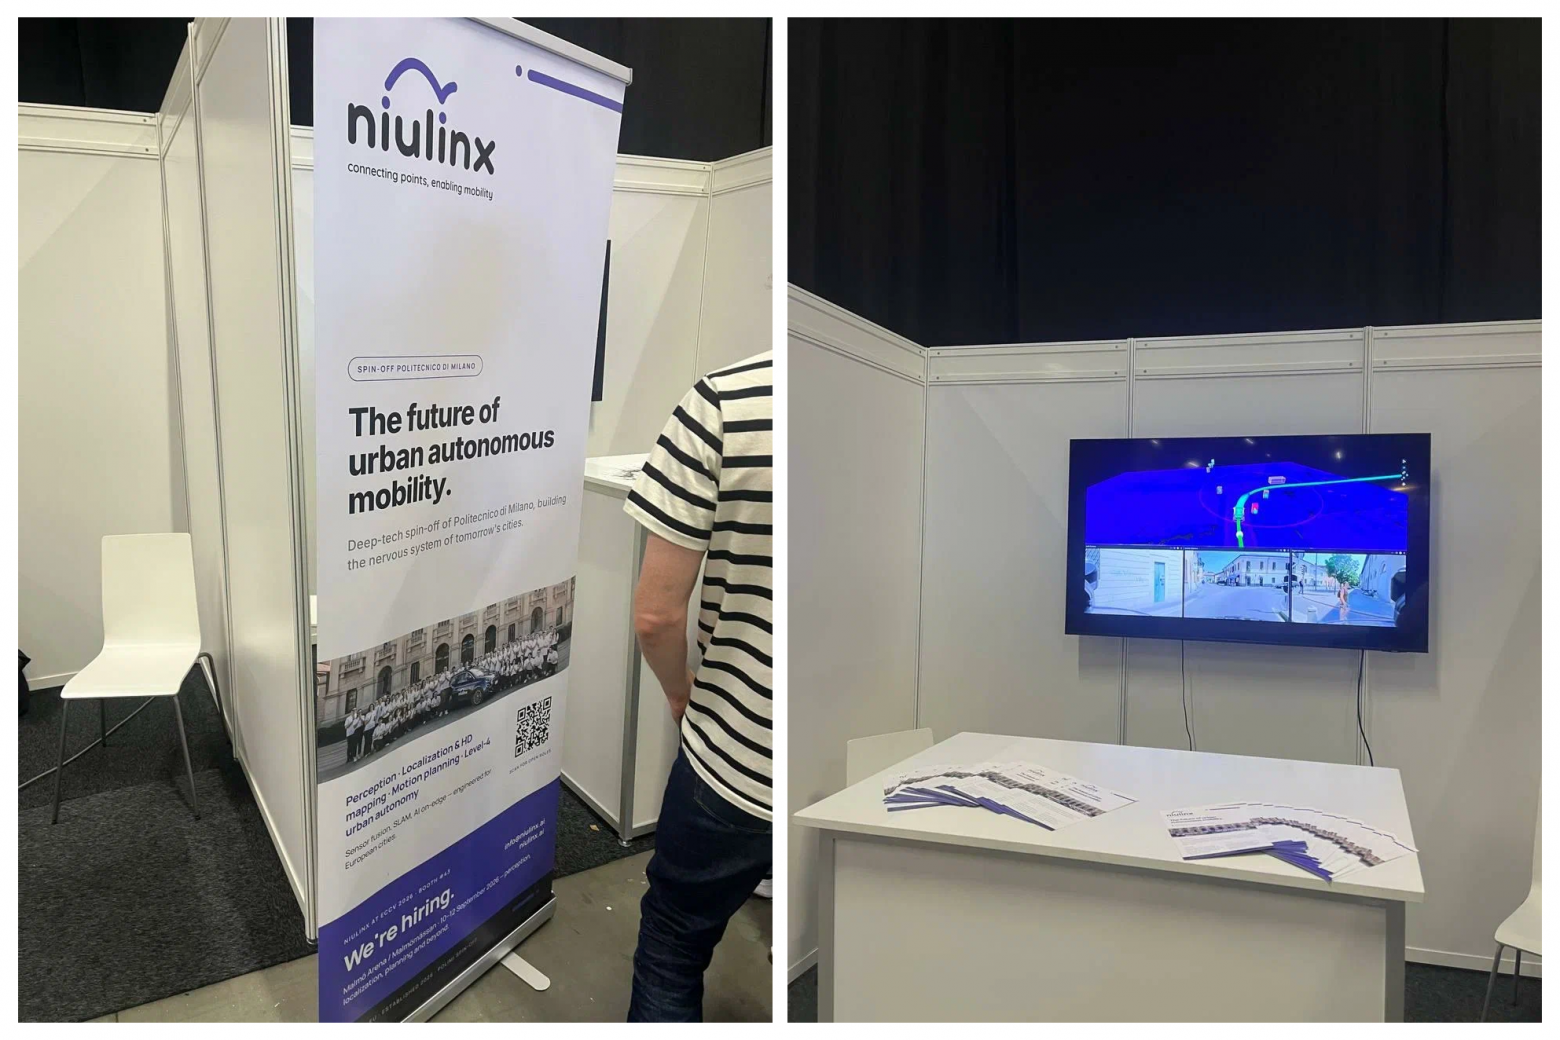
Niulinx — небольшой итальянский стартап, который планирует делать L4-каршеринг. Стек следующий: модульная архитектура, думают о safety‑контуре и о redundancy — иначе по итальянским законам не смогут запуститься без водителя. Поговорили о MRM и радарах. Снег и сильный дождь — пока out‑of‑ODD, как и езда по бездорожью или вне города (быстро ездить пока не планируют). Отдельно отметили: извержение вулкана — тоже out‑of‑ODD.
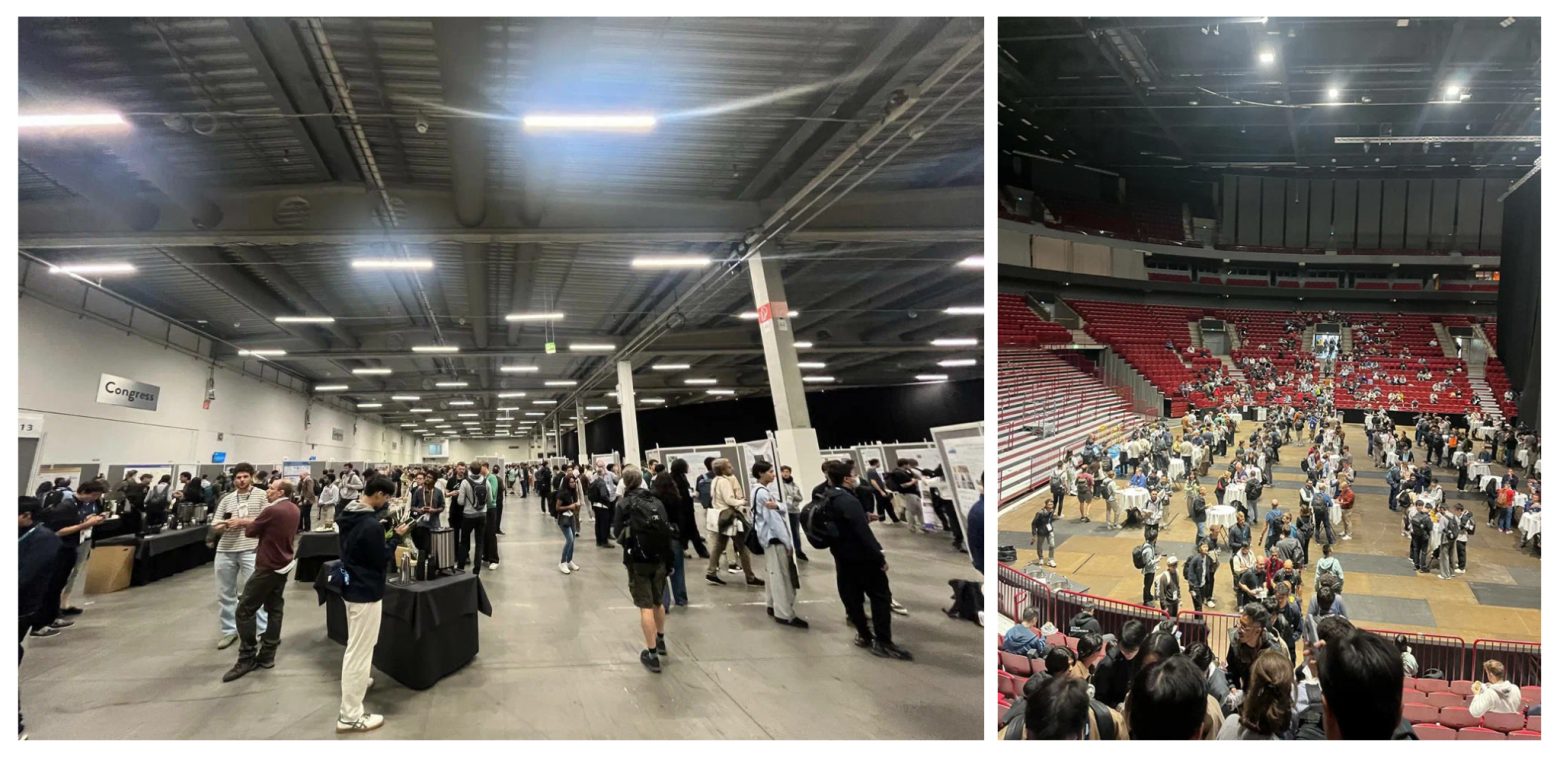
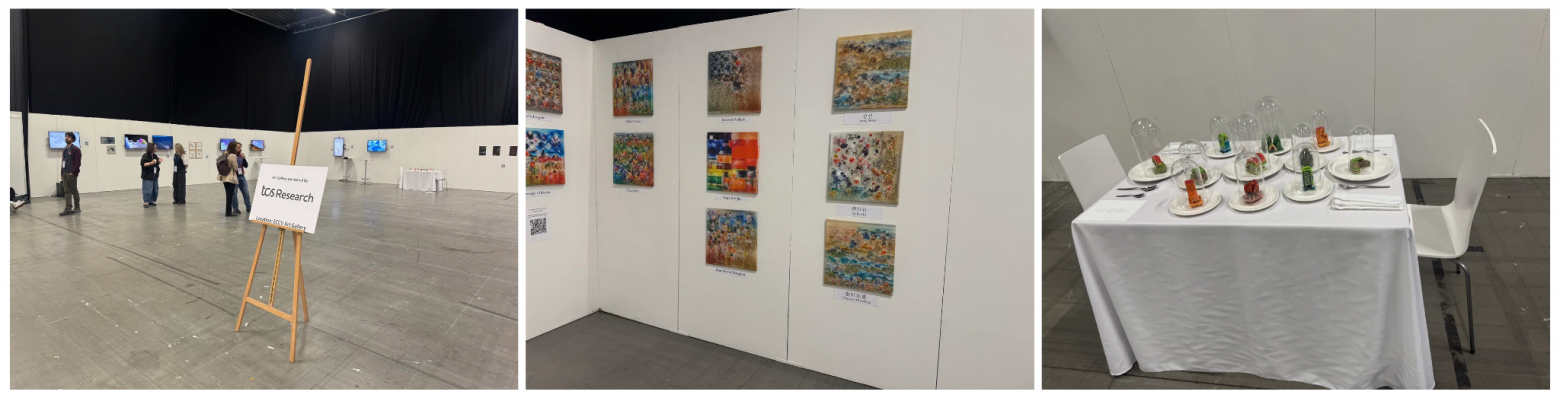
Также в зоне экспо было пространство с предметами искусства — и в расписании даже были слоты с рассказами об этих предметах. Для сравнения — два года назад в Милане такого не было. Правда, эти слоты конкурировали с постерами, поэтому побывать там не удалось.
Доклады и статьи по автономному транспорту
Начну с воркшопа Emerging Behaviors for Achieving Robust Autonomy, который посетил лично.
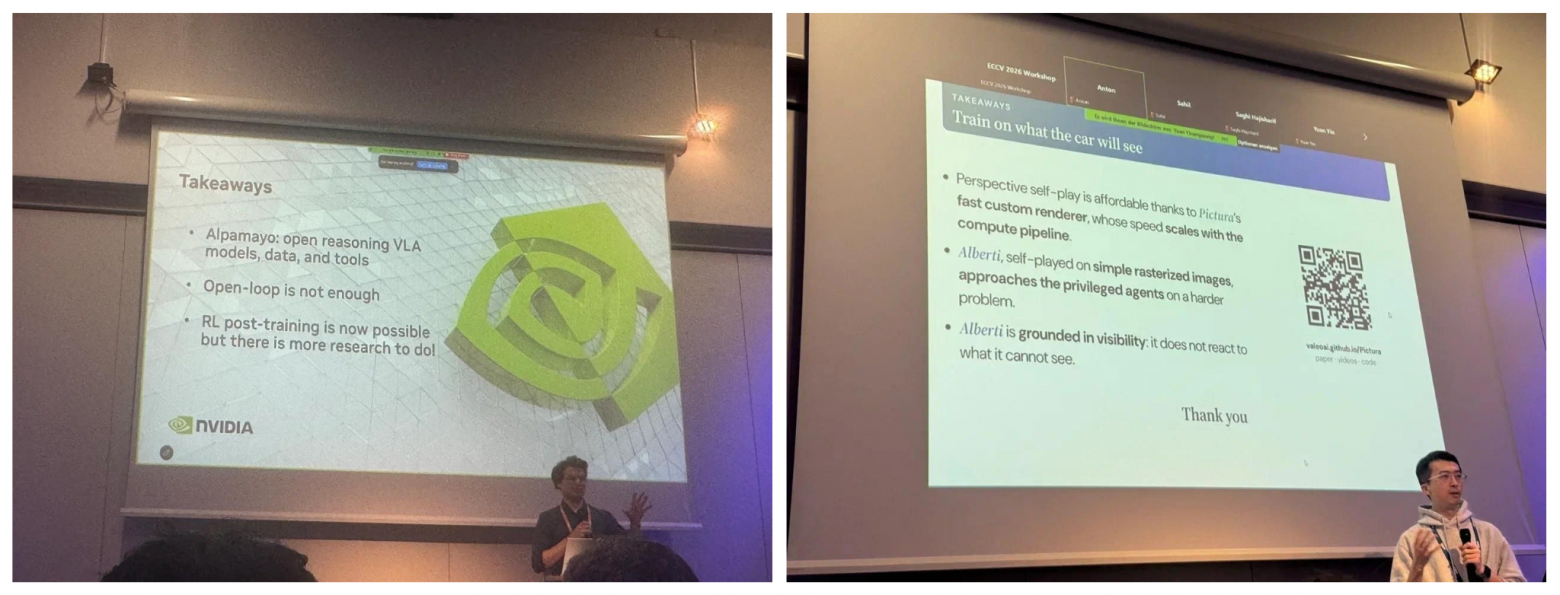
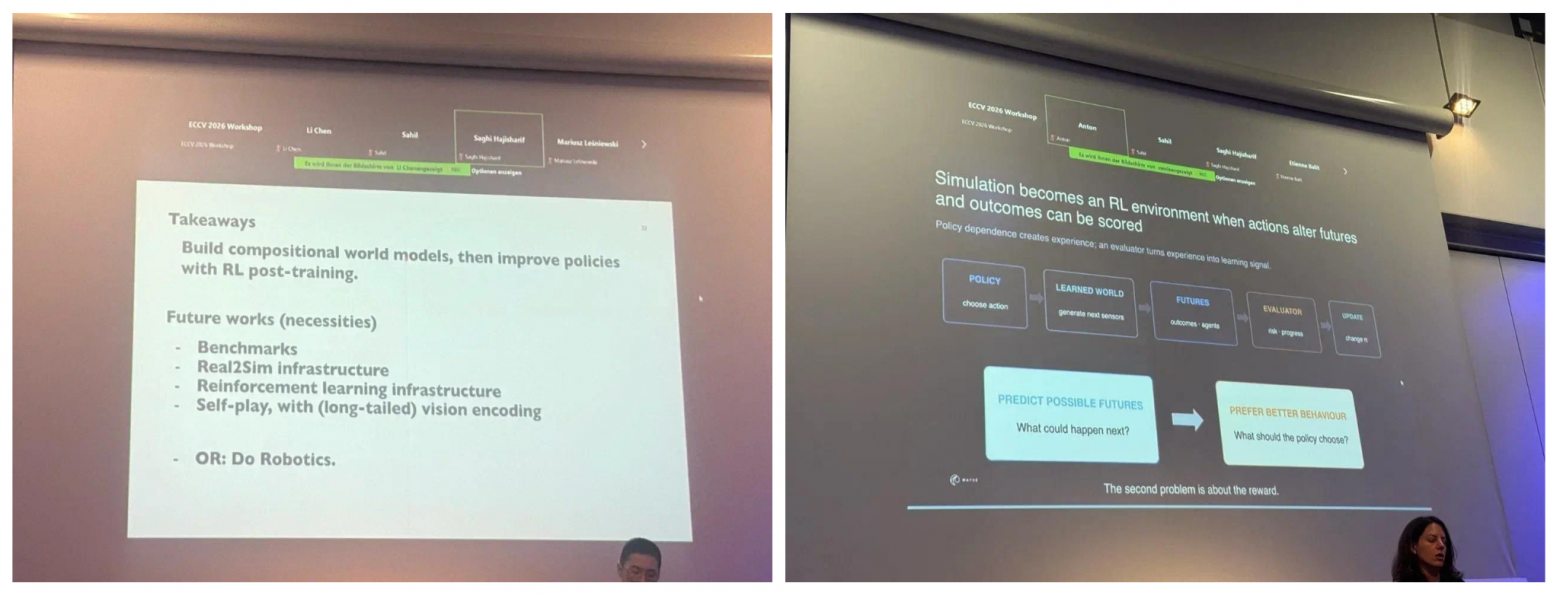
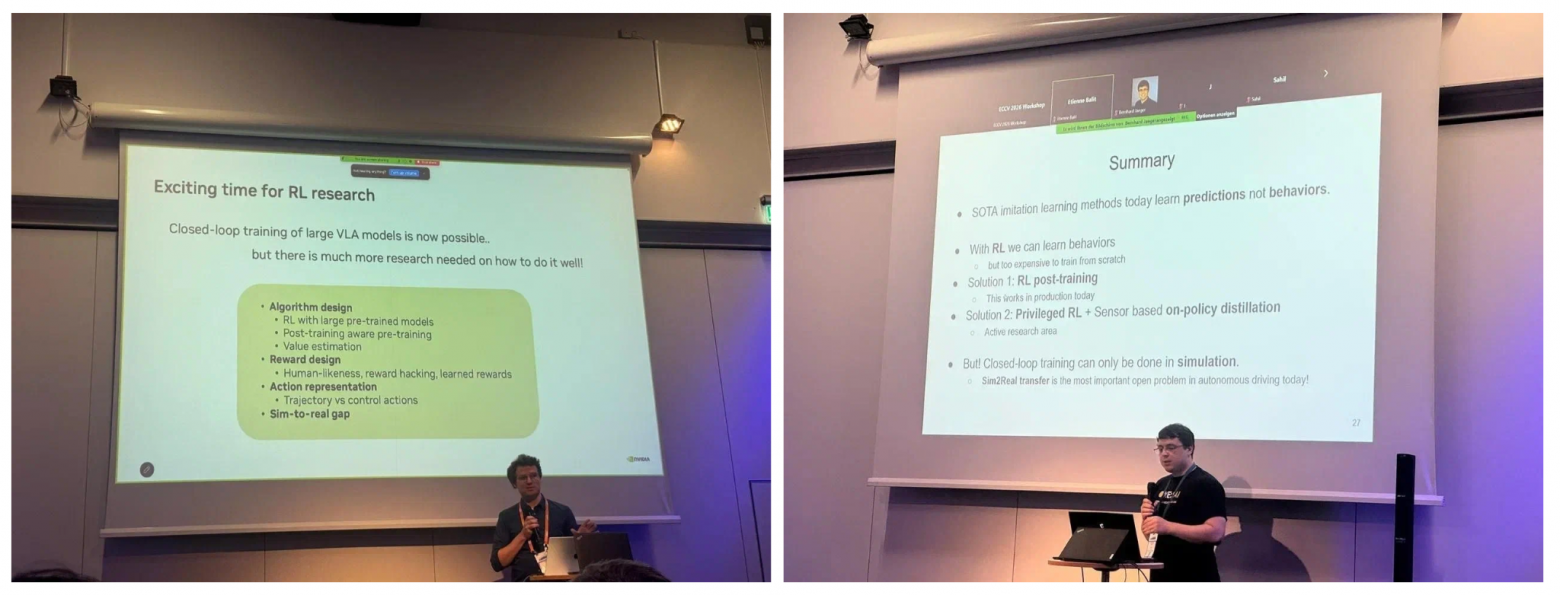
Участники обсуждали надёжность автономного транспорта. В нескольких докладах, как из индустрии, так и из академии, чётко прослеживались одни и те же тезисы по развитию планировщиков для автономных автомобилей:
Развитие ML‑планировщиков движется в сторону end‑to‑end‑моделей.
Уже сейчас индустрия активно использует RL для обучения ML‑планировщиков — пока в варианте RL post‑training в симуляции. Ресёрч идёт в сторону RL‑обучения с нуля, в том числе и для end‑to‑end‑сетей.
И в индустрии, и в академии интенсивно пытаются использовать Self‑play RL. Это был один из важных ингредиентов успеха AlphaGo, которая тренировалась играть сама с собой в го и в итоге впервые обыграла человека в эту игру.
Чтобы RL для end‑to‑end‑планировщика заработал, нужен быстрый симулятор с достаточно высоким качеством имитации сенсоров. Это пока остаётся исследовательской задачей. Даже NVIDIA, которая довольно далеко продвинулась в задаче симуляции сенсоров для роботов, пишет о том, что sim‑to‑real gap — всё ещё частая проблема.
Надёжный планировщик не сделать только на основе записанных логов. Симулятор должен уметь генерировать сложные случаи для обучения и тестирования. Для этого нужна эффективная world model, созданием которой занимаются и в академии, и в индустрии.
Академические боли тоже остаются прежними. В докладе PRIX: Learning to Plan from Raw Pixels for End‑to‑End Autonomous Driving авторы добились SOTA на нескольких бенчмарках для планировщика в автономном транспорте. Но на последнем слайде честно написали, что не могут предсказать, как модель будет вести себя в реальности, на живом роботе или автомобиле с ограниченными вычислительными возможностями. Это общая проблема академических исследований: своего флота автомобилей у них нет, а открытые бенчмарки требуют дополнительной валидации.
Отсюда хочется перекинуть мостик к теме ризонинга. Этой теме были посвящены работы на параллельных воркшопах, которые посетила руководитель группы ML‑разработки в автономном транспорте Полина Комиссарова.
Компания Motional рассказала о своём новом опенсорсном датасете для автономного транспорта с ризонингом — Motional Open‑Sources Dataset to Help Autonomous Vehicles Master Human‑Like Reasoning. Отдельный акцент ребята сделали на важности отбора long‑tail‑сцен.
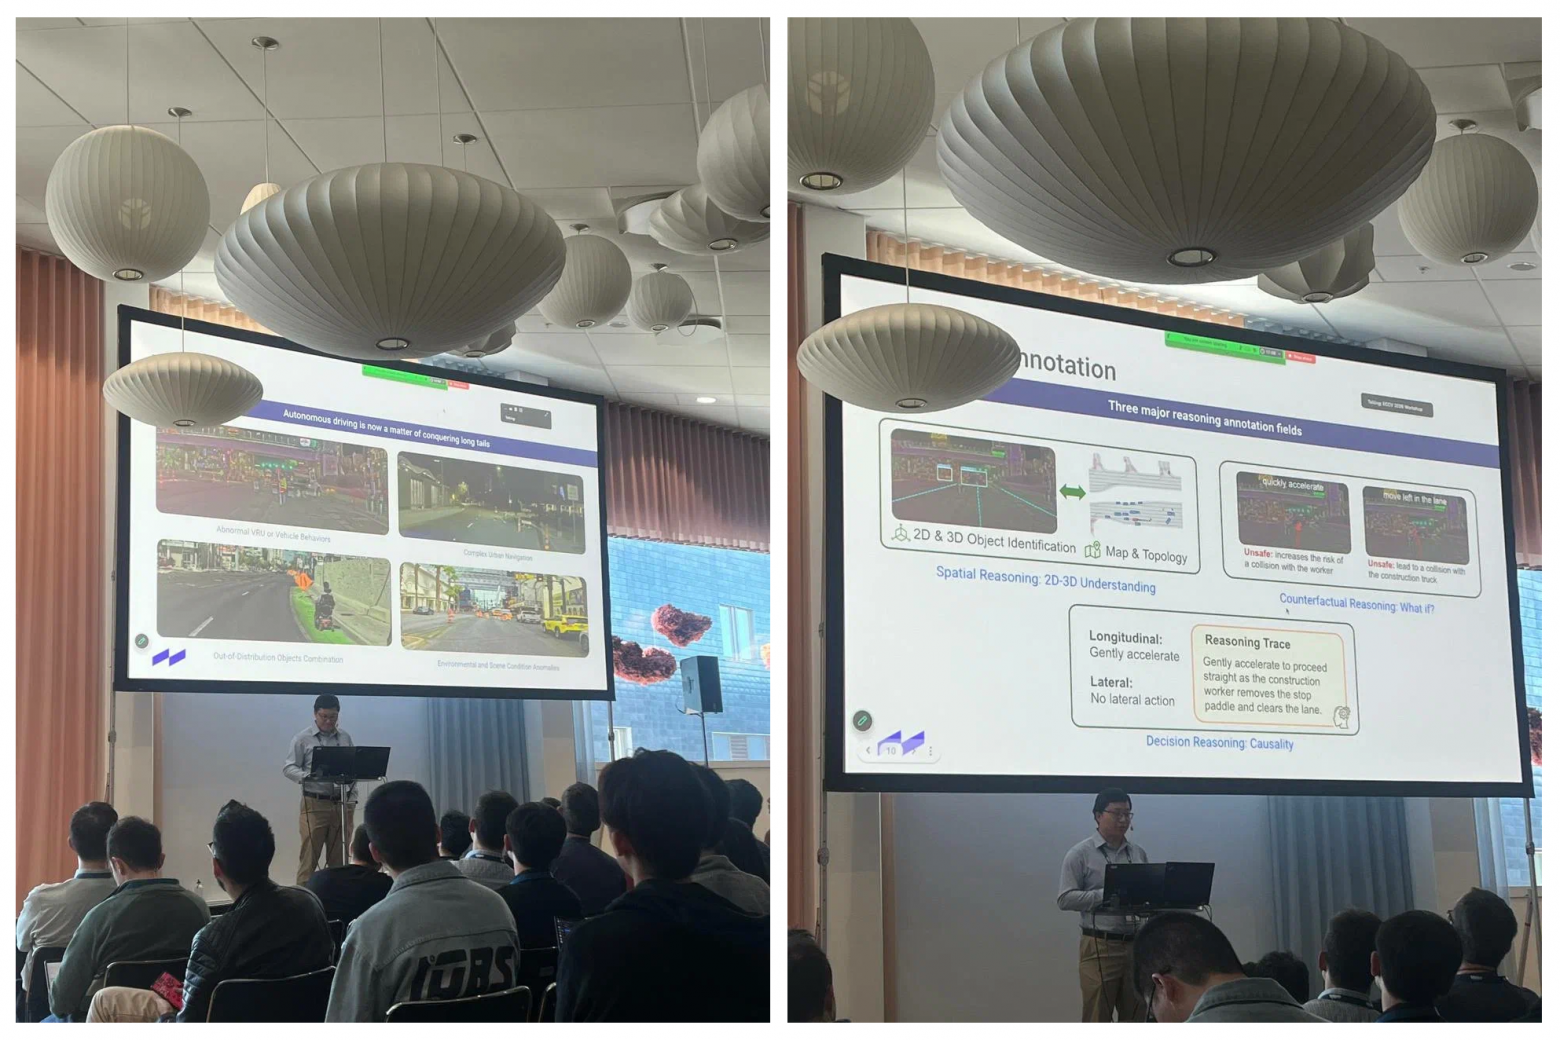
E2E/VLA сейчас плохо справляются с long‑tail‑ситуациями, такими как сложные ремонтные работы, падением посреди дороги и прочим. Нужно, чтобы модель понимала не только то, где и какие объекты находятся, но и то, что происходит и что, исходя из этого, нужно делать — эффективно и безопасно. Нужно добавить ризонинг.
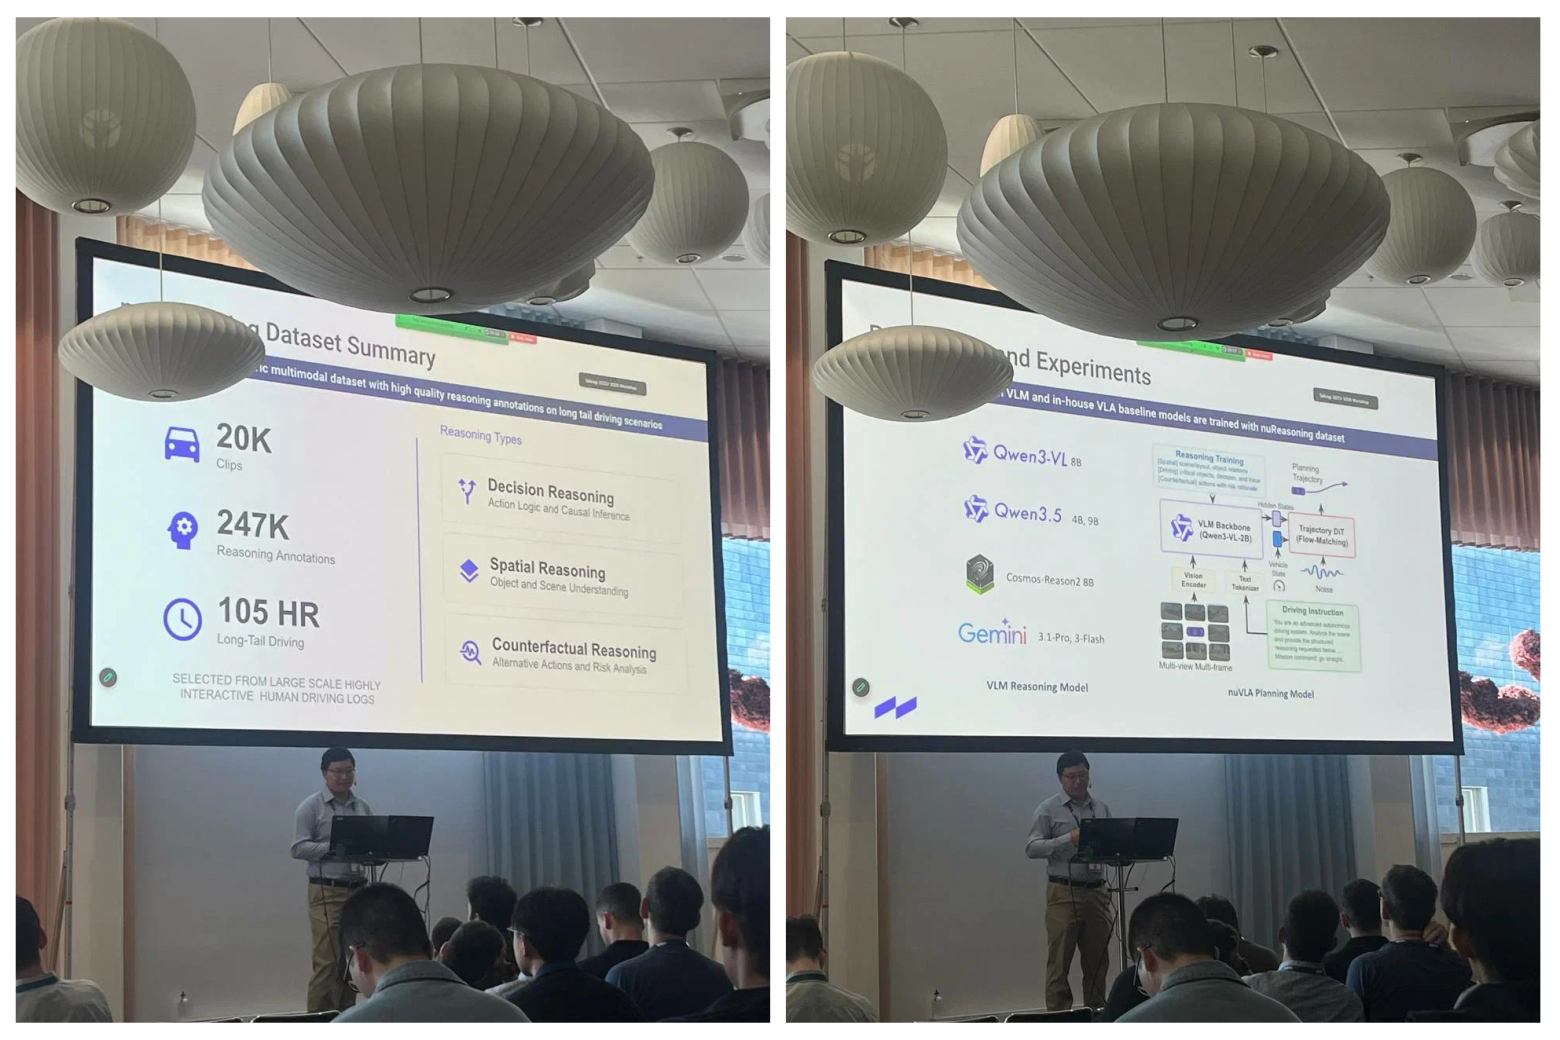
Сначала авторы собрали большой датасет long‑tail‑сцен. Использовали Gemini 3.1 Pro, чтобы она оценивала сложность сцены по 10-балльной шкале, отобрали самые сложные. Дополнительно их провалидировали люди. Релизнули 20 тысяч 20-секундных сцен, что равно 111 часам: камеры, лидары, HD‑карты, разметка и reasoning labels.
Следующим шагом сделали три вида ризонинга:
Пространственный: для каждого агента запоминаем расстояние до ego, движется ли он, и потенциальные пересечения траекторий и тому подобное
О принятом решении/действии: тут используют пространственный ризонинг + actions + виды с картинок + gt ego trajectory и др. Работает Gemini 3.1 Pro.
Контрафактный: тоже с помощью Gemini 3.1 Pro рассуждают, что будет, если поехать по другой, потенциально небезопасной траектории.
На базе результатов предыдущего шага сформулировали множество вопросов и ответов. Где находится пешеход? Что он собирается делать в следующую секунду? Сколько времени до потенциального столкновения? Куда сейчас ехать? Что было бы, если бы мы сейчас не затормозили, а ускорились?
После пофайнтюнили VLM на этих вопросах/ответах. Стало лучше!
Эти ризонинги также попробовали дополнительно давать VLA (внутри которой VLM) — планнингу тоже стало лучше.
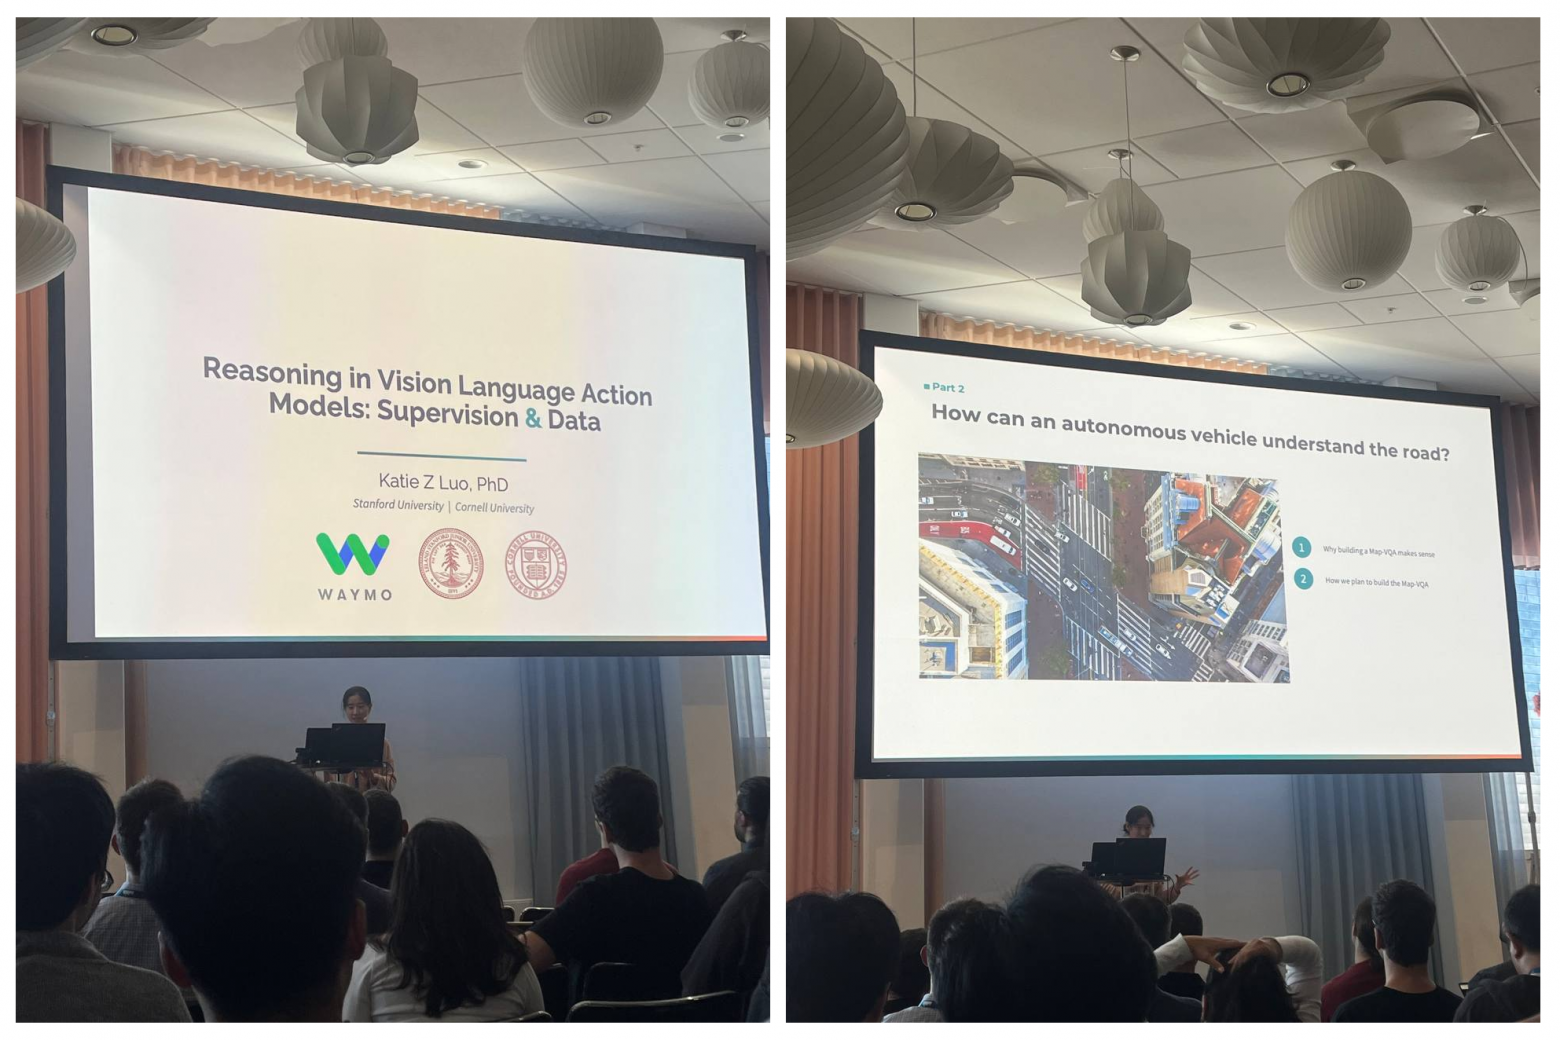
Ещё одно интересное выступление. Katie Z Luo из Стэнфорда рассказывала об embodied reasoning для гуманоидов и автономного транспорта на основе двух статей.
Расскажу о второй: Bridging Structure and Language: Graph‑Based Visual Reasoning for Autonomous Road Understanding.
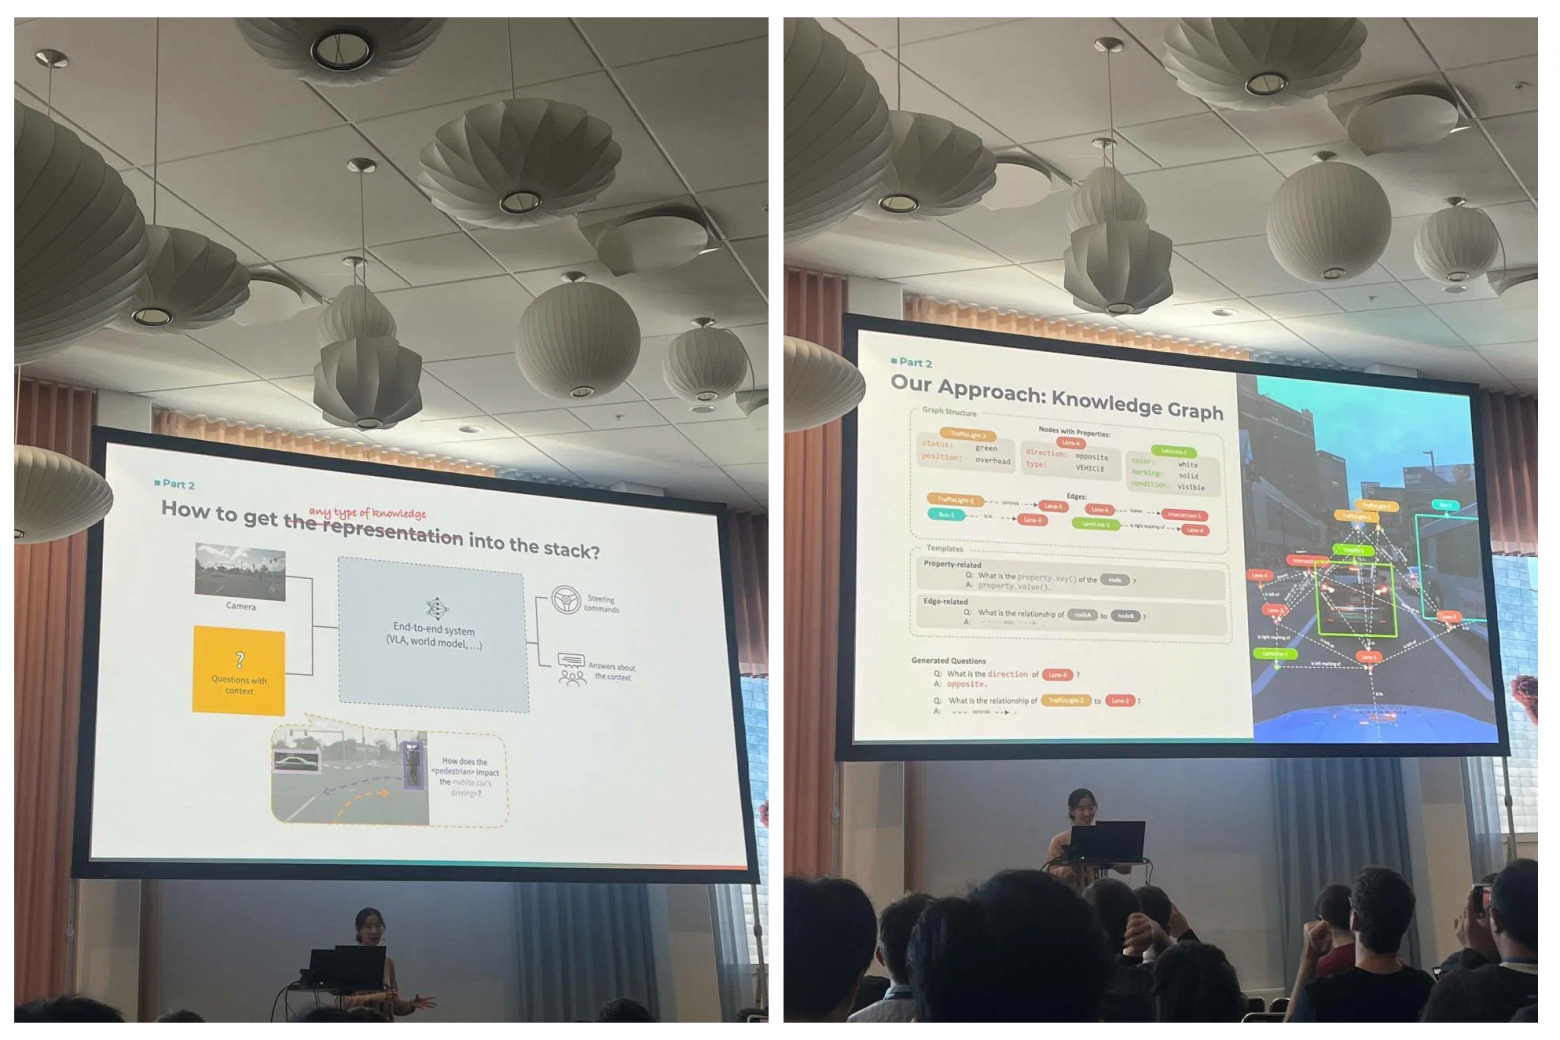
Авторы ставят задачу научить VLM отвечать на вопросы о происходящем на дороге.
Проблема в том, что VLM, обученные на internet‑scale‑объёме данных, хорошо понимают семантику, умеют работать с open‑vocabulary‑датасетами, но не понимают геометрические связи в пространстве (например, какой светофор к какой полосе относится).
В статье в качестве VLM берут Qwen3-VL-2B/4B‑Instruct. Первым шагом строят граф взаимосвязей (Combined Road Substrate (CRS)) между объектами на сцене: светофор 1 относится к полосе 2, грузовик 4 находится справа от велосипеда 12, ego сейчас на полосе 3.
Конкретно для построения графа авторы берут датасет с картинками из Argoverse, соответствующие HD‑карты с топологической структурой из OpenLane‑V2, вершинами графа становятся элементы карт. К каждой вершине докидывают её свойства (например, сигнал светофора — красный, чёрный автомобиль припаркован), направленные рёбра графа и их названия — «соседство» объектов, что чем управляет и прочее. Также есть небольшой постпроцессинг с участием человеческой разметки.
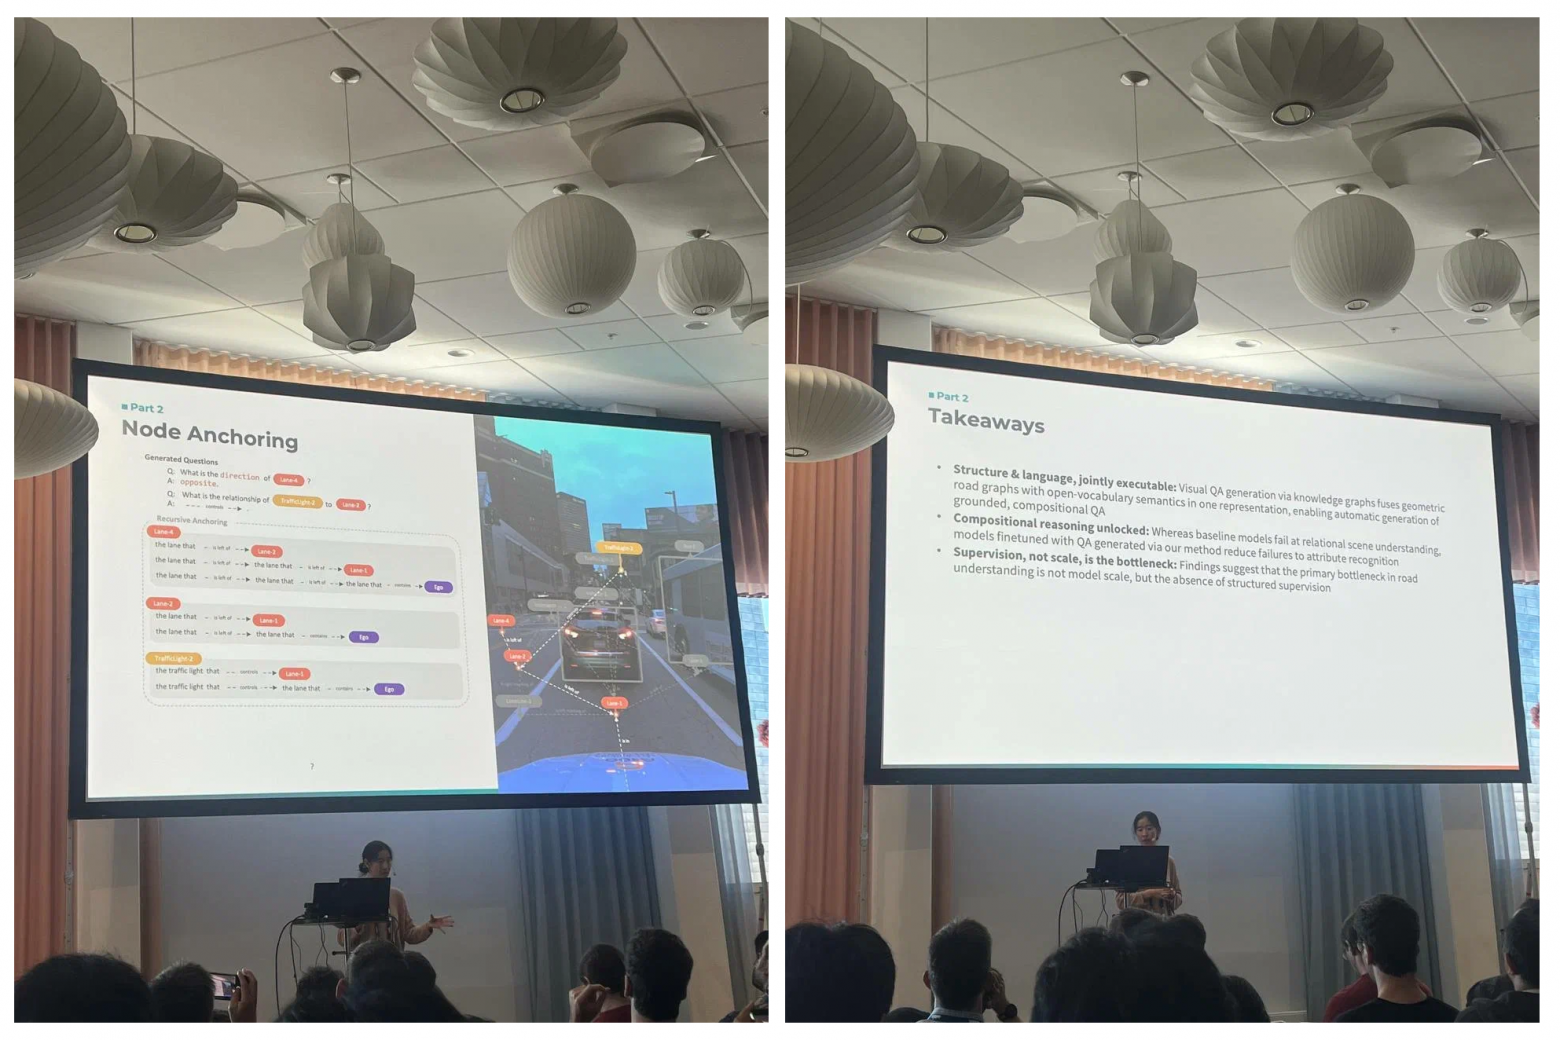
Затем по построенному графу нагенерили вопросов, соответствующих им ответов, а также сформировали chain‑of‑thoughts (CoT).
Как формируются вопросы? Тут есть варианты. Можно, например, взять две вершины, связанные не обязательно напрямую, и сформулировать вопрос о виде связи между ними. Или можно взять одну вершину и спросить, какое у неё свойство. CoT создаётся на основе прохода от стартовой вершины к конечной в процессе формирования ответа на заданный вопрос (если в вопросе задействованы несколько вершин). Также авторы генерируют hard negative samples.
Из 80 графов авторы получили 22 тысячи обучающих примеров. На отложенной проверке точность Qwen3-VL-4B‑Instruct выросла с 44,3% до 71,1%; добавление CoT дало 71,3%. Основной выигрыш связан со структурированной разметкой. Качество вождения здесь не проверялось.
Вместо заключения
После миланской ECCV 2024-го в этом году мы отчётливо почувствовали шведский минимализм и дух Скандинавии. Организация была чёткой и слаженной, что здорово облегчило изучение работ. Где конференция будет проводиться в 2028 году, пока не объявили, но уже очень интересно.
То, что ECCV стала намного больше и шире классического CV, — уже, наверное, ни для кого не новость. Исследователи ищут интересные темы и задачи на стыке областей и стараются подавать работы на конференции в каждой области. Анализируя срез статей, связанных с автономным транспортом, могу явно выделить тренд на создание end‑to‑end‑планировщиков, RL и self‑play, а главным узким местом, кажется, становится симуляция. Для обучения нужны быстрые и реалистичные симуляторы, которые умеют генерировать сложные сценарии. Отсюда большой интерес к world models.
Любопытно, что несколькими месяцами ранее проходила более профильная для автономного транспорта и роботов конференция ICRA, откуда наши коллеги привезли те же инсайды. Но на ECCV эти темы раскрывались через призму работы с сенсорами и использования инструментов компьютерного зрения, а на ICRA — через методы обучения планировщиков для управления роботами.
В то же время сохраняется большой разрыв между академией и индустрией. Исследователи ограничены задачами, для которых есть открытые бенчмарки, а также качеством этих бенчмарков. Применительно к автономному транспорту эта проблема присутствует в полной мере. Однако подобные конференции становятся мостом между академией и индустрией, который позволяет обмениваться информацией и лучше синхронизировать работу.
Будет интересно узнать в комментариях, планируете ли вы пробовать и исследовать какие‑то из идей, представленных на ECCV. А может, какие‑то уже протестировали и готовы поделиться результатами!
Новости конференций прямо с места событий мы публикуем в канале ML Underhood — подписывайтесь, чтобы ничего не упустить.
*Компания Meta признана экстремистской организацией, а её деятельность и продукты запрещены на территории РФ

