Привет, Хабр! На связи команда разработки кредитных продуктов для физлиц Т‑Банка. Эта статья завершает цикл нагрузочных испытаний Camunda 8.6. В предыдущих частях мы разобрали архитектуру Zeebe, масштабируемость и проблему накопления истории процессов.
Масштабирование Zeebe: от каскадных сбоев до 100 процессов в секунду через анализ ресурсов и тюнинг
Накопление истории в Zeebe: причины замедления и влияние на память
В Camunda 8.6 появились новые механизмы управления нагрузкой и изменились требования к конфигурации Elasticsearch. Мы проверили, как эти изменения влияют на производительность кластера под боевой нагрузкой.
Что будет в статье: рекомендации по развертыванию Zeebe‑кластера, как работает flowControl вместо backpressure, результаты новой волны тестов и итоговые выводы по эксплуатации движка. В конце покажем, как потерять производительность в 2 раза без базового тюнинга. Обсудим ключевые результаты и итоги по развертыванию и эксплуатации движка.
Зачем мы тестировали Zeebe
Zeebe впечатлил богатым функционалом для обработки бизнес‑процессов. Это современное масштабируемое решение, которое активно развивается. Но, как и предшественник (Camunda 7), имеет ряд трудностей при эксплуатации.
Цель испытаний: понять, насколько система продуктивна и применима в продакшене, найти все точки деградации и роста. Нагрузочное тестирование — довольно сложный процесс для каждой системы. Мы не планировали исследовать определенную часть системы, хотели понять, насколько она будет продуктивна и эксплуатационно применима в продакшене.
Мы не шли по готовому сценарию, а проводили испытания хаотично, возвращаясь к некоторым точкам анализа повторно. Это позволило оценить Zeebe максимально приближенно к реальности.
Мы не проводили существенные изменения кластера Elasticsearch или импорта данных на стороне Operate, так как это отдельная тема для исследований. Но каждый, кто использует Zeebe, должен понимать его ограничения, как он устроен и функционирует, — тогда вы получите довольно гибкий к масштабированию инструмент и нагрузите его по полной!
Как минимизировать накопление истории и влияние на память движка
Как мы выяснили в предыдущей статье, архитектура кластера Zeebe напрямую влияет на производительность обработки и экспорта данных. Рекомендация Camunda 8.6: разворачивать Elasticsearch в трех репликах для улучшения экспорта и индексирования исторических данных. Такой подход обеспечивает не только отказоустойчивость, но и стабильную обработку истории под высокой нагрузкой.
Импортеры: требуют отдельного масштабирования. При 10 партициях и 3 узлах импорта данные распределяются примерно по 3–4 партиции на узел. Это позволяет распараллелить выгрузку и ускорить обработку. А еще — увидеть актуальную историю в Operate.
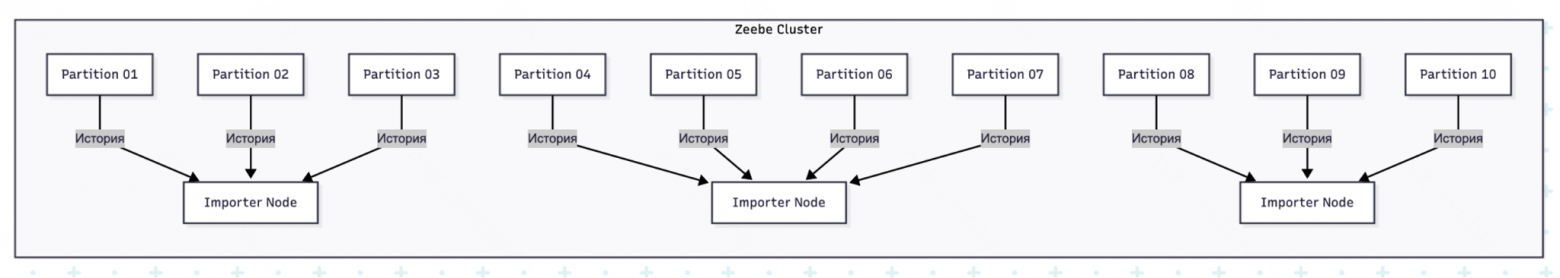
Теоретически даже один узел импорта может справиться с нагрузкой, если количество партиций ≤ количеству узлов × количеству потоков на узле. На практике производительность ограничивается не только CPU и памятью Zeebe, но и возможностями Elasticsearch.
Вывод: масштабирование Zeebe без учета производительности отдельных компонентов кластера (Elasticsearch, импортеры) бессмысленно. Балансировать нужно всю цепочку: от движка до хранилища истории.
Механизмы защиты: backpressure и flow control
До версии Camunda 8.6 действовал механизм backpressure — защита брокера от перегрузки через контроль inflight‑запросов. Как только число незавершенных запросов достигает лимита, новые отклоняются. Интересно, что алгоритмы backpressure — адаптивные ( AIMD, Vegas): они динамически корректируют лимиты на основе RTT, подстраиваясь под текущую нагрузку.
С версии Camunda 8.6 backpressure стал частью более широкого механизма — Flow Control. Система не только защищает брокер, но и балансирует скорость обработки и экспорта данных, предотвращая перегрузку downstream‑компонентов (Elasticsearch, Kafka‑exporters).
Важно: в self‑managed‑развертывании Flow Control по умолчанию отключен — его нужно включать и настраивать.
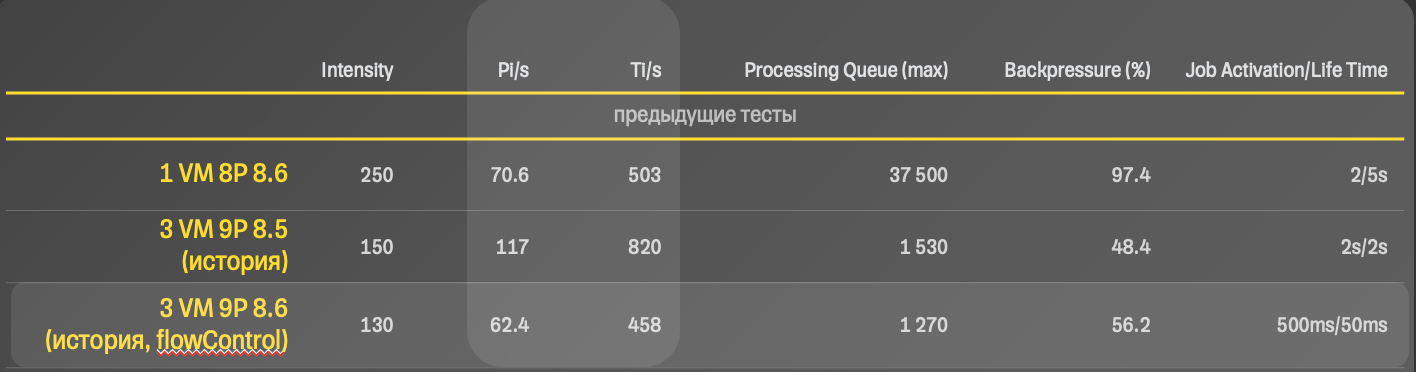
При включении flowControl есть существенный недостаток: замедление обработки приводит к искусственному снижению производительности системы в целом. Поскольку Zeebe начинает замедляться не из‑за нехватки собственных ресурсов, а из‑за ограничений в инфраструктуре для ожидания экспорта истории, общая пропускная способность падает, даже если движок технически способен обрабатывать больше.
Flow control обеспечивает стабильность за счет ограничения принимаемых запросов и подходит для сценариев, где целостность данных приоритетнее быстродействия. Его применение требует четкого понимания баланса между операционной нагрузкой и возможностями сопутствующих систем.
Серия испытаний
В исследовании мы сосредоточились на ключевых аспектах архитектуры Zeebe, которые больше всего влияют на производительность в продакшене. Мы уже затрагивали партиционирование, скейлинг ресурсов, накопление истории и влияние экспорта истории на движок. Сейчас хотим подчеркнуть дополнительные сценарии тестирования: настройку экспорта истории, размер процессов и вертикальный скейлинг.
История выполненных бизнес‑процессов может вовсе не храниться, если это предусмотрено функциональными требованиями к системе. Мы можем ее отключить или настроить ILM (Index Lifecycle Management) — механизм управления жизненным циклом индексов, который работает на стороне Elasticsearch.
Важный фактор использования Zeebe — то, что многие команды в начале использования Zeebe сталкиваются с перегруженными бизнес‑процессами, где огромная часть логики скрыта в воркерах. Воркеры могут сохранять результаты вызовов в переменные, и таких переменных может скопиться огромное множество.
В какой‑то момент после улучшения работы воркеров, настройки конфигурации и экспорта истории может не хватить аппаратных ресурсов, и движок станет уязвимым к перегрузкам. Такой подход может стать узким местом, критически замедляющим общую пропускную способность системы. Чтобы понять, как проявляются эти риски, мы провели серию испытаний по наиболее важным сценариям: настройке экспорта истории, размеру процессов и вертикальному скейлингу.
Тест без экспорта истории. Мы провели тест на старом кластере Camunda 8.5: отключили экспорт в Elasticsearch и выполнили ту же нагрузку, что и для Camunda 8.6. Результат — 114 процессов и 799 задач в секунду. Производительность не выросла.
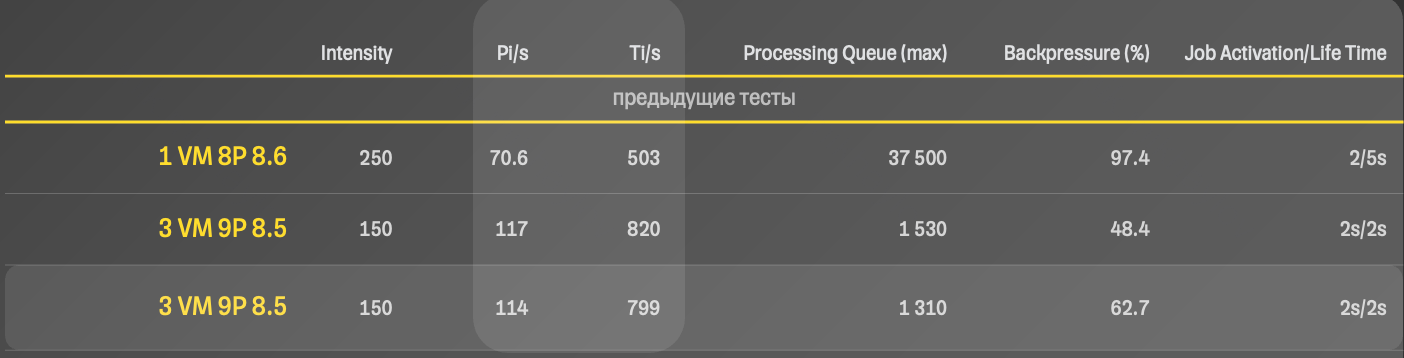
При этом изменение различных параметров настройки Zeebe уже не дает эффекта: система достигла максимума по ресурсам. При переключении на Camunda 8.6 в 3VM с отключением истории мы получили те же цифры.
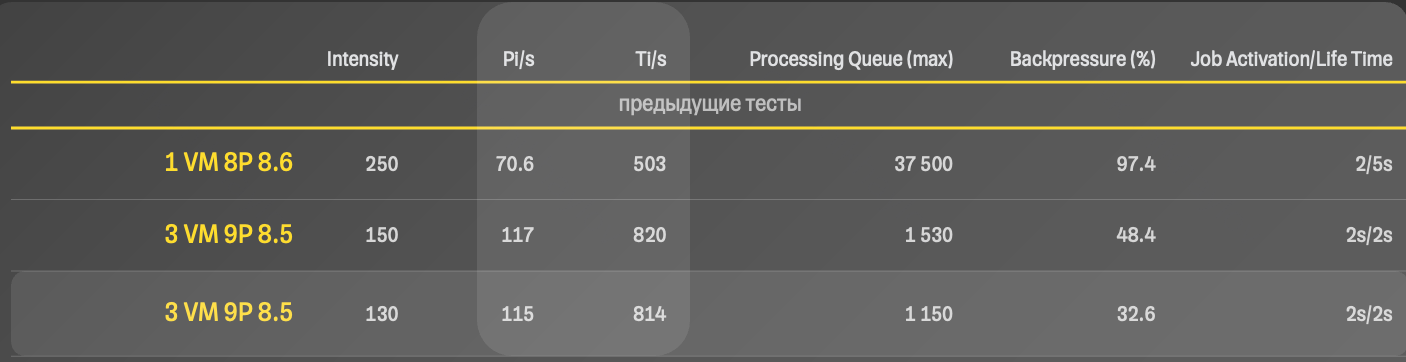
Вывод: дело не в истории. Мы упустили важную деталь.
Размер процесса. Мы провели серию тестов по размеру процесса, так как было удобнее анализировать метрики без истории. Увеличили размер процесса, добавив больше воркеров и разветвлений (в 3–4 раза). Среднее количество выполненных процессов в секунду снизилось в 20 раз.
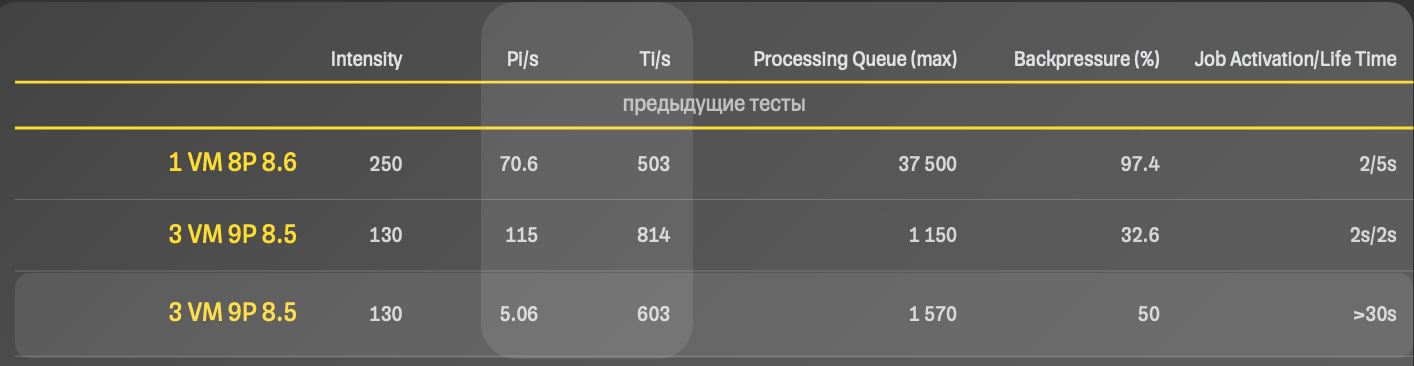
Вывод: Zeebe не предназначен для больших процессов. Чем компактнее воркеры и чем меньше переменных, тем лучше.
Вертикальный скейлинг. Мы провели ряд изменений ресурсов: поскейлились вертикально до 8 CPU / 16 RAM (три ноды). Получили прирост производительности почти на 40%, но ресурсы увеличили в два раза. Вопрос: почему только 40%?
Если посмотреть на использование ресурсов диска, можно заметить, что после 22:00 на графиках IOPS диска стабилизируется и выполняется множество операций чтения или записи на диск. Очередь на запись постоянная, а latency на запись в некоторых местах достигает 9 s.
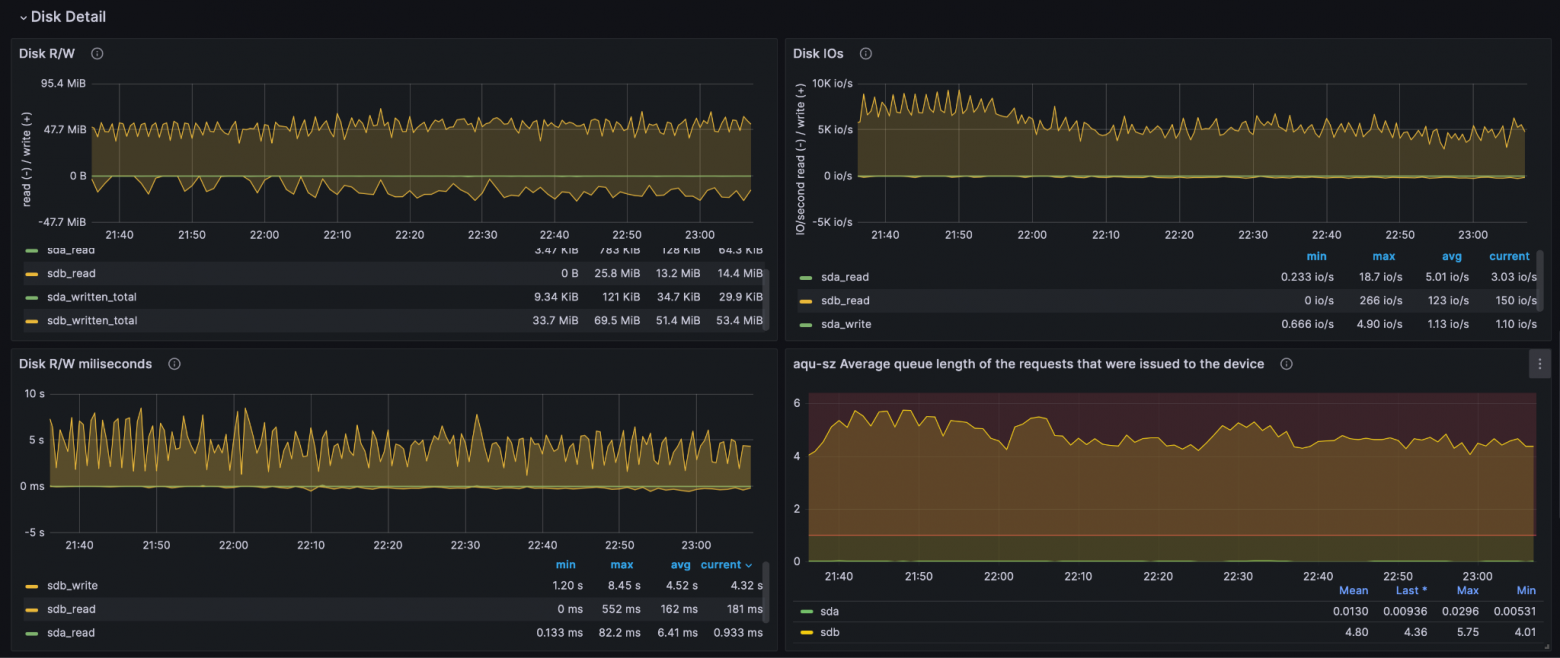
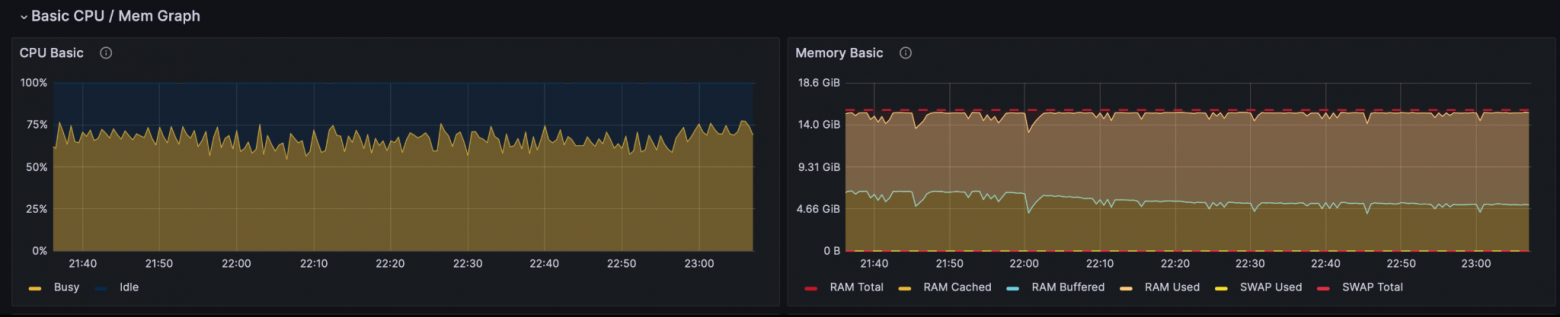
Потребление CPU не растет, так как выполняется меньше работы. Движок постоянно ждет диск, а новые команды обрабатываются последовательно. В свою очередь использование памяти на пределе, то есть движок обрабатывает процессы с высокой скоростью, но что‑то ему мешает.
Каждый compaction в RockDB — это чтение старых файлов и запись новых. Это создает ту самую огромную нагрузку на диск (60 МБ/с) и дикие задержки (latency до 9 сек), которые мы видели раньше на графиках.
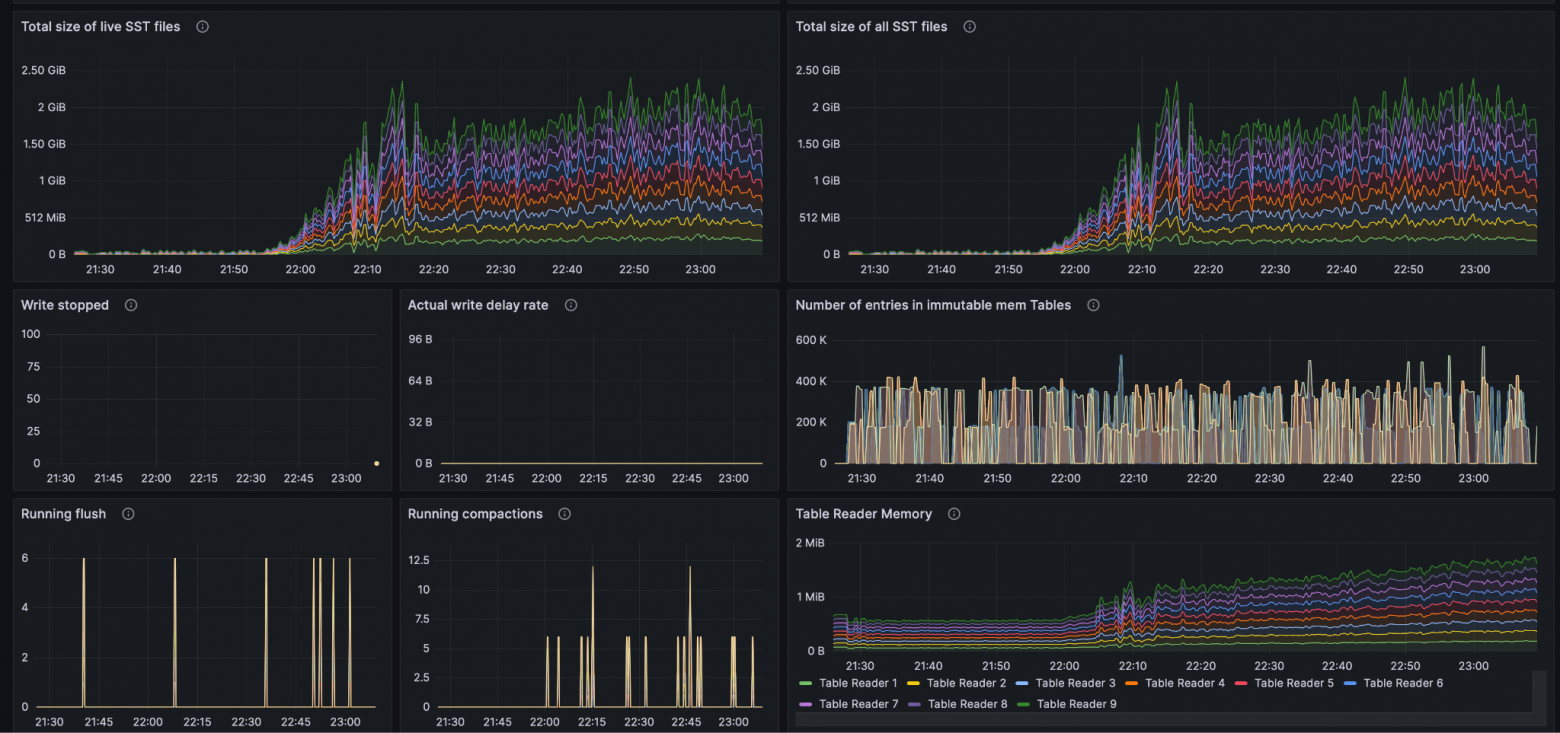
Теперь попробуем представить картину: Zeebe много пишет на диск, который и так уже на пределе своих возможностей. RocksDB пытается это упорядочить, но диск слишком медленный на таких объемах. Из‑за этого данные копятся в памяти. Память забита, диск в очереди на запись, а CPU ждет их обоих.
Дальше разберем, почему CPU ждет, если он может выполнять другие операции.
Находка: конфигурация CPU‑потоков
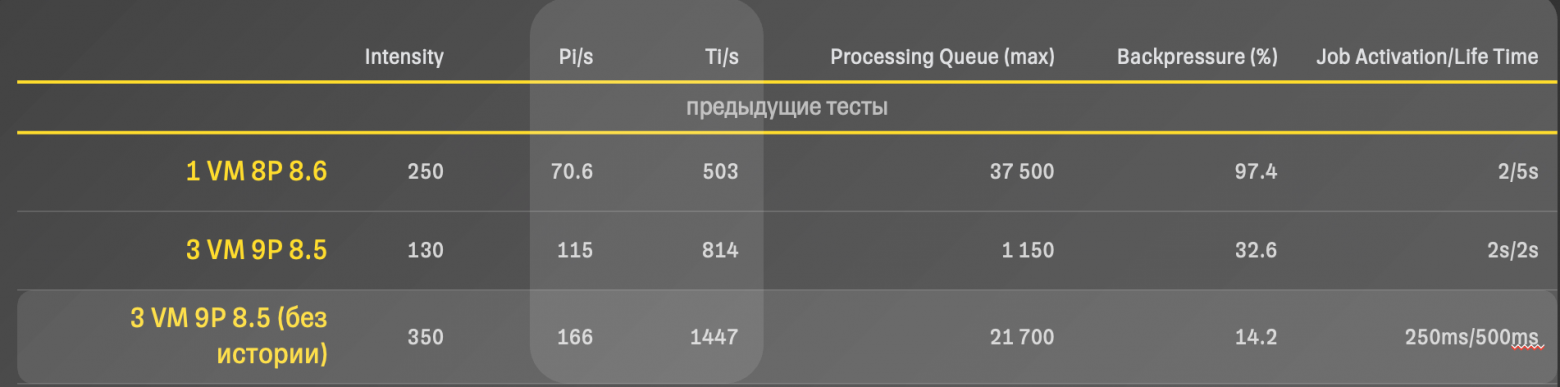
Мы получили результаты почти в 300 процессов и 2 000 задач в секунду, что показывает рост производительности в 2 раза.
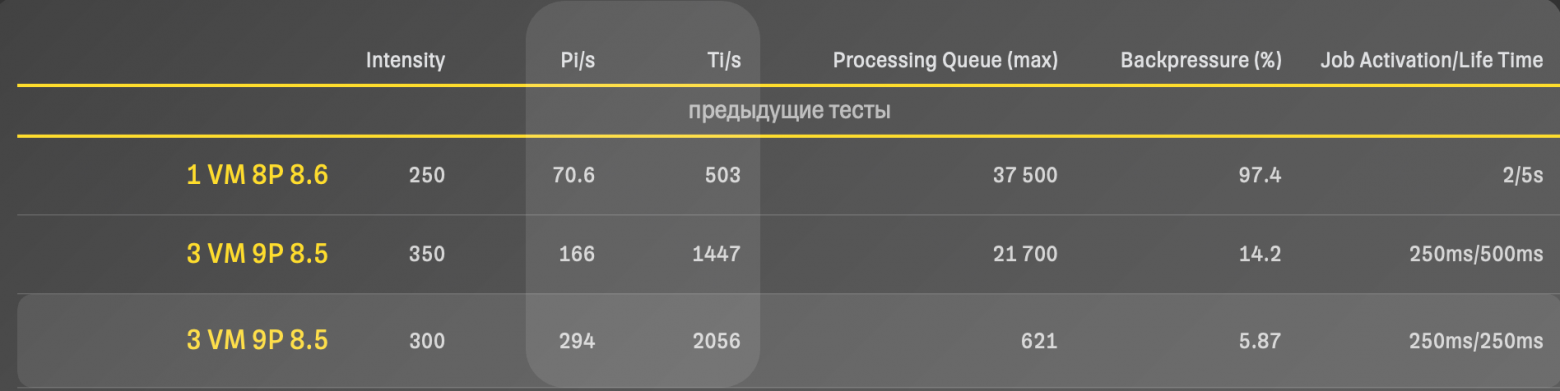
Все дело в настройках брокера, точнее — в количестве доступных CPU‑потоков. Мы упустили ключевой момент: конфигурацию параметров брокера, а именно число потоков CPU, которые он может использовать.
В новой инфраструктуре (3VM) настройки задаются через переменные окружения. И вот тут выяснилось неожиданное: вместо ожидаемых 4 потоков брокер работал всего с одним. Еще отличие — ресурсы JVM, но в этом плане падений не было, снимали heap‑дампы и анализировали флеймграфы.
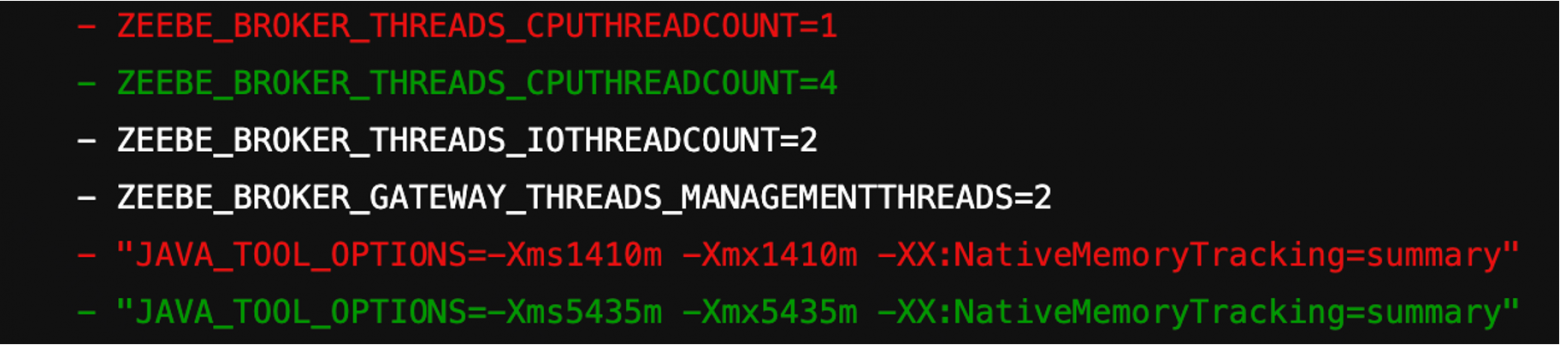
В старой конфигурации (1VM) ресурсы были значительно слабее и дефицит потоков не проявлял себя так остро. Система и так работала в режиме ограниченной мощности, и узкое горлышко осталось незамеченным.
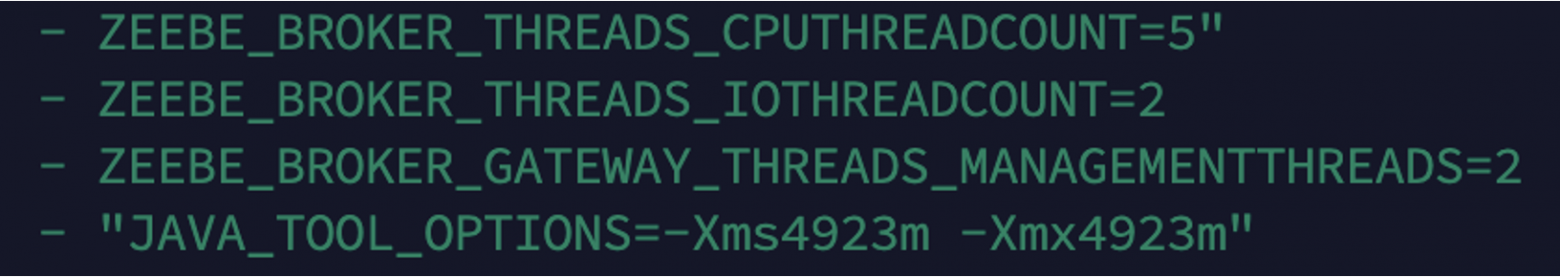
Пока одни потоки ждут ответа от диска (iowait), другие продолжают принимать запросы и заполнять новые MemTables. Это не ускоряет диск, но пропускная способность системы перестает падать в ноль. Брокер способен «переваривать» пик нагрузки, распределяя задачи. Это сглаживает пики и предотвращает ситуацию, когда диск не успевает, а процессор даже не пытается работать.
Кроме этого, мы получили эффективность акторов Zeebe: планировщик стал быстрее распределять задачи между ядрами, уменьшив внутренние очереди в брокере. Тем самым мы ускоряем RocksDB, который получил больше ресурсов для фоновой очистки данных и сериализации, что позволило пропускать больше данных через RAM и диск.
Рекомендация: при низкой утилизации CPU в Zeebe проверять количество рабочих потоков в конфигурации брокера. Неправильное значение может свести на нет все преимущества мощного железа.
Результаты с историей. С включенной историей дела обстоят хуже — она не выгружается. Диски забиваются event‑логами. Первый час нагрузочного тестирования мы видели тот же RPS, как и без истории. Примерно 300 процессов в секунду, но потом движок деградирует по ранее указанным причинам с ресурсами и оптимизацией экспорта и импорта данных.
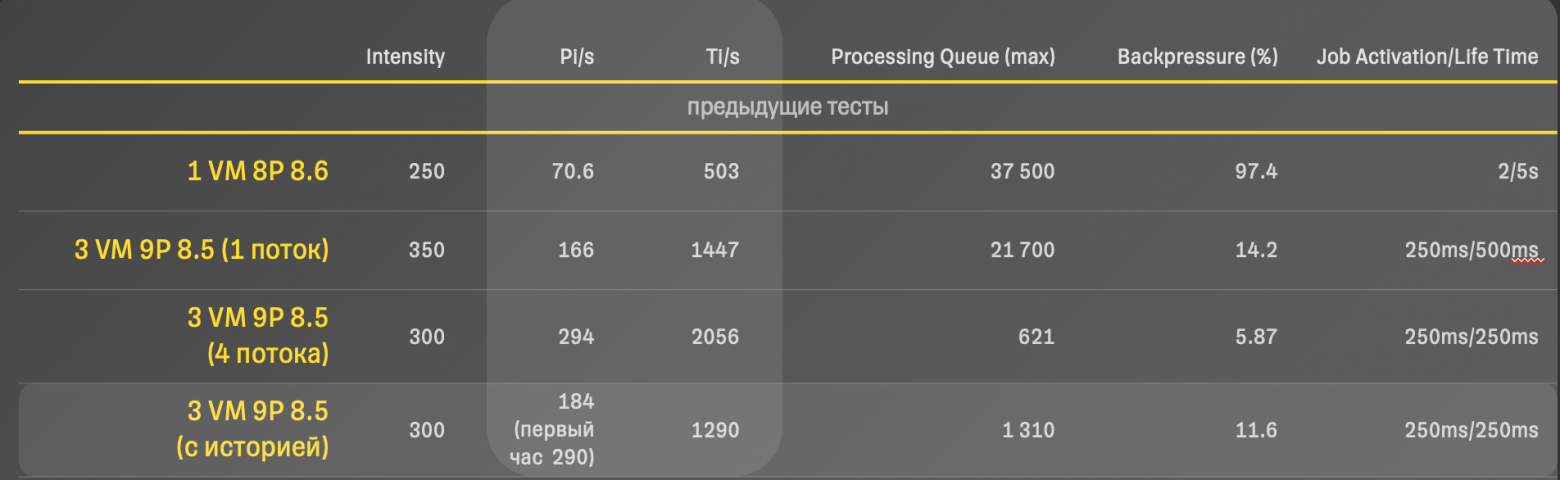
Итоговые результаты нагрузочного тестирования
Зависимость от партиций: увеличение числа партиций напрямую влияет на параллелизм обработки. На определенном этапе прирост стабилизируется — ресурсы работают на пределе и дальше помогает уже не настройка партиций, а масштабирование инфраструктуры.
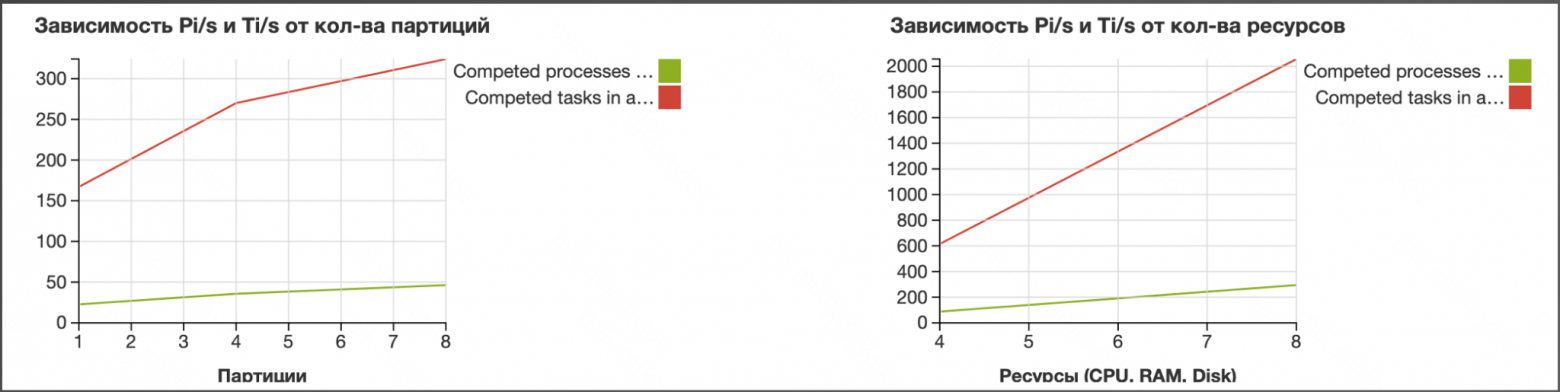
Зависимость от ресурсов: в нашем случае и горизонтальное, и вертикальное масштабирование показало линейный рост производительности. Вертикальное масштабирование — увеличение CPU, RAM на ноде, а горизонтальное — добавление новых нод в кластер. Это означает:
Zeebe эффективно использует дополнительные CPU‑ядра.
Нет явных блокировок между нодами.
Сеть и хранилище справляются с нагрузкой.
Процессы в день. Определим, сколько процессов в среднем за день может обрабатывать движок Zeebe в нашей конфигурации.
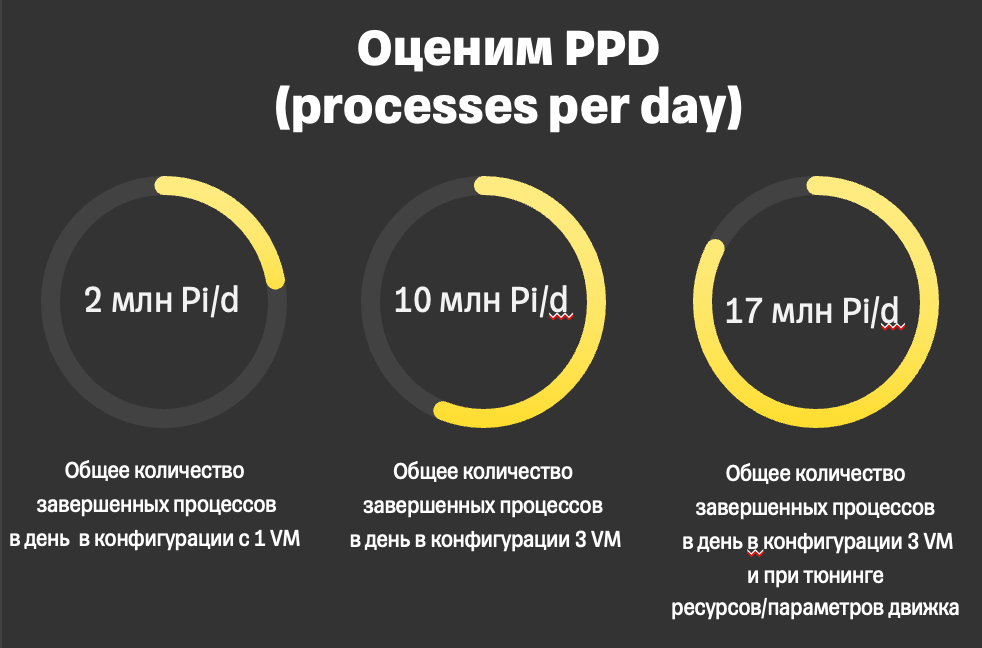
Если брать невысокую нагрузку, то в начальной конфигурации мы можем получить до 2 млн процессов в день, в средней — около 10 млн. Но если взять конфигурацию помощнее и потюнить ресурсы Elasticsearch, можно выжать просто огромные цифры, не теряя при этом показатели качества, надежности и отказоустойчивости системы.
Точки роста Zeebe. Zeebe поддерживает масштабирование на нескольких уровнях: на стороне клиентских сервисов и на уровне самого движка.
На стороне клиента повышение производительности достигается за счет использования асинхронных или реактивных подходов при обработке задач. Это позволяет эффективно управлять нагрузкой, минимизировать блокировки и быстрее освобождать ресурсы движка. Кроме того, сервисы‑воркеры можно масштабировать горизонтально — добавляя экземпляры в зависимости от объема поступающих задач, что особенно важно при пиковых нагрузках.
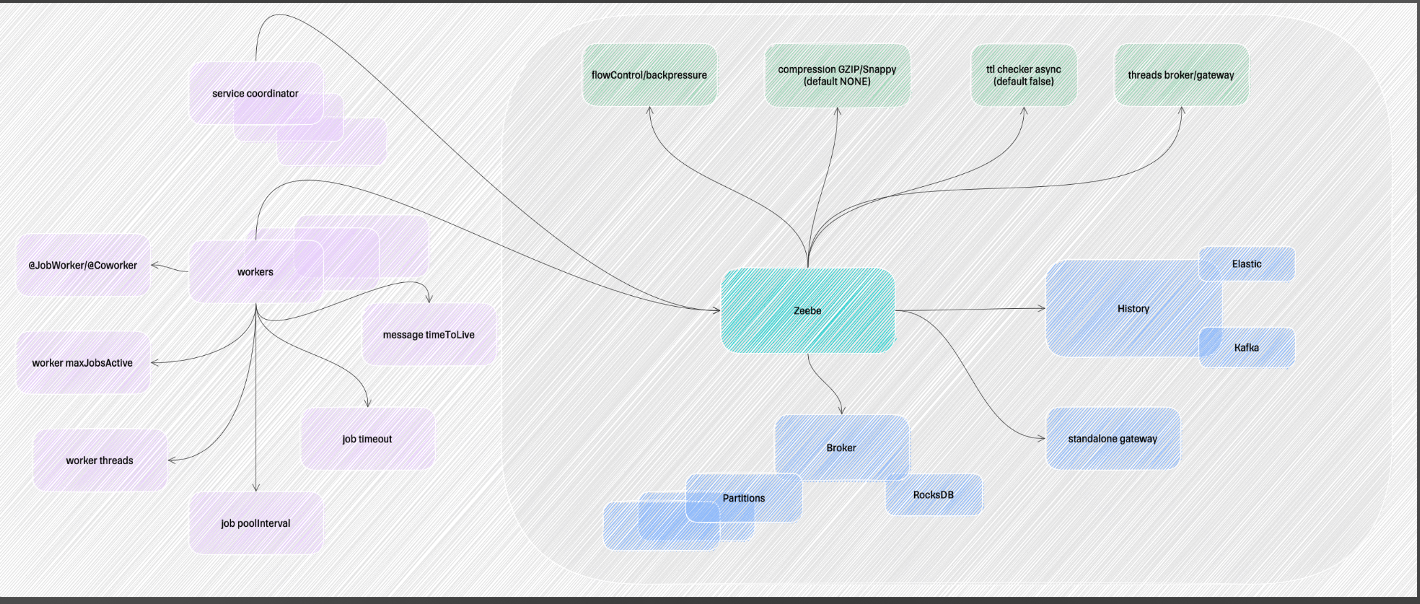
Движок также включает встроенные механизмы защиты от перегрузки: backpressure и flow control, которые помогают поддерживать стабильность при высокой нагрузке. Эти и другие компоненты (включая экспортеры и хранилища истории) формируют гибкую и отказоустойчивую систему, способную адаптироваться к меняющимся условиям.
Заключение
Мы завершили цикл нагрузочных испытаний и поиска узких мест движка Zeebe. Результаты оказались неожиданными и заставили пересмотреть некоторые наши представления о производительности, отказоустойчивости и эксплуатации движка.
Главные выводы:
Производительность зависит не от версии платформы, а от правильности конфигурации.
Механизмы backpressure/flow control защищают экосистему ценой скорости.
Настоящим узким местом оказались настройки брокера и дисковый I/O для RocksDB.
Исправление количества CPU‑потоков дало прирост производительности в два раза, тогда как увеличение размера процесса, бизнес‑логики воркеров и количества переменных снижало ее в десятки раз. Поэтому для стабильной работы критически важно проверять конфигурацию брокера, использовать быстрые диски, декомпозировать процессы и планировать ресурсы кластера с запасом, чтобы избежать отказов и деградации под нагрузкой.
Мы затронули ключевые аспекты внедрения движка: от масштабирования кластера до тонкостей оптимизации экспорта истории в Elasticsearch и дальнейшего отображения ее в Operate. Как показала практика, стабильность системы зависит не только от самого движка, но и от грамотного управления данными и ресурсами хранилища. В качестве рекомендаций оставим компоненты кластера, которые требуют улучшения.
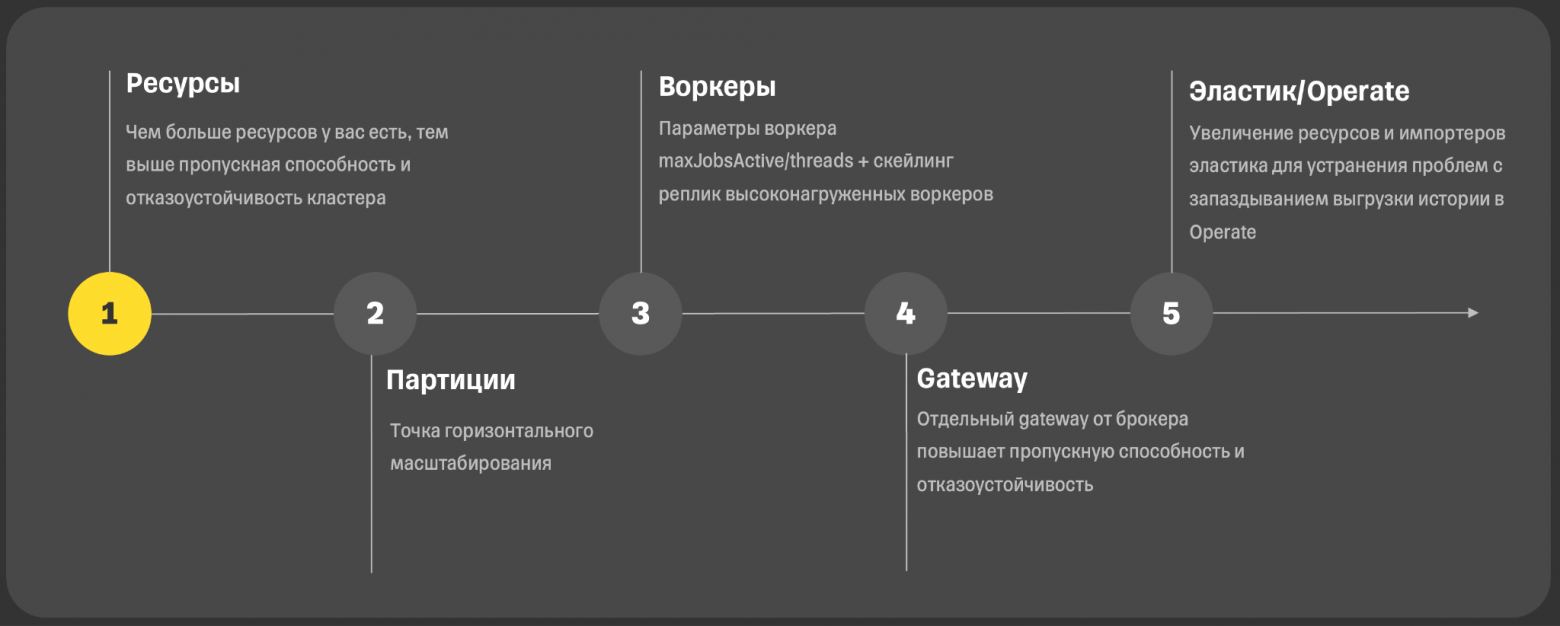
Не рекомендуем начинать с масштабирования инфраструктуры. Лучше сначала оптимизировать воркеры и бизнес‑логику, затем настроить параметры движка и только потом добавлять ресурсы. В противном случае может быстрее прокачаться неоптимальный код.
Будем рады продолжить дискуссию в комментариях! Расскажите, какие версии Camunda используете вы в продакшене? С какими проблемами производительности сталкивались и в каком виде используете платформу — Self‑Managed или SaaS? Ваш опыт поможет нам и другим читателям сократить время на поиск проблем в движке при его эксплуатации.