
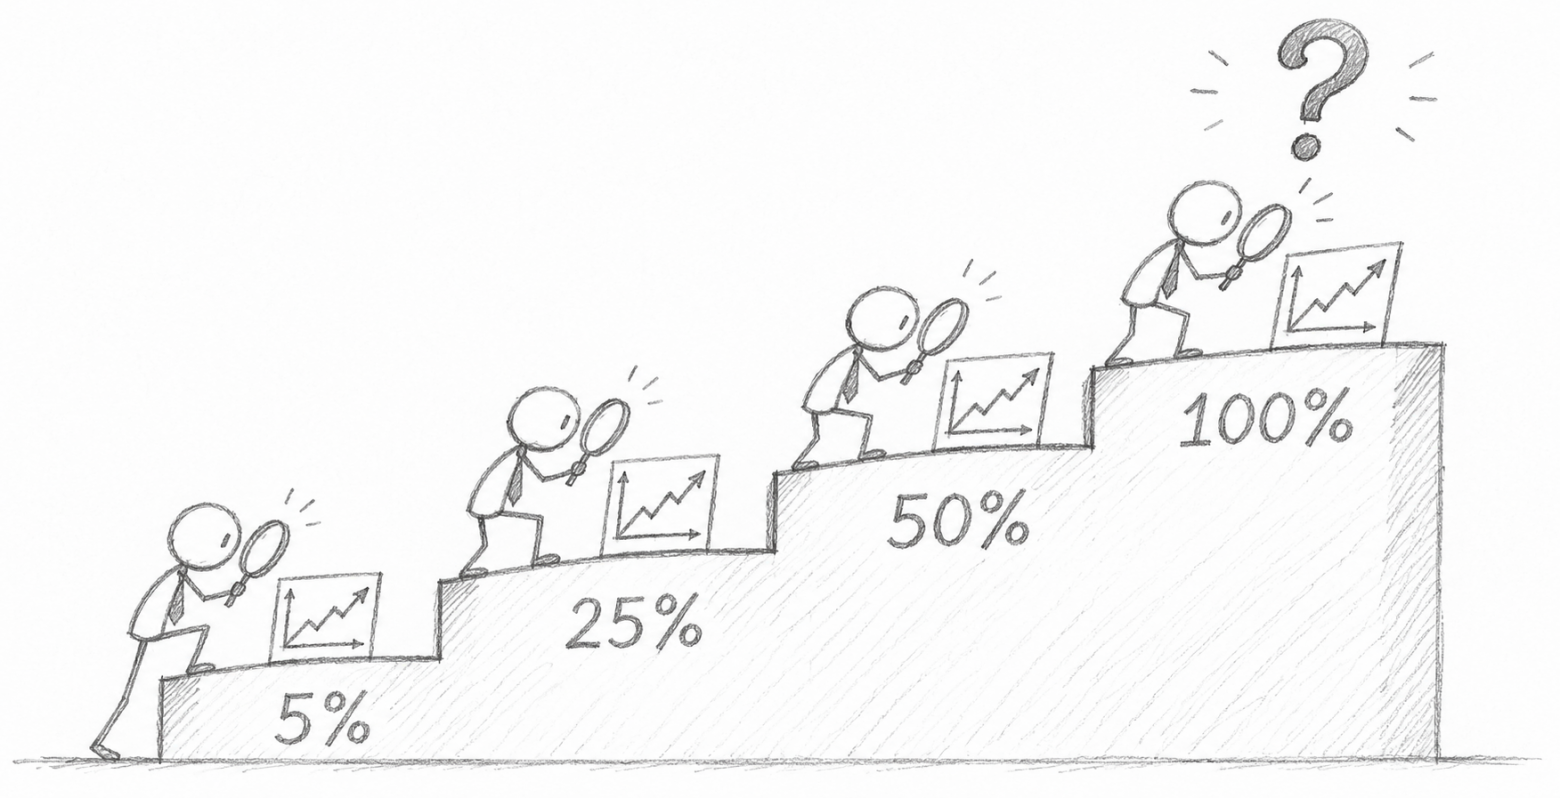
У каждого продуктового аналитика есть знакомый сценарий. Фичу раскатывают лесенкой 5% → 25% → 50% → 100%, на каждой ступеньке смотрят метрики, а на 100% начинается ожидание «прокраса». Сегодня p = 0.07 — «почти, подождём». Через пару дней p = 0.03, но эффект ниже MDE — «подождём, вдруг дорастёт». Ещё через неделю p = 0.04 — «прокрасилось», скриншот в чат.
Каждый шаг здесь выглядит разумно, но вместе они ломают статистику. Ниже разберём, насколько сильно ломают, почему, и какие есть честные способы смотреть в тест часто, даже если заранее неизвестно, сколько раз это придётся делать.
Что на самом деле считает z‑тест
Возьмём метрику со средним в контроле и в тесте
 . После
 пользователей в каждой группе статистика выглядит так:
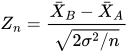
При верной нулевой гипотезе ( )
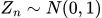 , и правило «отвергаем при
 » ошибается с вероятностью ровно 5%.
Важная оговорка: это верно для одного, выбранного заранее. Если же смотреть на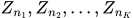 и останавливаться при первом пересечении порога, то ошибка первого рода считается уже по‑другому:
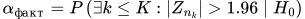
И это число всегда больше 5%.
Насколько больше? Цифры
Если бы взгляды были независимы, ответ был бы простым:
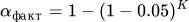
При 10 взглядах это 40%, при 21 — 66%. Но взгляды зависимы: сегодняшние данные — это вчерашние плюс ещё немного. Корреляция между двумя взглядами равна
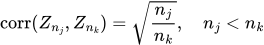
Например, взгляды на 20-й и 21-й день скоррелированы на ~0.98. Поэтому реальная инфляция меньше, чем при независимости, но всё равно большая.
Это можно проверить моделированием на A/A‑тестах, где эффекта нет по построению. Типичная лесенка: 3 дня на 5% трафика, 4 дня на 25%, неделя на 50%, дальше 100%, плановая длительность 3 недели. Каждый день считаем z‑тест и останавливаемся при первом p < 0.05. Повторяем 100 000 раз:
Как смотрим | Ложных «прокрасов» |
|---|---|
Один раз, в конце 3-й недели | 5.1% |
Каждый день, 1 неделя | 19.8% |
Каждый день, 2 недели | 28.1% |
Каждый день, 3 недели | 33.6% |
Каждый день, 6 недель («подождём ещё») | 40.3% |
Вместо 5% ошибок получается каждый третий тест.
Почему так происходит: случайное блуждание
Удобнее всего смотреть не на , а на накопленную сумму
 . При
 её приращения независимы, и в непрерывном пределе
 ведёт себя как броуновское движение
 (тут чуть‑чуть душно, но не переживайте:) ).
Для броуновского движения есть закон повторного логарифма:
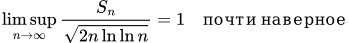
В переводе на язык z‑статистики:
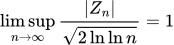
Знаменатель растёт бесконечно, хоть и очень медленно. Значит, рано или поздно пересечёт любой фиксированный порог, в том числе 1.96. Если ждать прокраса без ограничения по времени, вероятность ложного прокраса стремится к 100%.
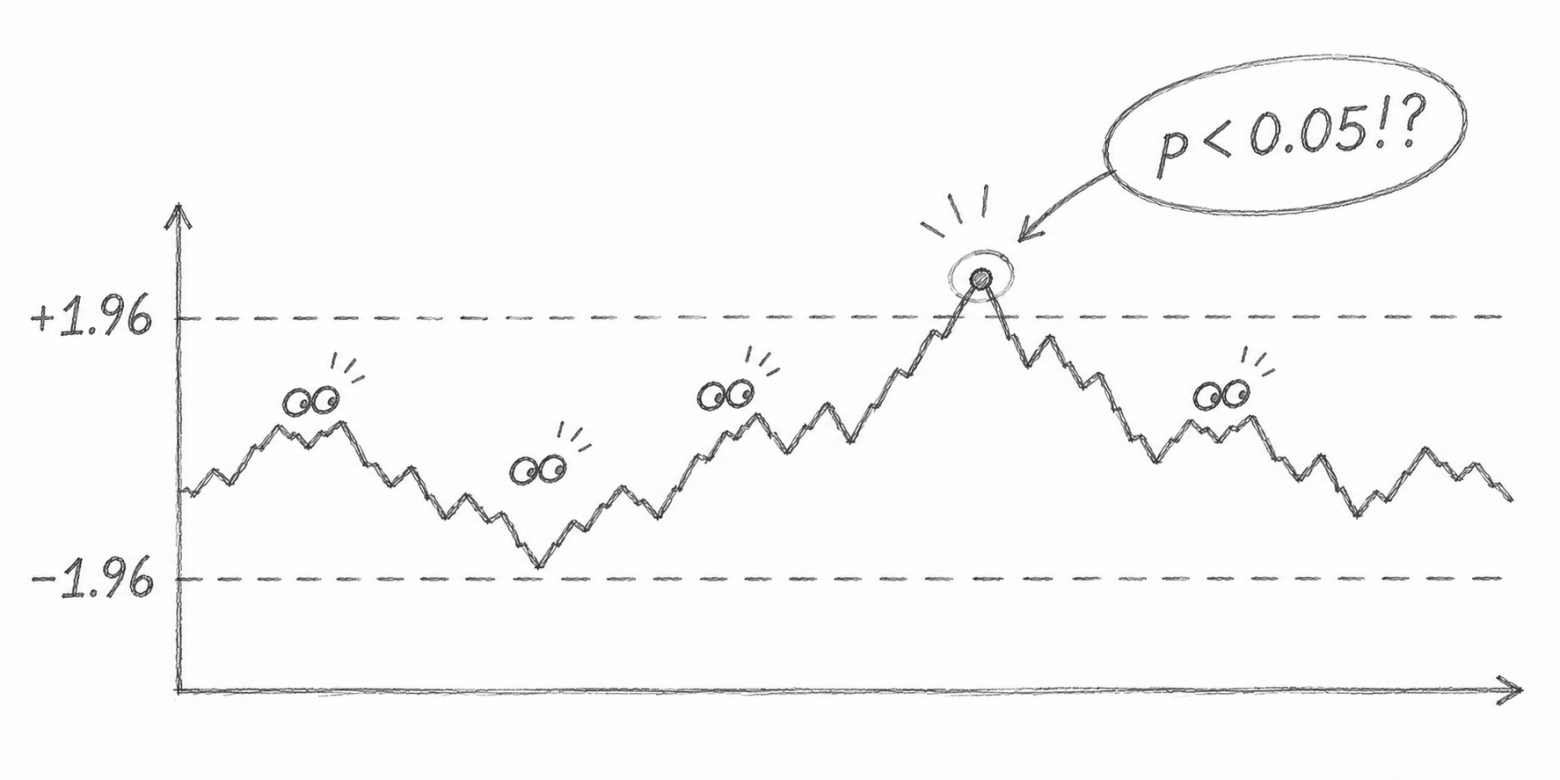
Отдельно про «p = 0.07, подождём»
Этот сценарий стоит разобрать отдельно, потому что он самый частый. Из тех же A/A‑тестов берём те, у которых в конце 3-й недели p оказался между 0.05 и 0.10. Это примерно 5% тестов, классическое «почти». Продлеваем их ещё на 3 недели с ежедневными взглядами.
Прокрашиваются 53.5%.
Объяснение простое. При p = 0.07 статистика уже стоит у самого порога ( ), и случайному блужданию достаточно небольшого толчка. Ожидание не даёт новой информации об эффекте, оно только даёт шуму больше попыток.
С «p низкий, но эффект ниже MDE» та же проблема, только в другой форме. Остановка в момент, когда оценка впервые дотянулась до MDE, отбирает реализации, где шум сдвинул её вверх:
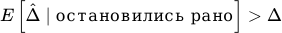
Это проклятие победителя (winner’s curse): эффект, с которым тест «победил», систематически завышен.
‑‑-
Почему нельзя просто «не смотреть»
Классическое решение называется fixed horizon. Заранее считаем выборку под MDE :
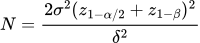
и смотрим один раз. Это корректно, но при поэтапной раскатке неприменимо: лесенка и нужна для того, чтобы смотреть. Если фича на 5% роняет конверсию, об этом надо узнать на 5%.
Значит, нужна процедура, в которой взгляды разрешены, а итоговая ошибка остаётся 5%. Таких подходов три.
Подход 1. Границы O’Brien‑Fleming
Идея: на каждом взгляде используем свой порог
 вместо 1.96, подобранный так, чтобы
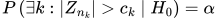
O’Brien и Fleming (1979) предложили такую форму для равноотстоящих взглядов:
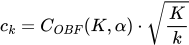
Константа подбирается численно. Для
 ,
 она равна 2.024:
Взгляд | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
Порог | 4.05 | 2.86 | 2.34 | 2.02 |
Номинальный p | 0.00005 | 0.004 | 0.019 | 0.043 |
У этой формы есть интуитивный смысл. Граница по сумме постоянна, а по
 убывает как
 . Ранние взгляды почти ничего не тратят, и на финальном пороге мы теряем совсем мало: 2.02 вместо 1.96. Плата за 4 взгляда — увеличение выборки всего примерно на 2%.
Для раскатки это идеальная форма: на ступеньках 5% и 25% данных мало, и любой «прокрас» там почти наверняка шум.
Почему не Бонферрони?
Бонферрони даёт порог 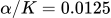 (
 ) на каждом взгляде, включая последний.
Он игнорирует корреляцию и потому сильно консервативен. O’Brien‑Fleming эту корреляцию учитывает.
Ограничение: классические границы требуют заранее знать и моменты взглядов. На практике после раскатки на 100% никто не знает, сколько раз откроет отчёт.
Подход 2. Alpha‑spending: число взглядов знать не нужно
Lan и DeMets (1983) предложили тратить не по номеру взгляда, а по доле накопленной информации.
Информация — это обратная дисперсия оценки эффекта,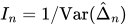 . Для простого теста она пропорциональна числу пользователей. Информационная доля:
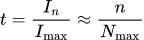
где — выборка под MDE из формулы выше (обычно с запасом 3–5%).
Дальше задаётся функция трат : неубывающая,
 ,
 . Она говорит, сколько ошибки разрешено «израсходовать» к моменту
 . Аналог O’Brien‑Fleming:
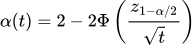
Посмотрим, как она тратит бюджет:
t | 0.1 | 0.25 | 0.5 | 0.75 | 1.0 |
|---|---|---|---|---|---|
| ~0.000000 | 0.0001 | 0.0056 | 0.0236 | 0.05 |

На каждом взгляде порог находится из условия
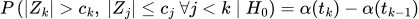
то есть ровно столько, сколько разрешено потратить с прошлого взгляда.
Главное свойство: границы зависят только от фактических , а не от заранее заданного $K$. Можно посмотреть три раза или пятнадцать, можно пропустить неделю. Итоговая ошибка остаётся
 .
Нюанс раскатки: считается по пользователям, а не по дням. День на 5% трафика даёт в 20 раз меньше информации, чем день на 100%. Для типичной лесенки:
День | Ступенька | t | Порог | Номинальный p |
|---|---|---|---|---|
3 | 5% | 0.01 | недостижим | — |
7 | 25% | 0.10 | > 4.4 | < 0.00001 |
14 | 50% → 100% | 0.40 | 3.13 | 0.0018 |
16 | 100% | 0.57 | 2.65 | 0.008 |
18 | 100% | 0.74 | 2.40 | 0.017 |
21 | 100% | 1.00 | 2.14 | 0.032 |
Что показывает моделирование:
ложных прокрасов 5.0% при 10 взглядах (против 33.6% при наивном подходе);
при 4 взглядах границы пересчитываются автоматически (∞; 3.13; 2.44; 2.02), и снова 5.0%;
мощность 77.6% против 80.1% у fixed horizon;
при реальном эффекте тест в среднем останавливается на 18-й день вместо 21-го.
Два‑три процентных пункта мощности — это цена права смотреть сколько угодно раз и в среднем заканчивать раньше.
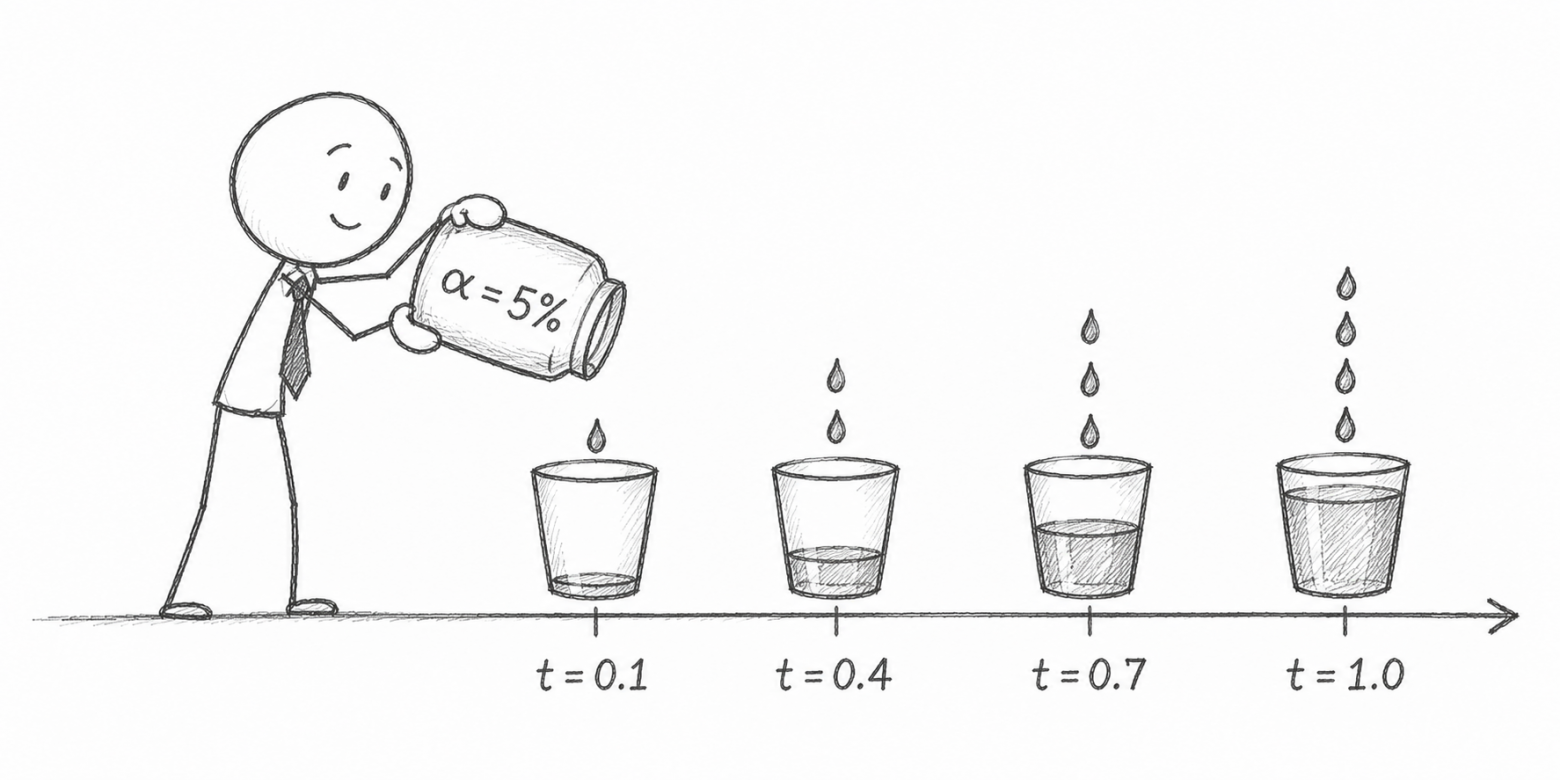
Подход 3. mSPRT: без горизонта вообще
У alpha‑spending есть горизонт: при бюджет закончился. Если эксперимент может длиться неограниченно, нужны методы always valid inference.
mSPRT (mixture Sequential Probability Ratio Test; Robbins, 1970; Johari и соавторы, 2017) сравнивает правдоподобие данных при и при «смеси» альтернатив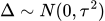 . Для нормальной статистики отношение правдоподобия выписывается явно:
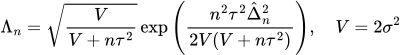
При процесс — мартингал с
 . По неравенству Вилля
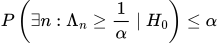
Отсюда always valid p‑value:
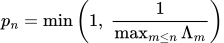
Его можно проверять хоть после каждого пользователя, бесконечно долго, и ошибка останется. Параметр обычно берут порядка MDE.
Цифры моделирования (ежедневные взгляды до 6 недель):
ложных прокрасов 1.8% (метод консервативен, гарантия ≤ 5%);
мощность 48% к 3-й неделе и 96% к 6-й.
За свободу платят длительностью: при той же мощности тест идёт в 1.5–2 раза дольше, чем fixed horizon.
Правило выбора: если можно назвать и дедлайн, берите alpha‑spending. Если нет — mSPRT.
Ступеньки раскатки проверяют не то, что кажется
На ступеньках 5%, 25% и 50% вопрос не «стало ли лучше», а «не стало ли хуже». Это другая гипотеза:
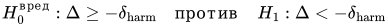
Её проверяют односторонним тестом по защитным (guardrail) метрикам, со своим бюджетом , обычно 0.01–0.02.
Ступенька | Вопрос | Инструмент |
|---|---|---|
5% | Ничего не сломали? | Guardrails, односторонний тест на вред |
25% | Нет ли сильного вреда? | То же + граница OBF по ключевой метрике |
50% | Не стало ли хуже? | То же |
100% | Стало ли лучше? | Alpha‑spending до $N_{\max}$ |
«Катим дальше» означает «вреда не нашли». «Фича победила» — только на 100% и только при пересечении границы.
Ещё одна ловушка — неоднородность ступенек. Пользователи с 5% к концу теста находятся в нём дольше остальных, а ступеньки приходятся на разные дни недели. Если эффект меняется во времени (эффект новизны), простое объединение данных смещает оценку. Помогает стратифицированная оценка по ступенькам $s$:
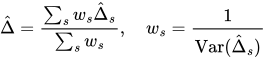
Второй вариант — накапливать информацию для финального теста только с момента, когда доля трафика перестала меняться.
Три вердикта вместо двух
Желание «подождать» во многом рождается из бинарности: «прокрасилось / не прокрасилось». Второй исход воспринимается как провал. Ситуацию заметно упрощают три вердикта по доверительному интервалу для эффекта:
Значимо: граница пересечена и
 . Катим.
Значимо, но ниже MDE: граница пересечена, но
 . Эффект есть, но меньше заложенного. Это полноценный результат, и дальше вопрос к экономике фичи, а не к статистике.
Меньше MDE: выборка
набрана, граница не пересечена, . Эффекта размера MDE нет. Продлевать не нужно.
Короткое правило: p = 0.07 при — это не «почти прокрасилось», а вердикт «меньше MDE».
Чек‑лист, что можно попробовать в своих экспериментах если есть время:)
До старта посчитать
под MDE с запасом 3–5% и зафиксировать функцию трат.На 5–50% проверять guardrails односторонним тестом на вред.
На 100% смотреть сколько угодно, на каждом взгляде пересчитывая
и.При
вынести один из трёх вердиктов.Если горизонта нет, с самого начала использовать mSPRT.
Продлевать тест после
только по заранее записанной процедуре (например, адаптивный пересчёт выборки), а не «потому что почти».После ранней остановки указывать, что оценка эффекта, скорее всего, завышена (или приводить median‑unbiased оценку).
Ограничения
Моменты взглядов не должны выбираться по данным.
«Смотрим каждый вторник» — норм.
«Посмотрим ещё раз, раз вчера было 0.06» формально нарушает гарантии alpha‑spending (mSPRT к этому устойчив).
Метрики‑отношения (средний чек, конверсия на сессию) работают, но
 нужно считать дельта‑методом или линеаризацией.
CUPED совместим: дисперсия падает, информация растёт, и
нужно считать по , а не по числу пользователей.
Много метрик — отдельная проблема. Последовательные методы защищают от многих взглядов, но не от многих метрик. Для этого нужны Holm/Benjamini‑Hochberg или схема «одна ключевая + guardrails».
Код
Границы alpha‑spending для произвольных моментов взглядов, методом Монте‑Карло:
import numpy as np
from scipy.stats import norm

def obf_spending(t, alpha=0.05):
    """Функция трат Lan-DeMets типа O'Brien-Fleming."""
    return 2 - 2 * norm.cdf(norm.ppf(1 - alpha / 2) / np.sqrt(t))

def boundaries_mc(info_fracs, alpha=0.05, n_sim=200_000, seed=0):
    rng = np.random.default_rng(seed)
    t = np.asarray(info_fracs, dtype=float)
    inc = np.diff(np.r_[0, t])
    S = np.cumsum(rng.standard_normal((n_sim, len(t))) * np.sqrt(inc), axis=1)
    Z = np.abs(S / np.sqrt(t))
    alive, spent, bounds = np.ones(n_sim, bool), 0.0, []
    for k in range(len(t)):
        need = int(round((obf_spending(t[k], alpha) - spent) * n_sim))
        z_alive = np.sort(Z[alive, k])[::-1]
        c = np.inf if need <= 0 else z_alive[min(need, len(z_alive)) - 1]
        hit = np.zeros(n_sim, bool)
        hit[alive] = Z[alive, k] >= c
        spent += hit.mean()
        alive &= ~hit
        bounds.append(c)
    return np.array(bounds)

print(boundaries_mc([0.10, 0.40, 0.66, 1.0]))  # примерно [inf, 3.13, 2.44, 2.02]
Для боевого использования лучше точный расчёт через рекурсивное интегрирование: gsDesign или rpact в R.
Итого
Ежедневное подглядывание с порогом 0.05 превращает 5% ошибки в 30–40%. Если ждать без ограничения, ошибка стремится к 100% (закон повторного логарифма).
«Подождём, пока прокрасится» при p ≈ 0.07 даёт ложный прокрас в половине A/A‑тестов.
Если N‑max известен, а число взглядов нет, подходит alpha‑spending Lan‑DeMets с функцией O’Brien‑Fleming: ошибка 5%, потеря мощности 2–3 п.п.
Если горизонта нет, подходит mSPRT: смотреть можно всегда, плата — длительность.
Ступеньки раскатки ищут вред, победу фиксирует только 100%.
Три вердикта вместо двух убирают главный мотив ждать.
А как в вашей команде решают, когда останавливать тест?
Ждёте прокраса, фиксируете длительность или уже используете последовательные тесты? Интересно почитать в комментариях, особенно про то, как это объясняют продактам.
Литература: O’Brien & Fleming (1979), Biometrics; Lan & DeMets (1983), Biometrika; Jennison & Turnbull, «Group Sequential Methods with Applications to Clinical Trials» (2000); Robbins (1970), «Statistical methods related to the law of the iterated logarithm»; Johari, Pekelis, Walsh, «Always Valid Inference» (arXiv:1512.04922); Howard et al., «Time‑uniform confidence sequences» (arXiv:1810.08240).

