
В последние джва года все как ужаленные бросились реализовывать свои пет-проекты при помощи ЛЛМ. В конце концов бросился и я сам.
Общие слова
Stackette — это экспериментальная процессорная архитектура. Основной идеей эксперимента является удешевление вычислений на стеке, что само по себе не новость. Только, в отличие от традиционных Forth-процессоров типа GreenArrays GA144 или J1, моя архитектура более ориентирована на поддержку «традиционных» языков типа C или Pascal. Это роднит Stackette с представителями старших поколений стековых (стеково-аккумуляторных) машин типа Burroughs B6500 или HP 3000 (из более современных — Tandem/16).
Подробно об архитектуре можно почитать в документах в репозитории, я же попробую обосновать основные архитектурные решения.
Набор команд (ISA)
Большинство современных ISA существуют в квадранте между двумя парами полярных парадигм:
Ортогональность против специализированности
Ортогональный набор команд означает, что любая команда может адресовать все операнды любыми способами. Максимальной популярности такой подход достиг вместе с VAX, а потом распространился и на RISC-архитектуры. Он упрощает как программирование на ассемблере, так и разработку компиляторов ЯВУ.
Специализированные регистры и форматы команд с неявными операндами, с другой стороны, помогают сэкономить на сложности декодера и длине инструкций, исключив из кодирования редко используемые сочетания операндов и способов адресации. Это имеет значение не только для 8-битных ретро-архитектур (MOS 6502), но и для современных гарвардских машин с произвольным размером инструкции (многие DSP).
Memory-to-Memory против Load/Store
Возможность произвольно адресовать данные в памяти значительно сокращает количество инструкций, необходимых для реализации одного и того же алгоритма, по сравнению с архитектурами типа Load/Store, чем снижает потребление памяти, а также упрощает ручное ассемблирование и компиляторы. Архитектуры, допускающие не более одного обращения к памяти на команду, с другой стороны, лучше поддаются конвейеризации.
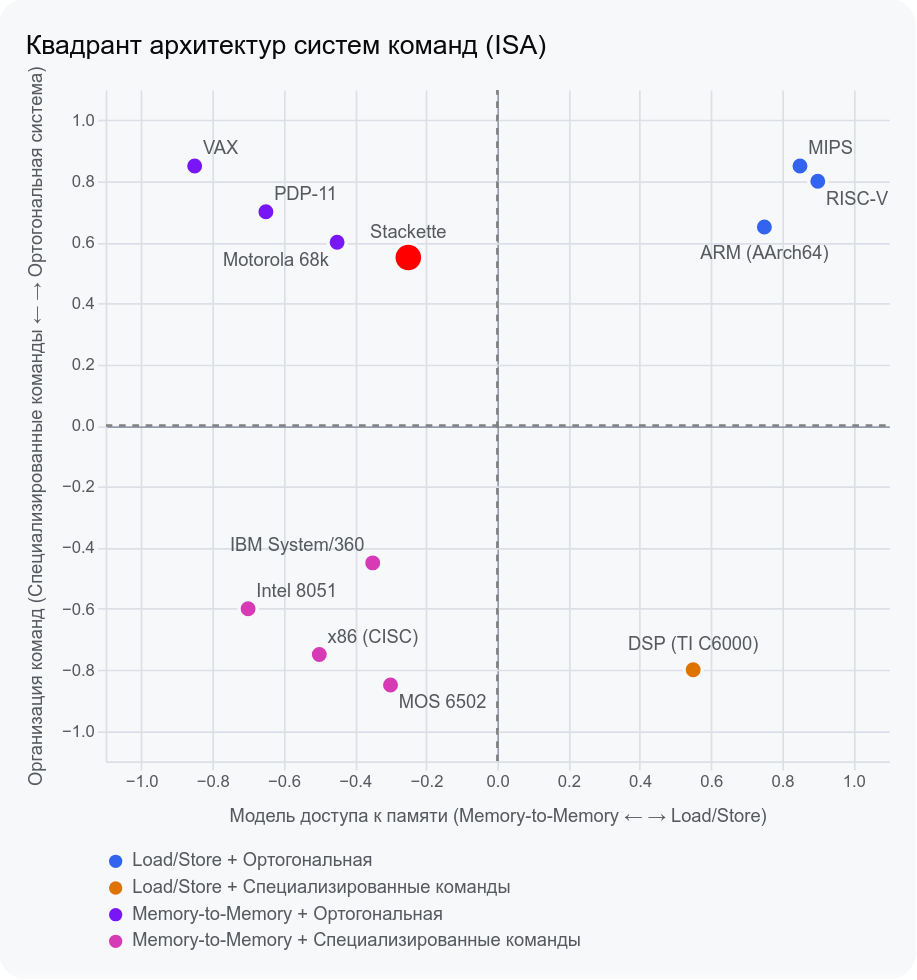
Gemini изобразили мне Stackette в окружении различных исторических и актуальных архитектур согласно моему описанию. Мне кажется, получилось довольно верно.
все двух-трёхадресные команды имеют один и тот же формат: стековый приёмник и произвольный источник данных (кроме
ST, которая имеет тот же формат кодирования, только меняет направление движения данных на противоположное). Поэтому систему команд можно считать достаточно ортогональной, несмотря на использование специализированных регистров,двух-трёхадресные команды “память → стек” выглядят как два или три обращения к памяти, но благодаря кешированию верхушки стека они в большинстве случаев сводятся к одному обращению к памяти. Для меня это выглядит как оптимальная стратегия. Я бы даже сдвинул красную точку вправо до нуля, но лень было спорить с Gemini.
Стековый фрейм, функции, ABI
Stackette имеет два аппаратно управляемых стека: стек вызовов и стек параметров. Стеки растут сверху вниз.
Стек вызовов хранит пары слов: (адрес возврата из функции, адрес фрейма). Этот стек изменяется только при выполнении инструкций CALL и RET, иного доступа к нему у программиста нет.
Стек параметров лучше всего представлять в таком виде:
| A || B | ← PFP| C || D | ← PSPx E x
A и B — параметры вызова функции, C и D — локальные переменные, E — мусор.
Перед вызовом вызывающая функция добавляет параметры A и B в стек. Инструкция CALL сохраняет указатель следующей команды (IP + 2..6) и указатель фрейма (PFP) в стеке вызова и копирует указатель стека параметров в указатель фрейма.
Соглашение по очистке стека — важная часть ABI. Существует два вида соглашения по очистке стека:
Очистка вызывающей стороной (caller cleanup). Достоинство такого подхода: легко поддерживать функции с переменным числом аргументов: функция «знает», сколько параметров было передано. Недостаток: каждый вызов функции сопровождается одинаковым кодом очистки, что зря расходует память,
Очистка вызываемой стороной (callee cleanup) происходит один раз, в вызываемой функции. Зато очистить стек от произвольного количества параметров становится очень сложно, а то и невозможно, если в распоряжении только инструкция
RET n.
Stackette имеет две команды возврата:
традиционная
RET nперед тем, как восстановить IP и PFP, уменьшает PSP на n слов,RET [PFP]делает то же самое, только вычитается не фиксированное количество слов, а последний параметр вызова. Предполагается, что именно в этом слове-счётчике хранится количество переданных аргументов (включая сам счётчик).
Стек служит для передачи не только параметров, но и для возврата данных. Поэтому в обоих случаях (что RET n, что RET [PFP]) необходимо корректировать число очищаемых слов. В теории это несложно сделать с обоих сторон: компилятор же знает сигнатуру функции. На самом деле исторический софт на C не соблюдает соглашения о вызовах так, как хотелось бы:
вариадические функции переобъявляются как функции без параметров,
результат объявляется, но не возвращается.
Благо, исправить каждый такой случай на уровне исходного кода несложно, и на переносимость программы это не повлияет.
Память, MMU
Stackette имеет 16-битные адреса (многие FPGA-девборды имеют 16-битную память и периферию), и использование какого-то вида расширения адреса просто напрашивалось. Мне не хотелось засорять программную модель процессора вариантами адресов разной битности и инструкций для их использования, как это сделали Intel в x86. MMU же как отдельное внешнее устройство даёт много побочных эффектов. Мне снова захотелось найти золотую середину.
В конце концов я выбрал простую схему с четырьмя старшими битами адреса, выбирающими один из регистров расширения адреса. Если сделать эти регистры 16-битными, то в нашем распоряжении оказывается транслятор 16-битных виртуальных адресов в 28-битные реальные. 256 МБайт адресного пространства, разбитые на четырёхкилобайтные страницы. Неплохо.
Развивая эту идею, я расширил виртуальное адресное пространство за счёт выделения разных типов обращения к памяти, как это было сделано в Z8000 или MC68000. Я назвал это «пространствами» памяти (memory spaces):
пространство кода,
пространство данных (адресуется косвенно,
LD [ADDR], или индексно,LD [MBP+MIDX]),пространство стека параметров,
пространство стека вызовов.
Каждое пространство имеет свои 16 регистров расширения адреса. На самом деле для стека вызовов 64 килобайта — это слишком. В реальности и пары страниц должно хватить за глаза.
Вообще говоря, любой настоящий (адресующий содержимое только относительно движущихся указателей) стек потенциально бесконечен. Ничто не мешает при переполнении указателей свопнуть дно стека на диск, подставить чистые страницы к верхушке, и скорректировать указатели. К сожалению, реальные программы на C активно этому препятствуют, передавая указатели на объекты в стеке между функциями. Если возврат указателя на такой объект — это довольно типичная ошибка новичка, то передача его в вызываемую функцию — вполне легитимное действие. Чтобы поддержать этот паттерн, мне даже пришлось добавить инструкцию LEA, аналогичную её x86-тёзке, и режим адресации, аналогичный фортовскому @ (fetch). Хотя и прерывание по переполнению стека параметров я тоже со временем добавлю.
Режимы выполнения кода
Регистры MMU, архитектурные регистры процессора (кроме TOS и NOS) и некотрые флаги состояния, недоступные программисту, образуют контекст исполнения. Для того, чтобы добавить привилегированный (системный) режим, мне пришлось удвоить контекст.
Процессор стартует в системном режиме. Для процессора по умолчанию доступен контекст пользовательского режима (отображённый в пространство данных, как и вся периферия) и собственное MMU. Настроив пользовательский процесс, системный код выполняет инструкцию IRET. Она переключает режим исполнения, сохранив при этом в системном контексте адрес следующей за IRET инструкцией.
Управление переходит к этой инструкции после:
незамаскированного аппаратного прерывания,
исключения в пользовательской программе (неверная инструкция, обращение к пустому адресу и т. д.),
системного вызова (команды
TRAP n).
Для простоты реализации системный режим не может быть прерван. По достижению IRET управление переходит или к следующей инструкции (для обработки накопившихся прерываний), или к прерванной инструкции пользовательского режима.
Единственное исключение из этого порядка — это исключение (невольный каламбур) в системном режиме. Тогда выполнение переходит к первой инструкции системного режима (“Soft Reset”). Это невосстановимая ситуация, в отличие от исключений пользовательского режима. Остаётся разве что отобразить postmortem-информацию.
Инструкции типа HALT нет. Вместо этого процессор тратит такты в дефолтном пользовательском процессе. Иначе следующее прерывание не будет вызвано.
Что реализовано
SoC на FPGA (пока проверялась только на Terasic DE0-Nano). В состав SoC входят: процессор, контроллер набортной памяти SDRAM (32 МБайта), контроллер ROM (SPI Flash 1 МБайт в корпусе DIP-8, снятая с мёртвой материнки), UART. Язык реализации — Amaranth HDL (да, Python). Конфигурация немаленькая, около 10000 LUT, но, во-первых, это примерно вровень с реализацией 80286 на MiSTer, во-вторых, почти 3000 LUT занимают регистры MMU. Если сделать MMU синхронным, то эти регистры перенесутся в BRAM, и LUTы освободятся, но добавится 1 такт задержки на каждое обращение к памяти,
нейрослоп-порт компилятора ACK (только C и ассемблер),
нейрослоп-порт Minix 2.0.4 (пока что очень минимальная система, чисто на поржать). Микроядерная ОС очень подходит под системный режим «бей и беги», а Minix 2 была портирована на 286 (я её даже запускал когда-то), так что выбор был очевиден.
Планы
добавить поддержку виртуальной памяти в общем виде, как бит Present в регистрах MMU, а также битов Read-Only (CoW) и Dirty. С другой стороны, бесконечный стек тоже нужно добить,
добавить в SoC поддержку сетевого адаптера (ENC28J60), SD-карты в SPI-режиме, возможно, часов реального времени и ещё чего-нибудь из закромов,
self-hosted ACK,
работать над портом Minix, как минимум добавить поддержку сети.
Благодарю за внимание!

