
У сайта есть страница обслуживания, а cron и воркеры продолжают работать по своим правилам. Поэтому перед переносом на новый выделенный сервер пригодился бы список всех писателей, включая импорт по расписанию: закрытый сайт сам по себе их не остановит. Даже после отключения расписания запущенный импорт придётся дождаться либо остановить отдельно. Со взятой задачей воркера похожая история, только там ещё надо знать, как приложение обрабатывает повтор. Разбирать судьбу этой задачи уже в конце переезда поздновато.
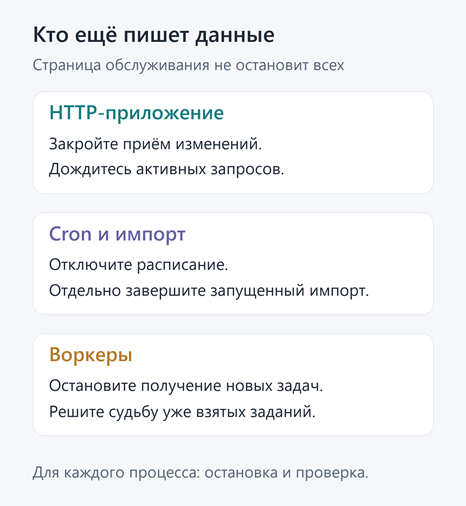
Кто продолжает писать
В каждой строке такого списка нужны процесс, способ остановки и проверка, что он закончил работу. Заодно надо договориться о допустимом простое и потере данных. RTO задаёт время восстановления сервиса, RPO обозначает момент, до которого должны восстановиться данные. Пример с ночной копией и вечерним переключением сразу показывает цену вопроса: без переноса последующих изменений данные между этими моментами в новую копию не попадут.
Если подтверждённые данные терять нельзя, финальную копию снимают из состояния, в которое уже никто не пишет.
Проверить копию до окна
Копию до окна надо восстановить в отдельной среде. Письма, платежи и вебхуки там отключить. Помимо времени восстановления, полезно было бы проверить роли и расширения базы, UID/GID, владельцев файлов, точки монтирования и исходящие подключения приложения. Версии стека лучше пока оставить прежними: смену версии PostgreSQL удобнее разбирать отдельной задачей. А перед сетевыми правками пригодятся проверенные SSH и консоль провайдера. Потерянный доступ сам по себе в план миграции обычно не входит.
Загрузки можно дослать вторым проходом после остановки записи. Для PostgreSQL способ выбирается по её документации резервирования: обычное копирование живого каталога базы не даёт согласованной копии. В описанном там двухпроходном варианте rsync сервер базы останавливают перед финальным проходом с проверкой сумм. Перед rsync ‑delete нужен ‑dry‑run и взгляд на направление. Лишние файлы удаляются у получателя; перепутать его с источником неприятно.
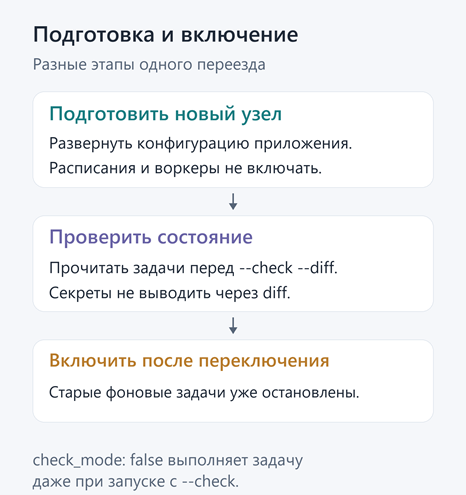
Где заканчивается подготовка Ansible
Для подготовки нового узла подходит playbook. А вот включение расписаний и воркеров разумнее вынести из подготовки: новая копия не должна выполнять задания одновременно со старой. Для предварительного просмотра используется такой запуск:
ansible-playbook -i inventory.yml prepare.yml --check --diff
В описании check mode есть неприятная для беглого чтения оговорка: check_mode: false заставляет задачу работать в обычном режиме даже с ‑check. Так что задачи лучше прочитать до запуска. У задач с секретами diff выключается, иначе содержимое конфига может попасть в вывод. Модуль без поддержки check mode этот запуск не проверит. Перед открытием записи пригодился бы отдельный шаг с проверкой состояния: не сошлось, значит, сначала надо разобраться с причиной. Продолжать перенос из непонятного состояния плохая идея.
Новый узел под прежним именем
Новый узел можно открыть под прежним именем до смены DNS:
curl --silent --show-error --fail-with-body --connect-timeout 5 --max-time 15 \
--resolve app.example.com:443:203.0.113.20 \
--write-out '\nHTTP %{http_code}\n' \
https://app.example.com/health/ready
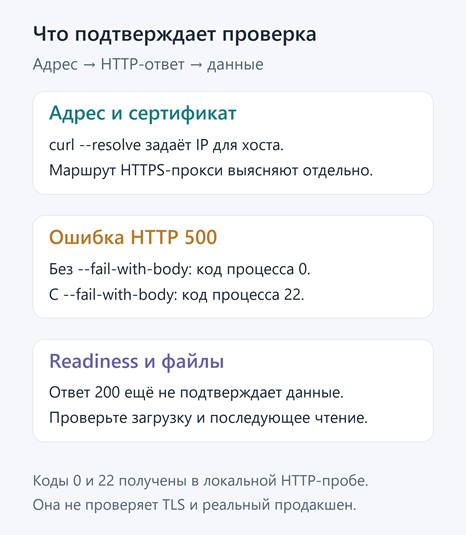
Адрес и путь здесь учебные. curl с --resolve обращается к указанному IP для пары хост/порт, проверяя сертификат; при HTTPS‑прокси маршрут надо выяснить отдельно. Для --fail-with-body нужен curl 7.76.0 или новее. Флаг добавлен после локальной пробы: на ответ HTTP 500 curl без него вернул код процесса 0, с ним код 22. Саму проверку HTTPS эта проба не затрагивала. Readiness всё равно стоит разобрать: ответ 200 от живого процесса ещё ничего не говорит о документах в хранилище. Для них нужна загрузка с последующим чтением, до переезда в тестовой среде, после переключения на контролируемых данных.
Лист для окна обслуживания
На само окно удобнее оставить семь пунктов. К каждому нужны исполнитель и проверка, которые уже отрепетированы на этом сервисе:
· Остановить приём изменений, старые расписания и воркеры.
· Дождаться активных операций, определить судьбу оставшихся задач.
· Завершить перенос базы и файлов, сверить результат.
· Закрыть запись в старое хранилище через все прежние входы.
· Переключить вход; проверить запись и чтение на новом узле.
· Включить новые фоновые задачи после остановки старых.
· При возврате сохранить изменения, принятые после переключения.
Что остаётся на старом узле
У DNS есть свой срок подготовки. TTL уменьшают заранее и ждут истечения прежнего значения: уже заполненные кэши от смены записи не очистятся. На старом адресе поэтому нужен согласованный вход либо обслуживание. У nginx перед применением конфига проверяется синтаксис, а после reload старые worker‑процессы могут ещё держать соединения. В списке писателей стоит оставить место и для этих запросов.
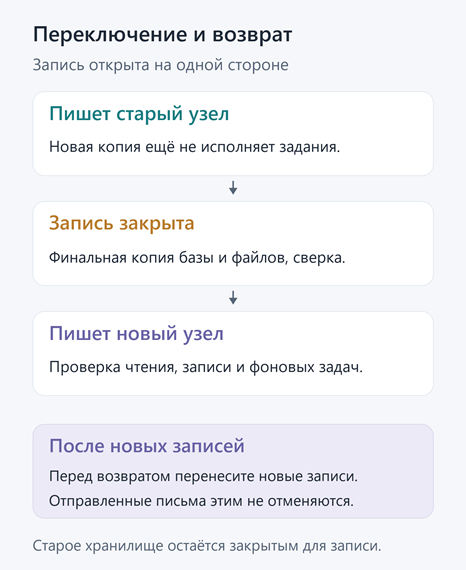
Вернуть старое приложение к актуальной базе иногда можно, если схема совместима.
Вернуть старую базу после новых записей без переноса изменений нельзя: в ней этих записей ещё нет.
Для обратного переноса опять придётся закрыть запись и проверить данные; уже отправленное письмо этим не отменяется.
Когда выключать старый сервер
Старый сервер пока лучше оставить на согласованный срок наблюдения, но с закрытой записью в прежнее хранилище. До его выключения нужны новая резервная копия и результат ближайшей важной фоновой задачи. Иначе проверка переезда закончится раньше, чем сервис выполнит свою обычную работу.

