


Привет, Хабр!
Меня зовут Александр Ершов, в Атоме я отвечаю за направление данных. В этой статье расскажу, как мы с командой строили дата-платформу с нуля: какую архитектуру выбрали и почему остановились именно на этом стеке.
Если попытаться сформулировать определение что такое дата-платформа, то будет выглядеть так. Дата-платформа - это комплекс технологий, который объединяет разрозненные данные компании, обеспечивает их качество и делает их доступными для анализа. Она помогает бизнесу отслеживать ключевые показатели, находить причины их изменений и принимать решения на основе данных.
Стек, на котором все работает: Flink, Spark, Airflow, S3(managed), Iceberg, Paimon, Nessie, ClickHouse(managed), PostgreSQL(managed), FastAPI, OPA/OPAL, OpenMetadata, Trino. Инфраструктура живет в Яндекс Облаке, поэтому часть решений — managed. Сервисы в K8s, используем Terraform/Terragrunt, частично Ansible, Helm чарты, k8s операторы для Flink и Vault.
Какие задачи стояли
В декабре 2023 года, когда я пришел в компанию, единого центрального хранилища не было, данные хранились в экселях или не собирались вовсе, но потребность в этом была и стояла задача построить аналитическое хранилище данных, которое сможет закрыть несколько задач:
· Историческое хранение — хранить данные долго и надежно
· Аналитический слой — предоставить возможность бизнесу и аналитикам считать бизнес метрики и строить дашборды
· Интеграционный слой (коннекторы) — забирать данные из множества разнородных систем-источников
· Удобные способы взаимодействия с хранилищем — получение данных из платформы по api/kafka
· RBAC — гранулярный доступ к данным на основе ролей (и желательно чтобы маскирование было)
С этих требований и начались первые шаги по проектированию. Основной проблемой на старте было отсутствие требований по нагрузке: мы попросту не знали, какие объемы нас ждут. Поэтому приходилось эмулировать нагрузку на синтетических данных и отталкиваться от нее. Платформа строилась в том числе для возможности получения телеметрии с машин.
Какие данные обрабатываем
Главная сложность была в том, что данные у нас очень разнородные по своей природе (и все надо обрабатывать). Платформа должна переваривать:
· потоковые события с автомобилей и от внутренних систем-источников
· данные из реляционных баз (PostgreSQL, MySQL и не только) — через CDC и батчевые выгрузки
· полуструктурированные и неструктурированные файлы — все, что не ложится ровно в таблицы
Этот зоопарк форматов и способов доставки во многом и определил архитектуру.
Архитектура
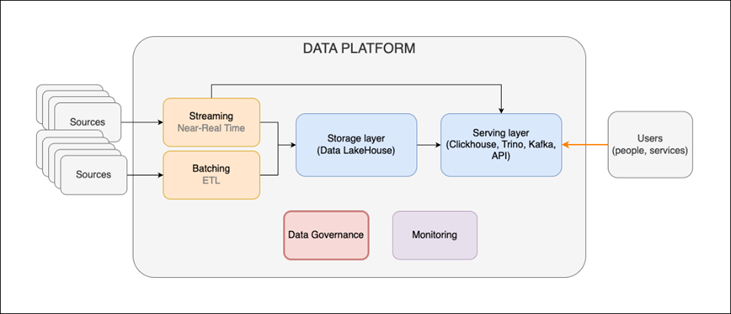
Продумывая архитектуру, мы сошлись на Lambda подходе, который сочетает два пути обработки: прием данных в режиме, близком к реальному времени (стриминг) и батч-загрузку. Телеметрия и события прилетают потоком и нужны быстро это стриминговая ветка. А все остальные данные, которые грузятся по расписанию — это батч.
Доступ к данным мы заложили сразу в нескольких форматах: дашборды для бизнеса, REST API для сервисов и SQL для тех, кто умеет писать запросы руками.
На самом верхнем уровне платформа выглядит так: источники → развилка на стриминг и батч → хранение → слой отдачи данных → потребители. Поверх всего этого — два сквозных контура: Data Governance (управление данными) и Monitoring (логи и мониторинг).
Хранение (Data LakeHouse)
Ядро исторической части — Data LakeHouse на S3 с табличным форматом Apache Iceberg и Apache Paimon и каталогом Nessie. Классическая многослойная модель:
· Raw — сырые данные как есть, источник правды. При этом логический Raw слой делится на два физических слоя хранения:
o Raw — слой хранения сырых неструктурированных и полуструктурированных данных (json, pdf, jpg, mp3, xls и так далее)
o Raw-iceberg — слой хранения данных из реляционных баз данных в формате iceberg или paimon
· Enterprise Data — очищенные, согласованные данные, унифицированная модель компании, в формате iceberg
· Data Marts — бизнес-витрины под конкретные задачи или команды
Физически структура хранения выглядит так: бакет с делением на raw слой и dm слой (и уровнями хранения внутри каждого), а также бакет iceberg и paimon с делением на raw, edm и dm объекты. Для хранения данных в Iceberg/paimon-слоях применяется паттерн CATALOG.SCHEMA.TABLE_NAME
Для батч и стриминговой загрузки мы используем разные табличные форматы. В батч ветке данные из баз источников записываем в Iceberg и после каждой загрузки запускаем compact для объединения мелких файлов в более крупные. При потоковой записи в Iceberg у нас накапливалось много мелких файлов. Для выполнения compact процедуры приходилось бы останавливать flink джобу, что не хорошо для непрерывной записи. Поэтому в стриминговой ветке мы перешли на Paimon, который позволяет делать compact в фоновом режиме и не мешает постоянной загрузке.
Стриминг (NRT Layer)
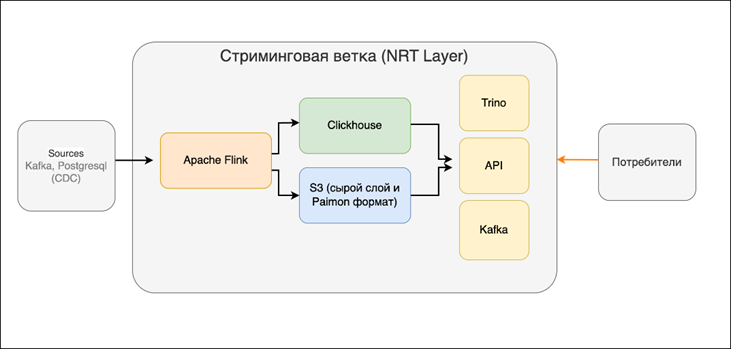
Потоковую обработку делает Apache Flink: джобы читают данные из Kafka и из БД (Flink CDC) и считают пользовательские витрины в ClickHouse в режиме near-real-time, а также сохраняют данные в S3 для долгосрочного хранения (в сыром или Paimon формате). Оформлены джобы как jar-файлы, оркестрируются через Flink k8s Operator, деплоятся с помощью своего Helm чарта через ArgoCD и GitLab CI/CD. Язык Java.
Отдельно для хранения телеметрии планировали использовать Cassandra, затем Scylla, но пока что эти решения остались как MVP и не вошли в текущую архитектуру, ввиду отсутствия большой нагрузки.
Принцип, который мы заложили в стриминг: обработка должна быть максимально простой и не упираться в производительность. Здесь допустимы легкая фильтрация и оконные обработки, но без тяжелой логики (возможно пока что).
Что касается наблюдаемости, у нас созданы дашборды в Grafana и также мы пошли по пути создания flink-admin панели, где можно управлять flink джобами через единое окно доступа. Сейчас готова MVP версия решения с продуманным планом развития.
Батч (Batch Layer)
Загрузку данных по расписанию делаем с помощью Python или Apache Spark, оркестрация — Apache Airflow. Spark обрабатывает и перекладывает данные через слои LakeHouse — от raw до dm и на финальном этапе данные реплицирует в ClickHouse, где они становятся доступны для аналитики, дашбордов и API.
На батч загрузку у нас приходится сейчас 80% объема всех загружаемых данных.
Слой отдачи (Serving Layer)
Финальный слой, где потребители забирают данные и проводят анализ:
· для дашбордов и API приложений — прямой доступ к базам ClickHouse или PostgreSQL
· для SQL аналитики — доступ к данным через Trino с помощью DBeaver, к Trino у нас подключен каталог Nessie, а также базы (ClickHouse и PostgreSQL)
· для разработки и DS команды - Jupyter с доступом к данным
Отдельный витринный слой в ClickHouse появился из-за ограничения используемого BI инструмента, на момент внедрения он не поддерживал подключение к Trino. Позже такой коннектор появился.
Контроль доступа (RBAC)
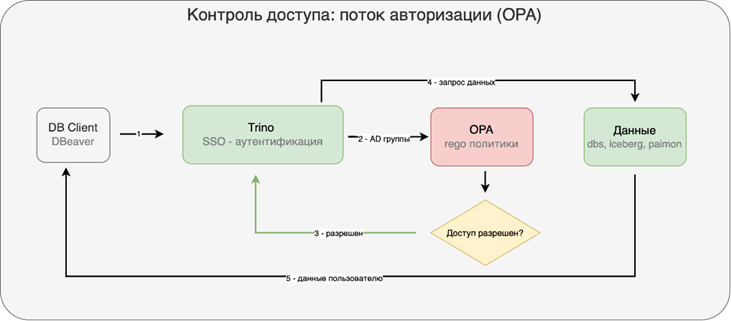
Доступ выдается на схему, объект, поля, строки и регулируется с помощью OPA (Open Policy Agent). Пользователь настраивает подключение к Trino в DBeaver, проходит аутентификацию по SSO, дальше в OPA отправляется запрос со списком AD групп пользователя. OPA сверяется с rego политиками: если доступ разрешен — пользователь видит данные, если нет — получает ошибку «доступ запрещен». Схематично на картинке ниже.
По умолчанию OPA хранит политики в репозитории и любое изменение доступа эта правка кода, поэтому мы внедрили OPAL, с помощью которого изменяемые политики лежат в базе данных. Для работы с политиками создали API для изменения/получения/добавления доступов и написали UI для работы с API. Теперь сотрудник с соответствующими правами может быстро изменить доступ к данным.
Доступ к Jupyter регулируется на уровне AD групп и в настоящий момент сервис доступен только на dev среде.
API не проходят через OPA и доступ выдается через сервисные токены для команд.
В части контроля за доступом к данным мы собираем все обращения к объектам, а также удачные и неудачные попытки входа. Отправляем их в топик Kafka и далее сохраняем в S3. На базе этих данных уже строим аналитику по используемости объектов платформы и считаем продуктовые метрики посещаемости (в тч к API).
Data Governance
Для целей сбора метаданных из систем источников и дата платформы, а также фиксации владельцев данных, разметки чувствительных данных и построения линеджа движения данных используем OpenMetadata.
На текущий момент, к каталогу подключены 90% всех баз в компании. Каждая база отнесена к домену данных, у многих определен владелец и ответственный сотрудник. Данные размечены по категориям чувствительности (K1–K4) и имеют описания полей, что позволяет быстро находить нужные данные в системе.
Сбор метаданных происходит автоматически по расписанию самой OpenMetadata, построение линеджа мы реализовали сами.
Для унификации реализации как в стриминге, так и в батче, мы разработали собственный сервис OMD Registerer. Он работает с API OpenMetadata, принимает на вход JSON от Flink или Spark-джобы, создает маппинг источника и таргета на каждом шаге. В результате мы получаем линедж на уровне объектов и полей объекта. Таким образом, любой маппинг аналитика единообразно проходит путь регистрации в OpenMetadata.
Data Quality - ближайшие планы
Следующий наш шаг — внедрение Data Quality во все пайплайны: технические проверки ETL (нет ли дубликатов и потерянных данных, корректны ли преобразования при переносе по слоям) и бизнес-проверки качества данных, которые деплоятся и запускаются автоматически по расписанию.
Monitoring
Про мониторинг здесь много писать не буду, отмечу ключевое:
для управления сущностями мониторинга используется Victoria Metrics Operator
локальный VM-кластер хранит метрики за несколько дней, поверх него работает AlertManager
алармы из AlertManager отправляются в три места: центральный AlertManager, центральная Grafana OnCall и канал команды дата платформы
все дашборды — в Grafana
Что получилось в итоге
Мы объединили в одной платформе батч и стриминг, историческое хранение, несколько способов доступа к данным через SQL, API и BI инструменты. Для доступа через Trino настроили разграничение прав, а для поиска данных и отслеживания их происхождения — каталог метаданных и линедж.
При этом мы прекрасно понимаем, что дата-платформа — это продукт, который живет и развивается вместе с компанией. Впереди еще много вызовов:
внедрение Data Quality во все пайплайны: ближайший приоритет, чтобы проверки качества стали стандартом для каждого потока данных
развитие flink-admin панели: из MVP в полноценное единое окно управления потоковыми джобами
развитие self-service: команды уже могут строить дашборды и анализировать данные самостоятельно, но есть планы по дополнительной автоматизации
мультиклаудность: использование нескольких облаков для большей надежности дата платформы

