Обновить
64K+

Data Engineering *

Обсуждаем вопросы сбора и подготовки данных

76,43
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как ML‑модели ломаются в продакшене и что с этим делать

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели6.3K

В Jupyter Notebook модель показывает отличный ROC‑AUC, а через пару недель в продакшене её предсказания становятся хуже случайного выбора. Причина может скрываться в признаке, который при обучении и инференсе рассчитывается по‑разному, или в изменившемся поведении пользователей.

Разбираемся, как Data Drift, Concept Drift и ошибки в работе с признаками влияют на качество моделей и какие практики ML System Design помогают избежать подобных проблем.

Разобраться в MLOps

Новости

Алгоритмы и программирование без привязки к языку программирования

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели7.4K

Хабр, привет! Давай начнём с самого начала, а именно:

Если вам непонятно почему одни пишут программы так словно говорят с компьютером на одном языке, а у других токены от AI агентов заканчиваются уже к обеду. То я, скорее всего, смогу вам ответить, а так же рассказать много интересного по теме программирования. Наука это всё-таки или искусство.

Читать далее

«Донащупывая» Data Lineage

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели8.7K

Добрый день, Хабр! В рамках основной деятельности — проектирования витрин данных в корпоративных хранилищах, — неизбежно сталкиваюсь с вопросом происхождения данных. Проще говоря, необходимо понять, кто и когда, как, из чего и в чьих интересах собрал попавшийся под руку датасет. Обновляется ли срез данных и есть ли у него пользователи? Для такого процесса в мире DWH давно укоренилось название «построить Data Lineage». Предлагаю вместе со мной еще раз пройтись по определению и попробовать его уточнить, так сказать, донащупать.

Читать далее

Builder ELT — open‑source инструмент для построения потоков данных

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели8.1K

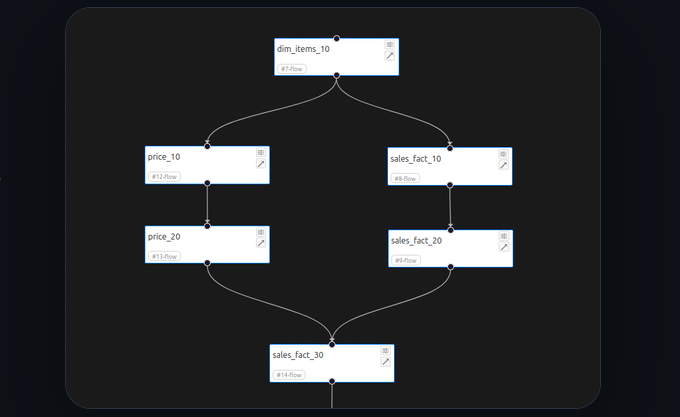
Builder ELT — open-source ELT-приложение, которое позволяет визуально создавать потоки загрузки, объединять их в цепочки и запускать по расписанию. Преобразования выполняются средствами целевой базы данных на нативном SQL, а Python используется для работы с нестандартными источниками и API. Приложение не хранит в себе пользовательские данные. Основная цель создать стандартизированное решение, в котором можно было бы быстро создать ELT поток, не теряя гибкость SQL трансформаций. В итоге любой аналитик знающий SQL может загрузить себе данные.

Откуда это все и зачем.

Примерно в начале 2026 года, работая инженером аналитиком на проекте, я написал питон код для стандартизации ELT процессов. В нем обычная дельта/фулл выборка и запись в журнал.

Процесс загрузки данных повторяется на каждом проекте, а каждый ELT разработчик пишет код по своему. Хотелось стандартизировать хотя бы реперные точки, уменьшить время разработки и кол-во ошибок. Конечно любая стандартизация это постановка в рамки и уменьшение гибкости. Но здесь сработало правило 20/80. В добавок аналитики как правило зависели от специалистов ELT и ждали новые данные.

Сначала был написан пул питон функций и использовалось в виде локального питон-пакета. Далее для удобства был прикручен GUI и база данных для хранения метаданных. Получилось приложение, в котором можно было подключаться к источнику/приемнику, создавать поток и планировать запуск. Получилось что-то с чем можно было уже работать. Далее для возможности создавать очередь потоков был прикручен celery и redis. Ну и на сладкое провайдер авторизации keycloak.

Читать далее

Насколько сильно Random State влияет на качество ML-модели? Проверяем на 100 экспериментах

Время на прочтение11 мин
Охват и читатели7.9K

Представим ситуацию: мы обучили модель, получили Accuracy 77% и решили немного изменить параметры. Запустили обучение повторно — теперь получилось 72%.

Читать далее

Может ли плохая модель победить хорошую? Как Data Leakage обманывает метрики

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели8.6K

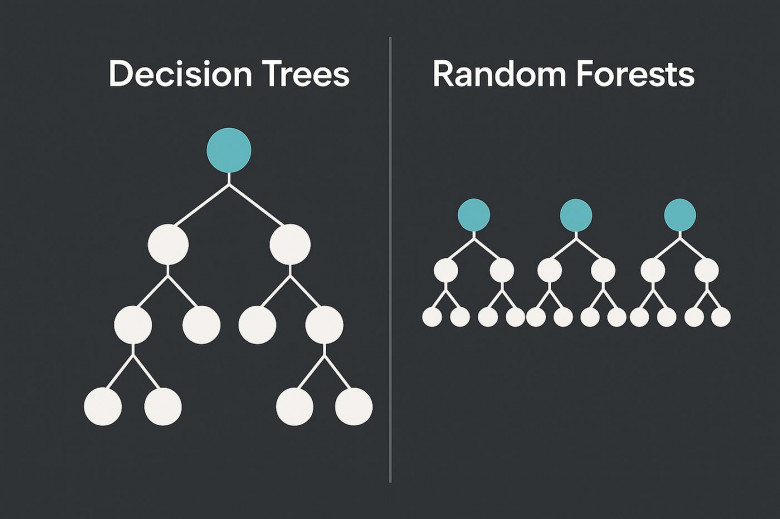
Представим обычную ситуацию: мы обучили несколько моделей, сравнили их на тестовой выборке и получили довольно странный результат. Простейшее дерево решений показывает Accuracy почти 97%, а Random Forest из 300 деревьев — всего 91,5%.

Читать далее

Движки таблиц ClickHouse

Уровень сложностиПростой
Время на прочтение20 мин
Охват и читатели5.8K

Система баз данных ClickHouse предоставляет изобилие разнообразных движков таблиц, из которых, однако, зачастую на практике разработчиками используется только ограниченный набор. Многие редко используемые движки, однако, предоставляют очень полезные и даже уникальные функциональные возможности, оптимизированы под использование в специфических ситуациях, и при правильном использовании способны существенно ускорить не только выполнение некоторых конкретных запросов, но и работу всей базы данных.

Привет! Я Дмитрий, Data Engineer в ИТ-компании SimbirSoft. В этой статье я постараюсь кратко описать основные категории существующих движков системы ClickHouse, особенности использования движков, а в конце дам несколько рекомендаций для их практического использования. Думаю, материал будет полезен больше джунам, однако и опытным специалистам, работающим с другими базами данных, будет интересно узнать про движки, которыми они еще не пользовались. Поэтому перед рассмотрением самих движков начну с небольшой вводной части.

Читать далее

После JOIN сумма выросла: как детализация ломает BI‑витрину

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели4.9K

Отчёт обновился без ошибок. Количество заказов совпало с источником. А сумма оказалась выше, чем до добавления товарных позиций. Можно начать искать дубли в загрузке, но сначала стоит проверить сам JOIN: иногда он совершенно правильно соединяет строки, которые нельзя суммировать вместе.

Разберём небольшой учебный пример: три заказа, их позиции и оплаты. Покажу, почему COUNT(DISTINCT) может скрыть проблему, SUM(DISTINCT) — испортить результат, а предварительная агрегация — исправить расчёт только при правильно выбранной детализации. SQL‑примеры проверены в SQLite; это разбор логики данных, без привязки к конкретной BI‑системе.

Разобрать пример

Как мы сделали классификатор металлопроката на 15+ млн SKU

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели5.6K

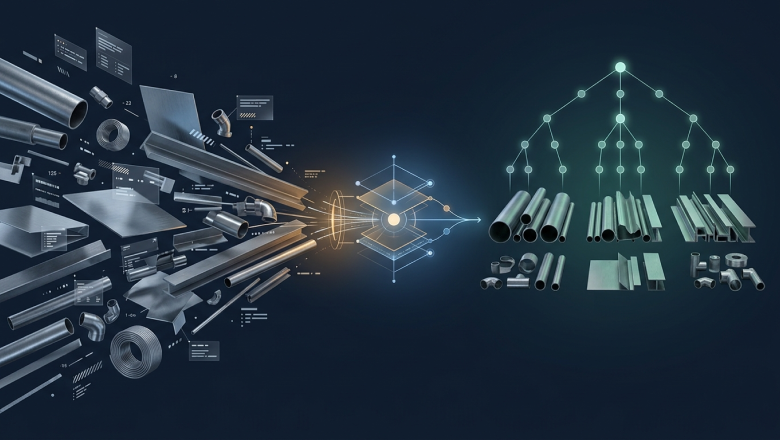
Можно ли разложить 15+ млн хаотичных товаров по 1100 категориям за месяц? Да – без зубодробительного ML и миллионных затрат на LLM-инференс!

В статье о том, как:

1. ML проиграл системе простых бизнес-правил;

2. мы присвоили артикулы товарам для целой отрасли;

3. заставить работать даже самые зашумлённые данные из CRM.

Читать далее

Оркестратор Apache Airflow: что это и как используется в BI и DWH

Время на прочтение10 мин
Охват и читатели7.7K

В статье разбираем, как устроен Apache Airflow 3, для каких задач он используется, какую роль играет в архитектуре DWH и BI, и когда его стоит выбирать для оркестрации процессов обработки данных. Сравниваем с Prefect и Dagster.

Читать далее

Как мы сократили поток событий в 600 раз с помощью FlinkSQL

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели6.5K

Привет! Меня зовут Сергей Прокопкин, я развиваю мотивационную программу и отвечаю за realtime-систему трекинга заданий в Авито. 

В мотивационной программе у каждого пользователя может быть свой набор заданий: купить товар, добавить что-то в избранное, забронировать услугу или выполнить последовательность действий. За выполнение пользователь получает награду — бонусы, промокоды, внутреннюю валюту, участие в розыгрышах и так далее.

На первый взгляд техническая задача выглядит довольно просто: получаем действия пользователя, проверяем их на соответствие активным заданиям и обновляем прогресс. Но когда поток событий становится большим, а число заданий и аудитория растут, простая схема начинает дорого обходиться. В нашем случае выяснилось, что более 99% обрабатываемых событий вообще не влияли на прогресс пользователей.

Расскажу, как мы вынесли фильтрацию из основной системы, почему выбрали FlinkSQL, как решали проблему актуального состояния пользователя и обогащения событий — и как в итоге в 600 раз сократили поток событий, доходящий до основной системы.

Читать далее

Как реализовать контракты данных для работы с объектами

Время на прочтение15 мин
Охват и читатели8.4K

Привет, Хаброжители! Мы подготовили для вас новый перевод статьи о контрактах данных. Здесь рассмотрены контракты данных на основе объектов, реализованные на базе CDC. Рассказано, каково определение контракта, как он выполняется, и как для него предписывается схема.

Читать далее

Мы перестали смотреть на дашборды расходов и добавили стоимость прямо в интерфейс Databricks

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели8.1K

А что если вместо дашборда по затратам Databricks добавить их прямо в интерфейс. С этой идеи начался наш мини проект, который решал сначала нашу локальную проблему, а теперь доступен для всех.

Читать далее

Ближайшие события

Мои парсеры не сломались. Они тихо возвращали пустоту

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели9K

Два парсера курсов месяцами возвращали пустоту. Ни ошибки, ни строчки в логе. Про то, что отсутствие данных — режим отказа по умолчанию, и про CI, который парсит и валидирует за меня.

Читать далее

Как использовать Neo4j в data engineering проекте: практический пример с Kafka, ClickHouse и Airflow

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели7.3K

Когда говорят о Neo4j, чаще всего вспоминают social networks, fraud detection, recommendation systems или knowledge graphs.

Но графовая база может быть полезна и внутри обычного data engineering проекта, где уже есть Kafka, аналитическая база, dbt, Airflow и BI.

Мне было интересно проверить именно этот сценарий.

Читать далее

Когда логи кричат, а ты не слышишь: как я приводил логи в порядок в ETL‑коннекторе

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели10K

Первые подводные камни логирования: практика на примере Python‑коннектора в Airflow — цифры до/после, спорные кейсы уровней, карта логов как контракт.

Погрузиться в логирование

Одно имя метрики, разные эксперименты: почему состав выборки надо хешировать

Время на прочтение3 мин
Охват и читатели5K

Рядом с метрикой принято хранить версию модели и версию данных, но этого мало. Правило отбора объектов в оценку расходится двумя способами: список идентификаторов устаревает, а условие с порогом даёт разный ответ в разные дни без всяких правок. У меня список из 39 исключений за год совпал с реальностью на девять позиций из тридцати девяти, а состав выборки сменился сам собой за одни сутки. Разбираю, что именно записывать рядом с метрикой, почему хешировать надо фактический состав, а не текст правила, и чего такой отпечаток не решает.

Читать далее

Бакеты вместо миллионов строк: как мы ускоряем рассчёты A/B-тестов без потери точности

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели7.9K

Представьте, что у вас одновременно запущено несколько десятков экспериментов. В каждом миллионы пользователей и несколько метрик с ежедневным пересчётом. У нас как раз такой кейс, поэтому ещё при проектировании платформы мы подумали, что считать метрики на уровне пользователей будет слишком дорого и медленно…

Решили попробовать через бакетирование. Все пользователи в рамках одного эксперимента разбиваются на 256 бакетов, поэтому статистика считается уже по бакетам. В результате вычислительная сложность и объём хранимых данных сокращаются на порядки. Вместо миллионов строк мы работаем всего с 512, поскольку для двух групп нужно обработать по 256 бакетов.

Но сразу возникает вопрос: а не теряется ли при этом статистическая корректность? Ведь нам важно оценивать эффект именно на пользователя, а не на бакет, работать со всеми типами метрик, включая ratio, и поддерживать всевозможные сплиты. Кроме того, мы хотим применять CUPED, который снижает дисперсию через исторические данные, но ещё сильнее усложняет расчёты.

Читать далее

Открываем код YTsaurus Flow: как обрабатывать более 100 ГБ/с в реальном времени без потерь и дублей

Время на прочтение15 мин
Охват и читатели20K

Если вы когда‑либо строили пайплайны для обработки потоков данных в реальном времени со строгими требованиями, то наверняка знаете, сколько инфраструктурных заморочек в этом деле. Например, обеспечивать относительно низкие end‑to‑end‑задержки в штатном режиме относительно несложно. Но что, если они нужны и в высоких перцентилях, в том числе при сбоях или плановом обслуживании одного из используемых дата‑центров целиком? Как правильно партиционировать поток данных, обрабатывающие его процессы и их долгосрочное состояние, если нагрузка постоянно меняется? Как гарантировать exactly‑once, то есть отсутствие потерь и дублей даже при сбоях оборудования и в краевых случаях? Как понять, обработали ли мы все данные на тот или иной момент? 

С такими вопросами мы столкнулись при разработке высоконагруженных рекомендательных систем. Для этих задач мы создали YTsaurus Flow — фреймворк потоковой обработки данных с сохранением состояния между событиями и гарантиями exactly‑once по умолчанию. Это совместный проект команд Yandex Infrastructure и Яндекс Рекламы для обработки потоков данных в реальном времени. И сегодня мы открываем его исходный код под лицензией Apache® 2.0.

Flow — часть YTsaurus, платформы хранения и обработки данных, которую мы выложили на GitHub в марте 2023 года. Flow использует хранилище, очереди и общий механизм транзакций платформы, чтобы брать на себя управление состоянием и восстановление обработки после сбоев. Разработчик пайплайна при этом сосредоточивается на прикладной логике.

В статье разберём, зачем мы разработали собственный движок, как устроены его пайплайны и за счёт чего обеспечивается exactly‑once. А на примере реального сервиса покажем, как переход на Flow помог сократить задержку поставки данных для дообучения моделей с десятка‑другого часов примерно до двух.

Читать далее

DVT — новый open source ETL (Low-Code и не только)

Время на прочтение5 мин
Охват и читатели5.6K

Привет! На связи Сергей Скирдин, технический директор ИТ-интегратора «Белый код». Я достаточно много занимаюсь интеграциями, хранилищами данных и BI, поэтому, когда ребята из «Денвик Аналитика» предложили познакомиться с новым инструментом DVT, не стал отказываться.

Читать далее
1
23 ...