

Для начала вам нужны два сервера, соединение через InfiniBand и одна достаточно серьезная задача, чтобы игра стоила свеч. Так выйдет общая сеть, которая связывает серверы для высокопроизводительных вычислений. Ну это в теории.
На практике просто купить два сервера и соединить их недостаточно. Нужно распределить задачу, наладить обмен данными и управление сетью. Именно это я и хочу разобрать, чтобы вы прикинули, а надо ли вам брать железо и становиться счастливым обладателем личного суперкомпьютера. Прошу к нашему шалашу эксперименту.
Кто я и почему все это пишу
Привет, я Денис Добрынин, старший Go-разработчик в Cloud.ru. Недавно выступал на конференции и там рассказал, как мы в команде прошли путь от страха до любви к InfiniBand, с чем столкнулись при исследованиях и как придумали такое понятие, как «суперкомпьютер как сервис».
Для тех, кто пока не в теме: InfiniBand — это технология быстрой связи с небольшими задержками, которую используют в вычислительных кластерах, в частности для задач ИИ. Быстрая связь помогает машинам обмениваться данными, хоть сама по себе не превращает любую программу в распределенную и не гарантирует ускорения, а жаль.
Поэтому оговорюсь: сами по себе два сервера, соединенные по InfiniBand, уже можно назвать маленьким суперкомпьютером. Но, помимо соединения, еще важно определить, как разделить задачи и как наладить обмен промежуточными результатами. Это мы и обсудим.
Немного теории (ладно, много)
Я не просто так сказал, что двум серверам нужна общая задача. Пока у вас в работе две независимые задачи, серверы спокойно забирают себе по одной. Им не нужны общие данные, каждый занимается своим делом.
А вот при работе с одной задачей серверам приходится обмениваться промежуточными результатами. Если обмен занимает больше времени, чем сами вычисления, второй сервер почти не ускорит работу: обе машины будут ждать данных друг от друга.
Перед тем как разбирать задачи и влезать в работу серверов, разберем несколько вводных.
Как устроен обмен данными между серверами
Возьмем в пример ответ нейросети. У него есть два разных этапа:
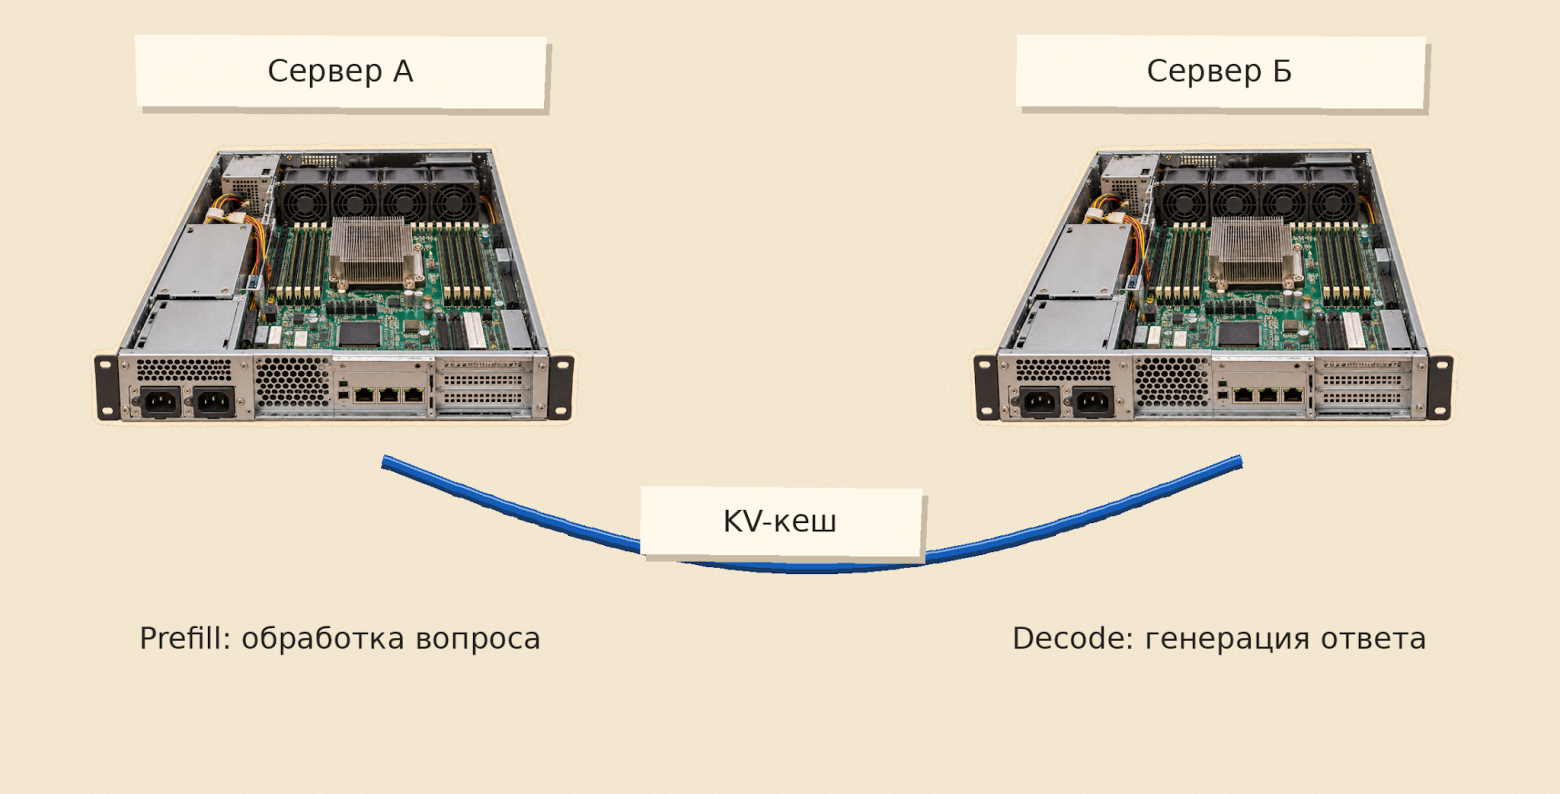
Prefill. Модель обрабатывает входной текст — вопрос и контекст.
Decode. Последовательно генерирует продолжение. Новые токены зависят от уже полученных, поэтому характер вычислений здесь другой.
Чтобы каждый раз не пересчитывать часть промежуточных данных для предыдущих токенов, модель использует KV-кеш. Проще говоря, рабочие записи, к которым она возвращается при генерации.
Если prefill и decode выполняются на разных вычислителях, эти записи нужно передать между ними. Разделение помогает по-разному распределять ресурсы между этапами, но добавляет требование к сети. Дорогой ускоритель, который ждет нужных данных, выглядит на графике гораздо менее впечатляюще, чем в спецификации.
Как именно InfiniBand помогает ускорить обмен данными
Одна из возможностей связанной с InfiniBand модели RDMA — передавать данные между областями памяти с меньшим участием процессора в переносе данных, чем при привычной обработке сетевого обмена. В нашем сценарии по сети нужно передать KV-кеш от вычислителя, который обработал запрос, тому, который будет генерировать ответ.
Со связью определились. Теперь нужно настроить сеть: обнаружить устройства и определить пути передачи данных.
Переходим к практике
А именно — к плану из четырех шагов:
Соединяем два сервера. Добавляем InfiniBand и менеджер подсети.
Делим сеть с соседями. Разбираем, как дать их машинам работать на той же фабрике, не смешивая доступы.
Убираем ручную работу. Автоматизируем сбор сведений о портах и подготовку конфигурации.
Меняем состав без остановки. Переносим серверы между группами, применяем настройки и подстраховываем менеджер подсети резервным. Отдельно разберем, для каких сценариев проверяли сохранение соединений.
В итоге получится понятная схема минимального кластера и управления им.
Соединяем два сервера
Вернемся к двум серверам, которые должны вместе выполнять вычисления. Подключаем их к фабрике InfiniBand — через нее машины будут обмениваться данными.
Но физическое подключение только часть работы. Нужно обнаружить устройства, определить, как они соединены, и настроить маршруты передачи данных. Напомню: в InfiniBand этим занимается менеджер подсети. Например, мы используем OpenSM. Добавляем его на нашу схему.
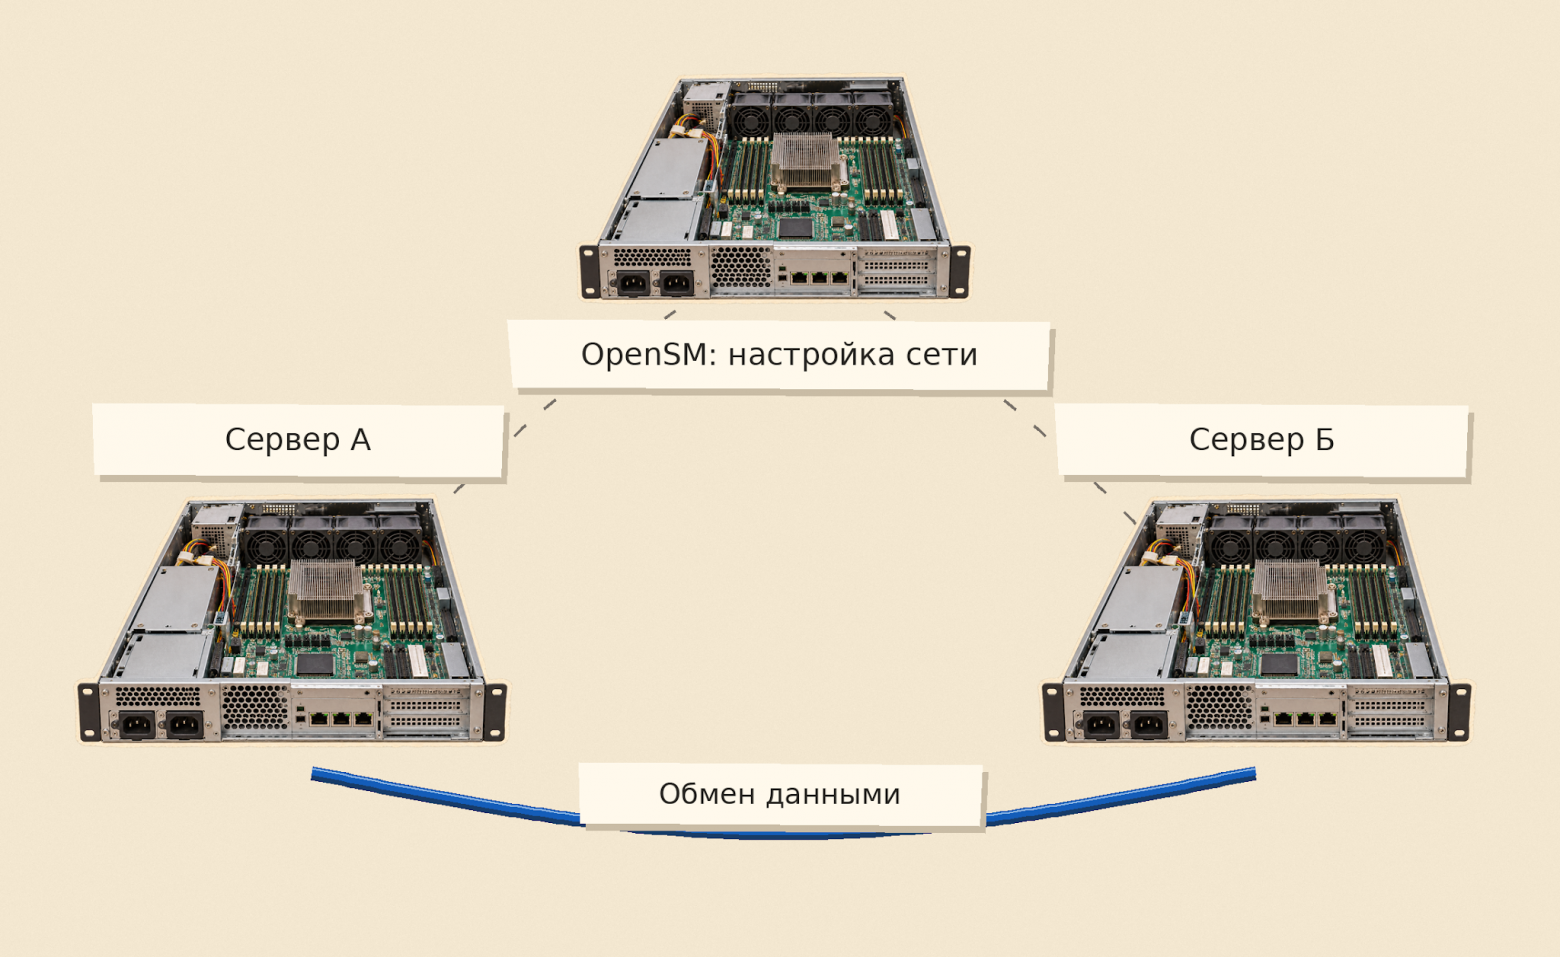
OpenSM обнаруживает топологию фабрики и настраивает сеть. При этом сами данные между серверами не требуется пропускать через процесс менеджера: он управляет настройками, а серверы обмениваются данными по настроенной сети.
Делим сеть с соседом
С серверами для одного пользователя разобрались. Но на общей фабрике нам нужно разрешить обмен между множеством серверов. Притом просто соединить все со всем уже недостаточно: надо определить, кому и с кем разрешено общаться.
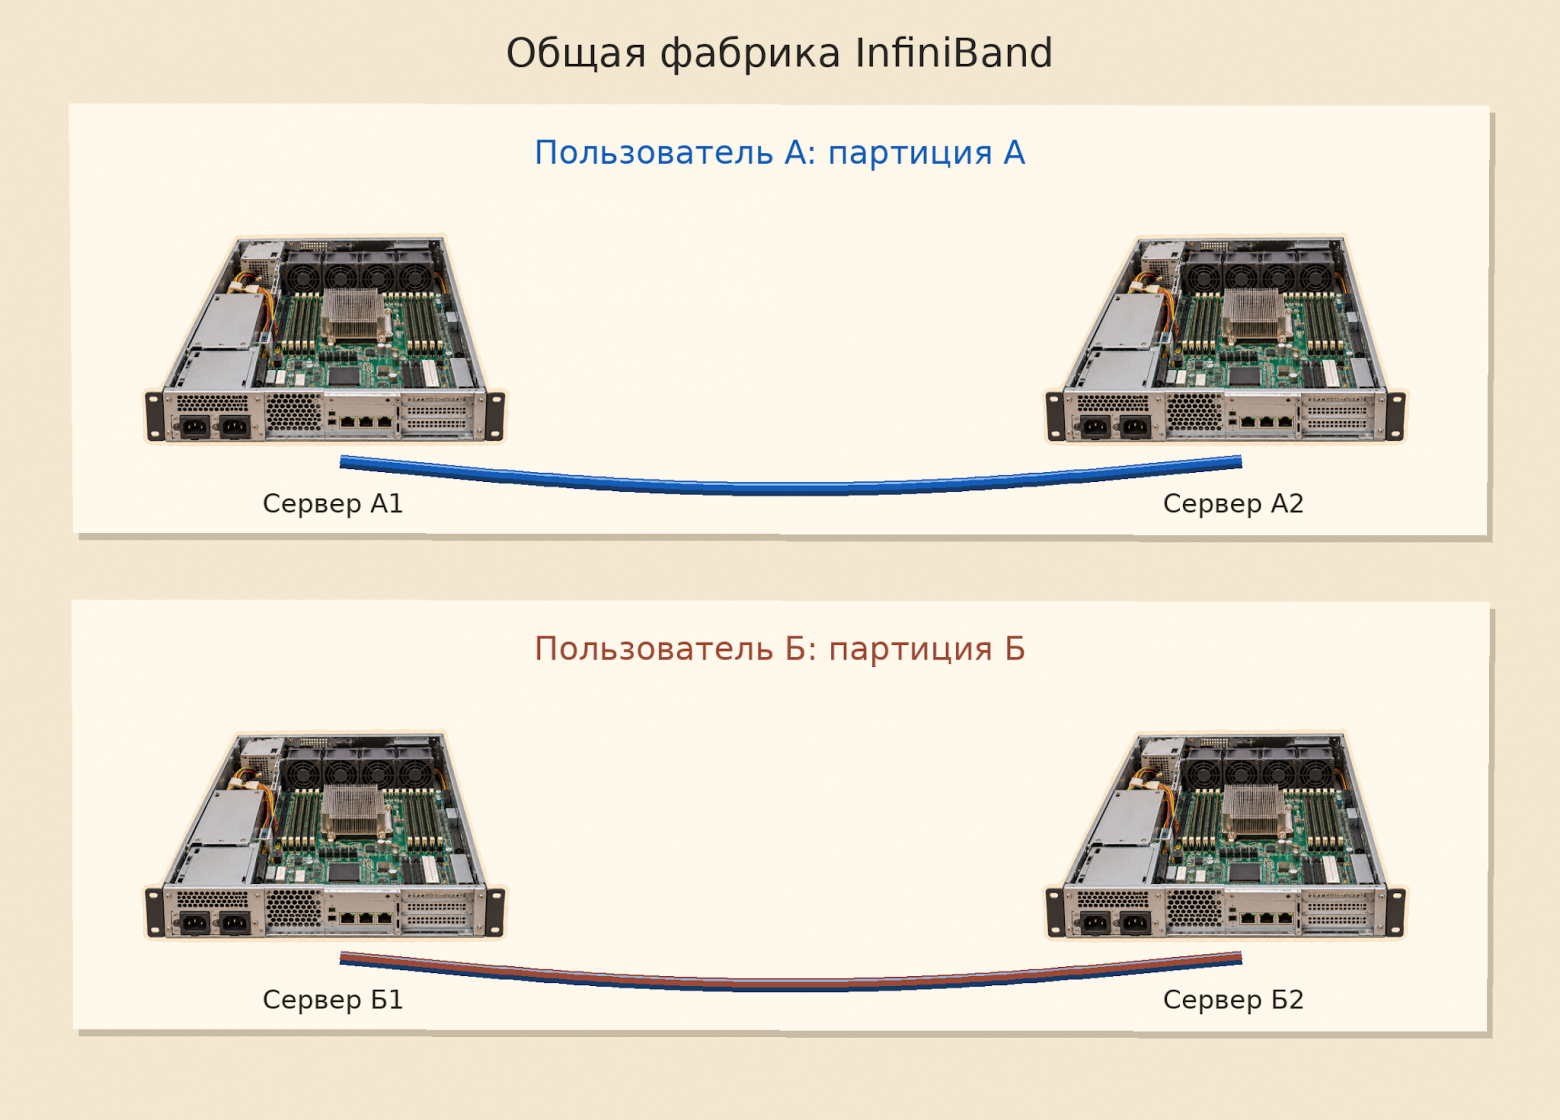
В InfiniBand для этого есть партиции — логические группы портов на общей фабрике. Принадлежность к ним проверяется с помощью ключей P_Key. Так мы разрешаем связь между серверами одного клиента и ограничиваем обмен с чужими машинами.
Теперь задача объединить два сервера несет за собой вполне конкретное изменение: включаем нужные порты в соответствующую партицию. А просьба разделить — изменить состав партиции.
Убираем ручную работу
Правила разделения понятны. Теперь нужно связать их с конкретными серверами: узнать, какие порты кому принадлежат, и записать это в конфигурацию. Прежде чем искать оборудование для своей сборки, начинаем с симулятора ibsim. Это опенсорс, так что любой может взять и изучить устройство сети на модели.
Но и тут возникает нюанс: не везде можно доверять симуляции. Есть у меня один кейс по теме.
В симуляции мы с командой ориентировались на один способ представления устройств и идентификаторов. Но на реальном железе выяснилось, что для нужной задачи удобнее собирать сведения локально средствами Linux. Запускать ради этого обход всей InfiniBand-фабрики не требовалось.
В общем, если нужно узнать, какие ключи лежат у человека в кармане, не обязательно делать перепись всех замков в городе.
Поэтому сейчас я бы использовал симулятор, чтобы разобраться с топологией и поведением инструментов. А работоспособность конкретного способа обнаружения устройств все равно проверял бы на том оборудовании и программных версиях, с которыми ему предстоит жить.
Но получить сведения о портах — это только полдела. Если дальше переносить их руками, схема быстро превратится в тест на внимательность. И есть очень большой риск провалить его.
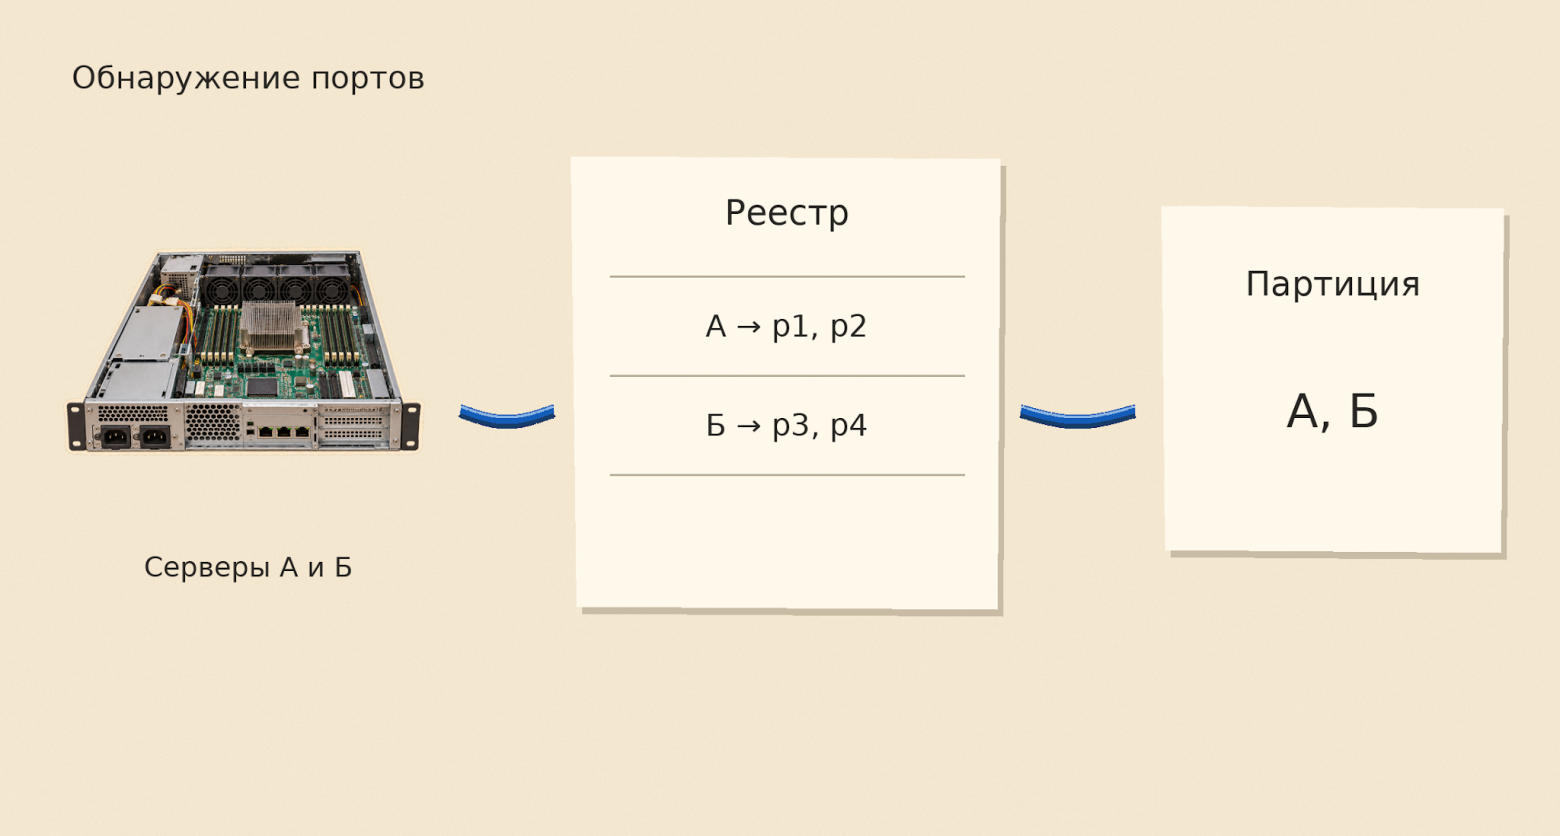
Причем сервер — это не обязательно один порт. У машины может быть несколько ускорителей и соответствующих подключений, и одно имя сервера оказывается связано с набором длинных машинных идентификаторов. Повторять этот набор в правилах неудобно.
Группировка портов делает конфигурацию более читаемой: имя группы представляет нужный набор подключений. Но если инженер по-прежнему собирает сведения руками, значительная часть работы остается. Команда Дениса автоматизировала и этот участок — от получения идентификаторов до создания конфигурации.
В автоматизированном варианте цепочка такая:
При запуске сервер собирает сведения о себе и передает их во внутреннюю систему через изолированную сеть управления.
Система хранит соответствие между сервером и его портами.
Это соответствие используется при построении конфигурации.
Инженеру не нужно каждый раз восстанавливать его по выводу команд.
Если вы ждали, что по итогу то, что занимало сорок минут, теперь занимает две, — прекращайте. Такие измерения нерелевантны. Объем операций разный: сегодня добавляют большую партию серверов, завтра переносят несколько машин между группами. Поэтому результат здесь корректнее измерять тем, насколько меньше стало ручных действий.
Меняем состав без остановки
Теперь мы знаем, какие серверы есть в нашей системе и кому с кем разрешено общаться. Проверяем следующий сценарий: одну машину нужно убрать из группы А и добавить в группу Б, пока остальные продолжают работать. Для этого придется изменить правила сети. Значит, нужно решить три вопроса: как доставить новые настройки, как применить их и что делать, если менеджер сети откажет.
Само изменение состава партиции проходит по такой цепочке:
Управляющая система формирует новую конфигурацию.
Конфигурация доставляется серверному менеджеру OpenSM по SSH.
OpenSM перечитывает ее вместо полного перезапуска.
Первый вопрос — как доставить конфигурацию до OpenSM. Именно здесь наша команда выбирала между SSH и отдельным агентом на хосте с программным интерфейсом. Для запуска остановились на прямом подключении по SSH. Так для передачи настроек не понадобился еще один сервис, который пришлось бы разрабатывать и поддерживать. К агентной системе можно вернуться, когда появится обоснованная потребность в ней.
Второй вопрос — как применить доставленные настройки, не устроив лишний перезапуск. Для этого OpenSM перечитывает конфигурацию. В проверенных командой сценариях это не разрывает текущие соединения.
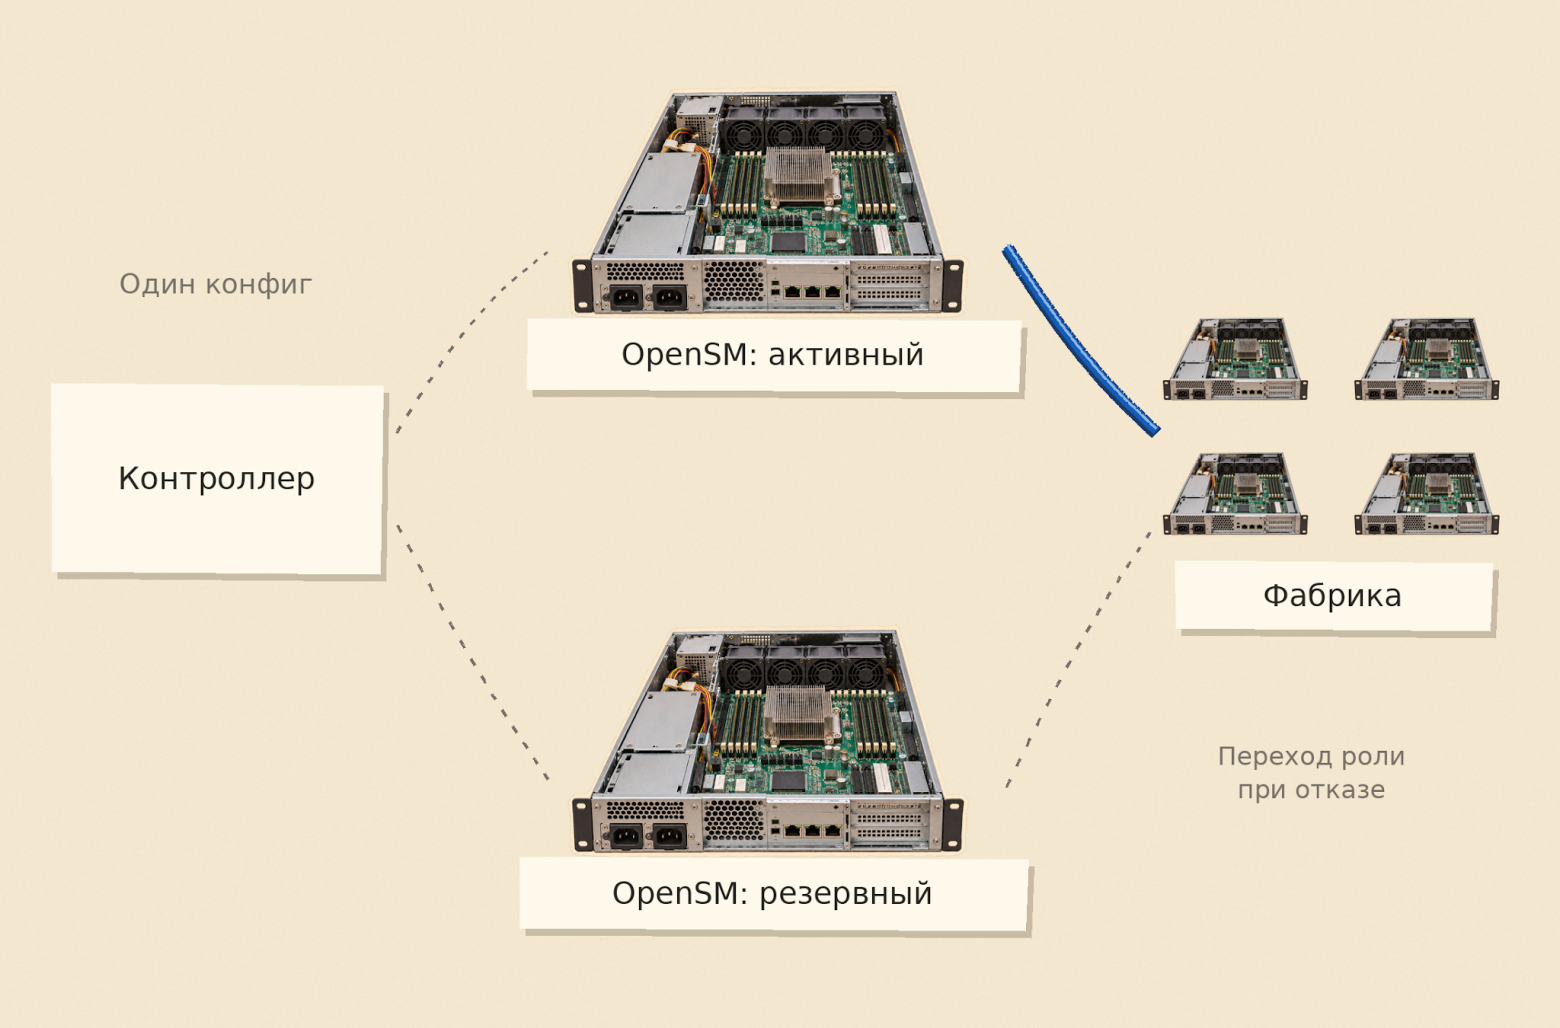
Остается третий вопрос: настройки применили, но что будет, если основной менеджер затем станет недоступен?
Одного способа обновления здесь уже недостаточно — нужен резервный менеджер, который сможет принять его роль. Причем ему нужна та же актуальная конфигурация. Поэтому подготовленные настройки записывают на оба сервера: основной и резервный. В нашем случае конфигурацию доставляем по SSH на основной и резервный серверы, а применяем через перечитывание OpenSM.
Итак, мы автоматизировали создание партиций и изменение их состава: сервер можно убрать из одной группы и добавить в другую. Инженеру больше не нужно вручную искать идентификаторы портов и переносить их в конфигурацию. В планах — автоматическое перераспределение мощностей и интеграция с Terraform.
Так мы пришли к «суперкомпьютеру как сервису»: через систему управления можно объединять серверы для совместной работы и менять состав групп. За этим стоят те же порты, партиции и настройки OpenSM, с которыми мы разобрались по ходу статьи.
Ну как, еще не перегорели с идеей создать свой суперкомпьютер? Сейчас посчитаем желающих.
