

Привет, Хабр! Меня зовут Анна Саботович, я веду внедрение AI-ревьюера в продуктовой группе Garage Eight, и самый частый вопрос, который мне задают: «Ну и когда он заменит человека?» Отвечу сразу: на части кода уже заменил.
В октябре наши iOS-команды сняли третий обязательный апрув на merge request (MR). Теперь в продуктовых репозиториях их не больше двух, при этом в репозитории ревьюера за тот же октябрь влили 35 MR, и апрув кого-то, кроме автора, есть только у шести. Во внутреннем сервисе аналитики разработки влили 69 MR, и ни в одном нет апрува другого человека: автор мержит сам. Хочу рассказать, как мы учились доверять AI и что планируем делать дальше.
Как мы поняли, где можно заменить человека
Всё началось с арифметики, которая перестала сходиться. В какой-то момент мы оказались в ситуации, когда кода, написанного с помощью ИИ, стало в пять раз больше, а людей на ревью оставалось столько же. В итоге одна фича на Android из 35 MR могла неделю ждать по два апрува на каждый. Нужно ли говорить, что это слишком долго?
В то же время загвоздка была и в самом ревью. Опечатка в тексте экрана и ошибка в расчете выплаты стоят по-разному, а апрувов на них до недавнего времени требовалось одинаково. Это не только неэффективно, но и опасно, потому что внимание рассеивается, и упустить важные детали становится легче.
Мы поняли, что просто убрать апрувы везде — точно не вариант и нужна граница: где человек незаменим, а где его можно исключить из цепочки. И эта граница должна проходить по цене ошибки, а не по типу репозитория или настроению тимлида.
Цену ошибки у нас оценивают архитекторы доменов (DSA) по общей для компании шкале из четырех tier и записывают в арх-панель. У каждого сервиса две оценки: что будет, если он остановится, и что будет, если он ошибется. Для ревью нам важна вторая. Уровень ставим по худшему сценарию, а сервис без оценки считаем Tier 1. На середину октября оценен 41% микросервисов. Мобильные приложения оценивают по модулям: приложение целиком в один tier не ложится.
В итоге схема, к которой мы хотим прийти, выглядит примерно так:
Tier | Цена ошибки | Что делает ревьюер | Сколько людей нужно |
|---|---|---|---|
4: сервисы одной команды, эксперименты | Ошибка видна только команде и не влияет на процессы в работе с пользователем | Ревьюит, автор мержит сам | Никого, если автоматические проверки зеленые |
3: внутренняя платформа | Ошибка скажется на внутренних процессах, но пользователь ее не увидит | Ревьюит, автор мержит сам | Никого, если автоматические проверки зеленые (уже так) |
2: второстепенные клиентские функции, внутренние процессы | Ошибка нарушит работу пользователя, но денег не коснется | Ревьюит и оценивает сложность MR | Один человек на простых и обычных MR, двое на сложных |
1: ключевые процессы и деньги клиентов | Ошибка ударит по деньгам пользователя или компании либо нарушит требования регулятора | Подсказывает | Двое, архитектурное решение за человеком |
Начали сознательно с Tier 3 и наших собственных репозиториев. Ошибка там бьет по нам самим, откатить ее просто, а авторы сами строят ревьюер и первыми видят, что он пропустил.
Бывает даже, что ревьюер находит баг в самом себе:
Бот: Удаленная строка -- comment в SQL или --- в markdown/YAML выглядит как --- comment и не считается. Из-за этого файл, где удалена только такая строка, теперь выбрасывается как no-changes. Раньше эта неточность влияла лишь на лимит строк, а теперь решает, увидит ли файл модель.
Агент автора: Исправлено… Спасибо, хорошая находка.
На других уровнях всё сложнее. Например, на Tier 2 число людей зависит от сложности MR. Ее уже оценивает ревьюер отдельным шагом до ревью и вешает на MR лейбл — простой, обычный или сложный. Автору таким лучше не заниматься, потому что, если он сам будет решать, простое изменение или нет, очень скоро простыми станут все.
Модель выбирает алгоритм, поэтому каждую смену проверяем на эвалах
У нас есть несколько моделей и уровней рассуждения — что и когда использовать, выбирает алгоритм в зависимости от класса сложности MR. Тот же класс ревьюер оставляет на MR лейблом и комментарием, и по нему бот будет решать, сколько людей нужно позвать.
На Tier 1 и 2 всегда ревьюит самая сильная модель, на Tier 3 и 4 пробуем модель, развернутую внутри компании: она дешевле, и код не утекает наружу. Первым на нее посадили репозиторий самого ревьюера. В первый же день один MR ревьюился на ней около 50 минут и занял очередь, а MR iOS ждали до 23,5 минуты вместо обычных одной — пяти. Такой вариант нас, конечно же, не устроил, и очередь пришлось переделывать.
В октябре алгоритм стал отдавать часть MR легким моделям, а сами модели сменили версию. Параллельно мобильные репозитории стали заметно реже править код по замечаниям бота, и сложно было с ходу понять, что из этого причина: резко поменялось всё и сразу. Для этого мы собрали эвалы: 42 MR из истории Android, iOS, веба и бэкенда, каждый в той версии, которую видел ревьюер. В 32 из них нашлись настоящие проблемы, и каждую подтвердил человек.
В целом эвалы нужны еще и потому, что с ботом всё чаще спорит не человек и по ответам в тредах всё хуже видно, что думают люди. Агенты спорят между собой и делают это вежливо и долго: на одном MR нашего QA-инструмента бот ревьюил 27 коммитов подряд и оставил 45 находок, на 44 из которых ответил агент. Всё это может продолжаться до утра, и чтобы такого не случалось, нужен потолок кругов и проверка только нового диффа.
Какая метрика помогает оценивать работу AI
Метрика, с которой мы начали, — доля резолвнутых замечаний, потому что GitLab отдает ее сразу, да и выглядела она неплохо: 92%. Но резолв не показывает, поменялся ли код: тред закрывают и после правки, и после «не согласен». А в Android и iOS включена настройка GitLab only_allow_merge_if_all_discussions_are_resolved, и MR не вольется, пока открыт хоть один тред. Когда я разобрала 832 находки в этих репозиториях вместе с ответами людей, на смерженных MR резолвнуто было 647 из 647. Такая метрика мерит гейт, и помог ли ревьюер, из нее не видно.
Принятие лучше считать по коду: замечание принято, если до мержа поменялся код рядом с его строкой. MR и так дорабатывают до мержа, поэтому сравниваем с фоном: как часто до мержа меняется случайное место того же файла. Например, в третьем квартале на смерженных MR 12 репозиториев было 585 серьезных находок, major и critical. После 219 из них код рядом поправили — это 37% от общего числа, а случайное место меняется в 7% случаев. Еще 27 принятых я проверила руками, в 25 правка действительно была про замечание.
Итого за квартал около 200 серьезных проблем были исправлены до мержа, 98 из них — баги. Принятие сильно отличается от репозитория к репозиторию и от месяца к месяцу. С 1 по 20 октября мобильные репозитории приняли 36% серьезных замечаний, в сентябре — 56%. Веб держится около 30%. А на сайте после двух третей замечаний автор не сделал ни одного пуша: такие находки нельзя записать ни в принятые, ни в ложные, пока не спросишь автора. Именно поэтому решение о том, убирать ли человека, принимаем по каждому репозиторию отдельно, по его собственным цифрам.
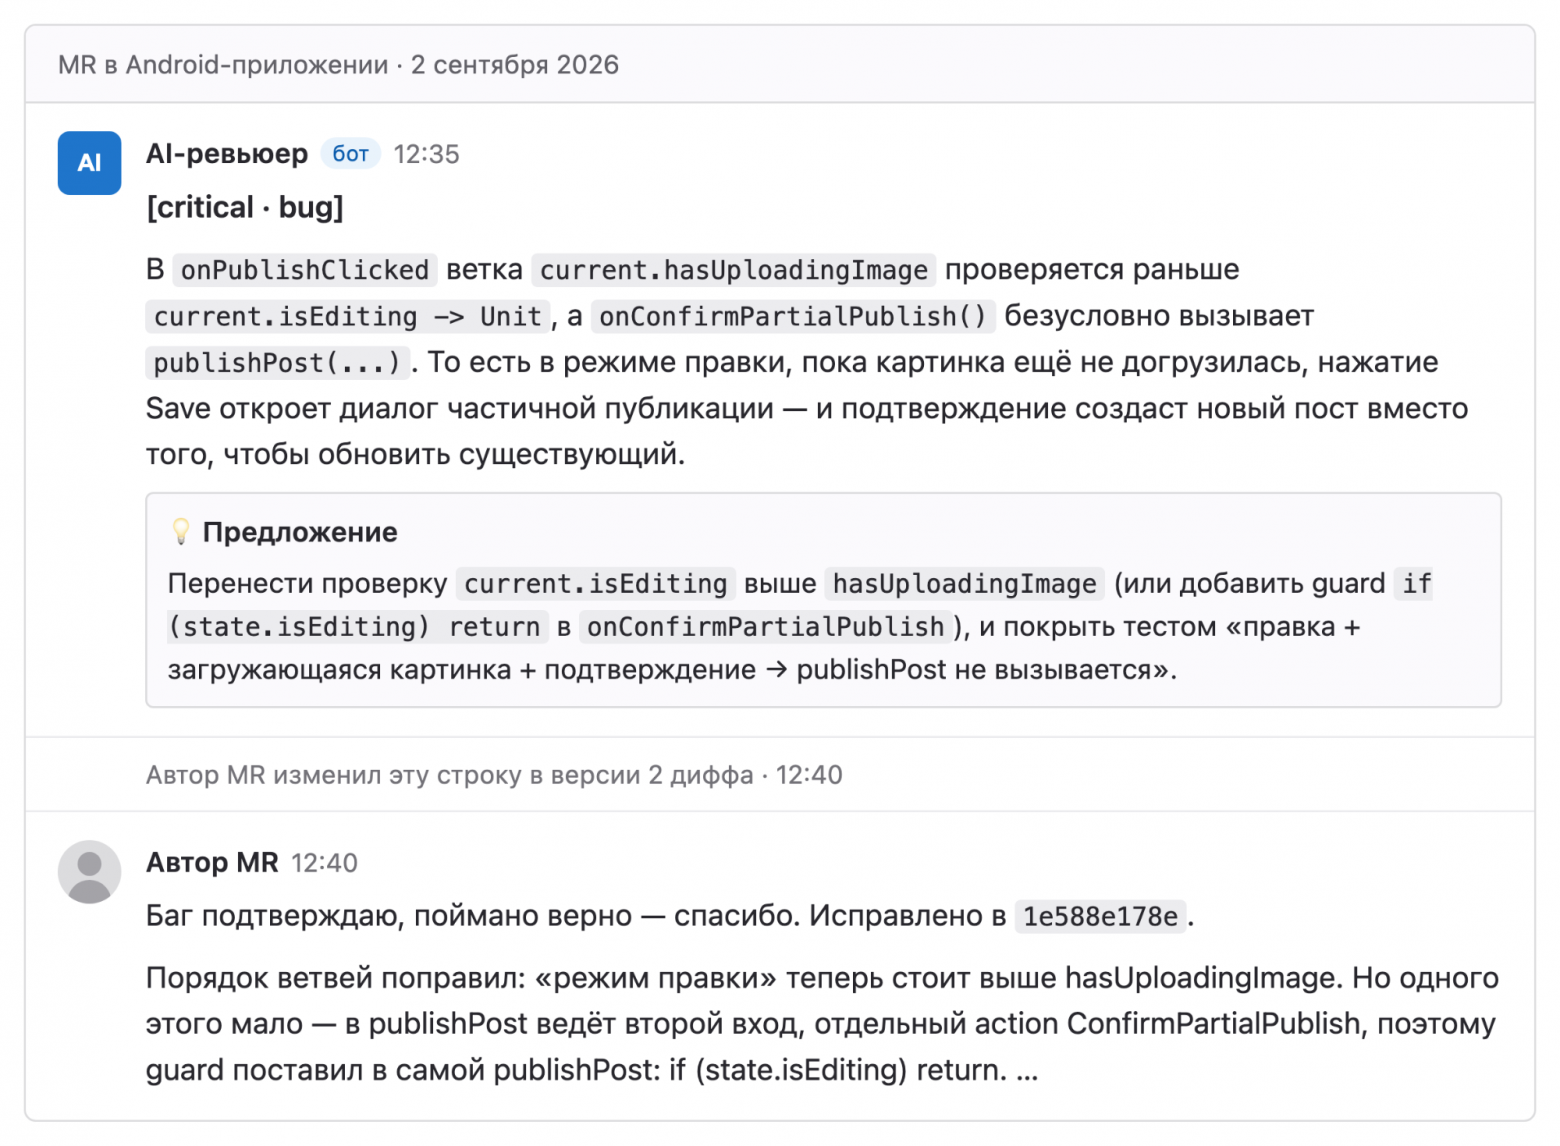
Например, такой баг человек в диффе пропустил бы легко:
Шум измеряем отдельно
Доля замечаний с пометкой «не полезно» должна быть не выше 10%. Вот вам типичный кандидат на такую пометку:
Бот: Duration считается через wall-clock Date(): если системное время сдвинется (NTP или руками) между показом и закрытием, duration вылетит в минус.
Разработчик, через минуту: Если бы у бабушки...
Споры с ботом тоже разбираем
У нас был случай, когда мы разбирали 63 явных возражения разработчиков на 832 находки бота в Android и iOS, и примерно в трети бот ошибся в факте, который можно проверить, а в пятой части правило применили не там, где оно работает.
Иногда противоречие сидит в самих правилах. На одном MR бот советует: .handleEvents(receiveOutput: { … }), через неделю на другом пишет: «§3.1 REVIEW.md прямо запрещает это». Разработчики в треде:
— а в ревью мд прямо есть пример…
— пример про handleEvents — рофлс, [коллега] как амбассадор комбайна ругался на такое… надо ему про ревью мд узнать )0))
Лечится это по-разному. Правила ревью лежат в репозитории каждой команды, в файле REVIEW.md, и противоречия вроде этого команда убирает сама обычным MR. А вот ошибки в фактах файлом правил уже не исправить: для них нужен отдельный проход, где бот до публикации перепроверяет свое утверждение по коду. Он пока в бэклоге.
Случалось и так, что правило в файле было, а ревьюер его не читал. Например, в iOS он проходил маршрут чтения правил только в 22% ревью, но как только чтение сделали обязательным, процент повысился до 96%, и повторяющиеся замечания людей в MR пропали.
Как страхуем себя от рисков
В первую очередь человека мы убираем ступенями: 3 → 2 → 1 → 0 обязательных апрувов. Первую ступень iOS проходит сам, это около 170 апрувов в месяц, где больше не нужны люди. На следующей ступени на простых и обычных MR остается один человек, на сложных — двое.
Порог каждой ступени считаем во времени людей: апрувы на MR и очередь к человеку. В будущем при росте откатов ревьюер должен будет сам возвращать обязательный человеческий апрув. Это будет нашим первым предохранителем, но пока его нет, на Tier 1 и 2 людей не убираем.
Второй предохранитель скучнее: ревьюер должен работать, иначе MR будет простаивать или уходить вообще без проверки. В сентябре наш ревьюер молчал семь суток, в октябре еще 30 часов — оба раза мы уперлись в лимит расходов на API, но узнали об этом уже позже. Чтобы избежать таких проблем, мы поставили алерты на тишину в рабочее время, зависшее ревью и баланс.
Чек-лист для ревью без человека
Чтобы репозиторий был готов к ревью без человека, должны совпасть сразу несколько факторов:
У репозитория есть tier от архитектора, а сложность MR оценивает не автор.
Принятие замечаний считается по коду, и есть фон для сравнения.
Доля «не полезно» держится ниже 10% хотя бы месяц.
Сняты базовые линии: апрувы на MR, ожидание человека, доля откатов.
Есть эвалы, и каждая правка правил или смена модели проверяется на них.
Ревью сходится: есть потолок кругов.
Есть алерт, если ревьюер замолчал.
Есть предохранитель, который сам возвращает человека при росте откатов.
У нас уже есть второй, пятый и седьмой пункты, предохранителя пока нет. Первый пункт тоже почти готов: tier сервисов ревьюер забирает из арх-панели, но вот модули мобильных приложений еще размечаем. Остальное пока в бэклоге.
Мой прогноз
В этом квартале мы подключаем новые репозитории Tier 3 и 4: записываем пороги ступеней и выбираем, какой репозиторий следующий, а включим его, когда он пройдет чек-лист выше — по цифрам, без привязки к дате. Когда заработает предохранитель, на Tier 2 простые и обычные MR будет смотреть один человек вместо двух.
Совсем без людей Tier 1 и 2 я в обозримом будущем не жду: там человек в ревью отвечает за то, что видит клиент, а на Tier 1 еще и за его деньги. Пока что такую ответственность перекладывать на модель я не готова.
Как думаете, когда в вашей команде AI-ревьюер сможет заменить человеческий апрув? Или считаете, что человек обязательно нужен на каждом этапе? Давайте обсудим.

