
Код больше ничего не стоит. Его пишет агент, быстро и почти даром, и считать умение писать код главным богатством команды уже нельзя.
Когда код подешевел, мы потеряли то, чего не замечали, пока оно доставалось бесплатно: понимание системы. Оно возникало само, пока человек неделями писал код руками. Теперь писать руками незачем, и понимать систему стало некому.
Я считаю, что из‑за этого разработку придется перестраивать целиком. Scrum со спринтами и бэклогом в Jira придуман для времени, когда самым медленным и самым дорогим звеном была разработка. Это время прошло, и привычные методологии отжили свое. Самым медленным и дорогим стало понимание, и работу нужно строить вокруг него.
Ниже я расскажу, как это можно устроить. Свой подход я называю Product Autonomy. Примеры возьму из финтеха: кошелек, платежи, интеграции с банками.
Вокруг чего все было построено
Еще недавно фича проходила четыре стадии: идея, недели согласований с партнером и комплаенсом, месяцы разработки, проверка. Третья стадия была самой долгой и самой дорогой, и все остальное под нее подстраивалось.
Так и положено по теории ограничений: если в цепочке есть узкое место, вся цепочка работает на него. Поэтому команды набирали из разработчиков, бэклог был очередью к ним, а владельца продукта учили ставить задачи так, чтобы разработчик их понял. Спринты, планирование, оценка задач тоже подчинены разработке.
Теперь это звено стоит не дороже самой идеи. Распорядок при этом никто не менял: мы до сих пор живем по расписанию, составленному под разработку, хотя узкое место уже не в ней.
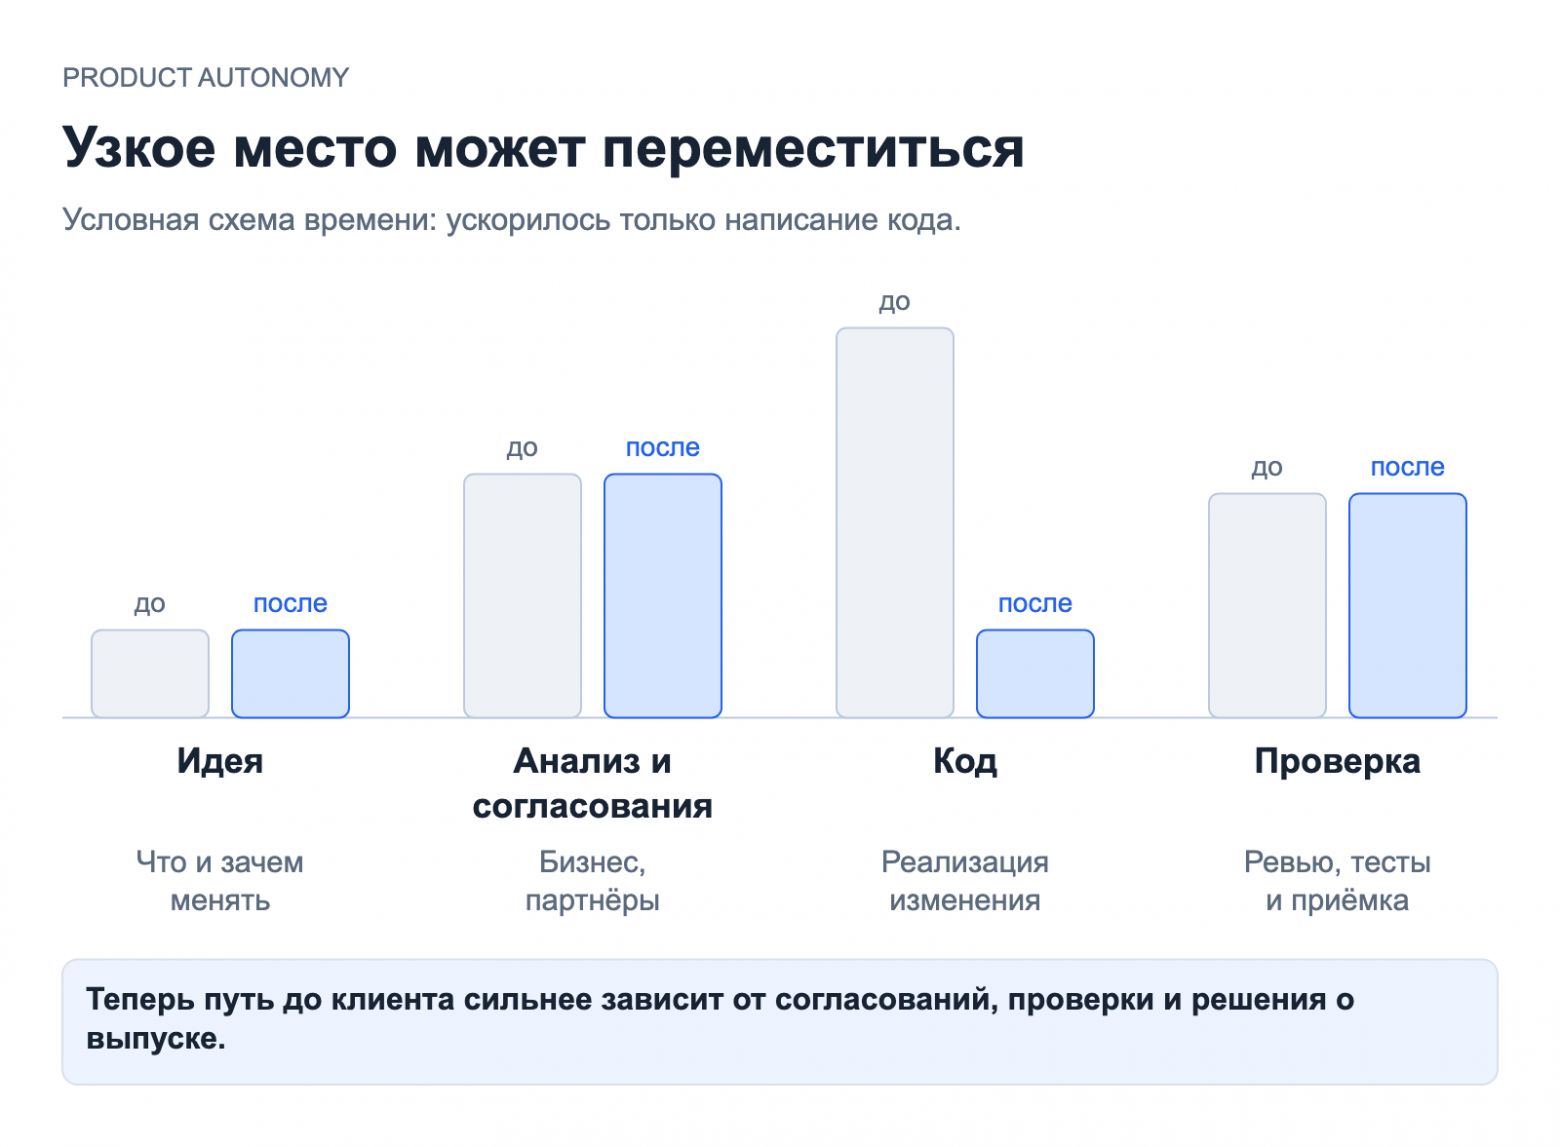
Что пропало, когда код подешевел
Пока человек писал код, он поневоле разбирался в системе, иначе код не напишешь. Аналитик, чтобы составить ТЗ, должен был выяснить у бизнеса, у партнера, у того же комплаенса, чего они на самом деле хотят. Тестировщик проходил сценарий от начала до конца так, как это делает клиент. Инженер, который когда‑то подключал банк, помнил, о чем тогда договорились, а если не помнил, находил это в старой переписке.
Понимание было распределено между людьми. Полной картины не было ни у кого, зато свою часть каждый знал твердо, потому что сделал ее сам.
Агенты избавили нас от ручной работы, и понимание ушло вместе с ней. ТЗ сгенерировано из идеи, код сгенерирован из ТЗ, и целиком ни то, ни другое не прочел ни один человек. Фич выходит все больше. Но по их числу не скажешь, сколько денег они принесли и знает ли хоть кто‑нибудь, что именно мы выпустили и зачем.
Для этой потери уже есть термин. Эдди Османи называет ее comprehension debt, долгом понимания: система работает, а команда не успевает в ней разобраться. Он настаивает, что понимание системы должно оставаться отдельной инженерной задачей, как бы дешево ни обходился код. О том же, только применительно к математике, говорит Теренс Тао в докладе «Math 2.0»: ответ теперь можно получить, минуя понимание, а раньше оно накапливалось по ходу дела, и на него опиралась следующая работа.
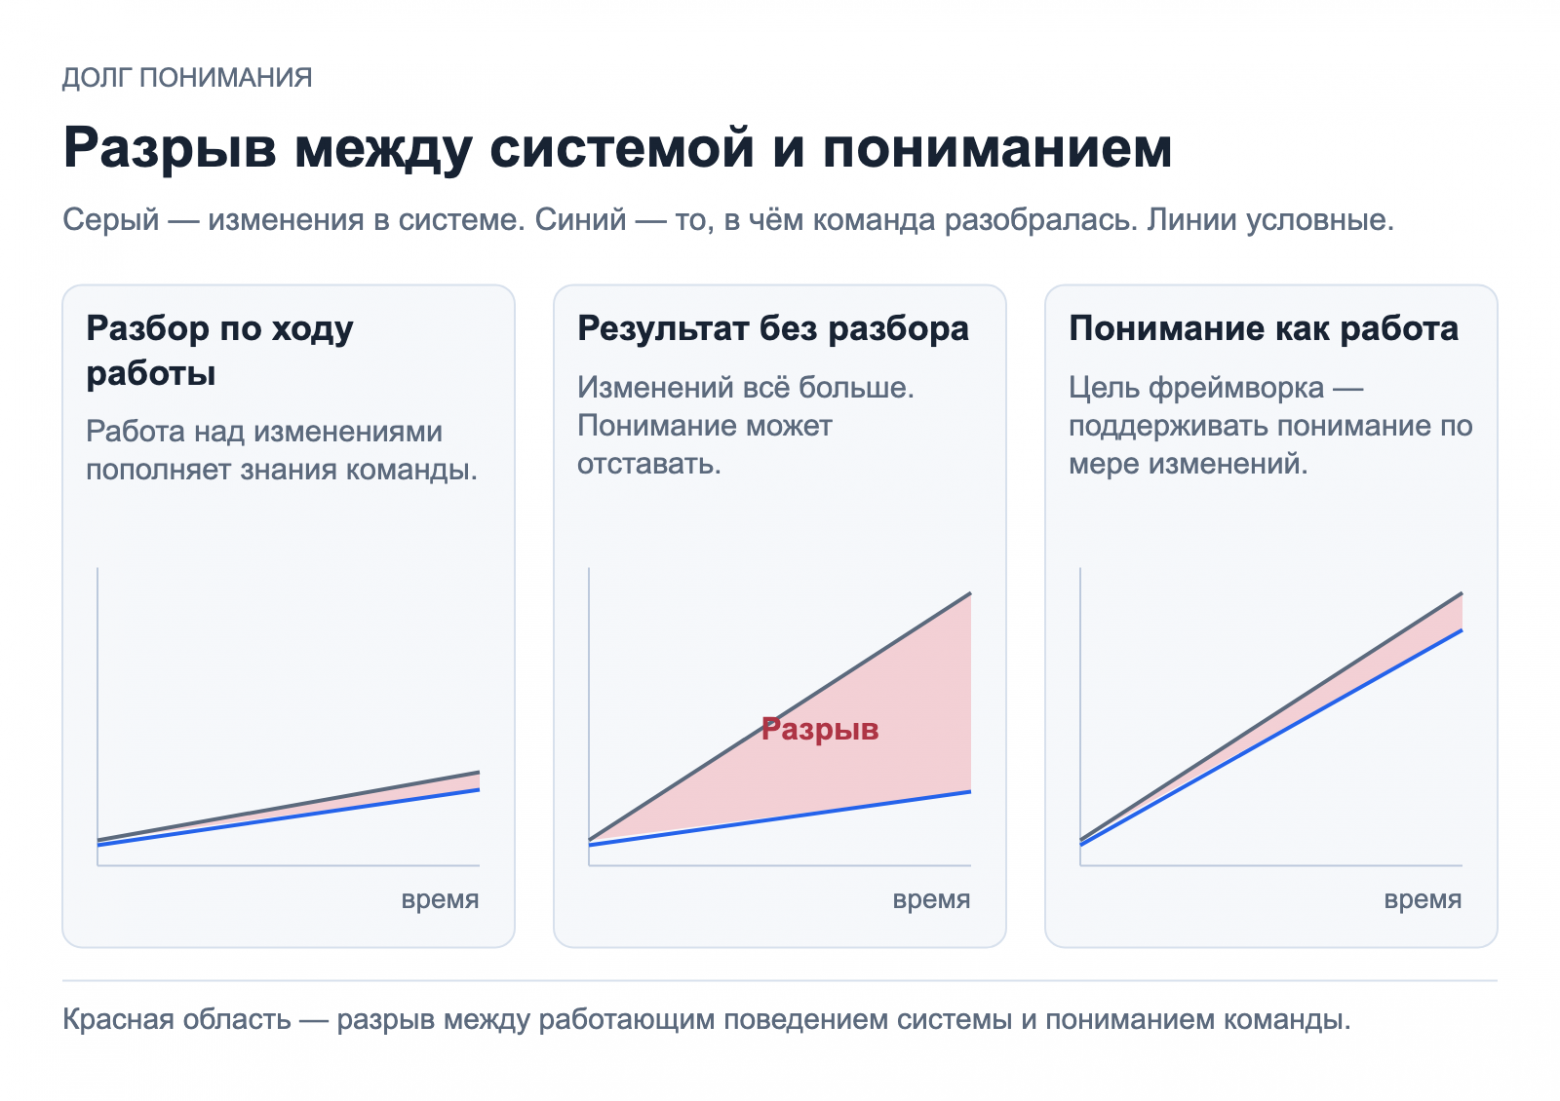
Раньше нас страховало то, что автор кода знал, что делает. Потом из страховки остались только код‑ревью и регресс. Теперь агенты ускорили и ревью, и регресс. Но за выпуск по‑прежнему отвечает человек, а читает он не быстрее, чем раньше. Агент пишет в разы быстрее, чем человек успевает прочесть и понять, и очередь непрочитанного растет.
Новое узкое место
Узкое место в цепочке осталось, только теперь оно в другом звене. Больше всего времени и денег уходит на то, чтобы понять, что мы делаем, для кого и что из этого выйдет.
Если спросить, у кого в команде это понимание еще осталось, ответ окажется неприятным. Разработчик код не писал. Аналитик ТЗ не составлял. Что делается и зачем, понимает один человек: владелец продукта, который придумал фичу и отвечает за ее результат.
Раз система должна подчиняться своему ограничению, работу надо строить вокруг владельца продукта. Он вместе с агентом доводит фичу от замысла до запуска. Инженеры больше не пишут фичи. Они строят среду, в которой владелец продукта может работать, ничего не ломая.
Это я и называю Product Autonomy.
Как это выглядит на деле
Возьмем условный пример. В кошельке часть клиентов начинает пополнять счет и бросает на полпути.
Владелец продукта (дальше буду писать PO, так короче) сначала выясняет, почему так происходит. Причин может быть несколько: ошибка, непонятный экран, человек передумал или его отвлекли. Напоминать стоит только тем, кого отвлекли. Если есть основания думать, что люди просто забывают вернуться, появляется гипотеза: напомним через сутки, и часть клиентов завершит пополнение.
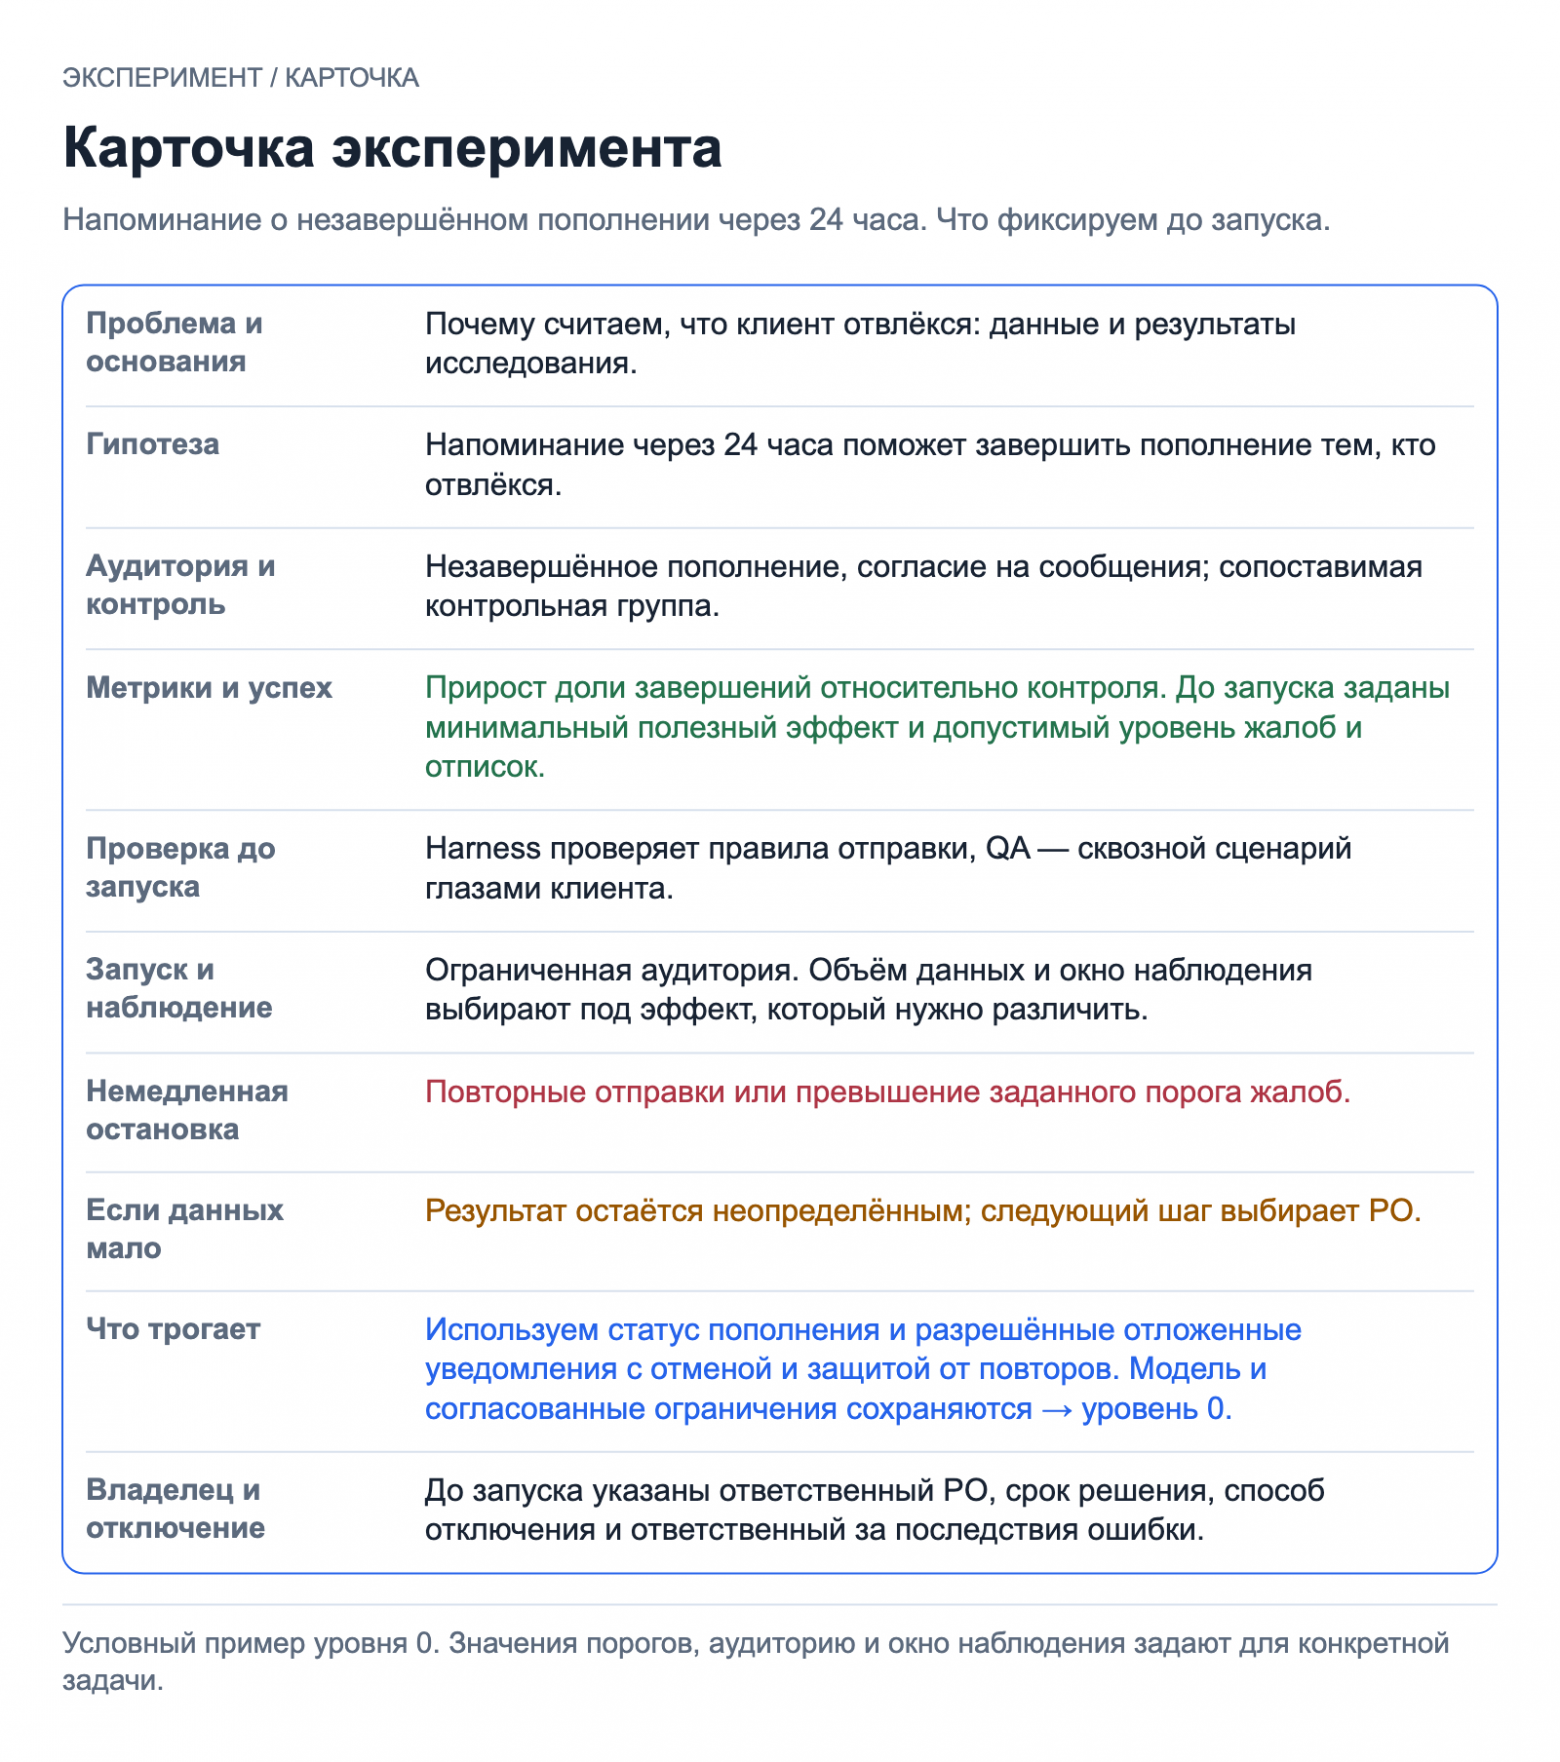
Еще до сборки PO записывает, что именно он хочет проверить. Подойдет и задача в трекере, и Markdown‑файл. Главное, чтобы там было сказано, на чем основана гипотеза, для кого изменение, какого эффекта мы ждем и как его измерять, что считаем успехом, при каких условиях останавливаемся, что меняется в системе, на какой аудитории запускаем, сколько наблюдаем и кто принимает решение.
Затем он вместе с агентом собирает сценарий в песочнице из того, что кошелек и сервис уведомлений уже умеют. Агент сверяется с правилами домена и с дизайн‑системой. PO смотрит на экран глазами клиента и сразу правит текст, условия срабатывания и сам экран.
Потом идет проверка. Автоматика контролирует то, что описано заранее: напоминание уходит только тому, кому положено, согласие на сообщения учитывается, одно и то же не отправляется дважды, а если человек пополнил счет, напоминание отменяется. После автоматики по сценарию проходит тестировщик. Он ищет ошибки, которых правила не предусматривают. Напоминание может быть технически безупречным и при этом прийти человеку, который только что обращался в поддержку.
Затем PO включает сценарий для небольшой группы клиентов, а для сравнения оставляет сопоставимую контрольную группу. Группа небольшая, чтобы ошибка, если она есть, задела немногих. Условия немедленной остановки записаны заранее: например, повторные отправки или жалобы сверх допустимого. Заранее известно и то, как выключить сценарий и кто будет разбираться с последствиями.
Последний шаг: PO принимает решение. Он смотрит, выросла ли доля завершенных пополнений и чем за это заплачено: жалобами, отписками или чем‑нибудь еще. Если данных мало, результат так и записывают: неизвестно. Если гипотеза не подтвердилась, сценарий выключают или возвращаются к вопросу, почему люди бросают пополнение. Если эффект того стоит, PO расширяет аудиторию, но в пределах, о которых договорились до запуска.
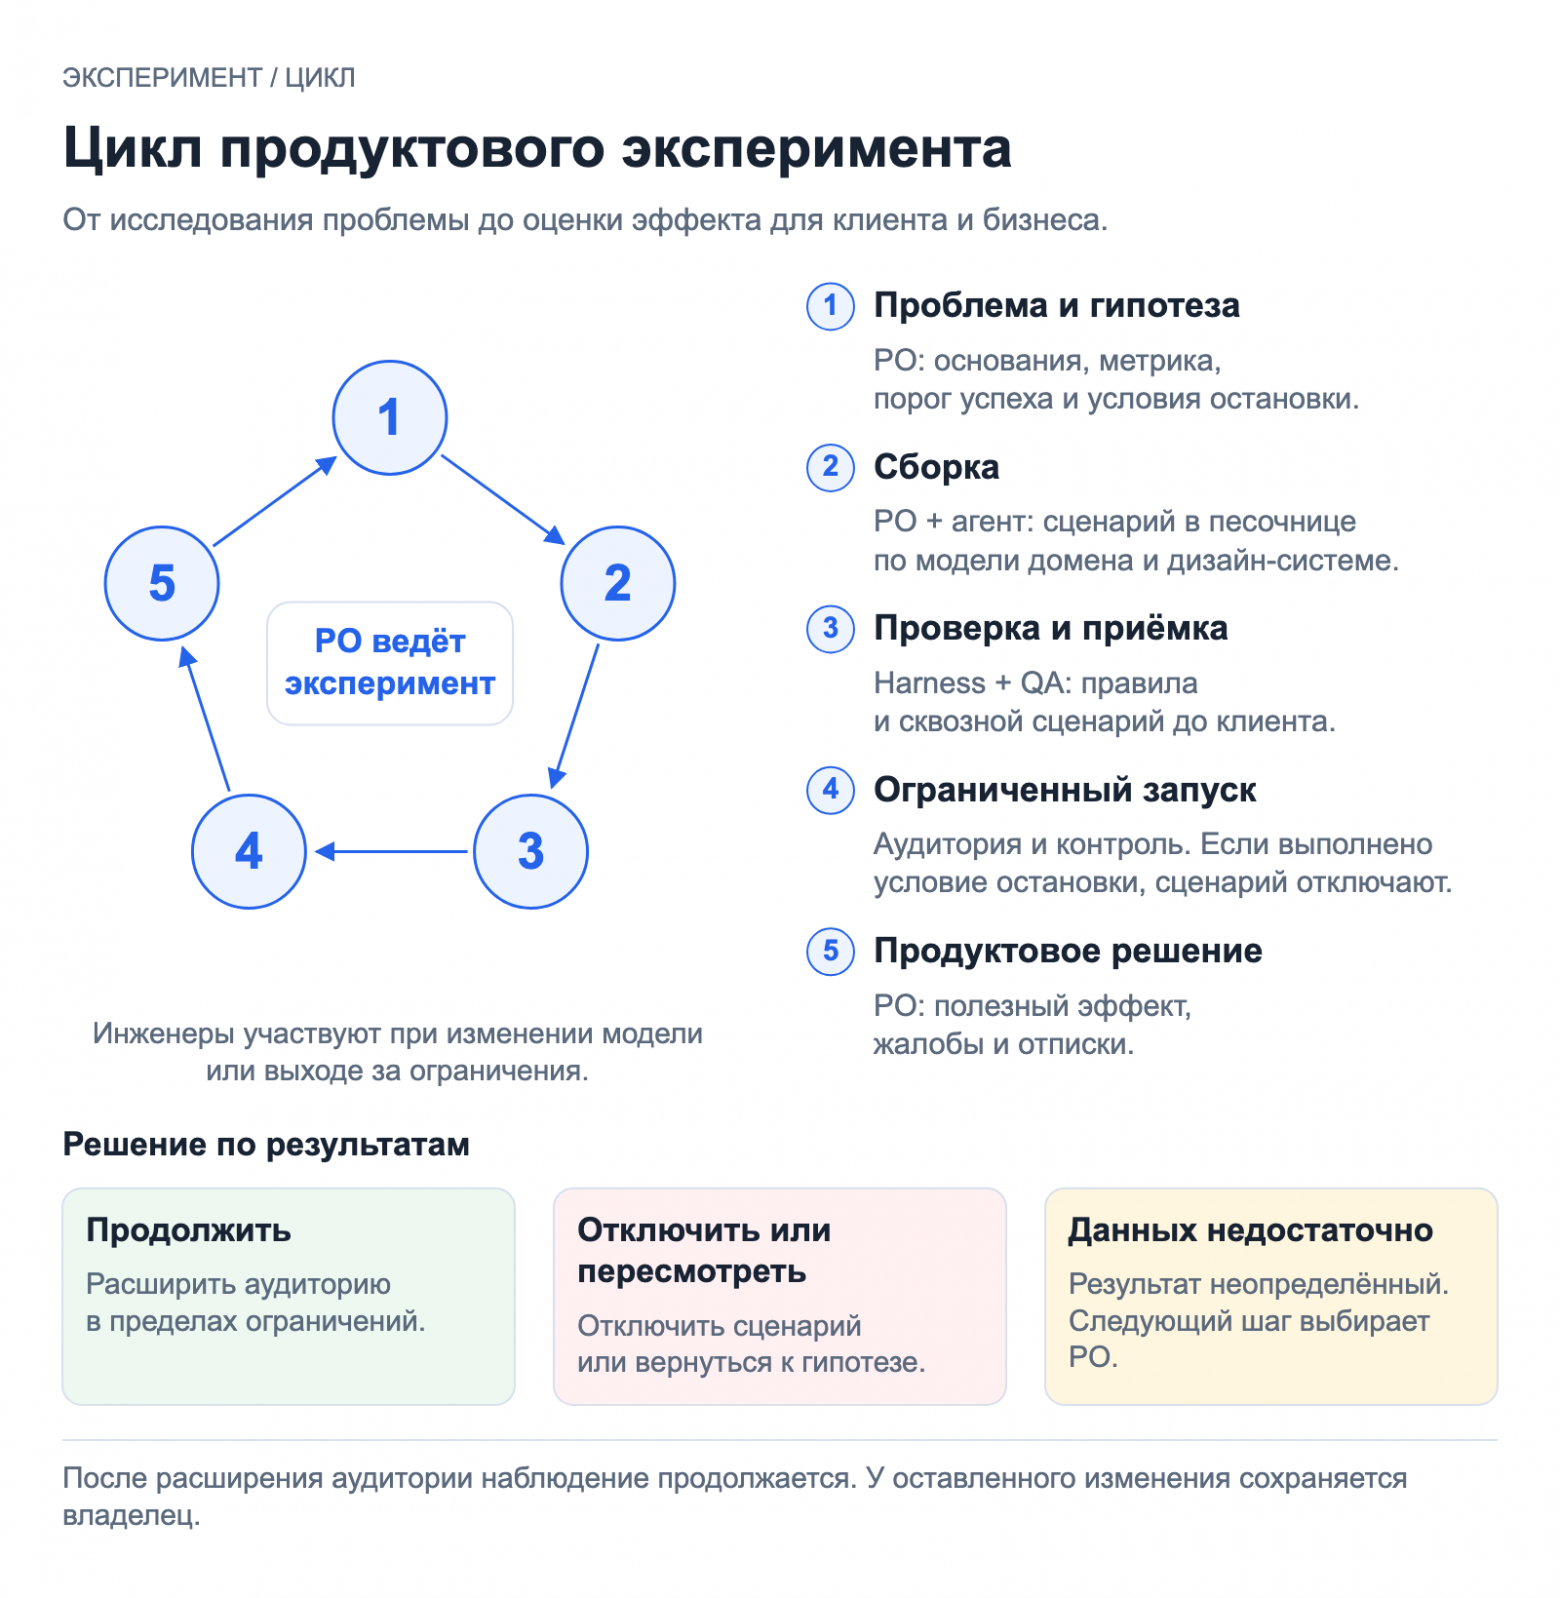
Выключить сценарий здесь в порядке вещей, ничего стыдного в этом нет. Фичу, на которую ушли месяцы, выключать жалко. Сценарий, собранный быстро и дешево, не жалко. Поэтому единицей работы становится эксперимент: мы заранее решаем, что хотим узнать и при каком результате остановимся, проверяем и идем дальше.
Что делают инженеры
Инженеры без дела не остаются: они строят среду, без которой PO нельзя подпускать к системе.
Первая их задача: описать модель домена. В ней записано, о чем сервисы договорились между собой, в каких состояниях бывает платеж и как он переходит из одного в другое, какие правила нарушать нельзя и что происходит при отказе. Про пополнение, например, там сказано, что значит подтверждение от партнера, как быть с повторным запросом и что делать, если деньги списаны, а ответ не пришел. Для каждого правила записано, откуда оно взялось: из договора, из требования бизнеса или из инженерного решения. Модель лежит в репозитории, и менять ее можно только через инженерное ревью.
Так возвращается понимание, которое мы потеряли. Раньше оно возникало само, в ходе ручной работы. Теперь его приходится добывать специально и записывать, и это отдельный инженерный труд. Османи считает, что инженеры должны держать в голове цельную модель системы. Я добавляю, что ее надо еще и записать, потому что на записанную модель опираются и агент, который пишет код, и проверки, которые этот код принимают.
Вторая их задача: построить harness. Так по‑английски называют проверки и ограничения, в рамках которых работают PO и агент. Сюда входят политики безопасности, ограничения доступа, средства наблюдения и автоматические проверки, которые ловят нарушения модели.
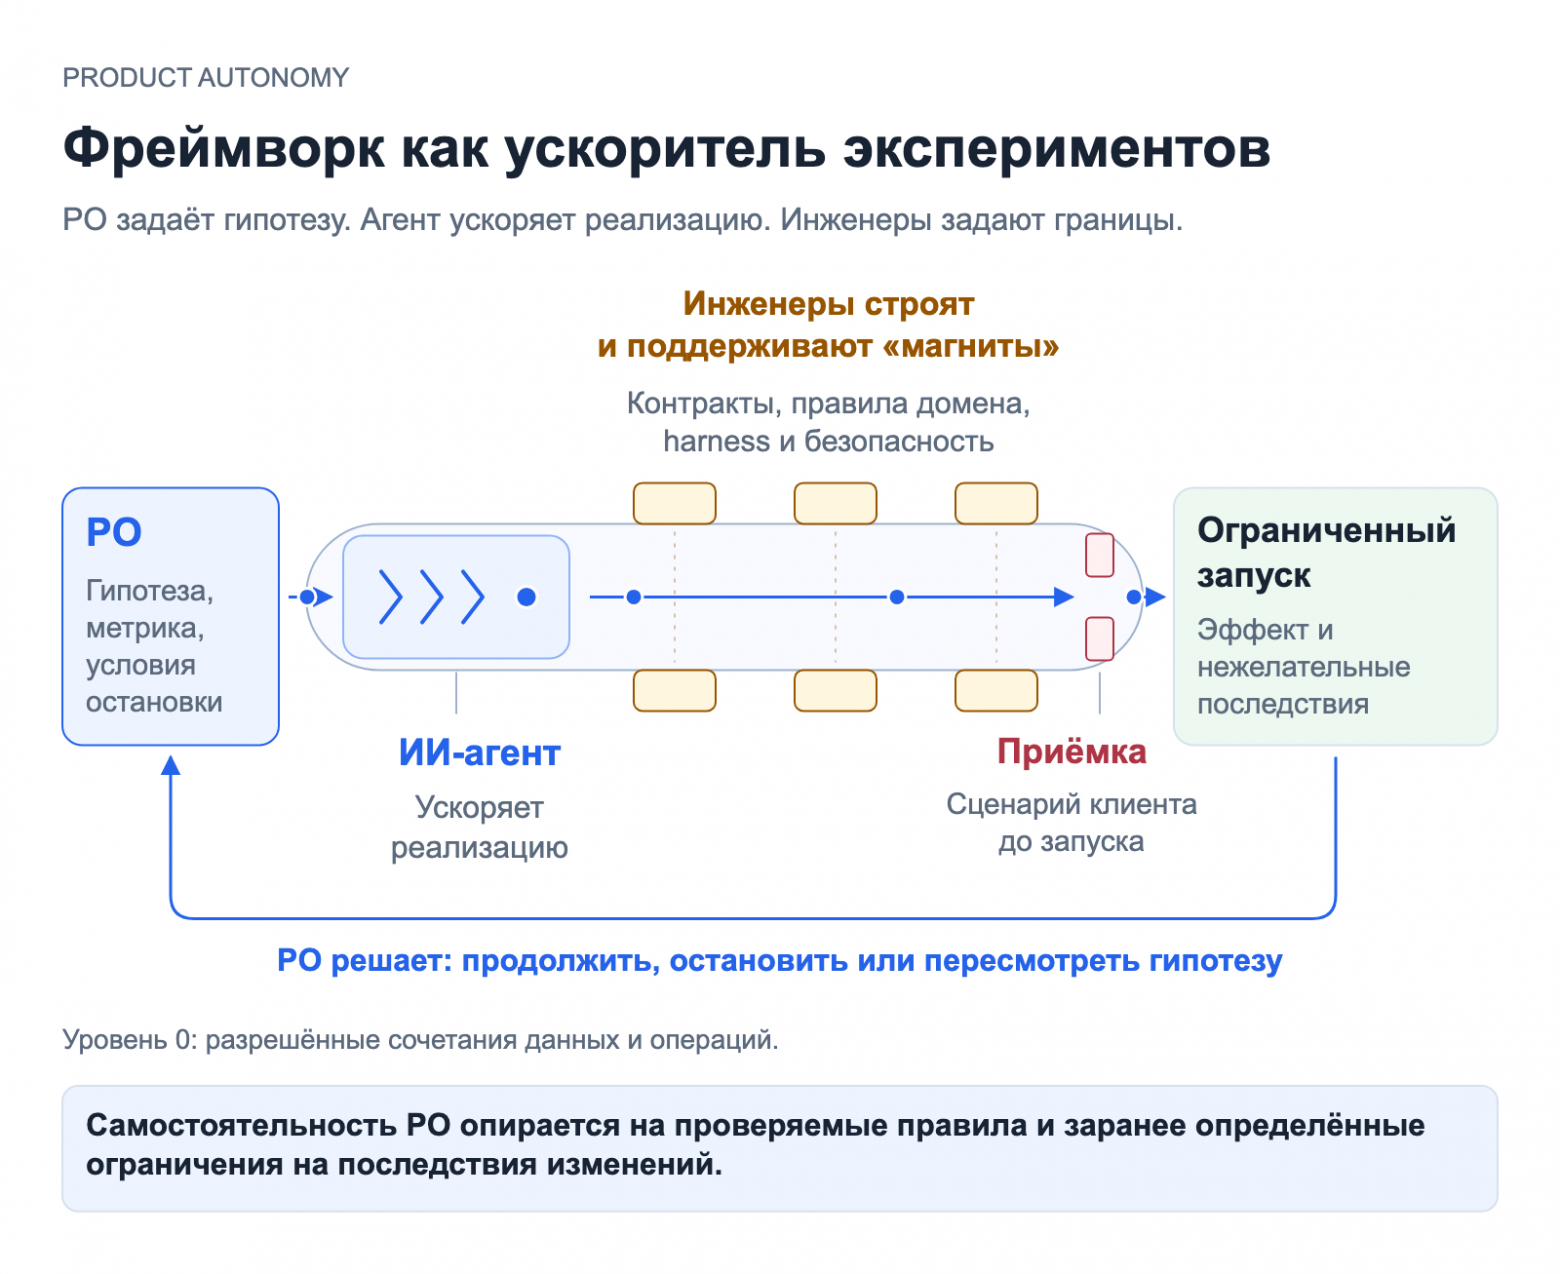
Harness подчиняется нескольким простым правилам. Агент, который меняет код, не вправе ослаблять проверки этого кода. Модель и проверки меняют инженеры, которые за них отвечают, и ревью у таких изменений отдельное. Сами проверки тоже проверяют. У инженеров есть заготовленные примеры: правильное напоминание должно пройти, повторная отправка должна быть отклонена, а попытка добавить в сценарий списание денег должна быть остановлена, пока ее не посмотрит инженер. Наконец, проверяют ровно ту версию сервиса, которую получат клиенты. Если после проверки что‑нибудь изменили, проверять надо заново.
Модель никогда не бывает полной. Поэтому инженеры заранее очерчивают периметр: какие данные видят PO с агентом, какие операции им доступны, что они могут менять. Сначала появляется периметр, который можно проверить, и только потом право в нем работать.
Что PO решает сам
Одной меркой все изменения мерить нельзя. Если мерка рассчитана на подключение нового банка, то и текст напоминания придется согласовывать как подключение банка. Я делю изменения на три уровня.
На нулевом уровне модель домена не трогают. PO меняет текст, экран и условия, при которых продукт обращается к клиенту, и пользуется только теми данными и операциями, которые в модели уже описаны. Сценарий остается в согласованных пределах по аудитории, по обязательствам перед клиентом и по допустимым последствиям. Наше напоминание относится как раз сюда, если отложенная отправка, отмена после пополнения и защита от повторов уже есть, а движение денег не меняется. Такое изменение PO после проверок и приемки запускает сам и сам решает, расширять ли аудиторию. Есть одна оговорка: когда меняется то, что мы обещаем клиенту, эти пределы надо пересмотреть, даже если данные и операции прежние.
На первом уровне меняется модель, но в пределах одного домена. Допустим, для эксперимента нужно знать, доставлено ли сообщение, а сервис уведомлений этого пока не сообщает. Тогда доменный инженер разбирается, что новый статус изменит в поведении домена, дополняет модель и проверки, договаривается с владельцем сервиса. Когда все готово, эксперимент ведет PO.
На втором уровне меняются правила движения денег, открывается доступ к чувствительным данным или подключается внешний партнер. Новый банк в кошельке относится сюда. PO ставит продуктовую задачу, а решение прорабатывают доменный инженер и владельцы всех затронутых систем. Если нужно перестроить взаимодействие систем, зовут архитектора. Если меняются правила доступа к чувствительным данным, зовут специалистов по безопасности. Владельцы систем до запуска подтверждают, что все готово, и определяют, на каких условиях выпускать изменение и как восстанавливаться после отказа. Запускать ли на этих условиях, все равно решает PO. А готовой интеграцией потом пользуются в экспериментах нулевого уровня.
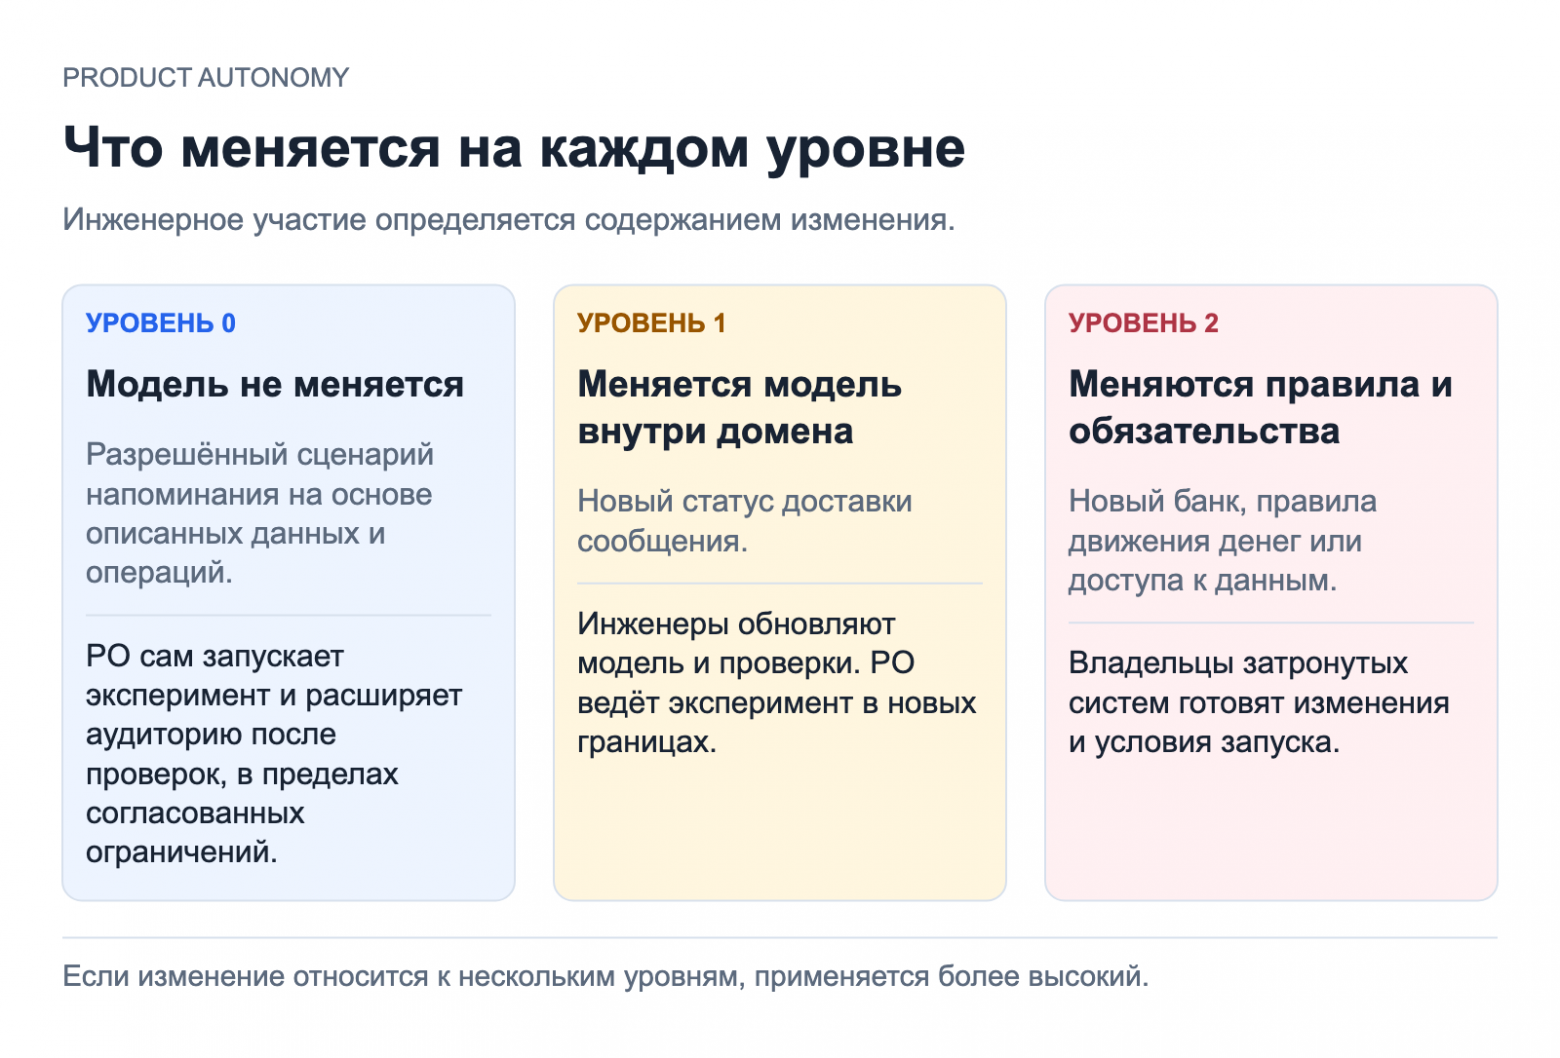
PO сам называет уровень изменения, но на слово ему не верят. Harness сверяет то, что изменилось на самом деле, с тем, что на этом уровне разрешено. Если они расходятся или проверить не удалось, выпуск останавливается, пока изменение не посмотрит инженер. Если изменение подходит под два уровня сразу, действует старший.
Кто еще нужен
Один PO с агентом всего этого не вытянет, поэтому рядом с ним остается команда.
Доменный инженер отвечает за работу сервисов и за модель своего домена, будь то деньги, карты или идентичность. Он расследует инциденты, а после срочного исправления добавляет проверку, которая в следующий раз поймает такую ошибку. Там, где интеграций много, часть его работы забирает отдельный инженер контрактов. Он занимается договоренностями с партнерами, вплоть до подробностей, от которых зависят деньги. Ответ банка «принято» значит, что перевод прошел, или только то, что заявку взяли в работу? От этого зависит, когда клиенту можно зачислить деньги.
Инженеры платформы делают то, что нужно всем доменам: агентные инструменты, песочницы, движок проверок, дизайн‑систему, оболочки приложений, управление запусками.
Тестировщик подключается, когда эксперимент еще только описан, и проходит сценарий целиком раньше, чем его увидит первый клиент. Повторяющиеся сценарии он переводит в автоматические проверки. Тест может написать и агент, но убедиться, что тест ловит нужную ошибку, должен человек.
Аналитик данных помогает выбрать метрики и аудиторию и разобраться в результате. Кто‑то ведет общий журнал запусков: чей эксперимент, когда принимать по нему решение, при каких условиях останавливать. По этому журналу служба эксплуатации видит, что сейчас включено, как это выключить и кого звать, если сломалось.
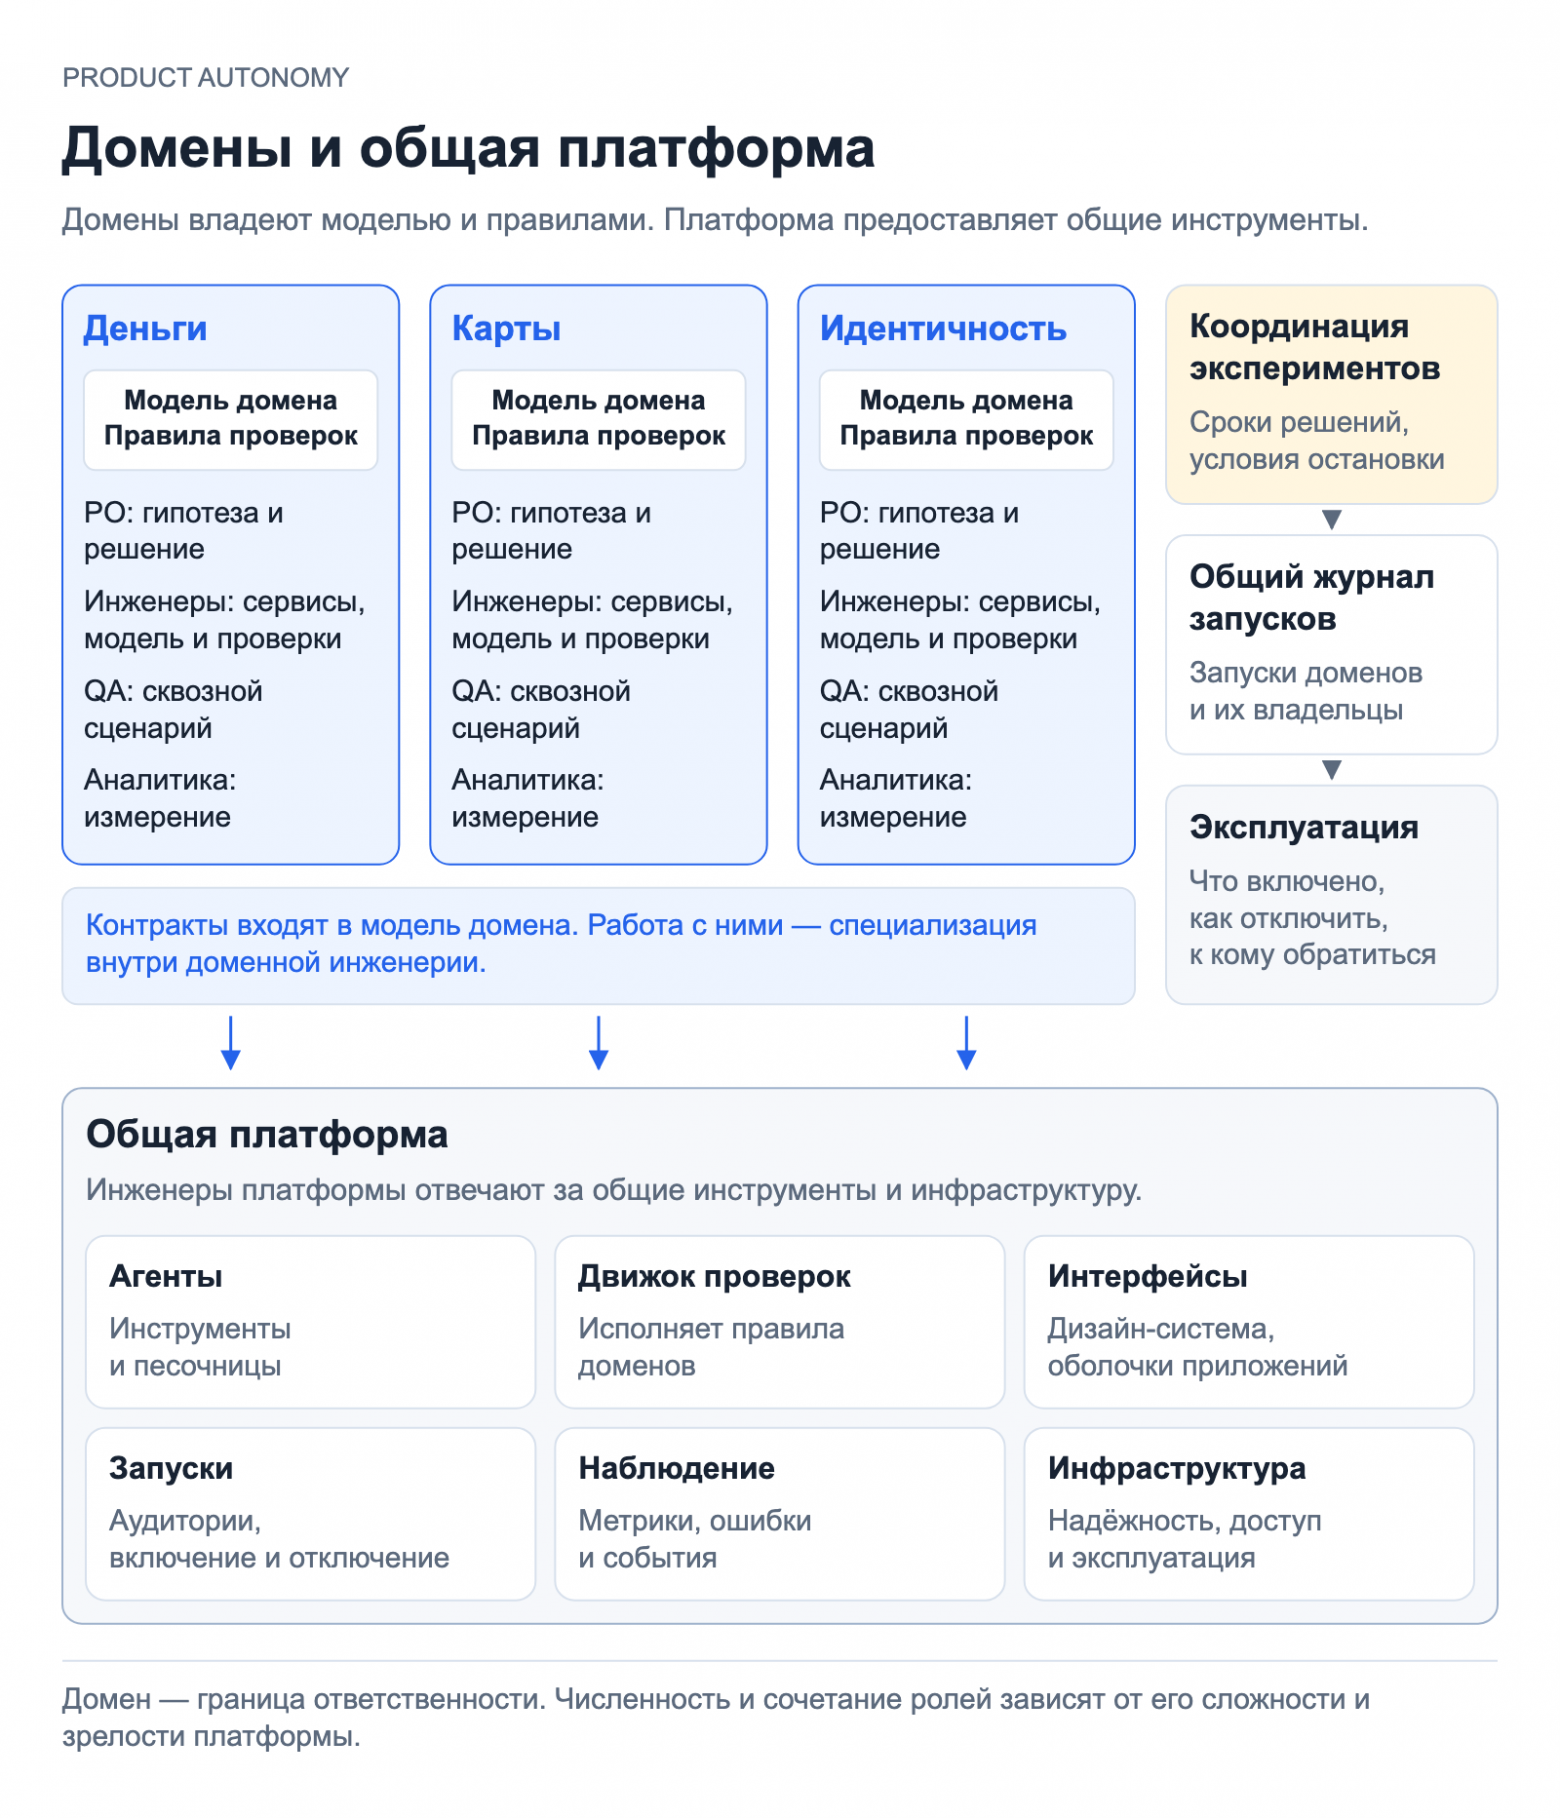
Сколько на все это нужно людей, зависит от сложности домена и зрелости платформы. Один человек может совмещать несколько ролей. Неизменно одно: модель, проверки и список разрешенного агенту меняют только инженеры, которые за них отвечают.
Где это не сработает
У подхода есть условия применимости и есть цена.
Нужен домен, у которого ясны границы, описаны контракты и есть инженеры, которые за него отвечают. В старой системе модель придется восстанавливать по коду, документам и памяти людей. Черновик напишет агент, но сверять его с действующими договоренностями и с настоящим поведением системы будут инженеры домена. История трафика поможет найти расхождения, но всех случаев в ней нет.
PO может ровно столько, сколько позволяет платформа. Если тексты и состав экрана в мобильном приложении уже меняются удаленно, через настройки, он этим пользуется. Если нужна новая функция в самом приложении, ее сначала делают инженеры и выпускают обновление, а эксперимент увидят только клиенты с новой версией.
PO легко перегрузить. Сборкой тоже надо управлять, и время на это отнимается у изучения клиентов. К тому же ему теперь нужно уметь ставить задачи, разбирать результаты и отказываться от собственной идеи.
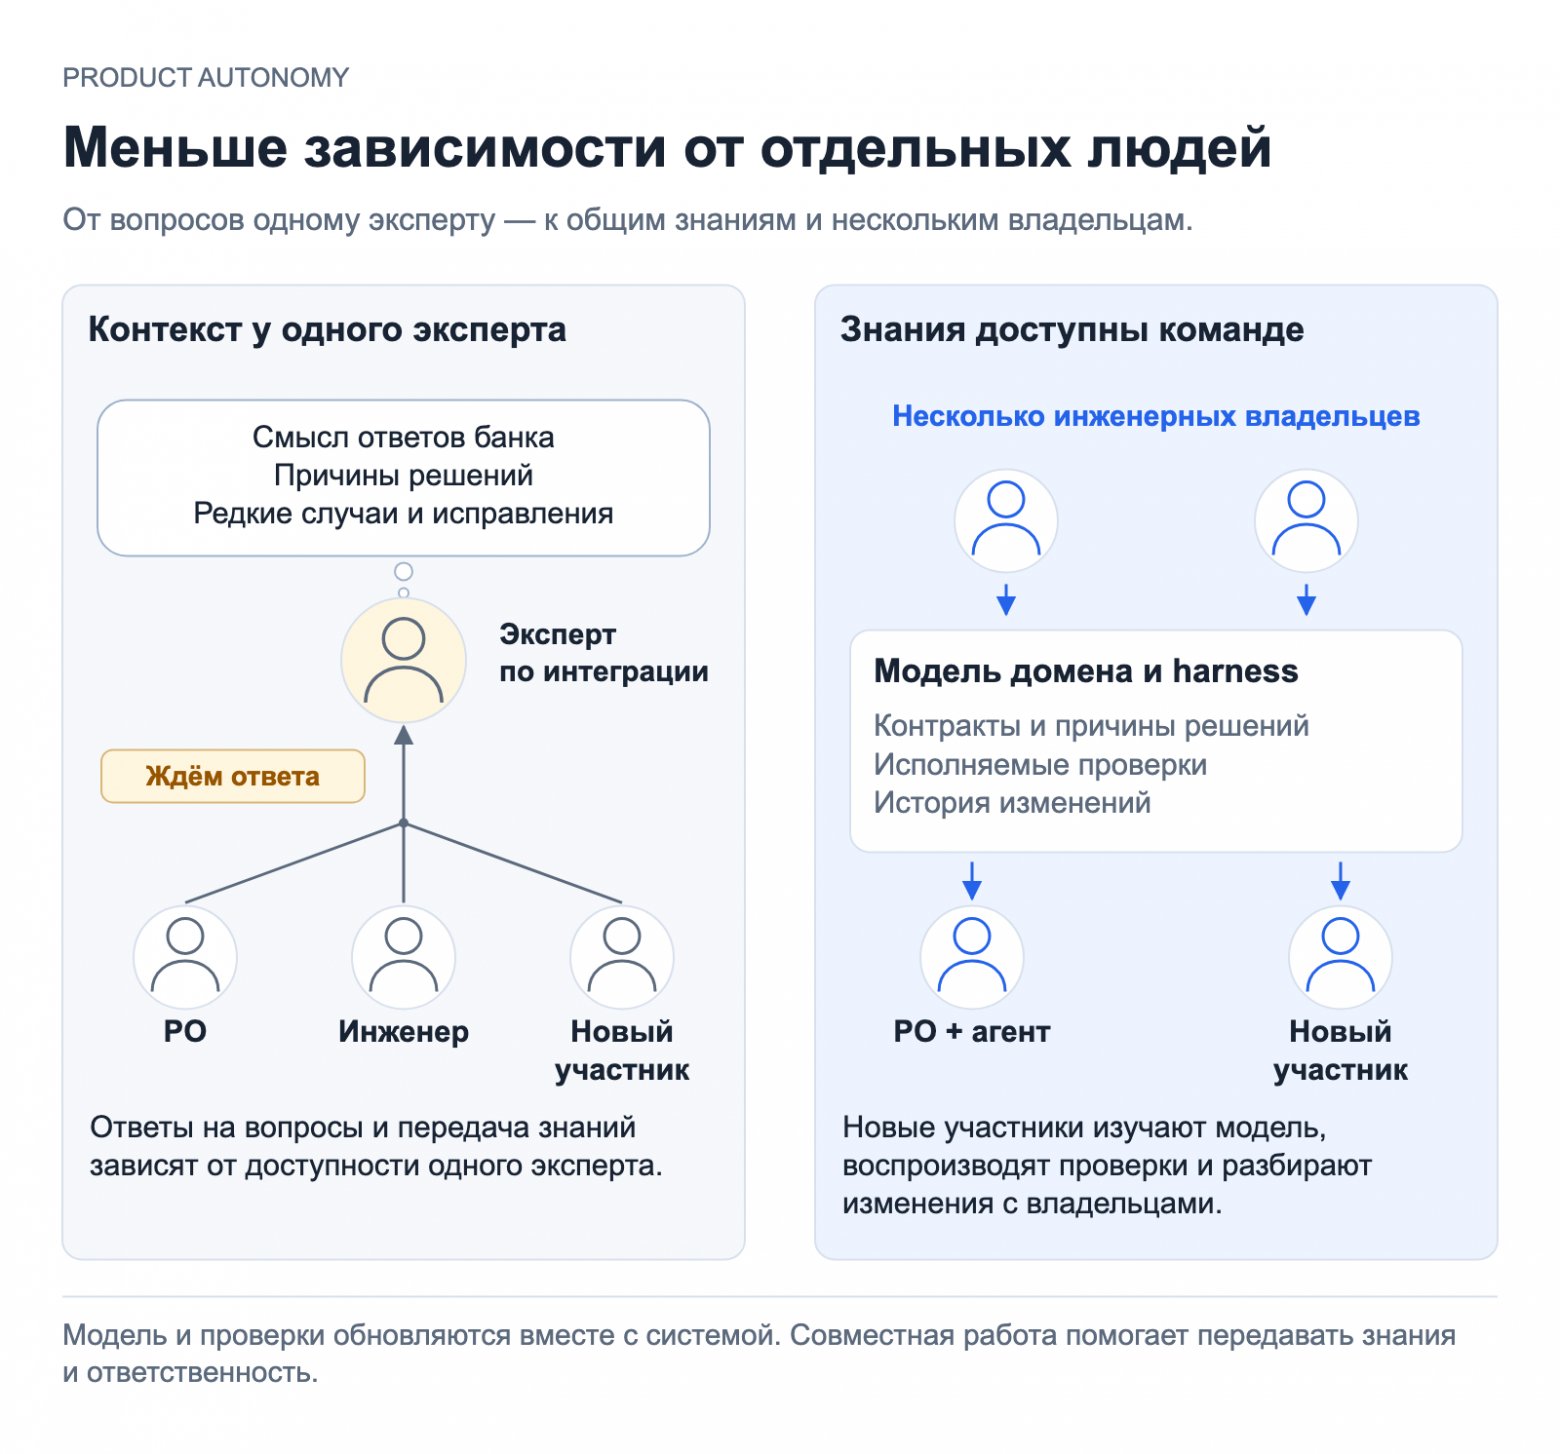
С записанной моделью команда не зависит от человека, который один помнит, как устроена интеграция. Но если саму модель понимает один инженер, мы всего лишь поменяли одного незаменимого на другого. У ключевых подсистем должен быть второй владелец.
Платформа может сама стать узким местом. Если ее надо дорабатывать под каждый эксперимент, очередь выстроится уже к инженерам платформы. Содержать ее тоже недешево: модель и проверки надо поддерживать, агенты и песочницы требуют вычислительных ресурсов. Все это окупается, только если экономия на повторной работе превышает новые расходы.
Наконец, harness проверяет только то, что описано. Если в модели чего‑то нет, проверки пройдут, отчет будет зеленым, а дыра останется. Зеленый отчет говорит о проверках, которые есть, а о тех, которых нет, молчит. Поэтому инженерам и дальше придется сверять модель с работающей системой и разбирать случаи, которых никто не предвидел.
Что осталось нерешенным
Труднее всего определить, где PO перестает действовать сам и должен позвать инженера. Эта граница зависит от того, насколько система изучена, как устроена платформа, насколько надежны проверки и во что обойдется ошибка. Чем лучше инженеры делают свою часть, тем дальше эта граница отодвигается.
Это первая версия подхода. Предлагаю обсудить, где проводить эту границу и как ее сдвигать.
