Комментарии 75

Qwen 3.8 flash next на strata попробуйте, должно быть пободрее

Спасибо) В LM Studio Flash-Next UD-Q2_K_XL не поместилась в бюджет памяти даже на 8K. А через Strata запускали именно на StrixHalo?
Нет, но было бы интересно узнать как на вашем железе. У меня х3 к скорости токенов по сравнению с 27b. А еще у нее меньше расход токенов поэтому выходило существенно бодрее.
В моей коробочке 96gb . LM Studio насчитал для Next 78,3gb даже при контексте 8K, а под модель оставалось 72,5gb. Попробую ужать систему и всё-таки впихнуть её через Strata. Самому интересно, что выйдет)
я запускал на 16гб врам + 64рам, в q3
и 200к контекста
хм, буду пробовать, спасибо большое

Не пробуйте Strata. Он быстр спору нет, но также нет стабильности. Пара тройка успешных и быстрых проб не компенсирует глубочайшего разочарования от регулярного неадекватного поведения. Посмотрите в сторону https://github.com/peonist-ai/halogen-flash-server . Вроде как есть удачные конфиги и для версии 96Gb. Сам пользуюсь больше месяца в связке с hermes. Текущая скорость выдачи в среднем 65 т/с и обработка промта на всем протяжении сеанса почти всегда 2к т/с. Пользую Beelink GTR9 Pro AI Max+ 395 (128Гб)

А а как проявляется нестабильность? Просто у меня Strata уже около месяц наверно работает практически круглосуточно, проблем с ней не больше, чем с llama.cpp. Или это специфические проблемы для AI Max+ 395? (У меня CUDA).
Допускаю, что нестабильность зависит от условий использования и проявляется по разному. В моем случае это игнорирование навыков или применение не уместных, для поставленной задачи. И этому даже есть объяснение https://www.mauriziofonte.it/blog/post/local-llm-deterministic-output-temperature-zero-llama-cpp-reproducibility.html в тексте есть еще ссылки на тесты Strata и замечания, где он неплох. И да, гонял тоже на CUDA (4080).

Что-то сомнительно. Strata подобно китайцам, берётся без споров за самую жёсткую экономию. Если у вас 32Гб рамы, и они ещё чем-то заняты были, то он скачает однобитный квант и алга! Проверяли, что именно он у вас крутит?

Мне кажется статья вообще не про это, а про особенности вычисления floating point чисел на разных устройствах в одном промпте и со спекулятивным исполнением, из-за чего float-ы могут чуть съезжать. А применение навыков мне кажется надо потвикать и взять другую версию модели. У меня вот эта Swift вариация вместо дефолтной которую Strata предлагает показала себя лучше и стабильней (там вроде как чуть по разному router веса квантованы) - дефолтная постоянно любила подсовывать вообще различные иероглифы в аутпут, тогда как Swift вариация ни разу такого не сделала.

Скромный вопрос, а чем занят что работает круглые сутки ?) я пока такие самохостинг модели не нашел чем загрузить)

Эли студия для начала пойдет. Но если вы потратили столько денег - логично перейти на VLLM, sglang и более интересные инструменты. Чтобы можно было понять насколько эта студия ограничивает https://forums.developer.nvidia.com/t/open-source-flash1017-engine-theoretical-blueprint-to-fit-all-384-experts-of-deepseek-v4-1-flash-1017-748b-in-106-gb-ram-on-a-single-128-gb-gb10/388205 тебе самые ресурсы, что в strixhalo но 748b параметров. И скорость схожа. При этом gb10 только чуть быстрее strixhalo.

https://github.com/peonist-ai/halogen-flash-server
Для этой железки есть более оптимизированное, благодаря MoE бегает бодрее чем 27B и примерно та же сообразительность

Ышшите на хаггингфейсе. Есть варианты. Этот qwen 3.8 flash на голову интереснее всего что тут обсуждают. И дело не только в скорости (flash MOE) - она умнее.
За счёт PLE offload влезает. Искать думаю сразу вариант под strixhalo. Ещё убедиться, что rocm и т.п. оптимизации включены. Я думаю strixhalo может быстрее работать.
Но именно эти модели на strixhalo не проверял. У меня там comfyui. Эти на gb10 (чуть быстрее).

Qwen3.8 27B выдаёт 12,8 токена в секунду, а Gemma 4 26B A4B на том же железе 63, хотя файлы у них почти одного размера.
:) дальше можно не читать


На маках Qwen 3.8 Flash Next в Q3 даже в 64 гига влезает. В Q4 уже в 96 (хотя я гонял и на 64, но 20 токенов в секунду было маловато). Поэтому крайне рекомендую к эксперименту именно эту модель. Вам главное движок найти который с AMD дружит.

Извините, но это очередное оторванное от современной реальности и бессмысленное тестирование. Когда читаю подобные статьи на хабре, то как будто на год назад во времени возвращаюсь. Неужели автору сложно реддит почитать и выяснить что на сегодняшний день актуально?

А что актуально?
Или уже вышла qwen 11.2 или Gemma133?
Сейчас актуальны Qwen3.8-27b и Qwen3.8-Flash-Next. А также Qwen3.6-35b, с некоторыми оговорками, для машин с 16 ГБ памяти. Gemma4 смысла не имеет, так как уступает Qwen3.8 почти во всем. Gpt-oss уже давно пора закопать.

Мир не заканчивается на одном программировании. Для текстовых документов Gemma4 на голову побивает Qwen3/8-27
Я с Вами не соглашусь. У меня Qwen (модель Qwen3.8-27b-q8_k_xl) отлично работает с текстовыми документами, ничем не уступает Gemma4 31b.
Я сейчас пересматриваю пачку корпоративных СТО. Qwen прекрасно находит нестыковки в деталях. Но Gemma как будто лучше понимает смысл: она может предложить решение, которого изначально не было в тексте, но которое решает задачу. Причем, еще и формулировки и названия точнее попадают в ГОСТовские. Конечно, я не берусь утверждать, что всегда и везде она лучше. Тут Вы правильно меня осадили, не стоило обобщать, я погорячился.
На самом деле я пришел к выводу, что самое главное в локальных моделях - навык умения работать с инструментами (tools, skills, MCP, RAG-базы знаний и т.д.). Любой недостаток модели в виде сырых знаний в любой области можно с лихвой компенсировать подключением инструментов и и постоянным наполнением базы знаний. Я выстроил иерархическую базу знаний на основе Obsidian для своей модели, которая уже включает несколько сотен отдельных документов. Например, по каждому моему ИТ-сервису, по каждому гаджеты, компьютеру и устройству, объектам Home Assistant есть отдельная заметка-справочник. Эти заметки создаёт и структурирует сама LLM (например, я ставлю ИИ задачу: на таком то IP у меня работает Jellyfin, вот логин/пароль, подключить, проведи подробный анализ данного сервиса и по итогам создай структурированный справочник заметку). Таким образом, по любой сущности у меня создана заметка - справочник. Если с какой то сущностью/сервисом требуется техническо сложное взаимодействие, то LLM создаёт для этого отдельные инструменты (а в некоторых случаях отдельные MCP-серверы).
В итоге, самым главным качеством модели становится работа с инструментами и знаниями. А это качество как раз у Qwen3.8 развито на очень высоком уровне, гораздо лучше чем у Gemma4 и других моделей.
В данный момент чем более подробной становится моя база знаний и чем более детальнее инструменты тем умнее в практическом смысле становится модель. Сейчас уже на уровне что я просто не вижу смысла использовать большие облачные модели в 90% случаев
Да нет, каждый день что-нибудь спрашиваю у Qwen и Deepseek на официальных сайтах, работать можно, но тексты бы им точно не доверил. Странные иероглифы, слова и предложения проскакивают постоянно.
Вот только что мне выдал такую фразу в начале диалога:
"Что happens без этой настройки?".
"Какие запросы считаются биллингуемыми?"
Причем выбираю Qwen3.8-Max или Qwen4 Max Preview, боюсь даже представить, что выдают квантованные и жутко заооптимизированные модели. Хотя для локальных и открытых моделей это может сильно.

Напишите пожалуйста статью по актуальным железкам и моделям. С удовольствием почитаю. Да и другим наверное интересно будет.
Про ту же Strata и на Хабре есть статьи. Но многие авторы прежде чем начать писать даже не читают, что уже написано до них и раз за разом пытаются изобрести велосипед.
Да я согласен с этим. Я в целом без сарказма. Мне интересна тема локальных LLM начиная с маленьких доступных для запуска на мини-ПК усилиями CPU+RAM для например управления умным домом Home Assistant без доступа в интернет и переходя к моделям посильнее для самых разных задач уже на пользовательских или серверных ПК. Поэтому с удовольствием читаю такого рода статьи и мне интересен опыт других энтузиастов. Хотя бы потому что самому нет возможности перепробовать все интересные комбинации железа в виду ограниченности ресурсов (время, деньги).
В оригинальном репозиторий hf у Google есть и модель и q4 версия и файл для активации MTP
Очень интересно, какие задачи бывают медленными, причем в таком количестве, чтобы нужно было создать процесс
Про MTP спасибо, не знал что у гугла лежит отдельный файл для активации. У меня на скачанных ггуфах он просто не включился, попробую с гугловским)
А медленные задачи... Один бот сидит редактором ленты, читает посты из источников на разных языках и пишет по ним короткие карточки на русском с проверенной ссылкой на источник. Скорость там вообще не волнует, волнует чтобы цифры и имена не переврал и ссылку не выдумал. Прямо сегодня прогнал на настоящих постах, Qwen3.8 накосячила в 2 карточках из 26, Gemma в 10 из 30 . Второй бот оператор в hermes desktop, ему даю поручения на несколько шагов (по сути бегает между окнами винды и нажимает кнопки). До конца Qwen довела 13 из 18, Gemma 3 из 18. Так что подождать лишнюю минуту мне не жалко. Ну и архив артефактов по ночам разбирать собираюсь, там пусть хоть час думает, индексирует, пишет карточки, помечает актуальность версий.

эту лучше гоняй nvidia/Qwen3.8-Flash-Next-FP4-Local на движке vllm. В инете есть форки vllm чтобы можно было запускать в nfp4 + KV в fp8 + n-gram с SSD. Скорость на твоем железе будет около 30-35 ток/с может и выше. Strata, хоть и быстрый движок, но качество на длинных контекстах 130к > заметно теряется, пробовал на практике на своей DGX Spark 128Gb.
Всем спасибо за наводки, записал себе три варианта, Strata, halogen-flash-server и vllm с fp4. Движки я в этот раз не сравнивал вообще, всё гонял через LM Studio на вулкане, потому что он уже стоял. Похоже, зря)
Про Strata у вас тут мнения разошлись, у кого месяц без проблем, у кого качество на длинном контексте сыпется. Длинный контекст как раз мой больной вопрос, задачи на 100к и 200к у меня уже есть, прогоню на них и посмотрю сам. Не уверен только, что vllm заведётся на амдшной встройке, но попробую. И Flash-Next в Q3 попробую впихнуть, в LM Studio она у меня даже в Q2 не влезла. Этож опыт)

и Windows снеси - поставь Ubuntu, под модели будет 90гб - а вижу, уже, тогда не забудь gtt в параметрах kernel и минимум в bios (512mb или 1gb)
sudo nano /etc/default/grub
GRUB_CMDLINE_LINUX_DEFAULT=“quiet splash amd_iommu=off amdgpu.gttsize=92160 ttm.pages_limit=23592960"
sudo update-grub
sudo reboot

И ещё можно gufo попробовать. Он чуть медленней halogen, но зато опенсорсный, поддерживает примерно те же плюшки (например, использование NPU), и при этом использует общедоступные GGUF, а не галогеновский специфичный формат (не надо модельки перескачивать). Плюсом ещё идёт работа с qwen image, если требуется.

Странно, работаю на страте (сейчас стоит предпоследняя версия) уже 2 месяца, контекст 256к. Иногда забивается под завязку, модель Q4 - ничего не теряется, пишет чисто, даже ни разу иероглиф не вставила в русский текст. Когда что-то не ясно спрашивает, после разъяснений четко продолжает. На ранних версиях бывали вылеты, сейчас всё стабильно.

температура 0 сейчас не рекомендуется, так как ухудшает "креативность" и способность решать нетривиальные задачи. Рекомендуют вроде как минимум 0.3

Не столько даже в креативности дело, сколько в том, что всегда берётся следующий токен с максимальной вероятностью, а из-за этого модель срывается в циклическое повторение одной фразы. Т.е. модель может нормально работать с рекомендованными параметрами, а с нулевой температурой отвечать только на простейшие вопросы.
Есть ещё мнение, что финальное обучение идёт сразу под рекомендованную температуру, и с нулевой результат будет хуже. Но тут не знаю.

Купил недешевую железку и тестил таким гуаном.
К сожалению, даже 290b модели мусор - только убогие петпроекты писать.

Я через https://github.com/Yamz-Labs/kyojin работаю с GLM-5.3-Flash и Qwen3.8-Flash на такой машине (со 128Гб)
Меня вполне устраивает, квен особенно шустрый и до 500к контекста тянет (хотя лучше до 250к работать, там скорость до 50т/с, а потом снижаться начинает).
Вначале были проблемы, ROCm не видел всю оперативку, обрывался на 50 с чем-то Гб, пришлось выделить 1Гб под видеопамять в биосе, после такого хака смог настроить.
Вулкан не пробовал, писали там медленнее.
Сейчас 190 появляются, туда в теории можно дипсик запихать, но работать, наверное, медленно будет.
О, такая же машина) С памятью у меня была похожая история. Пока под видео было жёстко отдано 48 гигов, линуксу оставалось 45 оперативки и толку не было. Убрал выделенную до минимума, у меня сейчас 0,5, остальное отдал через gttsize и ttm.pages_limit, теперь памяти стало хватать. Только я на вулкане, ROCm вообще не трогал. А Qwen3.8-Flash у вас в каком кванте, что до 500к тянет?
Брал оттуда же, с https://huggingface.co/yamz-labs/Qwen3.8-Flash-Next-EXL3-Yamz, написано что EXL3. Хорошо, что у вас в биосе можно 0.5 поставить, у меня минимум 1, в fevm faex9. Я вулкан не пробовал, поверил китайцу что ROCm быстрее будет, немного повозился со сборкой, но в конце-концов запустилось. Было бы интересно сравнить, действительно ли есть разница.
Vulkan медленнее Rocm, вот в этой сборке оба быстрые https://github.com/halo-box/strix-llama.cpp/releases/tag/v1.0.0 (но Vulkan всё равно слабее и ему нужны свежие RADV драйвера)
Strata поставьте, будет гораздо бодрее и модель посерьёзнее загрузите.

А подойдёт эта железяка для запуска моделей для генерации картинок или коротких видео? Кто-то пробовал?
Не особо, там MoE модели лучше всего идут. Картинки генерить еще туда-сюда, есть решения, если поискать, но видеокарта хорошая будет быстрее. Видео хз, наверное никак.
Картинки генерирует без проблем (comfyUI), только медленно. Видео: в принципе - да, но я пробовал только короткие по нескольку секунд, потому что не возникало необходимости. Машинка хорошая, только надо не торопиться с ней)
Картинки гонял, да. Работает через ComfyUI на ROCm под линуксом. Z-Image-Turbo выдаёт 1024 на 1024 секунд за двадцать, качество мне очень нравится. Qwen-Image 2512 заметно тяжелее, минут восемь на такую же картинку, но и творческая составляющая там выше, прямо скажу. Главное подать нормальный текстовый промпт, у меня его сначала пишет отдельная модель по референсу, а потом он идёт в генератор.

Картинки генерятся медленно, а еще медленнее они апскейлятся. Медленее 3060 12гб. Видео поинтереснее, потому что можно не пытаться экономить память, но скорость все равно не блещет.
От тестов Ryzen AI Max+ 395 с 96 ГБ памяти ждёшь совершенно другого. Этот сетап интересен в первую очередь запуском "больших" моделей, которые не помещаются на 1-2 видеокартах. То есть интересно в первую очередь использование преимущества большого количества универсальной памяти. Например, запуск Qwen3.8-27b в максимальных квантизациях q8_k_xl, с максимальным контекстом 262k и минимальным его сжатием (bf16). Или Qwen3.8-Flash-Next в Strata. Но, открываешь статью и видишь gpt-oss 20b, квантизацию q4 и мизерный размер контекста (facepalm).
Про большую память согласен, Q8 с кэшем в bf16 я правда не пробовал, вероятно попробую, спасибо. А контекст в статье не такой уж маленький, окна до 256к и вход до 200к, это раздел про длинный контекст. Я шёл от своих автономных цепочек задач, и у меня пока ни одной не нашлось, которой нужно больше 128к. 200к гонял так сказать на перспективну...
А у меня практически нет задач, которые бы потребляли меньше 100 тыс токенов. Более половины задач не укладываются в 262k токенов - организовал автоматический handoff в новую сессию. Есть задачи которве решаются за 5-7 таких сеансов по >200k токенов. Для меня сейчас самый большой недостаток локальных моделей - мизерный контекст в 262k токенов(((
Lm Studio надо оставить секретаршам.
Есть такой же Unsloth Desktop, только честный опенсорс, умеет больше, и может на лету выгрузить говорилку, чтобы погенерить картинок или речь, и загрузить говорилку назад.
А ещё лучше Strata. Вот мои результаты на Strata, ничего не крутил, запустил по умолчанию в Podman, 4090 и 64Gb DDR4.
Qwen-Next-Flash, Q_3_S — 50 т/с
DeepSeek 4.1, 2.00 bpw — 10-15 т/с
Первый нормально агентит, второй нужен только чтобы тексты писать по заданию, так что тоже сойдёт.

Плотная Qwen3.8 27B выдаёт 12,8 токена в секунду, а MoE-модель Gemma 4 26B A4B на том же железе 63, хотя файлы у них почти одного размера.
Тут сквозит некоторое удивление, но очевидно же, что размер модели тут совершенно ни при чём. Я на железках послабее запускал для сравнения qwen3.8:27B и qwen3.6:35B A3B, и у второй скорость гораздо выше. Кстати на HF уже давненько валяется MoE qwen3.8:35B - не официальная, правда. Но Gemma штука в целом всратая,тут любой другой вариант сгодится лучше.
Погонял бенчи для нескольких моделей от unsloth на beelink gtr9 pro ai max+ 395 со 128Гб унифицированной памяти, Ubuntu, бэкенд llamacpp + Vulcan, результаты такие получились
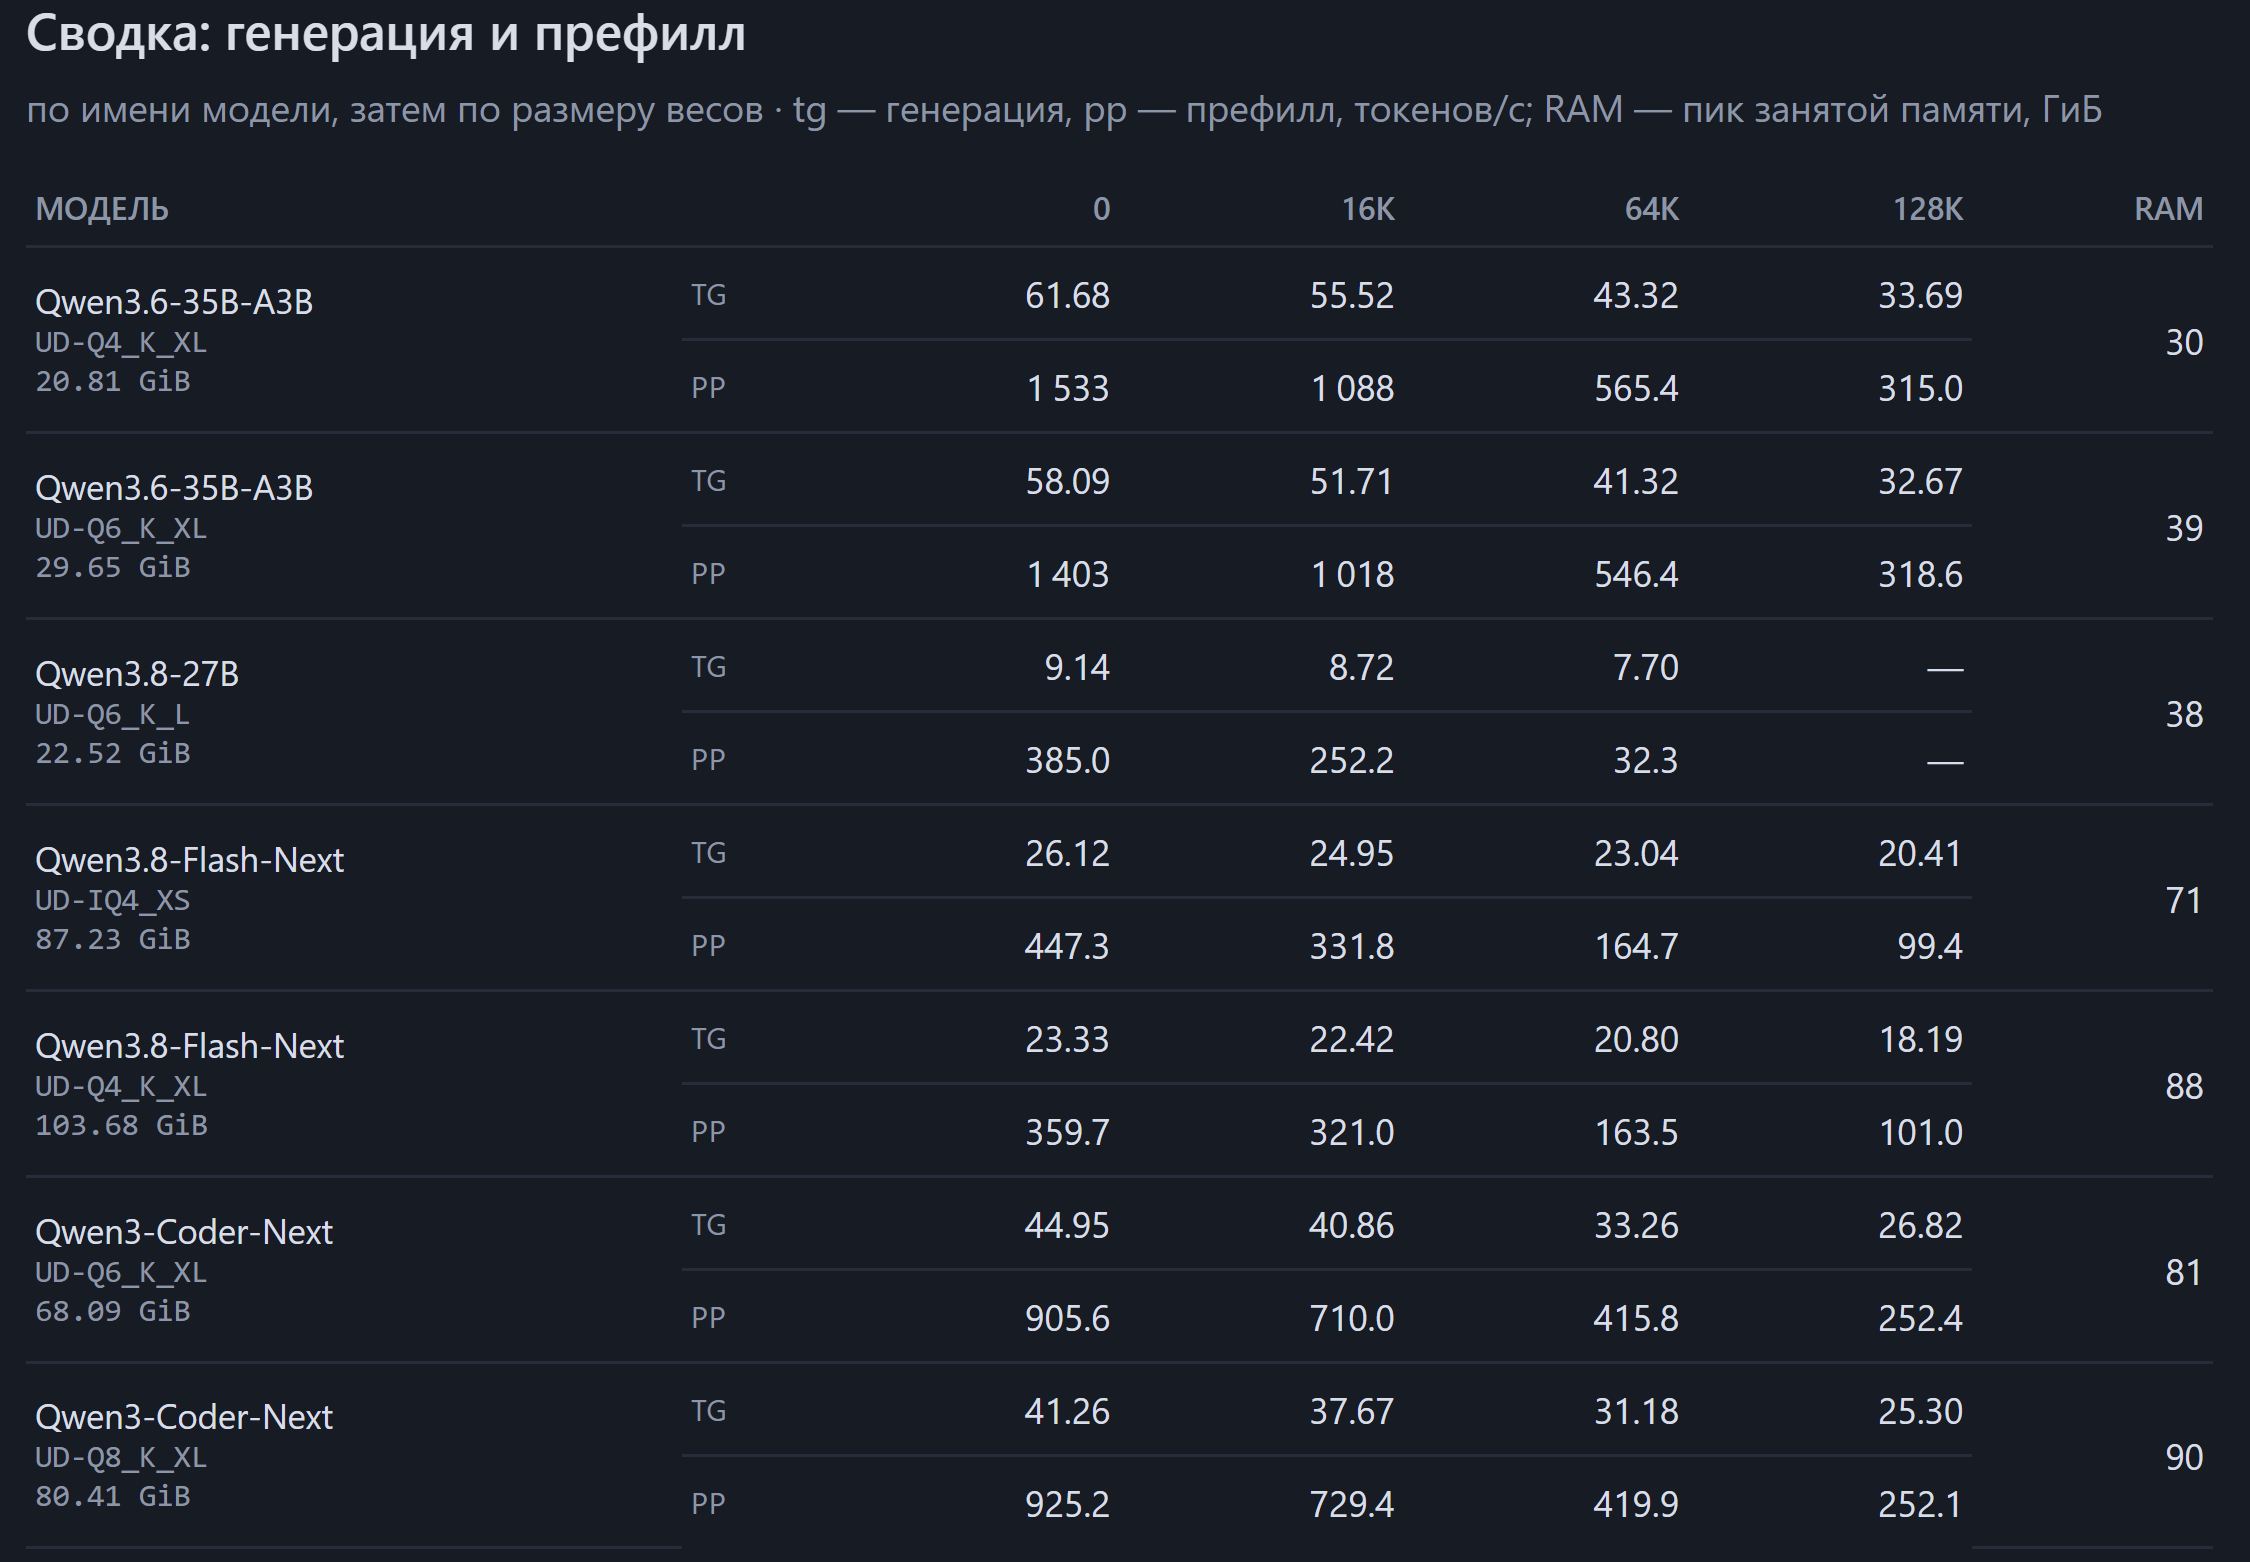
Возможности дальнейшей оптимизации пока не исследовал, тесты бежали подряд, каждый бенч 3 повтора.
Спасибо) очень кстати, тот же чип и тоже вулкан. Цифры сходятся с моими, у меня Qwen3.6 35B A3B в Q4 давала 53,5, плотная 27B в Q4 12,2. А вот Flash-Next у вас 26 на обычном llama.cpp, а выше люди пишут про 50-60 на halogen. Вот эту разницу и хочется проверить. IQ4_XS на 87 гигов в мои 96 не влезет, буду смотреть Q3.

Попробуй вместо LMStudio использовать Strata
Самый оптимизированный движок под 395+ - это halogen, его уже советовали выше. Он писался специально под эту железку. Что-то другое тыкать особого смысла нет. Бонусом идут мелкие модели типа decider или генерации картинок на NPU, но включение NPU само по себе просаживает скорость генерации большой модели, так что тут палка о двух концах.


Кто-нито тестил Recursive Flint? Вроде как специально заточен для кода и агентстких задач. И именно на таких действительно очень хорошо у меня себя показал. Лучше, чем Qwen Next. Возможно потому что сам по себе меньше, и можно использовать более выскокую квантизацию, чем у Квена. А для агентских задач как раз точность важна.
Флинта я смотрел в "нулевом заходе", чуть раньше. Скорость отличная, 70 ток/с на коротком, под 47 на 56к, длинный вход до 64к прошла чисто. Формат держала хуже, 51 из 60 против 59 у Qwen3.8, пару раз обрывала ответ. А до задач с инструментами просто не дошла, я тогда как раз перекраивал методику, и в новую серию взял других, хотя наверное, стоило бы взять и флинта.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Неделю гонял 14 локальных LLM на мини-ПК с Ryzen AI Max+ 395. Цифры, грабли и что я оставил себе