В прошлой статье я обещал рассказать, как семь агентов превращают голосовое сообщение из цеха в черновик задачи. Сел писать и понял, что обещал не совсем то, что есть на самом деле. Семь агентов в системе есть, я собрал их первыми. Но задачу, которую я надиктовываю в цеху, разбирает один маленький агент, а большой конвейер сейчас стоит без дела.
Так что расскажу про оба: как устроен конвейер из семи агентов, сколько стоил и сколько ехал один его прогон, какие баги в нём сидели друг в друге, как матрёшка, и почему для телефона я сделал отдельного агента, который обходится в десятки раз дешевле.
Зачем вообще семь
Идея была такая. На производстве сообщение может прийти о чём угодно: «на третьем станке опять течёт», «кончились подшипники 6204», фото накладной от поставщика, чертёж в PDF, просьба выточить деталь. Человеку некогда выбирать, в какой раздел это положить. Он просто пишет или говорит, а система сама понимает, что это, и готовит черновик действия: замечание производства, дефицит, приход на склад, задачу.
Одному промпту я такую работу доверять не хотел. Слишком разные входы и слишком разные выходы. Поэтому разложил её по ролям:
Агент | Модель | Что делает |
|---|---|---|
Нормализатор | Haiku 4.5 | приводит входящее к одному виду: текст, вложения, откуда пришло |
Классификатор | Haiku 4.5 | решает, что это: например, замечание, сообщение о дефиците, накладная, инициатива, задача или документ |
Извлекатель | Sonnet 4.6 | достаёт поля под свой тип; у каждого из шести типов свой промпт и своя схема, к тексту можно приложить фото |
Составитель | Sonnet 4.6 | превращает поля в черновик действия: задачу, замечание, заявку на закупку |
Проверяющий | Sonnet 4.6 | ходит в базу через инструменты и сверяет черновик с тем, что там есть |
Агент дефицитов | Sonnet 4.6 | фоновый: SQL считает нехватку материалов под наряды, модель расставляет приоритеты |
Контролёр | Sonnet 4.6 | раз в сутки: SQL находит зависшее, модель пишет дайджест |
Первые пять работают цепочкой на каждое входящее сообщение. Два последних живут отдельно, по расписанию, и про них я уже писал в прошлый раз.
Цепочка запускается фоновой задачей Celery. На каждое сообщение ставится замок в Redis на десять минут, чтобы его не начали обрабатывать дважды. При сбое задача повторяется до трёх раз с паузами 60, 120 и 240 секунд, это спасает от временных ограничений API и от упавшей базы. Каждый вызов модели пишется в журнал: модель, токены, цена, время, уверенность. Без этого журнала у меня бы не было ни одной цифры для этой статьи.
Проверяющий ходит в базу сам
Самый интересный из пяти — проверяющий. Составитель пишет черновик со словами из сообщения: «мотор АД-1», «наряд такой-то», «конструктор». Проверяющий должен превратить эти слова в настоящие записи и найти подвох. Для этого у него есть инструменты: найти проект по коду или названию, наряд по коду, материал по марке и размеру, человека по роли или имени, открытые замечания по тому же наряду. Модель вызывает инструмент, смотрит, что вернулось, решает, что делать дальше. Кругов разрешено не больше пяти, чтобы не зациклился.
Поэтому он на Sonnet: Haiku для такой цепочки рассуждений «спросил базу, получил ответ, понял, что не сходится» я брать не стал.
Кто имеет право нажать кнопку
Ни один агент не пишет в справочники напрямую. Всё, что они предлагают, проходит через одну таблицу политик. У каждого типа действия одна из трёх судеб: применяется само, если уверенность выше порога; всегда остаётся черновиком на подтверждение человеку; или вообще запрещено агенту. Выглядит так (сокращённо):
POLICIES: dict[str, dict] = {
    "classify_inbound":       {"policy": ActionPolicy.DRAFT_BELOW, "threshold": 0.85, "confirmer_role": "admin"},
    "draft_task":             {"policy": ActionPolicy.DRAFT_BELOW, "threshold": 0.80, "confirmer_role": "designer"},
    "create_deficit":         {"policy": ActionPolicy.DRAFT_BELOW, "threshold": 0.90, "confirmer_role": "warehouse"},
    "draft_purchase_request": {"policy": ActionPolicy.DRAFT_ALWAYS, "confirmer_role": "purchaser"},
    # Только человек:
    "approve_document_revision": {"policy": ActionPolicy.FORBIDDEN},
    "consume_material":          {"policy": ActionPolicy.FORBIDDEN},
    "release_work_order":        {"policy": ActionPolicy.FORBIDDEN},
}
Утвердить ревизию чертежа, списать материал или выпустить наряд в цех агент не может никогда, с любой уверенностью. Неизвестный тип действия по умолчанию превращается в черновик, который смотрит администратор. Я считаю это главным правилом всей агентной части: модель может ошибиться, и пусть её ошибка останется черновиком. Проводку по складу делает человек.
Первый полный прогон: 22,7 секунды и 11 центов
Когда я впервые прогнал всю цепочку без заглушек, тестовое сообщение было такое: «Выточить крышки 10 шт. для мотора АД-1». Вот что показал журнал:
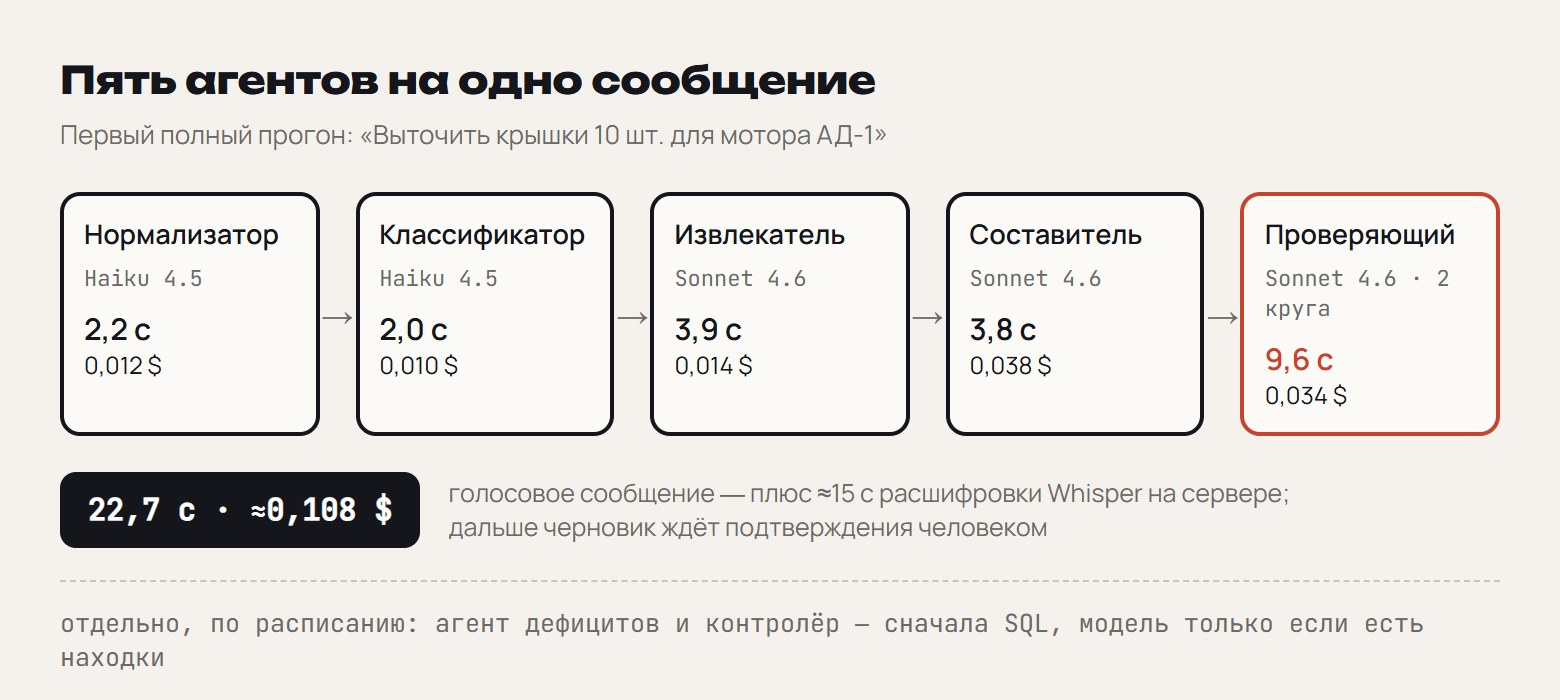
Всё вместе вышло 22,7 секунды и около 0,108 $ на одно короткое сообщение. Если сообщение голосовое, до этого его ещё расшифровывал Whisper на сервере, это примерно 15 секунд сверху. Черновик ушёл на подтверждение, я нажал «Подтвердить» в веб-кабинете, задача создалась. Проверяющий при этом нашёл одно замечание к черновику, то есть впервые реально что-то проверил. Почему «впервые», ниже.
Четыре бага, каждый прятал следующий
У проверяющего был флаг validator_skipped: если его ответ не удалось разобрать, черновик не терялся, а шёл дальше с пометкой «не проверено». Задумывался он как страховка, на деле стал одеялом, под которым жили четыре бага. Я долго считал флаг косметикой: ну не распарсился JSON, бывает. А когда начал разбираться, баги полезли по одному.
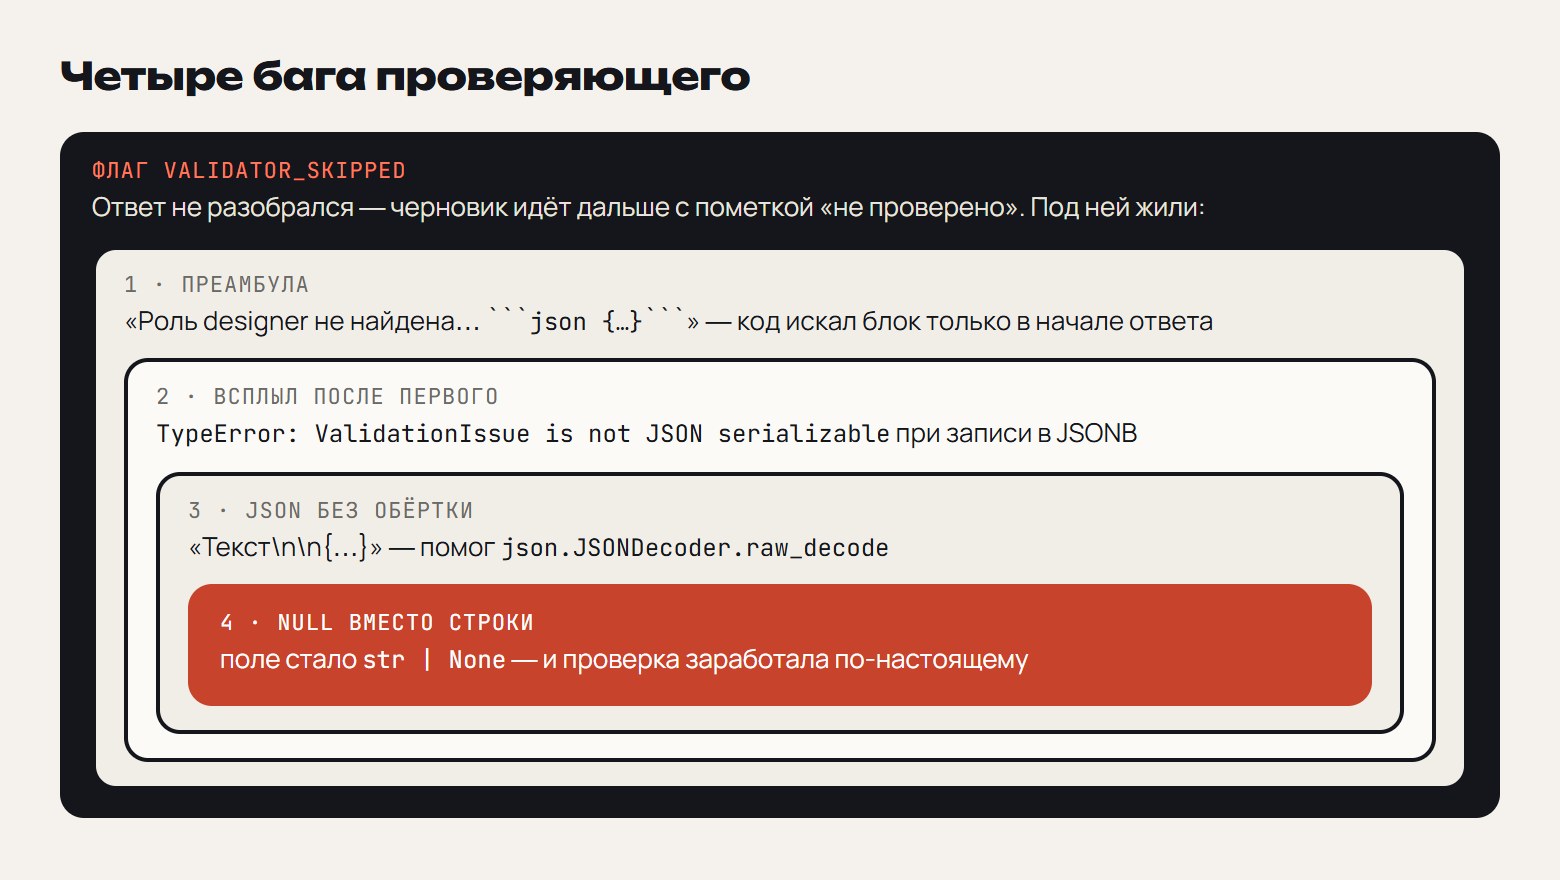
Первый. Остальные агенты отвечают через messages.parse() с Pydantic-схемой, и за формат там отвечает API. Проверяющий работает в цикле с инструментами, и итоговый JSON отдаёт обычным текстом. Модель должна была вернуть чистый JSON, но писала перед ним преамбулу вроде «Роль designer не найдена…», а уже потом блок кода с JSON. Мой код проверял, начинается ли ответ с блока кода, и не находил его.
Второй всплыл, как только я научил код находить блок в любом месте ответа. Список найденных проблем складывался в JSONB-поле как есть, а это Pydantic-объекты, и база отвечала TypeError: Object of type ValidationIssue is not JSON serializable. Раньше до этой строки просто не доходило.
Третий. Иногда модель вообще не заворачивала JSON в блок, а писала "Текст\n\n{…}". Регулярками разбирать вложенные фигурные скобки — путь к страданиям, поэтому я взял raw_decode из стандартной библиотеки, он сам говорит, где кончился объект:
def _extract_first_json_object(text: str) -> str | None:
    decoder = json.JSONDecoder()
    idx = text.find("{")
    while idx >= 0:
        try:
            _, end = decoder.raw_decode(text[idx:])
            return text[idx : idx + end]
        except json.JSONDecodeError:
            idx = text.find("{", idx + 1)
    return None
Теперь разбор идёт в три ступени: сначала ищем блок кода с пометкой json где угодно в тексте, потом первый целый JSON-объект, потом пробуем ответ как есть.
Четвёртый. JSON наконец разбирался, но модель ставила null в поле, которое схема ждала строкой, и падала уже валидация. Поле стало str | None.
Был и пятый, только уже не у проверяющего. Составитель иногда возвращал черновик с пустым payload: {}, хотя извлекатель перед ним честно отдал все поля. Схема черновика у меня нестрогая, словарь с чем угодно, и модель этим пользовалась. Сейчас там заплатка: если черновик пустой, в него копируются поля извлекателя, а в журнал пишется предупреждение. Правильное лечение — строгая схема под каждый тип действия, оно в списке дел.
И ещё одна деталь, которая стоила мне вечера. Исправление «выложено», сервис перезапущен, а ошибка в логах та же. Я искал баг в коде, а он был в выкладке: файл я копировал на хост, а код в контейнер был запечён при сборке образа, и контейнер его не видел. С тех пор в правилах проекта отдельный пункт: проверять, какой код реально лежит внутри контейнера.
Про то, что даже провайдерский structured output не всё гарантирует, хорошо написано в «Structured Outputs без иллюзий». У меня его в цикле с инструментами не было вовсе, так что я собрал полный набор.
Потом я пошёл с этим в цех
Конвейер заработал, и я начал делать то, ради чего всё затевалось: задачу голосом прямо в цеху. И тут посчитал, как это выглядит со стороны человека с телефоном.
Он стоит у станка и говорит: «Конструктору к пятнице, срочно, крышка подшипника». Дальше ждёт пять вызовов моделей, больше двадцати секунд, а если расшифровку делает сервер, то ещё дольше. За одну фразу платим 11 центов. А главное, после всего этого он всё равно смотрит на форму и сам жмёт «Создать». Человек и есть проверяющий: он видит, кого система поставила исполнителем и какой срок поняла. Пятиступенчатая проверка для формы, которую тут же проверят глазами, оказалась лишней.
Поэтому кнопку «Разобрать с ИИ» в приложении я сделал не через конвейер, а одним маленьким агентом:
речь распознаёт сам телефон, Whisper на сервере не нужен;
один вызов Haiku 4.5 с ответом не длиннее 800 токенов;
модель заполняет поля формы: название, описание, тип, срочность, срок, что уточнить;
работу проверяющего частично делает сервер до модели, а частично человек после.
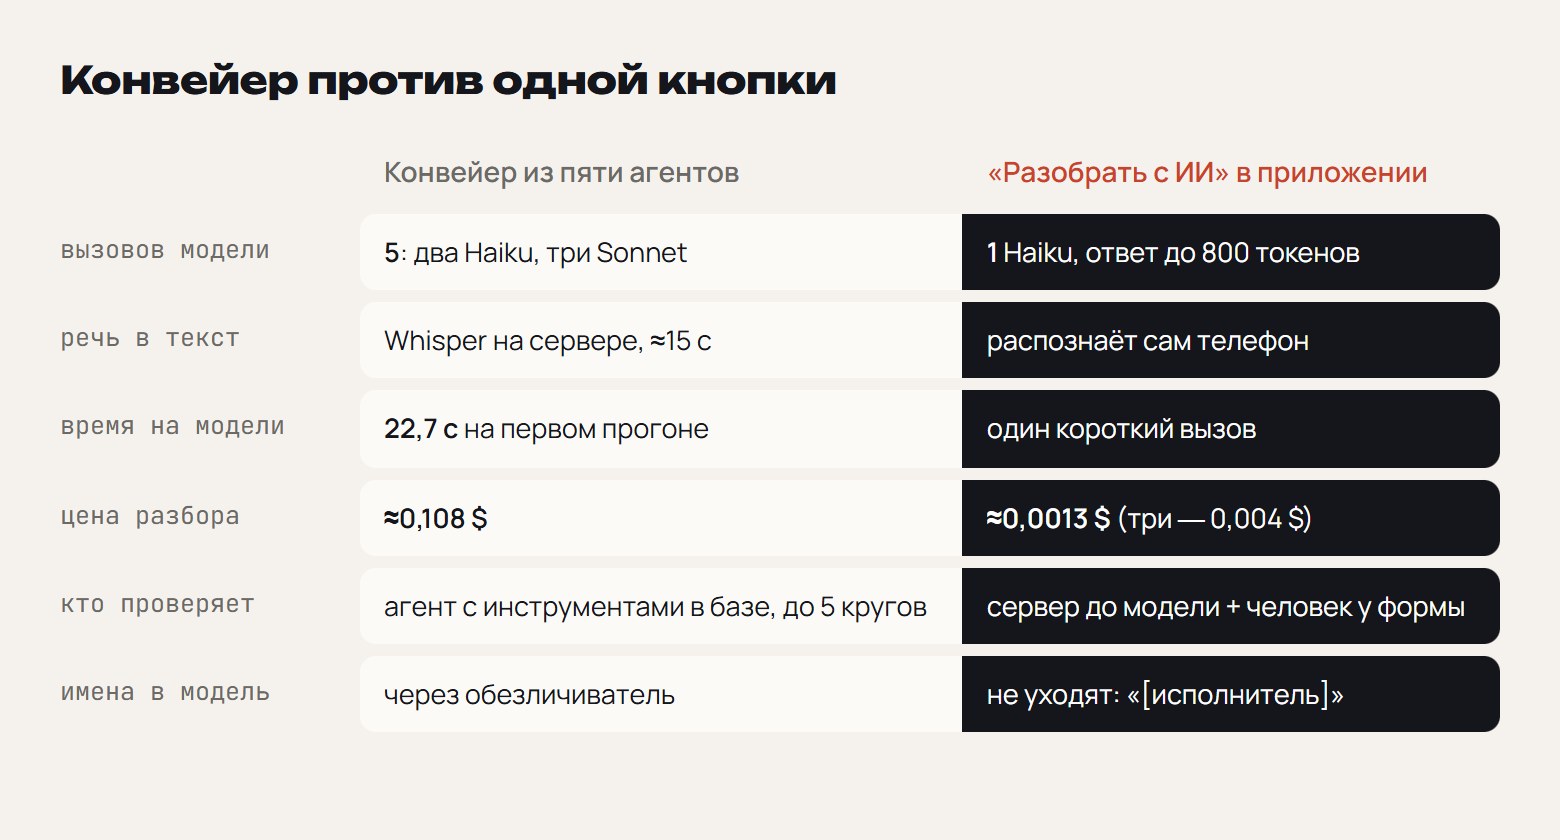
Исполнителя сервер ищет сам, по списку сотрудников, до модели. Сравнивает основы слов, так что склонения не мешают: «Ивану Петровичу» совпадает с «Иван Петрович». Найденное упоминание в тексте заменяется на «[исполнитель]», и имена в Claude не уходят вообще:
for uid, name in people:
    stems = _stems(name)                     # «Иван Петрович» → ['ива', 'петро']
    hits = [span for w, span in words for s in stems if w.startswith(s)]
    found = {s for s in stems for w, _ in words if w.startswith(s)}
    need = len(stems) if len(stems) <= 2 else 2
    if len(found) >= need:
        scored.append((len(found), uid, hits))
...
if len(scored) > 1 and scored[0][0] == scored[1][0]:
    return None, text                        # двое подходят одинаково: пусть выберет человек
В последних двух строках простая страховка: если в цеху двое с одинаковым именем и из фразы непонятно, о ком речь, сервер никого не угадывает. Поле исполнителя остаётся пустым, и человек выбирает сам.
Вместо инструментов проверяющего модель получает контекст сразу в запросе: до 30 проектов в работе и до 12 похожих задач. По ним она может предложить проект, связанные задачи и родителя в цепочке «нужно для». Сервер оставляет из этого только то, что действительно существует и видно автору. Придуманный номер задачи до формы не доедет.
Три разбора на первой проверке стоили вместе 0,004 $, это около 0,0013 $ за разбор против 0,108 $ у конвейера. Один вызов вместо пяти, и из них ни одного к Sonnet.
Где семь всё-таки нужны
Конвейер я не выбросил, и он не был ошибкой. Он нужен там, где заранее неизвестно, что пришло. Фото накладной надо сначала узнать как накладную, потом достать из неё позиции, потом найти каждую в справочнике материалов. «Кончились подшипники 6204» — это дефицит, «пришли подшипники, накладная на фото» — приход на склад, а «на третьем станке течёт» — замечание производства, и для каждого нужны свои поля. Тут классификатор, свои схемы под каждый тип и проверка по базе действительно работают.
А кнопка в форме задачи — другой случай. Тип входа известен заранее (это задача), форма известна, человек рядом. Тут каждый лишний агент добавляет секунды и центы и ничего не добавляет к качеству.
Вход у конвейера был один — Telegram-бот, и от бота я отказался, всё живёт в приложении. Так что сейчас цепочка из пяти ждёт новый вход. Один из кандидатов — приёмка накладной по фото прямо из приложения, она уже есть в планах. Два фоновых агента, дефицитов и контролёр, работают по расписанию: сначала SQL, потом один вызов модели, и только если SQL что-то нашёл.
Если интересно, как это выглядит на цифрах в общем случае, есть хорошее исследование «Окупается ли мультиагентность»: на большинстве задач команда агентов проиграла одиночному агенту и по точности, и по цене. Точность я так не мерил, но по цене и времени у меня вышло то же самое, только на живом производстве.
Что бы я сделал иначе
Начал бы с места, где стоит человек, а не с архитектуры. Сначала один вызов модели под конкретную форму, и только когда он перестанет справляться, второй агент. Журнал цены и времени каждого вызова завёл бы так же с первого дня: без него я бы до сих пор думал, что конвейер «немного медленный». И флаг вроде validator_skipped сделал бы громким: ошибку разбора писал бы в лог предупреждением и выносил в сводку.
Вместо вывода
Семь агентов красиво смотрятся на схеме, и для неизвестных входов они нужны. Но задачу из цеха разбирает один, за десятую долю цента, а проверяет её человек, который стоит рядом. Мне это нравится больше, чем двадцать с лишним секунд ожидания у станка.
В следующей статье цикла расскажу про другую команду агентов — ту, что писала саму систему: тех-лид, бэкенд, Android, тестировщик и контролёр релиза, который не верит отчётам остальных.