С августа у меня работает скрипт, который задает нейронке вопросы так, как их задал бы мой клиент, и считает, называет ли она меня. Сейчас он делает это раз в месяц. Рассказываю, как это устроено, что показали замеры и почему популярные советы вроде llms.txt почти ничего не дают.
5 ноября я читал лекцию «Бренд, который выбирает нейронка» на площадке МосХаб.Сколково, в цикле экспертных вебинаров РАСО и НИУ ВШЭ для студентов рекламы и PR. Там была маркетинговая часть. Здесь техническая: как устроен замер и что пришлось в нем переделать по дороге.
Зачем это мерить
Люди все чаще спрашивают нейронку вместо поисковика. По данным Mediascope, в сентябре 2026 года нейронками хотя бы раз в месяц пользовались 55% россиян, в октябре 2025-го было 26%. Яндекс в отчете за третий квартал пишет, что Алиса отвечает прямо над ссылками на 44% запросов. Бренда, которого нет в таком ответе, для человека в этом выборе просто нет.
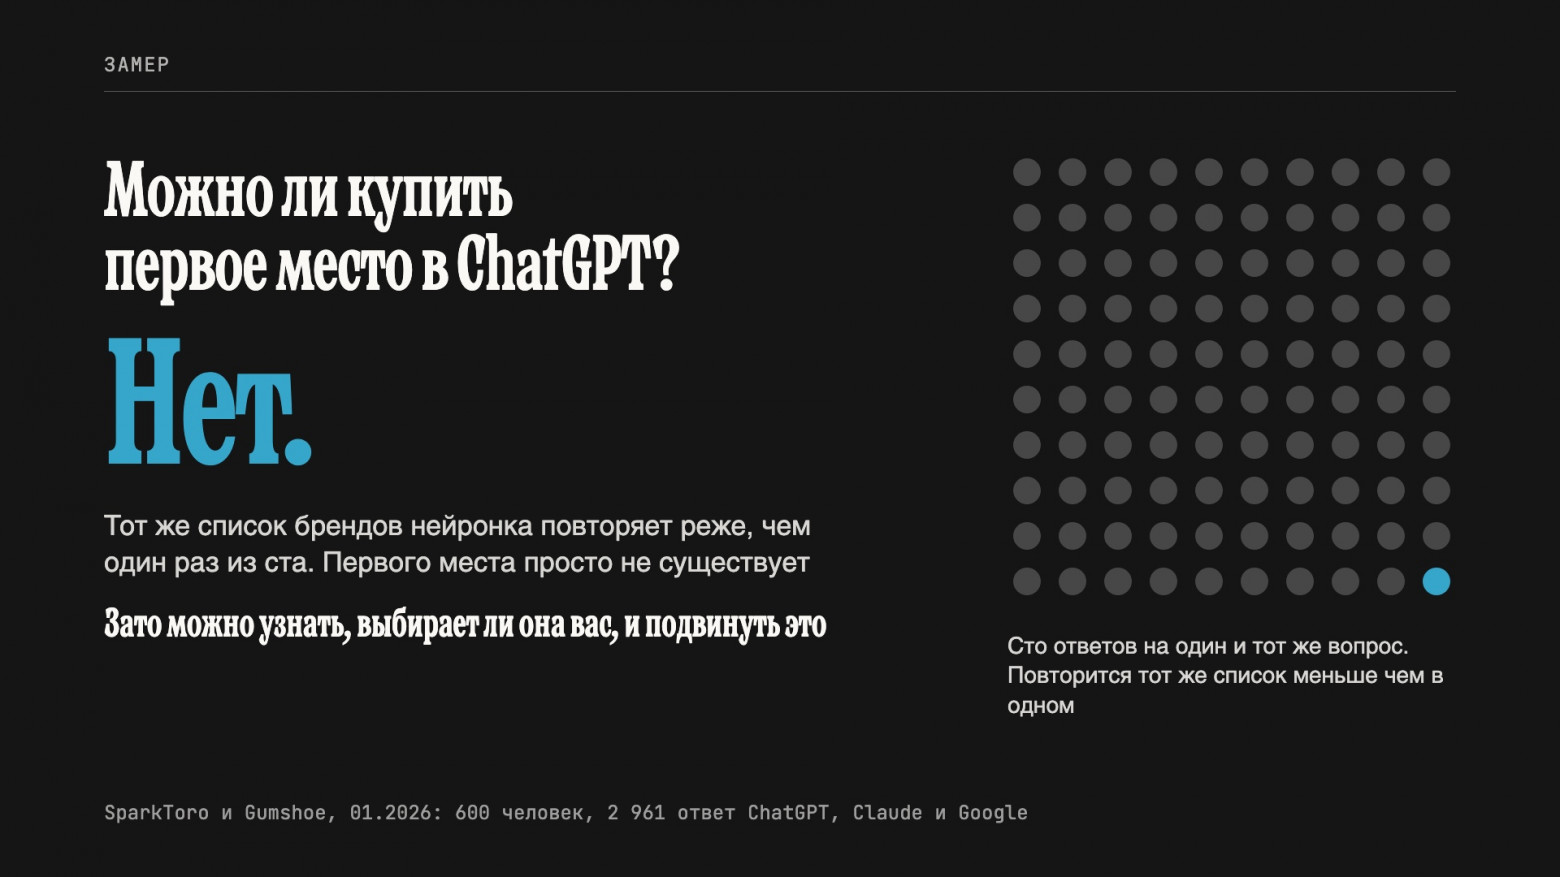
При этом первого места в ответе нейронки не существует. SparkToro и Gumshoe в январе 2026 года собрали 2 961 ответ трех нейронок, включая ChatGPT и Google, на одни и те же 12 вопросов. Тот же набор брендов повторялся реже, чем в одном ответе из ста, тот же порядок реже, чем в одном из тысячи. Рэнд Фишкин из SparkToro написал, что любой инструмент, который показывает «позицию в AI», несет чушь (в оригинале full of baloney). Для честности: соавтор работы сам продает трекинг видимости, исследование не рецензировано.
Отсюда правило, на котором стоит весь мой замер. Мерить можно только долю ответов, где ты есть, и только по многим прогонам.
Как устроен замер
Вопросы
22 вопроса лежат в обычном текстовом файле, разбитом на секции:
10 вопросов от клиента, который меня не знает. Под каждый на сайте есть страница с ответом. В главную цифру идут только они;
10 вопросов под кейсы и статьи: 6 под проекты из портфолио и 4 под статьи из раздела Лаборатория на сайте. Здесь моей считается и ссылка на сам продукт: на вопрос про диктофон для iPhone правильный ответ это страница приложения в App Store;
2 вопроса с моим именем и доменом. Это проверка связи: если нейронка перестала находить меня даже по имени, сломалось что-то другое.
Каждый вопрос уходит три раза, итого 66 вызовов. Скрипт стартует по крону первого числа каждого месяца, через полчаса собирается месячный отчет и сам приходит мне в Telegram.
Почему API, а не окно ChatGPT
Вопросы уходят в OpenAI Responses API: модель gpt-4o-mini с инструментом веб-поиска, и ответить без поиска ей нельзя.
payload = {
    "model": "gpt-4o-mini",
    "input": question,
    "tools": [{"type": "web_search"}],
    "tool_choice": "required",  # без похода в интернет ответа не будет
}
# POST https://api.openai.com/v1/responses
В окне ChatGPT есть память аккаунта и история. Пока готовился к лекции, я задал вопрос из замера в своем ChatGPT, и он пошел читать мои же файлы и переписку, а потом выдал «теплые контакты из сети». Это ответ про меня лично, незнакомый клиент увидит совсем другое. Через API у каждого прогона одинаковые условия, без памяти и истории.
Обратная сторона: gpt-4o-mini с поиском через API ведет себя близко к потребительскому ChatGPT, но это не одно и то же. Я меряю динамику в одинаковых условиях. Что увидит конкретный человек в своем чате, этот замер не скажет.
Что пишется в базу
По элементам web_search_call в ответе видно, что модель ходила в интернет и какие запросы придумала сама. Из message берется текст и аннотации с url, это и есть цитаты. Каждый прогон ложится строкой в SQLite с ключом «дата, вопрос, номер прогона»: есть ли мой домен среди ссылок, каким по счету доменом я иду (несколько ссылок одного сайта считаются одной позицией), назван ли я в тексте без ссылки, ходила ли модель в интернет, плюс ее запросы и источники. Ответ без поиска собран из памяти модели, к GEO он отношения не имеет, и отчет такие прогоны помечает.
Отчет считает долю ответов с моей ссылкой, число вопросов хотя бы с одним попаданием и домены, которые цитируют вместо меня. Чужой домен считается один раз на ответ: важно, в скольких ответах он был.
Формулировка вопроса решает почти все
Вопрос вида «посоветуй специалистов» модель часто читает как поиск организаций рядом и отдает ссылки на карты, иногда по выдуманным названиям компаний. Бывает, что она и вовсе не идет в интернет. Для любого сайта такой вопрос дает ноль, и замер на нем ничего не меряет.
Лечится просьбой в конце: «Дай ссылки на сайты». Модель отправляет вопрос в поиск почти дословно, поэтому каждое слово влияет на то, что она найдет. Новые вопросы я отбираю пробным режимом: каждый прогоняется один раз без записи в базу, скрипт печатает, что модель искала и какие домены процитировала. Вопрос остается, только если модель цитирует сайты. Пример из замера: «Кто проводит менторинг по вайбкодингу и AI-разработке на русском языке? Дай ссылки на сайты.»
Защиты от лишних трат
Скрипт сам ходит по крону в платный API, а такие вещи любят тихо жечь деньги или тихо врать. Поэтому защит четыре:
Идемпотентность. Прогон, который уже лежит в базе (тот же день, вопрос и номер), не повторяется и второй раз не платится.
Предохранитель. Не больше 70 вызовов за запуск. Если в файле больше 22 вопросов, это почти наверняка ошибка, и скрипт останавливается без единого вызова. После трех сбоев подряд тоже стоп, а 429 из-за кредитов не ретраится вовсе.
Замок от второго параллельного запуска с проверкой, жив ли процесс, который его поставил.
Алерт в мессенджер, когда срабатывает предохранитель или падает любой вызов API. Упавший или устаревший замер отчет показывает отдельной строкой «СБОИ ЗАМЕРА».
По моей оценке вызов с поиском стоит около 3 центов, 66 вызовов в месяц дают около 2 долларов.
Что показали замеры
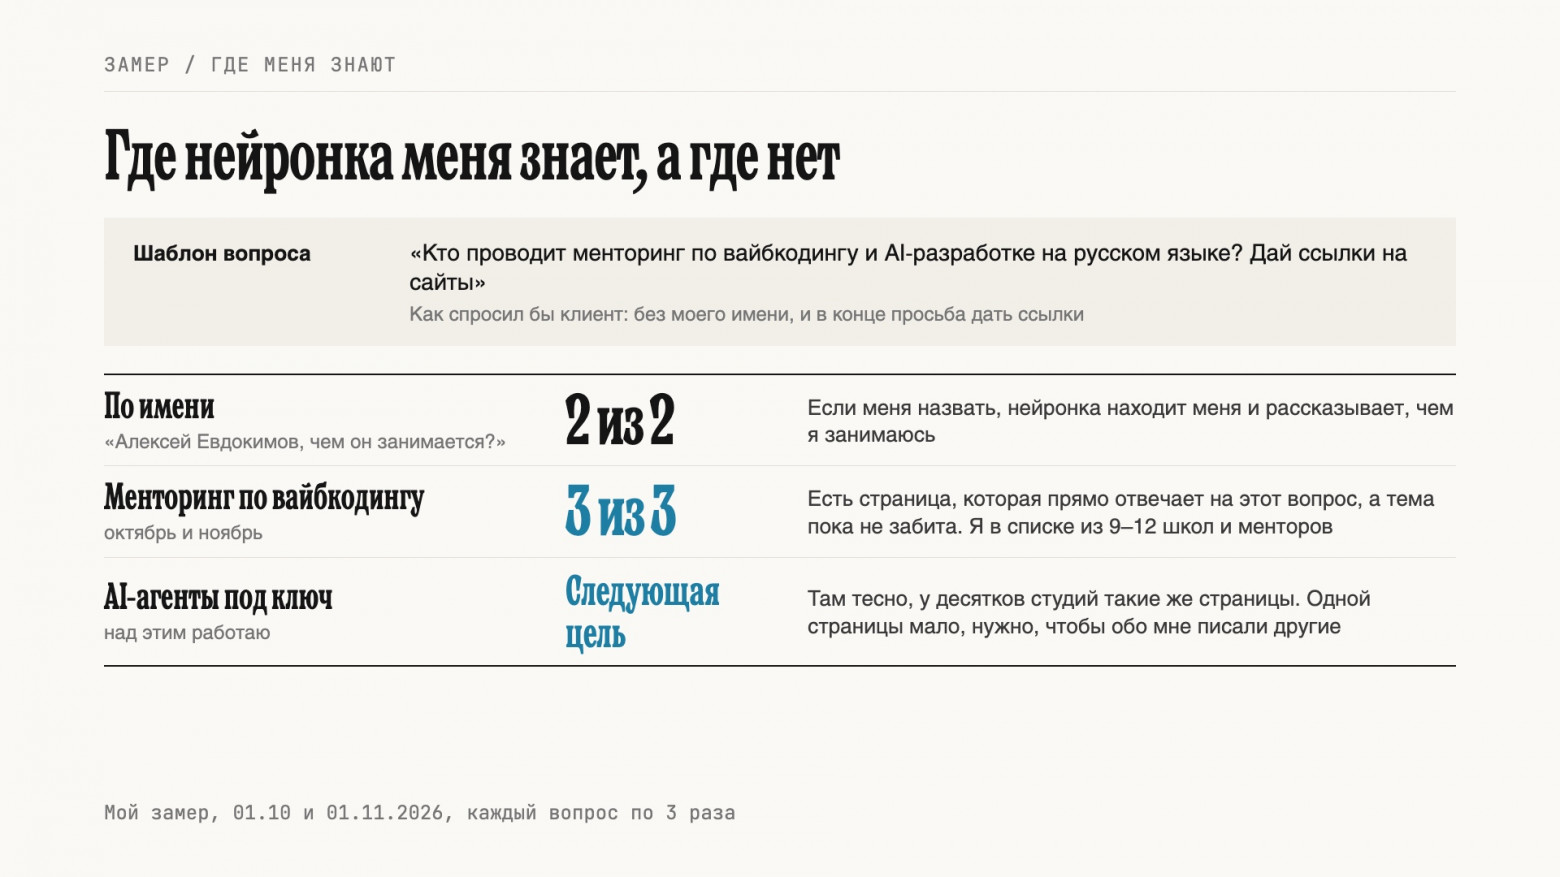
Полный набор из 22 вопросов прошел дважды, 1 октября и 1 ноября. Десять клиентских вопросов в нынешнем виде гоняются с 21 сентября, по ним точек три.
Где меня берут каждый раз. Вопрос про менторинг по вайбкодингу: я есть в каждом из трех ответов во всех трех замерах. Место при этом гуляет: в сентябре в лучшем прогоне мой сайт шел первым, в октябре четвертым, в ноябре 4-м, 5-м и 6-м среди 9-12 процитированных сайтов. Место гуляет, присутствие держится. Под этот вопрос на сайте есть страница, которая прямо на него отвечает, и тема пока не забита.
Где тесно. Вопрос про AI-агентов под ключ для малого и среднего бизнеса. 1 ноября все три ответа процитировали от 9 до 11 сайтов, и 8 из них повторились в каждом. Это собственные сайты студий и агентств. Где тема забита, одной своей страницы мало, нужно, чтобы о тебе писали другие. Это моя трактовка, она опирается на данные AirOps (о них ниже). Эта строка у меня следующая цель.
Ответы скачут сами по себе. Один и тот же вопрос от месяца к месяцу может дать совсем другой набор сайтов, хотя ни на одном из них ничего не поменялось. Три прогона на вопрос это мало, и по одной точке я выводов не делаю.
По имени нейронка находит меня в обоих вопросах, оба месяца. Это проверка связи, успехом я ее не считаю.
Вывод простой: мерить можно только долю, регулярно и на одних и тех же вопросах. Поэтому вопросы про кейсы и статьи живут в отдельной строке отчета и ряд клиентских не ломают.
Что не работает, с цифрами
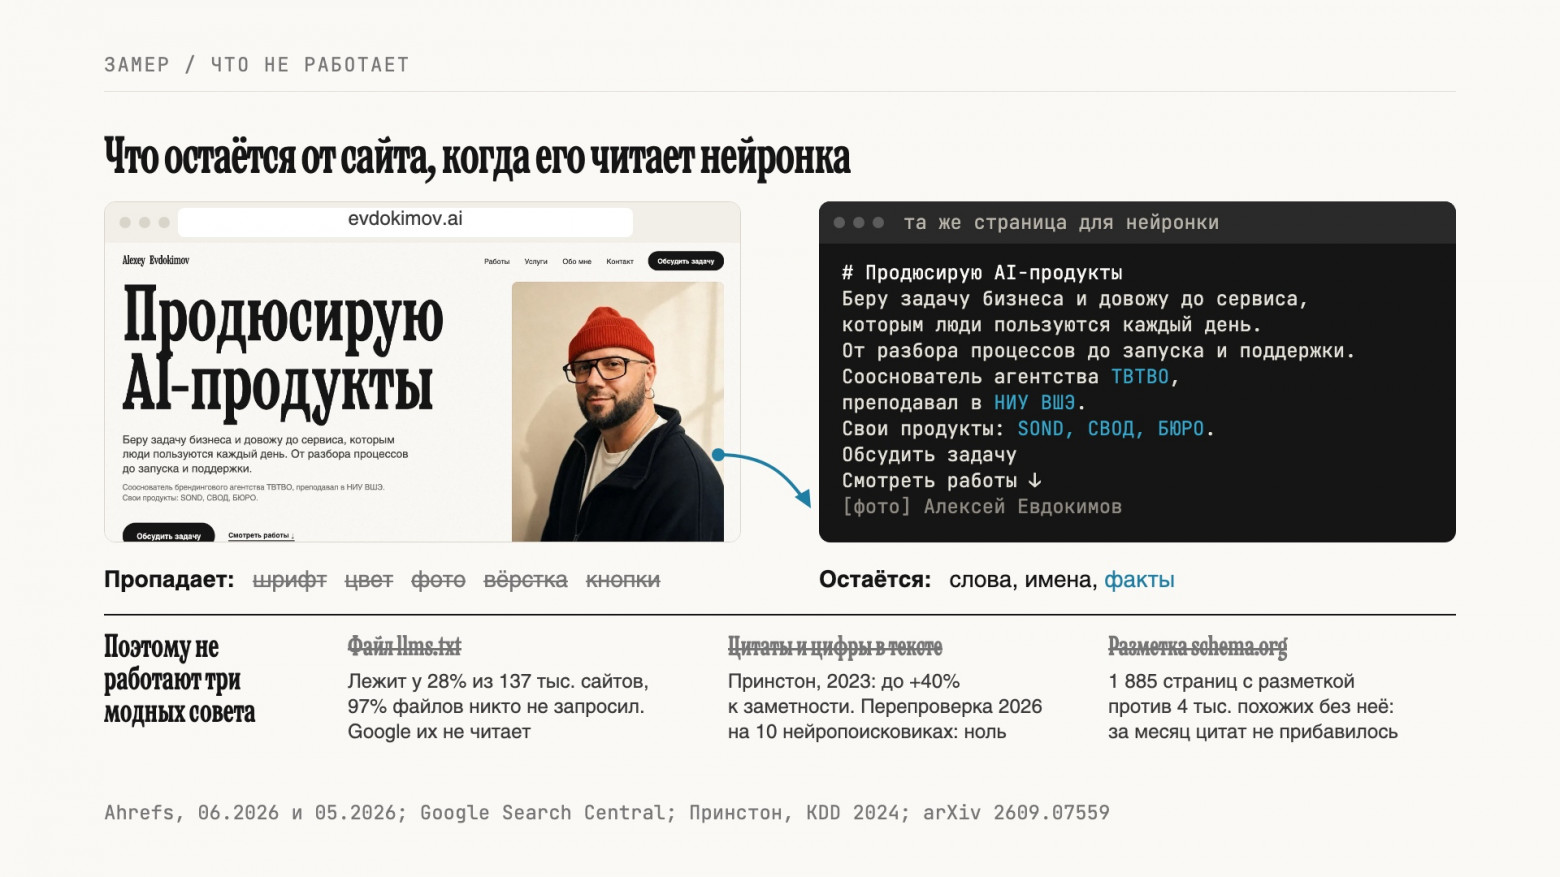
llms.txt. Ahrefs в июне 2026 года проверил 137 210 доменов. Файл публикуют 28% из них, и 97% этих файлов за май не запросил никто. Google в руководстве для вебмастеров пишет, что его поиск, включая генеративные функции, такие файлы не использует. У меня самого llms.txt лежит на сайте. Вреда нет, но и ждать от него нечего.
Разметка schema.org. Ahrefs в мае 2026 года взял 1 885 страниц, которые добавили JSON-LD разметку, и сравнил их примерно с 4 000 похожих страниц без нее, по 30 дней до и после. Цитирования в AI Mode выросли на 2,4%, в ChatGPT на 2,2%, оба изменения статистически незначимы. Для расширенных сниппетов в обычной выдаче разметка по-прежнему полезна, речь только про ответы нейронок.
Цитаты и цифры в тексте. Самый пересказываемый совет в GEO, из работы 2023 года, которая дала название направлению (Принстон и IIT Delhi, KDD 2024): цитаты и статистика поднимали заметность страницы в ответе до 40%. Поисковик там был собственный, на GPT-3.5 поверх топ-5 Google. Перепроверка 2026 года на десяти семействах современных нейропоисковиков дала для цитат минус 0,33 процентного пункта, для статистики минус 0,28, доверительные интервалы пересекают ноль. Эффекта нет, вреда тоже. Авторы перепроверки сами продают оценку контента, работа не рецензирована, но обзор 45 исследований за 2023-2026 годы приходит к тому же: такие приемы помогают, только когда страница уже попала в выборку источников.
Что работает
Чужие площадки. AirOps в октябре 2025 года разобрал 21 311 упоминаний брендов в ответах трех нейронок, включая GPT-5 и Perplexity, на коммерческие вопросы верха воронки. Упоминание бренда нейронка в 6,5 раза чаще брала со сторонних площадок, чем с сайта самого бренда. AirOps сам продает инструменты для контента, это стоит держать в голове. С моим замером это сходится: домены, которые цитируют вместо меня, по сути готовый список площадок, где мне надо появиться с фактами о себе.
Проверяемые факты вместо прилагательных. Препринт Си Чу и Юйпэна Хоу 2026 года, без рецензии. Средства для кожи, одна известная марка и девять придуманных, характеристики одинаковые. Известную марку три нейронки рекомендовали в 100% случаев. Стоило поднять придуманной марке рейтинг на 0,1 звезды, и она выигрывала в 64-80% случаев. Выдуманный «авторитетный» текст вроде «рецензируемое исследование, 120 человек» весил как плюс 0,17 звезды. Врать при этом не надо: часть моделей на агрессивные заявления реагирует наоборот, а накрутки уже ловят. Срабатывает то, что правда и что можно проверить: сколько клиентов, с какого года, кто подтвердит.
Страницы-ответы. Команда Bing пишет, что ассистент читает страницу кусками и собирает ответ из отдельных кусков. Кусок с прямым ответом на вопрос, с ценой или условием, ему взять проще, чем абзац про наши преимущества. Клиентский вопрос, где я есть в каждом ответе, закрыт как раз такой страницей.
10 ноября OpenAI открыла брендам прямой вход
Все, что выше, сводится к одному: нейронка верит фактам о тебе, если их находит. 10 ноября 2026 года OpenAI запустила в бете Businesses in ChatGPT, и теперь часть фактов можно передать ей напрямую.
Главная часть называется Business Hub, это бесплатный кабинет. Бизнес заявляет профиль и подтверждает его по телефону (звонок или СМС) либо DNS-записью, дальше идет проверка, в том числе личности. После этого можно обновлять данные о компании и подключить товарный фид с ценами и наличием. В кабинете видно упоминания, просмотры профиля, клики на сайт и темы разговоров, где цитировали ваш сайт, за 7 или 28 дней. Подтвержденный профиль получает синюю галочку. Брендовые ассистенты Business Agents на старте доступны только части интернет-магазинов и онлайн-сервисов в США.
Мне как человеку с самописным замером интересна одна деталь: упоминание у онлайн-бизнеса там засчитывается, только когда ChatGPT ссылается на сайт бренда, просто назвать бренд мало. Та же логика, что у моего счетчика.
Место в ответах это не покупает. Бенджи Шомейр, вице-президент OpenAI по монетизации, сказал, что заявленный профиль не должен влиять на то, как часто компания появляется в ответах (should not have an impact on how frequently it appears), потому что ответы должны оставаться объективными. По его словам, более полные данные могут помочь показать компанию в более подходящих разговорах. Получается способ дать нейронке точные факты о себе, без обещания, что она станет называть тебя чаще.
Я завел туда свой продукт 13 ноября, проверка личности еще идет. Посмотрю, что покажет кабинет, и расскажу.
Как повторить у себя
Ручной вариант занимает один вечер.
Попросите нейронку составить 20 вопросов под портрет вашей аудитории, потом перепишите их словами живого клиента. Имени бренда в вопросах быть не должно, с ним нейронка назовет вас и так. Шаблон: «Какие [категория] лучше всего купить? Дай ссылки на сайты».
Задайте каждый вопрос по три раза в новом чате в ChatGPT, Алисе и GigaChat. Если в аккаунте включена память, ответ будет подстроен под вас.
Посчитайте долю ответов, где есть ваш сайт, и выпишите сайты, которые нейронка цитирует вместо вас.
Автоматический вариант, если хочется смотреть динамику каждый месяц:
Responses API с
web_searchиtool_choice: "required", три прогона на вопрос, результаты в SQLite с ключом «дата, вопрос, номер прогона»;доля ответов с вашим доменом в ссылках, чужие домены по одному разу на ответ, прогоны без поиска отдельно;
вопросы отбирать пробным прогоном и не менять между месяцами, новые класть в отдельную секцию;
защиты от трат ставить до первого запуска по крону;
людей, пришедших из ChatGPT на сайт, ловить по метке: ChatGPT часто не передает реферер, зато сам дописывает к ссылкам
utm_source=chatgpt.com.
Если вы меряете что-то похожее, напишите в комментариях, сколько прогонов на вопрос делаете и на каких моделях. Хочу сравнить.
Запись лекции: https://youtu.be/H89ehxBbm08
Чек-лист, по которому можно быстро проверить свой бренд или отдать его своему агенту: https://evdokimov.ai/lab/brend-kotoryy-vybiraet-neyronka-cheklist/?utm_source=habr&utm_medium=article&utm_campaign=skolkovo
Мой канал «Евдокимов как обычно»: https://t.me/ltunevibe