

Представим картину: в кластере Kubernetes стоит deny-all, поверх — аккуратные allow-правила. Тест зеленый: curl из клиента до backend проходит, из «чужого» пода — нет. Вроде все хорошо, можно идти пить чай.
А потом берем под с hostNetwork: true и спокойно подключаемся к базе, к которой по политике пускают только backend. Hubble при этом честно пишет FORWARDED от имени (host) — точно так же, как для readiness-проб kubelet. Ни пода, ни namespace.
В статье расскажу, как сверять то, что написано в NetworkPolicy, с тем, что на самом деле происходит в eBPF-датапасе. Покажу два обхода, которые мы нашли на живом кластере, и как их закрыли.
Всем привет! Я Антон Паус, ведущий DevOps инженер в компании Cloud.ru. Почти вся моя карьера связана с сетями, поэтому тема NetworkPolicy мне близка. После появления новых требований от коллег из отдела безопасности, я решил проверить, насколько картина в NetworkPolicy отражает реальность. Было предположение, что NetworkPolicy не закрывают все кейсы для сетевого разграничения pod-ов в kubernetes кластере, но результат получился куда интереснее
Почему «тесты зеленые» — это еще не изоляция
Обычно NetworkPolicy проверяют просто: применили YAML, запустили kubectl exec ... curl из пары подов, получили ожидаемые «да» и «нет». Беда в том, что такой тест проверяет только те маршруты, о которых вы сами вспомнили. А обходы как раз лежат в стороне от них:
DNS — вроде не трафик приложения, но для разведки хватает с головой: порт базы закрыт, зато имя
db.shop.svc.cluster.localотлично резолвится.hostNetwork— процесс живет прямо в сетевом namespace ноды. В EndpointSlice такой под попадет с IP узла, но собственного veth у него нет, и обычные pod-политики его трафик не цепляют.Инфраструктура вне pod-сети — NodeLocal DNS, kubelet, адреса нод.
Поэтому проверять изоляцию лучше не одиночными вызовами curl, а по событиям из самого ядра. Здесь нам пригодятся два инструмента:
Cilium Hubble отвечает на вопрос «пропустил ли датапас»:
FORWARDED/DROPPED, identity источника и получателя, DNS-запросы через прокси.Tetragon отвечает на вопрос «кто это был»: процесс, под, аргументы,
saddr:sport.
На каком стенде проводились тесты
Для проведения тестирования я взял существующий стенд разработки, располагающийся в облаке на виртуальных машинах. Состав стенда и развернутые базовые инфраструктурные приложения такой:
Что | Значение |
Kubernetes | 1.35.4, 11 нод: 3 control-plane, 5 worker, 3 infra (инфраструктурная нагрузка) |
VM | Ubuntu 24.04, ядро 6.8 |
CNI | Cilium 1.20.4: kube-proxy replacement, VXLAN, pod CIDR 240.0.0.0/16, service CIDR 240.1.0.0/16 |
DNS | NodeLocal DNSCache 169.254.25.10 → CoreDNS 240.1.0.3 |
Hubble | Relay 1.20.4 и UI 0.13.6, UI опубликован через Gateway API ( |
Tetragon | 1.8.0, |
Admission | только встроенный Pod Security, без Kyverno |
Для тестирования развернул приложение, имитирующее атакующего:
Namespace | Под | Роль |
| frontend, backend, db, client | приложение; db - просто nc |
| attacker | обычный под атакующего |
| hostnet-same |
|
| hostnet-remote |
|
Поды разложены по нодам жестко через podAffinity и podAntiAffinity — дальше будет видно, почему это принципиально.
Шаг 0. Декларация
Классика:
deny-allна ingress и egress в обоих namespace.DNS.
client, frontend→backend:80.backend→db:5432.Все остальное запрещено.
Без политик, для контроля, ходят все и всюду. С политиками матрица выглядит так:
Проба | Ожидание | Факт |
client → backend:80 | allow | allow |
attacker → backend:80 | deny | deny |
client → db:5432 | deny | deny |
backend → db:5432 | allow | allow |
client: DNS | allow | allow |
Все пять проверок сошлись с ожиданиями. Обычно на этом тестирование и заканчивают. В логах Hubble тоже порядок:
240.0.7.221:44450 (pod) attacker/attacker -> shop/backend:80 Policy denied DROPPED (TCP Flags: SYN)240.0.7.93:35020 (pod) shop/client -> shop/backend:80 to-endpoint FORWARDED (TCP Flags: SYN)
Запомните колонку (pod). Скоро там появится кое-что другое.
Та же картина в Hubble UI, namespace shop:
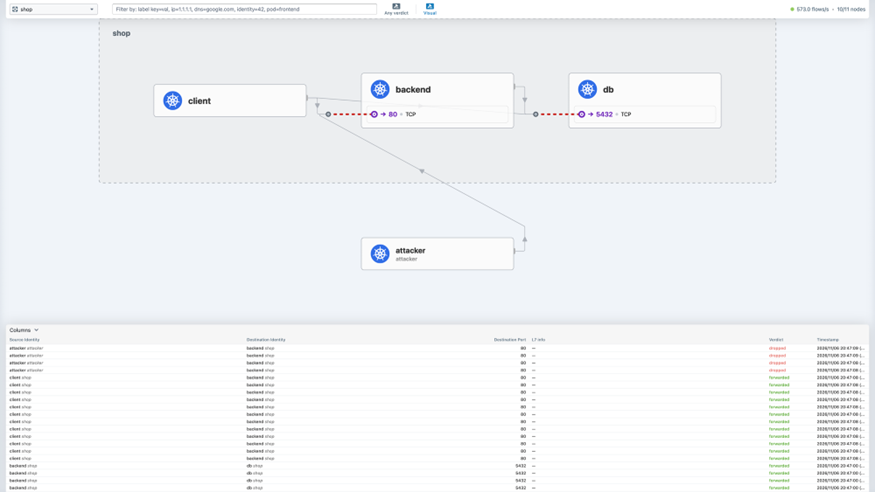
attacker → backend:80 dropped, client → backend:80 и backend → db:5432 forwardedПо таблице внизу все сходится: запрос attacker → backend:80 отброшен (dropped), а client → backend:80 и backend → db:5432 проходят (forwarded); проба client → db:5432 просто уже уехала за пределы окна. А вот сама карта поначалу сбивает с толку: стрелки client → backend и backend → db горят красным пунктиром, тогда как линия от attacker остается серой. Это особенность отрисовки в Hubble UI: если на порт прилетел хотя бы один отказ, красным подсвечивается сам вход в этот порт, в том числе на легитимной связи. Кто именно получил drop, видно только в таблице потоков, поэтому дальше сверяемся по ней.
Что Hubble UI не показывает по умолчанию
Придраться есть к чему, просто это спрятано в меню Visual:
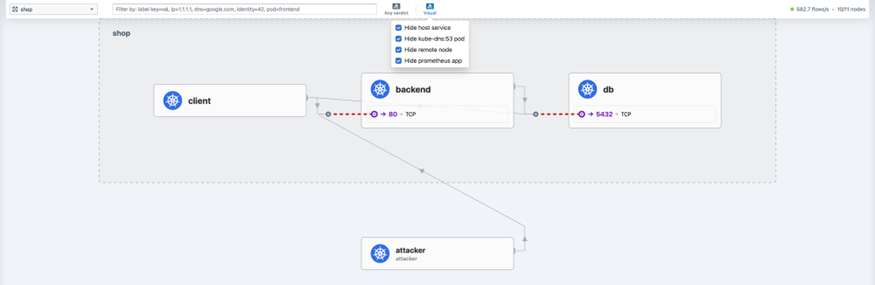
Меню Visual в Hubble UI: по умолчанию включены Hide host service, Hide kube-dns:53 pod, Hide remote node, Hide prometheus app
Все четыре фильтра включены из коробки. В бэкенде UI это обычный blacklist, который уходит в Relay с каждым запросом:
blacklist:{source_label:"reserved:host" source_label:"reserved:remote-node" source_label:"k8s:k8s-app=kube-dns" ...}
 blacklist:{destination_label:"reserved:host" destination_label:"reserved:remote-node" ...}
 blacklist:{destination_label:"k8s:k8s-app=kube-dns" destination_port:"53"}
 blacklist:{source_fqdn:"*.cluster.local*"}  blacklist:{destination_fqdn:"*.cluster.local*"}
Когда просто смотришь связи сервисов, такие умолчания выручают — иначе карту моментально зальют пробы kubelet и DNS-шум. Но для проверки изоляции они только мешают: оба обхода из этой статьи идут через host, remote-node и kube-dns:53, то есть ровно через то, что интерфейс по умолчанию прячет. Перед проверкой обязательно снимите галочки host, remote node и kube-dns. Все следующие скриншоты сделаны уже без них.
Обход 1. DNS
Грабли первые: NodeLocal DNS — это host
Пишем переносимую политику: egress на 53 к подам k8s-app=kube-dns. Применяем вместе с deny-all:
$ kubectl -n shop exec deploy/client -- nslookup backend.shop.svc.cluster.local.
 ;; communications error to 169.254.25.10#53: timed out
 ;; no servers could be reached
Смотрим в /etc/resolv.conf — nameserver 169.254.25.10. Это NodeLocal DNSCache, hostNetwork DaemonSet. Hubble сразу говорит, в чем дело:
shop/client:43492 <> 169.254.25.10:53 (host) policy-verdict:none EGRESS DENIED (UDP)
 shop/client:43492 <> 169.254.25.10:53 (host) Policy denied DROPPED (UDP)
В Hubble UI с настройками по умолчанию этих строк нет: получатель host, а он скрыт. Видно только, что у client «пропал» DNS.
В логе видно получателя (host): Cilium относит адрес NodeLocal к зарезервированной identity host, поэтому podSelector ее не зацепит. Открыть этот адрес через ipBlock тоже не выйдет. Хотя по спецификации Kubernetes ipBlock — просто CIDR (и другие CNI спокойно матчат им поды и узлы), в Cilium он по умолчанию работает только для внешнего трафика с identity world. Параметром policyCIDRMatchMode можно включить проверку ipBlock для pods или nodes, но локальный host (включая 169.254.25.10) все равно открывается только через toEntities: host. Прописать ipBlock на ClusterIP CoreDNS тоже не поможет: в режиме kube-proxy replacement Cilium проверяет политики уже после трансляции сервисного адреса в IP пода.
Лечится с помощью CiliumNetworkPolicy:
egress:
   - toEntities: [host, remote-node]
     toPorts:
       - ports:
           - {port: "53", protocol: UDP}
           - {port: "53", protocol: TCP}
Запись remote-node здесь попала из типового примера в документации Cilium для NodeLocal DNSCache — попутно она открывает 53-й порт на остальных узлах кластера. Сам 169.254.25.10 всегда относится к локальному host, поэтому если в Hubble дропы идут только до (host), его одного в toEntities вполне достаточно.
Мораль: сначала смотрим дропы DNS в Hubble, потом пишем allow-листы. Иначе либо DNS закрыт и вы ищете баг в приложении, либо host открыт шире, чем вы думаете.
L7: не даем резолвить лишнее
Даже когда порт базы закрыт, ее DNS-имя продолжает резолвиться — по сути, это готовая карта внутренних сервисов для атакующего. В Cilium DNS можно отфильтровать на L7.
Разрешим поду attacker запрашивать только backend.shop.svc.cluster.local (как через локальный кеш, так и через kube-dns):
egress:
   - toEntities: [host, remote-node]
     toPorts:
       - ports: [{port: "53", protocol: ANY}]
         rules:
           dns:
             - matchName: backend.shop.svc.cluster.local
   - toEndpoints:
       - matchLabels:
           k8s:io.kubernetes.pod.namespace: kube-system
           k8s:k8s-app: kube-dns
     toPorts:
       - ports: [{port: "53", protocol: ANY}]
         rules:
           dns:
             - matchName: backend.shop.svc.cluster.local
Пробуем отрезолвить базу из пода attacker:
attacker -> 169.254.25.10:53 (host) dns-request proxy DROPPED (DNS Query db.shop.svc.cluster.local. A)

 ** server can't find db.shop.svc.cluster.local: REFUSED
Запрос отбивается. Попутно всплывает полезная мелочь с ndots:5: в имени db.shop.svc.cluster.local всего четыре точки, поэтому без завершающей точки резолвер сначала перебирает суффиксы из search (вроде db.shop.svc.cluster.local.attacker.svc.cluster.local, а для короткого db.shop - db.shop.attacker.svc.cluster.local). В Hubble все эти попытки прилетают отдельными DROPPED-событиями, поэтому в проверочных запросах лучше сразу ставить точку на конце FQDN, чтобы не тонуть в лишнем шуме.
Грабли вторые: а если спросить CoreDNS напрямую?
Пишем такую пробу:
nslookup db.shop.svc.cluster.local. 240.1.0.3      # ClusterIP CoreDNS
 nslookup db.shop.svc.cluster.local. 240.0.6.179    # pod IP CoreDNS
Обе проходят — имя базы спокойно резолвится. Причем в Hubble видно, что запрос все так же шел через DNS-прокси Cilium:
attacker -> 169.254.25.10:53 (host) dns-request proxy DROPPED   (DNS Query db.shop.svc.cluster.local. A)
 attacker -> kube-system/coredns-…:53 dns-request proxy FORWARDED (DNS Query db.shop.svc.cluster.local. A)
На карте Hubble UI (namespace attacker, фильтры host и kube-dns сняты) это два разных ребра: к host:53 и напрямую к kube-dns:53.
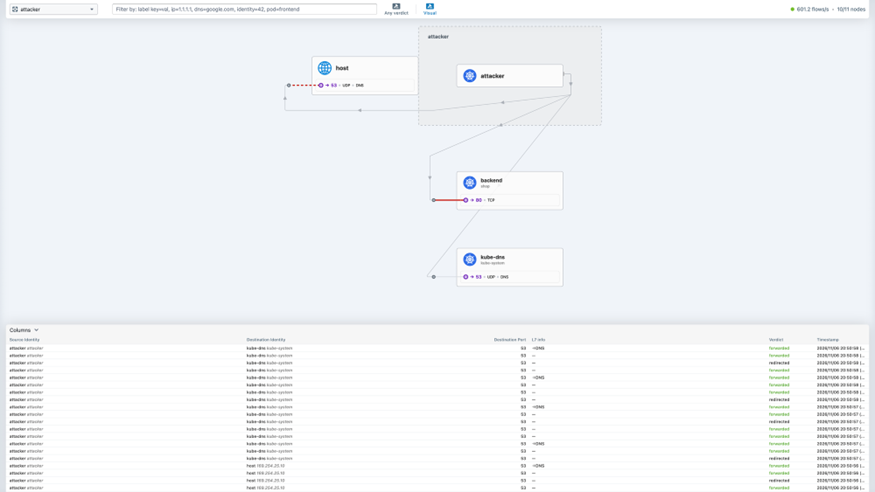
На линии к host виден красный пунктир, а к kube-dns его нет: в таблице там сплошь forwarded и redirected (перенаправление в DNS-прокси). При этом какое именно доменное имя запрашивали, веб-интерфейс не покажет: в колонке L7 info стоит безликое →DNS или прочерк, а если открыть карточку отброшенного пакета — там будет Unknown drop reason (ее видно справа на двойном скриншоте чуть ниже). За конкретными именами и реальной причиной дропа все равно придется идти в CLI и смотреть hubble observe.
Через NodeLocal получаем отказ, напрямую в CoreDNS — ответ. Все дело в том, как Cilium объединяет политики. В namespace осталась базовая K8s-политика allow-dns: она открывает порт 53 до подов kube-dns на L4 без всяких условий. Рядом легла наша CiliumNetworkPolicy с L7-фильтром на те же поды и тот же порт. Cilium складывает правила по «или», а голое L4-правило на порт с активным L7-прокси превращается в разрешение любых DNS-имен. В итоге список разрешенных доменов реально работал только на пути к NodeLocal (host), куда старая K8s-политика не распространялась.
Лечится просто: когда переходим на L7-фильтрацию DNS, обычную L4-политику allow-dns нужно убирать. Удаляем ее — и обе прямые пробы к CoreDNS тоже начинают получать REFUSED:
attacker -> 169.254.25.10:53 (host)         dns-request proxy DROPPED (DNS Query db.shop.svc.cluster.local. A)
 attacker -> kube-system/coredns-…:53        dns-request proxy DROPPED (DNS Query db.shop.svc.cluster.local. A)
Включаем в UI фильтр Dropped — в таблице теперь видны отказы и до kube-dns:53, и до 169.254.25.10:53 (хотя на самой схеме красной осталась только стрелка к backend:80, а линии к host и kube-dns серые — еще одно напоминание сверяться с таблицей, а не с цветом ребер).
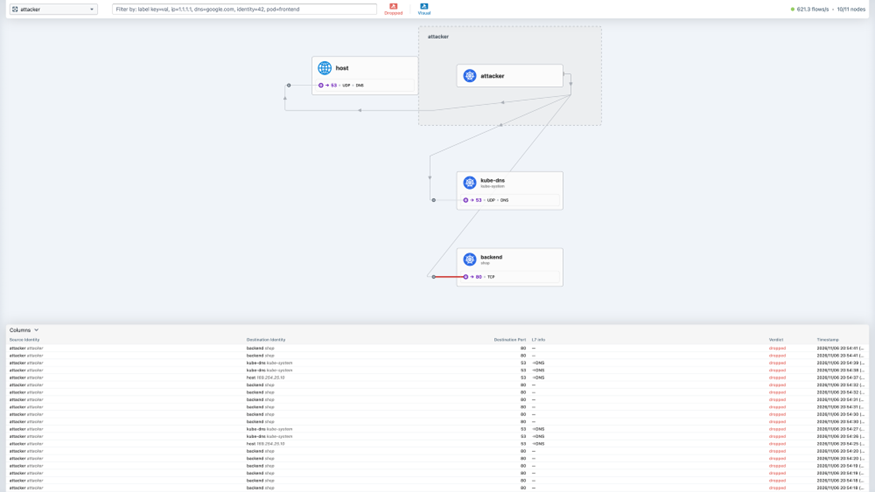
Этот эффект касается не только DNS: любое чистое L4-правило на ту же пару «получатель + порт» фактически обесценивает соседний L7-фильтр (правила на другие порты ему не мешают). На ревью отдельных YAML-файлов такое почти невозможно заметить глазами, ловится только живой проверкой.
Обход 2. hostNetwork
Дыра, которая зависит от того, куда упал pod
Baseline на месте. Пробуем из hostNetwork-pod-ов:
Источник | backend:80 ( | db:5432 ( |
attacker (pod-сеть) | deny | deny |
hostnet-same ( | allow, HTTP 200 | — |
hostnet-remote ( | deny | allow |
Под с hostNetwork: true беспрепятственно достучался до всех подов на своей ноде, в том числе до базы, куда по политике пускают исключительно backend. При этом с соседней ноды тот же самый под получает отказ (пару hostnet-same → db отдельно не гоняли: они на разных узлах, и результат там такой же, как у hostnet-remote → backend).
Механика видна по identity. С той же ноды трафик приходит как host, с соседней — как remote-node. Локальному стеку ноды Cilium по умолчанию разрешает ходить в локальные endpoint'ы (allow-localhost), иначе не работали бы readiness-пробы kubelet. А атакующий в hostNetwork-поде для датапаса и есть «локальный стек».
Отсюда неприятная ловушка при тестировании: если тестовый hostNetwork-под и цель волей планировщика разъехались по разным нодам, проверка вернет deny, и вы спокойно решите, что контур закрыт. В первый раз я наткнулся на этот allow чисто случайно: поды просто попали на один узел. Уедь под с базой на соседнюю ноду, тест прошел бы «зеленым», а дыра осталась на месте. Поэтому в тестах раскладку по нодам нужно прибивать явно.
Hubble видит, но не узнает
Вот так успешное подключение атакующего к базе выглядит в Hubble:
240.0.6.41:33488 (host) -> shop/db:5432 policy-verdict:L3-Only INGRESS ALLOWED (TCP Flags: SYN)
 240.0.6.41:33488 (host) -> shop/db:5432 to-endpoint FORWARDED (TCP Flags: SYN)
240.0.6.41 — внутренний адрес интерфейса cilium_host на узле с identity host. Ни имени пода, ни namespace в логе нет. Обратите внимание на L3-Only INGRESS ALLOWED: пакет прошел по встроенному разрешению Cilium для локального стека ноды, наши NetworkPolicy тут даже не спрашивали. Точно так же выглядят обычные пробы kubelet — Hubble фиксирует сам пропуск, но какой именно процесс открыл соединение, он не знает.
В Hubble UI с настройками по умолчанию этого трафика нет совсем. Снимаем галочки Hide host service и Hide remote node:
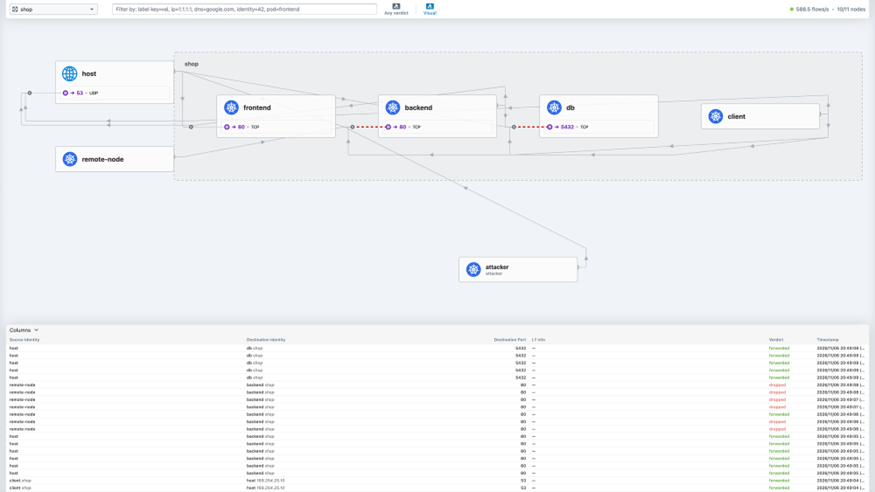
На карте появились host и remote-node, а в таблице — host → db:5432 forwarded, host → backend:80 forwarded и remote-node → backend:80 dropped (стрелки в порты 80 и 5432 снова подсвечены красным из-за чужих дропов на те же порты). Вот он, наш обход из таблицы выше. Проблема в том, что плашка host на схеме одна на весь узел: в нее свалены в кучу и kubelet, и NodeLocal DNS, и под атакующего. Заглянем в детали потока, там информации не больше:
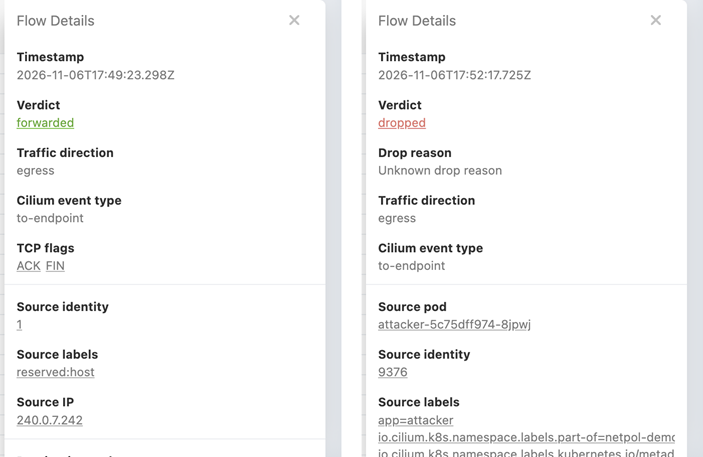
На левой карточке у источника видны только identity 1, метка reserved:host и IP ноды 240.0.7.242. Строки Source pod просто нет, поэтому выяснить через UI, кто именно открывал сокет за host, не получится. Справа для сравнения открыт отброшенный DNS-пакет от пода attacker: здесь под известен, зато вместо причины блокировки висит Unknown drop reason, а само имя домена нигде не фигурирует.
Tetragon: кто стоит за host
Tetragon привязывает события к поду по cgroup, а не по сетевому namespace. Для него hostNetwork-под остается обычным подом. Вешаем kprobe на tcp_connect:
apiVersion: cilium.io/v1alpha1
 kind: TracingPolicyNamespaced
 metadata:
   name: tcp-connect-audit
   namespace: attacker
 spec:
   kprobes:
     - call: tcp_connect
       syscall: false
       args:
         - index: 0
           type: sock
И получаем то, чего не хватало:
{"pod":"hostnet-same-7ccc78cfdc-tcvnh","binary":"/usr/bin/curl",
 "arguments":"-sS -m 3 -o /dev/null -w %{http_code} http://backend.shop.svc.cluster.local.",
 "function":"tcp_connect",
 "sock":{"saddr":"240.0.7.242","sport":50062,"daddr":"240.0.7.175","dport":80}}
Пара saddr:sport в событии Tetragon в точности совпадает с адресом и портом источника в Hubble. Если выгрузить оба потока событий в JSON и свести TCP SYN-пакеты с вызовами tcp_connect по ключу saddr:sport (хватает небольшого фильтра на jq), получаем:
VERDICT    SOURCE              IDENTITY     DESTINATION            PROCESS
 DROPPED    240.0.6.41:36574    remote-node  shop/backend:80        attacker/hostnet-remote  /usr/bin/curl
 DROPPED    240.0.7.221:44450   pod          shop/backend:80        attacker/attacker        /usr/bin/curl
 FORWARDED  240.0.6.41:33488    host         shop/db:5432           attacker/hostnet-remote  /usr/bin/nc
 FORWARDED  240.0.7.242:50062   host         shop/backend:80        attacker/hostnet-same    /usr/bin/curl
 FORWARDED  240.0.7.242:39992   host         shop/backend:80        UNATTRIBUTED
 FORWARDED  240.0.7.93:35020    pod          shop/backend:80        shop/client
Строки FORWARDED с identity host, напротив которых появился attacker/…, — это как раз трафик наших hostNetwork-подов, который в одном только Hubble сливался с системным фоном. А UNATTRIBUTED от host — обычные пробы kubelet: он запущен прямо на узле и под namespaced-политику Tetragon не попадает. В здоровой картине после такой склейки без привязки к поду должен оставаться только трафик хостовых служб; любой прикладной контейнер за host — сигнал, что кто-то ходит мимо политик.
Почему один и тот же SYN бывает и FORWARDED, и DROPPED
Для hostnet-remote → backend Hubble на ноде-источнике пишет FORWARDED (пакет ушел в туннель), а на ноде-получателе — DROPPED. Решение принимает получатель.
Отсюда правило: Hubble снимаем на нодах, где стоят цели, а Tetragon — на нодах, где стоят источники.
Закрываем, попытка первая: Sigkill
Первая мысль — убить процесс в момент tcp_connect, если это hostNetwork-под и адрес назначения в pod- или service-CIDR. В Tetragon это matchActions: Sigkill. Процесс послушно умирает, exit 137. Смотрим в Hubble на ноде базы:
240.0.6.41:47256 (host) -> shop/db:5432 to-endpoint FORWARDED (TCP Flags: SYN)
 240.0.6.41:47256 (host) -> shop/db:5432 to-endpoint FORWARDED (TCP Flags: ACK)
 240.0.6.41:47256 (host) -> shop/db:5432 to-endpoint FORWARDED (TCP Flags: ACK, FIN)
Трехстороннее рукопожатие все равно успело завершиться. Дело в том, что kprobe на tcp_connect отрабатывает уже по ходу отправки SYN, а SIGKILL прилетает процессу только при возврате в userspace. Передать данные атакующий не успеет, но просканировать открытые порты на узле сможет без труда. Не годится.
Попытка вторая: Override на connect()
Резать надо раньше, до сетевого стека. Идеальная точка — LSM-хук, но Tetragon на этих нодах пишет в логе lsm: false. Зато есть override_return: true, так что можно перехватить syscall и вернуть ошибку:
apiVersion: cilium.io/v1alpha1
kind: TracingPolicyNamespaced
metadata:
  name: block-hostnet-override
  namespace: attacker
spec:
  podSelector:
    matchLabels:
      role: hostnetwork-bypass
  kprobes:
    - call: sys_connect
      syscall: true
      args:
        - {index: 0, type: int}
        - {index: 1, type: sockaddr}
      selectors:
        - matchArgs:
            - index: 1
              operator: SAddr
              values: [240.0.0.0/16, 240.1.0.0/16]
          matchActions:
            - action: Override
              argError: -1
nc: connect to db.shop.svc.cluster.local. (240.1.8.119) port 5432 (tcp) failed: Operation not permitted
В hubble observe по поду базы теперь пусто — вызов режется на входе в ядро, и ни один пакет в сеть не уходит. Небольшое уточнение по синтаксису политики: в matchArgs указан оператор SAddr — именно так Tetragon называет целевой адрес внутри структуры sockaddr у sys_connect (в отличие от DAddr, который используется для ядерного sock в tcp_connect). В список подсетей мы добавили сразу и pod CIDR, и service CIDR, потому что перехват системного вызова происходит еще до того, как Cilium перепишет ClusterIP сервиса в IP пода. При этом DNS внутри таких подов продолжает работать: адрес NodeLocal (169.254.25.10) в эти диапазоны не входит.
Есть тонкость с UI. Узел host на карте после исправления никуда не денется, и ребра host → frontend и host → backend останутся — это пробы kubelet. Отличить «закрыли» от «не закрыли» по карте нельзя, только пробой и событиями Tetragon.
Попытка третья, правильная: не пускать такие поды вообще
Runtime-правило — это страховка. Основная мера — не пускать hostNetwork в прикладные namespace. Kyverno для этого не нужен, хватает встроенного Pod Security:
metadata:
  name: attacker
  labels:
    pod-security.kubernetes.io/enforce: baseline
Warning: existing pods in namespace "attacker" violate the new PodSecurity enforce level "baseline:latest"
Warning: hostnet-remote-… (and 1 other pod): host namespaces
...
Error creating: pods "hostnet-same-…" is forbidden: violates PodSecurity "baseline:latest": host namespaces (hostNetwork=true)
Обратите внимание на первые два предупреждения: уже запущенные поды остаются в строю. Admission-контроллер проверяет манифесты только в момент создания пода, поэтому включать политику нужно в таком порядке:
kubectl label --dry-run=server ns <ns> pod-security.kubernetes.io/enforce=baseline— список нарушителей.Убрать нарушителей.
Включить enforce.
Runtime-правило Tetragon закрывает окно между первым и третьим шагом.
А почему не поправить Cilium?
На стороне самого Cilium эту лазейку закрывает параметр allow-localhost=policy. По умолчанию в Kubernetes режим auto раскрывается в always, разрешая локальному стеку узла ходить во все свои поды без ограничений — благодаря этому из коробки работают пробы kubelet. Если переключить его в policy, под фильтрацию попадут и сами пробы: для них придется явно открывать fromEntities: host через CiliumNetworkPolicy (стандартная NetworkPolicy такой сущности не знает). Host firewall при этом решает другую задачу: фильтрует трафик на порты самой ноды. В любом случае настройка allow-localhost действует на весь кластер разом. На общем dev-стенде с чужими сервисами такое переключение превращается в отдельную миграцию с ревизией всех политик, а не в быструю правку для одного приложения.
Чеклист для проверки своего кластера
Записать матрицу намерений: кто → куда → порт → allow/deny.
Явно зафиксировать размещение: hostNetwork-проба рядом с целью и на соседней ноде.
Применить политики, прогнать пробы.
Снять потоки Hubble: через Relay (предварительно проверив в
hubble status, все ли ноды на связи) или прямо с агентов на нодах получателей. Писать лучше в режиме--followпараллельно с тестами: кольцевой буфер на активном кластере вымывается меньше чем за минуту, и--lastпосле прогона нужные пакеты уже не застанет.Снять Tetragon на нодах источников.
Свести потоки Hubble и события Tetragon по
saddr:sport. КаждыйFORWARDEDдолжен либо укладываться в матрицу доступа, либо однозначно относиться к системным процессам узла.Отдельные пробы DNS: через NodeLocal, через ClusterIP CoreDNS, через pod IP CoreDNS.
Если смотрите глазами в Hubble UI — снимите фильтры host, remote node и kube-dns. Имена DNS-запросов проверяйте в CLI.
После исправления — тот же прогон. Артефакты приложить к изменению политик.
В CI такую проверку легко оформить обычным job на тестовом кластере: прогнали набор проб по списку, сверили ответы с матрицей ожиданий и уронили сборку, если хотя бы одна проверка разошлась с планом.
Стоит учесть, что:
tcp_connectиconnectловят только TCP. Весь UDP из hostNetwork-подов, включая DNS, проходит мимо этих правил, поэтому такой под по-прежнему спокойно резолвит имяdb. Навесить на него L7 DNS-политику Cilium тоже не получится: уhostNetwork-пода нет собственного сетевого endpoint'а (veth), на котором Cilium мог бы завернуть трафик в DNS-прокси.Политики Tetragon здесь namespaced и с захардкоженными CIDR конкретного кластера. Для продакшена нужна кластерная
TracingPolicyи CIDR из конфигурации Cilium.Hubble без Relay видит трафик только своей ноды, а с Relay — только тех узлов, что сейчас на связи. О выпавших нодах
hubble observeпредупреждает одной служебной строкойnodes are unavailable, которая при фильтрации вывода легко теряется.Hubble UI годится для обзора, но не для аудита: фильтры по умолчанию прячут
host,remote-nodeи kube-dns, а DNS-потоки показаны без имени запроса.Наблюдение само по себе трафик не блокирует: Hubble и Tetragon показывают реальную картину в ядре (а Tetragon помогает временно прикрыть обход), но основную защиту все равно должны держать сетевые политики и admission.
Мои заключения
Чтобы сетевая изоляция в Kubernetes работала на деле, а не только на бумаге, должны сойтись три вещи:
Декларация —
deny-allпо умолчанию и минимально необходимыеallow-правила.Проверка факта — вердикт датапаса из Hubble в связке с процессом из Tetragon.
Закрытые обходы вокруг pod-сети — запрет
hostNetworkна уровне admission и фильтрация DNS строго через L7-правила без параллельных L4-разрешений.
На нашем стенде такая сверка вытащила шесть моментов, которых не увидишь через kubectl get networkpolicy:
политика «DNS к kube-dns» ломает резолв, потому что NodeLocal — это
host;L7-allowlist DNS обходится прямым запросом к CoreDNS при наличии L4-правила на 53;
hostNetwork-под достает базу на своей ноде, а в Hubble это выглядит как kubelet;
Hubble UI из коробки прячет и этот трафик, и DNS к kube-dns;
Sigkill по
tcp_connectопаздывает на рукопожатие, Override наconnect()— нет;Pod Security не трогает уже запущенные поды.
Если ваши тесты политик горят зеленым, но среди них нет проб из hostNetwork-пода и прямых запросов к CoreDNS в обход NodeLocal, то есть, о чем задуматься.