Сравниваем TabPFN-2.5 и CatBoost на банковских данных и считаем, сколько стоит выигрыш в качестве
Когда я начинал эксперимент, гипотеза была простой: чем больше заявок в обучении, тем лучше модель. Это звучит очевидно, однако данные показали другое.
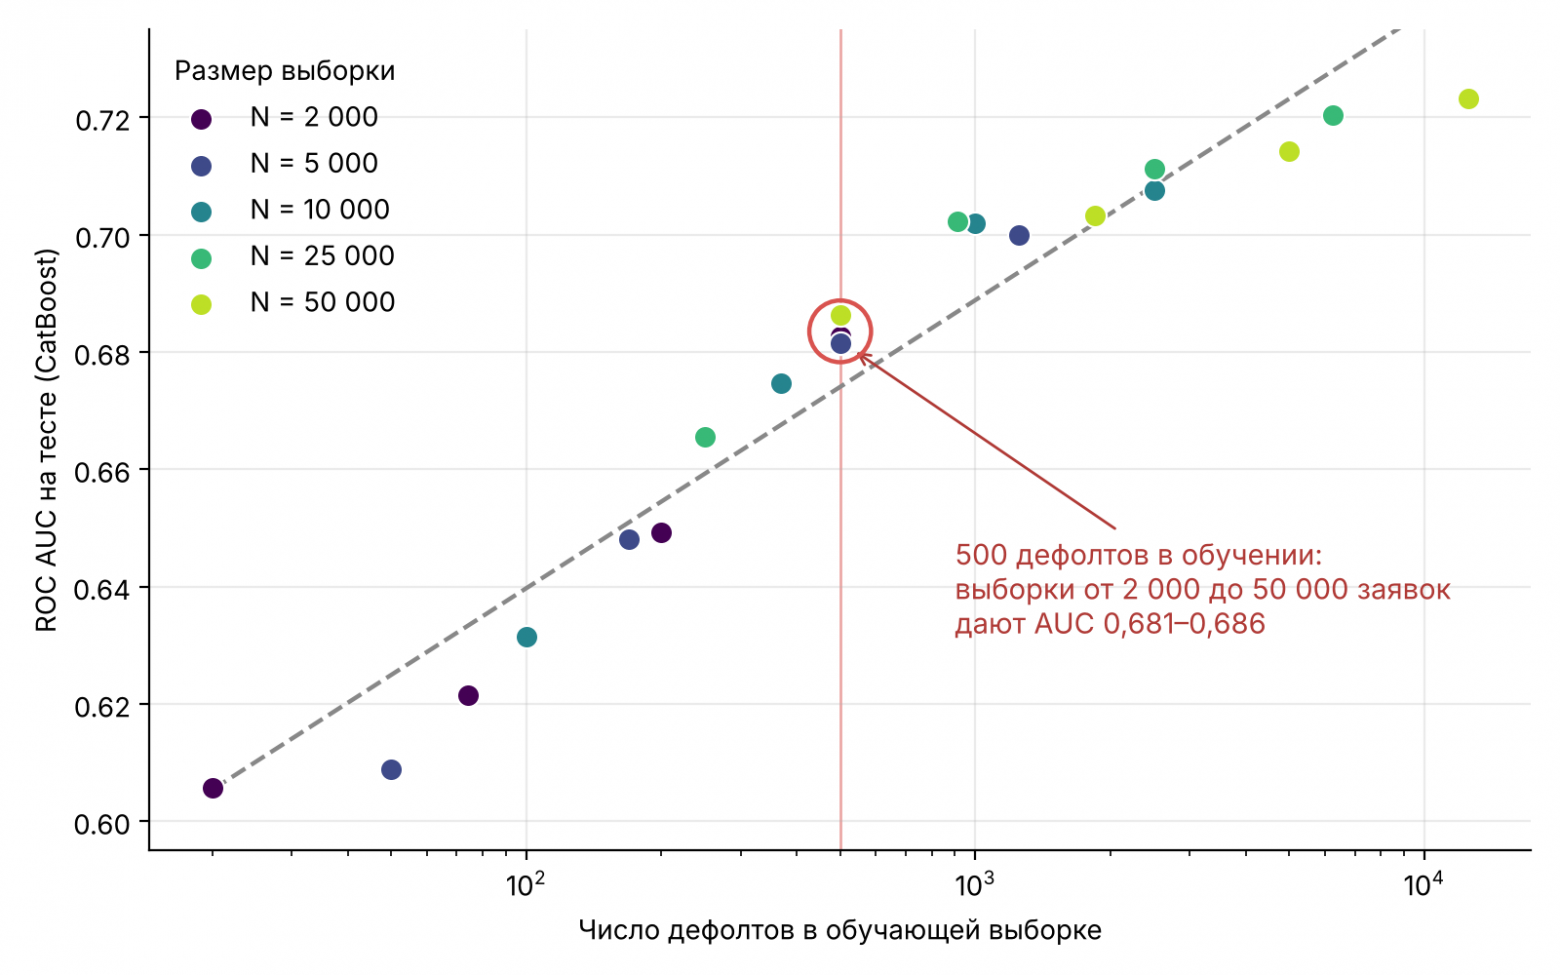
Возьмём три набора для обучения, в каждом из которых ровно 500 дефолтных заявок. В первом всего 2 000 заявок (25% дефолтных), во втором 5 000 (10%), в третьем 50 000 (1%). CatBoost на них показывает почти одинаковое качество: ROC AUC 0,683, 0,681 и 0,686. Размер выборки отличается в 25 раз, а результат тот же. Совпало только число дефолтов.
Дальше о том, как я к этому пришёл, где новая табличная модель TabPFN обгоняет CatBoost и почему «взять лучшую» оказалось не самым полезным вопросом.
Задача: две ошибки с разной ценой
Банк решает, выдавать ли кредит, и ошибиться может двумя способами. Ошибка I рода: кредит выдали клиенту, который потом ушёл в дефолт. Это прямые потери банка, и в работе она главная. Ошибка II рода: отказали клиенту, который вернул бы кредит, то есть банк потерял прибыль. Чтобы сравнивать модели честно, я не брал порог 0,5, потому что вероятности у моделей, обученных на выборках с разной долей дефолтов, смещены. Вместо этого я фиксировал долю отказов: на валидации находится порог, при котором отказывают 10% самых рискованных заявок, и он применяется к тесту.
Чтобы сравнивать модели честно, я не брал порог 0,5: вероятности у моделей, обученных на выборках с разной долей дефолтов, смещены. Вместо этого я фиксировал долю отказов: на валидации находится порог, при котором отказывают 10% самых рискованных заявок, и он применяется к тесту.
import numpy as np

def threshold_by_reject_rate(p_val, q):
    #Порог, при котором отказывают доле q самых рискованных заявок.
    return np.quantile(p_val, 1 - q)

thr = threshold_by_reject_rate(p_val, q=0.10)
reject = p_test >= thr
err1 = ((~reject) & (y_test == 1)).sum() / (y_test == 1).sum()  # пропущенные дефолты
При такой постановке ошибка II рода у всех моделей почти одинакова (около 0,09–0,10), поэтому сравнивать их нужно по ошибке I: сколько дефолтов модель пропустила.
Участники
CatBoost — базовый вариант. Градиентный бустинг над деревьями давно стал стандартом для таблиц. Он быстро учится и спокойно работает в проде.
TabPFN-2.5 — табличная foundation‑модель. Она предобучена на огромном числе синтетических задач и на ваших данных не обучается в привычном смысле: вы отдаёте ей обучающую выборку как контекст, и она выдаёт ответ за один прямой проход. Заявлено, что она особенно хороша на малых выборках.
Ограничение: лицензия TabPFN-2.5 некоммерческая. Для исследований это нормально, а «просто внедрить в банке» нельзя. Версию модели я задавал явно: в новых релизах пакета по умолчанию грузится уже другая.
Данные
Я взял открытый обезличенный набор кредитных историй Альфа‑Банка (соревнование Data Fest): 3 млн заявок, дефолт определяется как просрочка 90+ дней за 12 месяцев, доля дефолтов 3,55%. Историю клиента (несколько прошлых кредитов на заявку) я свёл к одной строке из 128 признаков.
Ограничения данных стоит назвать сразу. Анкеты нет, есть только кредитная история. В наборе только те клиенты, которым банк кредит выдал, поэтому выборка смещена. Смысл кодов статусов платежей не раскрыт, и я их не интерпретирую. Разбиение сделано по времени, а не случайно: модель учится на прошлом и применяется к будущему, а случайное разбиение скрыло бы дрейф и завысило качество. Доля дефолтов действительно «плывёт»: 3,61% в обучающем пуле, 3,49% на валидации и 3,21% на тесте.
Разбиение сделано по времени, а не случайно: модель учится на прошлом и применяется к будущему. Случайное разбиение скрыло бы дрейф и завысило качество. Доля дефолтов действительно «плывёт»: 3,61% в обучающем пуле, 3,49% на валидации и 3,21% на тесте.
Из обучающего пула я нарезал 60 подвыборок: размер от 2 000 до 50 000 заявок, доля дефолтов 1%, естественная, 10% и 25%, по три повтора.
Находка № 1: качество определяют дефолты, а не строки
Я построил регрессию ROC AUC на логарифм числа дефолтов в обучении и отдельно на логарифм размера выборки. Число дефолтов объясняет 86–92% разброса качества между запусками, размер выборки только 23–44%.
Объём данных тоже влияет, но признаки коррелируют. На практике в скоринге редкий класс — главный дефицит. Если у вас мало дефолтов, то миллион «хороших» заявок почти не поможет.
Находка № 2: где TabPFN выигрывает
Дальше я сравнил TabPFN и CatBoost на одних и тех же объектах. Из‑за стоимости вывода TabPFN считался на подмножествах валидации и теста по 10 000 объектов, на видеокарте Tesla T4 в Colab.
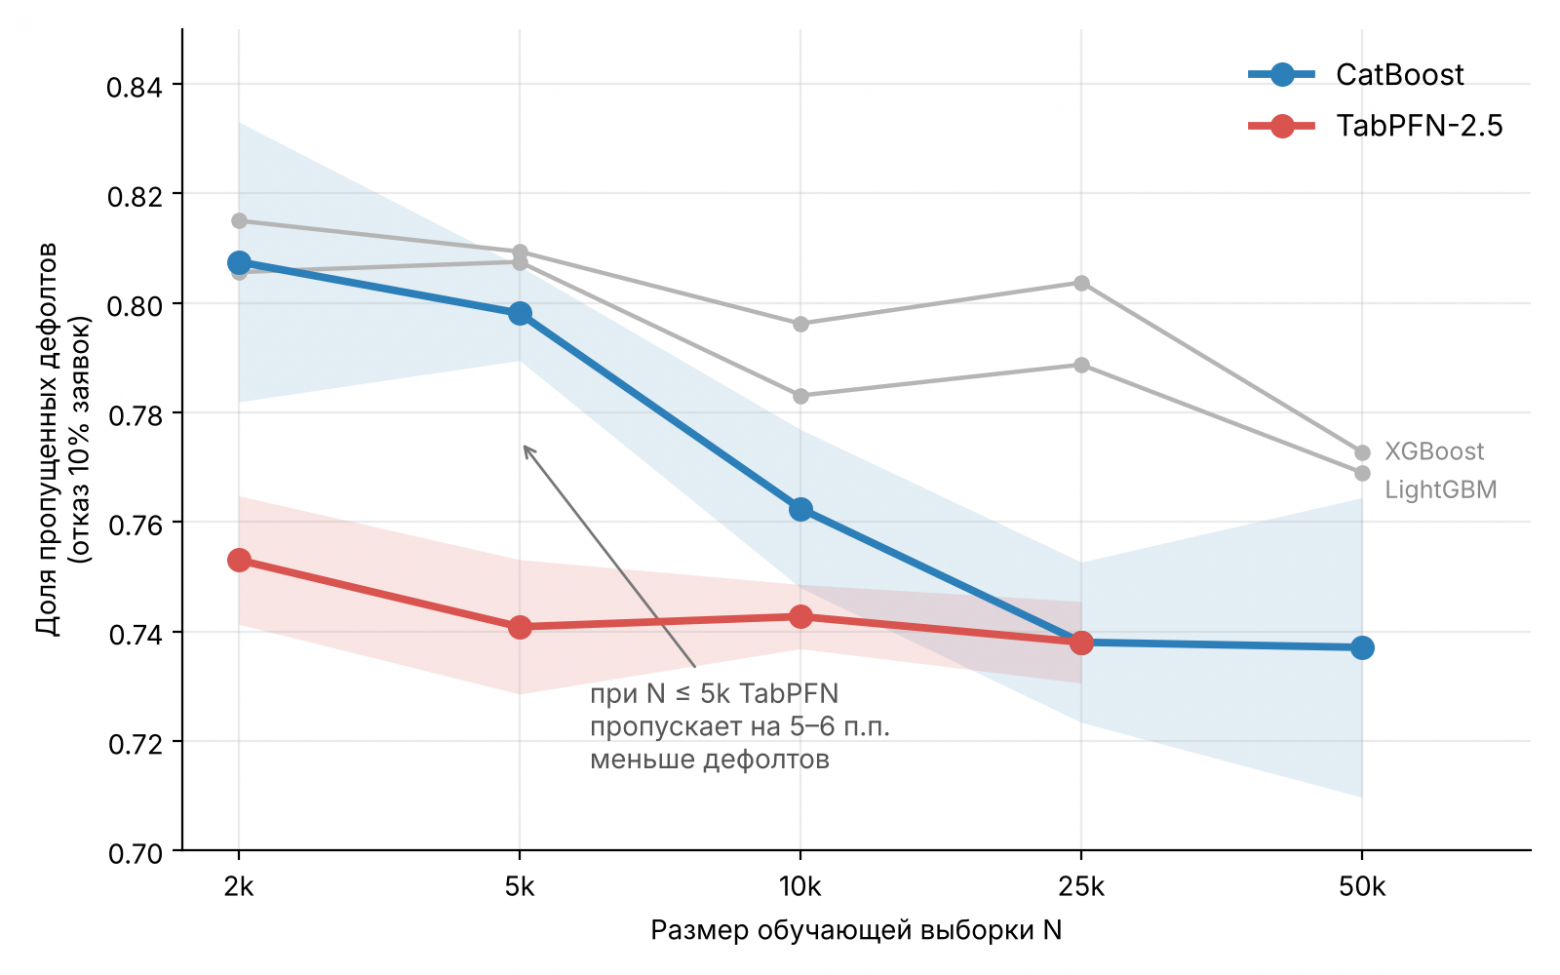
Результаты такие: при обучающей выборке до 10 000 объектов TabPFN нигде не хуже CatBoost по ROC AUC, а в 7 из 12 режимов выигрыш статистически значим, в основном при доле дефолтов 1% и естественной. Чем больше дефолтов в обучении, тем меньше преимущество, и это согласуется с находкой № 1. При 25 000 объектов модели неразличимы.
В бизнес‑метриках: при отказе 10% самых рискованных заявок TabPFN пропускает в среднем 75,0% дефолтов, CatBoost — 77,7%. Разница в несколько процентных пунктов, не революция. Абсолютные ошибки в обоих случаях высокие: AUC около 0,7, пропускается около трёх четвертей дефолтов.
Возможное объяснение: при малом числе дефолтов TabPFN опирается на знания, полученные при предобучении, а бустингу приходится выучивать всё из данных. Я это не проверял: измерено только то, что разница убывает с ростом числа дефолтов.
Цена вопроса
У TabPFN «обучение» почти бесплатное, зато вывод дорогой, потому что через сеть проходит вся обучающая выборка:
Размер обучения | 2000 | 5000 | 10 000 | 25 000 |
Вывод TabPFN на 20 000 объектах, с | 84 | 160 | 333 | 1243 |
Время растёт быстрее, чем размер данных. Бустинги на этом фоне дешёвые: LightGBM учится за секунды, CatBoost — за десятки секунд на процессоре. Оборудование разное (CPU и T4), поэтому сопоставлять можно только порядки. До 50 000 объектов на T4 TabPFN довести не удалось: в режиме с кэшем не хватило памяти.
Менеджер, который покупает скидку, а не качество
Из этого родилась идея «менеджера моделей»: правила, которое по характеристикам режима выбирает, кому доверить предсказание. Если дефолтов мало и выборка не слишком велика, берём TabPFN, иначе CatBoost. Пороги подбираются перебором на валидации, а цель такая:
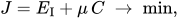
где  — ошибка I рода,
 — относительная стоимость вычислений,
 — цена вычислений: сколько ошибки банк готов уступить ради экономии времени.
Главный результат: менеджер не улучшает качество. При μ = 0 лучшим оказывается «TabPFN везде»: до 25 000 объектов TabPFN не уступает CatBoost ни в одном режиме, и переключаться не на что.
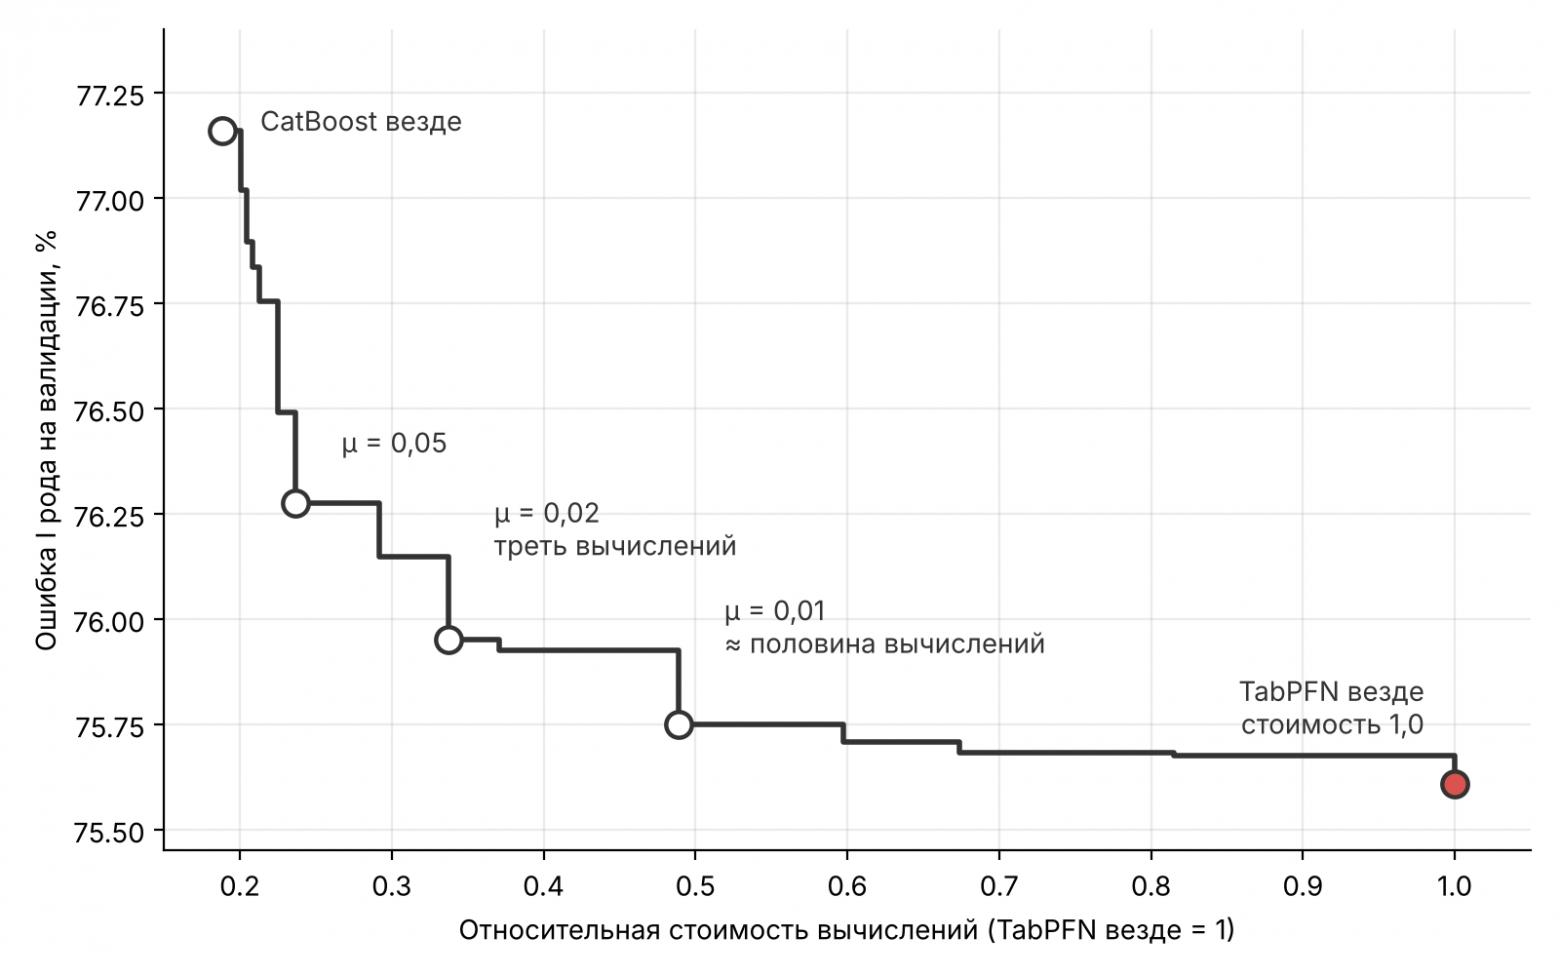
Менеджер задаёт компромисс между качеством и стоимостью вычислений:
Правило | Ошибка I рода | Отн. стоимость |
CatBoost везде | 0,777 | 0,19 |
TabPFN везде | 0,750 | 1,00 |
Менеджер, μ = 0,01 | 0,753 | 0,49 |
Менеджер, μ = 0,02 | 0,758 | 0,34 |
При μ = 0,01 мы платим +0,3 п.п. ошибки I рода (интервал включает нуль) и экономим около половины вычислений. При μ = 0,02 платим +0,8 п.п. (разница уже значима) и экономим две трети.
Оговорки: экономию даёт в основном ограничение размера выборки , а порог по числу дефолтов определяется слабо и нестабилен, если исключить один размер выборки. Так что это не готовое правило для прода, а методика, показывающая, где лежит граница компромисса.
Где модели ошибаются
Я посмотрел на ошибки отдельно. Вывод:
Обе модели пропускают в основном одних и тех же клиентов: 69,1% дефолтов пропущены обеими сразу, а поймать их хотя бы одной из двух удаётся лишь в 30,9% случаев (15,2% ловят обе, 10,7% только TabPFN, 5,0% только CatBoost). Поэтому «ансамбль мнений» тут мало что даёт.
Преимущество TabPFN сосредоточено у клиентов с короткой кредитной историей: при одном‑трёх прошлых кредитах она пропускает 56–57% дефолтов против 69–70% у CatBoost. Кроме того, пропущенные дефолты по имеющимся признакам почти неотличимы от добросовестных клиентов. Вероятно, решающие факторы лежат вне кредитной истории, а анкеты в данных нет.
Что я не проверял
TabPFN считался на подмножестве теста в 10 000 объектов, при размере обучения до 25 000, на одном ускорителе и без подбора гиперпараметров. CatBoost тоже не настраивался, так что при настройке разрыв мог бы сократиться. Выборка смещена (в ней только одобренные заявки), поэтому выводы о всём потоке заявок делать нельзя. Доверительные интервалы учитывают выбор объектов теста, но не разброс по обучающим подвыборкам, а времена измерены на разном железе и сопоставимы только по порядку величины.
Выводы
В скоринге с дисбалансом важнее число редких примеров, чем общий размер выборки.
На малых выборках и при редких дефолтах TabPFN не хуже CatBoost, а часто лучше, но платит временем вывода и ограничениями лицензии.
Бустинги остаются быстрой и дешёвой базой, особенно когда дефолтов достаточно.
Выбор модели — это выбор точки на кривой «ошибка и вычислительная цена», а не поиск победителя.
Код и скрипты воспроизведения: https://github.com/colziks/credit‑scoring‑model‑manager (данные в репозиторий не входят).