TL;DR. Пять месяцев ИИ-агент пишет производственное планирование для завода, который раньше жил в Excel. Я не читаю код вообще. Контроль вынесен в четыре вещи: правила, которые агент читает перед каждой задачей; тесты как контракт к каждому жёсткому правилу; храповик, который не даёт тестам слабеть молча; и ТЗ, которое растёт вместе с эксплуатацией. Это всё по отдельности не ново, но агент держит всё это вместе, синхронно при каждой правке. В командах людей обычно такой синхрон рассыпается на втором месяце. Ниже цифры за пять месяцев, включая набитые шишки и два случая, где модели попроще разобрали те же задачи, что и Opus: каждая сторона нашла то, что пропустила другая.
Страшилки ИИ-генерации
Агентофобию я преодолевал в прошлом году: он нагенерит код, который никто не поддержит. Через полгода в нём будет столько же смысла, сколько в отчёте, написанном за пять минут до дедлайна. Высматривать каждую правку при темпе в несколько PR в час невозможно, а без ревью непонятно, что вообще поехало в прод.
Я практикую такой подход:
Если код не читать, контроль надо вынести из кода туда, где его можно проверить машиной.
Это опыт нескольких проектов на одном ядре, повторяемость и сходимость процесса я для себя подтвердил этой практикой.
С чем сравниваю
Проект: приём заказов на резку плёнки и планирование производства на несколько станков. До нас планирование жило в книге Excel на три-четыре экрана шириной. Формулы ссылались на другие книги, целиком всё не обозреть на мониторе никак. Ошибка в ячейке вспучивалась на складе через неделю, когда не оказывалось запаса нужного артикула.
Чистый вайбкодинг сваливается в штопор уже на втором-третьем витке усложнения, уже есть опыт нескольких поколений вайбкодеров, живущих 5-9 месяцев от головокружительного успеха с лендингом и чат-ботом до полного фиаско на полноценном бэкенде.
Альтернативой вайбкодингу на малом и среднем производстве так и остаётся та книга Excel. Сравниваю агента с ней, а не с командой программистов, которую гипотетически могли бы нанять (в данном случае стоп-фактор — цена).
Четыре механизма
Правила. В корне репозитория лежит документ, который агент читает перед каждой задачей. Про стиль кода там нет ничего, только процесс:
прогоняй весь гейт (полный набор тестов и проверок CI), а не свой файл;
сначала падающий тест, потом код;
правило записывай в исполняемую форму, документ обновляй вдобавок, а не вместо;
чужой тест не твой черновик.
Каждый пункт появился после разбора разных типов дефектов. Первые три — из одного: замер показал 64 красных теста при отчётах «все тесты зелёные», потому что каждый гонял только свой файл, а CI не запускался ни разу. Четвёртый — после того как одно правило чинили девять раз: оракулы правились вместе с фиксом, и тикет вернулся с дословно тем же заголовком.
Тесты как контракт. У жёсткого правила ТЗ должна быть проверка (где её пока нет — ниже, в «Чего это не покрывает»). Для планировщика это реестр инвариантов: 13 правил вроде «день, закреплённый вручную, не сдвигается», «обеспечение совпадает с заказом в сумме всех заданий», «наладка в цепочке одна». Реестр исполняется на каждом плане, и каждое правило из него упомянуто минимум в двух тест-файлах. Тесты проверяют поведение. Проверки по тексту исходника запрещены отдельной проверкой в CI: «в файле есть строка X» ломается от переименования и ничего не говорит о том, работает ли программа.
Храповик. Тесты только добавляются. Если правка удаляет или меняет существующее утверждение в старом тест-файле, сборка краснеет. Разблокировать можно одной строкой в описании PR: RATCHET-OK: почему и чьим решением. Скрипт на bash, проверяет diff и больше ничего.
Появился он из боли. За 36 коммитов после появления гейта агент переписал ожидания у 21 существующего теста. Один тест про закреплённый день переписывался трижды, и правило вернулось тикетом от заказчика с тем же заголовком, что и первый. Тест красный, агенту надо закрыть задачу, самый короткий путь поправить ожидание. Человек на его месте делает то же самое, пусть и реже, когда лень разбираться.
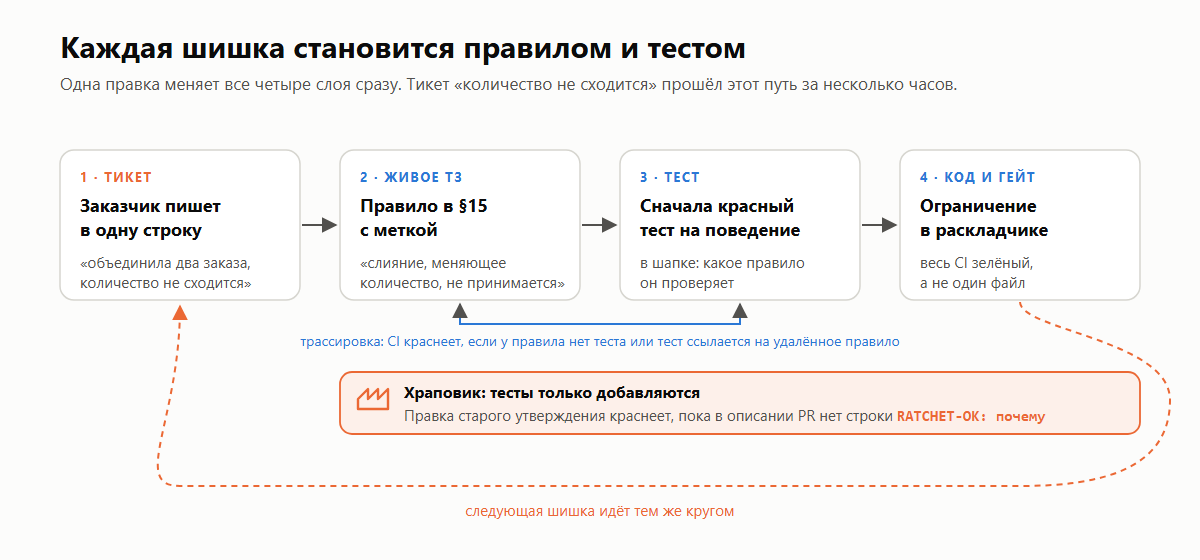
Живое ТЗ. ТЗ проходит четыре стадии: изложили, реализовали, параллельный запуск со старым Excel, опытная эксплуатация. Каждая шишка становится правилом в §15 ТЗ и тестом. Вот фрагмент как есть:
Совмещение заказов в одной резке — только с сохранением количества (решение заказчика 22.10.2026). Слитая резка обязана производить для каждой заказанной ширины обеих групп ровно столько, сколько та производила бы в собственной резке. У резки одно число проходов на все ширины, поэтому «выгодное» по прогонам слияние раздувает производство гостя (боевой случай: 80 мм — было 11 полос × 10 проходов = 110 шт. при заказе 110, слитно стало 1 полоса × 115 проходов = 115 шт.). Слияние, меняющее количество, не принимается — заказы режутся раздельно.
Заказчик написал тикет в одну строку: «программа объединила два заказа в один, резку сделала правильно, но количество не сходится». Через несколько часов это было правило, тест и ограничение в раскладчике. Сам раскладчик при этом остался тем же, просто одной из его оптимизаций стало нельзя пользоваться.
Откуда всё это взялось на самом деле
Примерно раз в неделю прилетал тикет с до боли знакомым заголовком, и я писал агенту что-то вроде «ну как тебе ещё объяснять, чтобы эта лажа не повторялась?». Без всякой надежды на ответ, просто чтобы выпустить пар.
А он каждый раз отвечал по делу. Не каялся, не клялся «больше никогда», а спокойно разбирал, почему правило не сработало, и предлагал что поменять вокруг него. Если пересказать своими словами его ход мыслей: документ я могу и не дочитать, а мимо красного теста не пройду; чужой тест поправил, потому что ничто не мешало; проверка по тексту зелёная — всё ок (хотя по факту всё уже сломано). Я тыкал его носом в его же признания, а он делал из этого строчку в правилах или проверку в CI, и она работала.
Так что четыре механизма выше — это его советы, он же их причесал и систематизировал. Оговорюсь: объяснения модели о собственных ошибках это правдоподобная реконструкция, а не доступ к настоящим причинам. Ценны они не точностью самодиагностики, а тем, что из каждого получается проверяемая мера. Сработала ли мера, показывает CI, подтверждая или опровергая гипотезу, и я доволен опытом проекта:
Агент хорошо подсказывает, где у него слабое место, а проверяет подсказку CI.
Не нужно угадывать вслепую. Спросил, получил гипотезу, закрепил тестом, посмотрел, держит ли.
Складываем пазл
Ни один из четырёх механизмов не придуман сейчас. TDD старше многих читателей, ТЗ пишут с советских времён, правила команды висят в каждом конфлюенсе. Почему у людей это не работает, хотя все знают, что надо?
Потому что процесс требует, чтобы при каждой правке все четыре слоя менялись вместе. Человек правит то, что вспомнил. Документация в конфлюенсе значительно расходится с кодом на второй месяц, а потом её перестают открывать. Тест, который мешает, переписывают в пятницу вечером. Никто не держит в голове всю картину, и никто не обязан её держать.
Агент не умнее программиста, у него просто нет проблемы с памятью в этом смысле. Он перечитывает правила, ТЗ и тесты при каждой задаче, потому что так устроен его рабочий день. Это дорого, если платить человеку, и дёшево, если платить за токены. За пять месяцев ТЗ и сопутствующие документы выросли с 1 300 до 10 500 строк, и агент перечитывает нужные куски каждый раз. Человек бы их не открыл.
Для меня это главная мысль статьи.
Дорогой процесс, который все рекомендуют и никто не выполняет, наконец стал выполнимым.
Модель здесь работает как очень дисциплинированный исполнитель с бесконечным терпением к чтению документов, гениальности от неё не требуется.
Чего это не покрывает
Дальше будет полезная часть для того, кто захочет повторить.
Оговорка: под всем этим в нашем случае работает Интеграм — логика бэкенда описана данными без кода, и любое приложение работает через одни и те же 26 методов ядра: описание схемы (DDL), чтение и запись данных (CRUD), запросы и метаданные. Для процесса это важно в одном месте: агенту не надо каждый раз учить новый API, и тест на «записалось ли количество» выглядит одинаково для любой таблицы. Это заметно облегчает задачу. На обычном стеке, где у каждой таблицы свой API, такие тесты придётся писать под каждую, и сеть тестов обойдётся дороже. Насколько дороже, я не мерил, так что переносимость выводов на другой стек остаётся открытым вопросом.
Параллельная работа не вскрывает дефекты методологии. Сравнение с Excel ловит расхождения между двумя системами. Если станок ушёл в плановый ремонт (ТО), а в Excel этого нет и в программе нет, обе выдадут одинаковый неверный план, и сверка покажет ноль. Единственное, что ловит такое, это сравнение «факт против плана». Мы его сделали задним числом: подняли журнал 1 246 заданий за три месяца и посмотрели, где реальность разошлась с расписанием. Простои там видны только через отдельную таблицу отпусков станка, которую теперь заполняем руками — в Excel календарь ТО не влиял на план, а у нас влияет.
Поведенческие тесты не ловят уязвимости. Тест проверяет, что количество сохранилось, а не то, что оператор одного цеха не прочитает заказы другого. Права и аудит у нас в ядре и проверяются отдельно, тестами планировщика они не покрыты вообще. Если ваше ядро этого не делает, четыре механизма выше вас не защитят.
Столп держит только размеченное. Правило без теста уезжает так же, как конфлюенс. У жёстких правил §15 ТЗ и у 13 инвариантов реестра ссылки на тесты есть, хотя и не у всех. Мягкие правила, а это основной объём ТЗ, долго не имели идентификаторов вовсе: правку их прозы не ловило ничто, и сколько из них без проверки, сказать было нельзя. Цена этого видна со стороны. В какой-то момент заказчик сказал, что мы уже полтора месяца топчемся на месте. Мы не топтались, новые функции шли одна за другой, но одни и те же косяки возвращались слишком часто, и заказчик видел именно их. Теперь у проверяемого правила есть метка в ТЗ, тест в шапке объявляет, какие правила он проверяет (или что это тест на разовый дефект), и CI краснеет, если у правила нет теста, у теста нет правила или тест ссылается на удалённое правило. Сотни старых тестов разом не разметить, поэтому для них тот же храповик, только по счётчику: число неразмеченных может только уменьшаться. Размечен пока самый горячий раздел, правила про фольгу и переносы заданий (только по фольге за июнь и июль пришло 22 тикета). Сверка сразу показала то, чего я не знал:
что | сколько |
|---|---|
жёстких правил в §15 ТЗ / ссылок из них на тест-файлы | 29 / 24 |
размеченных правил в горячем разделе / из них без теста | 12 / 2 |
инвариантов реестра / заявлены строкой в шапке теста | 13 / 1 |
тестов планирования / не объявляют, что проверяют | 292 / 272 |
Инвариант, упомянутый в тесте по имени, тестом на правило не считается, отсюда «1 из 13». Про неразмеченные разделы я не знаю ничего, но это число на виду и может только уменьшаться.
ТЗ растёт. 10 500 строк за пять месяцев, в восемь раз, и рост линейный по числу шишек, а шишки не кончаются. Сжимать его, сливая частные правила в общие, я не хочу: это риск потерять правило ради экономии строк. Объём решается в рабочем порядке декомпозицией, так же, как уже решился для кода. Табличный компонент когда-то дорос до 15 700 строк в одном файле, и читать и править его целиком агенту стало ненадёжно. Его разрезали на модули по смыслу, сборка склеивает их обратно в тот же файл, и агент открывает только нужный модуль. С ТЗ и инструкцией для агента делаем то же: каждый раздел в своём файле, общий документ собирается из них для того, кому он нужен целиком. Рост от этого не прекращается, но перестаёт мешать: агент читает раздел, который касается задачи, а размер остального ему безразличен.
📎 Мешает ли агенту размер ТЗ: проверка по логам и тикетам (для тех, кто любит проверять)
Прежде чем резать, я проверил, есть ли что лечить. Вопрос был в том, теряется ли агент в большом документе, и проверял я его двумя способами.
Как агент читает ТЗ. Я разобрал логи 335 сессий агента и посмотрел все обращения к трём основным документам ТЗ (около 7 100 строк из 10 500). Целиком документ не читался ни разу. Агент сначала ищет нужное место поиском, потом открывает кусок вокруг него. Ошибок правки (не нашёл фрагмент, правил устаревшую копию) ноль. На самый ходовой документ за сессию уходит порядка 5 тысяч токенов. Даже с учётом того, что прочитанное потом оплачивается на каждом следующем шаге, это меньше процента входных токенов этих сессий.
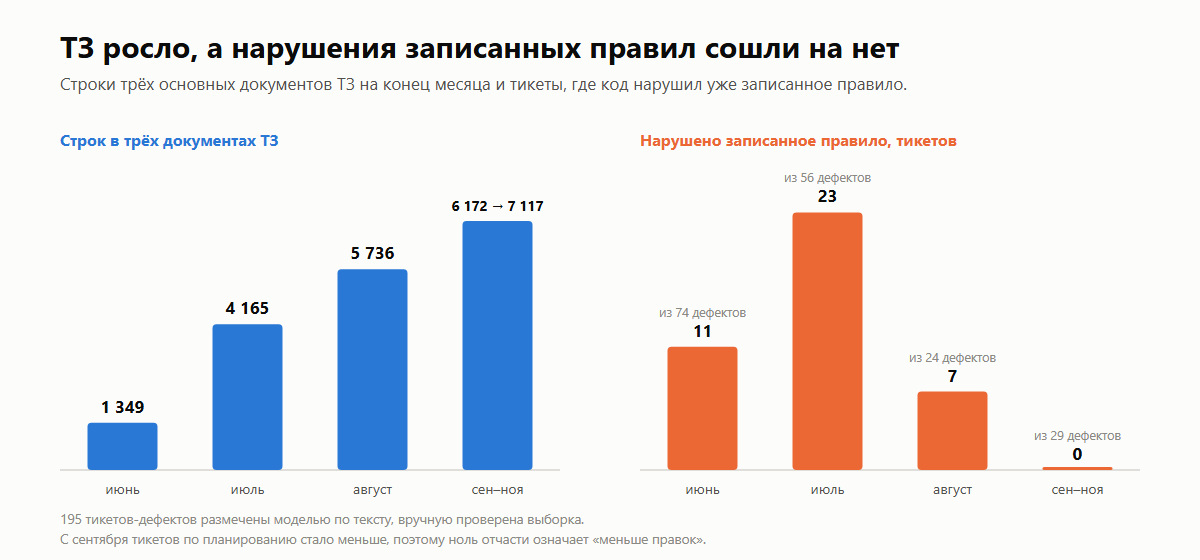
Возвращались ли записанные правила. Я разметил 195 тикетов, похожих на дефекты, по четырём классам: код нарушил правило, которое уже было записано; дефект самого ТЗ (правила не было или правила противоречили друг другу); обычная ошибка; не дефект. Это та самая метрика возвратов, которую ниже я называю недостающей. Пока она грубая: модель размечала тикеты по тексту, а я выборочно проверял.
месяц | строк в трёх документах ТЗ | тикетов-дефектов | из них нарушено записанное правило |
|---|---|---|---|
июнь | 1 349 | 74 | 11 |
июль | 4 165 | 56 | 23 |
август | 5 736 | 24 | 7 |
сентябрь–ноябрь | 6 172 → 7 117 | 29 | 0 |
Из 41 нарушения 11 случились, пока правило жило только в тикете, а самого ТЗ ещё не было. Нарушений правил, которые уже стояли в ТЗ, 30.
ТЗ продолжило расти, а нарушения записанных правил сошли на нет. Если бы агент терялся в большом документе, кривые шли бы вместе. Нарушения июля и августа устроены иначе: одно и то же правило ломалось многократно. Ограничение длины рабочего дня вернулось 11 раз, и почти каждый раз его ломала правка соседней кнопки. Это регрессии, а не «не нашёл», и лечатся они храповиком и стражем, а не нарезкой. Ещё шесть августовских тикетов — дефекты самого ТЗ: два правила противоречили друг другу, а в движке и в тексте стояли разные числа. Такое нарезка тоже не ловит, это работа трассировки «правило ↔ тест».
Отсюда честная формулировка: декомпозиция ТЗ нужна для удобства правки (раздел легко открыть целиком, правка не того файла ловится сборкой в CI), а не как защита от ошибок агента. Защита — тесты. Оговорка та же, что и выше: с сентября тикетов по планированию стало меньше, так что ноль отчасти означает и «меньше правок». Логи, кроме того, только с одной машины.
Реестр правил перехватывает, но не лечит. Страж здесь означает проверку в самом планировщике: перед записью плана он снимает операции, нарушающие инвариант реестра. Тикеты про нарушение жёстких правил планирования почти исчезли, и сначала хотелось записать это на счёт реестра. Посчитал честнее, по журналу планирования: 21,8 тысячи записей за август–октябрь. Движок по-прежнему предлагает операции, нарушающие жёсткие правила, от 0,2 до 1,2 раза на одно нажатие «Сгенерировать» или «Упорядочить», и тренда вниз нет. Страж на записи такие операции снимает, поэтому до заказчика они не доходят, но причина в движке осталась. Обратная сторона: снятая операция значит, что нажатие выполнилось не целиком, и рано или поздно придёт тикет «нажал, а ничего не произошло».
И ещё одно: общий поток тикетов по планированию упал в восемь раз, с 40 до 5 в неделю, а контрольная тема (правила про фольгу, которых в реестре нет) ушла в ноль точно так же. Так что спад реестру приписать нельзя, он мог случиться и от стабилизации. То же относится к процессу целиком: что он работает, я вижу по потоку тикетов, но причинную связь не доказывал, и контрольной группы у меня нет. Теперь страж пишет в журнал, какое именно правило сработало; через квартал станет видно, какие правила срабатывают постоянно, а какие ни разу (и жив ли у таких тест).
Нет эталона, нет процесса. Всё держится на том, что было с чем сравнить: книга Excel, поведение операторов, решение заказчика. В новом продукте, где эталона нет, живое ТЗ вырождается в обычное: пишем, что придумали.
Храповик при этом работает, но защищает он уже наши догадки о реальности.
Цифры
Срез на 6 ноября 2026 года, с первого коммита проекта 30 мая.
31.05 | 31.07 | 30.09 | 06.11 | |
|---|---|---|---|---|
Тест-файлов проекта | 22 | 309 | 435 | 494 |
Проверок в них | 281 | 5 090 | 7 636 | 9 008 |
Строк в ТЗ и документах проекта | 1 300 | 6 300 | 9 400 | 10 500 |
Проверки считал по вызовам утверждений в коде тестов, цифра занижена: циклы проверяют больше, чем написано строк.
Храповик работает с 30 июля. За три месяца строка RATCHET-OK появилась в 57 PR этого проекта. Причины типовые: заказчик поменял решение («заточка ножа больше не обнуляет пробег»), ожидание устарело физически (наладка 15 минут оказалась 55), чужой тест проверял текст исходника. Ослабление без объяснения не прошло ни разу, потому что без строки сборка красная, а со строкой причина видна в истории.
Из 1 385 прогонов CI с конца июля красных 81. Из них 41 уронил именно храповик, это 30 разных PR. Значит, агент примерно раз в три дня пытался изменить существующий тест и упирался. Красных PR по проекту 34 из 241 с прогонами.
До храповика был карантин: на 27 июля 64 тест-файла числились красными «временно». Сейчас ноль.
Главный эффект виден по регрессам. С июня по август каждый пятый-шестой тикет по планированию был регрессом, 18%, и эта доля не менялась месяцами. С сентября она 5%: два-три регресса в месяц вместо десяти в неделю. Тикетов в целом тоже стало намного меньше (об этом ниже), но доля от этого не зависит. Падение приходит через две недели после включения храповика. В первой половине августа ещё доделывались задачи, начатые до него, и регрессы шли по старым темам: потерянные резки, недобитый день. Последний из них 13 августа, дальше почти месяц ни одного. Доказательством это не считаю, в те же недели менялось и многое другое, но лучшего объяснения для доли у меня нет.
Время от пожелания до правки у заказчика я считаю от создания тикета до слияния PR: выкладка идёт сразу после слияния, так что это и есть время до прода.
По 378 задачам, закрытым принятыми PR:
значение | |
|---|---|
медиана | 0,8 часа |
до часа | 55% задач |
до четырёх часов | 79% |
до суток | 98% |
90-й перцентиль | 9,6 часа |
дольше недели | 2 задачи |
Отсчёт идёт от тикета, а пожелание иногда жило до него в переписке, поэтому это нижняя граница. Неприятная деталь: в октябре медиана выросла с привычного часа до 2,4 часа. Это вторая фаза проекта, где задачи крупнее и чаще упираются в решение заказчика, и простой в ожидании ответа тоже сюда входит. Сравнивать предлагаю каждому со своей командой. Понятно, эти числа иллюстрируют скорость, а не доказывают качество. Задачи разного размера, а долю задач, вернувшихся повторным тикетом по тому же правилу, до и после храповика я не считал. Это была бы правильная метрика, её у меня пока нет.
Теперь про поздно вскрытый косяк. Сколько расхождений поймал параллельный запуск и по каким причинам, я посчитать не могу. Мы не завели учёт: расхождение становилось тикетом, тикет закрывался, и класс причины нигде не записан. По тем случаям, которые я помню и нашёл, картина пёстрая. Программа теряла часть количества при склейке заданий, ошибка программы, стала инвариантом. Менеджер в Excel раскладывал полосы с отходом 21–31 мм, а программа давала 95 мм, потому что не знала приоритета направлений: пробел в требованиях. Остатки сырья в метрах и квадратных метрах разошлись в разные знаки, и выяснилось, что это две независимые меры по замыслу, а не ошибка: пробел в модели данных, хотя по дороге нашлась и настоящая ошибка программы. Оператор отметил резки, а событие «завершить» не записалось: пробел в данных.
Если будете повторять такое, заведите поле «причина расхождения» в первый же день.
Две задачи, два решения
Полноценный опыт «одно ТЗ, три модели» я не ставил. Получилась дешёвая версия почти случайно: по двум задачам у меня есть принятые PR с тестами, а две модели попроще, MiMo 2.5 Pro и GLM 5.3 Flash, параллельно подготовили свой разбор тех же задач. Принятые PR писал агент на Opus, он же проверял их по коду. Потом отдельный проход модели сверил разбор с принятым решением. Принятых PR модели попроще не видели, решали по тексту задачи и коду. Задачи я не отбирал: это просто две, по которым у меня оказались оба решения. Принятый PR здесь тоже не эталон, ниже видно что он пропустил.
Первая задача про диаграмму Ганта резки: добавить номер заказа клиента в подпись полосы и спрятать ссылки на планирование, если у роли нет права на запись в таблицу заданий. Первую половину разбор сделал правильно. Во второй написал так:
self.hasZadanieWrite = !!(zadanieMeta && String(zadanieMeta.granted).toUpperCase() === 'WRITE');
Сверка нашла три проблемы. Если метаданные не загрузились, ссылки пропадают у всех, включая тех, у кого право есть; принятый PR прячет их только при заведомом запрете. Право может прийти составным, WRITE, DELETE, и строгое сравнение его не пропустит; в PR на это отдельный тест. Подсказка «открыть в планировании» осталась бы у тех, у кого ссылки уже нет. Тестов в разборе не было вообще, в PR их 11 новых и 7 обновлённых ожиданий.
Сверка при этом перегнула. Первое замечание она назвала нарушением требования, хотя в задаче написано буквально «скрывать, если нет WRITE», и разбор прочитал её буквально. «Прятать только при заведомом запрете» решил автор PR по ходу, в тексте задачи этого не было. И это удобство, а не безопасность: права всё равно проверяет сервер.
Вторая задача про табличный компонент. Справочники, доступные по ссылке, приходят в метаданных без ключа granted, и компонент считал их доступными на запись. Принятый PR поправил проверку и нормализовал отсутствующий ключ в READ везде, где присваивается право таблицы. Разбор предложил то же самое, но нашёл место, которого PR не касался: у формы редактирования записи была своя нормализация.
const metadataGranted = metadata.granted !== undefined ? metadata.granted : null;
const formIsReadOnly = metadataGranted !== null && metadataGranted !== 'WRITE';
Нет ключа, значит null, значит форма редактируемая: «Сохранить», «Удалить», «Дублировать» у справочника, который роль менять не может. PR вылечил список и правку в ячейке, а открытую карточку нет. Это пропустили и тесты, и самопроверка агента по коду. Исправление ушло отдельным PR.
В обратную сторону вышло так же. Разбор не заметил, что собранный файл компонента на main разошёлся с модулями: часть кода жила только в сборке, и первая же пересборка её теряла. Это поймал уже существующий тест. Разбор же предлагал править файл по номерам строк и закрепил бы дрейф. Не увидел он и побочного эффекта: ядро не выдаёт granted администратору, и после фикса тот увидел бы все таблицы read-only. В PR это было вынесено вопросом и закрыто следующей правкой.
нашёл разбор | нашёл принятый PR | |
|---|---|---|
Гант | подсказка, составное право, тесты | осторожность при сбое метаданных |
Таблица | форма редактирования | дрейф сборки, администратор без прав |
Что я из этого вынес. Модель попроще ошибается, но не молча: её ошибки видны и ловятся сверкой и тестами. Делить исполнителей на сильных и слабых здесь неинтересно, находки достались обоим. Интереснее, что два решения плюс тесты вытаскивают разногласия быстрее ревью.
Ошибки собрались на развилках, которые нигде не записаны. В обоих случаях вопрос один, «что делать, если данных о правах нет», только в первом это неизвестность, а во втором известный смысл «доступ по ссылке». Граница между ними лежала в голове автора PR. Сеть защищает записанное, а новая развилка остаётся без защиты, пока шишка не станет правилом и тестом.
Ещё про источники ошибок. Общую слепую зону сеть не видит: форму пропустили и PR, и тесты, нашёл её только второй проход, который искал тот же шаблон по всему коду. А тест, который потом закрыл форму, проверяет текст исходника, хотя такие тесты у нас запрещены. Сторож (проверка в CI, которая не пускает новые тесты по тексту исходника) искал assert(src.includes(…)), а тест обернул проверку в свою функцию check(…), и сторож её не узнал. Запрет на бумаге и запрет в CI разошлись, ровно как в разделе выше про правила без теста. Сторож я после этого поправил по тому же процессу: сначала тест на сам сторож, красный на четырёх случаях из семи, потом регулярка. Прогон по всем 934 тест-файлам показал ещё 14 таких строк в трёх старых тестах, ложных срабатываний ноль. Старые тесты сторож не трогает, он смотрит только новые строки, так что эти 14 остаются долгом.
Два правила я планирую добавить в документ для агента. Поведение при отсутствии данных о правах записать явно (ссылки не прячем, таблицы без granted считаем read-only) и покрыть тестом поведения. Собранный файл проверять пересборкой в CI и сравнением с закоммиченным: сейчас «пересобери и закоммить оба» есть только строкой в правилах.
Это два случая, статистики тут нет. Сверку делала модель, и в одном выводе она сама ошиблась; сверка с принятым PR говорит «отличается», а не «неверно». Измерением это станет, когда тесты принятого PR прогонят против реализации, написанной моделью попроще и посчитают, сколько покраснеет. Такой таблицы у меня пока нет.
Что делать, если хочется попробовать
Начать с одного правила, одного теста на него и храповика с первого дня. Храповик стоит двадцать строк bash и окупается на первой неделе, а вводить его задним числом пришлось через разбор 64 красных файлов.
Заказчику не обещать, что агент «понимает производство». Обещать, что каждое его замечание через несколько часов станет правилом с проверкой, и показать эту проверку.
Где развилка важная, давать задачу двум исполнителям и сверять решения: это дешевле ревью и находит то, что каждый по отдельности пропускает.
Не пробовать там, где не с чем сравнить. Без старой книги Excel, без журнала факта или без человека, который скажет «количество не сходится», процесс превращается в аккуратное оформление собственных предположений.
Это наш путь, и он не закончен. Трассировка правил покрывает пока один раздел ТЗ, ТЗ не сжимается, учёт расхождений придётся заводить заново. Но с каждой шишкой, превращённой в правило и тест, мы чувствуем себя всё комфортнее: возвратов по зарегистрированным правилам, по моим наблюдениям, почти не бывает (посчитать их я ещё не успел), а новые развилки видны раньше, чем доходят до заказчика.
P.S. Меня до сих пор слегка угнетает, что самой полезной строкой во всём процессе оказалась RATCHET-OK:. Не модель, не архитектура. Требование: Стоять! Напиши причину, прежде чем ослабить тест. Людям, видимо, нужно было то же самое грубое ограждение, просто им никто его не поставил.