Дисклеймер
Я буду упоминать много разных сервисов в этой статье. Но это не реклама ни одного из них. Более того, я снёс у себя все эти сервисы.
Месяц назад мне пришла в голову идея сделать YouTube-канал, для которого вообще не придется снимать видео. Не в смысле нарезать чужие ролики или накладывать нейросетевой голос на картинки, а создать полноценную цифровую копию себя. Чтобы она сидела перед камерой, рассказывала интересные вещи, меняла ракурсы, а я занимался только подготовкой контента.
Выглядело это как идеальная возможность масштабировать производство видео. Не нужно выставлять свет, записывать по десять дублей, бороться со своей дикцией и потом часами монтировать материал. Написал сценарий, запустил генерацию, получил готовый ролик. Причем не какой-нибудь минутный шортс, а полноценное десятиминутное видео с ведущим, хорошим монтажом и инфографикой.
Я потратил какое-то время на эксперименты, собрал почти полностью автоматизированный процесс, научился делать такие ролики буквально за несколько долларов и даже получил несколько тысяч просмотров на одном из первых видео.
А потом обнаружил, что люди почему-то предпочитают смотреть на меня настоящего, сидящего в темной комнате с микрофоном за 300 рублей, чем на мою идеальную цифровую копию.
Но обо всем по порядку.
Зачем мне вообще понадобился AI ютуб канал
У меня есть мобильное приложение для изучения иностранных слов. Я занимаюсь его разработкой и продвижением и постоянно экспериментирую с разными источниками органического трафика. Один из таких источников, который давно хотелось попробовать, это YouTube.
Идея была довольно простой. Сделать отдельный канал про изучение иностранных языков, где ведущий рассказывает о разных методах запоминания слов, особенностях языков и научных исследованиях в этой области. А где-то по ходу видео можно нативно упоминать мое приложение, если оно подходит по контексту.
Проблема только в том, что полноценное производство видео довольно трудозатратное. Нужно подготовить сценарий, выставить свет, записать материал, смонтировать, добавить иллюстрации. А если хочется регулярно выпускать ролики, все это превращается в отдельную работу.
И тут я подумал, что современные нейросети уже достаточно хорошо генерируют людей. Почему бы не попробовать автоматизировать вообще весь процесс?
Как я создавал свою цифровую копию
Первым делом я начал изучать сервисы, которые могут оживлять изображения. Сначала я сделал ролик через Hedra и даже опубликовал. Но пришлось его удалить, потому что получилось слишком плохо. King AI сделал еще хуже.
Нормальный результат получился только в HeyGen на самой дорогой модели Avatar 6. Около $1 за минуту видео.
Но просто создать говорящую голову мне было недостаточно. Я хотел, чтобы ролик выглядел как нормальная съемка, где есть несколько камер, меняются планы, появляются перебивки и инфографика. Поэтому решил подготовить сразу несколько вариантов своего аватара.
Я сделал обычные фотографии себя с разных ракурсов, а потом с помощью ChatGPT превратил их в полноценные сцены с одинаковым фоном. Студия тоже сгенерированная, ествественно.
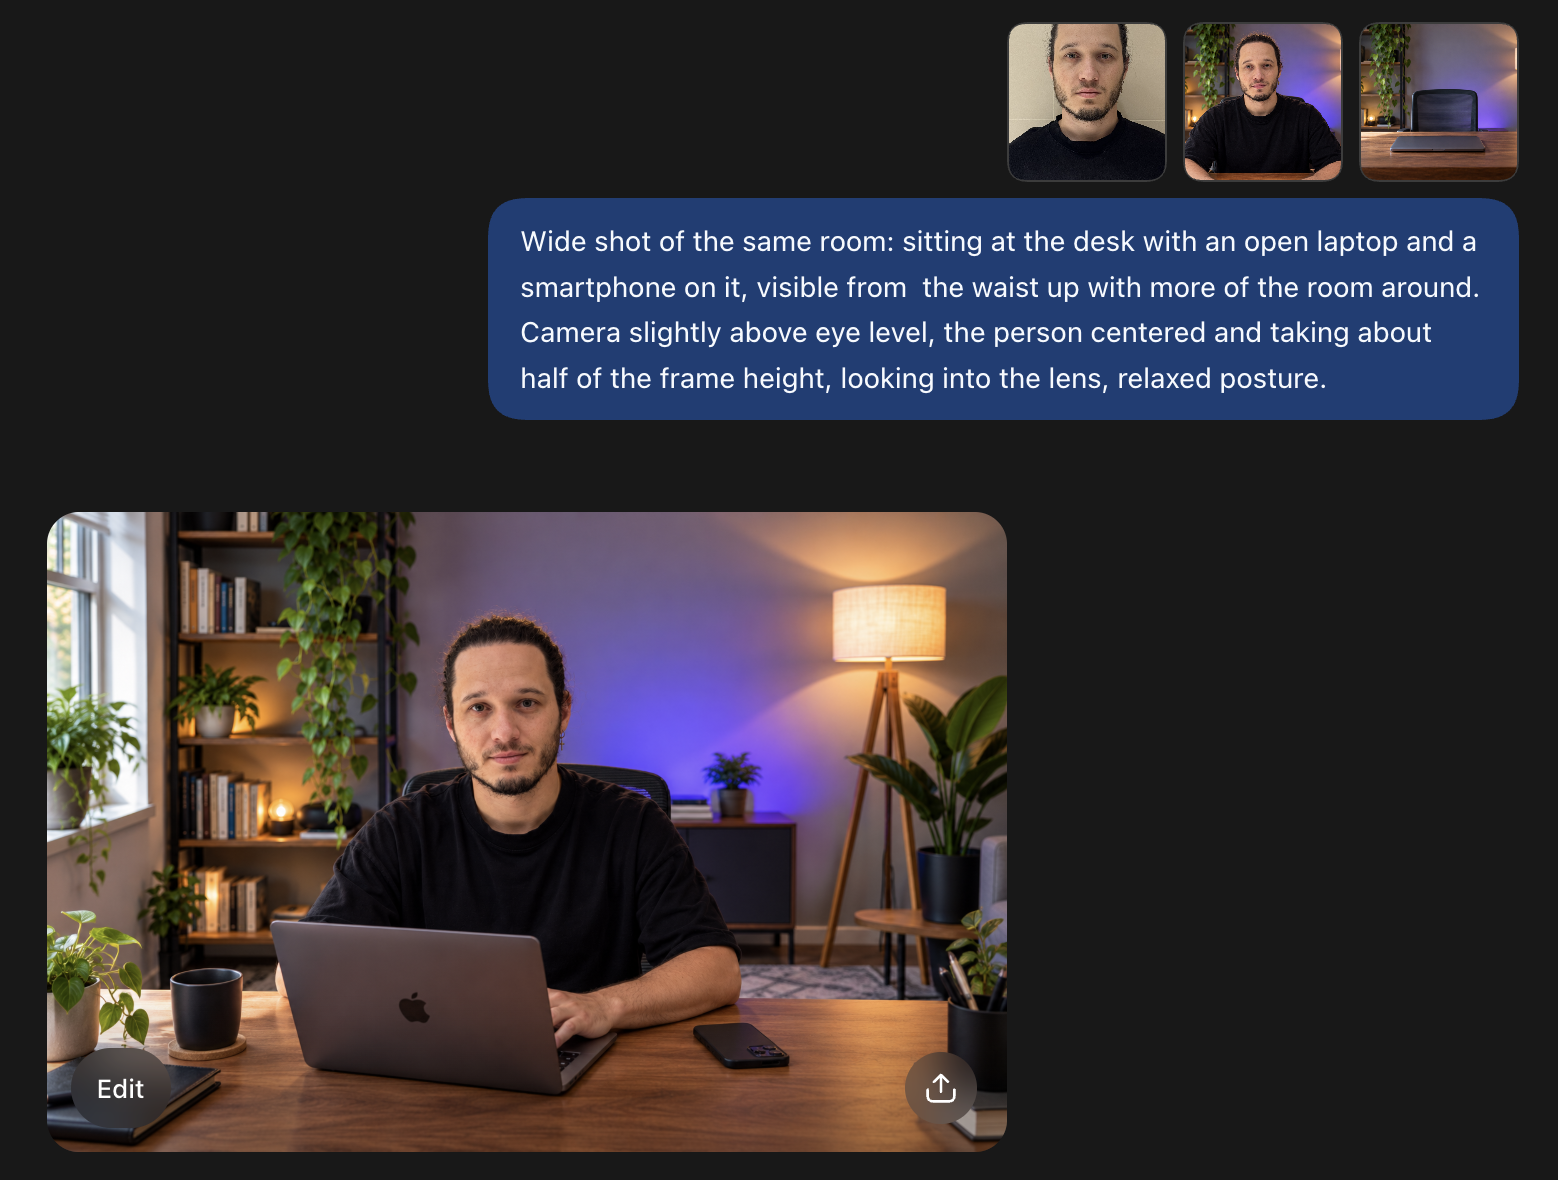
Получилось что-то вроде виртуальной студии, в которой можно переключаться между несколькими камерами:
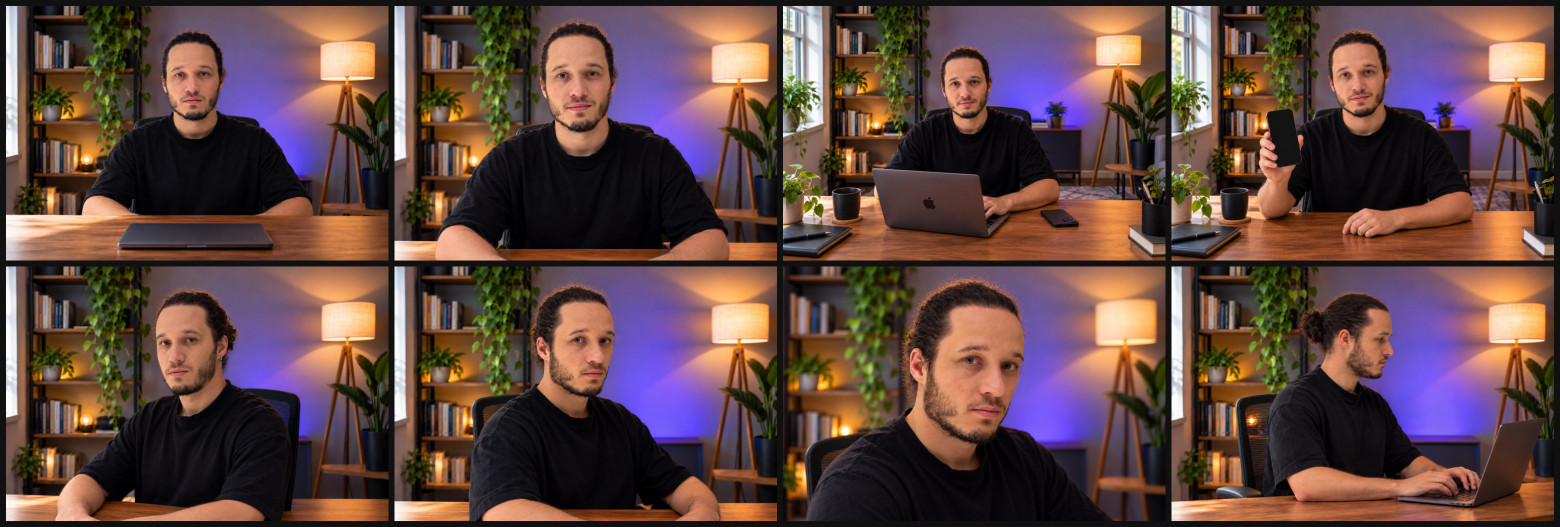
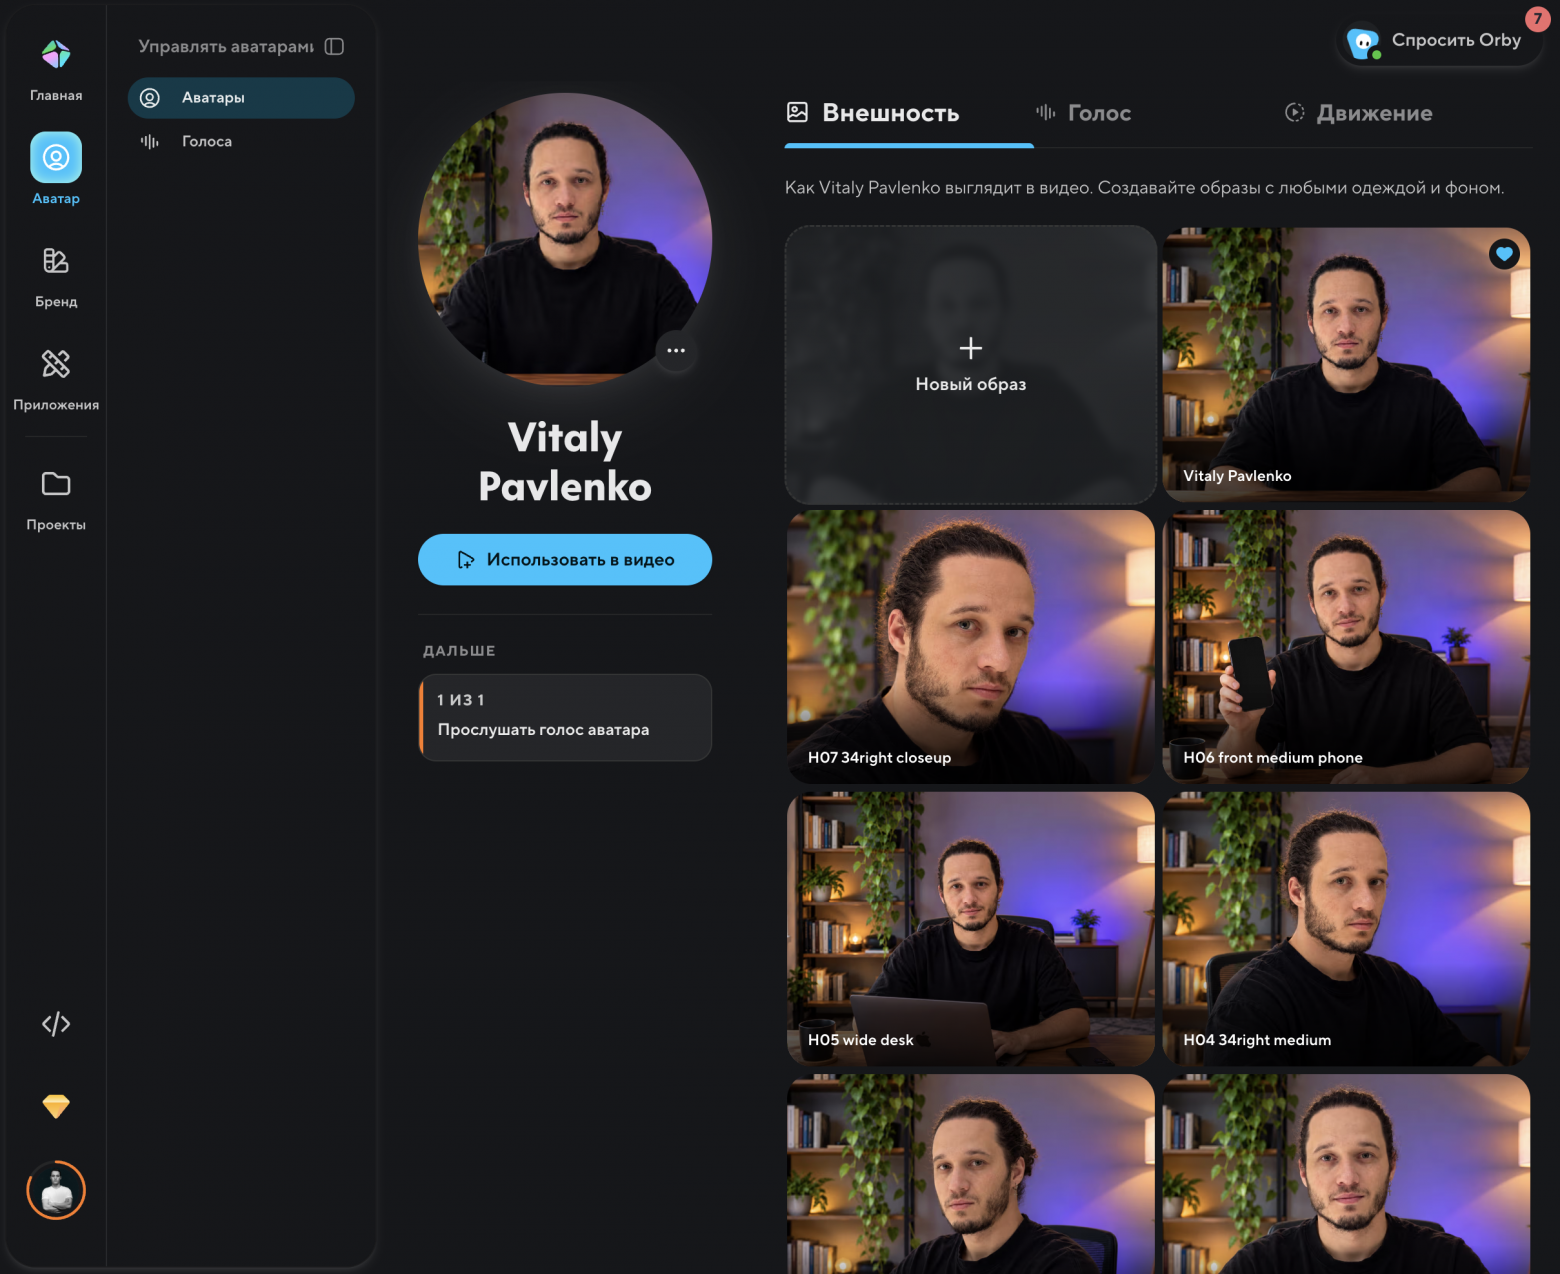
Затем на основе этих сцен создал в HeyGen несколько конфигураций аватара.
Дальше началась самая интересная часть. Я хотел не просто вручную загружать текст в HeyGen и скачивать готовое видео, а автоматизировать производство целиком.
Для этого использовал Claude Code. Он готовил сценарий и сразу разбивал его на отдельные сцены с раскадровкой. То есть определял, какой текст произносится в каждом фрагменте, какой ракурс использовать, когда переключиться на крупный план, а когда показать инфографику.
Я старался сделать так, чтобы это было похоже на обычный видеомонтаж. Не держать человека десять минут в одном неподвижном кадре, а периодически менять планы, чтобы ролик выглядел живее.
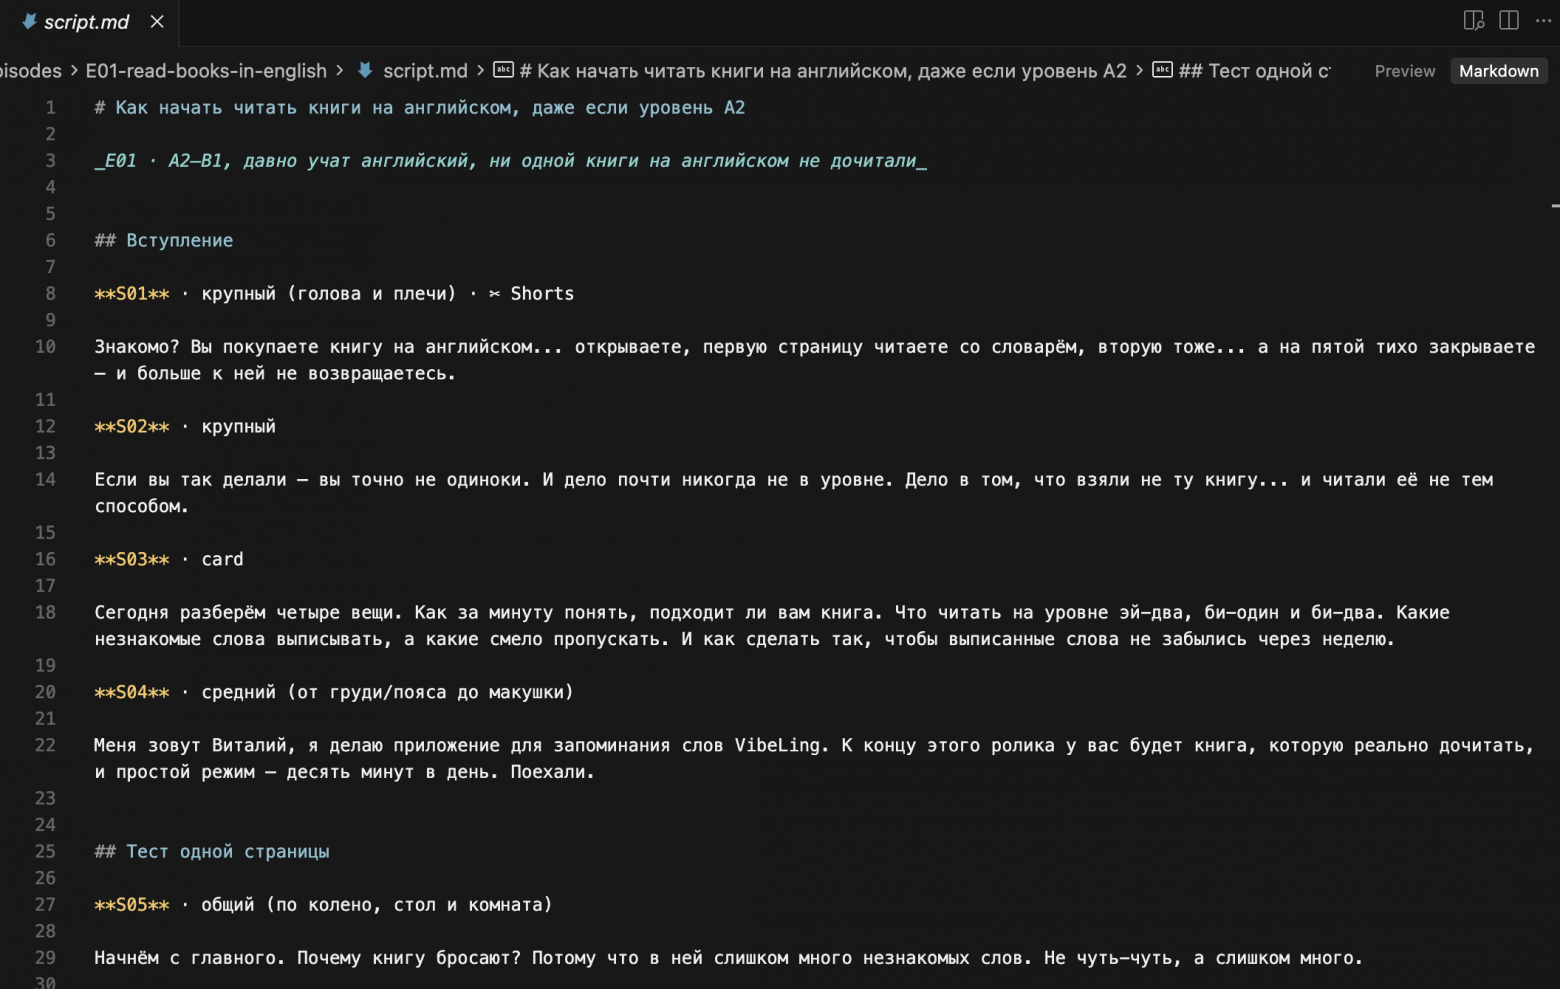
После подготовки сценария Claude Code запускал генерацию аудио через ElevenLabs. Каждый фрагмент текста озвучивался отдельно, и на выходе получался набор аудиофайлов под конкретные сцены. Я использовал свой собственный голос в ElevenLabs. Создал его через конструктор, просто прочитав небольшой фрагмент текста в микрофон.
Вся эта последовательность довольно хорошо поддавалась автоматизации. По сути, это был набор повторяющихся операций с понятными входными и выходными данными. Самым сложным оказалось не написать скрипты, а добиться приемлемого качества самого аватара.
Когда я получил первый нормально собранный ролик, результат меня действительно впечатлил.
Конечно, если внимательно присматриваться к лицу, можно заметить странности. Иногда мимика немного не соответствует сказанному, иногда глаза ведут себя не совсем естественно. Но в целом это уже не выглядело как совсем уж примитивная нейросетевая поделка.
Я даже подумал, что на таком уровне качества вполне можно строить полноценный YouTube-канал.
Кажется, людям не понравилось
На радостях я решил поделиться результатом в X:
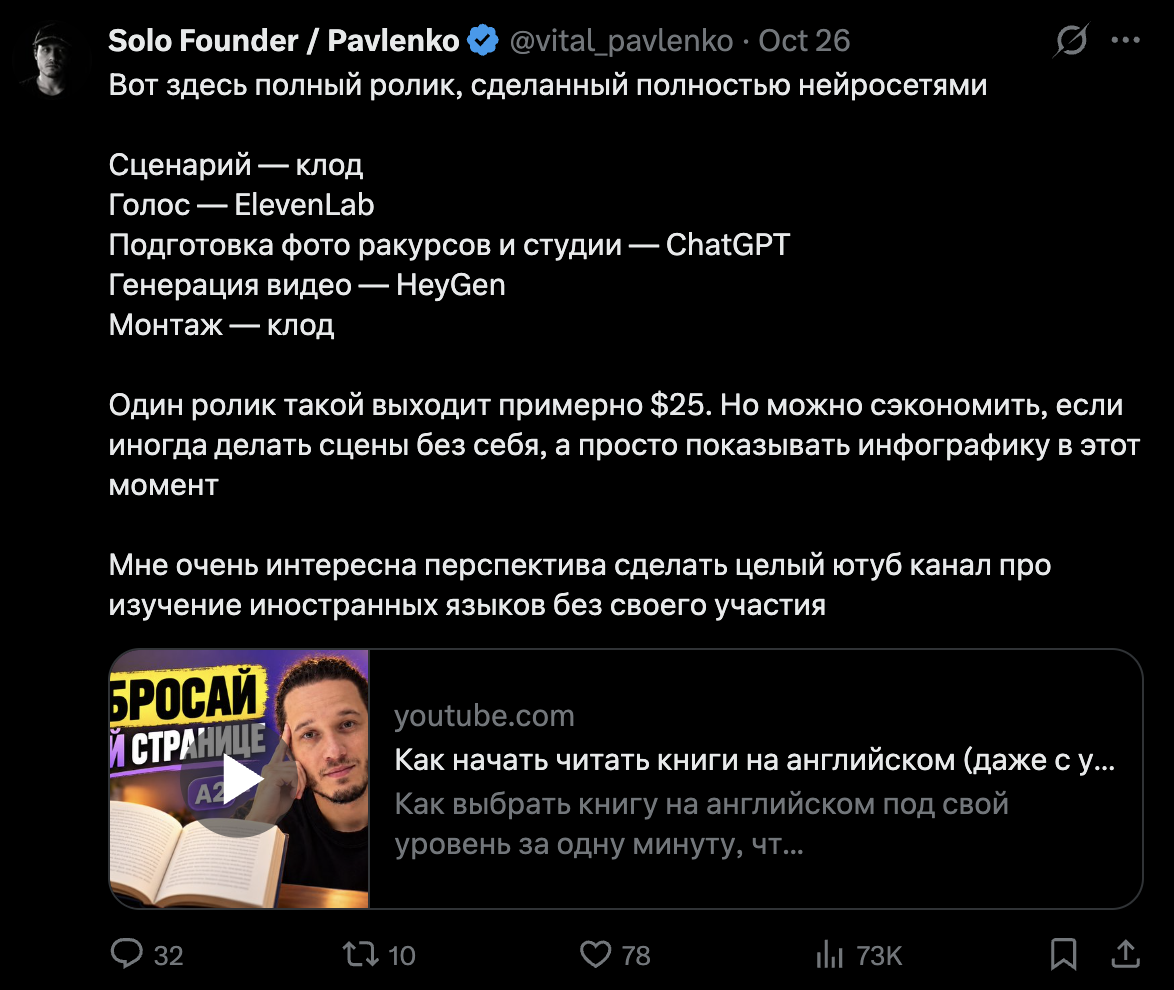
И совершенно не ожидал такой реакции.
Вместо обсуждения автоматизации и технической реализации люди начали писать, что видео выглядит ужасно. Что на него неприятно смотреть, что движения лица какие-то неестественные, что все это вызывает эффект зловещей долины.
Если кто не сталкивался с этим термином, эффект зловещей долины возникает, когда искусственный человек выглядит почти настоящим, но какие-то мелкие несоответствия во внешности или движениях вызывают у зрителя дискомфорт. Причем чем ближе такой персонаж к реальному человеку, тем заметнее могут становиться эти странности.
Пост начал расходиться. Его подхватили другие люди, а блогер Влад Тен даже опубликовал пост в своем Telegram-канале со ссылкой на мое видео. После чего много людей начали дизлайкать ролик.
В итоге видео набрало несколько тысяч просмотров, 10 лайков и целых 100 дизлайков.
И самое смешное, что YouTube несмотря на негативную реакцию, начал кидать видео в рекомендации другим людям, потому что посчитал интересным из-за такого внимания.
Я, конечно, немного расстроился из-за реакции, но не стал сразу закрывать эксперимент. Более того, подумал, что эта ситуация вообще не показатель.
Ведь все эти люди изначально знали, что смотрят на AI-аватара. Я сам об этом написал и буквально пригласил аудиторию оценить генерацию. Естественно, они стали разглядывать лицо, искать ошибки, обращать внимание на странности, которые обычный зритель мог бы вообще не заметить.
А что, если человек просто найдет ролик через поиск YouTube, захочет узнать, как эффективнее запоминать иностранные слова, и даже не задумается, настоящий перед ним ведущий или нет?
В общем, я решил продолжить.
А если попробовать на английском?
Я обнаружил, что на английском языке HeyGen справлялся с мимикой заметно лучше, чем на русском. При этом у меня вообще-то нет никакой причины ограничиваться русскоязычной аудиторией.
Ведь это не я лично сижу перед камерой. Сценарии можно писать на любом языке, ElevenLabs озвучит их, HeyGen сгенерирует видео. А приложение у меня поддерживает разные языковые пары, в том числе изучение испанского с английского.
Поэтому я решил полностью переориентировать канал на англоязычную аудиторию, которая изучает испанский.
Ниша довольно широкая, тем для образовательных видео огромное количество. Можно рассказывать про запоминание слов, чтение книг в оригинале, особенности грамматики, ошибки начинающих.
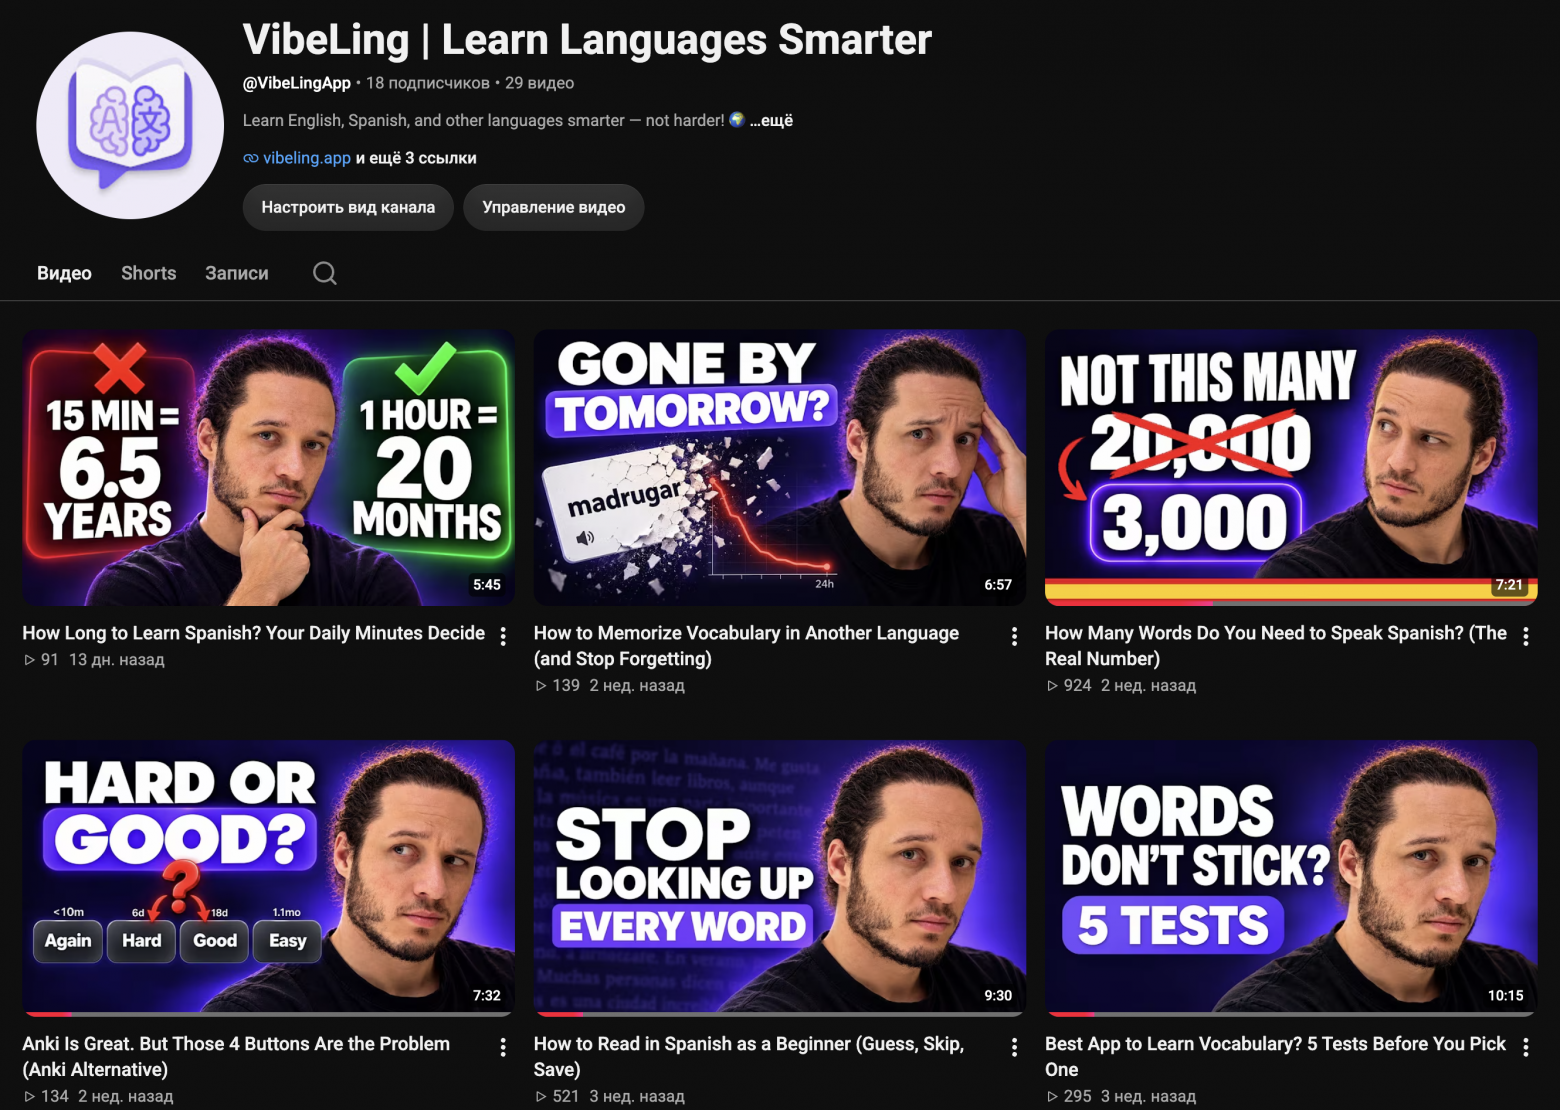
Заодно я существенно переработал сам процесс производства.
Первый полноценный ролик получился довольно дорогим (около $25). Большую часть конечно занимала генерация видео через HeyGen.
Поэтому я начал сокращать количество времени, которое аватар проводит на экране. Вместо того чтобы десять минут показывать свое лицо, оставил его в начале, конце и отдельных переходах между смысловыми блоками. А основную часть видео стал заполнять инфографикой, иллюстрациями и другими визуальными вставками.
Это решало сразу две проблемы. Во-первых, зритель меньше смотрит на потенциально неестественную мимику. Во-вторых, существенно сокращаются затраты на генерацию.
В итоге аватар занимал около 20% хронометража, а стоимость производства десятиминутного видео удалось снизить примерно до 2-3 долларов.
При этом сами видео, на мой взгляд, даже стали интереснее. Вместо непрерывной говорящей головы появилось больше визуальных объяснений и примеров.
Пример такого ролика:
На этот раз я уже ничего не рассказывал о новых видео в твиттере. Хотел посмотреть, как контент будет работать сам по себе.
И вот тут появились первые действительно интересные результаты.
YouTube довольно быстро расставил все по местам
Параллельно с этим экспериментом я веду другой YouTube-канал, где записываю видео самостоятельно. Без нейросетевого аватара, без идеальной дикции и практически без нормальной студии.
Я просто сижу дома перед камерой, рассказываю про разработку продуктов, продвижение, свои эксперименты. У меня далеко не самая лучшая речь, есть дефекты дикции, всякие эканья и мэканья, слова-паразиты. Освещение так себе, микрофон за 300 рублей, комната темная.
В общем, если сравнивать два видео чисто технически, нейросетевая версия должна была бы побеждать по всем фронтам. Там идеальный звук, ровная речь, никаких запинок, аккуратная картинка, красивые переходы.
Но когда я открыл аналитику YouTube, увидел совершенно другую картину.
На моих обычных видео средняя продолжительность просмотра составляла около 5 минут. На роликах с AI-аватаром около одной минуты.
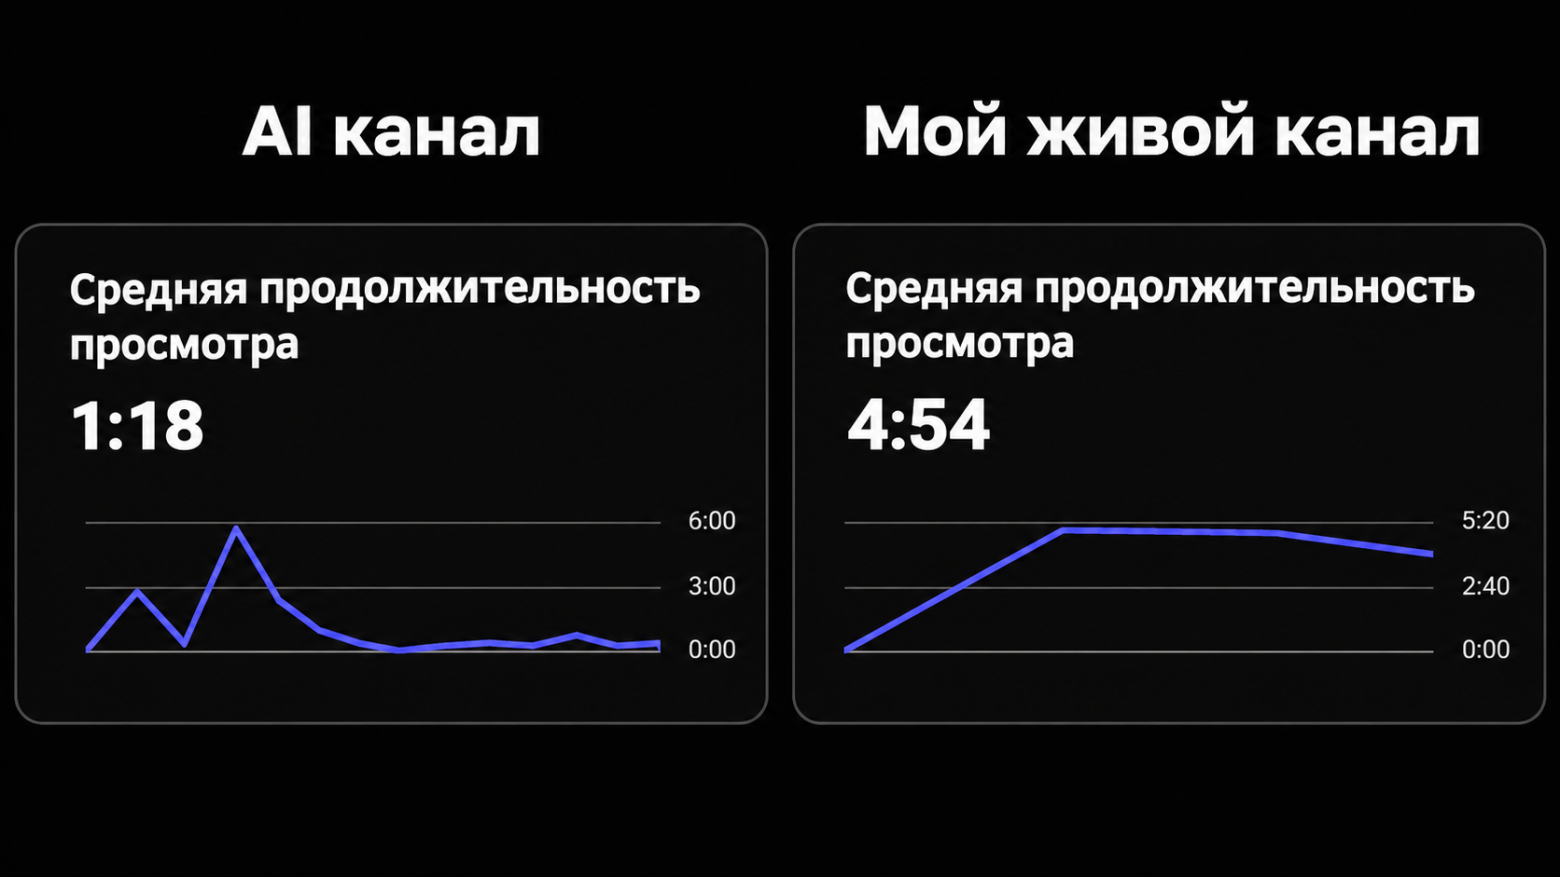
А это один из самых главных показателей для ролика. Если пользователи не досматривают видео, то и ютуб не будет его рекомендовать другим.
И здесь стало понятно, что первый ролик, который собрал несколько тысяч просмотров благодаря хейту, вообще нельзя считать успехом. Он привлек аудиторию не потому, что людям было интересно изучение языков, а потому, что они хотели посмотреть кринжовое видео и написать хейт-комментарий.
Самое интересное, что люди не всегда понимали, что это AI
Пока я экспериментировал с ИИ-генерацией, несколько человек показывали мои ролики своим знакомым, не предупреждая, что видео сгенерировано нейросетью.
И некоторые зрители действительно не замечали подвоха.
Это, кстати, довольно интересный момент. Когда заранее говоришь человеку, что перед ним нейросеть, он начинает специально искать ошибки. Рассматривает глаза, губы, движения лица, пытается поймать какие-нибудь артефакты генерации.
А когда не предупреждаешь, человек может вообще не задуматься о том, настоящий перед ним ведущий или нет.
Но меня в итоге заинтересовало даже не это.
Допустим, технология действительно научилась обманывать зрителя. Он не видит ошибок Lip Sync, не замечает странных движений глаз и считает ведущего настоящим. Почему тогда ролики все равно не смотрят?
Я не могу точно ответить на этот вопрос.
Но у меня появилось предположение, что дело не только в визуальных артефактах.
Когда смотришь на живого человека, ты постоянно замечаешь какие-то мелочи. Он запинается, чешет голову, меняет интонацию, делает паузы, иногда неудачно формулирует мысль, улыбается невпопад или неожиданно эмоционально реагирует на собственные слова. Все это создает ощущение живого разговора.
Нейросетевой ведущий может произносить тот же самый текст гораздо чище и грамотнее, но при этом выглядеть как человек, который вообще не понимает, о чем рассказывает.
У него нет собственного отношения к сказанному. Он не вспоминает что-то по ходу разговора, не пытается подобрать слова, не отвлекается на собственные мысли. Он просто очень убедительно воспроизводит заранее подготовленный текст.
Возможно, именно отсутствие этой естественной непредсказуемости и чувствуют зрители.
Причем самое неприятное, что словами это довольно сложно объяснить. Смотришь на ролик и вроде все нормально. Человек говорит, губы двигаются, картинка красивая. А через минуту почему-то уже хочется закрыть видео.
Я перестал выкладывать видео на AI-канале
Несмотря на то, что мне удалось полностью автоматизировать процесс и добиться минимальной стоимости видео, я все равно решил бросить эту затею.
Я научился дешево производить контент, который люди не хотят смотреть.
И никакая автоматизация эту проблему не решает. Можно выпускать десять роликов в день вместо одного, но если зритель закрывает их через минуту, масштабировать особо нечего.
При этом я не считаю, что нейросети вообще бесполезны для видеопроизводства. Наоборот, я продолжаю использовать их для подготовки сценариев, иллюстраций, инфографики и других вспомогательных задач. В этом они действительно экономят огромное количество времени.
Но попытка полностью заменить живого ведущего цифровой копией в моем случае провалилась.
Я решил, что пока лучше продолжать снимать видео самостоятельно. Пусть это занимает больше времени, пусть у меня неидеальная дикция, плохой свет и дешевый микрофон. Судя по тому, что я увидел в аналитике, зрителям все это мешает гораздо меньше, чем мне самому.
Так что если вы тоже откладываете запуск YouTube-канала, потому что у вас нет хорошей камеры, студийного света, поставленной речи или вы просто стесняетесь себя снимать, возможно, это вообще не так важно. Главное, что вы настоящий.
У меня есть телеграм-канал Solo Founder. Рассказываю в нем про создание и продвижение своих продуктов.