Продолжаю осваиваться в мире LLM с открытыми весами после блокировки моего аккаунта Claude Code. Начало истории в прошлой статье.
TL;DR. Развернул GLM 5.3 Flash на двух DGX Spark: читать его ответы приятно, но засоряет контекст комментариями в Bash, зацикливается и путается в собственных действиях — для кодинга на постоянку пока не беру. Попробовал Qwen 3.8 Flash Next (INT4-AR) на двух Spark: TPS вырос на 34–59%, prefill — почти в полтора раза, TTFT на 128K — 39 с; самая быстрая конфигурация из четырёх и новый фаворит. Попутно расширил плагин Pi для PhpStorm: remote-сессии, уведомления в Telegram и инструмент ask_question.
GLM 5.3 Flash
Как и обещал на прошлой неделе, развернул на двух DGX Spark GLM 5.3 Flash по рецепту GLM-5.3-Flash-DGX-Sparks-1104, чтобы попробовать её в работе.
На этой неделе использовал GLM на своих pet-проектах и для улучшения инструментов разработки. Первые впечатления пока неоднозначные...
Плюсы
в какой-то момент осознал, что мне приятно читать, как он пишет ответы! То есть Qwen и DeepSeek часто путают окончания слов, пунктуацию, придумывают новые слова, смешивают языки (например,
echoшить,доступаков,Title取自), теряют мысль. Вроде бы мозг уже адаптировался, но всё равно чувствуешь дискомфорт из-за неестественной последовательности токенов. И ты стараешься поскорее прочитать по диагонали написанную простыню текста, чтобы уловить какой-то смысл. А при написании плана с GLM поймал себя на мысли, что я смакую каждое предложение!дисциплинированно пользуется инструментом TODO (на уровнях high и max). За DeepSeek и Qwen часто подмечал, что когда они заводят TODO-список, то часто забывают его двигать. То есть сделано уже 5 пунктов, а отметка
in_progressвисит на третьем. GLM же своевременно двигает пункт. Но на уровне low пару раз ловил такое же застревание на первом пункте и у GLM. Также педантично исполняет то, что написано в навыках, и более точно следует шаблонам.
Минусы
засоряет свой контекст комментариями в Bash. Например,
echo "=== reset_app: 'git checkout BASE_REF -- app' восстанавливает файлы t1/base, потом удаляет файлы, которых нет в t1/base (по diff HEAD), потом clean -fdq app...===. И это я его ещё сократил раза в 4... В итоге — 90% вывода Bash составляют комментарии. Из-за этого очень быстро растёт контекст. В какой-то момент понимаешь, что блоки «Thinking», которые были в начале сессии, исчезли, и вместо них размышления производятся внутри инструмента Bash...в первой же задаче кодинга столкнулся с обратной стороной педантичности — зацикливанием. Хорошо, что у меня в плагине отображаются инструменты — благодаря этому заметил, что агент уже давно создаёт файлы типа
/tmp/probe119.php. То есть он уже создал 119 копий файла. Остановил его, попросил объясниться. Агент признался, что застрял в цикле, и написал красивое объяснение. А если б я его без присмотра оставил? К утру обнаружил бы, что у меня закончилось место на диске...часто путается в собственных действиях. В комментариях Bash можно встретить что-то вроде такого: «Прошлая команда вернула ошибку. Почему? Кто-то работает параллельно и переключил ветку!» И несколько команд спустя: «Ага... Это был скрипт calibrate.sh, который я вызвал перед этим». Чаще всего начинает упираться в такие мини-расследования, когда контекст переваливает за 130–150к.
После инцидента с зацикливанием решил в AGENTS.md добавить строку:
Одинаковый результат 3 раза подряд при разных пробах — стоп: переформулировать гипотезу или вернуться к спеке, не запускать четвёртую.
Qwen 3.8 Flash Next INT4-AR
Сегодня воспользовался советом читателя @Ka463 и с помощью рецепта Qwen3.8-Flash-Dual-DGX-Sparks-TensorFold развернул Qwen 3.8 Flash Next (INT4-AR) на двух DGX Spark. Результат превзошёл мои ожидания!
По ощущениям — раза в полтора быстрее, чем на одном Spark (точные цифры ниже). Им я пока крайне доволен: хорошо и быстро выполнил диагностику бага, точечно его пофиксил, написал регрессионный тест.
Пока я мало с ним поработал, но, кажется, нашёл своего фаворита.
Плюсы
В полтора раза быстрее prefill и генерация токенов, чем на одном Spark
Минусы
пока не обнаружены
Замеры TTFT и TPS
Параметр | GLM 5.3 Flash | Qwen 3.8 Flash Next |
|---|---|---|
Железо | 2 × DGX Spark | 2 × DGX Spark |
Движок | TensorFold | TensorFold |
Квантизация | 4 bpw EXL3 | INT4-AR |
Контекст | 1M | 1M |
Reasoning | low / high / max | low / medium / xhigh |
Temperature | 0 / 0.6 / 0.7 | 0 / 0.6 / 0.7 |
Методика та же, что в прошлой статье: по 10 замеров на каждом размере контекста, уникальные промпты со случайным salt — кэш префикса не работает, это честный холодный prefill; перед серией — один прогревочный запрос. Единственное отличие — добавился размер 256K, т.к. обе модели с 1М контекста.
Размеры контекстов: 2K, 8K, 32K, 64K, 128K, 256K.
Профиль: code
maxTokens: 256
temperature: 0
thinking: off
GLM 5.3 Flash
Контекст | prompt tokens (median) | TPS p50 (min–max) | TTFT p50, с (min–max) | prefill, ток/с |
|---|---|---|---|---|
2K | 2129 | 69.0 (52.9–81.6) | 1.40 (1.38–1.41) | 1523 |
8K | 8290 | 64.6 (58.5–74.5) | 5.22 (5.21–5.43) | 1589 |
32K | 32777 | 66.2 (61.6–75.6) | 18.48 (18.40–18.51) | 1774 |
64K | 65512 | 71.8 (60.8–87.2) | 36.63 (36.46–36.75) | 1788 |
128K | 130987 | 66.6 (56.5–75.5) | 74.73 (74.52–74.91) | 1753 |
256K | 262150 | 70.5 (64.5–76.4) | 154.43 (153.85–155.43) | 1697 |
Qwen 3.8 Flash Next
Кластер из двух Spark
Контекст | prompt tokens (median) | TPS p50 (min–max) | TTFT p50, с (min–max) | prefill, ток/с |
|---|---|---|---|---|
2K | 2126 | 116.8 (95.0–146.0) | 0.58 (0.56–0.59) | 3653 |
8K | 8280 | 107.2 (99.1–142.1) | 2.19 (2.16–2.21) | 3781 |
32K | 32797 | 115.3 (78.9–138.1) | 8.77 (8.72–8.83) | 3738 |
64K | 65598 | 112.3 (80.5–131.6) | 18.34 (18.28–18.43) | 3577 |
128K | 130928 | 97.4 (86.5–132.9) | 38.84 (38.76–38.93) | 3371 |
256K | 262074 | 96.6 (69.4–107.5) | 85.57 (85.36–85.74) | 3063 |
1 Spark vs 2 Spark
Контекст | TPS 1 | TPS 2 | Δ TPS | TTFT 1 | TTFT 2 | Δ TTFT | prefill 1 | prefill 2 | Δ prefill |
|---|---|---|---|---|---|---|---|---|---|
2K | 80.2 | 116.8 | +46% | 0.94 | 0.58 | −38% | 2256 | 3653 | +62% |
8K | 74.0 | 107.2 | +45% | 3.29 | 2.19 | −33% | 2515 | 3781 | +50% |
32K | 74.8 | 115.3 | +54% | 13.05 | 8.77 | −33% | 2514 | 3738 | +49% |
64K | 70.7 | 112.3 | +59% | 26.90 | 18.34 | −32% | 2438 | 3577 | +47% |
128K | 72.6 | 97.4 | +34% | 56.94 | 38.84 | −32% | 2299 | 3371 | +47% |
Замер 256K для одного Spark не проводился — в прошлой статье серия заканчивалась на 128K. И нюанс: одиночный Spark работал в квантизации 4-бит NVFP4, кластер — INT4-AR, так что сравнение не совсем точное, но порядок величин оно показывает.
Что видно из цифр
GLM на двух Spark генерирует 65–72 ток/с — медленнее DeepSeek (99–109 ток/с на тех же двух Spark, данные прошлой статьи) и примерно на уровне Qwen на одном Spark (70–80). В пересчёте на Spark — 33–36 ток/с, худший результат среди всех четырёх конфигураций.
С prefill у GLM тоже неважно: 1,5–1,8 тыс. ток/с против 2,3–2,5 тыс. у Qwen на одном Spark и 1,7–2,3 тыс. у DeepSeek. На 128K TTFT у GLM — 75 с (Qwen на одном — 57 с, DeepSeek — 73 с).
А вот Qwen на двух Spark — совсем другое дело. TPS вырос до 97–117 ток/с (+34–59% к одному Spark), TTFT на 128K упал с 57 до 39 с (−32%), а prefill достиг 3,1–3,8 тыс. ток/с (+47–62%) — лучший результат среди всех конфигураций. На 256K — TTFT 86 с против 154 с у GLM.
Выводы по Qwen с двумя Spark:
Удвоения TPS снова нет: +34–59%. Цифры сопоставимы с DeepSeek на двух Spark.
Prefill масштабируется лучше генерации: +47–62%. Холодный разбор длинного контекста — сильная сторона кластера.
По сумме метрик — самая быстрая конфигурация из четырёх: TPS на уровне DeepSeek или выше, prefill и TTFT заметно лучше всех. Плюс первые впечатления от работы (см. выше) — пока мой фаворит.
Улучшаем инструменты
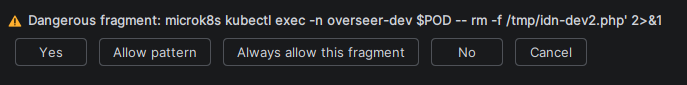
В качестве основного harness (обвязки) использую минималистичный Pi, установленный в WSL. Основные расширения: pi-subagents, plan-mode, @blessium/pi-search, @ff-labs/pi-fff, pi-lsp-extension, @casualjim/pi-caveman. А также самописный permission-gate, чтобы запрашивались разрешения на опасные команды.
И чтобы было удобнее работать с Pi, написал плагин-обёртку, который устанавливается в PhpStorm (а также другие IDE JetBrains). Написал я его пару месяцев назад ещё с помощью Opus. Но активно начал использовать только две недели назад. И сразу стал сталкиваться с рядом неудобств, которые устранял с помощью DeepSeek+Qwen. Да, они редко с первого раза идеально справлялись с моими пожеланиями, но со второй (максимум с третьей) попытки каждая фича работала, как мне хотелось.
Уведомления в Telegram
Добавил возможность для определённой сессии с ПК или с телефона включать уведомления через бота для тех случаев, когда агент завершает ход, просит разрешение или ждёт ответа на вопрос (ask_question).
Remote-сессии
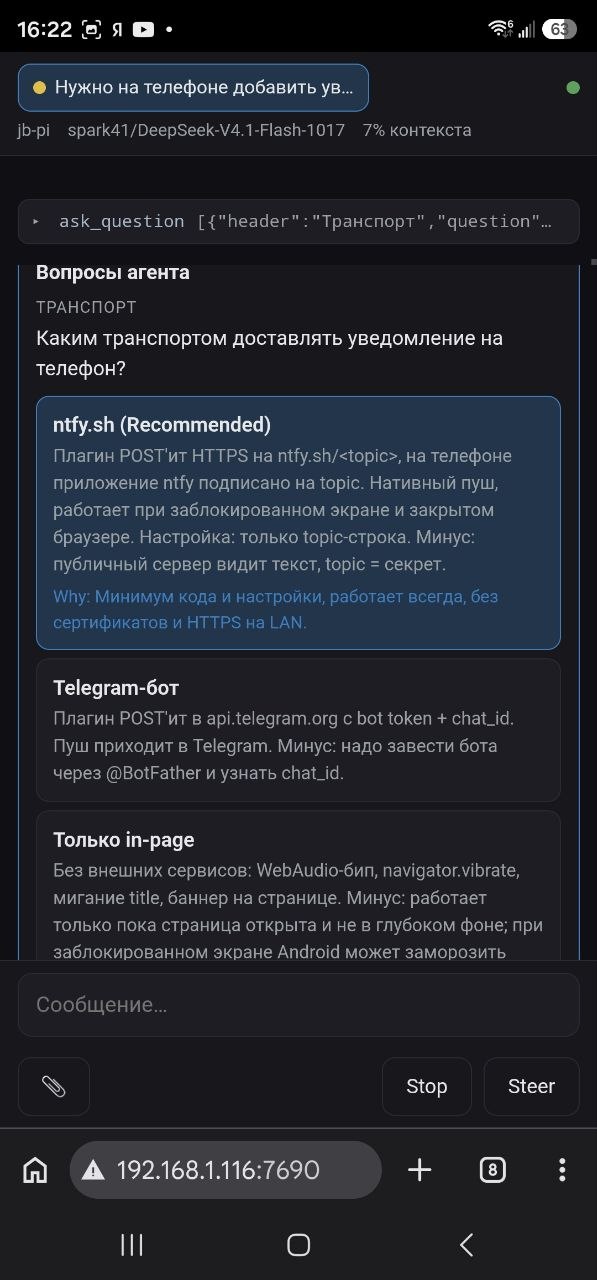
Это, пожалуй, самая полезная для меня фича, которая позволяет хотя бы ненадолго отойти от монитора, а не подбегать к нему каждые 2–3 минуты, чтобы дать разрешение на выполнение команды или ответить на вопросы. Теперь можно в браузере на телефоне подключиться к нужной сессии и управлять ею из другой комнаты или даже с другого конца города (лишь бы это был тот счастливый день, когда работает мобильный интернет).
За неделю это стало привычным инструментом:
Оставил на ночь прогон бенчмарка. Проснулся около трёх ночи, глянул на телефон — уведомлений нет, сплю дальше. А в пять утра пришло сообщение в Telegram: разблокировал телефон, ответил на вопросы агента — и сплю дальше.
Remote-сессию можно открыть даже в VR-шлеме! Свернул игру, нажал кнопку разрешения, вернулся к игре.
Нужно съездить к стоматологу? Поднимаю SSH-туннель, а в автобусе читаю отчёт и запускаю новую сессию.
Кажется, что я накостылил себе аналог OpenClaw...
Инструмент ask_question
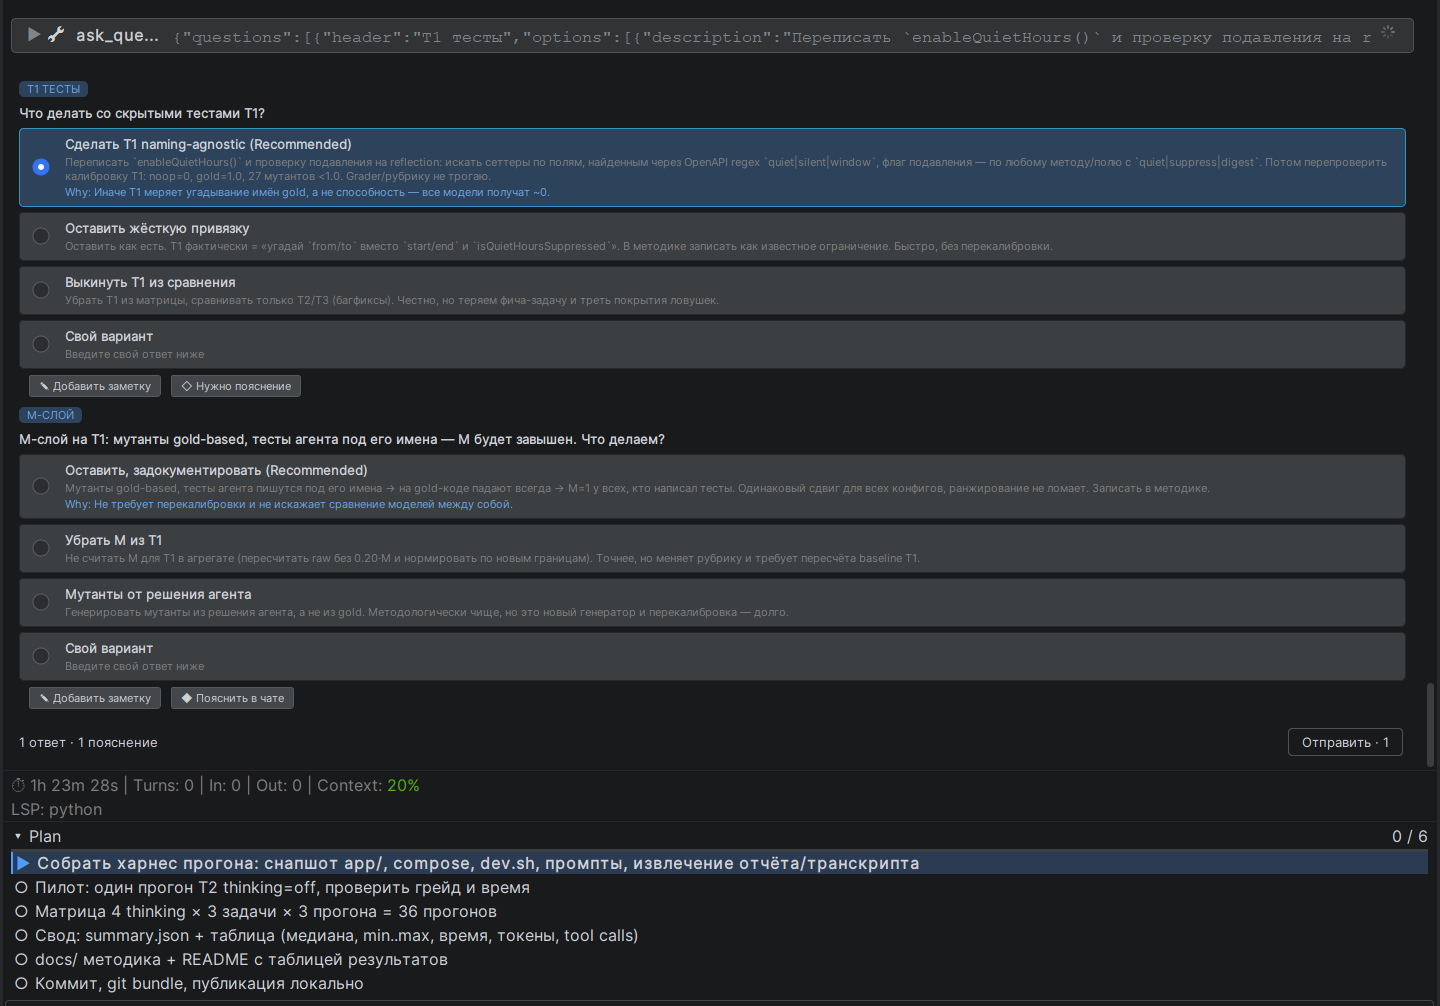
Работая с агентами Hermes и Pi, я все время ностальгировал по инструменту AskUserQuestion в Claude Code. Но попробовав новую ADE ThinkRail, увидел у них похожую реализацию. Решил, что могу и в свой плагин добавить любимый инструмент. В отличие от Claude Code, также можно добавить заметку к выбранному варианту ответа или попросить объяснить конкретный вопрос подробнее.
Итоги второй недели
Понемногу расширяю арсенал локальных моделей.
Думаю, можно иногда поднимать GLM 5.3 Flash ради написания документации или редактуры статьи. Но на постоянную основу для кодинга я бы его пока не брал. Возможно, дам ему шанс позже.
А на данный момент я в восторге от Qwen 3.8 Flash Next на паре Spark. Думаю, буду плотно использовать его на следующей неделе.
За счёт оптимизации инструментария и развития системы оповещения удаётся за сутки успевать гораздо больше, чем до блокировки Claude Code. Если нет лимитов, агент может работать круглосуточно!
А если параллельно запустить двух агентов? Можно же ещё больше сделать!
В общем, вы поняли: моя зависимость от агентов лишь усугубилась...
Думаю, следующим шагом нужно пробовать автономных агентов типа OpenClaw: делегируешь им задачи и не сидишь над ними, контролируя каждый шаг. Это позволит сберечь своё время и внимание. Как минимум для pet-проектов такой подход можно попробовать.
Что дальше
На этой неделе задался вопросом, какой reasoning effort оптимально устанавливать для задач написания кода. Пока работал с Claude Code, придерживался такого подхода: планирование и отладка — Opus + high, а написание кода по плану — Opus + low или Sonnet + medium. Но к этому пришёл на уровне интуиции и с целью экономии токенов.
Поэтому возникла идея проверить это экспериментальным путём. Изначально собирался опубликовать данные уже в этой статье, но эксперимент в самом разгаре — за выходные завершить не успел. На следующей неделе обещаю поделиться результатами.
Ссылки
прошлая статья — про DeepSeek V4.1 Flash 1017 и Qwen 3.8 Flash Next