За четыре части мы собрали работающий лейкхаус. В первой разобрались, почему обычное озеро данных со временем превращается в свалку файлов. Увидели преимущества Apache Iceberg: транзакции, управление схемой, снапшоты. Во второй — подняли каталог метаданных на Hive Metastore, зарегистрировали namespace и создали первую таблицу. В третьей — подключили вычислительные движки Trino и Apache Spark, что позволило выполнять SQL‑запросы поверх файлов в объектном хранилище.
Все это время у платформы был ровно один интерфейс — SQL в консоли. Для инженера и аналитика это привычно, для продакта или маркетолога — нет.
Привет! На связи Арманд, бэкенд‑разработчик на Go в Selectel. В этой части мы поднимем BI-инструмент, подключим к нему витрину ClickHouse и SQL‑движок Trino, соберем первый дашборд. Что еще важнее, детальнее разберемся, что происходит внутри, когда дашборд открывают десять человек одновременно. Последнее часто и преподносит сюрприз. Основным инструментом серии остается Redash, но также рассмотрим Metabase и Apache Superset.
Содержание
→ Зачем нужна визуализация
→ Redash, Superset или Metabase
→ Поднимаем Redash
→ Подключаем источники: ClickHouse и Trino
→ Первый дашборд
→ Что происходит под капотом, когда открывается дашборд
→ Что ломается на втором дашборде
→ Metabase
→ Superset
→ Заключение
Зачем нужна визуализация
На практике отсутствие дашбордов приводит к тому, что любой вопрос бизнеса превращается в тикет для аналитика: «Посчитать выручку по регионам за квартал». Тот пишет запрос, копирует результат в таблицу, отправляет в мессенджер. Через неделю тот же вопрос приходит с другими датами, и цикл повторяется. Дашборд разрывает этот круг: SQL‑запрос пишется один раз, дальше пользователи самостоятельно меняют период и анализируют метрики.
BI‑инструменты превращают массивы сырых данных в наглядные таблицы и графики, помогая принимать решения людям без специфических знаний.
Со стороны специалистов выигрыш многосторонний:
скорость принятия решений — менеджеру не приходится ждать, когда аналитик выгрузить отчет;
мгновенная реакция на изменение ситуации — например, резкое падение продаж или сбой в цепочке поставок;
фокусировка на ключевых показателях для конкретного специалиста — выручка, конверсия, ROI, количество активных пользователей;
визуализация и поиск скрытых трендов — мозг плохо воспринимает таблицы, а графики, диаграммы и тепловые карты помогают «схватить» всю картину целиком;
страховка от ошибок в запросах — все отделы оперируют теми же показателями;
самостоятельность пользователей — снижается или полностью убирается зависимость от инженеров данных, аналитиков, системных администраторов.
Хорошая BI-платформа дает полный аналитический цикл — от сырых данных до интерактивных дашбордов. С бизнеса снимается нужда поддерживать самостоятельно инфраструктуру и содержать целый штат специалистов.
Объединение всех этапов — интеграции, очистки, моделировании и визуализации — позволяет уйти от хаоса и ошибок. Остается чистая польза:
легкость аналитики — например, можно проследить полный путь клиента и денег от первого клика по рекламному баннеру;
платформа автоматизирует подготовку данных, радикально сокращая время создания новых отчетов;
безопасность на уровне строк настраивается один раз — каждый регион работает со своими данными;
легкое масштабирование — платформа способна обрабатывать терабайты в озере данных.
BI-платформа также позволяет связать все этапы работы с данными. До этой части мы работали с чистым SQL и не могли визуализировать результаты. Теперь же они обретают наглядность: parquet в объектном хранилище, таблица Iceberg, витрина в ClickHouse, итоговый график со ссылкой, которую можно отправить коллеге.
Redash, Superset или Metabase
Три инструмента с открытым кодом позволяют проводить самостоятельный анализ данных бизнес-пользователям и получать прямой доступ к аналитике. Сравним их:
Redash | Superset | Metabase | |
|---|---|---|---|
Число контейнеров | 6 | 4 | 1 |
Внешний стейт | Postgres и Redis | Postgres и Redis | Встроенная БД или Postgres |
Трино | Есть встроенный | Есть, лучшая поддержка | Сторонний драйвер |
ClickHouse | Есть встроенный | Есть | Плагин |
Автор запроса | SQL | SQL и конструктор | Конструктор и SQL |
Целевой пользователь | Аналитик | Аналитик, инженер данных | Бизнес-пользователь |
Разграничение доступа | Группы, источники | Роли, row-level security | Группы, песочницы |
Metabase объективно самый легкий: один контейнер и встроенная база. Если цель буквально в минимуме сущностей, то это оптимальный выбор. Superset дает лучшую интеграцию с Trino и разграничивает доступ к данным, но требует заметно больше времени на настройку и понимание его модели датасетов. Redash посередине: подход SQL-first, простой редактор запросов, низкий порог входа для аналитика со знанием SQL.
Redash по инфраструктуре самый тяжелый: ему нужны собственные инстансы Postgres, Redis и четыре контейнера для самого приложения.
В Redash четыре сущности: источник данных, запрос, визуализация, дашборд. Нет ни семантического слоя, ни датасетов, ни отдельного языка описания метрик. Запросы пишутся на чистом SQL, как и в любом другом клиенте, а визуализация и дашборды — это слои поверх уже выполненных запросов.
В этом и состоит цена выбора: развертывание шести контейнеров позволяет не добавлять собственных концепций поверх SQL (как, например, датасетов в Superset). Для минимальной платформы обмен разумный. Если же ресурсы стенда ограничены, а пользователи не владеют SQL, стоит присмотреться к Metabase — там компромисс ровно обратный.
Перед тем как закладывать любой из этих трех инструментов в постоянный контур, хорошо бы заглянуть в репозиторий и обратить внимание на даты последних релизов и активность мейнтейнеров. К примеру, у Redash темп разработки за последние годы менялся несколько раз.
Поднимаем Redash
Redash состоит из пяти сервисов, и понимать роль каждого крайне полезно. Половина проблем на старте связана с тем, что не поднялся один из его компонентов:
server— веб-интерфейс и API (то, что открывается в браузере);scheduler— планировщик, который ставит в очередь обновление запросов по расписанию;worker— фоновые задачи, такие как отправка почты, обновление схемы источников, служебная периодика;adhoc worker— отдельный воркер, выполняющий пользовательские запросы;postgresиredis— хранение внутреннего состояния и очередь задач.
Важно отметить: этот postgres не имеет никакого отношения к данным самого лейкхауса. В нем хранятся учетные записи пользователей, тексты запросов, описания дашбордов и кэшированные результаты выполнения запросов.
Docker Compose
Добавим Docker Compose к стенду из предыдущих частей. Ключевое требование — общая Docker-сеть с Trino и ClickHouse, иначе Redash не увидит их по именам сервисов.
x-redash: &redash
  image: redash/redash:25.1.0
  depends_on: [redash-postgres, redis]
  env_file: .env
  networks: [lakehouse]
  restart: unless-stopped

services:
  clickhouse:
    image: clickhouse/clickhouse-server:25.8
    ports:
      - "8123:8123"
    volumes:
      - clickhouse-data:/var/lib/clickhouse
      - ./clickhouse-init:/docker-entrypoint-initdb.d:ro
    networks: [lakehouse]
    restart: unless-stopped

  trino:
    image: trinodb/trino:latest
    ports:
      - "8080:8080"
    volumes:
      - ./trino/etc/catalog:/etc/trino/catalog:ro
    networks: [lakehouse]
    restart: unless-stopped

  redash-server:
    <<: *redash
    command: server
    ports:
      - "5000:5000"
    environment:
      REDASH_WEB_WORKERS: 4

  redash-scheduler:
    <<: *redash
    command: scheduler

  redash-worker:
    <<: *redash
    command: worker
    environment:
      QUEUES: "periodic emails default schemas"
      WORKERS_COUNT: 1

  redash-adhoc-worker:
    <<: *redash
    command: worker
    environment:
      QUEUES: "queries"
      WORKERS_COUNT: 2

  redash-postgres:
    image: postgres:16-alpine
    environment:
      POSTGRES_USER: redash
      POSTGRES_PASSWORD: redash
      POSTGRES_DB: redash
    volumes:
      - redash-pg:/var/lib/postgresql/data
    networks: [lakehouse]
    restart: unless-stopped

  redis:
    image: redis:7-alpine
    networks: [lakehouse]
    restart: unless-stopped

volumes:
  clickhouse-data:
  redash-pg:

networks:
  lakehouse:
    driver: bridge
В clickhouse-init лежит скрипт для инициализации ClickHouse:
CREATE DATABASE IF NOT EXISTS analytics;

CREATE TABLE analytics.orders_daily
(
    order_date Date,
    category    LowCardinality(String),
    revenue     UInt64,
    orders      UInt32
)
ENGINE = MergeTree
ORDER BY (order_date, category);

INSERT INTO analytics.orders_daily
SELECT
    toDate('2026-06-01') + number AS order_date,
    category,
    500 + (number * 37 + cityHash64(category) % 11) * 10 + cityHash64(category, number) % 3500 AS revenue,
    5 + cityHash64(number, category) % 120 AS orders
FROM numbers(115)
ARRAY JOIN ['electronics', 'home', 'fashion', 'sport', 'books'] AS category
WHERE number != 96;

INSERT INTO analytics.orders_daily
SELECT toDate('2026-09-05') AS order_date, category, 0 AS revenue, 0 AS orders
FROM (SELECT arrayJoin(['electronics', 'home', 'fashion', 'sport', 'books']) AS category);

CREATE USER redash IDENTIFIED WITH sha256_password BY 'redash123';
GRANT SELECT ON analytics.* TO redash;
Скрипт для заполнения (reseed) Trino после перезапуска:
#!/usr/bin/env bash
# Пересеивает трино после перезапуска: memory-каталог хранит данные в оперативке.
set -euo pipefail

docker exec stand-trino trino --catalog iceberg --execute "CREATE SCHEMA IF NOT EXISTS demo"
docker exec stand-trino trino --catalog iceberg --execute "CREATE TABLE IF NOT EXISTS demo.orders_daily (order_date DATE, category VARCHAR, revenue BIGINT, orders INTEGER)"
docker exec stand-trino trino --catalog iceberg --execute "
INSERT INTO demo.orders_daily
SELECT date_add('day', n, DATE '2026-06-01'), category,
       500 + (n * 37 + CAST(abs(rand() * 3500) AS BIGINT)),
       5 + CAST(abs(rand() * 120) AS BIGINT)
FROM UNNEST(sequence(0, 114)) AS t(n)
CROSS JOIN (VALUES ('electronics'),('home'),('fashion'),('sport'),('books')) AS c(category)"
echo "Готово: iceberg.demo.orders_daily, 575 строк (2026-06-01 .. 2026-09-23)"
Этот скрипт прогоняется при первом запуске ClickHouse и создает витрину analytics.orders_daily с демо данными, а также пользователя redash — будут использоваться в примерах ниже.
Также понадобится конфигурационный файл для Trino. Положим его в каталог trino/etc/catalog/iceberg.properties:
connector.name=memory
memory.max-data-per-node=512MB
Теперь сможем использовать коннектор memory и не поднимать S3 и Metastore ради демонстрационной витрины.
Файл .env располагается рядом с docker-compose.yml:
REDASH_DATABASE_URL=postgresql://redash:redash@redash-postgres/redash
REDASH_REDIS_URL=redis://redis:6379/0
REDASH_COOKIE_SECRET=<openssl rand -hex 32>
REDASH_SECRET_KEY=<openssl rand -hex 32>
REDASH_LOG_LEVEL=INFO
REDASH_ENFORCE_CSRF=true
Первый запуск
До того как поднимать сервисы, нужно один раз накатить миграции БД и создать схему:
docker compose run --rm redash-server create_db
docker compose up -d
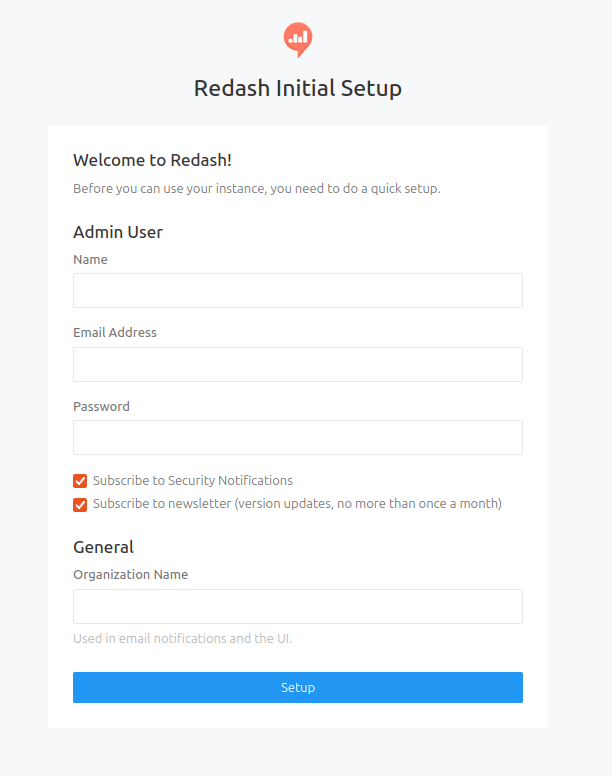
Далее открываем http://localhost:5000, попадаем на страницу первичной настройки и настраиваем учетную запись администратора. Регистрации как таковой в Redash нет: первый пользователь создается на стартовом экране, остальных администратор приглашает вручную.
Возможные проблемы на старте и способы их избежать:
миграции нужно выполнить обязательно до первого запуска
server, причем ровно один раз — иначе контейнер будет циклически падать из‑за отсутствующих таблиц, причем в логах причина выглядит не столь очевидно;без
REDASH_COOKIE_SECRETиREDASH_SECRET_KEYприложение не запустится — их нужно сгенерировать с помощьюopensslи не переиспользовать между окружениями;если забыть про
adhoc worker, интерфейс поднимется и будет выглядеть рабочим, но любой запрос зависнет в статусеExecuting— он ставится в очередь, но не обрабатывается;общая сеть обязательна — Redash обращается к источникам по DNS-именам контейнеров (
localhostвнутри его контейнера ссылается на него самого).
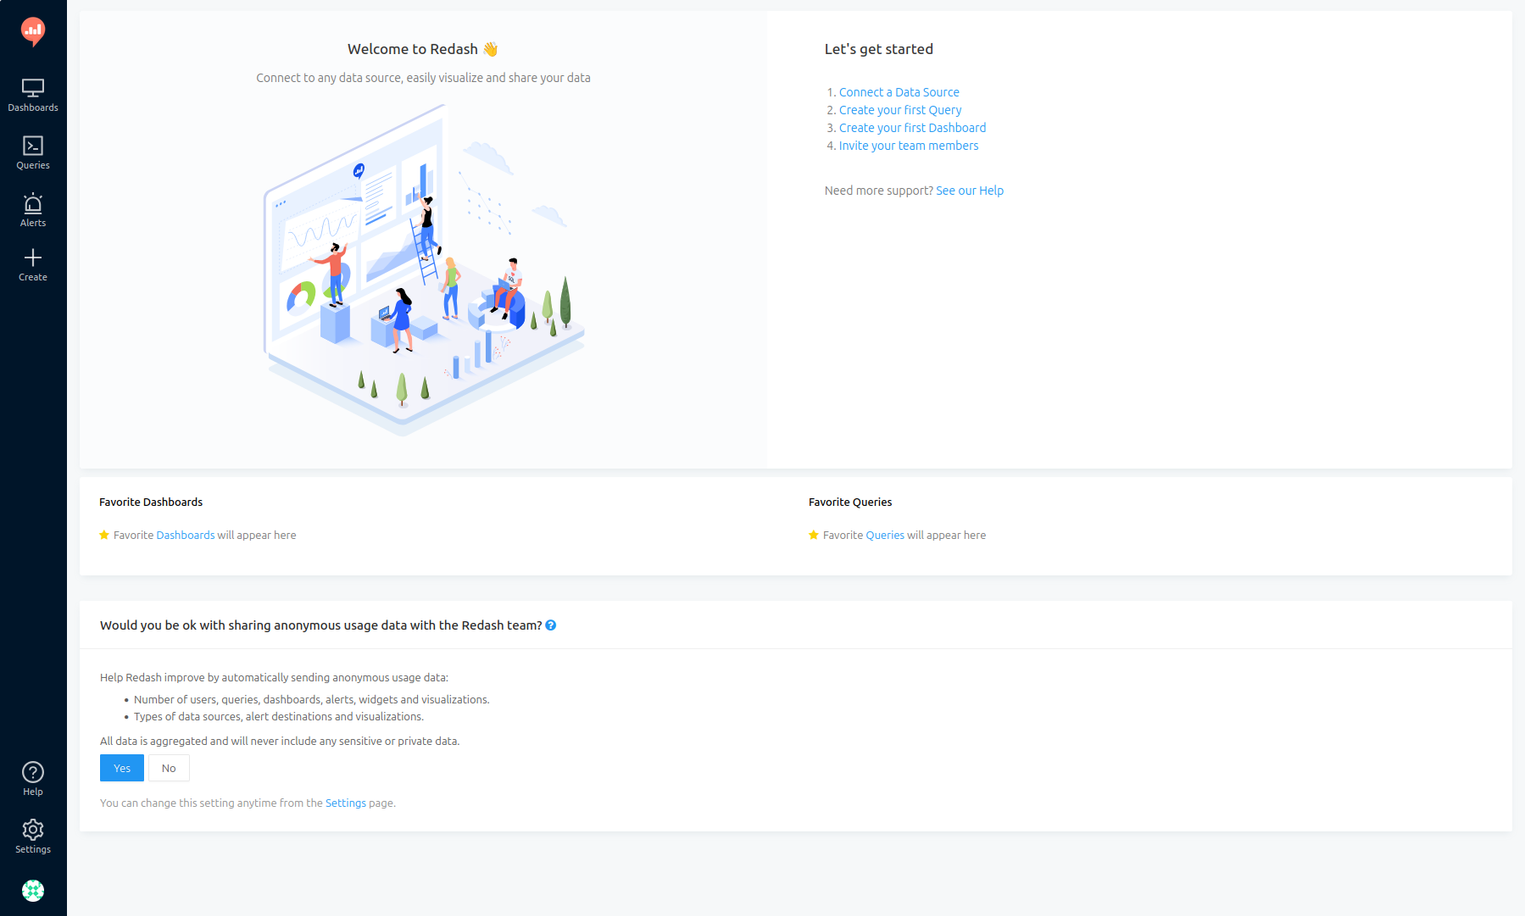
После создания пользователя будет доступен главный экран:

Облачные базы данных
Создайте готовую базу данных в облаке за 5 минут. Поддерживаем PostgreSQL, MySQL, Redis и не только.
Подключаем источники: ClickHouse и Trino
После предыдущей четвертой части у нас два способа обращения к данным, обладающим разным профилем нагрузки и назначением.
ClickHouse — идеален для дашбордов. Витрина на движке MergeTree уже агрегирована, отвечает за десятки миллисекунд и спокойно держит десяток одновременных пользователей. Это то, что пользователи открывают каждое утро и обновляют по расписанию.
Trino — предназначен для нерядовых аналитических задач, то есть когда нужно ответить на вопрос, которого в витрине нет, и требуется залезать в сырые таблицы Iceberg целиком. Такой подход медленнее, зато работает со всеми данными в каталоге.
Соблазн подключить что-то одно есть всегда, но оба варианта плохи поодиночке. Выбрать только Trino — дашборды будут работать, но каждое обновление страницы начнет генерировать полноценную нагрузку на все хранилище, что уже на десятом виджете станет заметно. Оставить исключительно ClickHouse — аналитик упрется в границы подготовленной витрины на первом же нестандартном вопросе, после чего будет вынужден просить помощи инженера данных.
Поэтому подключим в Redash оба источника.
ClickHouse
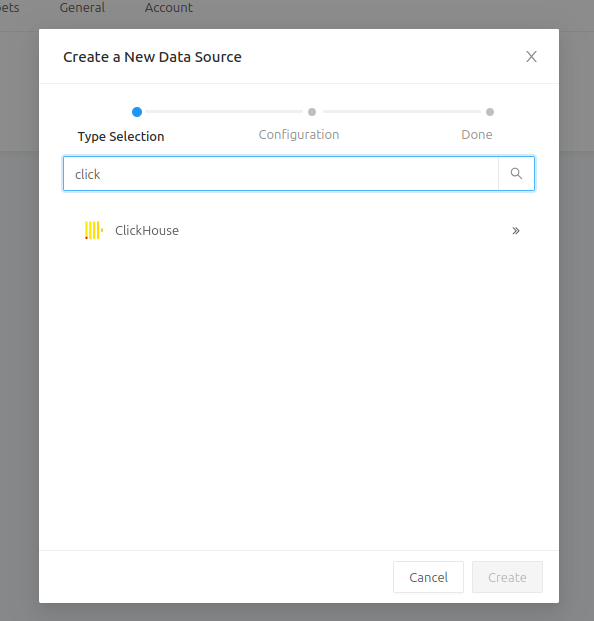
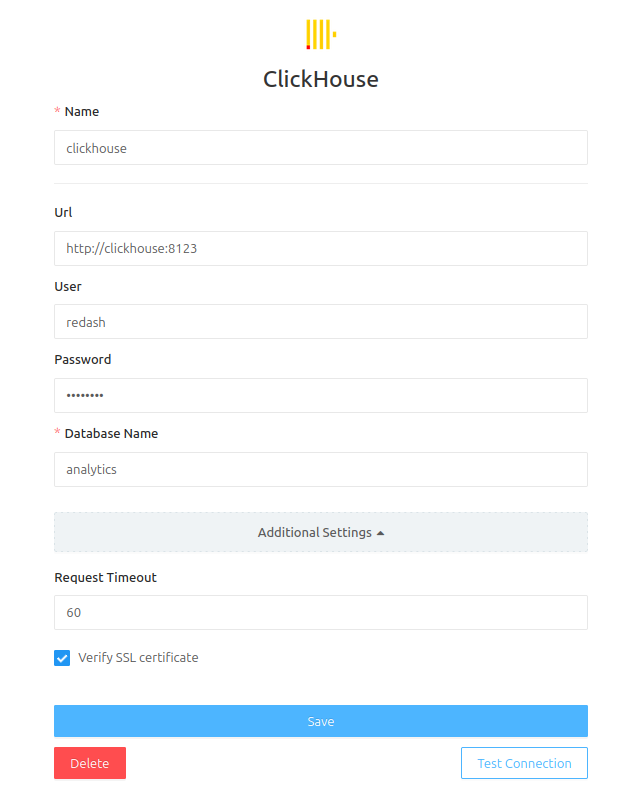
Перейдем в Settings → New Data Source, выберем тип ClickHouse и заполним следующие параметры:
URL:      http://clickhouse:8123
User:     redash
Password: ********
Database: analytics
Timeout:  60
Обратите внимание: мы используем пользователя redash вместо default. Мы еще обсудим меры безопасности, когда дойдем до разграничения доступа.
Trino
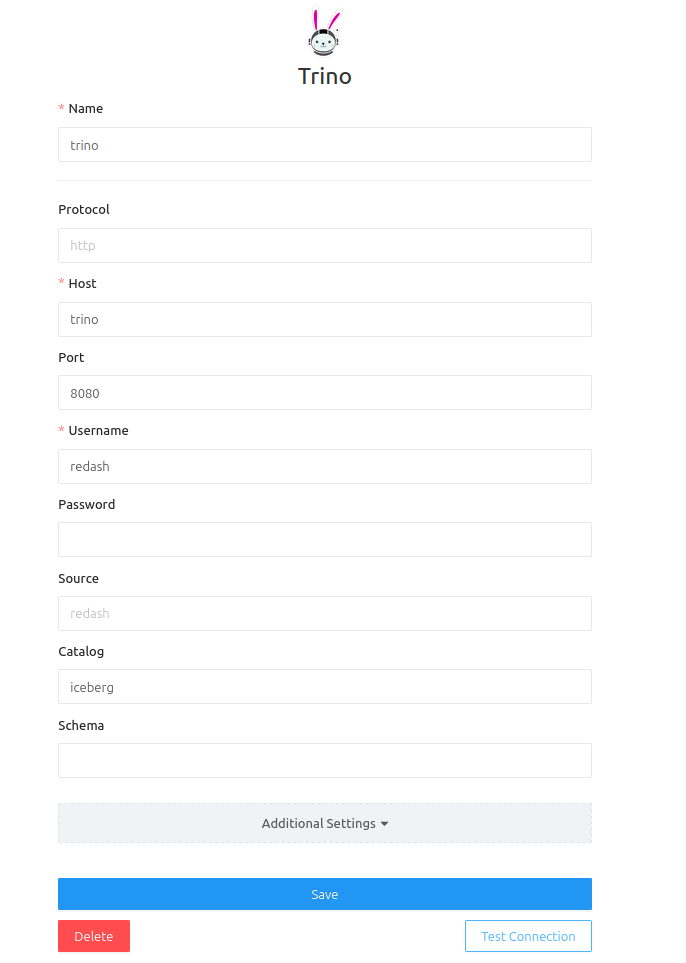
Аналогично подключаем Trino: Settings → New Data Source, тип Trino. Заполняем:
Host:     трино
Port:     8080
Catalog:  iceberg
Schema:   demo
Username: redash
В минимальной сборке из третьей части аутентификация в Trino отключена, пароль не нужен — достаточно передать имя пользователя, под которым запросы отображаются в его интерфейсе. Для любых сред, кроме локального стенда, такое подход недопустим.
После сохранения конфигурации нажимаем Test Connection, затем Refresh Schema. Redash подтягивает список таблиц и колонок, чтобы работало автодополнение в редакторе. Схему он кеширует, поэтому новая таблица в Iceberg появится в подсказках не мгновенно. За обновление схемы отвечает тот самый фоновый воркер с очередью schemas из предыдущего раздела «Поднимаем Redash».
Первый дашборд
Плохой дашборд начинается с данных: человек смотрит, какие есть таблицы, и рисует графики по тому, что нашлось. Хороший дашборд начинается с вопроса. Возьмем конкретный и достаточно типовой пример: динамика выручки и распределение продаж по категориям.
Понадобятся три запроса к витрине ClickHouse, потому что дашборд будет обновляться по расписанию и должен отвечать быстро.
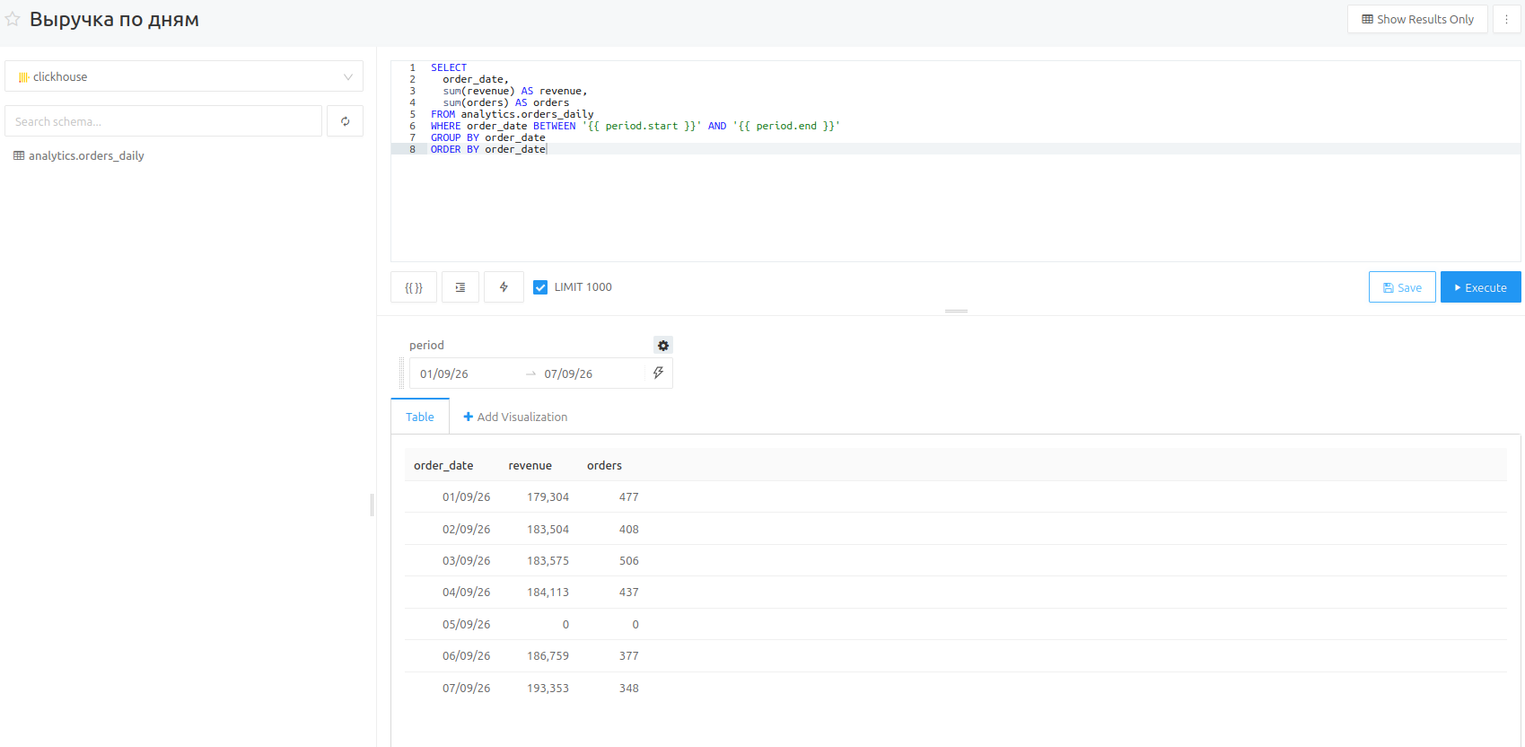
Запрос 1. Выручка по дням
SELECT
    order_date,
    sum(revenue)  AS revenue,
    sum(orders)   AS orders
FROM analytics.orders_daily
WHERE order_date BETWEEN '{{ period.start }}' AND '{{ period.end }}'
GROUP BY order_date
ORDER BY order_date
Конструкция {{ period.start }} — параметр Redash. В редакторе это поле ввода, а тип Date Range дает пользователю привычный выбор периода. Мы видим ту автоматизацию, ради которой все затевалось: SQL‑запрос пишется один раз, дальше период меняет тот, кто смотрит.
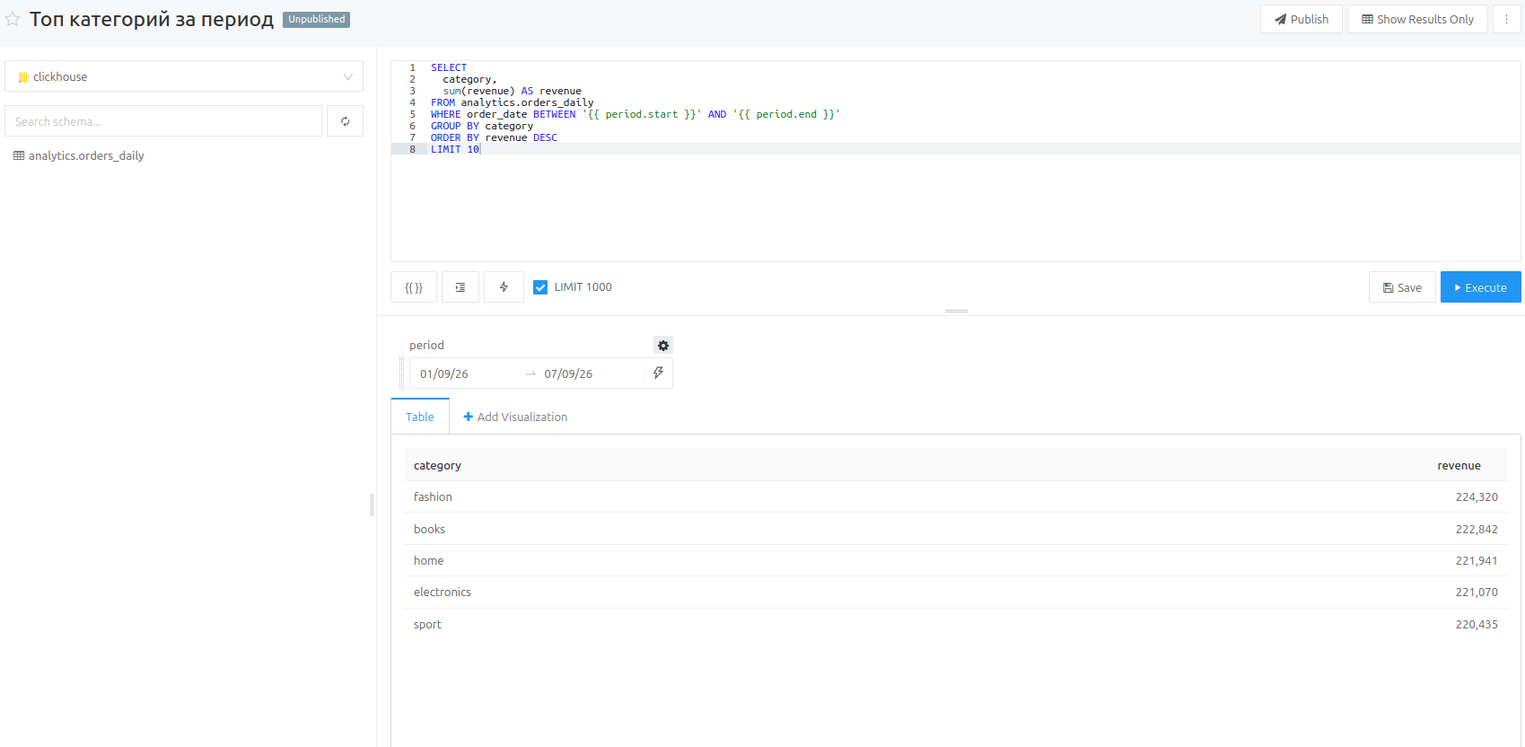
Запрос 2. Топ категорий за период
SELECT
    category,
    sum(revenue) AS revenue
FROM analytics.orders_daily
WHERE order_date BETWEEN '{{ period.start }}' AND '{{ period.end }}'
GROUP BY category
ORDER BY revenue DESC
LIMIT 10
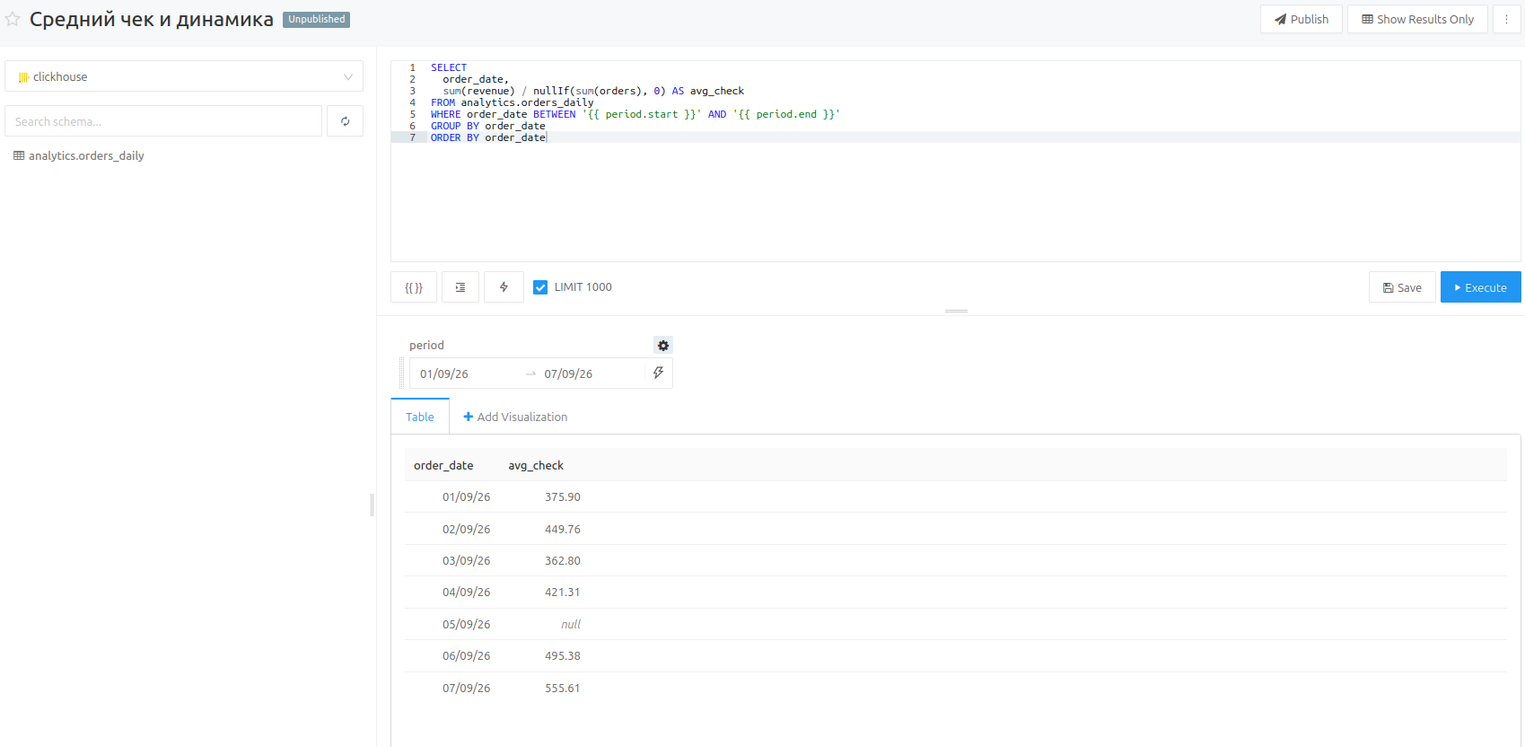
Запрос 3. Средний чек и динамика
SELECT
    order_date,
    sum(revenue) / nullIf(sum(orders), 0) AS avg_check
FROM analytics.orders_daily
WHERE order_date BETWEEN '{{ period.start }}' AND '{{ period.end }}'
GROUP BY order_date
ORDER BY order_date
Обратите внимание на nullIf: деление на ноль в ClickHouse не бросит ошибку, но выдаст inf, и график в этом месте просто схлопнется. Подобные краевые случаи в BI всплывают позже и обходятся дороже, чем при тестировании в консоли, потому что смотрит на них уже не автор запроса.
Сборка дашборда
1. Сохранение запроса. Нажмем Execute (Ctrl+Enter), убедимся в корректности данных, нажмем Save (Ctrl+S) и введем осмысленное имя, например «Выручка по дням». Несохраненный запрос добавить на дашборд не получится.
2. Создание визуализации. Под областью результата есть ссылка Add Visualization — она открывает редактор графика. Слева выбирается Chart Type и назначаются колонки осей. Для выручки по дням подойдет тип Line (ось X — order_date, Y — revenue). Для топа категорий — Chart с галочкой Horizontal Chart (ось X — category, Y — revenue). Для среднего чека снова Line. Имя визуализации станет заголовком виджета, поэтому здесь сразу стоит задать осмысленное название, а не оставлять дефолтным «Chart».
3. Создание дашборда. В меню Create (в правом верхнем углу) выберем New Dashboard, зададим имя и нажмем Save.
4. Размещение виджетов. Откроем дашборд и нажмем карандаш справа вверху — перейдем в режим редактирования. Кнопка Add Widget открывает диалог со всеми сохраненными визуализациями — выбираем нужную и жмем Add to Dashboard. Действия нужно повторить для каждого графика.
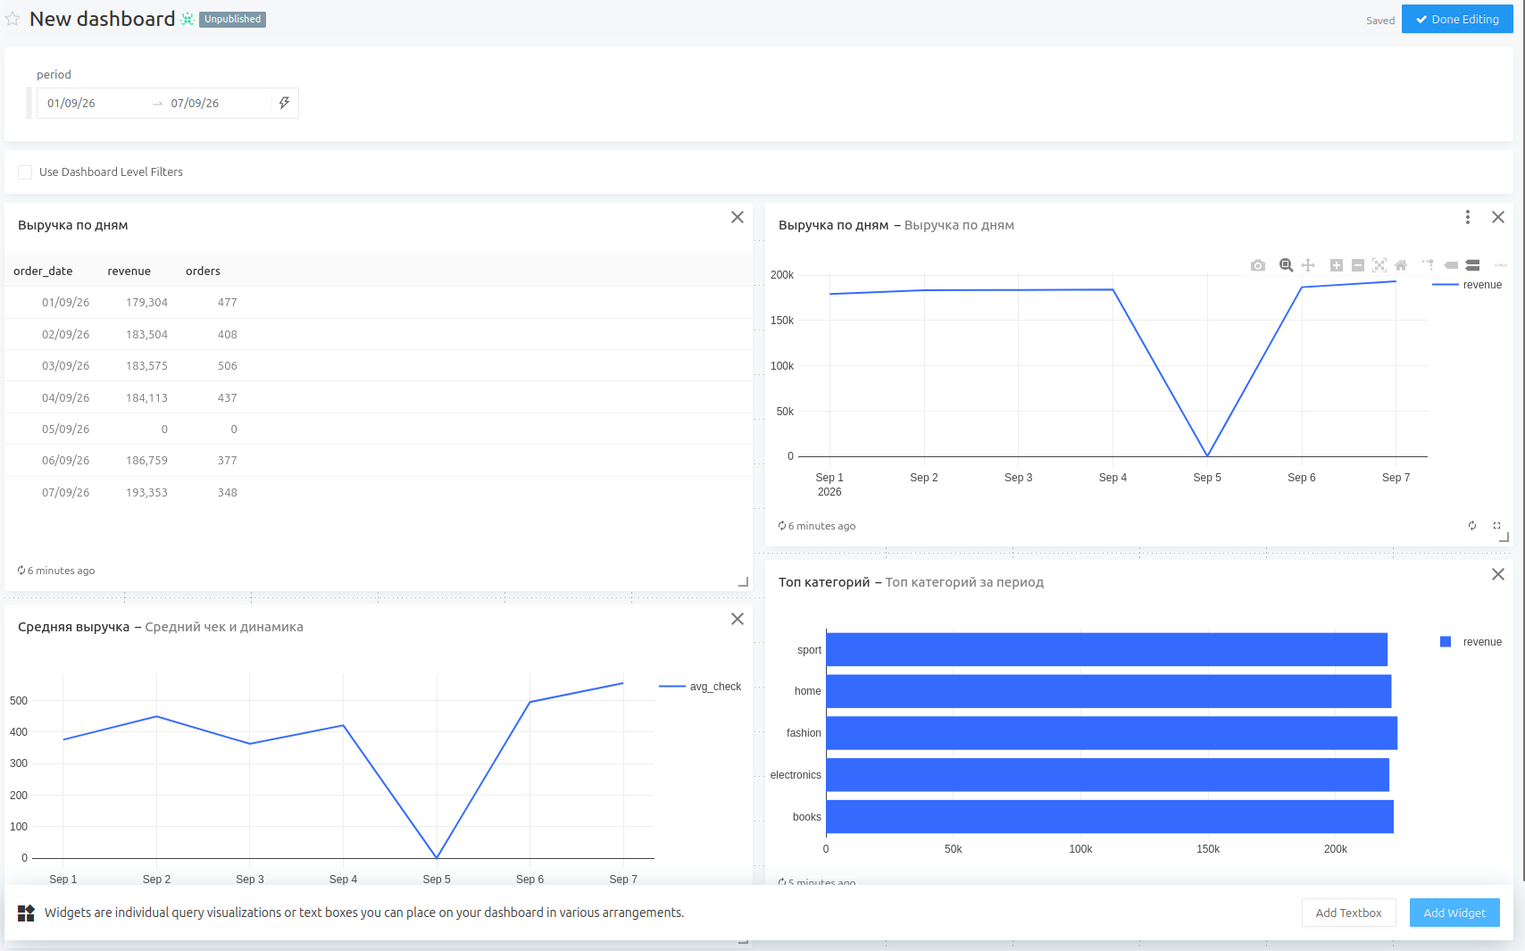
5. Сохранение и публикация. После расстановки элементов нажимаем Save, затем Publish — кнопка появляется в шапке дашборда. Теперь доступна постоянная ссылка, которую можно отправить коллеге.
6. Настройка расписания. Вернемся к каждому из трех запросов. Под шапкой запроса, в панели с метаданными (где указаны автор и источник), есть строка Refresh Schedule — кликнем ее. В открывшемся диалоге зададим Refresh every: Never (по умолчанию) или период — от секунд до недели. Для дневных и недельных расписаний появляется отдельный выбор времени срабатывания. Для нашей витрины разумный минимум — один час.
Ad-hoc в трино: когда витрины не хватает
Итак, регулярные метрики отражаются на дашборде. Однако рано или поздно возникнет вопрос, на который витрина не отвечает — например: «В какой день недели покупают лучше?». В таблице orders_daily нет колонки с днем недели. Добавлять его — значит править ETL‑пайплайн, что потребует время, а проверить гипотезу нужно сейчас. Для этого и существует второй источник — Trino.
Запрос пишется в том же редакторе Redash, только с указанием Trino в качестве источника:
SELECT
  day_of_week(order_date) AS weekday,
  sum(revenue) AS revenue
FROM orders_daily
WHERE order_date BETWEEN DATE '{{ period.start }}' AND DATE '{{ period.end }}'
GROUP BY 1
ORDER BY 1
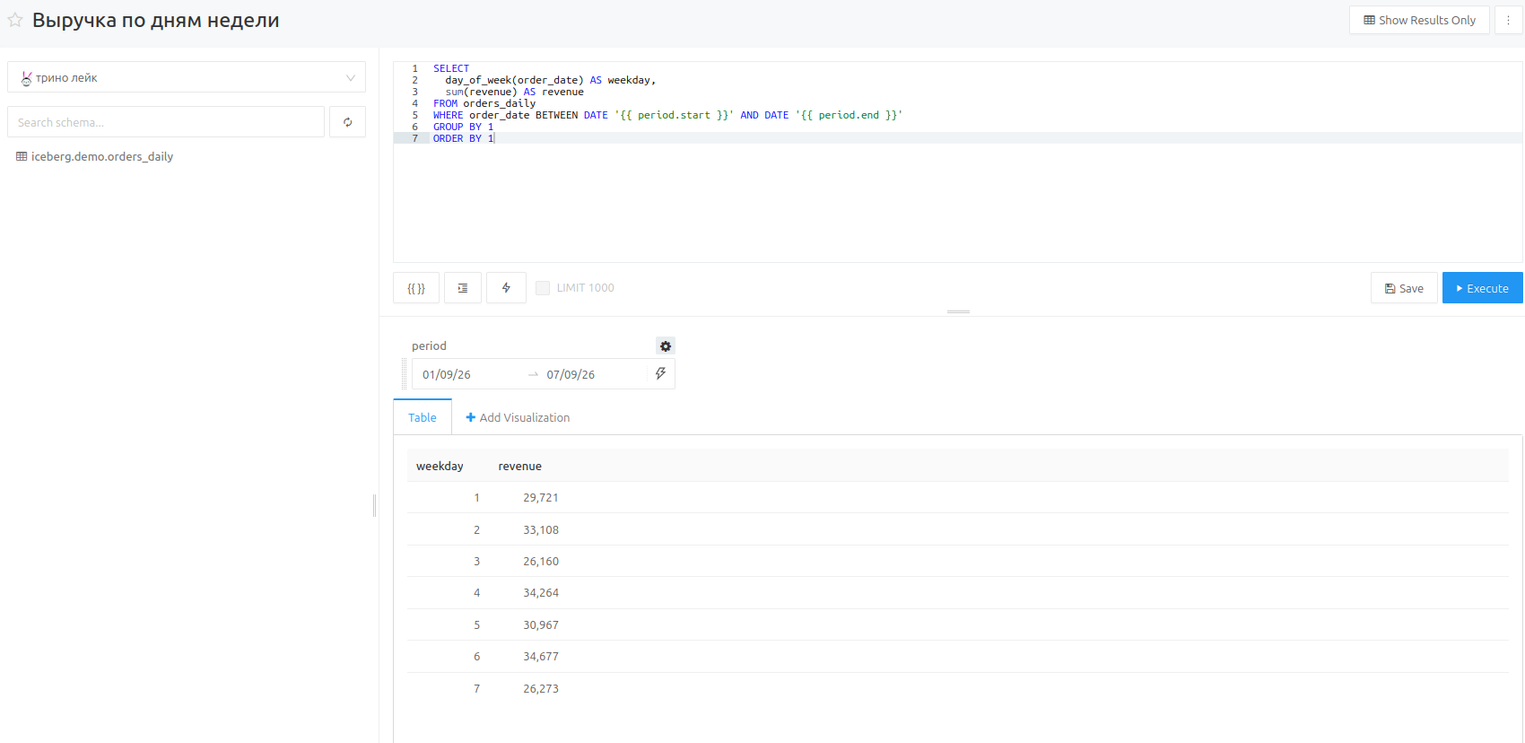
Функция day_of_week возвращает номер дня недели (1 — понедельник, 7 — воскресенье). Результат — обычная таблица: можно оставить ее ответом в редакторе, а можно положить на тот же дашборд еще одной визуализацией.
Есть два отличия от ClickHouse-диалекта, на которых легко споткнуться:
DATEперед параметром — Trino строго типизирован и автоматически не приводит строки к датам: подстановка безDATEдаетvarchar, и запрос падает с ошибкойCannot check if date is BETWEEN varchar(10) and varchar(10)из‑за несоответствия типов, так как ключевое словоDATEпревращает подставленное значение в литералDATE '2026-08-01'.GROUP BY 1— Trino не разрешает ссылаться на псевдонимы из блокаSELECTвнутриGROUP BY(приходится использовать порядковые номера столбцов), в отличие отORDER BY, где псевдонимы работают.
Важно помнить, что Trino читает сырые данные целиком. Если «в какой день недели покупают лучше» спрашивают уже третий раз — это сигнал добавить измерение в витрину и перевести запрос на ClickHouse.
Что происходит под капотом, когда открывается дашборд
Дашборд — это живое окно в данные: страница открылась, запросы ушли в базу, вернулись свежие цифры. В Redash архитектура устроена иначе, и непонимание ее особенностей стабильно приводит к двум типам инцидентов: «цифры не те» и «платформа легла в девять утра».
Дашборд из десяти виджетов — это десять запросов
Redash не объединяет запросы, не переиспользует промежуточные результаты и не строит общий план на дашборд. Каждый виджет привязан к своему запросу, а тот выполняется отдельно и независимо. Если все десять виджетов одновременно читают одну и ту же таблицу, движок и прочитает ее десять раз.
Отсюда первое практическое правило: агрегировать на стороне витрины, а не плодить виджеты поверх сырой таблицы. Один запрос, возвращающий несколько метрик разом, почти всегда лучше трех запросов, отличающихся одной функцией.
Открытие дашборда обычно не обращается к источнику вообще
Redash хранит последний результат каждого запроса у себя, в собственном Postgres. Когда страница открывается, виден именно сохраненный результат — в углу виджета есть время его получения. В ClickHouse и Trino в этот момент не уходит ничего.
Запрос реально выполняется только в трех случаях: или пользователь нажал Execute в редакторе, или Refresh на дашборде или сработало расписание.
Следствие, которое стоит проговорить всей команде вслух: актуальность показателей на дашборде определяется расписанием обновления запроса, а не тем, насколько свежие данные в LakeHouse. Если запрос обновляется ежечасно, а витрина раз в пятнадцать минут, пользователь видит данные с задержкой до часа. Обратное тоже верно: ежеминутное расписание не сделает данные свежее, чем их положил туда пайплайн, зато добавит шестьдесят лишних запросов в час.
Цепочка задержек в итоге выглядит так:
событие в источнике — задержка пайплайна загрузки в Iceberg;
таблица Iceberg — задержка обновления витрины в ClickHouse;
витрина MergeTree — расписание обновления запроса в Redash или (виджет на дашборде).
Результаты лежат в Postgres, что не бесплатно
Каждый результат сохраняется в таблицу query_results как JSON-документ. Запрос, возвращающий миллион строк, положит в базу Redash многомегабайтную запись — и будет делать это заново при каждом обновлении по расписанию.
Отсюда два правила.
Агрегировать в запросе, а не в визуализации, ведь выгружать сырые строки, чтобы график сам их посчитал, — прямой путь к распухшей базе.
Следить за размером таблицы результатов. Ее рост — это первый индикатор того, что кто-то завел дашборд на сырых данных.
Сколько запросов одновременно уйдет в ClickHouse, определяет параметр WORKERS_COUNT в adhoc worker. Если поставить одного воркера, то десять человек, синхронно нажавших Refresh, выстроятся в очередь внутри Redash и будут жаловаться на медленный BI. Если поставить двадцать — очередь просто переедет в ClickHouse, и жаловаться начнут все, включая тех, кто к BI отношения не имеет.
Правильная настройка здесь не универсальна: она выводится из того, сколько одновременных запросов выдерживает использующийся движок. Но осознанно выбранное число всегда лучше дефолтного.

Managed Kubernetes на выделенных серверах
Снизьте расходы на ИТ‑инфраструктуру и улучшите производительность микросервисов.
Что ломается на втором дашборде
Все описанное выше не мешает первому дашборду. Проблемы начинаются, когда дашбордов становится десяток, а пользователей больше трех.
Расписания сходятся в одну точку
Человек, создающий запрос, выбирает период обновления из выпадающего списка: каждый час, каждые 30 минут. В результате все запросы в системе обновляются в начале часа, одновременно. Нагрузка на движок при этом не размазана по времени, а собрана в узкие пики, и именно в эти минуты пользователи видят таймауты.
Лечится разносом расписаний вручную и тем, что тяжелые запросы намеренно ставятся на не частое обновление. Это не автоматизируется в open-source версии, поэтому проще договориться на берегу.
Таймауты
Долгий ad-hoc запрос в Trino упрется в таймаут либо источника в настройках Redash, либо самого движка. Первый настраивается на источнике, второй — в конфигурации Trino. Разбираться, какой именно сработал, приходится по логам, и здесь помогает то, что Redash передает имя пользователя в Trino: запрос видно в его веб-интерфейсе.
Доступы: главное ограничение
В Redash права выдаются на источник данных целиком, через группы: full access или view only. Тонких настроек row-level и column-level security в открытой версии нет. Если аналитику нельзя видеть зарплаты, а таблица с ними лежит в том же каталоге Trino, средствами Redash настроить нужное ограничение не получится.
Правильное место для разграничения доступа — движок, а не BI-инструмент. Именно поэтому в разделе «Поднимаем Redash» мы создавали специального пользователя redash, а не подключались под стандартным default. Ему же следует выдать права на схему витрин:
CREATE USER redash IDENTIFIED WITH sha256_password BY '...';
GRANT SELECT ON analytics.* TO redash;
При таком подходе BI физически не сможет показать то, чего не видит его технический пользователь. Вопрос доступа решается один раз в движке, а не повторяется в каждом подключаемом инструменте. Для Trino логика та же — ограничение на уровне каталога и схемы.
Дублирование данных
Раз результаты всех выполненных запросов лежат в Redash во внутреннем Postgres, там же оказывается и копия всех данных, включая даже те, что попали в выборку случайно. Значит, дополнительную базу данных нужно защищать наравне с основным хранилищем, выполнять резервное копирование. Для локального стенда это неважно, но для реального контура это не так.
Отсутствие семантического слоя
В Redash нет места, где условная выручка определена один раз. Два аналитика напишут ее двумя способами: один с учетом возвратов, другой без — и оба дашборда будут выглядеть одинаково убедительно. На масштабах небольшой команды подобная нестыковка лечится код-ревью запросов и общими витринами. Если выручка подсчитана в витрине ClickHouse, а не в тексте запроса, расхождений не будет. Это, кстати, еще один аргумент за то, чтобы дашборды брали информацию из витрины, а не сырого озера данных.
Metabase
Рассмотрим теперь Metabase. Поднимается он намного проще, чем Redash, так требуется только один контейнер:
services:
  metabase:
    image: metabase/metabase:latest
    ports:
      - "3000:3000"
    volumes:
      - metabase-data:/metabase-data
    environment:
      MB_DB_FILE: /metabase-data/metabase.db
    networks: [lakehouse]
    restart: unless-stopped

volumes:
  metabase-data:
Внутреннее состояние по умолчанию сохраняется в H2 — встроенной Java-базе, состоящей из одного файла. Для локального стенда это идеально: ноль лишних сущностей. Но H2 не справляется с конкурентной записью, поэтому плохо масштабируется на команду. Если пользователей инструмента больше двух, рекомендуется мигрировать на Postgres через переменную MB_DB_CONNECTION_URI.
После запуска Metabase будет доступен по адресу http://localhost:3000.
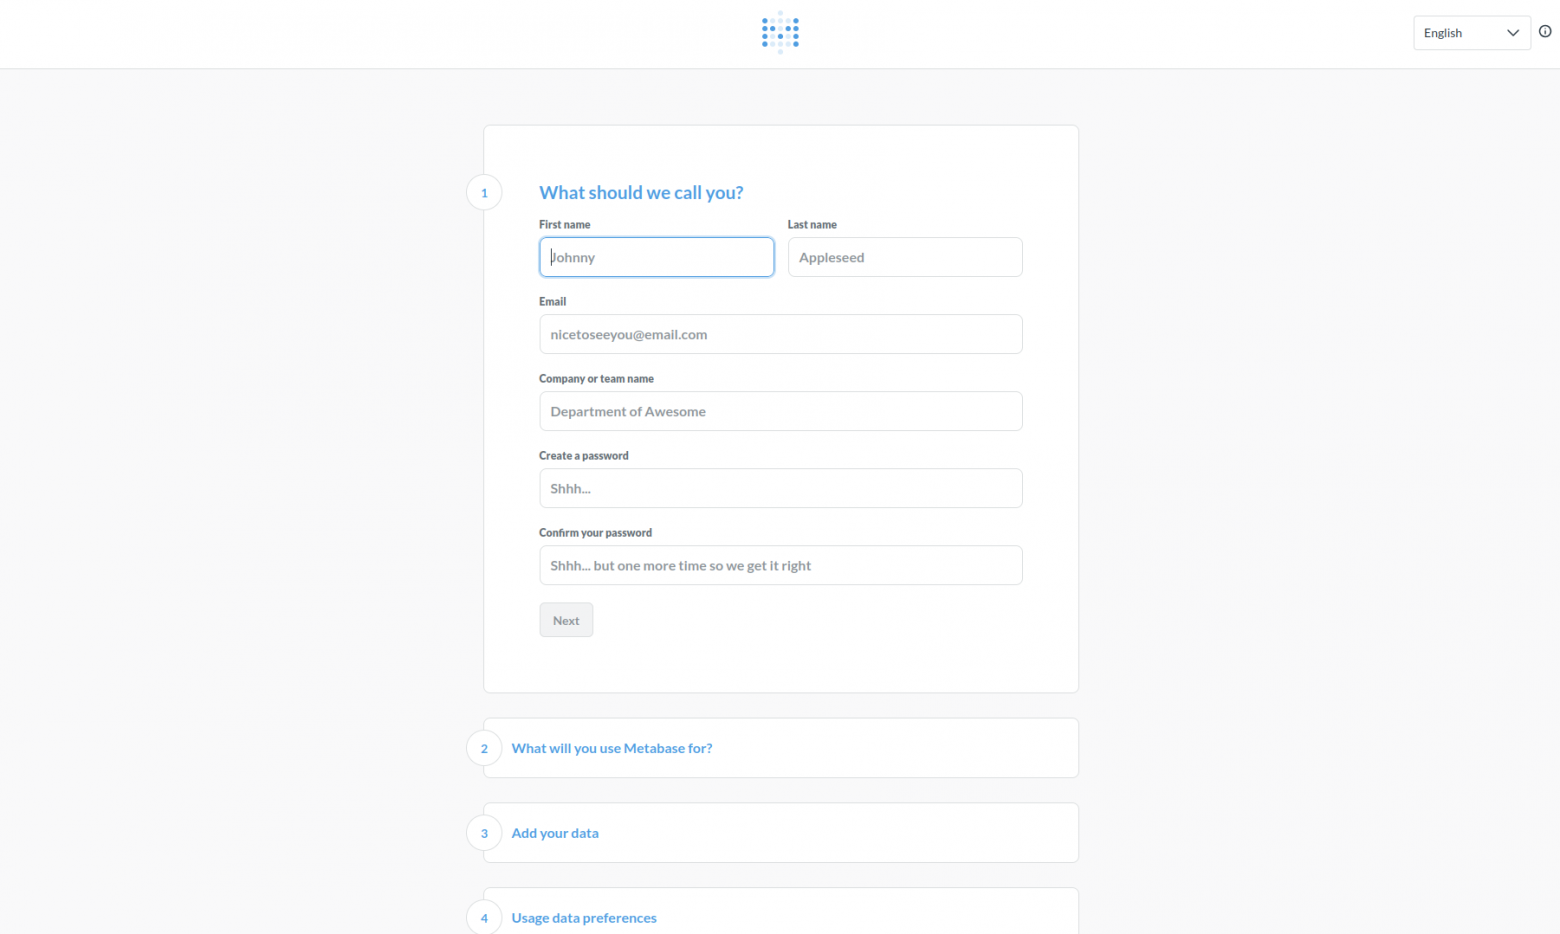
Как и для Redash, нужно сначала создать административного пользователя. Сразу же можно подключить источник таким же способом как и для Redash.
После регистрации нас встретит главный экран, где уже можно настраивать аналитику.
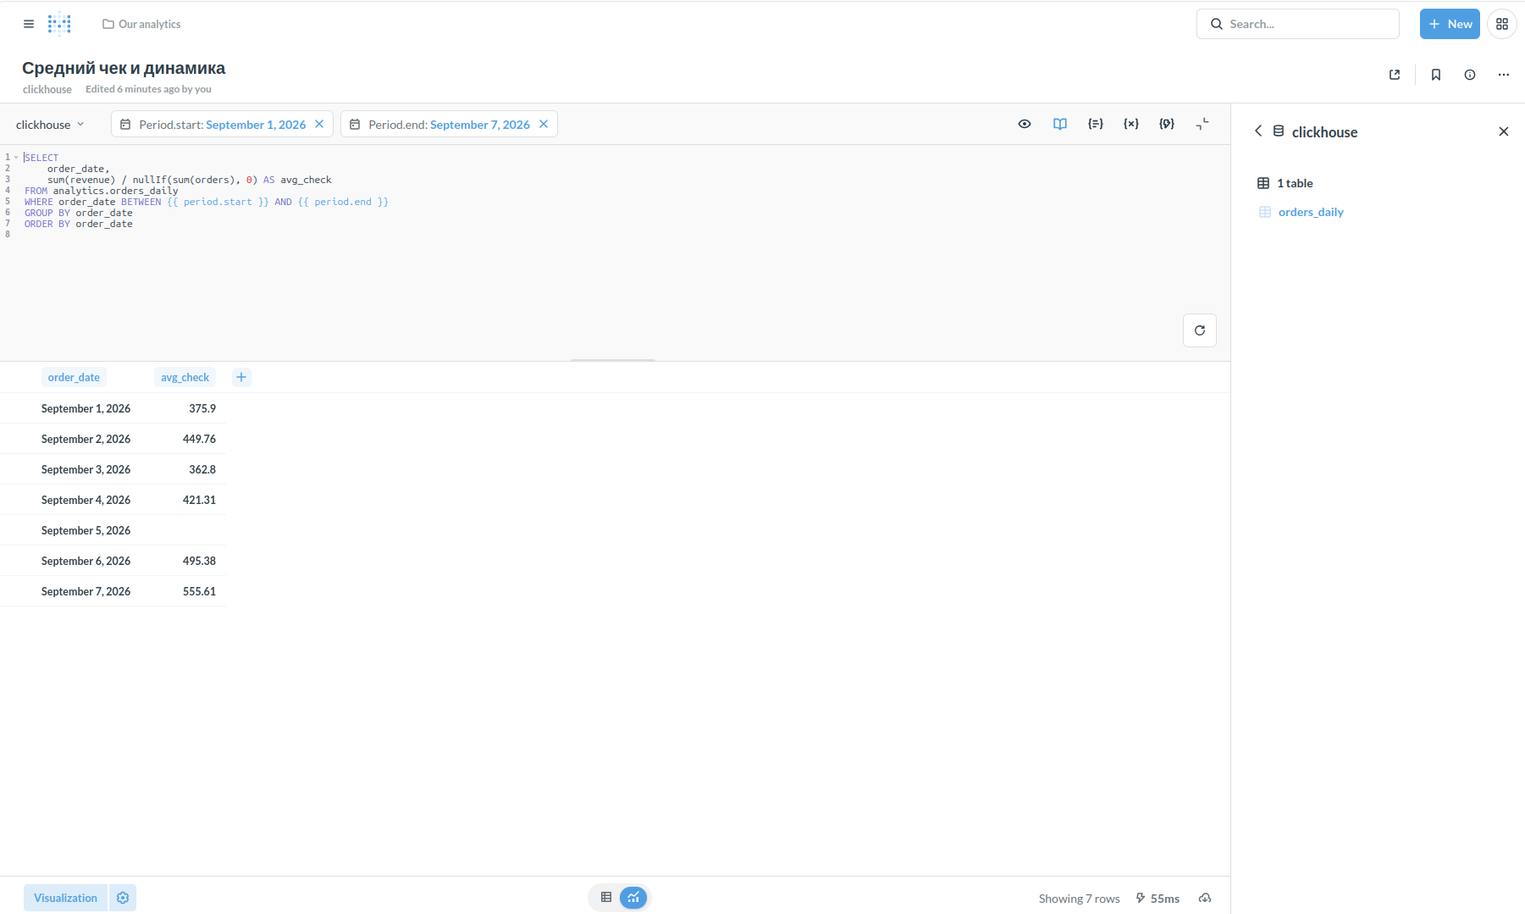
Добавим те же запросы, что и для Redash и построим дашборд. Для добавления нового запроса, нужно нажать кнопку New в правом верхнем углу и выбрать запрос.
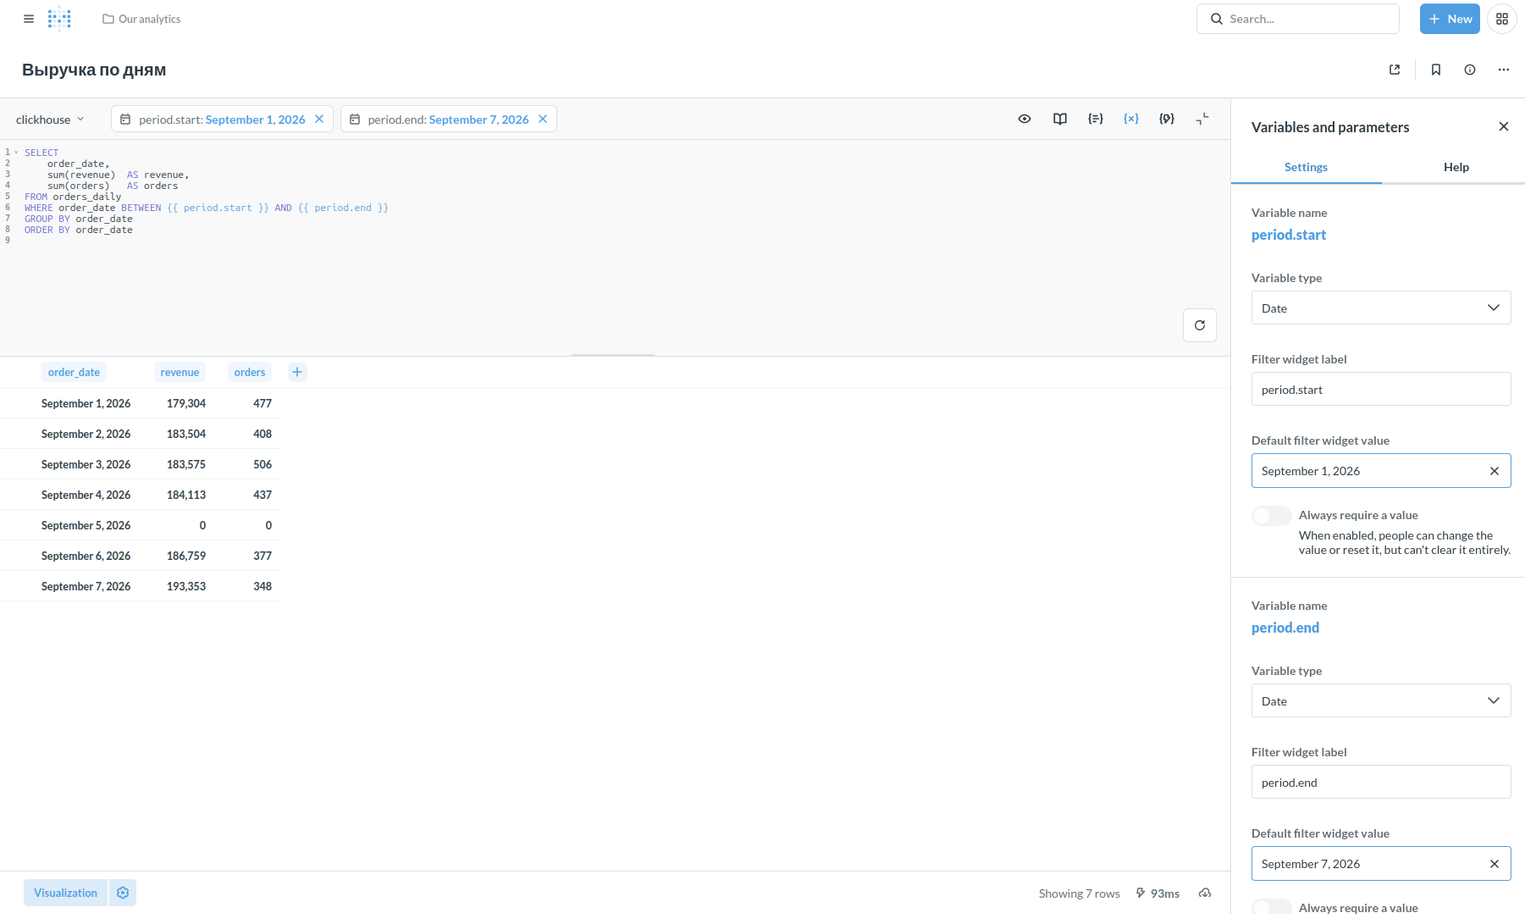
Справа сразу можно настроить значения для параметров, а также построить визуализацию по данным, если нажать на кнопку слева снизу.
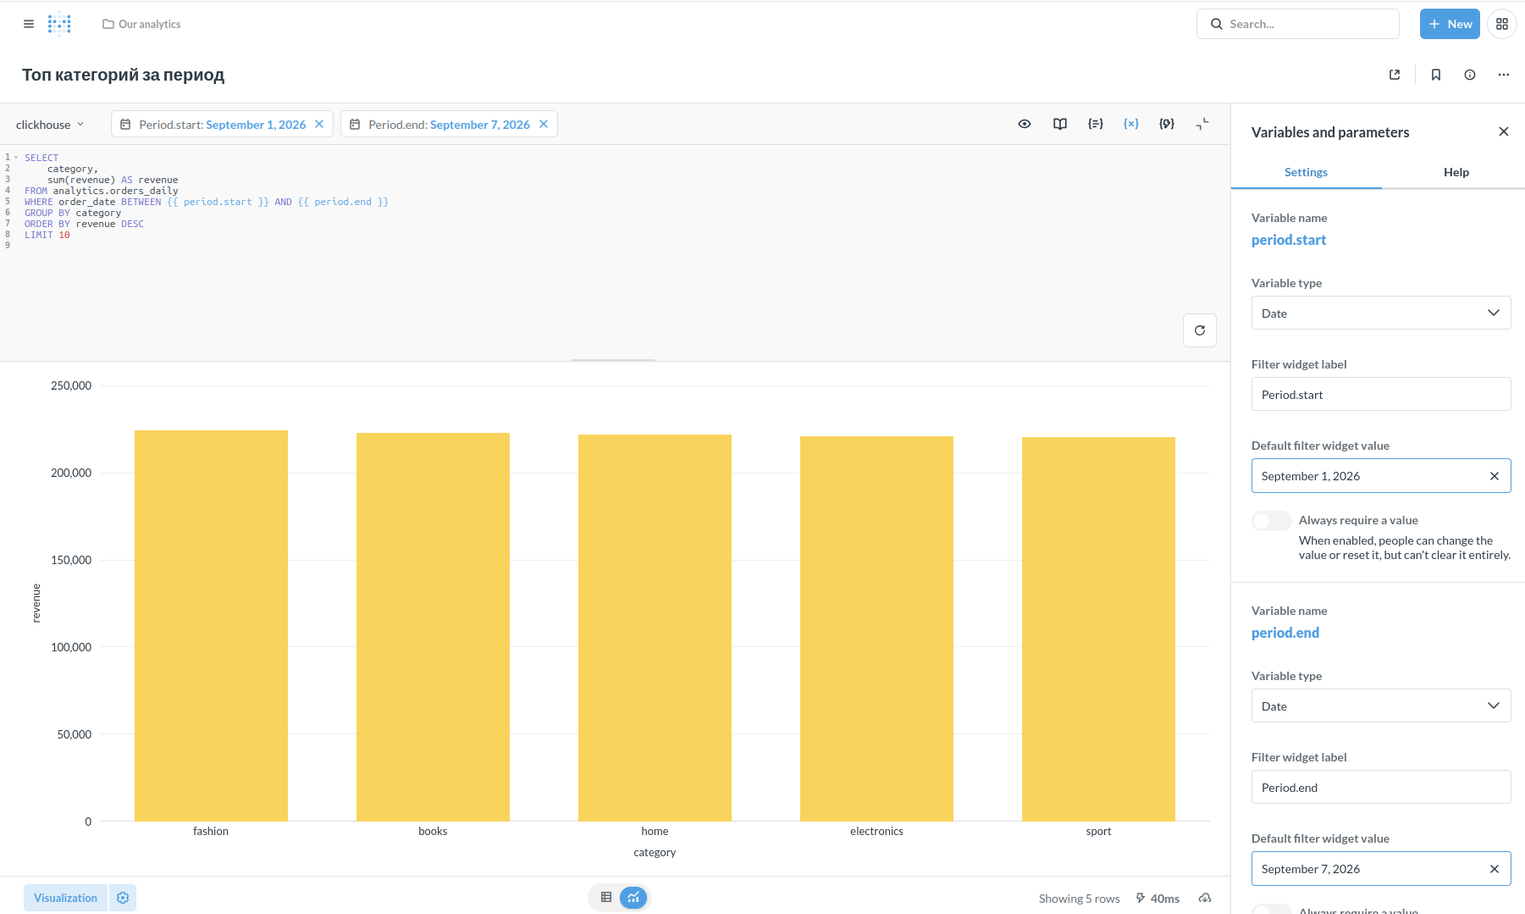
Сохраним последний запрос.
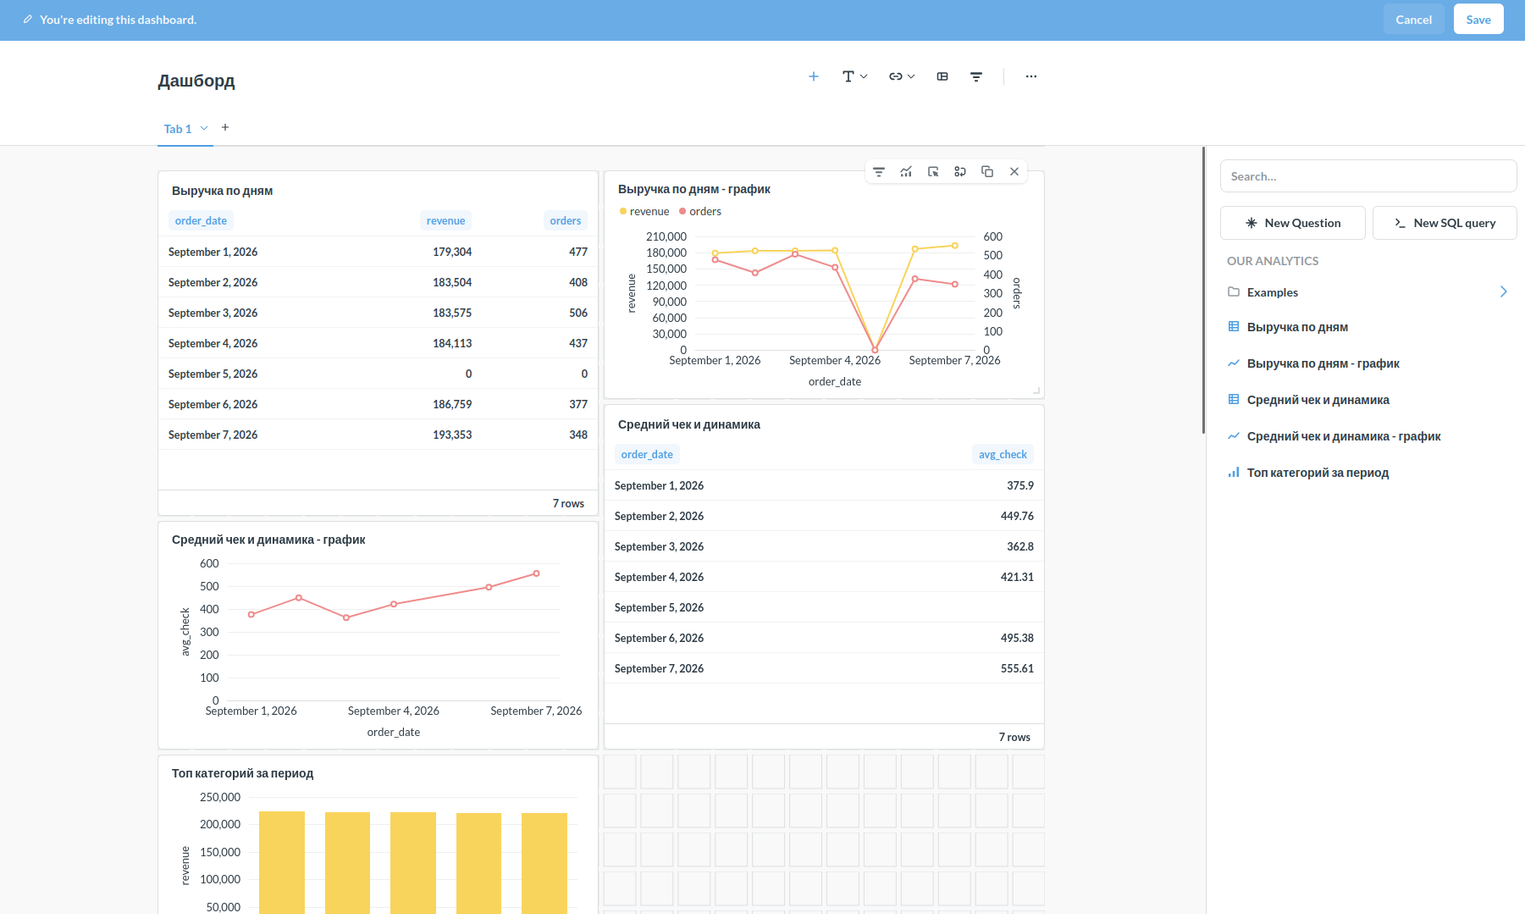
После этого можно создать новый дашборд и добавить туда наши графики и таблицы.
Superset
Apache Superset поднять немножко сложнее. Так как в официальном Docker-образе нет драйверов к нашим движкам, то их придется установить самостоятельно. Для этого можно использовать следующий dockerfile:
FROM apache/superset:latest
USER root
RUN uv pip install --python /app/.venv/bin/python --no-cache \
    psycopg2-binary trino clickhouse-connect
USER superset
Положим его в директорию superset рядом с основным docker-compose.yml. Там же создадим конфигурационный скрипт pythonpath/superset_config.py:
import os

SECRET_KEY = os.environ["SUPERSET_SECRET_KEY"]
SQLALCHEMY_DATABASE_URI = "postgresql+psycopg2://superset:superset@superset-db/superset"

class CeleryConfig:
    broker_url = "redis://superset-redis:6379/0"
    result_backend = "redis://superset-redis:6379/0"

CELERY_CONFIG = CeleryConfig
Соответствующая часть Docker Compose выглядит так:
x-superset: &superset
  build: ./superset
  depends_on: [superset-db, superset-redis]
  environment:
    SUPERSET_SECRET_KEY: <openssl rand -base64 42>
  volumes:
    - ./superset/pythonpath:/app/pythonpath:ro
  networks: [lakehouse]
  restart: unless-stopped

services:
  superset:
    <<: *superset
    ports:
      - "8088:8088"

  superset-worker:
    <<: *superset
    command: celery --app=superset.tasks.celery_app:app worker --pool=prefork -O fair -c 2

  superset-db:
    image: postgres:16-alpine
    environment:
      POSTGRES_USER: superset
      POSTGRES_PASSWORD: superset
      POSTGRES_DB: superset
    volumes:
      - superset-db:/var/lib/postgresql/data
    networks: [lakehouse]

  superset-redis:
    image: redis:7-alpine
    networks: [lakehouse]

volumes:
  superset-db:
Если попытаться с Superset зайти на localhost:18088 сразу после запуска, то ничего не выйдет. Сначала надо применить миграции для БД, создать учетную запись администратора, и в конце инициализировать роли безопасности.
docker compose run --rm superset superset db upgrade

docker compose run --rm superset superset fab create-admin --username admin --email admin@example.com --password <пароль>

docker compose run --rm superset superset init
Теперь созданный на предыдущем шаге администратор может работать.
После логина будет доступен стартовый экран, где можно будет добавлять запросы и дашборды.
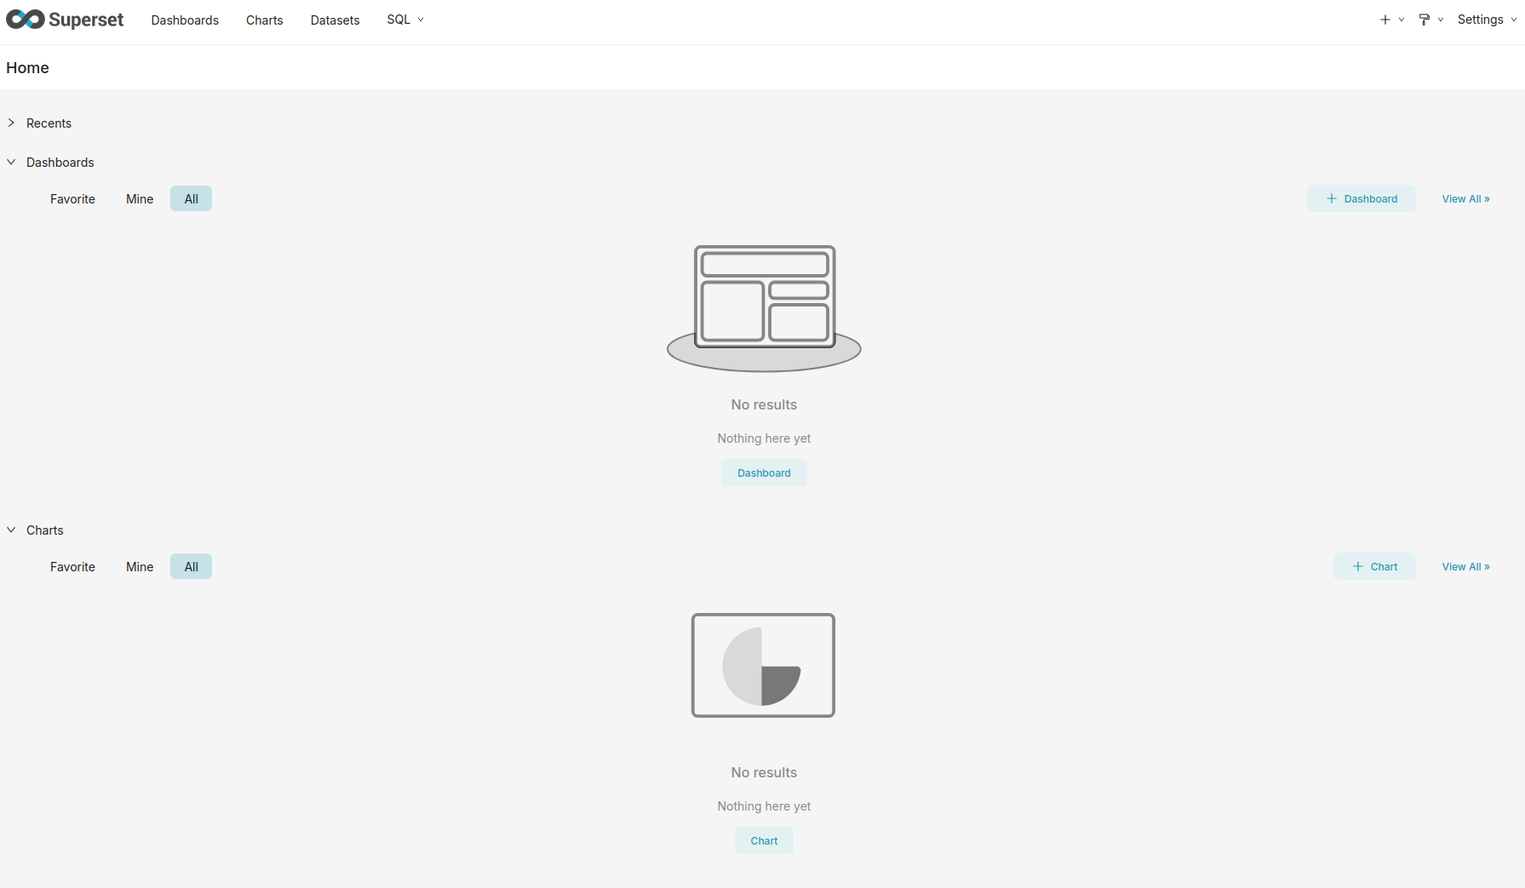
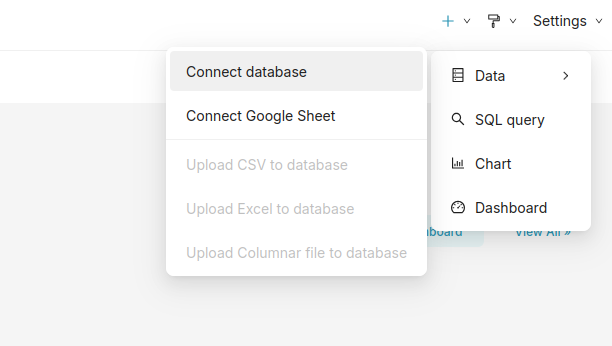
Теперь можно добавить новое соединение.
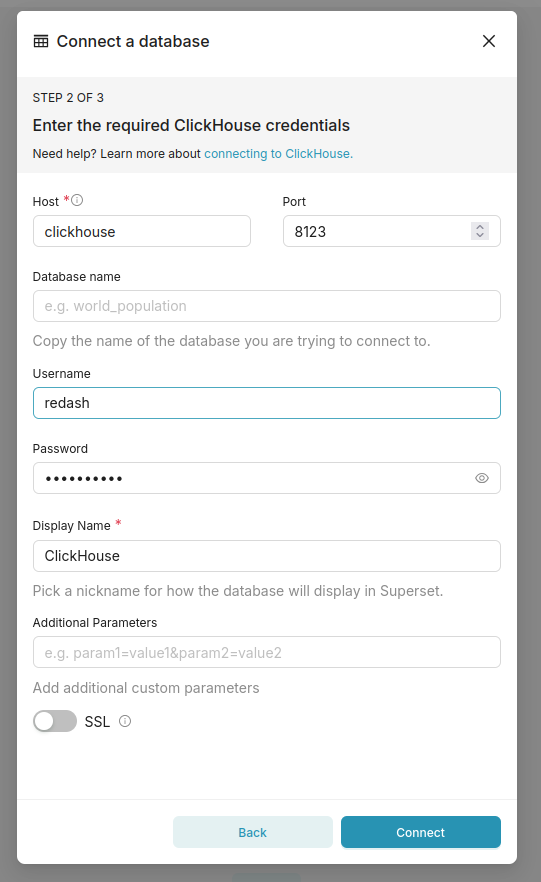
Выбираем ClickHouse и заполняем поля как для других инструментов.
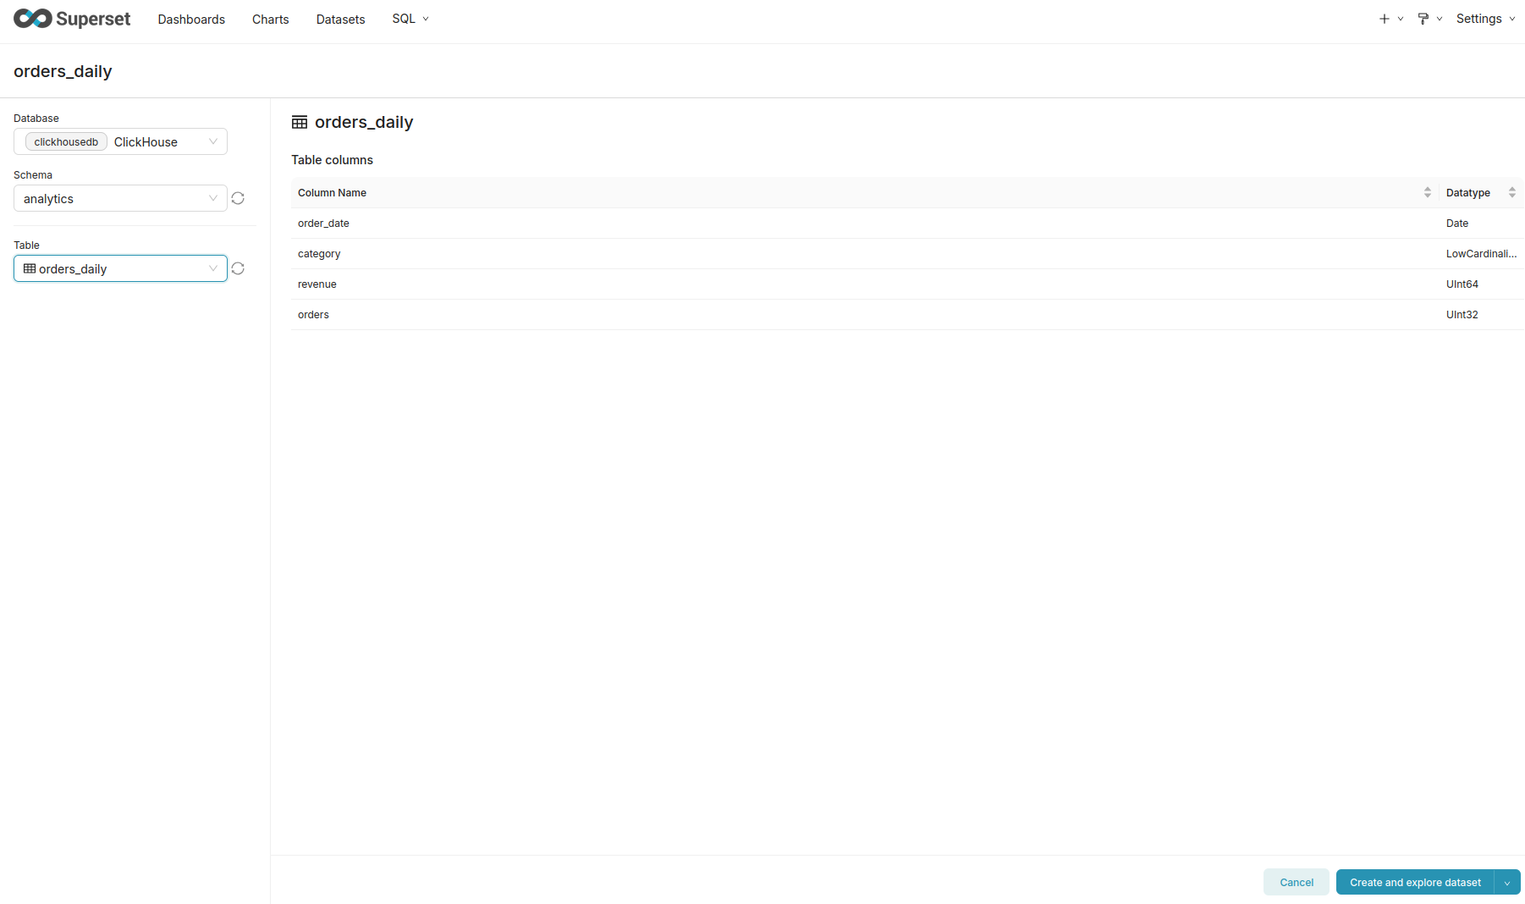
Теперь можно переходить к созданию датасетов.
Датасет — это промежуточный слой между запросом и дашбордом. Superset позволяет строить графики и данные из отдельных блоков, которые доступны в датасете. Можно, конечно, по классике использовать чистый SQL.
Кликаем на Добавить новый датасет и выбираем наше соединение с ClickHouse. Теперь датасет можно сохранить.
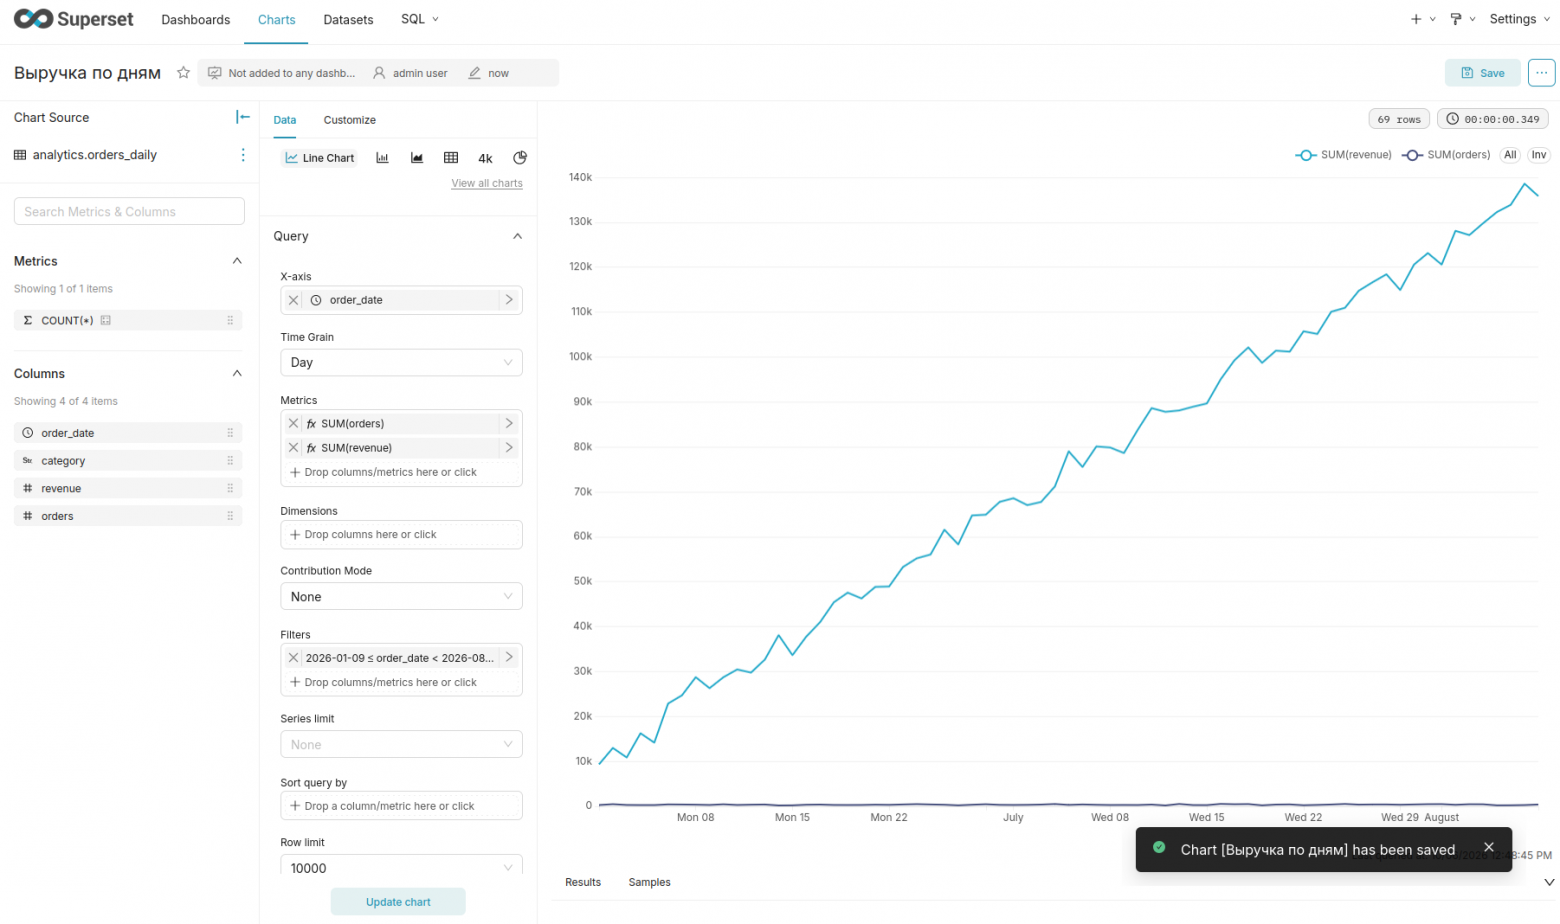
В Superset писать SQL необязательно, можно собрать дашборд из датасета. Например, выручка по дням будет выглядеть так:
Топ категорий:
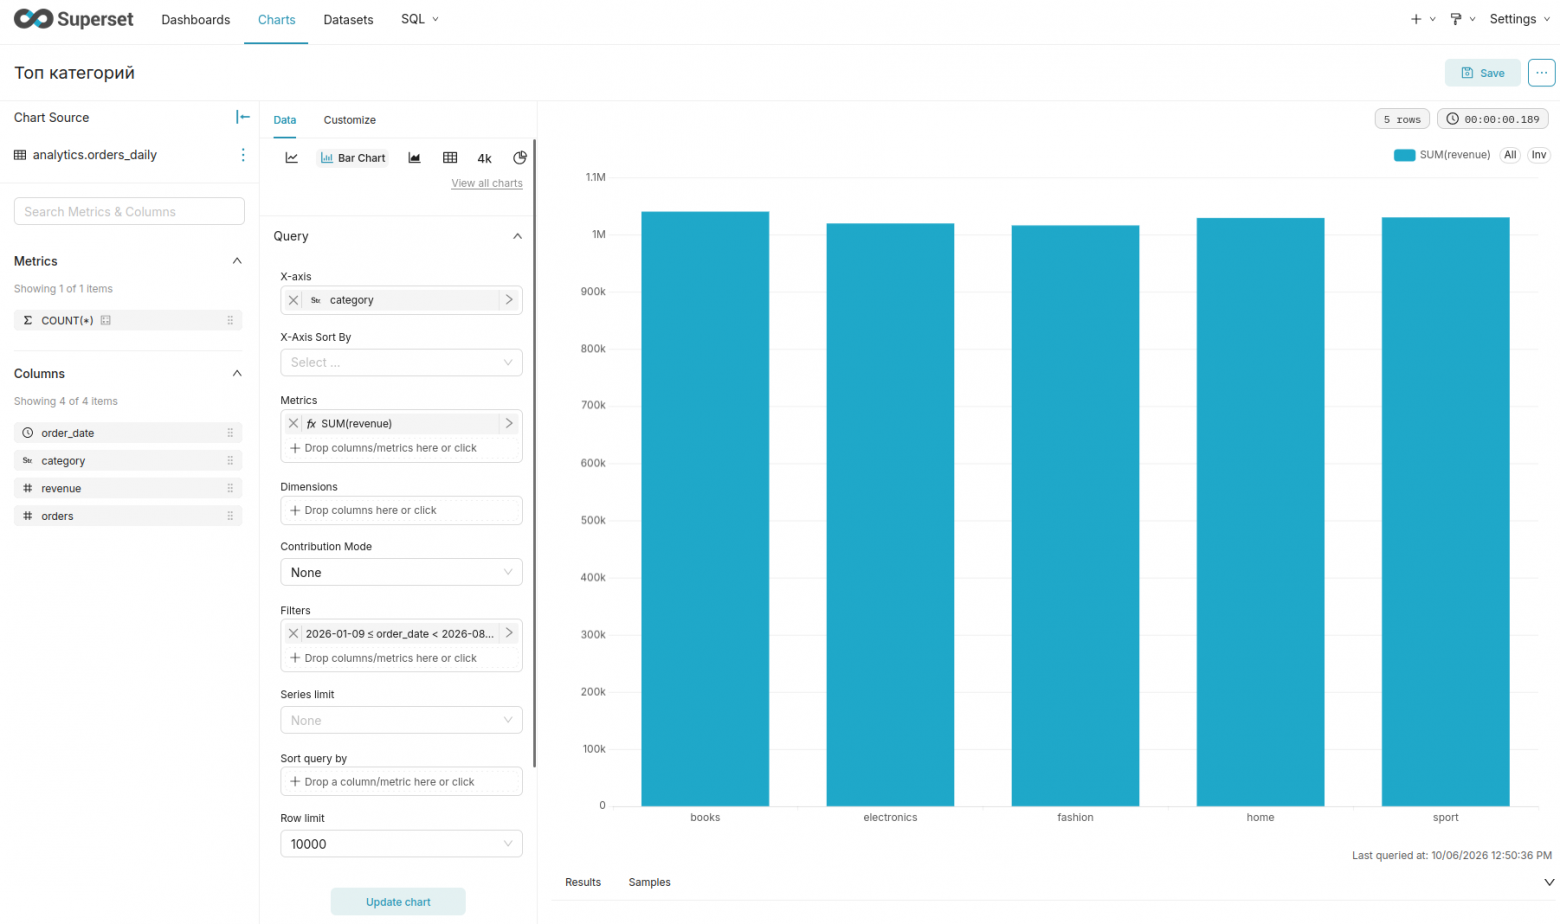
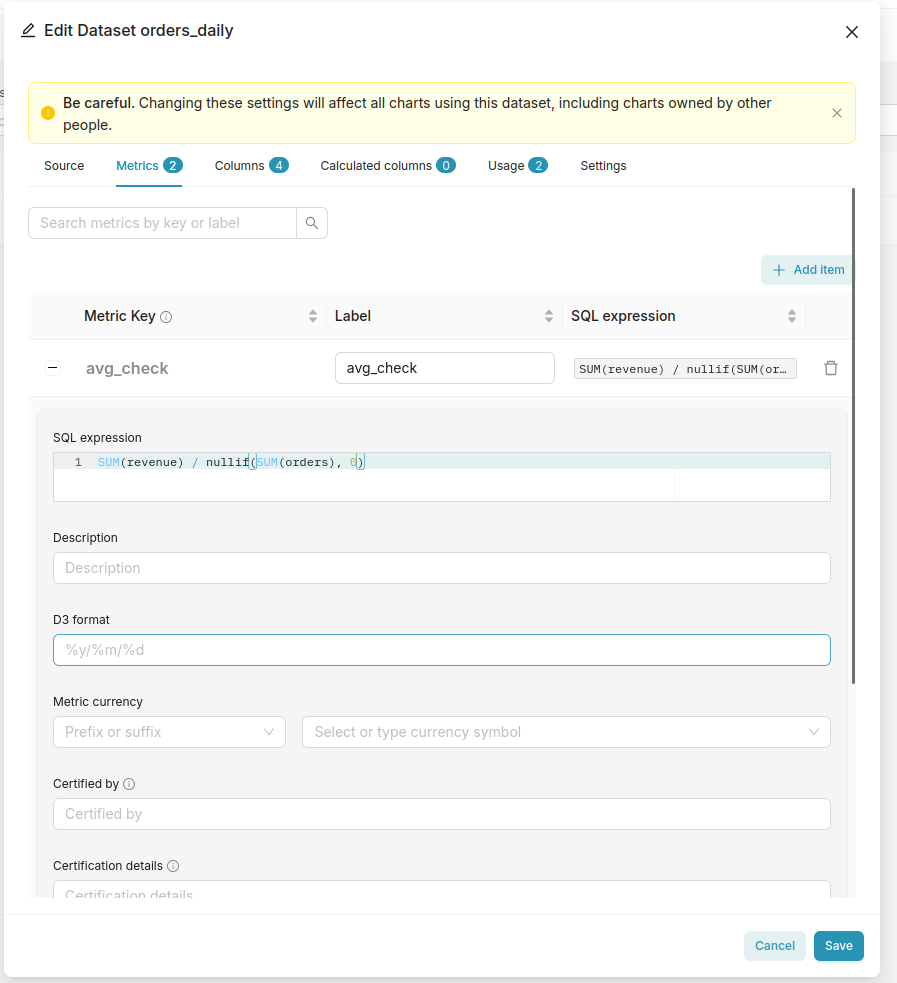
Для среднего чека нужно добавить новую метрику в наш датасет. Сделать это можно во вкладке Datasets:
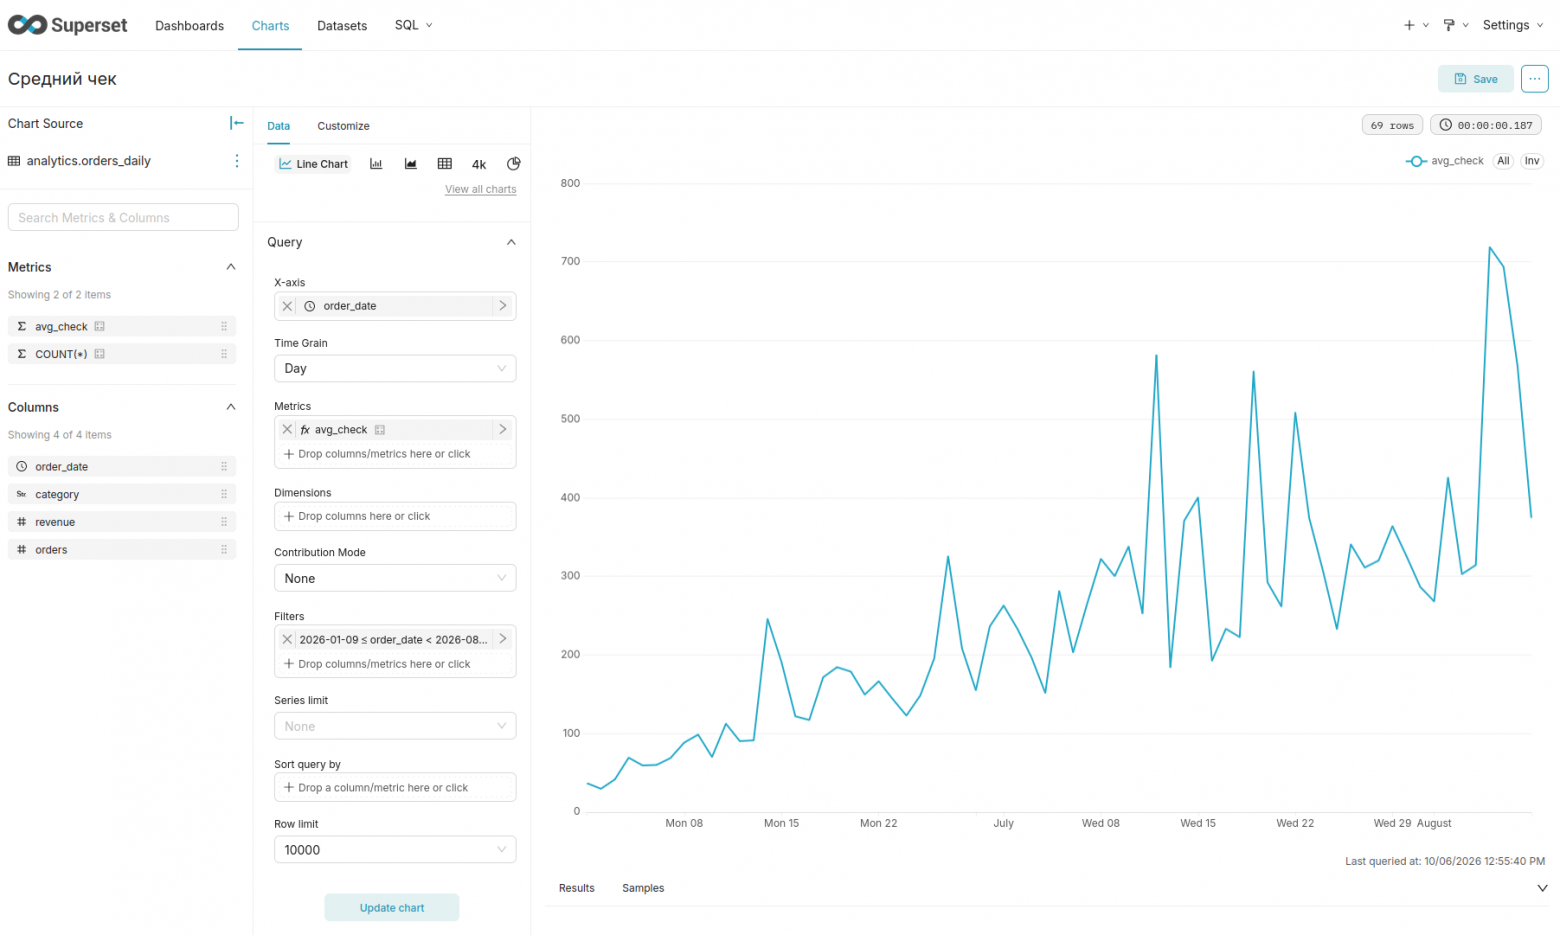
Теперь, при построении графика, можно выбрать только что созданную метрику.
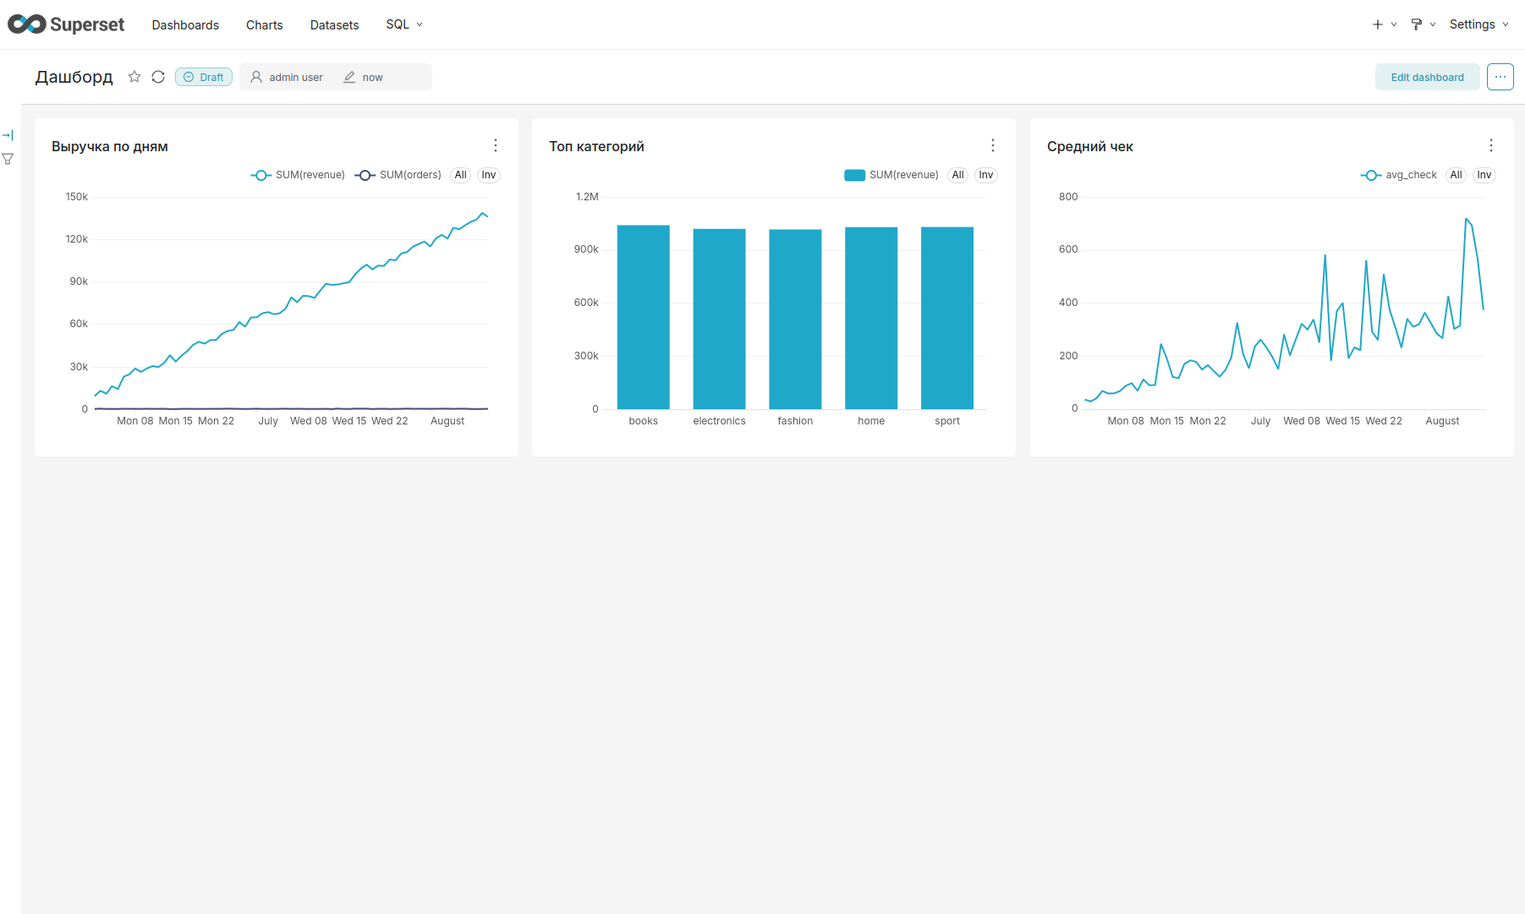
Дашборд создается как и в других инструментах. Нужно только перетащить построенные чарты и сохранить результат:
Заключение
Платформа данных замыкается в единую экосистему. Данные попадают в объектное хранилище, Iceberg дает им структуру и транзакционность, каталог — единое место для схемы, Trino и Spark выполняют тяжелые запросы, ClickHouse держит витрины, а Redash, Metabase, или Superset показывают результат. Аналитик, менеджер и маркетолог получают ответы сами, без обращения к инженеру данных.
Предыдущие части
• Озеро данных и Apache Iceberg
• Каталог метаданных
• Вычислительный движок
Ключевые выводы:
нагрузка от дашбордов идет и в витрину, и в лейк, а не в продовые базы — в этом и смысл разделения, выстроенного за предыдущие четыре части;
дашборд показывает не «живые» данные, а сохраненный результат последнего выполнения запроса, а значит об актуальности данных необходимо заботиться отдельно;
разграничение доступа — в движке, а не в BI-инструменте, поэтому нужно создавать отдельного технического пользователя с минимальными правами.