Обновить
64K+

Визуализация данных *

Облекаем данные в красивую оболочку

100,35
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

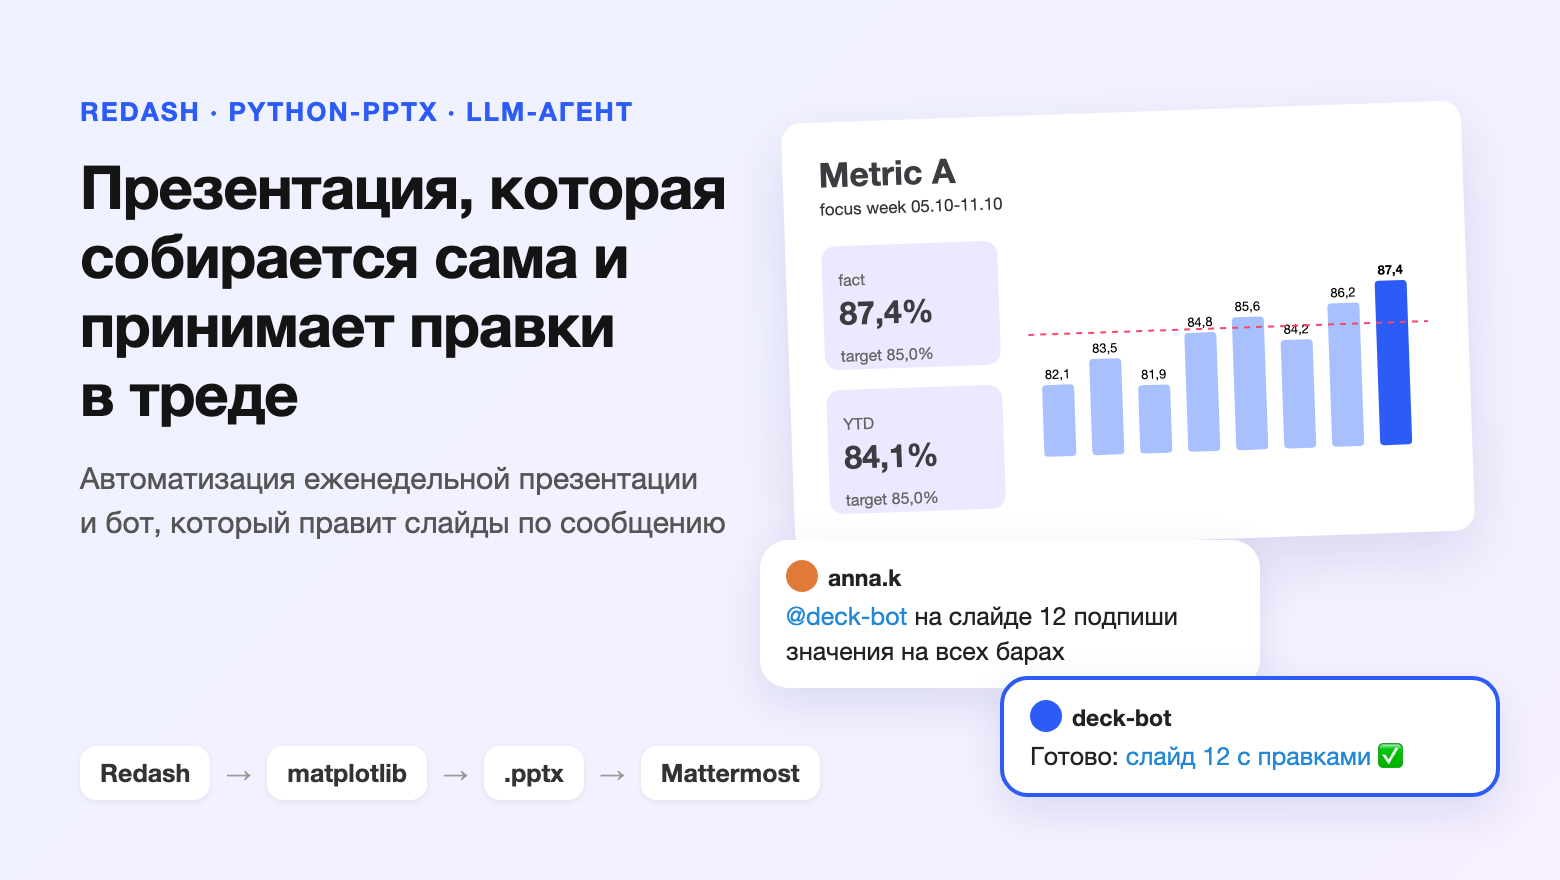
Как я автоматизировала еженедельную презентацию и научила AI‑бота делать правки прямо в треде
Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели6.6K

Расскажу, как я автоматизировала сборку еженедельной презентации: данные берутся из Redash, собирается .pptx, и раз в неделю ссылка на неё приходит в мессенджер. А потом я сделала бота, которому можно написать правку к слайду прямо в треде под презентацией.

Каждую неделю у департамента проходит встреча, и к ней нужна презентация на несколько десятков слайдов с метриками в разных разрезах. Ранее 20+ менеджеров собирали презенатцию руками: открывали Redash, прокликивали фильтры, делали скриншоты, выгружали данные в иксель и делали промежуточные расчеты, вставляли это все на слайды, подписывали цифры, делали ручное форматирование и т.д. Каждую неделю на это уходило несколько часов.

Я опишу основные шаги и как всё устроено. Код в статье упрощённый, под свои задачи его придётся дорабатывать.

Читать далее

Новости

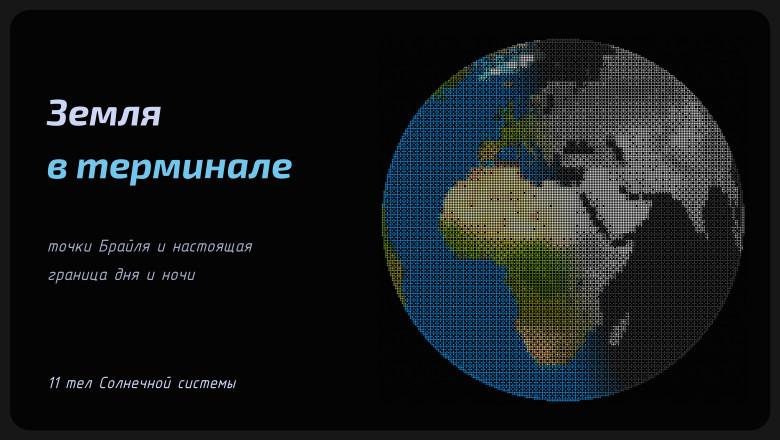
Глобус в терминале: Земля из символов Брайля и реальная смена дня и ночи

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели7K

Представьте, что в уголке вашего терминала висит глобус Земли, и ночь на нём наступает там же, где за окном. Я написал такую программу за два дня. Она загружает карту мира, обтягивает ею сферу и отображает её символами: точками шрифта Брайля, значками Юникода либо буквами. Шар вращается мышью и раскрашивается одной из десяти палитр. Помимо Земли утилита показывает Солнце, Луну, все планеты и Цереру. Ставится одной командой, без Python и зависимостей.

Читать далее

Почему женщин нет на «Олимпе достижений»?

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели6.6K

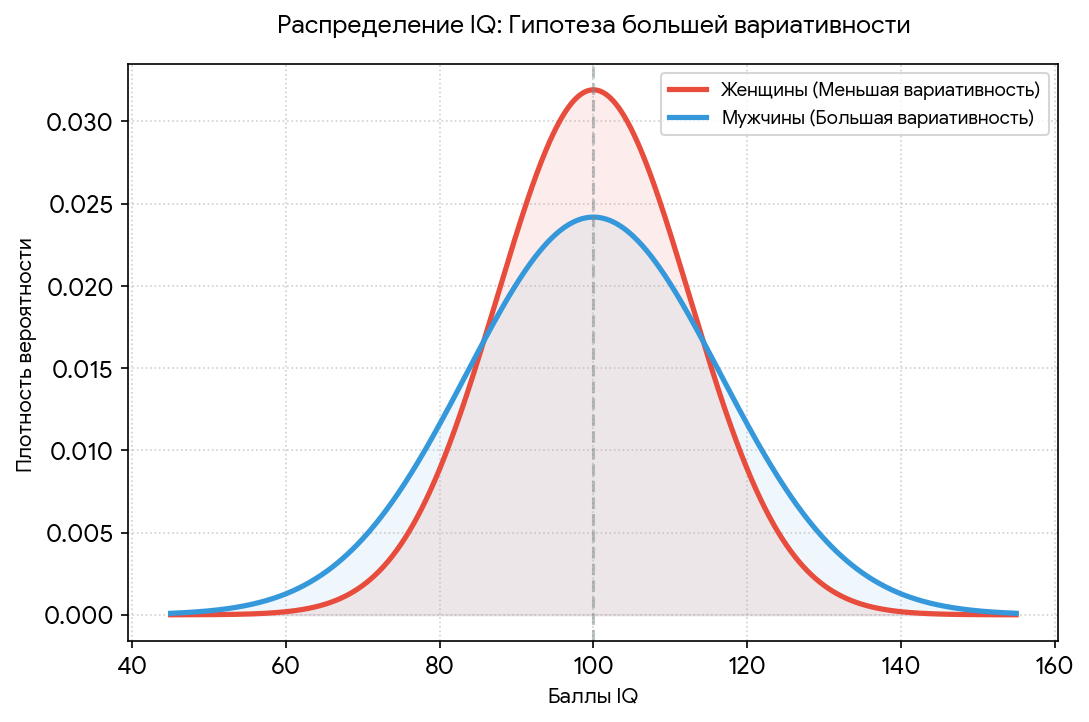
Доброго времени суток, дорогие читатели. Этот вопрос мучает меня уже на протяжении двух недель — с того момента, как я вернулся в шахматы и решил заглянуть в топ-100 FIDE. К своему удивлению, я не обнаружил там ни одной женщины. Меня очень заинтересовала эта тема, и я решил начать свой писательский‑научный путь.
В ней я подробно разберу, почему людей с выдающимися достижениями в науке, спорте и искусстве среди мужчин статистически больше, если сравнивать их с общим объемом открытий человечества. В ходе аргументации я буду опираться на сухие научные концепции и факты, которые продемонстрируют ответ на данный вопрос абсолютно без моего вмешательства и оценочного суждения.

Читать далее

Постобработка IFC без Revit, часть 2: площади ТЭП, дубли и правки, которые можно переслать

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели4.7K

Хабр, привет! Это Кирилл, с коллегой Анастасией @nobimnolife делаем IDS Core. Сейчас усиленно взялись за постобработку и немного расскажем о новых инструментах.

В прошлой статье мы рассказывали, как научились править IFC прямо в браузере: заполнять параметры, менять класс и этаж, удалять лишнее — и при этом не ломать файл. После публикации просмотрщиком начали пользоваться не только мы, и вопросы пошли другие. Уже не «как поменять тип данных», а «почему у нас не сходится общая площадь», «что делать с дублями из отчёта» и «как передать правки коллеге, чтобы он не делал всё заново».

Ниже — что мы на эти вопросы сделали и что выяснили по дороге. Почти в каждой истории оказалось, что очевидное решение не работает.

Читать далее

Сбор персональных данных через чат‑бот

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели5.7K

Требования Закона «О персональных данных» нужно соблюдать во всех случаях, когда вы сталкиваетесь с обработкой персональных данных. К сожалению, в большинстве случаев наводится порядок на сайте и внутри компании (относительно работников). Поскольку это два основных направления, где у Роскомнадзора возникает больше всего вопросов. Но предприниматели забывают или относят к малым рискам, когда осуществляют обработку персональных данных в чат-ботах.

Читать далее

Первый проект Process Mining: как выбрать процесс для оптимизации, собрать команду и не застрять на этапе пилота

Уровень сложностиПростой
Время на прочтение17 мин
Охват и читатели6.8K

Первый проект процессной аналитики обычно начинается с выгрузки журнала событий из учетной системы. По нему команда строит цифровой двойник процесса и находит петли и возвраты. Труднее сделать процессную аналитику постоянным рабочим инструментом компании, чтобы работа не закончилась презентацией по итогам пилота. Судя по глобальному опросу Deloitte, это удается не всем: за четыре года доля компаний, которые применяют Process Mining на уровне всей организации, почти не изменилась.

Эта статья — для тех, кто впервые запускает процессную аналитику: будущих руководителей центров компетенций, операционных директоров и процессных аналитиков. Разберем шесть шагов от постановки исследовательских вопросов и выбора процесса до оценки результатов пилота и перехода к постоянному мониторингу. Покажем, как собрать команду, определить KPI и принять решение о масштабировании. Возможности инструментов рассмотрим на примере VK Business Analytics — платформы VK Tech для анализа и оптимизации процессов.

Читать далее

Код считает, модель описывает: как мы встроили LLM в отчетность и не дали ей трогать цифры

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели9.4K

Привет, Хабр! Меня зовут Егор Шлюпиков, и я работаю старшим бизнес-аналитиком в YADRO в большой команде, которая менеджерит IT-оборудование. Мы следим за парком готовой техники и комплектующих, нужных для работы сотрудников. Сколько нужно купить, что залежалось, что в ремонте и утилизации и так далее — плюс финансовая аналитика.

В статье расскажу, как мы собрали сервис, который снял с нас немалую часть рутины: каждое утро он без участия человека выпускает более десятка отчетов с выводами от нейросети. При этом ни одно число в отчете не проходит через модель — все считает код, а она только пишет текст. Раскрою, как мы к этому пришли, зачем понадобился Trino и что делать, когда нужных данных в учетной системе просто нет.

Читать далее

Табло вылетов наоборот: как я превратил телеграм‑канал Росавиации в статистику по закрытиям аэропортов

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели7.3K

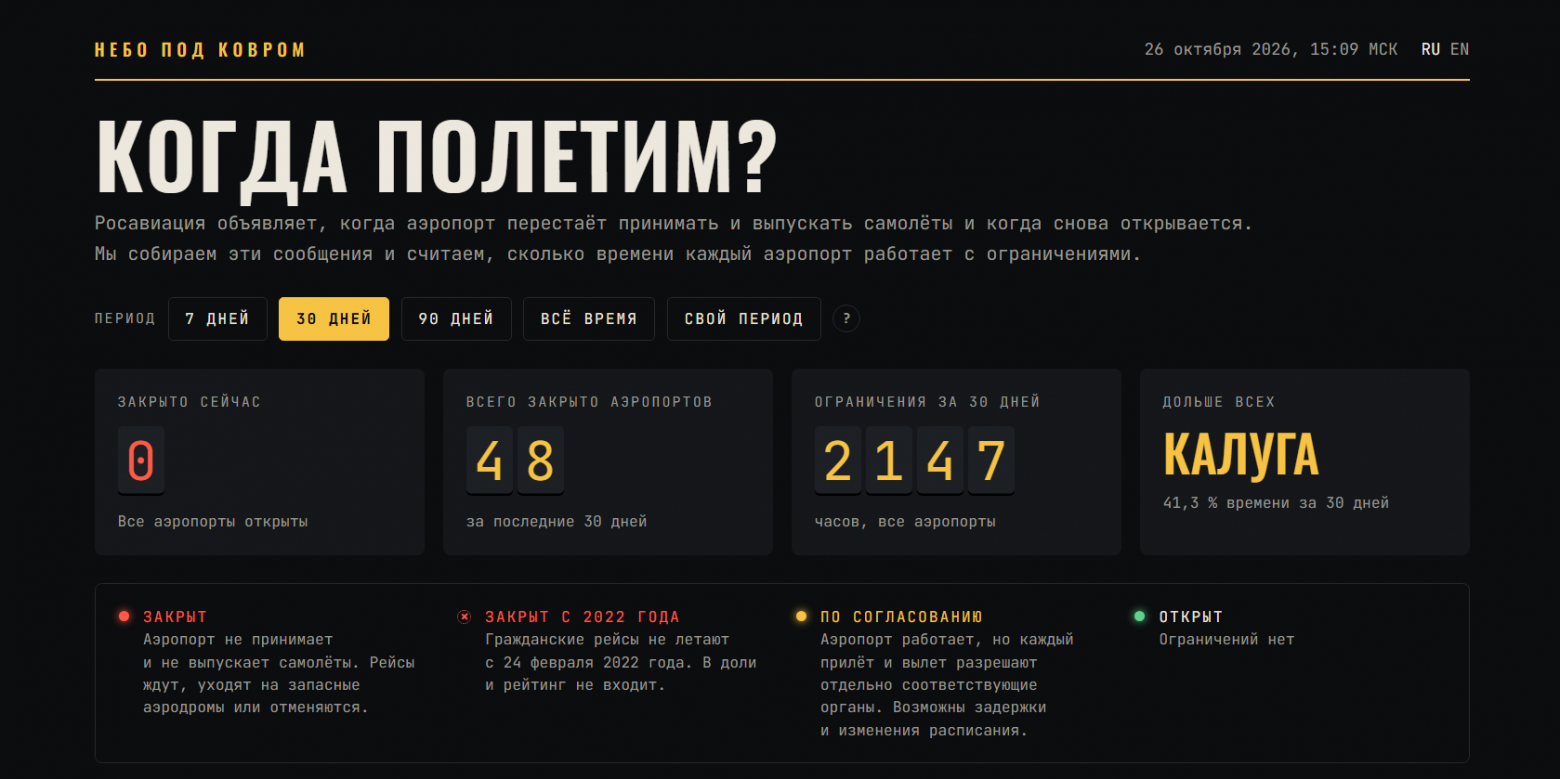
С лета 2025 года у многих появилась привычка перед вылетом проверять сведения об ограничениях в аэропортах. Один из таких источников — телеграм-канал "Говорит Росавиация". Там коротко пишут, где ввели ограничения на приём и выпуск самолётов, а где сняли. Несколько дней назад один телеграм-канал сделал по этим постам инфографику "Когда спокойнее всего улетать из Москвы": проценты по часам и дням недели для четырёх московских аэропортов. Инфографика отличная, но я живу в Петербурге. Так что первым делом я пошёл искать, откуда взяты данные, чтобы сделать такую же для Пулково.

А потом, как это обычно у меня бывает, задача выросла. Раз парсер всё равно пишется, почему бы не посчитать все аэропорты? А раз все — зачем снимок на одну дату? Хотелось живую статистику: зайти в любой момент и увидеть, что происходит сейчас и как было за любой период.

Так появился сайт "Небо под ковром". Это карта аэропортов, где для каждого видно, сколько времени он был под ограничениями, в какие часы и дни это бывает чаще всего и закрыт ли он прямо сейчас. В статье — как разобрать почти девять тысяч постов в трёх форматах, и что делать с ограничением, которое ввели и забыли снять.

Читать далее

12 индексов риска: динамика и слепые зоны

Уровень сложностиСредний
Время на прочтение18 мин
Охват и читатели7.9K

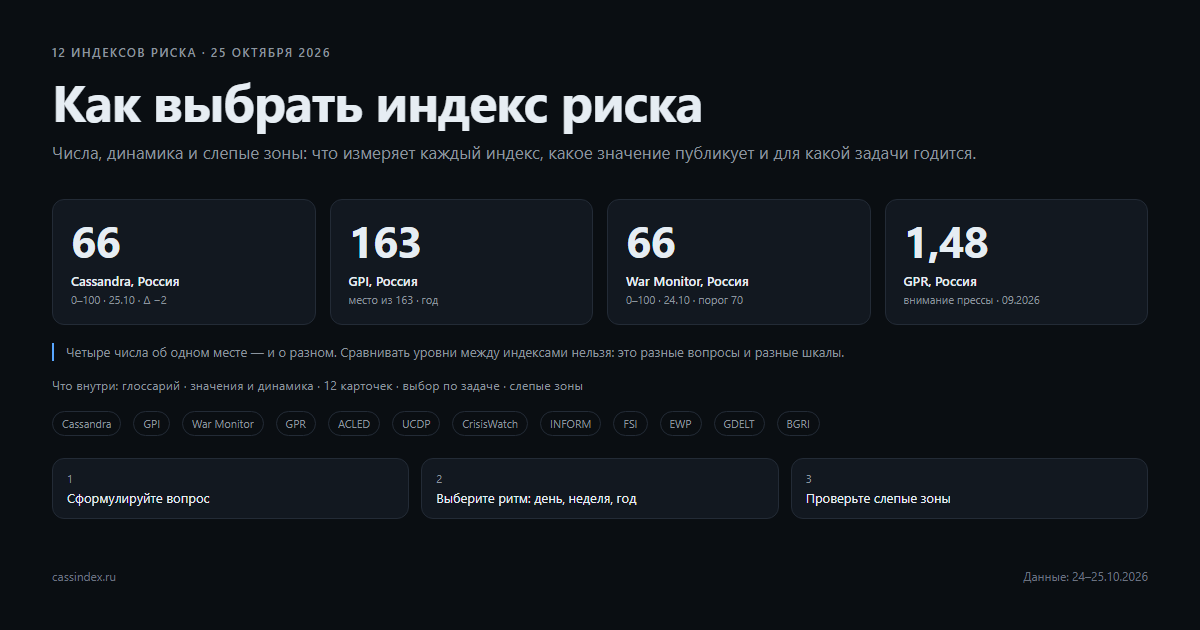
Это не прогноз войны и не вероятность войны. Ни один из 12 проектов не называет дату и не оценивает, кто прав. Это разбор для читателя, который хочет выбрать инструмент под свою задачу: что именно измеряет каждый индекс, какое число он показывает, как это число меняется и чего в нём нет.

Cassandra Index в таблице - мой проект. Он проходит те же проверки, что и остальные, и получает не первое место. Все числа ниже взяты из публичных источников и проверены 24–25 октября 2026 года.

Читать далее

Как люди придумывали красоту: собрал атлас 195 визуальных стилей, от пещеры Ласко до уирдкора

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели9.6K

Нейросети дали всем суперсилу: любой человек может за минуту получить вполне красивую картинку. Но суперсила попала в руки людям, которые часто не знают, что с ней делать. Я в том числе.

Попросить у ИИ «нарисуй в стиле импрессионизма» может каждый. Попросить «в стиле неопластицизма» или «в стиле вейпорвейва» может только тот, кто знает, что такие стили вообще есть, и чем они отличаются. Это как если бы мне дали возможность построить по щелчку пальцев любой дом. Любой. Но какой? Я не учился архитектуре и, скорее всего, построю то, что видел у соседа, а не то, что мне на самом деле близко.

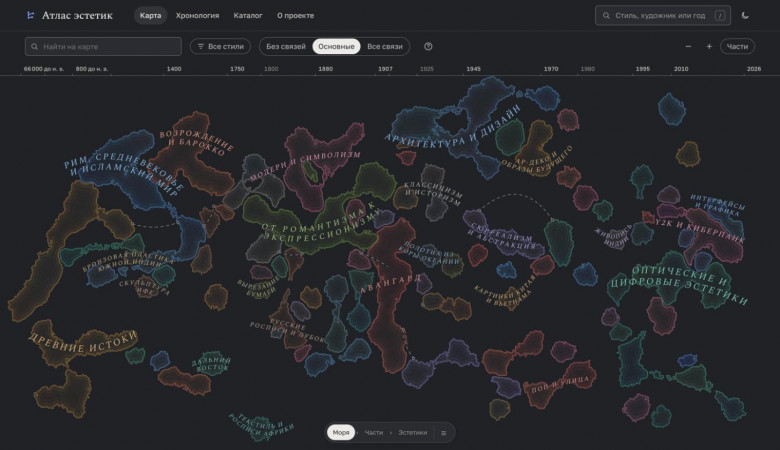
Художественного образования у меня нет. Поэтому я решил сделать себе карту: какие визуальные стили придумали люди, откуда они взялись и как связаны друг с другом. Получился Атлас эстетик.

Пройтись по атласу

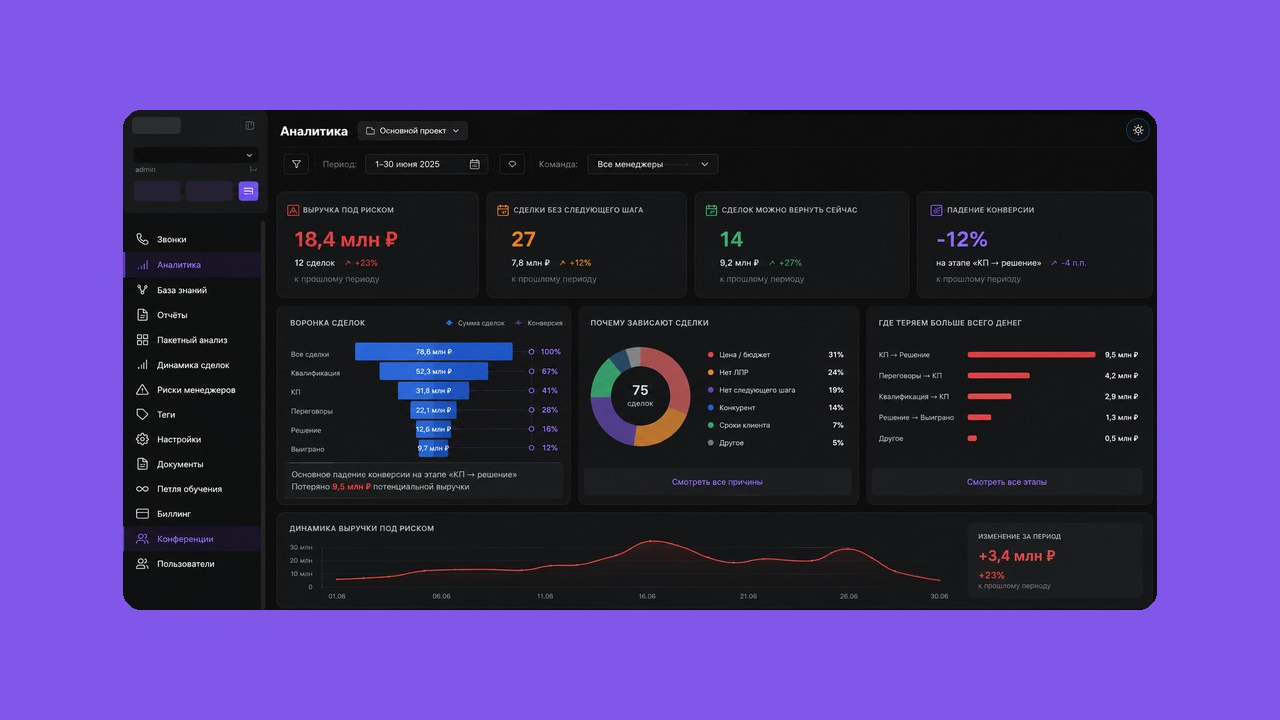
Токены, состояния и тепловая матрица. Как я раскладывал по экранам данные телефонного звонка

Время на прочтение11 мин
Охват и читатели4.9K

Я проектирую интерфейс сервиса, который разбирает записи звонков отдела продаж. Запись распознаётся, делится на реплики клиента и менеджера, проверяется по чек-листу, а результат уходит в CRM и на экраны руководителя. Модели и интеграции ведёт команда продукта, моя часть это проектирование и дизайн.

Здесь не будет про модели. Будет про то, как длинный неструктурированный результат обработки звонка превращается в экраны, которые читаются за минуту, и что происходит с дизайн-системой, когда её выгружают из Figma в CSS-переменные. Числа из макетов сняты через Plugin API, код токенов взят из выгрузки, данные на скриншотах демонстрационные или обезличенные.

Читать далее

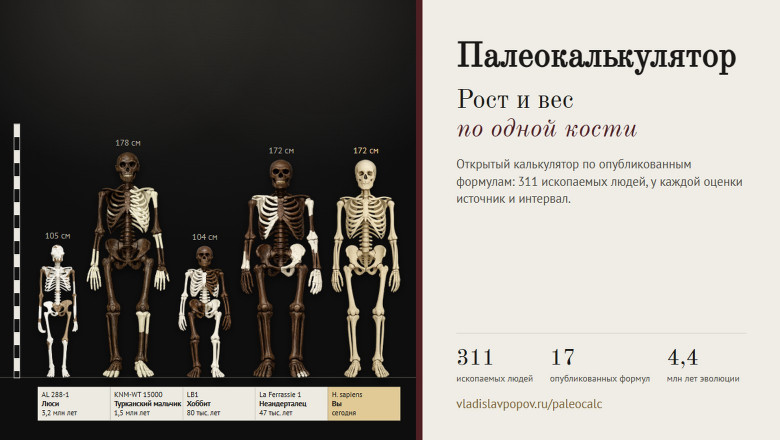
Рост и вес неандертальца по одной кости: я сделал открытый калькулятор по научным формулам

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели9.4K

Статья про то, как я калькулятор для антропологов по открытым данным сделал: внутри вы можете найти, на кого из древних людей вы больше всего похожи.

В июле 2026 года в PNAS вышла статья Кевина Хаталы и соавторов про следы на берегу древнего озера в северной Кении. Около 1,4 млн лет назад там прошли восемь парантропов вида Paranthropus boisei. От этого вида до сих пор находили в основном черепа с огромными челюстями и зубами, а ниже шеи почти ничего. По отпечаткам стоп авторы оценили рост до 1,8 м и массу около 75 кг. Это заметно больше, чем получалось раньше по редким костям.

Меня в этой новости зацепило не то, что парантропы оказались крупными, а сам вопрос: как вообще по следу, обломку бедра или куску таза узнают рост и вес существа, которое умерло миллион лет назад? Ответ скучнее и интереснее, чем кажется. Есть десятки опубликованных регрессионных формул, у каждой свой автор, своя выборка, своя ошибка. Я собрал главные из них в один открытый калькулятор и положил рядом базу из 311 ископаемых людей.

Читать далее

Что там вообще с квартирами и ипотекой? Большой разбор

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели11K

В далеком 2011 году квадратный метр в российской новостройке стоил в среднем 43,7 тыс. рублей, а к 2026 году стал стоить уже 215,3 тыс. рублей - это почти пятикратный рост за 15 лет.

И казалось бы, вывод очевиден: квартиры стали значительно менее доступными, а зарплаты отстали от цен, и примерно с этой мысли я и начинал исследование, но решил копнуть глубже и посмотреть, как за это время изменились зарплаты, сравнил средние цены с официальными индексами Росстата, разложил изменение доступности на составляющие и рассчитал ипотечную нагрузку по данным осени 2026 года.

И вот тут выяснилось, что история с доступностью жилья гораздо интереснее, чем кажется по первым двум цифрам.

Читать далее

Ближайшие события

Лучшие ИИ для визуализации данных 2026: нейросети для графиков, диаграмм, дашбордов и схем

Время на прочтение11 мин
Охват и читатели4.9K

Нейросеть построила график продаж и написала, что в конце сентября выручка упала. Но действительно ли покупатели стали заказывать меньше? Или выгрузка закончилась 28-го числа, а последнюю неделю сравнили с полной?

Убедительный график ещё не означает правильный расчёт. Возвраты могут попасть в продажи, товарные позиции — превратиться в отдельные заказы, а дубли — создать рекордную неделю. Поэтому при выборе нейросети для графиков меня интересует, можно ли проверить результат и повторить его на новых данных.

Читать далее

Когда получилось не просто форкнуть Grafana: история «Графини» от MVP до Enterprise

Время на прочтение10 мин
Охват и читатели11K

Привет, Хабр! С вами Павел Мирошин, архитектор продукта «Графиня».

Сегодня мы поговорим не про очередной релиз и не про список новых фич. В статье — личная история о том, как растёт продукт, когда у тебя нет большой команды разработчиков, архитектура не высечена в камне, а требования меняются быстрее, чем успеваешь закрывать задачи в Jira.

«Графиня» начиналась как небольшой MVP, который делала команда из трёх человек. Мы хотели получить аналог Grafana, но быстро поняли, что просто повторить чужой продукт — не наш путь. Пришлось самостоятельно решать вопросы архитектуры плагинов, динамических форм, расширения фронтенда, кэширования, ФСТЭК и, наконец, алертинга.
В дальнейшем какие-то первоначальные решения пришлось пересмотреть. И, конечно, были проблемы, которые мы создали себе сами.

Читать далее

Анализ результатов выполнения задачи № 3 в Хакатоне 2 026

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели5.5K

Содержание статьи

1. ИТ в настоящее время.

2. Знакомство с задачей № 3.

3. Предварительные результаты выполнения задачи № 3 участниками.

4. Модель, разработанная командой процессного аналитика.

5. Проведение анализа результата выполнения задачи № 3 участниками.

1. ИТ в настоящее время

Развитие информационных технологий в настоящее время предоставляет возможности для создания ИТ-продуктов не только ИТ-специалистами, но и людям, которые таковыми не являются. Можно предположить, что конечный ИТ-продукт у ИТ-специалистов и у не ИТ-специалистов будет отличаться.

Чем же могут отличаться ИТ-продукты, созданные ИТ-специалистами, от ИТ-продуктов, созданных не ИТ-специалистов, и как последние могут это сделать?

Будучи процессным аналитиком и консультантом по управлению, решил не практике это проверить путем участия в хакатоне 2026, проводимом под эгидой Московского правительства. Наша команда состояла из двух человек: процессного аналитика и молодого специалиста, специализирующегося на машинном обучении.

Конечно, соревноваться в программировании с ИТ-специалистами никоим образом не собирались, так как мы обладаем знаниями в разных сферах. Однако возможность создать ИТ-продукт, по крайней мере прототип модели, возможно, если использовать потенциал какого-либо ИИ-агента, которые можно найти в интернете свободно и которые предоставляются бесплатно. Хочется заметить, что ИТ-специалисты также их используют, чтобы ускорить разработку ИТ-продукта.

2.  Знакомство с задачей № 3

Итак, сначала из списка выбрали задачу № 3, которая называется «Интеллектуальный сервис планирования рабочих маршрутов для инженеров с учетом временных окон и сложности проводимых работ».

Читать далее

Из хаоса закладок — в галерею визуализаций: история создания DataDrops

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели6.5K

Если вы работаете с данными или просто любите графики и карты, то наверняка знаете то самое чувство. Увидели классную визуализацию, захотели сохранить, кинули в закладки или переслали себе в чат. А через пару недель она либо потерялась, либо вы уже не помните, зачем вообще её сохраняли.

У меня было ровно так же. Моя личная коллекция датавиза выглядела как хаос из закладок в браузере, сохранённых постов в LinkedIn и случайных ссылок в Notion Obsidian. Найти что-то конкретное спустя время было почти невозможно.

Поэтому в какой-то момент из всего этого хаоса появился DataDrops, мой небольшой пет-проект, который представляет собой галерею визуализаций данных. Это рассказ о его создании, а ещё о том, как я полтора года делал платформу, а потом за месяц почти полностью пересобрал её.

Читать далее

Множество Мандельброта — объемная картина? Выпуклая? И почему из 120 картин кажутся только две?

Уровень сложностиСредний
Время на прочтение26 мин
Охват и читатели6K

Это фрагмент множество Мандельброта и я его описал в википедии:
https://commons.wikimedia.org/wiki/File:Mandelbrot_Set_Image_118.png

А вот скажите... Кажется ли вам что объемная картина? Выпуклая? Особенно синий! А почему? Это же очень интересно! Говорят что да. Это мощный оптический эффект трехмерности на плоском рисунке. Наш мозг, привыкший считывать распределение света и тени в реальном мире, мгновенно интерпретирует эти плавные градиенты как трехмерный рельеф, хотя на самом деле мы смотрим на абсолютно плоскую двухмерную проекцию.

Читать далее

Возможности сводных таблиц в Superset

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели5.2K

С версии Superset 6.0 в метрики сводных таблиц можно подставлять произвольный HTML. Это открывает возможности, которые раньше казались недоступными — например, карточки KPI прямо в ячейках Pivot Table.

Я уже описывала различные фишки, которые можно реализовывать в сводных таблицах: здесь, здесь и здесь.

В данной статье продолжу раскрывать потенциал сводных таблиц.

Читать далее

От SQL‑запроса до результата — в одном окне. Обзор на dbt‑модуль в SubQuery

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели6.1K

Привет! Меня зовут Маргарита, я BI-архитектор в Далее. Моя задача — чтобы клиенты получали подготовленные данные в удобном для них виде. В этом мне помогает dbt (Data Build Tool).

Раньше мы использовали локальную версию dbt, а с прошлого года перешли на внутреннюю веб-платформу SubQuery. Теперь все задачи я делаю в одном окне, и на ту же работу уходит заметно меньше времени: по моим ощущениям, в 2-3 раза.

Возможно, этот обзор будет полезен коллегам, которые тоже работают с данными. Первое, к чему я быстро привыкла, — результат SQL-запроса модели dbt можно посмотреть сразу в превью. Не нужно отдельно открывать СУБД  и проверять данные на корректность выполненного SQL.

Читать далее
1
23 ...