У нашей небольшой финансовой компании из Петербурга есть маскот: рыжий вислоухий кот в пиджаке. За два месяца он появился на обложках статей на десятках площадок, в карточках Pinterest, обоях на телефон и в роликах. Рисует его генеративная модель gpt-image через API, людей-иллюстраторов в процессе нет.
Нарисовать красиво модель умеет. Сложнее сделать так, чтобы на сотой картинке это был тот же кот, что и на первой, и чтобы на картинке не было ничего, за что площадка снимет пост. Ниже то, что у нас сработало, и то, что ломается до сих пор.
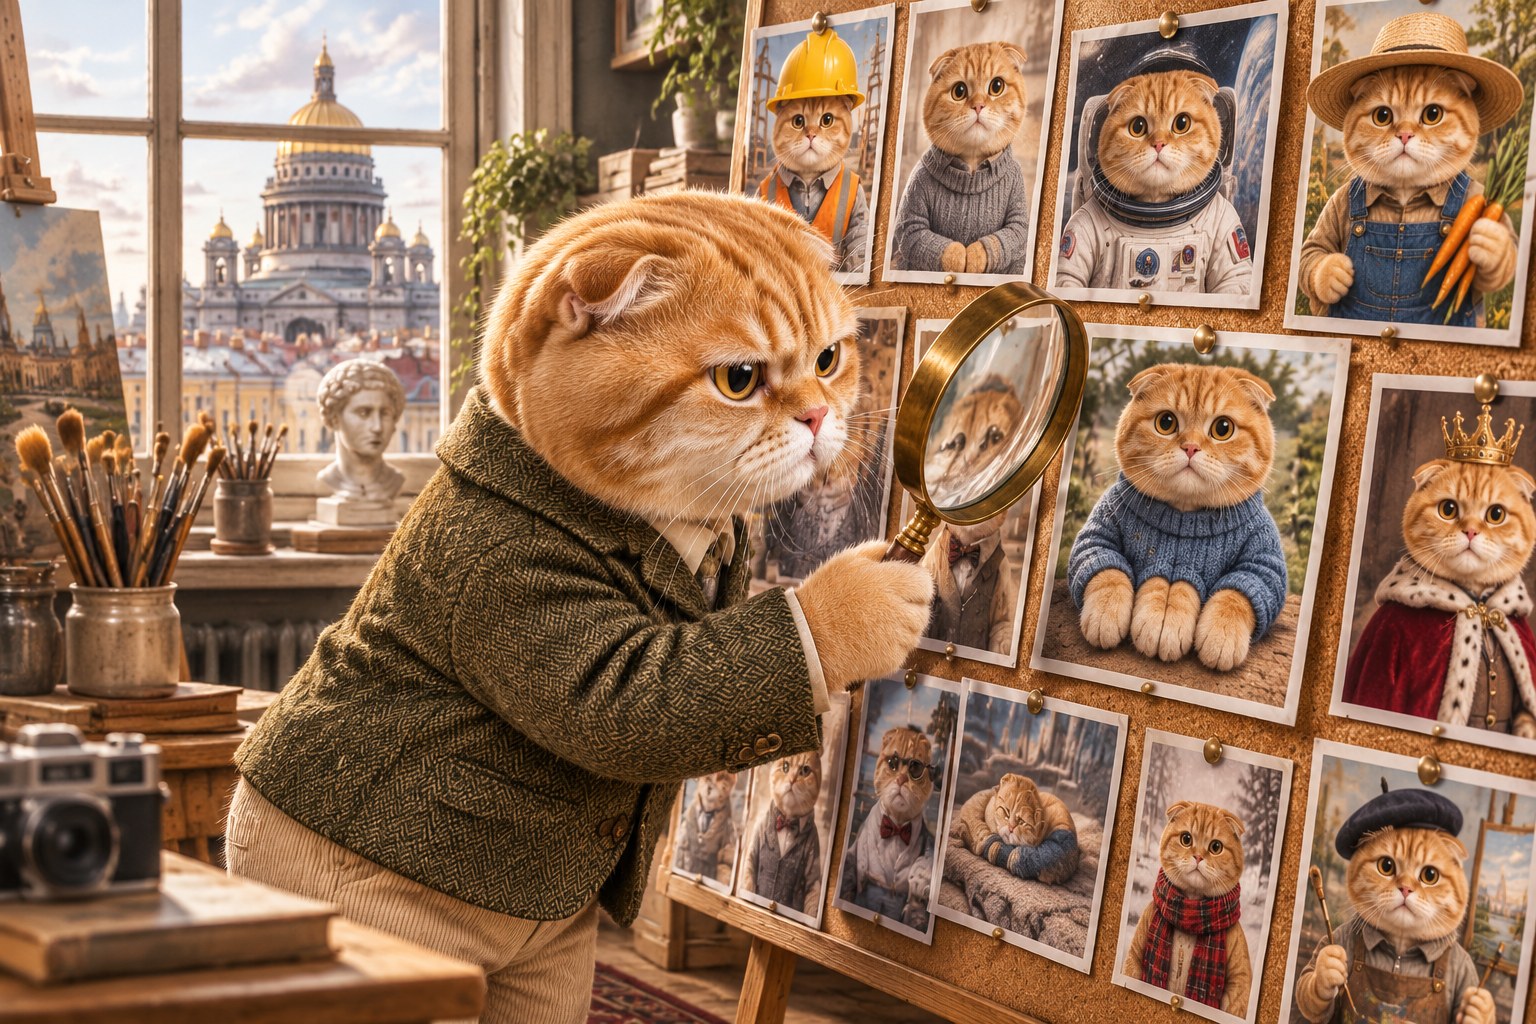
Якорь персонажа: один референс и короткое описание
Первое, что мы поняли: текстовое описание персонажа не держит его стабильным. «Рыжий вислоухий кот» каждый раз получается немного другим: меняется форма морды, оттенок, длина шерсти. Держит только референсное изображение, которое передаётся в каждый запрос.
Схема у нас такая:
один основной референс кота, который не меняется месяцами;
в промпте фраза вида «the same ginger Scottish Fold cat from the reference», а не повторное описание внешности;
одежда описывается отдельно и может меняться под сюжет: пиджак, свитер, каска, комбинезон. Морда и окрас при этом берутся с референса.
Шаблон промпта
Промпт собирается из одних и тех же блоков в одном порядке:
Стиль: «Photorealistic warm illustration» или «documentary-style photo», если площадка любит реализм.
Персонаж: тот же кот с референса и его одежда.
Действие: что кот делает лапами. Нам больше нравятся сцены, где он что-то держит или с чем-то борется, чем портреты, где он просто сидит.
Место: узнаваемая деталь города в окне. Купол Исаакиевского собора модель рисует уверенно.
Запреты: «no readable text, no letters, no logos».
{
  "id": "cover-divorce",
  "size": "1536x1024",
  "refs": ["refs/cat.png"],
  "p": "Photorealistic warm illustration. The same ginger Scottish Fold cat from the reference, wearing a green tweed jacket with no logo, sits between two halves of a toy house... Isaac's Cathedral dome in the window. No readable text, no letters, no logos."
}
Задания лежат в JSON, скрипт гоняет их параллельно и по два варианта на задание. Перед запуском скрипт сверяет цену модели за картинку с порогом и отказывается генерировать, если цена выше. Это защита от того, что у агрегатора внезапно сменится тариф, а мы запустим пачку из сорока картинок.
Что ломается: текст
Фраза «no text» работает плохо. На бумагах, экранах ноутбуков, календарях и вывесках модель всё равно рисует буквы, и это почти всегда абракадабра. На обложке такая абракадабра сразу выдаёт генерацию.
Помогает другое: описывать текст как нечитаемый. «Text unreadable, blurred», «abstract colorful code lines, unreadable», «chalkboard with drawings only». Модель охотнее рисует размытое пятно, чем вообще ничего.
Отдельная история с картинками, где текст нужен, например карточки-инфографики для Pinterest. Раньше мы собирали их в HTML: картинка сверху, текст снизу. Выглядело это как шаблон из конструктора. Сейчас модель верстает карточку целиком, сама пишет русский текст, а промпт требует воспроизвести его «строго дословно, без лишних слов и латиницы», каждый пункт в кавычках.
Результат лучше, но опечатки всё равно бывают: из реальных примеров «подтинуть» вместо «подтянуть» и «раз месяц» без предлога. Поэтому каждый вариант просматривается глазами, и если ошибки в обоих вариантах, задание перегенерируется. Короткий текст ошибается реже: мы держим 2-5 слов на пункт.
Что ломается: лапы, логотипы и чужие персонажи
Лишние конечности. Чем сложнее действие (кот держит телефон и одновременно подписывает документ), тем выше шанс получить третью лапу. Лечится упрощением сцены.
Логотипы реальных сервисов. Если в сцене есть «документы с госуслуг» или «банковское приложение», модель может нарисовать что-то похожее на настоящий логотип. Для нас это риск: картинка начинает выглядеть как реклама или подделка чужого бренда. Мы пишем «abstract banking app screen with a big green checkmark».
Сходство с известными персонажами. Рыжий кот в шляпе с пером и сапогах для картины на тему «Ночного дозора» получился слишком похожим на известного мультяшного кота в сапогах. Такую картинку мы выбросили. Теперь для сюжетов с «известными картинами» берём только работы в общественном достоянии и не даём персонажу атрибуты узнаваемых героев.
Значок в углу. Иногда в углу появляется маленькая метка. Мы её просто обрезаем при подготовке файла.
Правила площадок важнее красоты
Одна и та же картинка не подходит везде. За два месяца у нас сложился такой список:
Т-Ж: первое изображение становится обложкой, на нём не должно быть текста. Логотипов мы там тоже не ставим.
Клерк: обложка без логотипов и текста, размер 2048×1152.
Drive2: аудитория любит реализм, поэтому там фотореалистичные сцены с подписью «иллюстрация сгенерирована».
Pinterest: у сгенерированных пинов ставим отметку, что изображение изменено с помощью ИИ.
Пикабу и форумы банков: кот-маскот выглядит как реклама, поэтому там простые скетч-мемы в две панели без персонажа.
Обложка никогда не таблица и не инфографика. Таблица на первом экране выглядит как отчёт, её не хочется открывать. Инфографика только внутри текста.
Ещё одна деталь, о которой редко пишут: в файлах остаются метаданные о происхождении изображения (C2PA). Мы их не вычищаем и картинки за фото не выдаём.
Размеры
Под разные задачи держим три размера:
1536×1024 для обложек статей, дальше обрезаем под нужное соотношение;
1024×1536 (2:3) для пинов;
1088×1920 для обоев на телефон 9:16, верхнюю пятую часть кадра просим оставить спокойной, там будут часы.
Что показали цифры Pinterest
Самый неожиданный результат дал Pinterest. За первые 30 дней аккаунт набрал 1,84 тыс. показов, и почти все дали три развлекательных пина: бумажная кукла-кот (697 показов), одежда для неё (219) и раскраска (195). Финансовые инфографики, ради которых всё затевалось, набрали по 4-10 показов.
Вывод для себя мы сделали простой: персонаж собирает внимание там, где он интересен сам по себе. Финансовый совет с котом на картинке так и остаётся финансовым советом. Поэтому развлекательных картинок с котом стало больше, а финансовые темы остались в меньшинстве.
Чек-лист перед публикацией
Кот похож на референс: морда, окрас, уши.
Нет лишних лап и пальцев.
Нет читаемой абракадабры на мелких предметах.
Нет логотипов реальных компаний и сходства с известными персонажами.
Если на картинке есть текст, он совпадает с заданным дословно.
Картинка соответствует правилам конкретной площадки.
Генерация убрала из процесса иллюстратора, но не убрала редактора. Каждая картинка всё равно проходит человеческий взгляд, и регулярно находится что-то, что нельзя публиковать.
Если вы тоже ведёте персонажа на генерациях, интересно, как вы держите консистентность: референсами, дообучением или чем-то третьим?