У нас небольшое производство: вышивка, печать на одежде, сувенирка. Снимков цеха и готовых заказов накопилось около двухсот, они лежат в трёх папках на Яндекс.Диске и Google Drive. Этими кадрами я иллюстрирую статьи на открытых площадках, их уже больше трёхсот, и правило у меня простое: один и тот же снимок не должен дважды появиться на одной площадке. Читатель, который видит знакомую фотографию во второй статье подряд, перестаёт верить, что за текстом стоит живой цех.
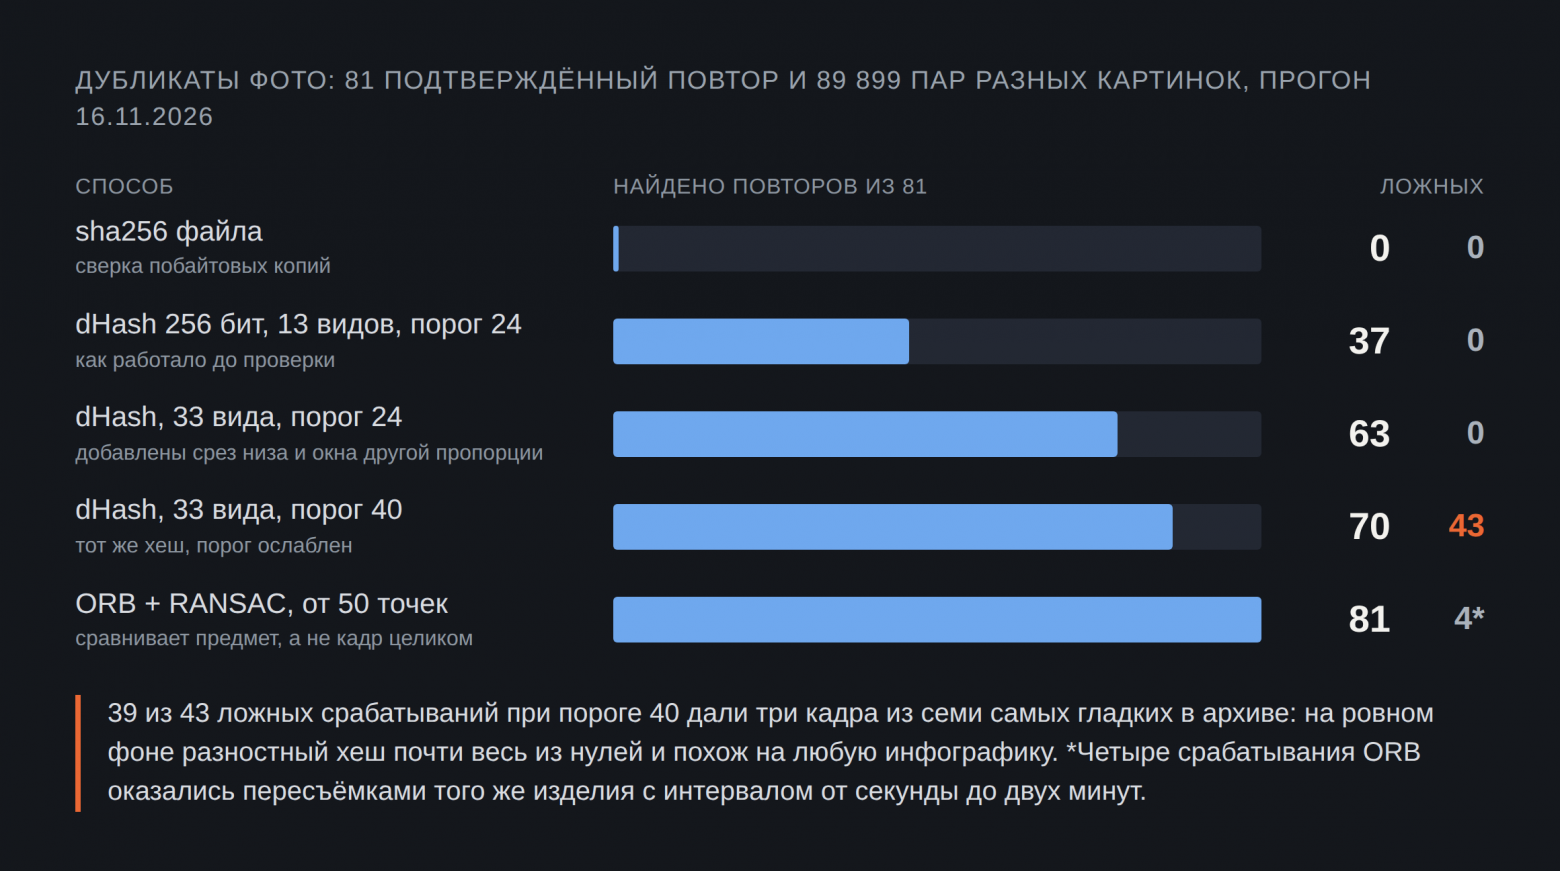
Следить за этим вручную давно невозможно, поэтому дубликаты фото ловит скрипт, и проверка у него идёт в две ступени. Сначала sha256 исходника сверяется с реестром использований, потом картинка-кандидат сравнивается по перцептивному хешу со всем, что уже стоит на площадке. Порог 24 стоит с тех пор, как проверку написали, и на настоящих повторах его никто не проверял. Готовые программы, которые умеют найти одинаковые фото на диске, мне не подходили: они ищут повторы внутри одной папки, а здесь снимок надо узнать в уже свёрстанной обложке, обрезанным и подписанным. В ноябре я наконец проверил эту связку на настоящих повторах, которые за три месяца прошли в статьи. Из 81 подтверждённого повтора хеш при рабочем пороге нашёл 37. Ниже код, данные прогона 16 ноября 2026 года, два способа поднять находимость и место, где перцептивный хеш ошибается так, что ослаблять порог нельзя.
Как устроен хеш, который я проверял
Это разностный хеш (dHash) на сетке 16×16, то есть 256 бит. Картинка переводится в оттенки серого и ужимается до 17×16 пикселей. Каждый бит отвечает на вопрос, светлее ли пиксель своего левого соседа:
def dhash(im: Image.Image, size: int = 16) -> np.ndarray:
    g = im.convert("L").resize((size + 1, size), Image.Resampling.BICUBIC)
    a = np.asarray(g, dtype=np.int16)
    return (a[:, 1:] > a[:, :-1]).reshape(-1)
Расстояние между двумя картинками считается по Хэммингу, это число несовпавших битов. Пересжатие JPEG и уменьшение такой хеш почти не задевают, а вот кроп его ломает: сдвиг рамки на пятую часть кадра даёт совсем другую сетку. Поэтому от каждой картинки берётся 13 «видов» (кадр целиком, восемь центральных кропов от 95 до 50 % и четыре кропа с отрезанным на 20 % краем), а расстоянием пары считается минимум по всем 169 сочетаниям видов:
def views_distance(va: np.ndarray, vb: np.ndarray) -> int:
    # va, vb: (13, 256) - хеши всех видов двух картинок
    return int((va[:, None, :] != vb[None, :, :]).sum(-1).min())
Пара с расстоянием до 24 включительно считается одним снимком. Чтобы не тратить время на полноразмерные фотографии по 4 000 пикселей, все картинки перед хешированием ужимаются до 320 пикселей по длинной стороне. На сетке 16×16 это ничего не меняет.
Откуда взялись положительные пары
Самое трудное в такой проверке это разметка. Повторы, которые я сам сделаю из снимка (пересжатие, кроп, поворот), покажут только то, как хеш держит мои собственные преобразования. Мне нужны были настоящие: исходник из архива и файл, который в итоге вышел в статье, со всем, что с ним сделали при вёрстке.
Такие пары можно собрать из реестра использований. С конца сентября каждый раз, когда кадр из архива ставится в статью, в таблицу пишется путь исходника, его sha256 и номер статьи. Собранный корпус выглядит так:
Что | Сколько |
|---|---|
файлов в архиве (159 на Яндекс.Диске, 35 в двух папках Drive) | 194 |
из них уникальных по sha256 | 180 |
картинок в статьях (обложки и картинки в тексте) | 804 |
строк реестра, уникальных по паре «исходник, статья» | 272 |
из них с исходником из архива | 81 |
Остальные 191 строка реестра ссылаются на кадры не из архива: свёрстанные графики, сгенерированные обложки, подборки, вырезанные из чужих папок. Их я в проверку не брал.
Реестр знает, какой снимок ушёл в статью, но не знает, в какой именно файл. Поэтому для каждого из 81 исходника скрипт берёт ближайший по хешу кадр той же статьи, а дальше все пары я просмотрел глазами. В 9 случаях снимка в статье не оказалось: кадр записали в реестр при подборе, а поставили другой. Остаются 72 настоящих повтора. К ним добавились 9 пар почти-копий внутри самого архива, о них чуть ниже. Итого 81 положительная пара, разметка лежит в labels_real_pairs.json.
Отрицательных пар две группы. Первая состоит из всех пар разных снимков архива, их 16 101. Вторую я поначалу не включил и чуть не пришёл к неверному выводу: это сочетания каждого снимка архива с каждой PNG-картинкой из текста статей (графики, таблицы, сгенерированные кадры), всего 73 800 пар. Я рассчитывал, что фотографий из архива среди PNG нет. Две пары оказались настоящими повторами: снимок кружек стоял в одной статье, пересохранённый в PNG, и заметил я это только по результатам ORB. Рабочий хеш давал этим парам 72 и 75, то есть повтор прошёл незамеченным. В реестре этого использования нет, поэтому в 81 положительную пару они не входят, а из отрицательных я их убрал, осталось 73 798.
Внутри архива всё чисто
Побайтовых копий в архиве 14 групп, папка «апдейт» на Drive частично повторяет основную. Среди 180 уникальных по sha256 файлов хеш нашёл ещё 9 пар. Восемь из них на расстоянии 0 или 1: тот же снимок, пересохранённый в другом размере или с другим качеством JPEG. Одна пара на расстоянии 15: это одна и та же карточка с логотипом в двух масштабах. Хеш кадра целиком даёт у неё 46, и находят её только кропы.
Следующая по близости пара стоит уже на расстоянии 64. Это две фотографии модели в одной позе и в кепках разного цвета, то есть самый трудный случай «похоже, но другое». Между 15 и 64 в архиве нет ни одной пары. Если бы проверка шла только по архиву, вывод был бы «порог 24 с запасом, можно не думать». Пары из статей рассказывают другую историю.
Что делают с кадром по дороге в статью
Из 72 повторов в статьях рабочий порог поймал 28. У остальных 44 расстояние от 37 до 106, и у 32 из них оно больше 64, то есть больше, чем у двух разных фотографий модели в кепках. По разметке причин две.
Плашка внизу, 21 случай. На части площадок я ставлю под фото чёрную полосу с подписью, примерно десятую часть высоты кадра. Для человека это тот же снимок. Для dHash нижние две строки сетки из 16 полностью меняются, а остальные сдвигаются, потому что кадр с плашкой пропорционально ужимается до 17×16. Центральные кропы тут не помогают: они режут кадр со всех сторон, а плашка остаётся внутри.
Кроп с другой пропорцией и заголовок поверх, 23 случая. Вертикальный снимок со склада превращается в горизонтальную обложку 16:9, из общего плана вырезают одну кружку, на обложку кладут заголовок крупным шрифтом. Виды из списка выше сохраняют пропорцию исходника, поэтому окно 16:9 из вертикального кадра в нём просто отсутствует.
Первая правка: ещё 20 видов
Обе причины видны в самом списке видов, поэтому лечатся тоже видами. Я добавил три среза снизу (6, 9 и 12 % высоты) и окна пяти пропорций в трёх положениях: у начала, по центру и у конца длинной стороны.
def extra_views(im: Image.Image) -> list[Image.Image]:
    w, h = im.size
    out = [im.crop((0, 0, w, int(h * (1 - f)))) for f in (0.06, 0.09, 0.12)]
    for ar in (1.0, 4 / 3, 3 / 2, 16 / 9, 3 / 4):          # ширина / высота окна
        ww, hh = (w, int(w / ar)) if w / h < ar else (int(h * ar), h)
        for pos in (0.0, 0.5, 1.0):
            l, t = int((w - ww) * pos), int((h - hh) * pos)
            out.append(im.crop((l, t, l + ww, t + hh)))
    return out
Видов стало 33, сочетаний на пару 1 089 вместо 169. На упакованных в uint64 битах и np.bitwise_count это всё равно миллисекунды. При том же пороге 24 хеш нашёл 63 повтора из 81 и не дал ни одного ложного срабатывания ни в одной из двух отрицательных групп. Плашка больше не проблема: нашлись все 21 случай. Из 23 кропов с заголовками нашлись только 5.
Напрашивается следующий шаг: поднять порог и добрать оставшиеся 18. Это и есть то место, где хеш врёт.
Почему гладкий кадр похож на всё подряд
При пороге 32 расширенный хеш находит 68 повторов и даёт 10 ложных срабатываний, при пороге 40 находит 70 и даёт 43. Ни одно из них не приходится на пару двух фотографий: все случаются, когда снимок сравнивается с инфографикой. И почти все приходятся на одни и те же кадры. Карточка с логотипом на чёрном фоне при пороге 40 «совпала» с 23 разными графиками и таблицами, тёмный размытый снимок вышивальной машины с девятью, вторая карточка с логотипом с семью.
Причина в самой формуле. Бит dHash равен единице, только если правый пиксель строго светлее левого. На ровном фоне соседние пиксели равны, и бит всегда ноль. Хеш гладкой картинки почти целиком состоит из нулей, а у свёрстанной инфографики со светлым или тёмным полем то же самое. Две почти нулевые строки из 256 бит близки по Хэммингу независимо от того, что изображено. Минимум по тысяче сочетаний видов только помогает найти такое окно: в каком-нибудь кропе обязательно окажется кусок ровного поля.
Гладкость кадра можно измерить прямо по хешу. Назовём бит «уверенным», если разница яркости соседей на уменьшенной картинке не меньше 6 из 255. В медианном снимке архива уверенных битов 62 %. У карточки с логотипом 18 %, у второй карточки 20 %, у размытого кадра машины 29 %. Все три входят в семёрку самых гладких кадров из 180, и на них приходятся 39 из 43 ложных срабатываний при пороге 40.
Первая мысль была сравнивать только уверенные биты и нормировать расстояние на их число. Я это проверил, и стало хуже: при пороге 24 такой хеш находит 69 повторов, но даёт 13 ложных срабатываний на инфографике, а при пороге 40 ложных уже 302, из них 34 между двумя фотографиями. Если у двух картинок общих уверенных битов мало, пересчёт на 256 раздувает случайное совпадение. Отсюда вывод: доля уверенных битов годится как признак «этому хешу не верь», а не как способ его починить.
Вторая ступень: сравнивать предмет, а не кадр
Оставшиеся 18 повторов это обложки, где снимок обрезан до детали или почти закрыт заголовком. Хеш по сетке здесь бессилен в принципе, потому что от кадра осталась малая часть, и нужен поиск похожих изображений по содержимому, а не по рамке. Зато сохранились сами объекты: вышивка, кружка, шов. Их можно сравнить по ключевым точкам. Я взял ORB из OpenCV, тест отношения Лоу и RANSAC с моделью подобия: кроп плюс масштаб это сдвиг, поворот и равномерное растяжение, полная гомография тут не нужна.
ORB = cv2.ORB_create(nfeatures=1500)
BF = cv2.BFMatcher(cv2.NORM_HAMMING)
def orb_inliers(fa, fb) -> int:
    (ka, da), (kb, db) = fa, fb                  # ключевые точки и дескрипторы
    if da is None or db is None or len(ka) < 8 or len(kb) < 8:
        return 0
    pairs = BF.knnMatch(da, db, k=2)
    good = [m for m, n in (p for p in pairs if len(p) == 2) if m.distance < 0.75 * n.distance]
    if len(good) < 8:
        return len(good)
    src = np.float32([ka[m.queryIdx].pt for m in good])
    dst = np.float32([kb[m.trainIdx].pt for m in good])
    _, mask = cv2.estimateAffinePartial2D(src, dst, method=cv2.RANSAC, ransacReprojThreshold=4.0)
    return int(mask.sum()) if mask is not None else 0
Признаки считаются один раз на картинку по копии в 640 пикселей. Результат:
Положительные (81) | Разные снимки архива (16 101) | Снимок и инфографика (73 798) | |
|---|---|---|---|
медиана точек | 496 | 3 | 3 |
минимум / максимум | минимум 56 | максимум 219 | максимум 43 |
от 50 точек | 81 | 4 | 0 |
Нашлись все 81 повтор, включая обложки, где от снимка осталась кружка с краю. На инфографике ORB не ошибся ни разу: ни одна пара «снимок и график» не набрала больше 43 точек.
Четыре срабатывания на разных снимках архива я пересмотрел, и ни одно из них не оказалось ошибкой в житейском смысле. Это пары кадров одного изделия, снятых с интервалом от секунды до двух минут: худи с принтом спереди и чуть сбоку (219 точек), надпись на чёрной ткани с двух ракурсов (90), спина толстовки с принтом на человеке и крупным планом (67), войлочные изделия с логотипом клиента (50). Плоский принт при повороте камеры остаётся плоским, и модель подобия легко его совмещает. ORB отвечает на вопрос «тот же ли предмет», а не «тот же ли кадр». Для моей задачи это скорее плюс: вторая фотография той же худи в соседней статье читается как повтор так же, как первая.
По времени связка выходит недорогой. Признаки ORB для 252 картинок посчитались за 10 секунд, сопоставление шло около 4 миллисекунд на пару. Проверка одного кандидата по всем 800 картинкам площадок занимает несколько секунд.
Что я переношу в рабочую проверку
Поиск дубликатов фото я перевожу на такую схему:
sha256 исходника против реестра, как раньше. Он ловит только повторный выбор того же файла, и это всё равно полезно, потому что работает мгновенно.
dHash по 33 видам, порог 24. Если доля уверенных битов у кандидата ниже 30 %, результат хеша не учитывается, решает следующий шаг.
ORB с RANSAC, от 50 совпавших точек считается повтором, причём повтором предмета, а не обязательно кадра.
На размеченных данных такая связка находит 81 повтор из 81. Ложными оказались только четыре пересъёмки, а их я и хотел бы видеть в отчёте.
Сколько повторов уже вышло
Последним шагом я прогнал связку по всему, что есть: 180 уникальных снимков архива против 804 картинок в статьях, 144 720 пар, 11 минут. Совпадений нашлось 159, из них 51 нашёл только ORB. Из 180 снимков в статьи вышли 73. Большинство, 34 снимка, использованы один раз, ещё 17 дважды, а самые ходовые (головка вышивальной машины над чёрным рисунком, игла с золотой нитью по кепке, DTF-принтер с листом плёнки) стоят в шести статьях каждый. Сам по себе это не нарушение: разные площадки читают разные люди.
Нарушение это повтор на одной площадке. Таких снимков нашлось шесть, и все шесть я проверил глазами: это действительно один кадр. В одном случае первая статья снята модерацией, и читатель повтора не увидит. Остаются пять повторов на четырёх площадках, все в опубликованных статьях. Прежний хеш, сравнивая картинки двух статей, поймал бы из них один, с расстоянием 0. У остальных четырёх расстояние от 57 до 96. Во всех четырёх снимок в двух статьях обрезан по-разному, а в одном к тому же стоит плашка.
Чего я не учёл
Разметку делал один человек, то есть я, и смотрел пары на небольших превью. Ошибиться в паре «тот же снимок или соседний кадр серии» на превью в 200 пикселей можно. Спорные пары я открывал в полном размере, но вторую разметку для сверки никто не делал.
Положительные пары взяты из реестра, а реестр завели 27 сентября и задним числом внесли туда статьи начиная с середины сентября. Всё, что ставилось раньше, в проверку не попало. Пороги 24 и 50 подобраны на этих же 81 парах, отдельной контрольной выборки нет, и на другом архиве они могут сдвинуться.
Зеркальное отражение и заметный поворот я не проверял: в статьях их не оказалось. dHash к отражению не устойчив вообще, ORB устойчив к повороту, но не к отражению. Если кто-то начнёт зеркалить кадры, нужен ещё один вид.
Разведку я делал в рабочем окружении с Pillow 12.3, а все итоговые числа посчитаны в отдельном, где стоит OpenCV и Pillow 13.0. При рабочем пороге оба окружения дали одно и то же: 28 находок из 72. Ещё одна мелочь на случай, если будете повторять на виртуальной машине: OpenBLAS внутри колеса opencv-python-headless определил процессор как Opteron и падал с Illegal instruction в estimateAffinePartial2D. Помогла переменная окружения OPENBLAS_CORETYPE=Haswell.
Архив снимков, реестр использований и картинки статей сняты 16 ноября 2026 года: 194 файла архива, 804 картинки в статьях, 277 строк реестра. Все числа в статье получены прогоном скриптов сравнения в тот же день.