Всем доброго времени суток. В данной статье я хочу рассказать, чем шардирование отличается от репликации, какие задачи решает каждый подход и почему шардирование не всегда является оптимальным решением на ранних этапах. Сразу предупрежу, что информация ориентирована на человека, который хочет узнать в общем о данных подходах, если понравится мой метод рассказа, можете перейти в мой телеграмм канал: https://t.me/backend_iznutri там в скором времени расскажу более глубоко о данных подходах.
Для разберемся, что означают данные термины:
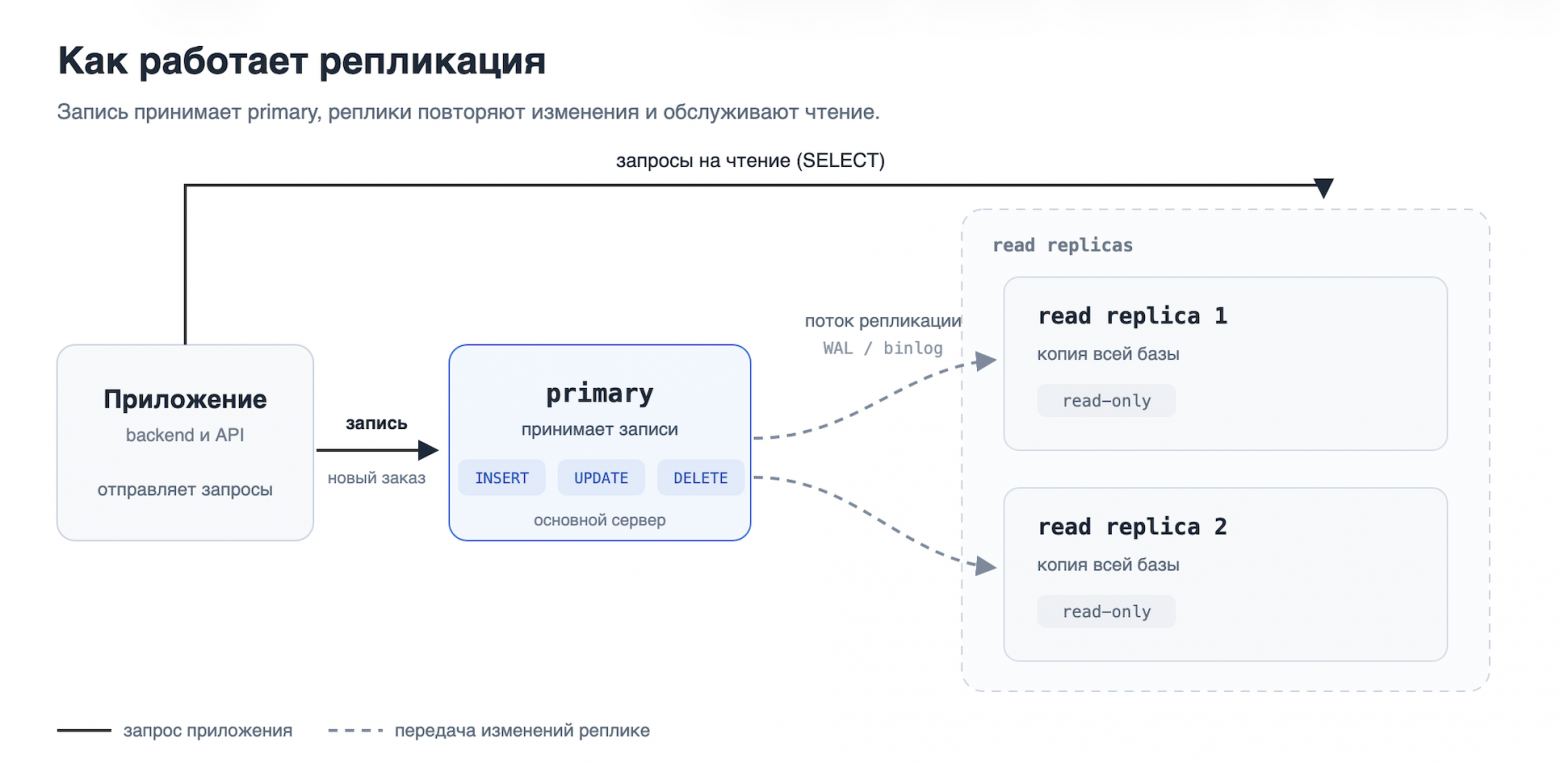
Репликация создаёт одну или несколько копий базы данных. Такие копии называют репликами. Они могут повышать доступность системы, резервировать данные и распределять нагрузку на чтение.
Шардирование не создаёт маленьких копий базы данных. Мы делим большую базу на шарды, и каждый шард хранит только часть общего набора данных.
Разницу данных подходов лучше увидеть на примере интернет-магазина:
При репликации обычно выбирается один основной сервер который называют primary(master). Он принимает операции записи: создание заказа, изменение цены товара, обновление данных пользователя. Рядом работают одна или несколько реплик, read replicas(также можете услышать определения slave). Они получают копии данных с primary и обслуживают запросы на чтение. Такая методика называется master-slave. Например, просмотр каталога товаров можно направлять на реплики, а создание нового заказа оставлять на primary. Так нагрузка на чтение распределяется между несколькими серверами, и основной сервер не обрабатывает все запросы один. При этом реплика не ограничена только простыми операциями: она может выполнять и сложные запросы, включая JOIN. Главное отличие в назначении запроса, primary обычно отвечает за запись, реплики за чтение. Данные не всегда появляются на реплике моментально. Между записью в primary и её появлением на read replica может пройти некоторое время. Это называется replication lag, задержка репликации. Представим ситуацию: пользователь оформил заказ, после чего сразу обновил страницу и открыл раздел со своими заказами. Если этот запрос попадёт на реплику, которая ещё не успела получить новые данные, пользователь временно не увидит только что созданный заказ. Поэтому разработчикам нужно учитывать, какие запросы можно отправлять на реплики. Например, каталог товаров можно читать с реплик, потому что небольшая задержка обычно не критична. А информацию о только что созданном заказе лучше некоторое время читать с primary.
Теперь перейдём к шардированию.
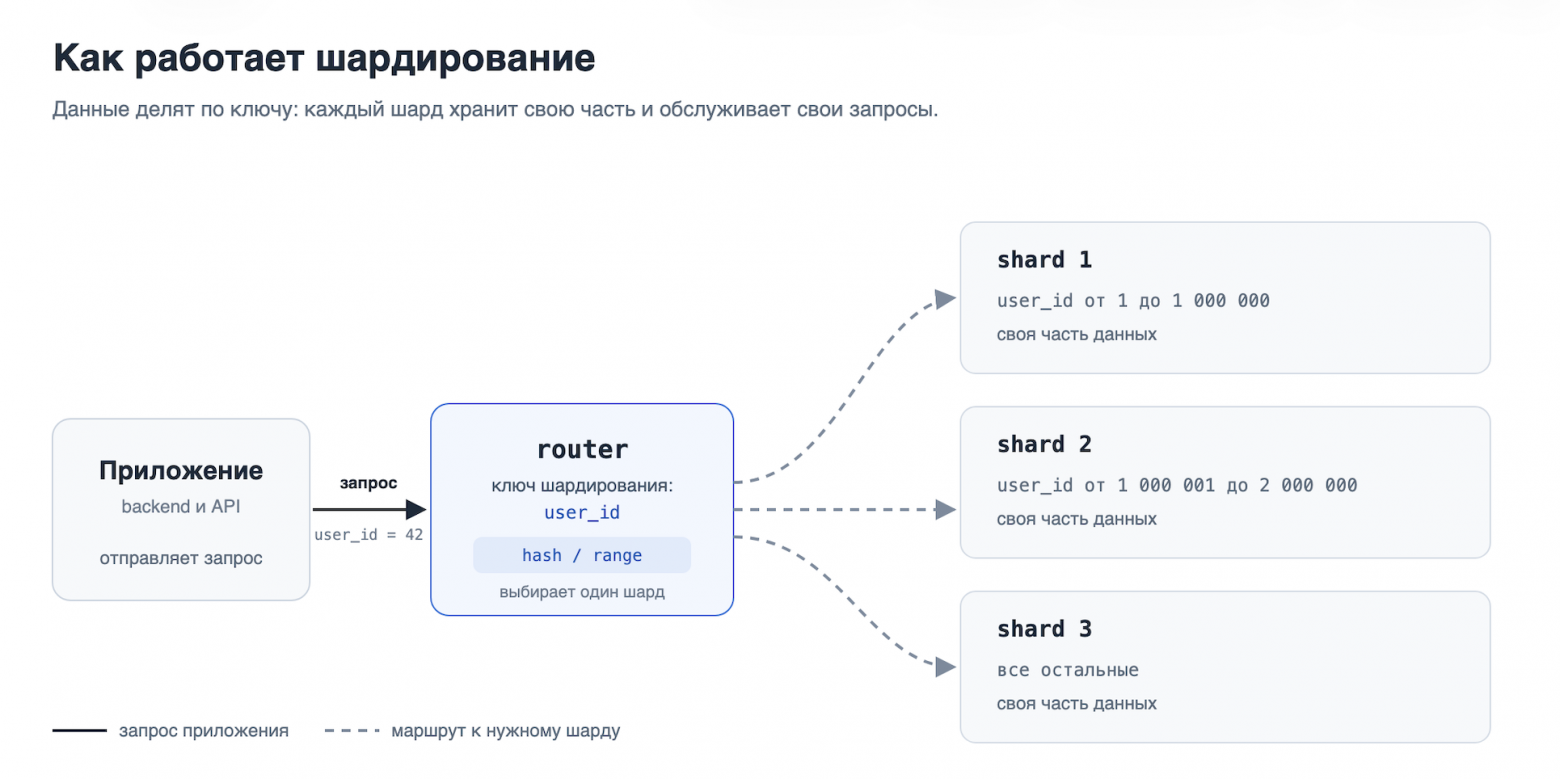
Представим, что наш интернет-магазин стал настолько большим, что все данные пользователей, товаров и заказов перестали помещаться на одном сервере. Кроме того, один сервер больше не справляется с количеством операций записи. В таком случае базу делят на несколько частей, шардов. Распределения между шардами происходит по разному, самый простой распределить пользователей с идентификаторами от 1 до 1 000 000 разместим на первом шарде, от 1 000 001 до 2 000 000 на втором, остальных на третьем. Теперь каждый шард хранит только часть пользователей и их данных. Когда приложение получает запрос, оно должно определить нужный шард и отправить запрос именно туда. В отличие от репликации, шарды не содержат одинаковые копии всей базы данных. Каждый из них хранит свой фрагмент общего набора данных. Поэтому шардирование распределяет между несколькими серверами и нагрузку на чтение, и объём данных, и операции записи.
Если выразить разницу совсем коротко:
При репликации мы создаём несколько копий одних и тех же данных;
При шардировании мы разделяем данные между несколькими серверами.
Оба подхода можно использовать одновременно. Например, каждый шард может иметь свой primary и несколько read replicas. Тогда шардирование распределяет данные и записи, а репликация повышает доступность каждого шарда и помогает обрабатывать чтение.
Почему шардирование не стоит добавлять слишком рано
На первый взгляд может показать, что шардирования очень универсальный подход мы просто делим базу на части и получаем больше производительности, но на практике выходит все намного сложнее и вот почему. Шардирование усложняет систему. Приложению теперь мало отправить запрос в базу данных. Сначала оно должно понять, на каком шарде находятся нужные данные, и только потом отправить запрос правильному серверу. Если пользователь ищет свой заказ по user_id, приложение легко определит нужный шард, но если заказ ищут по номеру, дате или статусу, а эти поля не входят в ключ шардирования, запрос нужно будет отправить на все шарды одновременно. Такой подход называется fan-out query. Каждый шард выполняет свою часть запроса, после чего приложение или специальный прокси собирает результаты, сортирует и возвращает пользователю. Чем больше шардов, тем дороже эта операция. Ещё одна проблема: транзакции между шардами. В обычной базе в одной транзакции можно изменить несколько связанных таблиц. После шардирования связанные данные могут оказаться на разных серверах. Заказ пользователя может лежать на одном шарде, а информация о его балансе на другом. Чтобы одновременно создать заказ и списать деньги, обычной локальной транзакции уже недостаточно. Приходится использовать распределённые транзакции, саги или проектировать процесс так, чтобы система могла работать с временно несогласованными данными. Также шардирование усложняет миграции. Со временем один из шардов может стать слишком большим или перегруженным. Тогда часть данных нужно перенести на другой шард без остановки приложения и потери новых записей. Отдельная проблема заключается в неравномерном распределении нагрузки. Если ключ шардирования выбран не совсем удачно, большая часть запросов может улететь на один шард - такой шард обычно называют горячим. Остальные серверы будут простаивать, а перегруженный шард станет узким местом.
Из-за всех этих особенностей шардирование обычно рассматривают как последний из основных вариантов масштабирования базы данных. Сначала стоит проверить более простые решения:
Оптимизировать запросы и добавить недостающие индексы;
Уменьшить объём данных, который обрабатывает один запрос;
Использовать кеширование;
Увеличить ресурсы сервера (вертикальное масштабирование);
Добавить read replicas, чтобы распределить нагрузку на чтение;
Вынести редко используемые или исторические данные в отдельное хранилище.
И только если этих способов недостаточно, а один сервер больше не справляется с объёмом данных или количеством операций записи, можно переходить к шардированию. Оно само по себе не плохое решение, но становится плохим, если добавлено слишком рано или без чёткого понимания того, как приложение будет находить данные, выполнять транзакции и перемещать данные между шардами.