Обновить
32K+

Микросервисы *

Микросервисная архитектура и все что с ней связано

13,5
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

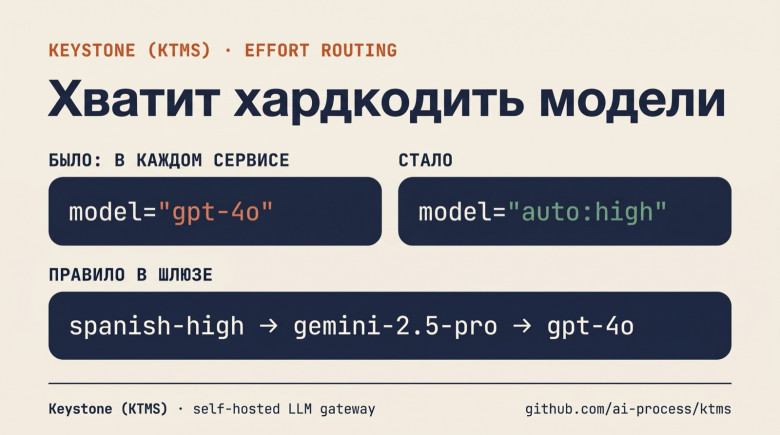
Как мы перестали хардкодить модели: effort-маршрутизация, авто-выбор сложности, фолбэки и лимиты расходов

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели3.2K

Самая дорогая строчка в микросервисе с LLM — model="gpt-4o". За ней тянутся свой ключ вендора, свои ретраи и счёт, который потом некому разобрать.

Расскажу об одной идее, которая это убирает: сервис не должен знать, какая модель ему отвечает. Вокруг неё четыре механизма: правила маршрутизации, автоматический выбор сложности, поведение при сбоях вендоров и контроль денег. Примеры — из нашего open-source шлюза Keystone (KTMS) на Go, но схему можно повторить в любом шлюзе.

Читать далее

Новости

Внедрение ИИ буксует не из-за модели, главный тормоз — интеграция

Время на прочтение17 мин
Охват и читатели4K

Меня зовут Виктор Овчинников, больше двадцати лет я занимаюсь обменом данными между корпоративными системами и сейчас руковожу разработкой интеграционной платформы.

Все эти годы интеграция оставалась скучной технической прослойкой, которую в бюджетах по привычке записывали в строку «поддержка». В 2026 году ситуация изменилась, и не потому, что шины вдруг стали красивее или моднее, а потому, что ИИ-проекты начали массово застревать именно в интеграционном слое.

Главный тормоз ИИ-проектов в крупных компаниях в 2026 году - это не выбор модели, не мощности GPU и не цена за токены. Это банальный обмен данными между корпоративными системами. В Connectivity Benchmark Report 2025 компании MuleSoft 95% ИТ-руководителей отметили, что интеграционные барьеры мешают внедрению ИИ. Отчет Anthropic «The 2026 State of AI Agents» фиксирует ту же картину с другого угла: среди инженеров, которые уже строят агентные системы на продакшене, 46% называют интеграцию с существующими корпоративными системами главным техническим вызовом - она обошла и вопросы безопасности с комплаенсом (40%), и качество самих данных (42%).

Читать далее

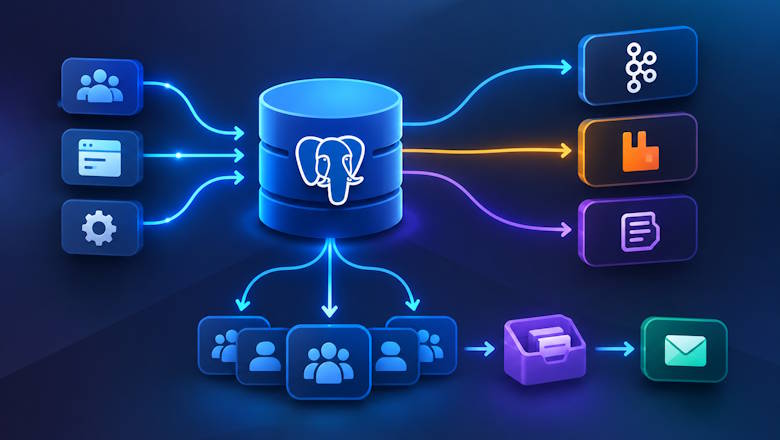
Очередь на Postgres: масштабирование, inbox и сравнение с Kafka и RabbitMq

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели5.2K

В прошлой статье я утверждал, что Kafka не нужна, если событие и результат бизнес-операции пишутся в PostgreSQL одной транзакцией. Только ленивый не написал Главное Возражение в комментариях: слот логической репликации не делится между читателями, каждый вычитывает журнал целиком — значит, читатели и станут узким местом.

Я решил проверить это утверждение. Сравнить сколько ресурсов потребляют консьюмеры очередей по сравнению сравнению с чтением логической репликации при увеличении их количества.

Это не вердикт по выбору транспорта: в конце будут условия, при которых брокер нужен, и они следуют из тех же цифр.

Читать далее

Два сервиса писали в один ключ Redis одно и то же. Это и было опасно

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели5.1K

Переводя сервис прогнозов на общий Redis, я увидел в чужой базе ключ current_occupancy_cache и обнаружил, что ровно такой же пишет мой сервис. Развёл по разным номерам баз. Сегодня полез проверять эту историю и выяснил две вещи. Во-первых, коллизия стала невозможна через два дня сама по себе: мультигородность добавила ключу суффикс :city, и ни в одном коммите той фичи сервис прогнозов не упоминается. Во-вторых, и это интереснее, на тот день обе записи были одинаковыми поле в поле. То есть затирание прошло бы совершенно корректно, без ошибки и без строчки в логе. Опасным оно стало бы четырьмя днями позже, когда в одну из записей добавили has_live_data, а на фронте стоит ?? true. Про то, почему совпадение данных это не свойство системы, а след копипасты, и почему разводить общие пространства имён надо до того, как данные разъехались.

Читать далее

Укрощение GPU в Kubernetes: динамический шеринг мощностей

Время на прочтение5 мин
Охват и читатели4.8K

Мы искали решение, которое позволило бы управлять ускорителями с той же степенью свободы, как мы привыкли работать с CPU или оперативной памятью.

Читать далее

Асимметрия модульного монолита

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели8.1K

Всем привет. Меня зовут Александр Кубит, я работаю архитектором, системным аналитиком и разработчиком в компании Promet System. Мы уже много лет занимаемся развитием и сопровождением довольно крупной ERP-системы по управлению заводами металлоконструкций. На данный момент наша кодовая база насчитывает порядка четырех миллионов строк кода.

Несколько лет наша команда состояла из двух-трех разработчиков, которым по наследству досталось огромное легаси. Предметная область сама по себе достаточно сложная: сотни сущностей, тысячи, если не десятки тысяч бизнес-правил, которые связывают различные части системы в единые процессы — проекты, справочники, производство, финансы, планирование, техническую документацию, заказы, поставки, складской учет и многое другое. Долгое время мы занимались в основном написанием нового функционала и доработкой существующего. Времени на архитектуру особенно то и не было. Но в какой-то момент пришло понимание, что дальше работать в таком ключе практически невозможно: система начинала яростно сопротивляться любым изменениям. Классическая анемичная модель, где половина логики в контроллерах, а половина в сервисах.

Читать далее

Микросервисы (async single-threaded) в эмбеддед и рефакторинг «кошмара на С++» с помощью ИИ

Уровень сложностиСложный
Время на прочтение10 мин
Охват и читатели10K

Я всегда знал, что разработка для встраиваемых систем (embedded) является не тривиальным делом, но даже не представлял, насколько С++ код в реальных enterprise-проектах может быть... скажем так, перегруженным. Тем интереснее попытаться исправить хотя бы кусочек такого кода, тем более что сегодня у нас есть прилежный цифровой помощник.

Справится ли искусственный интеллект с рефакторингом кода, от которого у обычного разработчика дёргается глаз? И в чём нейросети пока ещё безоговорочно уступают человеку? Заглядывайте под кат, там много боли, костылей, D-Bus и немного С++ и однопоточной асинхронности (async single-threaded).

Читать далее

С системой, которую нельзя менять, не интегрируются. Её можно только зеркалить

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели8K

Ты не владеешь источником — значит, не владеешь временем. Как поллер по updated_at молча теряет строки, почему exactly-once это свойство твоей записи, и почему сверка важнее потока.

Читать далее

Go 1.25 сам читает лимит CPU, а automaxprocs молча это выключает

Уровень сложностиСложный
Время на прочтение8 мин
Охват и читатели6K

Обновили Go до 1.25 и оставили привычный automaxprocs? Пустой импорт теперь может отключить встроенное управление GOMAXPROCS и изменить поведение сервиса под CPU‑квотой. Разбираемся, как новый рантайм работает с cgroup, откуда берётся разница на дробных лимитах и что проверить перед удалением старой зависимости.

Проверить GOMAXPROCS

Как мы разделили монолит на независимые операторы и сделали OperatorHUB в Nova

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели6.9K

Раньше инфраструктурные модули в Nova устанавливали с помощью YAML-манифестов. Например, чтобы развернуть в Kubernetes-кластере систему хранения данных Longhorn, администратор находил нужный манифест в документации и копировал его в Nova Console. Затем менял параметры под свой кластер, указывал названия нод и при необходимости применял патчи. Если что-то не работало, шёл обратно в документацию и искал пропущенное или неправильно заполненное поле.

За развёртывание инфраструктурных модулей в Nova Container Platform отвечал Apps Operator. В нём были собраны семь манифестов (Custom Resource) для разных сервисов, а сам Apps Operator подтягивался вместе с кластером, даже если заказчику требовалась только часть компонентов.

Со временем такой монолит перестал подходить и пользователям, и команде. Версии инфраструктурных компонентов были привязаны к релизам платформы. Для обновления одного из них заказчику приходилось обновлять весь кластер, а изменение даже одного модуля влекло за собой полное регрессионное тестирование Apps Operator. Изначально он не выглядел будущим монолитом. Манифесты компонентов хранились отдельно в Git внутри кластера, а для их доставки использовали FluxCD. Сам оператор задумывался как лёгкая обёртка над GitOps-системой, но со временем разросся. Этот опыт показал, что хранение манифестов за пределами оператора само по себе не защищает его от превращения в монолит.

Привет, Хабр! Меня зовут Никита Лось, я — системный аналитик Nova Container Platform в компании Orion soft. В статье я расскажу, почему мы взяли за основу OperatorHUB из проекта Operator Framework, что пришлось изменить под Nova и как переносили работающие кластеры с монолитного Apps Operator на набор независимых операторов.

Читать далее

Код-ревью самому себе через год: 8 архитектурных ошибок соло-проекта

Уровень сложностиСредний
Время на прочтение18 мин
Охват и читатели5.4K

Через год после закрытия соло-проекта (React, 3×NestJS, PostgreSQL, Socket.IO, Kubernetes в GKE) я устроил себе код-ревью и нашёл 8 ошибок, которые всплыли бы при первом росте трафика: двойное списание баланса, сообщения, теряющиеся между pod'ами, чужой чат по UUID, деплой, который нельзя откатить. Почти все жили не внутри технологий, а на стыках. Разбираю каждую с кодом и исправлением.

Читать разбор 8 ошибок

429 — это не про скорость. Это про бюджет, которого ты не видишь

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.4K

Рейт-лимит — это не ограничение скорости. Это бюджет, и тратишь его не ты один. Разбор на Telegram Bot API, Redis и одном наивном планировщике 2023 года.

Читать далее

Как на Python описать архитектуру сервисов и превратить её в код

Уровень сложностиПростой
Время на прочтение16 мин
Охват и читатели9.2K

Можно ли описать архитектуру на Python, а получить работающий каркас сервиса на Go, C++, Rust или TypeScript? Причём так, чтобы схема не становилась отдельной документацией, которую все забывают обновлять.

В статье покажу, как из одного описания получить граф и код, зачем нужны разные уровни детализации и как попробовать новую логику рядом с работающей.

Читать далее

Ближайшие события

Мой первый outbox

Уровень сложностиПростой
Время на прочтение13 мин
Охват и читатели7.5K

Привет! Меня зовут Серёжа. Я работаю Java‑разработчиком. В этой статье хочу поделиться своим первым опытом реализации паттерна «outbox».

Решил я это сделать по нескольким причинам:

1. Зафиксировать для себя «на бумаге» архитектурное решение и полученный опыт.

2. Поделиться знаниями и идеями с теми разработчиками, кому только предстоит впервые выполнить похожую задачу.

3. Получить от профессионалов комментарии и замечания по улучшению моего решения.

Итак, давайте начнём!

Посмотреть на реализацию

Kafka гарантирует порядок? Разбираем 3 инцидента с Outbox

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели5.4K

Один ключ на все события заказа — и кажется, что порядок гарантирован. А потом клиенту приходит «Ваш заказ собран» раньше, чем «Оплата получена», витрина откатывает статус назад, а после планового перезапуска одно событие пропадает навсегда.

В статье разбираем три таких инцидента из одной системы на transactional outbox, PostgreSQL и Kafka 4.2. Попробуйте сами определить, где сломалось: в источнике, в relay, в продюсере или у потребителя.

Читать далее

Почему мы не стали делать еще одну большую СЭД

Время на прочтение6 мин
Охват и читатели4.9K

Российский рынок систем электронного документооборота сформировался давно и сегодня остается одним из наиболее зрелых сегментов корпоративного ПО. Крупные решения закрывают десятки сценариев — от регистрации и согласования документов до специализированных процессов, которые отличаются в зависимости от отрасли, масштаба бизнеса и внутренних регламентов компании.

Такая функциональная насыщенность стала естественным результатом развития рынка. Однако вместе с возможностями росла и сложность систем: увеличивалось число настроек, интерфейсов и сценариев работы, а внедрение СЭД все чаще превращалось в отдельный ИТ‑проект, требующий настройки, интеграции и обучения пользователей.

Мы в «Диасофт» считаем, что следующий этап развития СЭД может быть связан не с дальнейшим расширением функциональности, а с изменением самого подхода к архитектуре. Вместо еще одной крупной системы, которая существует рядом с ERP, CRM и другими корпоративными платформами, функции работы с документами могут стать частью уже существующих бизнес‑процессов.

Читать далее

Не начинать с LangChain: как спроектировать корпоративную GenAI платформу до реализации

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели7.4K

Корпоративную GenAI платформу легко начать с выбора LLM, LangChain, vector database или Kubernetes. Но до этого полезнее ответить на другие вопросы: кто имеет доступ к данным, где проходит security boundary, какие компоненты действительно нужно разделять и что должно войти в первую версию.

В статье разберу, как спроектировать корпоративную GenAI платформу до начала реализации: требования и NFR, C4, Modular Monolith, разделение.NET и Python, PostgreSQL + pgvector, RabbitMQ, LLM Gateway, ADR и границы MVP.

Читать далее

Retry policy на практике: подводные камни внедрения

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели7.8K

Что делать, если произошла ошибка? Житейская мудрость говорит, что можно попробовать еще раз. 

В контексте разработки ПО существует известный и простой паттерн для повышения отказоустойчивости — retry.

Реализация ретраев в Java-приложениях придумана давно. Как вариант — достаточно добавить в код стандартные аннотации. Но внедрить ретраи — это не так просто, как кажется: нужно решить еще много вопросов — например, как сохранить согласованность данных, как подружить ретраи на разных уровнях архитектуры, а еще учесть особенности разных технологий. И наконец, как при этом не навредить проекту.

Привет! Меня зовут Петр Деменев, я Java-разработчик в MTC Web Services. В материале расскажу о нашем горьком, но успешном опыте внедрения политики ретраев в реальный проект и о неочевидных особенностях, с которыми мы столкнулись. В тексте будет акцент не на строгих теоретических канонах, а на реальной жизни, чтобы приземлиться на уровень практического опыта. И попутно расскажу о некоторых способах ретрая.

Читать далее

Рулим в облака: деплой микросервиса генерации ID в Kubernetes

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели9.4K

Привет, Хабр! Продолжаю серию статей по проектированию и разработке отказоустойчивой микросервисной системы сокращения ссылок.

Если вы только присоединились, рекомендую ознакомиться с предыдущими частями:

Читать далее

Заказ снаружи, десятки систем внутри. Как менялся IT‑ландшафт «Петровича»

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели6.1K

Привет! Это Дима Левин, я работаю системным аналитиком в «Петрович‑Тех». В прошлой раз я рассказывал о процессе обезличивания персональных данных. В этой статье я попытаюсь рассказать историю роста и развития IT‑ландшафта компании «Петрович».

Это история о том, как IT‑ландшафт «Петровича» вырос из одной системы в десятки специализированных и теперь движется к единой платформе. А заодно разберемся, чем занимается «Петрович‑Тех» и почему его работу можно сравнить со строительством.

Читать далее
1
23 ...