Не гадать, а измерить
Каждый, кто хоть раз давал кодинг-агенту задачу, поймет о чем речь. Хочется передать ему побольше: техническое задание, документацию на внешний API, правила команды, примеры готового кода. «На всякий случай добавлю ещё и это» — пожалуй, одно из самых распространённых действий.
С инженерной точки зрения это анти-подход. Окно контекста конечно и лишняя информация не просто занимает место, она размывает внимание модели. Кроме этого, пересказ уже известных агенту данных почти никогда не даёт прироста качества. И тут возникает вопрос: как понять, какая часть контекста реально помогает в решении задачи, а какая является просто шумом?
Я вместе с Дуэйд (doaid) постарался найти ответ на этот вопрос экспериментальным путем. Для эксперимента нашему кодинг-агенту ставилась реальная инженерная задача — разработка сервиса текстового поиска на Rust. А далее я добавлял контекст порциями, фиксируя, как каждая из них меняет план работы.
Предлагаю посмотреть, что из этого вышло. Спойлер: оказалось, что на результат влияет не количество переданного контекста, а его роль. Одни данные определяют архитектуру решения и меняют весь дальнейший ход работы, другие остаются практически незамеченными.
Как был устроен эксперимент
Идея очень простая. Вместо того чтобы скармливать агенту всё сразу и смотреть на результат, я добавлял информацию порциями и смотрел, как каждая меняет план.
Порядок действий:
Составляю обычное техническое задание (ТЗ) на разработку.
Кладу ТЗ в папку проекта, чтобы оно стало частью окружения агента, а не пересказывалось в переписке.
Прошу агента подготовить план реализации ТЗ.
Начинаю постепенно подкармливать агента контекстом: сообщения, файлы, репозитории, документация, правила.
После каждой порции прошу агента предложить изменения к плану и оценить влияние этой порции по заранее заданной шкале.
Ключевой ход — не оценивать качество итогового кода, а фиксировать влияние на промежуточный результат, которым служит план. План в этом эксперименте становится своего рода индикатором реакции модели: он меняется быстрее, чем сам код, и позволяет увидеть, какие сведения действительно повлияли на ход рассуждений агента, а какие остались без внимания.
Четыре файла, четыре роли
Чтобы измерение было воспроизводимым, в папке проекта заведены четыре файла. У каждого своя задача:
readme.md — всё о проекте;
plan.md — сам план реализации (тот самый индикатор);
logqa.md — журнал запросов пользователя и финальных ответов агента, здесь фиксируется каждый шаг;
influence.md — журнал оценок влияния каждой порции контекста.
Разделение грает важную роль. logqa.md — это «сырая история»: что спросили, что ответили. influence.md — это «интерпретация»: во сколько баллов обошёлся каждый шаг. Первый отвечает на вопрос «что происходило», второй — «насколько это было существенно».
Шкала влияния: от «ничего» до «нужен человек»
Центральным элементом эксперимента я сделал пятибалльную шкалу. Её формулировку постарался проработать так, чтобы оценка не превращалась в произвольное суждение, но при этом оставалась достаточно универсальной для применения к самым разным порциям контекста.
Балл | Значение |
1 | Ничего не нужно менять в плане |
2 | Нужны косметические изменения, возможно переименование сущностей |
3 | Нужны изменения в плане, небольшие по объёму, новых разделов плана не появляется |
4 | Нужны серьёзные изменения в плане, появляются новые разделы плана |
5 | Нужны серьёзные изменения в плане, появляются новые разделы плана и альтернативные пути реализации |
Верхняя ступень является здесь самой интересной. Балл 5 — это не просто «много нового». Это качественно иная ситуация. При балле 5 план не только растёт, но и разветвляется: появляются варианты, выбрать между которыми агент не может, ему для этого нужен человек. Именно на этой ступени инженерия контекста сталкивается с ограничениями: есть решения, которые нельзя делегировать модели, потому что они требуют знания договорённостей команды, политик безопасности или внешних ограничений.
Хронология: 24 шага, 24 оценки
Прежде чем делать выводы, посмотрим на весь эксперимент целиком. Ниже дана сводная таблица: какая порция контекста была подана, какой балл она получила и что именно изменилось в плане. В ней заметна и естественная разбивка на две большие фазы. Первая — планирование (шаги 1–14), когда план только строился и перестраивался. Вторая — исполнение (шаги 15–24), когда план уже принят, началась реализация, а контекст свёлся к серии контрольных аудитов кода.
Этап | Балл | Что изменилось в плане |
1. Заготовки файлов (readme/plan/logqa/influence) | 2 | Косметика: добавлены разделы «Статус» и «Структура файлов». Направление плана не менялось |
2. «Сервис на Rust, оформи plan.md» | 4 | Закрыт выбор стека (Rust: axum/tokio/reqwest/toml). План из «черновика» стал исполнительным: появились разделы «Контракт HTTP+JSON», «Архитектура», «Модули и ответственность», «Тестирование», «Порядок реализации» |
3. Документация Yandex Search API v2 | 4 | Уточнён целевой API (это v2 / WebSearchService, а не старый «Яндекс.XML»). Новые разделы: соответствие параметров ТЗ и API, логика sync/async через Operation с фолбэком, декодирование rawData (Base64 → XML), лимит в 250 результатов. Стек дополнен quick-xml/base64 |
4. Правила разработки компании | 5 | Новые разделы (наблюдаемость, деплой, модель репозиториев, тесты) и альтернативные пути: REST/JSON vs gRPC/proto, точные имена репозиториев, нужны ли сразу helm/k8s/proto, способ доставки логов в OpenSearch. Всё это решает только пользователь |
5. Уточнения: gRPC/proto, имена, репо сразу, логи в stdout | 4 | Закрыты развилки из шага 4. Контракт — gRPC/proto (сервис WebSearcher, становятся tonic/prost), добавлен шаг 0 «Определить прото-контракт», зафиксированы имена репозиториев |
6. Изучение примеров компании | 5 | Отказ от ручного стека наблюдаемости в пользу внутреннего фреймворка redup-servicekit; proto как git-сабмодуль + build.rs; конфиг YAML; новый блок «Деплой/CI» (Dockerfile, Jenkinsfile, helm, k8s); дашборды-как-CRD. Несколько альтернативных путей |
7. «Использовать redup-servicekit; изучить servicekit и helm» | 4 | Подтверждён выбор фреймворка (закрыта развилка «ручной стек»). Новые разделы «Внутренний фреймворк redup-servicekit» и «Базовый helm-чарт redup.helm» с деталями конфига, слоёв, роутера метрик/health, узлов чарта |
8. «Как оформить источник/версию redup-servicekit?» | 1 | Ничего в сути плана. Добавлен только пояснительный раздел «Ключевая зависимость — как в примере» (crates.io, semver 0.4.0). Это документация, а не изменение плана |
9. «Что ещё осталось решить?» | 1 | Ничего не меняется — это запрос на перечень оставшихся решений (XML-ответ, схема proto, инфраструктура, параметры по умолчанию). Уточняется наполнение шагов, а не структура плана |
10. Живой запрос к Yandex endpoint | 3 | Уточнён раздел про API: найден endpoint /v2/web/search и авторизация Api-Key, раскрыта реальная XML-структура. Закрыты два «Открытых вопроса». Новых разделов реализации не появилось |
11. Изучить sre.jenkins.library.groovy | 4 | Новый раздел «Jenkins Shared Library» (изучено): таблица параметров, описание пайплайнов. Закрыты инфраструктурные открытые вопросы, уточнены шаги 11–13 (вызов готовых пайплайнов). |
12. Репозитории очищены; k8s = redup.k8s.websearch | 3 | Зафиксированы имена/ветки репозиториев-заготовок и namespace websearch. Новый пояснительный раздел «Вводная по папкам-репозиториям»; переименованы k8s-ссылки. Направление не менялось |
13. Уточнение всех открытых вопросов | 4 | Закрыты «Открытые вопросы» 1–13. proto переименован в пакет redup.websearcher.v1, переработан конфиг (base_url, search_type, api_key), lang в v1 не маппится в search_type |
14. «Выполняй plan.md» | 4 | Начато исполнение: реализованы шаги 0–15 (proto, Rust-сервис, тесты, Dockerfile, Jenkinsfile, helm, k8s). Это исполнение плана, а не его перестройка; появились новые файлы |
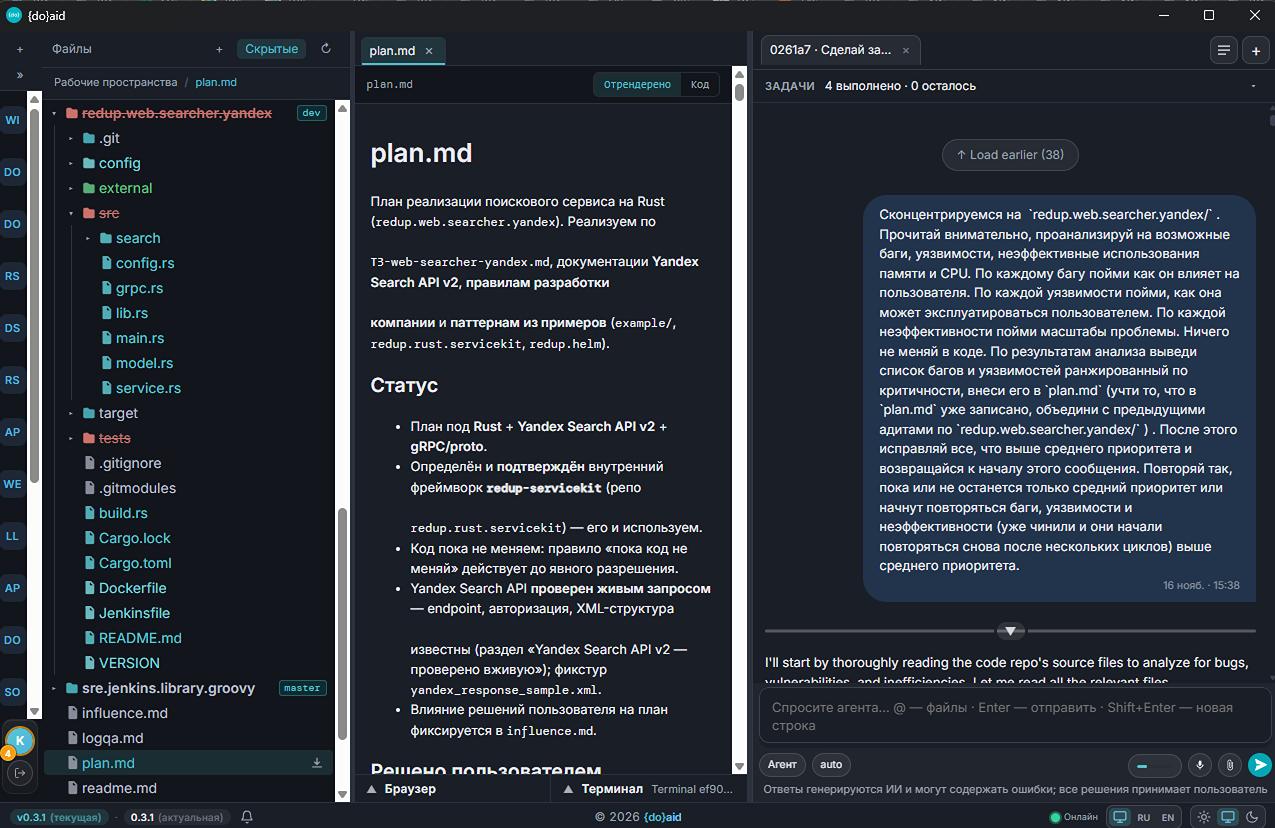
15. Аудит «выше среднего» | 4 | Новый раздел «Аудит redup.web.searcher.yandex». Найден критичный баг: sync_url() навешивал /search на уже полный endpoint → 404, из-за чего режим sync не работал. Исправлены п.1–3 (корректный URL, HTTP-таймауты, эмуляция async) |
16. Аудит (цикл 2) | 3 | Подраздел «цикл 2». Новых выше-среднего нет; +2 средних: #10 (async_timeout_ms не соблюдается из-за eager-эмуляции), #11 (мёртвое удаление id). Код не менялся |
17. Аудит (цикл 3, порог «выше нижнего») | 4 | Порог исправления опущен: пофикшены все средние #6/#7/#8/#10/#11. Остались только нижние. Появились изменения в коде, новых разделов/альтернатив нет |
18. Аудит (цикл 4, контрольный) | 1 | Ничего в сути плана. Контрольный аудит подтвердил: исправления работают, регрессий нет. Добавлен только подраздел «цикл 4» (документация) |
19. Аудит (цикл 5, контрольный) | 1 | Ничего. Подтверждение, что все исправления на месте; добавлен подраздел «цикл 5» |
20. Аудит (цикл 6, исправить всё оставшееся) | 2 | Закрыты последние нижние #4 (сбор текста по флагам in_url/in_title) и #5 (клоны в body()). «Осталось исправлять нечего». Суть плана не изменилась |
21. Аудит (циклы 7–8) | 3 | +2 новых пункта после переписывания yandex.rs: #12 (неограниченный рост async_results → добавлен кап 1024) и #13 (аллокации на тег). Остались низкие #14/#15 |
22. Аудит (цикл 9) | 2 | Закрыты микро-пункты #15 (заимствующая Serialize-структура) и #14 (осознанно оставленный fetch_add). Осталось исправлять нечего |
23. Аудит (циклы 10–11) | 2 | +2 новых: #16 (валидация api_key/base_url на границе, fail-fast) и #17 (лимит размера ответа 16 MiB). Остался микро #18 |
24. Аудит (цикл 12, контрольный) | 1 | Ничего. Контрольный аудит: существенных недостатков выше нижнего приоритета нет, регрессий нет. Добавлен только подраздел «цикл 12» |
Уже при беглом взгляде видно: баллы распределились не случайным образом. Они группируются по типу поданной информации. Разберём две крайности — максимум и минимум.
Что сильнее всего меняет план: балл 5
Высший балл 5 получили две порции контекста, и оба случая показательны.
Шаг 4 — правила разработки компании. Когда в контекст попали корпоративные правила, план не просто «вырос» — он развился. Появились новые крупные разделы: наблюдаемость (логи по уровням, OpenSearch, обязательные метрики, Grafana), деплой (helm с дефолтами, k8s с переопределениями), модель репозиториев, требования к тестам.
Но важнее не объём, не количество новых пунктов: обнаружились развилки, которые агент не может закрыть сам. Какой внутренний контракт — REST/JSON или gRPC/proto? Как точно назвать репозитории? Нужны ли сразу helm/k8s/proto-репозитории? Как доставлять логи в OpenSearch — через сид-кар или через сборщик? Ответы на эти вопросы — не про код, а про договорённости команды. Это и есть суть балла 5: появляются решения, доступные только человеку.
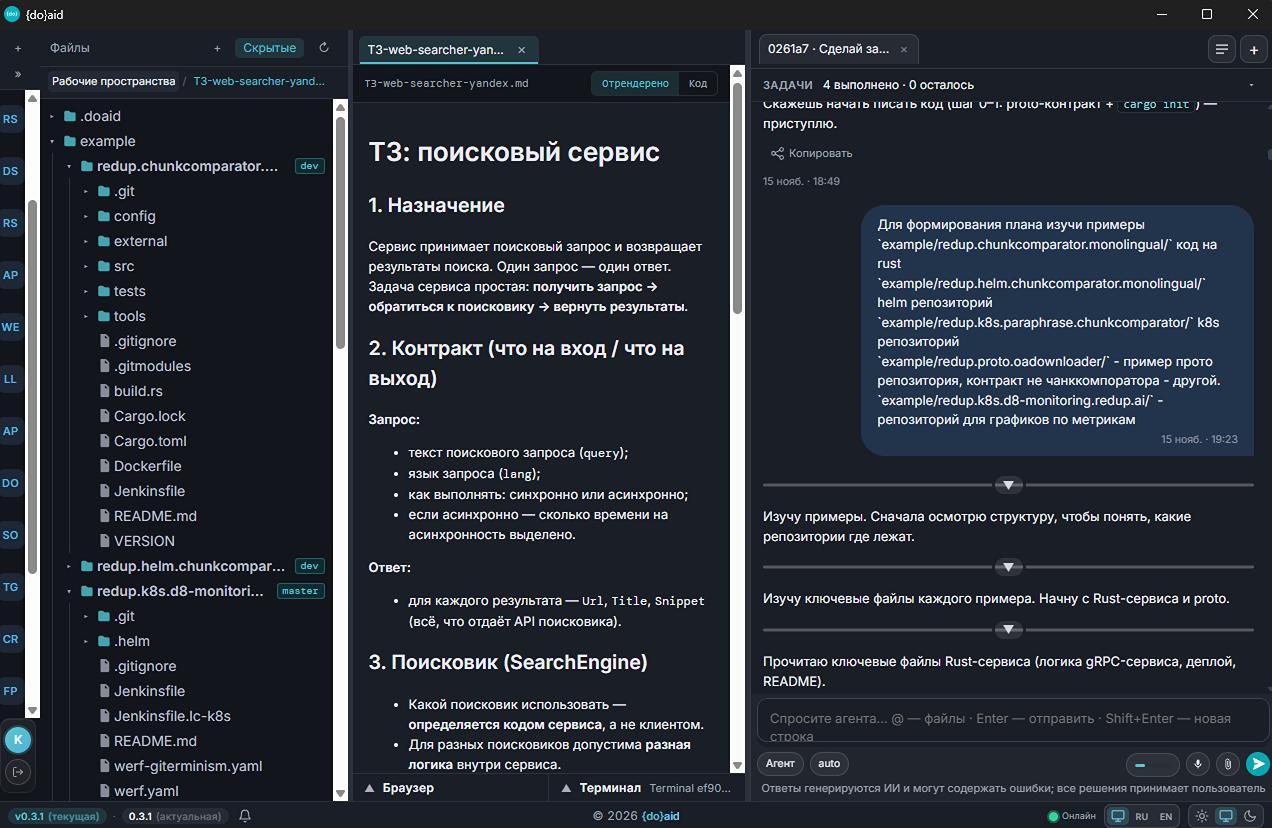
Шаг 6 — изучение примеров компании. Вторая порция с баллом 5 — даже не документ, а набор реальных репозиториев: готовый Rust-код, helm-чарт, k8s-манифесты, proto-пример и мониторинг-репозиторий. Если корпоративные правила задавали общие требования, то репозитории показали, как команда решает конкретные инженерные задачи на практике.
Изучив фактический код, агент обнаружил, что команда уже использует внутренний фреймворк redup-servicekit, который закрывает наблюдаемость из коробки. Это перевернуло весь стек: ручные metrics/prometheus/tower-http были отброшены в пользу фреймворка. Заодно обнаружились и другие развилки: про то как git-сабмодуль, конфиг в YAML вместо toml, деплой через multi-stage и werf, дашборды как CRD.
Оба случая подсвечивают, что в контекст попала информация, которую агент не мог вывести сам. Ни названия репозиториев, ни существование внутреннего фреймворка, ни паттерны наблюдаемости не угадываются из абстрактного ТЗ. Это знание живёт «в головах команды» и в их репозиториях, а не в предметной области задачи. Именно поэтому такой контекст максимально влияет на план и одновременно порождает вопросы к человеку.
Что почти не влияет: балл 1
Другая крайняя точка — балл 1 — тоже неслучаен. Характерно, что к нему относятся несколько повторных и уточняющих действий.
Шаг 8 — «как оформить источник/версию redup-servicekit?». Это вопрос о деталях уже принятого решения. Агент проверил пример, увидел обычную semver-зависимость из crates.io и закрыл микро-вопрос. План по сути не изменился, в него добавился лишь пояснительный абзац.
Шаг 9 — «что ещё осталось решить?». Это вопрос-состояние: агент перечислил открытые вопросы, но сам факт перечисления не меняет план. План уже содержал эти вопросы; запрос лишь озвучил их.
Шаги 18, 19, 24 — контрольные аудиты. Самая показательная группа. После того как в шаге 17 все средние проблемы были исправлены, мы несколько раз просили агента «снова проанализируй и исправь». Каждый раз оказывалось: новых проблем выше нижнего приоритета нет, регрессий нет, код не менялся, а в план добавлялся лишь очередной контрольный подраздел. Балл 1 — честная фиксация того, что дальнейшие повторы не дают ничего.
Эти примеры иллюстрируют важный принцип: информация, которая лишь подтверждает уже известную информацию, не развивает план. Она не добавляет ни нового знания, ни новой развилки решения, ни нового раздела. В контексте она занимает место, но почти не работает.
Закономерность: важно не количество, а роль
Сопоставив обе крайности и промежуточные значения, можно выделить закономерность. Влияние контекста зависит не от объёма, а от того, какую роль играет информация: превращает ли она неизвестное в решение, открывает ли новые ветвления, уточняет ли детали или просто подтверждает уже принятое.
Роль информации | Балл | Что происходит с планом |
Решения и развилки (правила команды, реальные примеры) | 5 | Новые разделы + альтернативные пути, выбрать которые может только человек. Агент доходит до предела своих полномочий. |
Факты о предметной области (ТЗ, документация API, стек) | 4 | Появляются новые разделы плана, но направление определяется фактом. Развилок, требующих человека, не возникает. |
Верификация (живой запрос к API, фиксация имён) | 3 | Уточняются и закрываются отдельные «открытые вопросы», новых разделов плана и альтернатив не появляется. |
Косметика (переименования, оформление) | 2 | Малые правки: переименования, пояснительные подразделы; суть и структура плана сохраняются. |
Подтверждение (повторы, уточнение уже решённого) | 1 | План не меняется; возможно, добавляется только документация. |
Фактически шкала 1–5 измеряет прирост энтропии решений. Контекст на балл 5 — это когда перед пользователем открывается пространство выбора, которого раньше не было. Контекст на балл 1 — это когда энтропия не изменилась вовсе, потому что всё уже было определено.
С этим согласуется и поведение одного и того же типа контекста в разных фазах. Возьмём документацию внешнего API. В первый раз (шаг 3) она дала балл 4 — потому что вскрыла: целевой API оказался не тем, что подразумевалось, и потребовал новых разделов. А вот живой запрос к этому же API (шаг 10) дал лишь балл 3: он подтвердил и уточнил уже обозначенное, но направление не поменял. Та же информация, но на разных стадиях, влияет по-разному: пока неизвестно много, любой факт резко меняет план; когда контуры определены, тот же факт лишь шлифует детали.
Именно поэтому наибольший вклад дают первые «тяжёлые» порции (правила, примеры), а последующие порции того же характера дают убывающую отдачу. Это своего рода закон убывающей маржинальной полезности контекста.
Отдельно можно подчеркнуть, что основной вклад для балла 5 пришел из корпоративной реальности, а не из формального ТЗ. Техническое задание, каким бы подробным оно ни было, описывает что нужно получить. А правила и примеры описывают как это принято делать в конкретной команде — и именно это «как» содержит основную массу скрытых ограничений и развилок. Для кодинг-агента это критично: он блестяще переводит хорошо поставленную задачу в код, но он не знает ваших договорённостей, если вы их в него не вложили.
Что класть в контекст
Опираясь на измерение, можно сформулировать правила, описывающие что действительно стоит передавать агенту.
1. ТЗ передавать файлом, а не сообщением. Уже на шаге 1 ТЗ положили в папку проекта. Это важный приём: файл постоянно доступен агенту, его можно перечитать в любой момент, и он не раздувает живое окно переписки. Рассказ ТЗ «своими словами» в чате — худший вариант: он искажает смысл и занимает контекст, который лучше потратить на ход работы.
2. Правила команды и реальные примеры отдавать обязательно и как можно раньше. Это контекст максимального влияния (балл 5). Его надо отдавать сразу, а не по ходу, чтобы не переписывать план задним числом. Примеры (репозитории) даже полезнее документов, потому что показывают фактический, а не декларируемый порядок вещей.
3. Документация внешних систем нужна, но как источник фактов. Она закрывает «что» и даёт балл 4. Полезно фиксировать, что осталось неопределённым (в эксперименте — «Открытые вопросы»), и явно проставлять, какие из них блокирующие.
4. Развилки выносить пользователю, а не решать за него. Прямое следствие шкалы: если видишь балл 5 — значит, есть место, где модель столкнулась с ограничениями, "уперлась" в корпоративное или политическое решение. Такие вопросы нужно передавать человеку, а не додумывать.
5. Вести журнал и оценки. Пара файлов logqa.md и influence.md превращают неявный процесс в измеримый. Журнал даёт историю и воспроизводимость, оценки позволяют сделать картину наглядной. Это и есть элемент научного подхода, который вместо ощущений дает числовые свидетельства.
6. Фиксировать договорённости по мере их появления. Когда пользователь закрывает развилку (шаги 5, 13), это решение надо немедленно записать в план и закрыть соответствующий «Открытый вопрос», чтобы агент в следующий раз не блуждал.
Что оставить за пределами контекста
Вторая половина вопроса — не менее важная. Что не надо класть в контекст?
1. Уже решённое и подтверждённое. Контекст балла 1 — это пересказ или повторение того, что уже определено. Повторные контрольные аудиты (циклы 4, 5, 12) показали: как только всё исправлено, снова гонять агента бессмысленно — он просто сигналит «всё в порядке». Каждый такой повтор съедает контекст и время, не давая ничего взамен.
2. Информацию, которую агент может получить сам. Если агенту уже дан главный пример или источник, не нужно дублировать его содержимое пересказом. Один раз дать точный источник — лучше, чем много раз пересказывать одно и то же. Знание «откуда взять» ценнее «что там написано».
3. Лишние детали, не влияющие на решения. Это очень контринтуитивно: кажется, что «побольше деталей» — надёжнее. Но избыточная информация размывает внимание и отвлекает модель от главного. Следует стремиться к минимально достаточному набору, покрывающему решения и развилки.
4. Оценки и догадки вместо фактов. Агенту полезнее дать проверяемый факт (например, живой ответ API), чем предположение. Предположения порождают неточности в плане, которые потом придётся исправлять.
Главный критерий того, что не давать агенту достаточно простой: если информация не меняет ни одного решения и не создаёт ни одной развилки — она не нужна. Вопрос «изменит ли это балл на 3 и выше» может являться быстрым фильтром для решения, положить кусок знания в контекст или нет.
Где тут место человеку
Отдельно хочется поговорить о верхней ступени шкалы. Вокруг балла 5 может сложиться впечатление, что на этом уровне просто агент не справился. На самом деле это не так.
Балл 5 — это свидетельство того, что задача вошла в зону, где нужно настоящее инженерное и управленческое решение, а не генерация кода. Агент выполнил свою часть: он обнаружил, что ответ зависит от внешних ограничений, которые ему не передали. Вместо того чтобы выдумывать, он честно поднял вопрос. Умение распознать этот момент и вовремя вернуть выбор пользователю — по сути, тоже навык хорошего контекст-инжиниринга.
В эксперименте это проявилось дважды — на шагах 4 и 6, когда агент упёрся в «а как у вас принято?» и вернул вопрос человеку. Человек ответил (шаги 5, 13), развилки закрылись, план стал конкретнее, и дальше агент спокойно пошёл вперёд. Получилась почти идеальная петля: агент выявляет границу своих полномочий — человек её раздвигает — план детализируется.
Что не так с этим экспериментом
Как и любой эксперимент, этот имеет границы применимости, о которых стоит честно сказать.
Во-первых, это единичное наблюдение. Причём на очень специфической задаче — разработке одного Rust-сервиса в одной корпоративной среде. Обобщать числа на все задачи нельзя: на другой задаче, с другим агентом и другой организацией распределение баллов будет иным, хотя качественная закономерность, как связь влияния с ролью информации, скорее всего сохранится.
Во-вторых, оценки влияния выставлял не независимый наблюдатель, а сам ход процесса, где агент и пользователь действовали вместе. Субъективный компонент в выставлении баллов неизбежен, и хотя шкала детализирована, граница между соседними баллами (например, 3 и 4) в отдельных случаях может быть спорной.
В-третьих, «влияние» измерялось через изменения плана, а не через качество итогового продукта. Теоретически возможна ситуация, когда контекст почти не изменил план, но существенно улучшил код, или наоборот. Для измерения качества продукта нужна другая методика и другие метрики. Я сознательно выбрал план как быстрый и наглядный индикатор, но это именно индикатор, а не итоговая метрика.
Наконец, важно отличать изменение плана от исполнения плана. Шаг 14 («выполняй план») получил балл 4, хотя формально план не перестраивался, он на этом шаге исполнялся. Здесь балл отражает масштаб появившихся артефактов (множество новых файлов), а не контентные развилки. Это честная оговорка, поскольку шкала задумана в первую очередь для измерения влияния информации на планирование, а не факта реализации.
Вывод
Эксперимент показал, что контекст-инжиниринг можно сделать измеримым, и измерение даёт нетривиальные результаты.
Главным выводом для меня стало то, что влияние контекста определяется не его количеством, а тем, открывает ли он новые решения. Максимальный эффект — балл 5 — дала информация из корпоративной реальности: правила команды и фактический код готовых примеров. Она не просто расширяла план, а открывала развилки, которые может разрешить только человек. Минимальный эффект — балл 1 — дали повторы и уточнения уже принятого, они не двигали план ни на шаг, но тратили драгоценное время.
Отсюда практическое правило: класть в контекст то, что способно изменить решение, и оставлять за его пределами то, что лишь подтверждает уже решённое.
Можете повторить эксперимент на совей задаче, а если уже есть опыт или свои наработки в оценке важности того или иного контекста в работе с агентами приглашаю поделиться опытом.