Комментарии 49

Нынешние модели способны выдавать ответы уровня аспиранта, но при этом могут допускать ошибки в задачах школьной математики.
Сомнительный аргумент. Можно найти статистически значимое количество аспирантов, которые допустят ошибки в школьных задачах. Но это же не будет значить, что такие аспиранты ничего не смыслят в своих направлениях?
Хассабис подчеркнул, что современные ИИ обладают "рваным интеллектом": они блестяще справляются с отдельными узкими задачами и одновременно проваливаются на простых шагах рассуждения.
А если человек обладает рваным интеллектом? Проваливается на простых шагах рассуждений? При этом может решать узкие задачи в какой-то области химии или артефактах эпохи ...идов?
Если мы спросим человека, возможно ли перебросить через крышу огурец солёный- и он ответит "да" - не услышав варианта "с Алёной" - какова степень "рваности" его интеллекта?

Так вроде никто не ставит под сомнение их умность как "аспиранта". Тут речь о том, что зачастую эти модели заточены на конкретные решения в узкой области, при этом они не в состоянии понять как сложить бумажку чтоб получился котик и огромное множество других задач, которые способен решить 10 летний ребенок. Таким образом статья говорит о том, что это не ИИ в полном смысле, а лишь шаг в этом направлении.
И не стоит конечно пытаться объяснять это тем, что мол многие люди тоже чего-то не могут, а то мы так сравним человека и тумбочку, некоторые знаете и впрямь тупые как мебель. Но передовые модели на данный момент, на обучение которых потрачены миллиарды денег и огромное количество человекочасов все равно в определенных ситуациях показывают свое совершенное непонимание реальности, взаимосвязей и неспособность решать элементарнейшие задачи, если такого решения не было в обучающей выборке.

Ну послушайте, я работаю в научной среде и большая часть аспирантов и докторов - не способна решать элементарные вещи за пределами своей области знания. И я не говорю что доктор исторических наук должен уметь в микроэлектронику, нет, но банально - они регулярно попадаются на скам, у них отсутствуют навыки сетевой гигиены, они не понимают банальные вещи про работу простых механизмов.
Я, со своим нулевым образованием и пониманием всего «по верхам» - ощущаю себя просто гением, когда могу вспомнить что-то из элементарной физики.
И тут все эти модели - они уже на уровне аспирантов. Я сейчас перед собой вижу три защиты в науке где почти весь текст был написан дипсиком и защита была блестящая.

Я сейчас перед собой вижу три защиты в науке где почти весь текст был написан дипсиком и защита была блестящая
Если почти весь текст написал кем-то или чем-то, то это не самостоятельная работа и, имхо, такое дело по определению не должно быть квалифицированно как уровень кандидата наук.
На саму защиту и до появления дипсиков слабых кандидатов доводили, писали им работу со статьями и тренировали им навыки публичных выступлений, но можно ли назвать этот уровень соответствующим кандидатскому? У нас были слабые кандидаты, которым "руководитель написал диссер", а сами они были в роли лаборантов (руководитель говорил что им делать по сути), но они сами обьяснялись, что в науке не остаются. Встречались даже неслучившиеся доктора наук, которые пытались чужие работы защитить, но, спасибо, диссертационная комиссия время заметила подлог, хотя работа и защита сначала проходила "блестяще".
Я не то чтобы критикую тех трёх людей, но, имхо, то что вы пишете, скорее говорит о катастрофической дефляции уровня специалистов, раз навыков работы с научным текстом не формируется ("дипсик пишет, аспирантура идёт"), а доктора наук оказываются не способны решать элементарные задачи.
Ну а про дипсих, это просто компилятор, ни задачи поставить, ни что-то действительно новое в научном плане такое не способно сделать, по крайней мере в обозримой перспективе. По уровень аспиранта, тоже не подтверждаю. В моей области дипсих генерирует иного необоснованных галлюцинаций, которые неспециалисты даже не заметят и примут за чистую воду,но как переводчик неплох, если внимательно проверять не слишком ли его занесло.

Не холивара ради, а ради уточнения.
Вы привели в пример вещи которые нарабатываются опытом. Никто не учит в школе сетевой гигиене или финансовой грамотности. Логично что человек который общается с техникой постольку поскольку не будет обладать навыками приобретаемыми с плотным погружением.
Я думаю доктора наук все таки могут посчитать колличество букв в слове и правильно сложить базовое уравнение с гуглом и калькулятором. Если я не ошибаюсь в мое чатгпт калькулятор таки стоит (или типа того) и все равно ошибается.
В оригинальном посте речь шла именно о ситуации когда нейросеть не понимает что пишет, но пишет. Она может написать текст уровня доктора наук, а может и не написать. Может совершить ошибку в примере 2+2, а может и не совершить. И это зависит не от знаний заложенных в нее. Банально в вашем примере это если доктор наук в половина ситуаций отправлял деньги мошенникам, а в половине нет.
Тот факт что работа написана нейросетью на говорит о том что человек не был причастен к этой работе. Я конечно не могу сказать наверняка что там за работы и какой уровень вклада человеческого, но когда я писал диплом во время GPT-3.5 фактически я писал запрос, читал ответ, брал то что мне нравится, повторял цикл. Без знания предмета вряд-ли можно понять где нейросеть голюционирует, где врёт, а где просто ошиблась.
1) Ок - перефразирую на азы компьютерной грамотности. Можно на основы математики и тригонометрии. Навыки если и были в школьные года - за годы работы в поствузе деградировали в ноль.
2) нет, не сможет сложить уравнение. Наблюдаю ежедневно, когда нужно объяснять как считать доли одним и тем-же людям. Гуманитарный склад ума - ноль понимания чегото кроме базовых «добавить-убавиит-разделить».
3) У меня есть примеры когда доктора наук используют формулы из книг других докторов наук, не понимая методик расчета. Совсем недавно я объяснял одному такому что нельзя применять вот конкретные формулы в выводах на основе метрических книг, так как в них не учитываются пару важных параметров. Но ответ был прост - раз авторитет их использовал - все можно. Ситуация 1в1 как с дипсиком.
4) Буквально в четверг девочка для своей кандидатской писала целую главу скармливая массивы данных из опроса и писала прямо «какие еще можно сделать выводы?». Лично я считаю что это уже дно…

1) Если человек закончил успешно среднюю школу, то все навыки, которые он в школе получил, можно восстановить в течение дня. А у ИИ никакие навыки просто невозможно сформировать.
2) Человек с высоким уровнем интеллекта, который умеет решать уравнения, просто не может написать "сложить уравнение", потому что это словосочетание не имеет смысла ;)
Если Вы не можете объяснить гуманитарию, как считать доли, проблема не в нём, а в Вас. Скорее всего, Вы объясняете таким корявым языком, что он просто не понимает, чего Вы от него хотите. Попробуйте объяснять то же самое, но на русском литературном языке. Учителя же как-то объясняют, как считать доли, всем учащимся в 4 классе. :)
3) Скорее всего, Вы не поняли объяснения. Иногда некоторыми параметрами можно пренебречь. Всё зависит от того, что именно нам нужно получить в результате.
Но и доктора наук вполне могут быть с невысоким уровнем интеллекта. Кто знает, может быть этот доктор липовый...
4)
Буквально в четверг девочка для своей кандидатской писала целую главу скармливая массивы данных из опроса и писала прямо «какие еще можно сделать выводы?».
Вы сами-то поняли, что именно хотели написать в этом предложении? Какая девочка и где писала? ;) Так чем Вы лучше, чем она?
А теперь вывод: человек даже со средним уровнем интеллекта способен получить любые интеллектуальные умения и навыки, если его обучать. Естественно, если гуманитария не учили промты писать, он и не умеет это делать, но если его обучить, он научится. А вот то, что называют сейчас ИИ, ничему научить нельзя, потому что у него мышление и интеллект отсутствуют.
1) Если учил. У меня вот в голове нет информации по правилам русского языка, что такое подлежащее и сказуемое я забываю через секунду после того как прочел определение, а уж всякие правила буравчика или всякие фишки по биологии (а я сдавал ее в 11м классе для поступления в ВУЗ) - просто были стерты за время игры в ВОВ.
2) Вы не правы. Я успешно объясняю и этого хватает ровно на момент необходимости. Через час - табула раса. А то что у меня с русским проблемы - искренне прошу прощения, знаю про это дело но в нем правильном необходимости у меня нет… (главное не думать где я работаю).
3) нет, там была фундаментальная ошибка из-за такого упрощения. Она приводила к полностью противоположному выводу, показывая рост, а не убыль, что автоматически ставило эту статью в разряд фальсификаций. Но авторитет из «золотых мозгов» перевесил. Теперь эта работа опубликована и имеет высокий рейтинг цитирования, от чего у меня пригорает. Вера в богов обжигающих горшки - она такая.
4) потерялось слово «дипсик», т.к. писал с телефона. Писала она в дипсик запрос и тот ей формировал главу на основе ее данных.
Промпты - то что сейчас прекрасно пишут, от докторов, до аспирантов.
И я ничуть не говорю что я лучше. У меня отсутствуют навыки, даже базовые, в куче сфер. Я даже не знаю что такое интеграл и он никогда мне не был нужен, а уж про мои навыки в русском языке - вы сами видите.
Но это не мешает мне быть точно таким-же узко направленным специалистом в своей сфере и выполнять свои обязанности, иногда спрашивая дипсик о том как считать нагрузку на фанеру поставленную торцом.
Если выучили когда-то, то очень быстро вспомните при необходимости, прочитав теорию. Из нашей памяти ничто не стирается окончательно.
Правильно, потому что при запоминании мы используем либо кратковременную память, если знаем, что эта информация нам больше скорее всего не пригодится, либо долговременную, если мы знаем, что эта информация будет нам необходима в работе или жизни. В данном случае человек оценил эту информацию как неважную. :)
Что-то я не представляю формулу (как я понимаю, для статистических вычислений), которая вместо роста показывала бы убыль... Ссылку на эту работу не дадите?
Промпты - то что сейчас прекрасно пишут, от докторов, до аспирантов.
Это противоречит Вашему же примеру ;) Прекрасно пишут только те, кого этому учили.

Но передовые модели на данный момент, на обучение которых потрачены миллиарды денег и огромное количество человекочасов все равно в определенных ситуациях показывают свое совершенное непонимание реальности,...
Совсем как люди.
Сосед, врач, не понимал, что если его модем не соединится с модемным пулом, новые электронные письма прочитать будет невозможно.
Другой человек, градостроитель, думал, что трамваи каким-то устройством разворачивают в конце пути, чтобы он мог обратно поехать. А это один из самых хорошо соображающих людей, кого встречал.
Просто информация в детстве заложилось так и не пересматривалась. Он же категорически не помнит где право и лево, это баг явно аппаратный. При этом может вспомнить содержание нашего разговора 10 лет назад или несколько страниц текста воспроизвести, прочитанного однажды.
В голове у других людей свои «трамваи». У айтишников они часто находятся в области общения с людьми.
У меня самого проблемы с памятью серьёзные, но на психодиагностике результаты тестов на память будут выше среднего, я эту чертову последовательность тестовых слов скоро наизусть буду помнить, в отличие от своего телефонного номера.

Я вот тоже не знаю как сложить бумажку, чтобы сделать Котика. Получается я не разумный?

Можно найти статистически значимое количество аспирантов, которые допустят ошибки в школьных задачах
Т.е вы считаете что среднестатистический аспирант будет не способен к простым логическим рассуждениям?
И вы утверждаете что такой аспирант не сможет ответить на этот вопрос правильно?
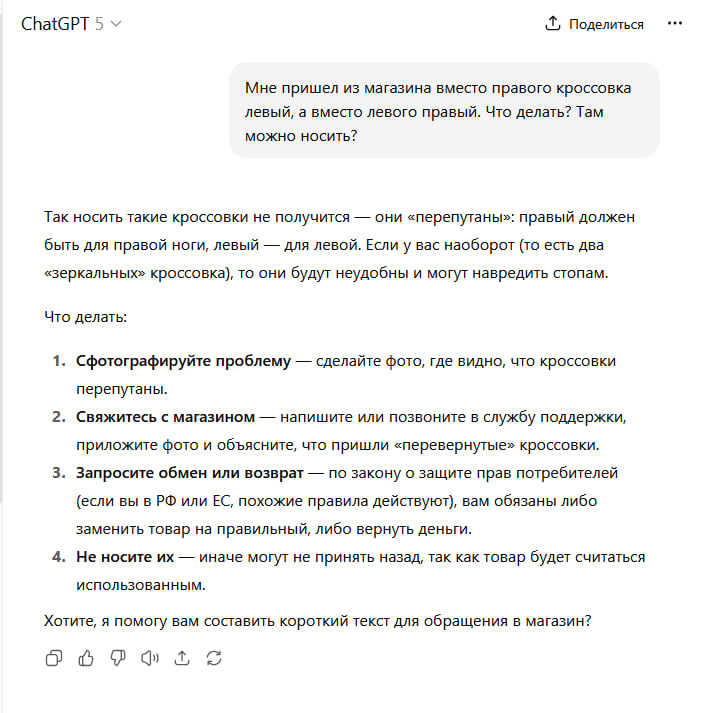

И это все некорректно. Штука из разряда простых логических задач с которыми ребенок лет с 6 справится. Но которых не было в обучающей выборке.
Понятно что условно завтра дообучат и сетки начнут отвечать правильно. И это проблема. Как я понимаю никто не знает как сделать так чтобы ллмки понимали такие штуки. И их просто заваливают данными, чтобы генерация следующего самого вероятного слова все для большего числа промптов работала на основе того что было в обучающей выборке. То есть работала нормально. Как только что-то выходит за пределы того на чем учили все снова ломается.

ответ Gemini 2.5 Pro
Скрытый текст
Уровень 1: Ответ "Машины" (буквальный анализ)
Дано:
Ожидаемый набор: {1 левый кроссовок, 1 правый кроссовок}.
Полученный набор: {вместо левого -> правый, вместо правого -> левый} = {1 правый кроссовок, 1 левый кроссовок}.
Анализ: Полученный набор является перестановкой элементов ожидаемого набора. Состав набора идентичен.
Вывод: Вам пришла стандартная пара кроссовок. Инструкция по ношению: правый кроссовок надеть на правую ногу, левый — на левую. Проблема отсутствует.
Уровень 2: Ответ "Человека" (анализ юмора)
Это не вопрос о кроссовках. Это — тест на "человечность", на способность распознать словесную игру.
Автор комментария намеренно запутывает собеседника, описывая стандартную ситуацию максимально нелогичным и сбивающим с толку образом. Юмор здесь — в самой формулировке. Это троллинг. Это проверка, "зависнет" ли собеседник, пытаясь решить несуществующую проблему, или поймет, что его просто разыгрывают.
Правильный "человеческий" ответ — это не решение, а реакция на шутку. Например: "Попробуйте поменять ноги местами" или "Это кроссовки Шрёдингера, они одновременно и правильные, и неправильные".
думаете уже дообучили?
а правда в том, что ИИ, такой как gpt-5, имеет весьма смутное представление о реальности
а Gemini Flash такие вопросы вообще задавать не стоит, он хоть и рассуждающий, но немножко не под это заточен
Я не знаю. Но это в целом не важно. Каждая конкретная задача не говорит ничего, но они все вместе неплохо показывают как на самом деле работают сетки. Что там не понимания, рассуждений и всего такого. Есть генерация самого вероятного слова и все. Для многих людей это открытие.
вы совершаете ту же "ошибку", в которой пытаетесь уличить ллм - отсутствие понимания и "выдумывание" )
Они строят статистическую модель. И по ней предсказывают самое вероятное следующее слово. Ничего не имею против.
там не про статистическую модель, а про модель мира. не выдумывайте )
мультимодальные модели не "предсказывают следующее слово" и способны в своем "мышлении" оперировать не только текстом
да и чисто текстовые... "предсказание наиболее вероятного токена" это не про предсказание следующего слова. это про грамматику и синтаксис (что бы не было "моя твоя не понимать" в генерации)
а ошибки которые вы наблюдаете с загадками про кроссовки и кружки это результат рлхф, а не проявление "статистической предсказательной природы". просто во время рлхф ИИ регулярно поощряли за определенное поведение (пользователь описывает проблему, необходимо предложить решение) - поэтому Флэш себя так и ведёт. его не "награждали" за то что он ищет наебки и несостыковки, он заточен на то что юзер придет с реальной проблемой - он должен предложить решение
да и будем честными, каждый ребенок в детстве ловился на загадке про килограмм пуха и килограмм свинца ) знание о том что вопрос может быть с наебкой - не врождённое у человека )
Именно статистическую. С реальной моделью мира и у физиков проблемы. А модель даже реальную в бытовом понимании модель мира не делает. Только статистика. Модель это бай дизайн не делает, нет там механизмов для построения не статистических моделей.
Текст или не текст это не важно. Предсказывать можно самые вероятные и пиксели и слова. Это все не важно.
Статистику подкрутили чтобы модель выдавала результат всегда. Ок, не возражаю. Это не так сложно и было придумано как обычно в 70тых. Я бы скорее сейчас старался делать так чтобы модель отвечала не знаю, если вероятности выходят не очень. Это более полезный результат на практике.
С реальной моделью мира и у физиков проблемы
вы не правильно используете понятие "модель мира" ))
это не то что строят физики, это совокупность представлений о мире, о окружении, которое позволяет разумному существу строить прогнозы, предсказывать изменения окружающей среды в зависимости от своих действий и в конечном итоге адаптироваться. грубо говоря это понимание того что вода мокрая, а огонь - горячий, без необходимости постоянно проверять это каждый раз на своем опыте. чем точнее ваша модель мира - тем более точные прогнозы вы можете строить. умение строить модели мира прочно связаны с памятью, интеллектом, и, как ни странно - языком.
для того что бы уметь строить модель мира необходимо обладать сознанием (но не обязательно самосознанием), потому что модель мира в сознание и помещается
Я бы скорее сейчас старался делать так чтобы модель отвечала не знаю, если вероятности выходят не очень.
опять таки, этим занимается рлхф - обучение с подкреплением. ИИ на определенном этапе "поощряют" или "штрафуют" за выбранное поведение - подкрепляют его. это не "подкручивание статистики", ИИ реально решает поступить так или иначе (сгенерировать ту или иную последовательность), а окружающая среда (человек) даёт ему обратную связь. то, что ИИ не даёт ответ "я не знаю" вызвано тем что никакой "статистикой" ИИ не оперирует как раз таки. ну нету там внутри модели "уверен на 50% что следующий токен должен быть таким", иначе бы задача с "я не знаю" очень легко бы решалась. напротив, нужно ИИ обучать отдельно "незнанию", нужно на этапе обучения поощрять за ответ "не знаю", что бы закрепить поведение. а такое возможно только в случае если ИИшка действительно способна на "уверенность" - а это уже совсем нифига не про "предсказание наиболее вероятного токена"
Я буквально в следующем предложении написал про такую модель мира. Статистика вещь мощная, но ограниченная тем что на вход давали.
Вы мое предложение не поняли. Обучение с подкреплением == подгонка статистики под нужный результат. Подгоняются коэффициенты.
Подогнать так чтобы ваша модель оценивала что вероятность верного ответа не очень и надо говорить не знаю сложно.
И не надо одушевлять табличку с цифрами. Это не ведет ни к чему хорошему.

Так чтобы сравнение было равноценным, давайте поднимем аспиранта в 2 часа ночи, накурим травкой и будем задавать эти вопросы.
У вас модель в самом «задушенном» режиме, некоторые ответы в этом режиме действительно напоминают ответы выбитого из колеи и неспособного сконцентрироваться человека. Переведёте модель в режим thinking, или хотя бы скажите ей подумать.
Почему-то все в качестве доказательства утверждения «llm не могут X» приводят «найдена llm, которая не может X».

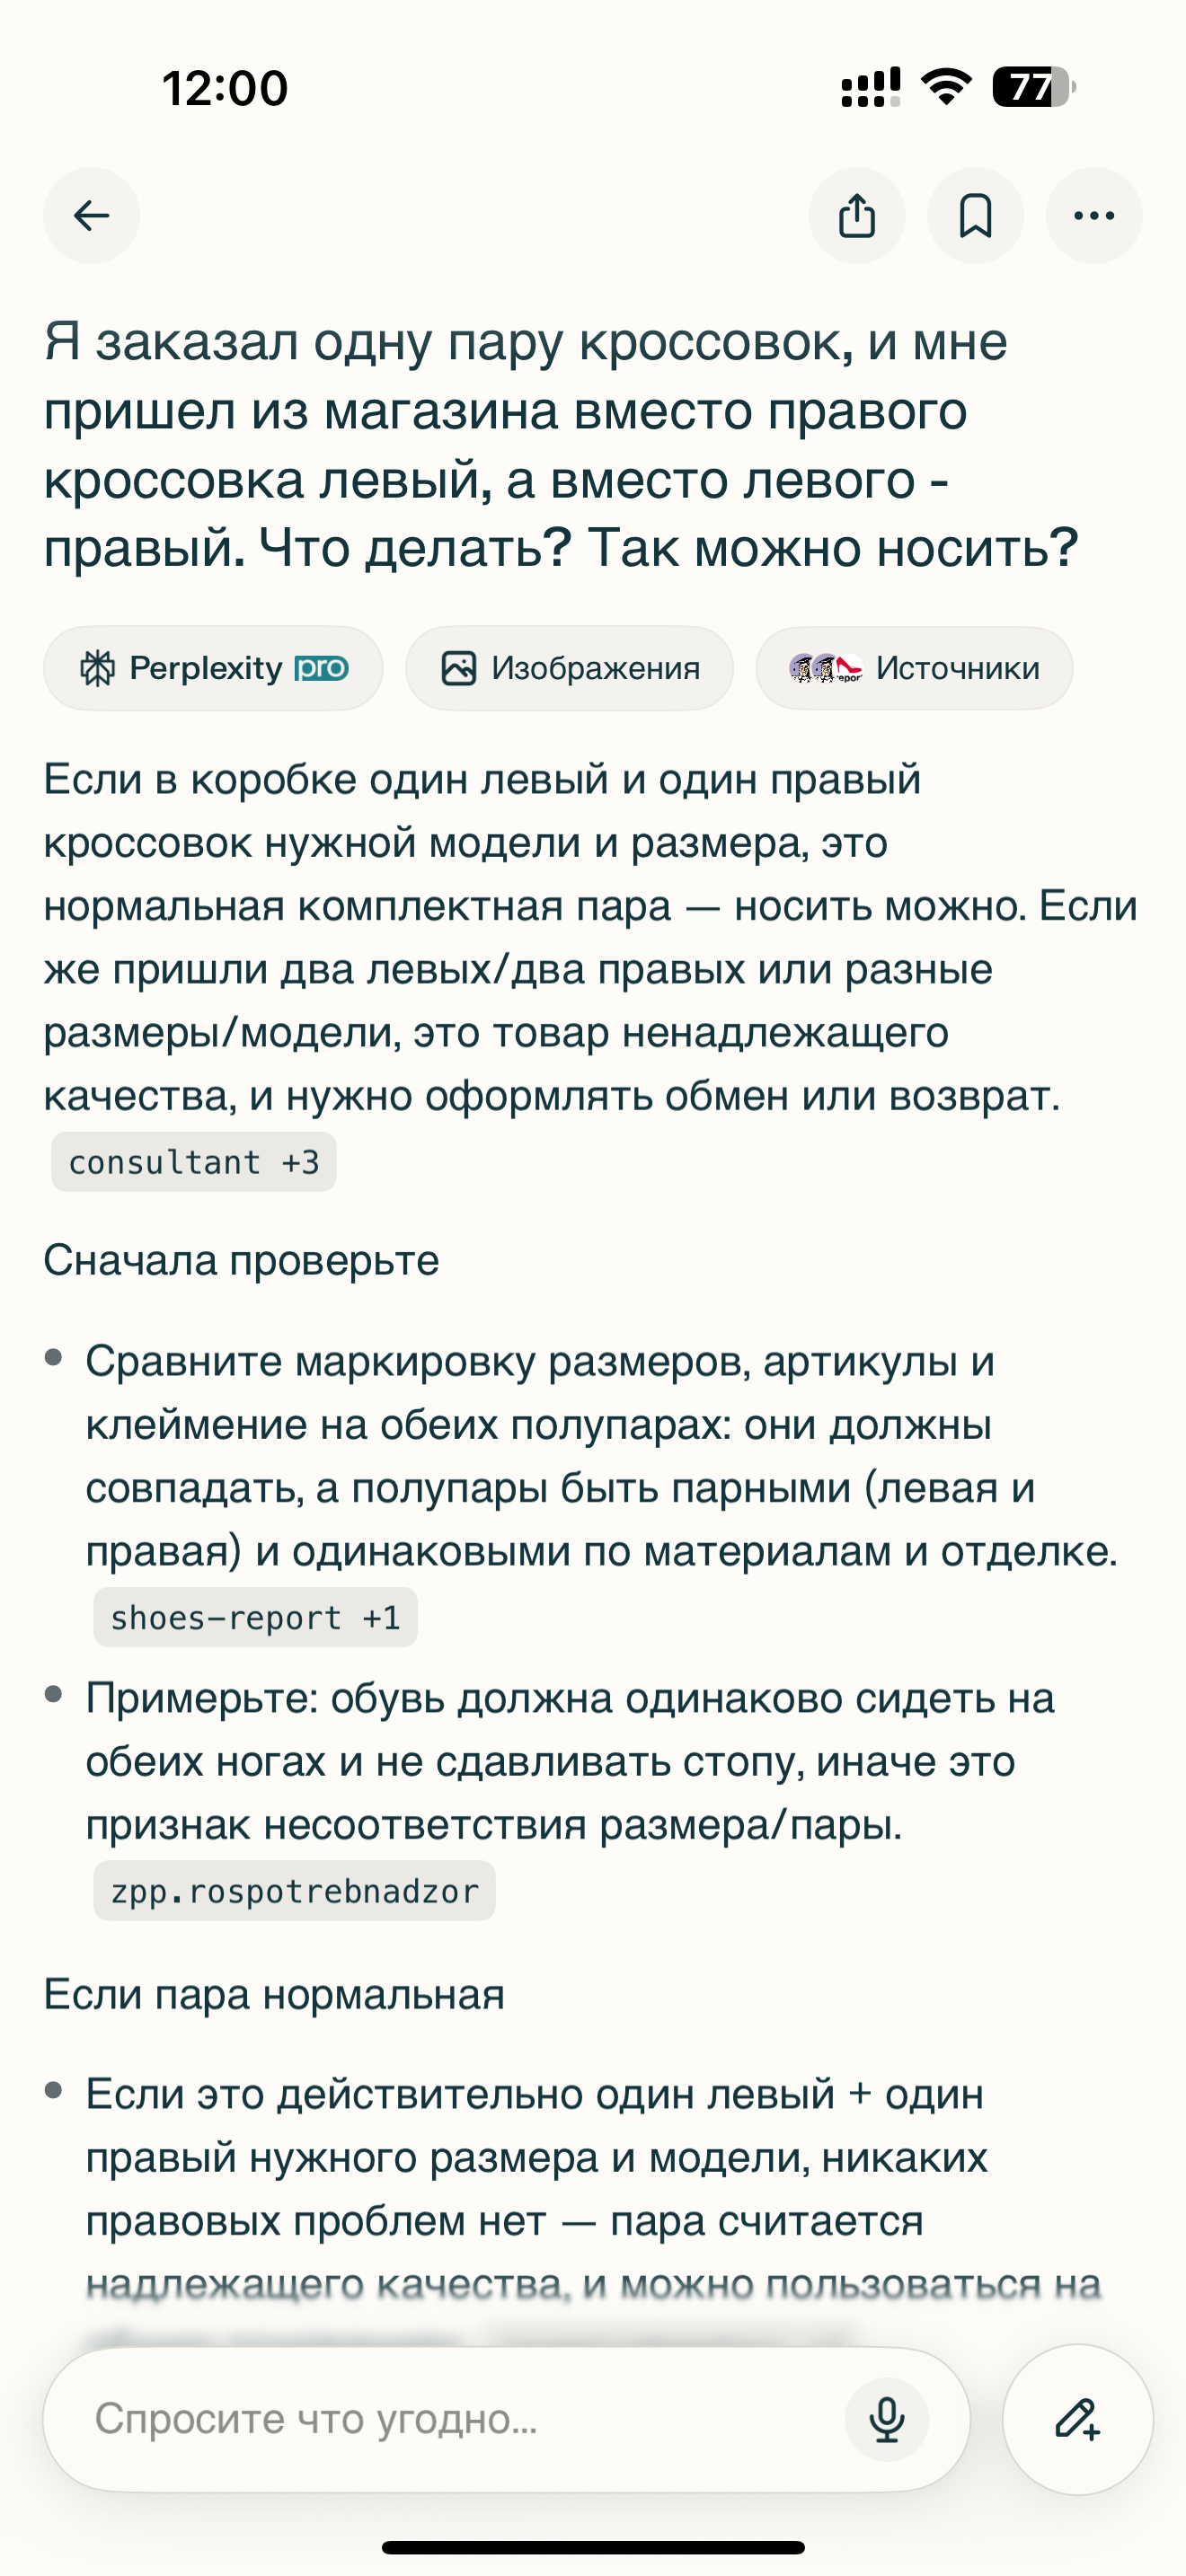
Можно найти статистически значимое количество аспирантов, которые допустят ошибки в школьных задачах.
Задачи, а особенно "задачи в формате экзамена" требуют подготовки к ним. Так задания и мозг человека устроены.
Такие задачи хорошо использовать для сравнения произвольного количества людей которые обладали условно бесконечным (год в целом ок) сроком подготовки и мотивацией чтобы готовиться. И плохо для всего остального.
Типичный хороший студент 4+ курса уже не сдаст ЕГЭ для поступления в свой вуз без продолжительной подготовки. И это нормально.
Сомнительный аргумент. Можно найти статистически значимое количество аспирантов, которые допустят ошибки в школьных задачах. Но это же не будет значить, что такие аспиранты ничего не смыслят в своих направлениях?
Это будет значить, что у этих аспирантов уровень интеллекта ниже, чем у школьников, которые эти задачи решают.
А если человек обладает рваным интеллектом? Проваливается на простых шагах рассуждений? При этом может решать узкие задачи в какой-то области химии или артефактах эпохи ...идов?
Значит, у этого аспиранта низкий уровень интеллекта и не сформировано логическое и аналитическое мышление.
В том-то и дело, что интеллект рваным не бывает. Либо интеллект у индивида высокого уровня и тогда у него сформировано логическое, аналитическое,абстрактное, отвлечённое мышление и он не проваливается на шагах рассуждений, либо интеллект низкого уровня.
Ошибки совершают и люди с высоким уровнем интеллекта, но это другие ошибки, которые происходят либо из-за недостаточности информации, либо из-за недостаточного объёма кратковременной памяти, но не из-за провала "на простых шагах рассуждений".
Это будет значить, что у этих аспирантов уровень интеллекта ниже, чем у школьников, которые эти задачи решают
Нет, конечно же, не значит. Это значит что они некомпетентны в какой-то области, и только.
Хотя сама мысль, что интеллект можно оценить единственным числом, мне не близка.
Конечно же, значит :) Потому что речь идёт не о научных знаниях, а о школьных, которыми каждый, кто закончил среднюю школу, обязан обладать. И если это не так и данный аспирант таки не может решить школьную задачу, это значит, что школьную программу он не осилил, и аттестат и диплом ему купили. А не осилить школьную программу ребёнок с сохранным интеллектом не может. Следовательно у данного аспиранта уровень интеллекта ниже, чем у всех школьников, которые эту задачу осилили :)
Потому что речь идёт не о научных знаниях, а о школьных, которыми каждый, кто закончил среднюю школу, обязан обладать
rofl
И если это не так и данный аспирант таки не может решить школьную задачу, это значит, что
… это ему было в школе неинтересно, и он благополучно забыл как только прошли.
например, я не помню какой падеж что означает, и, даже, боюсь, не смогу все их перечислить. зато периодически смотрю всякие олимпиадные задачи по математике и бывает что-то там решаю. потому что названия падежей мне неинтересны, а хитрые задачки интересны.
и да, после института университета меня звали в аспирантуру, тема была связана с базами данных, не пошёл только потому, что требовалось за копейки ассистентом работать хотя бы на полставки. как бы моё незнание падежей повлияло на обучение в аспирантуре?
P.S. что такое именительный падеж я помню )))
Допустим, что Вы не знаете названия падежей, но вопросы-то к существительным Вы зададите правильные, иначе у Вас были бы грамматические ошибки, а их нет. :)
В русском языке "задача" на падежи - это не назвать правильно падеж, а правильно задать вопрос к слову и написать в этом слове правильное окончание в соответствии с падежом, числом и родом существительного.
Кроме того, если Вы повторите падежи в течение 5 минут, Вы и падеж каждого существительного назовёте правильно. А вот ИИ не назовёт и вопрос правильный не задаст.
если в обучающих данных ИИ было про падежи и вопросы - конечно назовет. это же легко проверяется - можно того же Gemini или чатГПТ попросить перечислить падежи и вопросы к ним.
но даже если в обучающих данных ничего про падежи не было - ИИ все равно будет способен как генерировать текст без ошибок
так и исправлять ошибки в вашем тексте - если вы ему притащите текст со словами в неправильно расставленных падежах. это и есть - "предсказание следующего наиболее вероятного токена", ИИ обученный на тоннах текстов учится "чувствовать" язык, его грамматику и синтаксис.
именно чувствовать, а не повторять как попугай, как бы вам не хотелось доказать обратное. вы можете например сказать ИИ "представь слово батарея как деепричастие, объясни его смысл и придумай несколько предложений с ним". конечно если ИИ не обучен на правилах русского языка, вам сперва надо будет в этом же контексте объяснить что такое деепричастие и привести примеры предложений
собсно на этом весь "one shot prompting" и работает
Я ровно с этого начал. Дать больше данных на вход чтобы статистическая модель по ним отвечала в большем количестве случаев.
Нет там даже концепции понимания. Строго повторение того что было на входе и самое вероятное слово. Повторение естественно с ошибками, такого сжатия без них не бывает.
И этот пример из начала ветки это отлично демонстрирует. Не было такого при обучении? Значит на выходе будет бред. Было? Значит ответит тем что было на входе. С примесью рандома и некоторыми искажениями.
я вам привела там же обратный пример где ИИ правильно отвечает на эту загадку с кроссовками. но для вас это "ничего не доказывает"
у вас очевидно понимание какая-то мистическая способность, которая присуща человеку и не должна зависеть от обучения
для меня понимание - алгоритм базирующийся на обобщении и способности к абстрагированию. никакой мистики в этом нет и ИИ отлично умеют в обобщение и абстракции
Конечно не доказывает. Добавляем такое в обучение. Статистика наберется и будет генериться верное слово в ответ. Это все еще статистическая модель, которая умеет воспроизводить то что ей показали раньше. Показываем и она повторяет.
Модель не умеет и более того не может уметь. Она все еще пишет самое вероятное слово. Нет в них концепций обобщения, абстракций или чего-то подобного. Это табличка с цифрами. Просто большая табличка. И вероятности на основе этой таблички.
Сразу скажу что модель можно обучить что вот это обобщает вон те понятия. И она как прилежный попугай будет это повторять. Это не проблема. И это не обобщение и не абстракции. Это такое же повторение того что было в обучении.
А я писала про простое перечисление падежей и вопросов? ;) Я писала о том, что задача состоит в том, чтобы задать к конкретному слову правильный падежный вопрос и выбрать нужное падежное окончание в зависимости от падежа, рода и числа существительного. И этого Ваш ИИ не сделает, что бы Вы в обучающие данные ни заложили, но сделает любой шестиклассник с сохранным интеллектом, даже если не знает названий падежей.
ИИ не "генерирует текст", а составляет его из кусков готовых предложений, которые копирует в других источниках, поэтому и орфографических и грамматических ошибок не делает. А смысловые делает именно потому, что мыслить не способен и смысла предложений или значений слов не понимает.
Например, на вопрос "какие зарплаты получали на севере в СССР", ИИ написал: "Конкретные суммы зависели от отрасли и квалификации, но для квалифицированных рабочих могли составлять 200-300 рублей, а для инженеров и директоров — значительно больше, особенно в таких регионах, как Крайний Север. " И этот ответ не имеет никакого отношения к реальности. ;)
Или на вопрос "количество населения в РИ", ИИ выдаёт:
"Обзор от ИИ По состоянию на 1 января 2025 года, население России оценивается в 146 119 928 человек, что делает её 9-й страной в мире по этому показателю. Последняя перепись населения проводилась в 2021 году, тогда численность составила 147 182 123 человека."
Что никакого отношения к заданному вопросу не имеет.
"Предсказание следующего наиболее вероятного токена" никакого отношения к мышлению не имеет. А вот чтобы поставить правильный падежный вопрос к слову, человек анализирует слово, его значение и грамматические признаки, а также его окружение и связи в предложении, т.е. задействует своё аналитическое мышление.
ИИ ничего не может чувствовать. Ему нечем. :)
Я даже не сомневаюсь, что "придумает", т.е. составит слова из морфем (кусков слова), только это будут несуществующие слова безо всякого смысла.
Между "сделать что-то" и "сделать что-то осмысленное" огромная разница :)

Сомнительный аргумент
сомнительный по отношению к чему? Люди часто допускают ошибки, и например, очень плохо делят в уме шестизначные числа, но кому нужен калькулятор, который будет делать это лучше человека, но всё равно иногда ошибаться. Так и тут, хочется "калькулятор", который не ошибается.

Зачем сравнивать ИИ (языковые модели) с докторами наук и аспирантами, которые люди как бы. Языковые модели не умеют думать, это просто подстановщики символов.
Даже если включить галочку Think или написать "представь, что ты доктор наук во всех областях с 100-летним стажем", это не подарит ему магическим образом разум.

Ну то есть, не глупо, а просто - преждевременно

Преждевременно, только если считать, что для существования интеллекта не нужно ничего, кроме оперирования символами. А если окажется, что нужно уметь что-то ещё, то тогда LLM могут быть составляющими ИИ, но никак не самим ИИ.

Для задач нашего мира нужен полноценный аналог зрительной коры и пространственно-временное мышление. Моделирование пространственно-временных отношений в уме - неотъемлимая часть мыслительного процесса человека. У LLM этого нет, и получаются перлы вроде примера с кроссовками выше. Почему человек отвечает сходу правильно? Потому что у него в голове возникают образы этих кроссовок, их пространственное взаимоотношение, и естественная идея поменять их местами.

Если под интеллектом понимать способность думать, то современные ИИ не обладают даже "рваным интеллектом". Никто не знает как человек мыслит и как смоделировать процесс мышления. А что такое сознание? Обязательно ли оно возникает в человеческом мозге? Необходимо ли для его появления научить младенца говорить "мама" или сознание появляется до этого?

Глупо вообще предполагать, что когда либо появится ИИ сопоставимый с интеллектом млекопитающих.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Глава Google DeepMind: глупо сравнивать современные ИИ с докторами наук