Комментарии 13

На самом деле весьма интересная железяка. Хотеть.
С выхода первого Portal хочу себе разумную GLaDOS вместо люстры, но ее возможности были ограничены технологиями того времени. Кажется эта коробочка вполне сойдет за ее будущие мозги.

А в чем преимущество по сравнению с уже имеющимся решением на Ryzen 395+ max 128GB ?
В отличие от решения нвидии тут полная совместимость со всем софтом

Только если нативная поддержка cuda.
До появления 385+/395+ это было действительно сильное предложение, но сейчас - уже не настолько интересно.

В том что там еще и GPU с памятью 128Gb работает, а не только CPU?
Но какая производительность этого GPU по сравнению со встройкой ryzen вопрос.

Встройке этого райзена можно выделить 96Гб под видеопамять из этих 128. Другое дело, что все нейронки адаптированы под Nvidia и завести что-то на AMD - нетривиальная задача
Унифицированная память имеет большую пропускную способность, чем через DRAM ходить, и задержки меньше

На этих райзен распаяная унифицированная память на шине 256-bit.

Пропускная способность 256 GB/s. В интернетах много отзывов с результатами реальных замеров в 120± GB/s, но эти бенчмарки по сути показывают скорость до CPU, а до NPU никаких ограничений нет. Если сравнивать с DGX Spark, то там полоса памяти 273 GB/s. В этом отношении разницы между ними практически нет.
Ryzen 395+: NPU ≈50 TOPS (FP8), DGX Spark: ≈250 TOPS на FP8 (вывел ориентировочно из официальной производительности в инференсе для разреженного FP4). Получается преимущество 5-ти кратное. По объёму моделей для 395+ потолок — 70B при ~61 токен/с, хотя на практике можно и до ~128B крутить с ~15 токен/с. У Nvidia DGX Spark потолок до ~200B, а скорость инференса на таких же моделях будет измеряться в сотнях токен/с. И в отличии от изолированного по сути писюка на 395+, Spark-и штатно масштабируются (есть два порта QSFP по 100 Гбит/с), без роутера можно соединить напрямую пару устройств и поднять потолок до ~405B (FP4). Не говоря уже о вариантах, когда есть 100Gbps-роутер (не диковинка — у меня в домашней лабе уже пару лет такой эксплуатируется (Mikrotik CRS504-4XQ-IN), покупал за ≈50 ты₽), а устройства могут быть на значительных расстояниях друг от друга.
На моей взгляд, девайс крайне интересный и это определённо win-win для производителя и приобретателей. Покупка или переделка видеокарт 4090 24→48G становится совершенно бессмысленной, у меня были планы переделать свою и докупить ещё одну, но теперь этот бюджет стоит попридержать, т.к. (даже без учёта имеющейся 4090!) в него прям ровно влезает DGX Spark.

Ryzen 395+: NPU ≈50 TOPS, DGX Spark: "до 1 PFLOP" (на FP4). Получается преимущество 20-ти кратное, теоретически. По объёму моделей для 395+ потолок — 70B при ~61 токен/с, хотя на практике можно и до ~128B крутить с ~15 токен/с. У Nvidia DGX Spark потолок до ~200B, а скорость инференса на таких же моделях будет измеряться сотнями токен/с.
Вся эта мощь может остаться не востребованной, если скорость памяти медленная, а у DGX она медленная, на уровне 4060ti. Первый обзор уже появился, и результаты пока не очень.
В Llama 3.1 70B скорость генерации 2.66 t/s в fp8, в GPT-OSS 120B - 11.66 t/s, у людей на Ryzen 395+ на вулкане выдает 49 t/s.
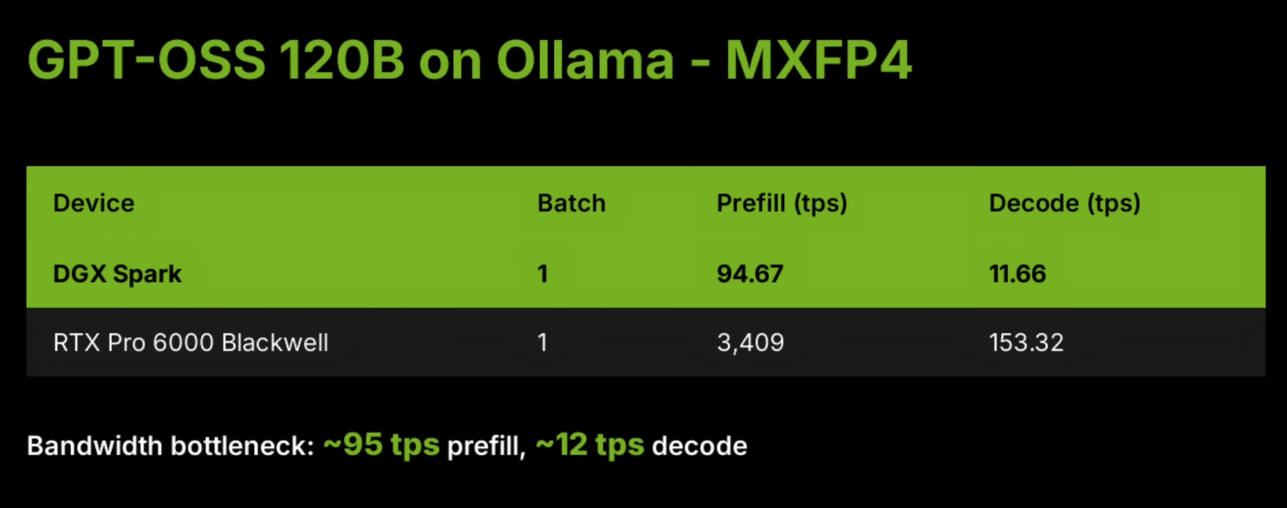
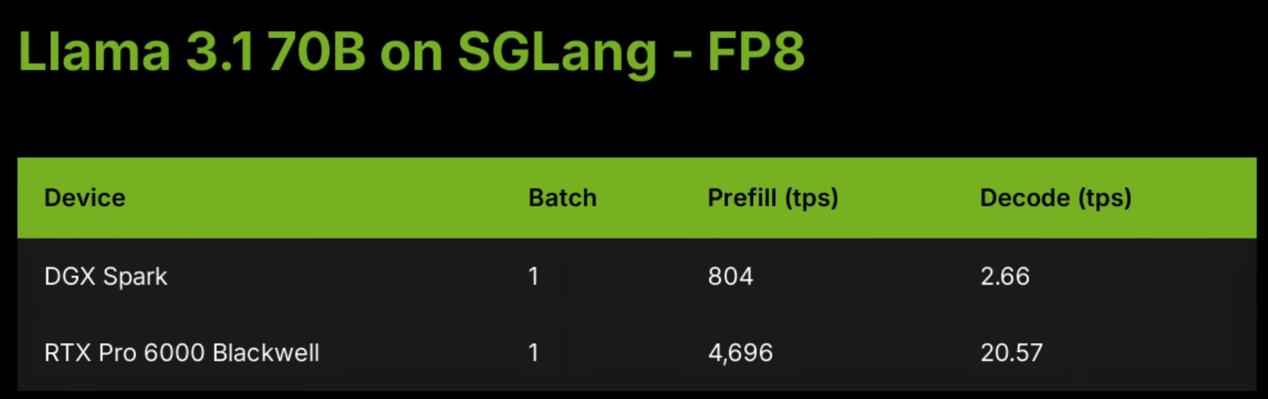
Хм, выглядит грустновато... Похоже на маркетинговый план "не отдавать всё сразу", а поэтапно двигаться от LPDDR5X → GDDR6 → GDDR6X → GDDR7 → …, выпуская каждые полгода новую модель ("2X Amazing Technology!") чтобы мы не расслаблялись!
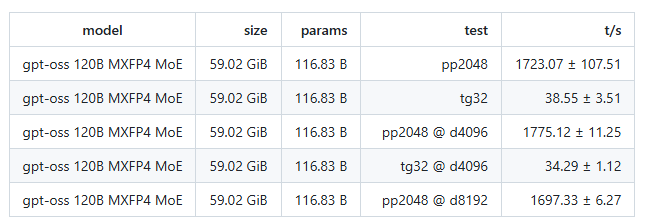
Обновленные данные с llama.cpp: https://github.com/ggml-org/llama.cpp/discussions/16578
Цифры стали лучше, как и ожидалось pp на cuda работает лучше чем на vulkan, но генерация всё равно упирается в скорость памяти.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
«Персональный ИИ-суперкомпьютер» от Nvidia поступит в продажу 15 октября