


Сегодня мы публикуем первую часть перевода материала, который посвящён созданию собственных синтаксических конструкций для JavaScript с использованием Babel.

Для начала давайте взглянем на то, чего мы добьёмся, добравшись до конца этого материала:
Мы собираемся реализовать синтаксическую конструкцию
В вышеприведённом примере при работе с функцией
Я выбрал именно последовательность символов
Для того чтобы добиться поставленной цели, нам нужно выполнить следующие действия:
Выглядит как нечто невозможное?
На самом деле, ничего страшного тут нет, мы вместе всё подробно разберём. Я надеюсь, что вы, когда это дочитаете, будете мастерски владеть тонкостями Babel.
Зайдите в репозиторий Babel на GitHub и нажмите на кнопку
Создание форка Babel (изображение в полном размере)
И, кстати, если только что вы впервые создали форк популярного опенсорсного проекта — примите поздравления!
Теперь клонируйте форк Babel на свой компьютер и подготовьте его к работе.
Сейчас позвольте мне в двух словах рассказать об организации репозитория Babel.
Babel использует монорепозиторий. Все пакеты (например —
Отмечу, что в Babel для автоматизации задач используется Makefile. При сборке проекта, выполняемой командой
Если вы не знакомы с такими понятиями, как «парсер» и «абстрактное синтаксическое дерево» (Abstract Syntax Tree, AST), то, прежде чем продолжать чтение, я настоятельно рекомендую вам взглянуть на этот материал.
Если очень кратко рассказать о том, что происходит при парсинге (синтаксическом анализе) кода, то получится следующее:
Вот отличный ресурс для тех, кто хочет больше узнать о компиляторах.
Если вы думаете, что «компилятор» — это что-то очень сложное и непонятное, то знайте, что на самом деле всё не так уж и таинственно. Компиляция — это просто парсинг кода и создание на его основе нового кода, который мы назовём XXX. XXX-код может быть представлен машинным кодом (пожалуй, именно машинный код — это то, что первым всплывает в сознании большинства из нас при мысли о компиляторе). Это может быть JavaScript-код, совместимый с устаревшими браузерами. Собственно, одной из основных функций Babel является компиляция современного JS-кода в код, понятный устаревшим браузерам.
Мы собираемся работать в папке
Мы уже говорили о токенизации и о парсинге. Найти код, реализующий эти процессы, можно в папках с соответствующими именами. В папке
Давайте решим нашу задачу, воспользовавшись техникой разработки через тестирование (Test-driven development, TDD). По-моему, легче всего сначала написать тест, а потом, постепенно работая над системой, сделать так, чтобы этот тест выполнялся бы без ошибок. Такой подход особенно хорош при работе в незнакомой кодовой базе. TDD упрощает понимание того, в какие места кода нужно внести изменения для реализации задуманного функционала.
Запуск теста для
Если вы обнаружите, что просмотр всех тестов занимает слишком много времени, то можете, для запуска нужного теста, вызвать
Наш парсер обнаружил 2 токена
Откуда я это узнал? Ответ на этот вопрос нам поможет найти использование режима мониторинга кода, запускаемого командой
Просмотр стека вызовов приводит нас к packages/babel-parser/src/parser/expression.js, где выбрасывается исключение
Добавим в этот файл пару команд логирования:
Как видно, оба токена — это
Как я узнал о том, что конструкции
Об этом я расскажу в разделе данного материала, посвящённом функциям
Прежде чем продолжать — давайте подведём краткие итоги:
А сейчас мы сделаем так, чтобы 2 символа
Для начала заглянем туда, где определяются типы токенов. Речь идёт о файле packages/babel-parser/src/tokenizer/types.js.
Тут можно найти список токенов. Добавим сюда и определение нового токена
Теперь давайте поищем то место кода, где, в процессе токенизации, создаются токены. Поиск последовательности символов
Теперь, в том случае, если после текущего символа
Если снова запустить тест — то можно заметить, что сведения о текущем и следующем токенах изменились:
Это уже выглядит довольно-таки неплохо. Продолжим работу.
Прежде чем двигаться дальше — взглянем на то, как функции-генераторы представлены в AST.
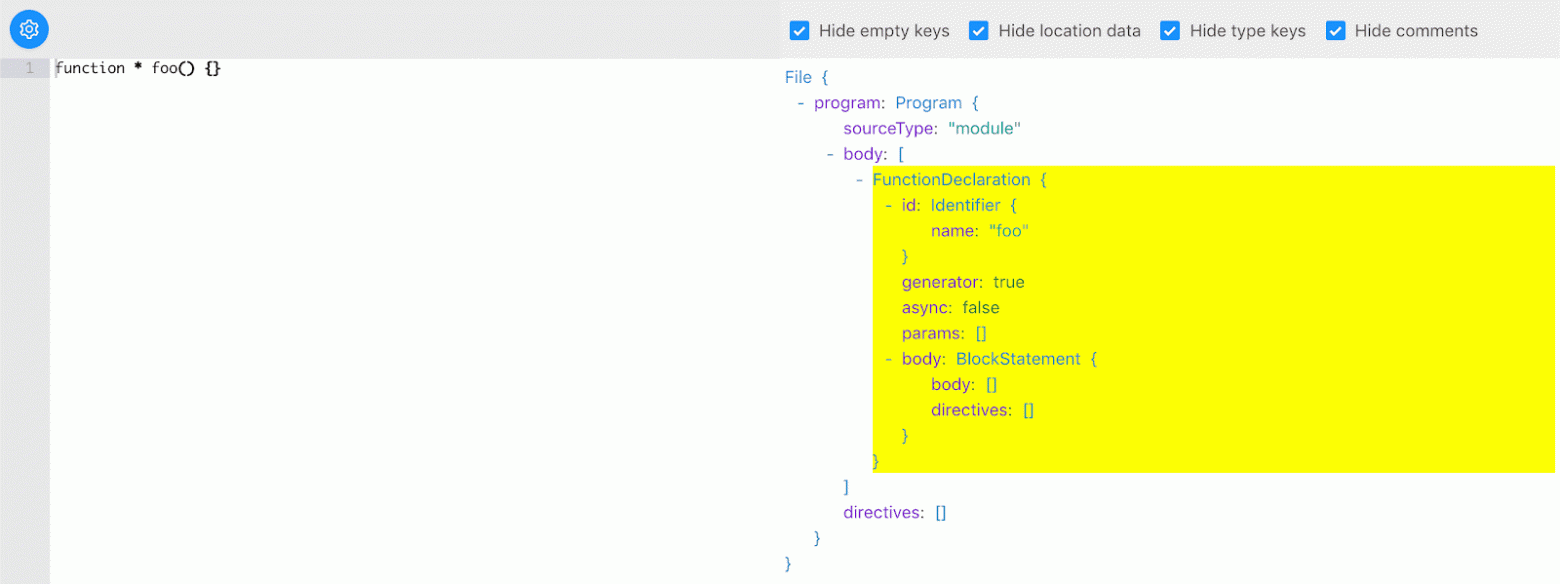
AST для функции-генератора (изображение в полном размере)
Как видите, на то, что это — функция-генератор, указывает атрибут
Мы можем применить аналогичный подход для описания функции, поддерживающей каррирование. А именно, мы можем добавить к
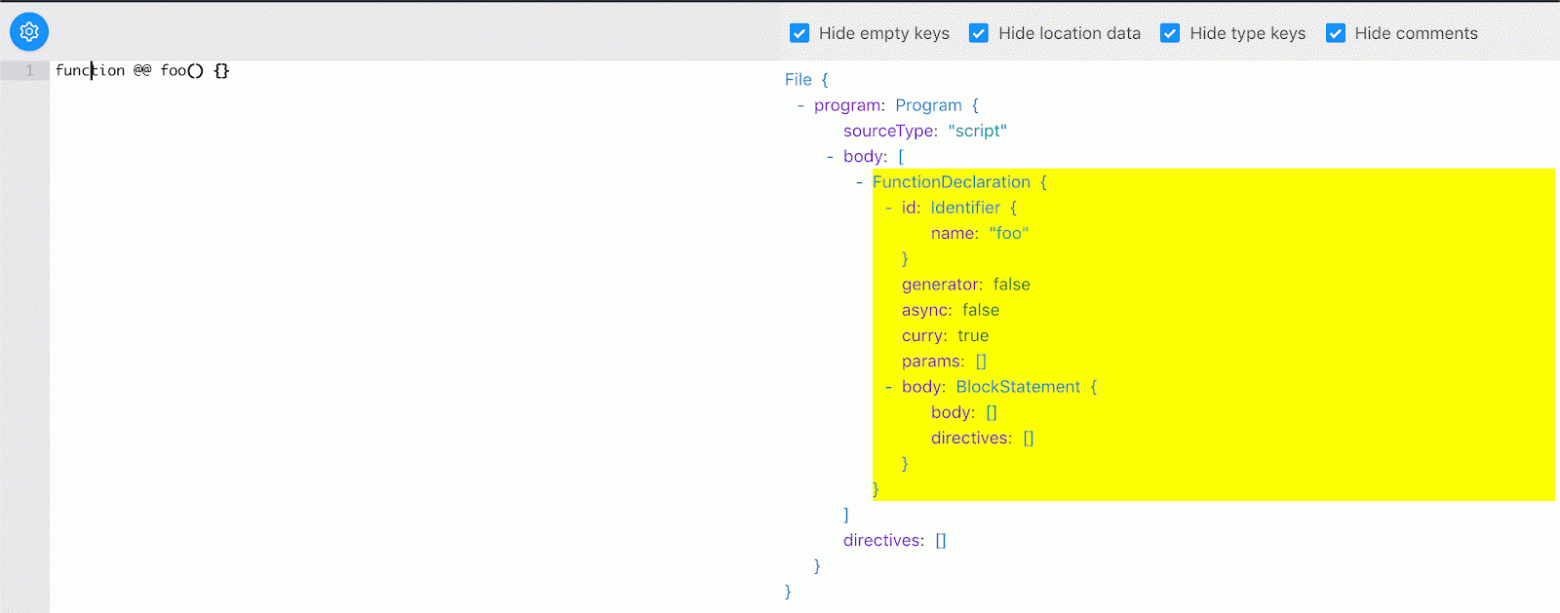
AST для функции, поддерживающей каррирование (изображение в полном размере)
Собственно говоря, теперь у нас есть план. Займёмся его реализацией.
Если поискать в коде по слову
Если мы снова запустим тест, то нас будет ждать приятная неожиданность. Код успешно проходит тестирование!
И это всё? Что мы такого сделали, чтобы тест чудесным образом оказался пройденным?
Для того чтобы это выяснить — давайте поговорим о том, как работает парсинг. В процессе этого разговора, надеюсь, вы поймёте то, как подействовала на Babel строчка
Продолжение следует…
Уважаемые читатели! Используете ли вы Babel?

Обзор
Для начала давайте взглянем на то, чего мы добьёмся, добравшись до конца этого материала:
// конструкция '@@' оснащает функцию `foo` возможностями каррирования
function @@ foo(a, b, c) {
  return a + b + c;
}
console.log(foo(1, 2)(3)); // 6
Мы собираемся реализовать синтаксическую конструкцию
@@, которая позволяет каррировать функции. Этот синтаксис похож на тот, что используется для создания функций-генераторов, но в нашем случае вместо знака * между ключевым словом function и именем функции размещается последовательность символов @@. В результате при объявлении функций можно использовать конструкцию вида function @@ name(arg1, arg2).В вышеприведённом примере при работе с функцией
foo можно воспользоваться её частичным применением. Вызов функции foo с передачей ей такого количества параметров, которое меньше чем количество необходимых ей аргументов, приведёт к возврату новой функции, способной принять оставшиеся аргументы:foo(1, 2, 3); // 6 const bar = foo(1, 2); // (n) => 1 + 2 + n bar(3); // 6
Я выбрал именно последовательность символов
@@ потому, что в именах переменных нельзя использовать символ @. Это значит, что синтаксически корректной окажется и конструкция вида function@@foo(){}. Кроме того, «оператор» @ применяется для функций-декораторов, а мне хотелось использовать что-то совершенно новое. В результате я и выбрал конструкцию @@.Для того чтобы добиться поставленной цели, нам нужно выполнить следующие действия:
- Создать форк парсера Babel.
- Создать собственный плагин Babel для трансформации кода.
Выглядит как нечто невозможное?
На самом деле, ничего страшного тут нет, мы вместе всё подробно разберём. Я надеюсь, что вы, когда это дочитаете, будете мастерски владеть тонкостями Babel.
Создание форка Babel
Зайдите в репозиторий Babel на GitHub и нажмите на кнопку
Fork, которая находится в левой верхней части страницы.Создание форка Babel (изображение в полном размере)
И, кстати, если только что вы впервые создали форк популярного опенсорсного проекта — примите поздравления!
Теперь клонируйте форк Babel на свой компьютер и подготовьте его к работе.
$ git clone https://github.com/tanhauhau/babel.git

# set up
$ cd babel
$ make bootstrap
$ make build
Сейчас позвольте мне в двух словах рассказать об организации репозитория Babel.
Babel использует монорепозиторий. Все пакеты (например —
@babel/core, @babel/parser, @babel/plugin-transform-react-jsx и так далее) расположены в папке packages/. Выглядит это так:- doc - packages - babel-core - babel-parser - babel-plugin-transform-react-jsx - ... - Gulpfile.js - Makefile - ...
Отмечу, что в Babel для автоматизации задач используется Makefile. При сборке проекта, выполняемой командой
make build, в качестве менеджера задач используется Gulp.Краткий курс по преобразованию кода в AST
Если вы не знакомы с такими понятиями, как «парсер» и «абстрактное синтаксическое дерево» (Abstract Syntax Tree, AST), то, прежде чем продолжать чтение, я настоятельно рекомендую вам взглянуть на этот материал.
Если очень кратко рассказать о том, что происходит при парсинге (синтаксическом анализе) кода, то получится следующее:
- Код, представленный в виде строки (тип
string), выглядит как длинный список символов:f, u, n, c, t, i, o, n, , @, @, f, ... - В самом начале Babel выполняет токенизацию кода. На этом шаге Babel просматривает код и создаёт токены. Например — нечто вроде
function, @@, foo, (, a, ... - Затем токены пропускают через парсер для их синтаксического анализа. Здесь Babel, на основе спецификации языка JavaScript, создаёт абстрактное синтаксическое дерево.
Вот отличный ресурс для тех, кто хочет больше узнать о компиляторах.
Если вы думаете, что «компилятор» — это что-то очень сложное и непонятное, то знайте, что на самом деле всё не так уж и таинственно. Компиляция — это просто парсинг кода и создание на его основе нового кода, который мы назовём XXX. XXX-код может быть представлен машинным кодом (пожалуй, именно машинный код — это то, что первым всплывает в сознании большинства из нас при мысли о компиляторе). Это может быть JavaScript-код, совместимый с устаревшими браузерами. Собственно, одной из основных функций Babel является компиляция современного JS-кода в код, понятный устаревшим браузерам.
Разработка собственного парсера для Babel
Мы собираемся работать в папке
packages/babel-parser/:- src/ - tokenizer/ - parser/ - plugins/ - jsx/ - typescript/ - flow/ - ... - test/
Мы уже говорили о токенизации и о парсинге. Найти код, реализующий эти процессы, можно в папках с соответствующими именами. В папке
plugins/ содержатся плагины (подключаемые модули), которые расширяют возможности базового парсера и добавляют в систему поддержку дополнительных синтаксисов. Именно так, например, реализована поддержка jsx и flow.Давайте решим нашу задачу, воспользовавшись техникой разработки через тестирование (Test-driven development, TDD). По-моему, легче всего сначала написать тест, а потом, постепенно работая над системой, сделать так, чтобы этот тест выполнялся бы без ошибок. Такой подход особенно хорош при работе в незнакомой кодовой базе. TDD упрощает понимание того, в какие места кода нужно внести изменения для реализации задуманного функционала.
packages/babel-parser/test/curry-function.js

import { parse } from '../lib';

function getParser(code) {
  return () => parse(code, { sourceType: 'module' });
}

describe('curry function syntax', function() {
  it('should parse', function() {
    expect(getParser(`function @@ foo() {}`)()).toMatchSnapshot();
  });
});
Запуск теста для
babel-parser можно выполнить так: TEST_ONLY=babel-parser TEST_GREP="curry function" make test-only. Это позволит увидеть ошибки:SyntaxError: Unexpected token (1:9) at Parser.raise (packages/babel-parser/src/parser/location.js:39:63) at Parser.raise [as unexpected] (packages/babel-parser/src/parser/util.js:133:16) at Parser.unexpected [as parseIdentifierName] (packages/babel-parser/src/parser/expression.js:2090:18) at Parser.parseIdentifierName [as parseIdentifier] (packages/babel-parser/src/parser/expression.js:2052:23) at Parser.parseIdentifier (packages/babel-parser/src/parser/statement.js:1096:52)
Если вы обнаружите, что просмотр всех тестов занимает слишком много времени, то можете, для запуска нужного теста, вызвать
jest напрямую:BABEL_ENV=test node_modules/.bin/jest -u packages/babel-parser/test/curry-function.js
Наш парсер обнаружил 2 токена
@, вроде бы совершенно невинных, там, где их быть не должно.Откуда я это узнал? Ответ на этот вопрос нам поможет найти использование режима мониторинга кода, запускаемого командой
make watch.Просмотр стека вызовов приводит нас к packages/babel-parser/src/parser/expression.js, где выбрасывается исключение
this.unexpected().Добавим в этот файл пару команд логирования:
packages/babel-parser/src/parser/expression.js

parseIdentifierName(pos: number, liberal?: boolean): string {
  if (this.match(tt.name)) {
    // ...
  } else {
    console.log(this.state.type); // текущий токен
    console.log(this.lookahead().type); // следующий токен
    throw this.unexpected();
  }
}
Как видно, оба токена — это
@:TokenType { label: '@', // ... }
Как я узнал о том, что конструкции
this.state.type и this.lookahead().type дадут мне текущий и следующий токены?Об этом я расскажу в разделе данного материала, посвящённом функциям
this.eat, this.match и this.next.Прежде чем продолжать — давайте подведём краткие итоги:
- Мы написали тест для
babel-parser. - Мы запустили тест с помощью
make test-only. - Мы воспользовались режимом мониторинга кода с помощью
make watch. - Мы узнали о состоянии парсера и вывели в консоль сведения о типе текущего токена (
this.state.type).
А сейчас мы сделаем так, чтобы 2 символа
@ воспринимались бы не как отдельные токены, а как новый токен @@, тот, который мы решили использовать для каррирования функций.Новый токен: «@@»
Для начала заглянем туда, где определяются типы токенов. Речь идёт о файле packages/babel-parser/src/tokenizer/types.js.
Тут можно найти список токенов. Добавим сюда и определение нового токена
atat:packages/babel-parser/src/tokenizer/types.js export const types: { [name: string]: TokenType } = { // ... at: new TokenType('@'), atat: new TokenType('@@'), };
Теперь давайте поищем то место кода, где, в процессе токенизации, создаются токены. Поиск последовательности символов
tt.at в babel-parser/src/tokenizer приводит нас к файлу: packages/babel-parser/src/tokenizer/index.js. В babel-parser типы токенов импортируются как tt.Теперь, в том случае, если после текущего символа
@ идёт ещё один @, создадим новый токен tt.atat вместо токена tt.at:packages/babel-parser/src/tokenizer/index.js getTokenFromCode(code: number): void { switch (code) { // ... case charCodes.atSign: // если следующий символ - это `@` if (this.input.charCodeAt(this.state.pos + 1) === charCodes.atSign) { // создадим `tt.atat` вместо `tt.at` this.finishOp(tt.atat, 2); } else { this.finishOp(tt.at, 1); } return; // ... } }
Если снова запустить тест — то можно заметить, что сведения о текущем и следующем токенах изменились:
// текущий токен
TokenType {
  label: '@@',
  // ...
}

// следующий токен
TokenType {
  label: 'name',
  // ...
}
Это уже выглядит довольно-таки неплохо. Продолжим работу.
Новый парсер
Прежде чем двигаться дальше — взглянем на то, как функции-генераторы представлены в AST.
AST для функции-генератора (изображение в полном размере)
Как видите, на то, что это — функция-генератор, указывает атрибут
generator: true сущности FunctionDeclaration.Мы можем применить аналогичный подход для описания функции, поддерживающей каррирование. А именно, мы можем добавить к
FunctionDeclaration атрибут curry: true.AST для функции, поддерживающей каррирование (изображение в полном размере)
Собственно говоря, теперь у нас есть план. Займёмся его реализацией.
Если поискать в коде по слову
FunctionDeclaration — можно выйти на функцию parseFunction, которая объявлена в packages/babel-parser/src/parser/statement.js. Здесь можно найти строку, в которой устанавливается атрибут generator. Добавим в код ещё одну строку:packages/babel-parser/src/parser/statement.js export default class StatementParser extends ExpressionParser { // ... parseFunction<T: N.NormalFunction>( node: T, statement?: number = FUNC_NO_FLAGS, isAsync?: boolean = false ): T { // ... node.generator = this.eat(tt.star); node.curry = this.eat(tt.atat); } }
Если мы снова запустим тест, то нас будет ждать приятная неожиданность. Код успешно проходит тестирование!
PASS  packages/babel-parser/test/curry-function.js
  curry function syntax
    ✓ should parse (12ms)
И это всё? Что мы такого сделали, чтобы тест чудесным образом оказался пройденным?
Для того чтобы это выяснить — давайте поговорим о том, как работает парсинг. В процессе этого разговора, надеюсь, вы поймёте то, как подействовала на Babel строчка
node.curry = this.eat(tt.atat);.Продолжение следует…
Уважаемые читатели! Используете ли вы Babel?


