Обновить
-6
Алексей@java3000

Администратор windows умеющий в программирование

Отправить сообщение

Правильный дизайн API: что такое «один», «много», «нуль» и «ничто»

Время на прочтение9 мин
Охват и читатели21K
Здравствуйте, наши постоянные и эпизодические читатели.

Сегодня хотим предложить вам интересную статью о дизайне API и связанных с этим подводных камнях. Не спрашивайте, как мы на нее набрели, творческий поиск — дело очень нелинейное.

Приятного чтения
Читать дальше →

Написание бота для мессенджера Tox

Время на прочтение12 мин
Охват и читатели20K
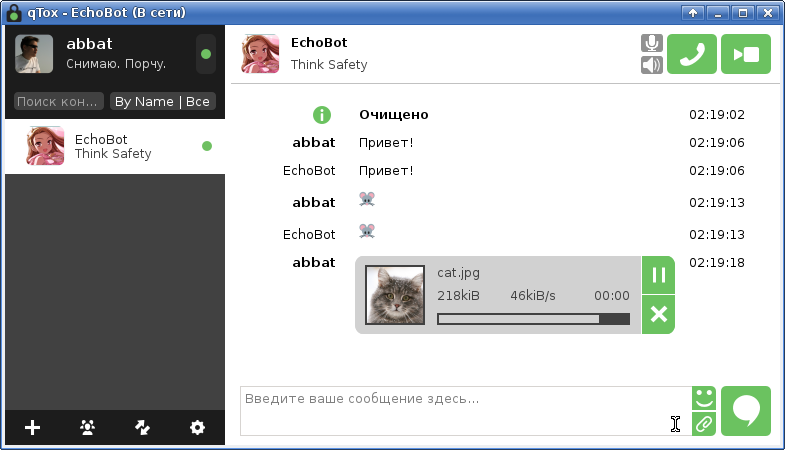
На фоне общей увлеченности созданием ботов для Telegram я бы хотел рассказать об API не очень широко известного мессенджера Tox и показать на примере простого echo-бота, как можно так же легко и быстро создавать собственных.

image

Читать дальше →

Insider API: поиск трендов и быстрая навигация в текстах соц. и традиционных медиа

Время на прочтение2 мин
Охват и читатели2.8K
Как часто, имея массив текстов (любой тематики) мы хотим увидеть тематическую выжимку? Какие темы обсуждаются? Какие наиболее популярные? Как было бы здорово ввести поисковые слова и получить тренды вокруг них!
image
Читать дальше →

Практики успешной монетизации API на базе Azure API Management

Время на прочтение6 мин
Охват и читатели9.8K
Всем привет!
Сегодня хотим обсудить тему управления API. Когда имеет смысл открывать свой API, кто имеет возможность монетизировать свой API и как внедрить систему API менеджмента, чтобы затраты, как на начальное внедрение, так и на его эксплуатацию были минимальны.


Мы хотим поделиться своим опытом разработки системы управления API на базе Azure API Management. Давайте начнем с самого начала.
Читать дальше →

Открытие API для работы с услугами от российского лоукост-хостера (часть 1)

Время на прочтение5 мин
Охват и читатели10K
После продолжительной паузы мы собрались с мыслями и решили подготовить небольшой цикл статей, которые будут полезны как разработчикам, так и обычным нашим клиентам, кому потребуется заказывать больше одной услуги за один раз.


Предпосылки к этой публикации появились достаточно давно. Один из клиентов с большим количеством виртуальных серверов поинтересовался о том, есть ли возможность работать с API нашего биллинга. В то время, честно говоря, мы были не готовы к такому диалогу и не смогли предложить готовое решение.
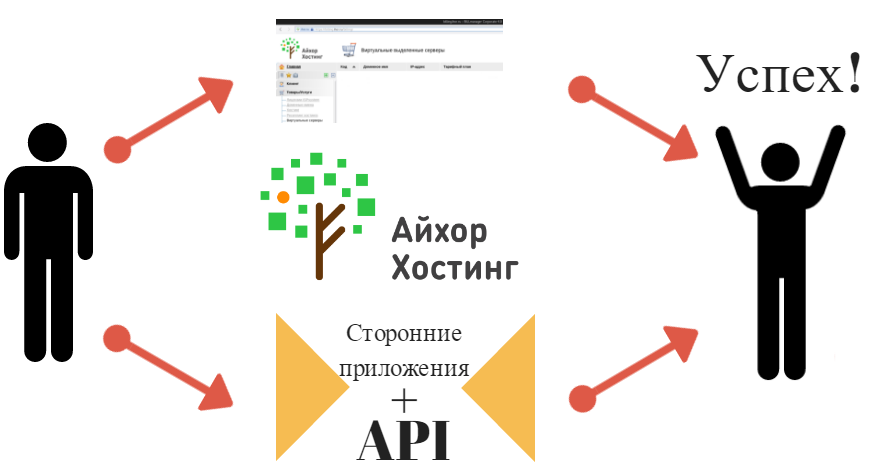
С начала лета мы получили еще несколько подобных вопросов и поняли, что нельзя оставлять их без ответов. И сегодня я расскажу как работать с API биллинга нашей компании для заказа виртуальных серверов любого количества.
Читать дальше →

Open API Ivideon: первые шаги

Время на прочтение8 мин
Охват и читатели18K

Как же быстро время пролетело: наш предыдущий пост вышел на Хабре 2 года назад. Когда молчишь так долго, ты либо мертв, либо усердно работаешь, чтобы в один момент взорваться новостями и поведать что-то стоящее.

Если вы не знаете, кто мы, то объясним в четырех словах: сервис видеонаблюдения через Интернет. За остальными подробностями отсылаем к самой первой статье.

Вот и в Ivideon занимались стоящим проектом – Open API. Да, это открытый API, позволяющий нашим клиентам и партнерам упростить и автоматизировать взаимодействие с нашим сервисом. И даже создавать новые продукты!

Проект пока что находится на стадии бета-тестирования, но вы, если желаете, можете попробовать API. Подробнее об этом расскажем в конце статьи.

Читать дальше →

Spring без XML. Часть 1

Время на прочтение23 мин
Охват и читатели50K
Привет, хабрахабр!

На данный момент тут уже довольно много гайдов по такой связке, но они на мой взгляд во-первых немного устаревшие, во вторых — я считаю что должен быть гайд как сделать что-то осязаемое но простое, чтобы показать что и такое возможно.

Итак, если вам хочется попробовать Spring MVC с сохранением в базе и 0(нулем) файлов xml-конфигураций, прошу под кат!


Конечно хотелось бы сразу запустить приложение, но сначала немного подготовимся.

1. Подготовка к запуску


1.1 IDE


Вся разработка будет вестись на Intellij IDEA, но не думаю что реализация в другой IDE будет сильно сложнее.
Читать дальше →

Spring без XML. Часть 2

Время на прочтение9 мин
Охват и читатели20K
И снова день добрый. Пост в продолжение публикации «Spring + Java EE + Persistence, без XML. Часть 1».


1. Введение


1.1 Подгружаем проект


Если вы хотите с этой части начать, либо не осталось проекта сделанного в предыдущей части, можете скачать его с github.
Схема простая:
  • Заходите из консоли в папку с проектами IDEA
  • git clone github.com/MaxPovver/ForHabrahabr.git
  • cd ForHabrahabr/
  • git checkout withauth
  • Готово, теперь можете грузить проект в студию так же как описано в первой части.

1.2 Что мы будем делать в этой части?


В этой части мы рассмотрим как хранятся отношения многие-ко-многим на уровне объектов сущностей;
доделаем распределения прав пользователям;
сделаем простейший REST-controller;
сделаем регистрацию новых пользователей (только для админа);
и все это без XML.
Читать дальше →

Compalex: сравнение схем двух баз данных

Время на прочтение3 мин
Охват и читатели38K
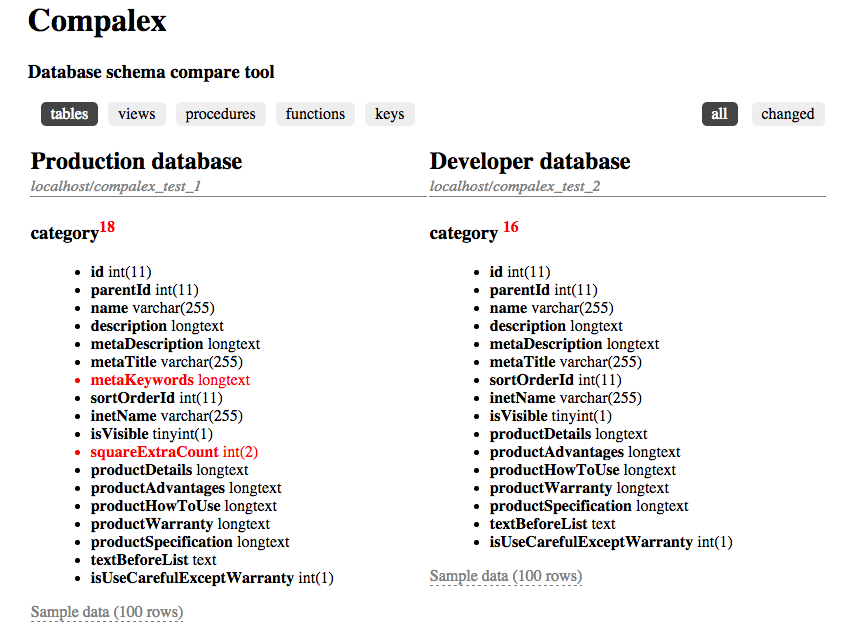
Предположим, у вас есть prod и test базы данных. В какой-то момент разработчик внес изменения в тестовую базу, но забыл внести эти изменения в боевую базу. Если это часто используемая таблица, то ситуация очень быстро становится очевидной, так как в логах появятся ошибки в SQL-запросах и вам начинает звонить начальник с упреками «какого @#$%».

Но иногда изменения затрагивают редко используемые таблицы, либо изменения на первый взгляд не совсем очевидны (например, кто-то изменил длину поля VARCHAR и у вас стали обрезаться строки, или кто-то добавил индекс, из-за которого запросы на тестовой базе выполняются на порядок быстрее).

Еще вариант — вы провели обновление ПО и у вас все перестало работать. Куча непонятных ошибок на пустом месте, приложение лежит, пользователи не довольны.

В таких случаях бывает очень полезно посмотреть чем же отличаются базы и сделать соответствующие выводы.


Читать дальше →

Поиск недействительных паспортов или учимся готовить бинарные файлы

Время на прочтение4 мин
Охват и читатели14K
В комментариях к публикации Почему Go превосходит посредственность, один из хабраюзеров предложил в качестве примера написать алгоритм поиска по списку недействительных паспортов.
Одним из условий задачи было — не использовать для этой цели СУБД. Также решение должно по минимуму использовать память, место на диске и ЦП.

К своему удивлению обнаружил, что большинство комментаторов предлагали всё же использовать СУБД, несмотря на то, что решение, использующее стандартные базы данных будет весьма громоздким (кроме того, что для самих данных нужно использовать минимум 5 байт на запись, так ещё и почти столько же места на индексы).

Имея опыт работы над бинарными базами для Sypex Geo, я решил попробовать набросать формат бинарного файла и алгоритм поиска по нему.
Читать дальше →

Статистика арбитражной системы. Открытые данные

Время на прочтение2 мин
Охват и читатели9.8K
image

Важным компонентом деятельности любого государства является арбитражная система. От качества ее функционирования зависит слаженность работы всей экономики страны. Ведь именно в арбитражных судах решается судьба крупных и мелких предприятий, принимаются основополагающие решения, которые формируют судебную практику по таким важным вопросам как: взыскание обязательных платежей и санкций, оспаривание административной ответственности, банкротные дела и корпоративные споры.

Однако, как оценить качество работы арбитражных судов? Как увидеть слабые места? Как спрогнозировать возможные проблемы?


Чтобы специалисты, журналисты и участники процесса могли ответить на эти вопросы мы создали сервис статистики работы арбитражных судов — открытые данных арбитражной системы.

Что можно узнать из этих данных?

Читать дальше →

Открытые данные электоральной статистики России

Время на прочтение2 мин
Охват и читатели2.4K
Некоммерческая организация ГОЛОС занимающаяся мониторингом выборов в России буквально вот только что открыла сайт электоральной статистики в нашей стране — stat.golos.org

Всего в их базе 36 834 записи о выборах на всех уровнях власти — от федерального до местного самоуправления, по всем регионам и начиная с 2003 года.

Огромный объем работы наконец-то доступный онлайн. Данные по весьма чувствительной теме под названием «выборы». Причем данные официальные, наконец-то, извлеченные из сайта Центризбиркома и представленные в форме пригодной для повторного использования как открытые данные.

И у каждого из выборов есть ссылка на CSV файл с описанием. Который можно выгрузить, загрузить в Excel, загрузить в любимую базу данных, построить инфографику, сделать свой региональный проект, сделать проект по собственному муниципалитету и многое другое.

Скриншот главной страницы:
image
Читать дальше →

О том как создаются и финансируются общественные проекты в области e-Government

Время на прочтение6 мин
Охват и читатели6.5K
Несколько раз я уже поднимал эту тему — о том как именно создаются и финансируются различные гражданские и общественные проекты, на сей раз я эту тему разберу подробнее и опишу с примерами то как это происходит в мире и в России.

Как создаются такие проекты и на какие деньги?


Два эти вопроса столь тесно переплетены, что связаны неразрывно. От того как именно проекты создаются, кто является их инициатором сильно зависит то откуда они получают финансирование, если оно вообще оказывается необходимым. Проекты бывают очень разными. Простым и сложными. Созданными одним человеком и сотней волонтеров. Основанные на краудсорсинге и краудфандинге. Конечно, на открытых данных и не только. Однако все они поддаются четкой категоризации.

Проекты можно разделить на следующие группы:

— проекты на гранты некоммерческих организаций (в пределах страны);

— проекты созданные на гранты международных организаций;

— проекты созданные по государственному заказу;

— проекты созданные существующими некоммерческими организациями для поддержки своей деятельности;

— коммерческие проекты;

— персональные «проекты-порывы» от инициативных граждан;

— краудфандинг

— медийные проекты созданные СМИ

А также по каждому из подходов расскажу подробнее.
Читать дальше →

Реестр стационарных объектов наблюдения (комплексы ФВФ)

Время на прочтение2 мин
Охват и читатели9.1K
image

Для жителей Москвы на сайте www.data.mos.ru есть официальный список камер фото и видео регистрации ПДД. На вкладке «Для разработчиков» находится описание полей. Всю базу можно выгрузить в формате CVS.

www.data.mos.ru/datasets/621_reestr_statsionarnyh_obektov_nablyudeniya_kompleksy_fvf

На портале «Открытые данные» опубликована информация о 600 с лишним стационарных комплексах фото и видео фиксации нарушений ПДД, установленных на дорогах столицы. Данные доступны в виде таблицы, по которой автовладельцы смогут проверить свой обычный маршрут, а также доступны для выгрузки в формате CVS, который могут использовать разработчики для создания приложений, например, предупреждающих водителя о необходимости снизить скорость на определенном участке дороги (эдакие самописные радар-детекторы).
Читать дальше →

Конкурс приложений на открытых данных полиции

Время на прочтение1 мин
Охват и читатели8.2K
Друзья!

Как многие, наверняка, помнят мы каждый год проводим конкурс Apps4Russia с призами, партнерами и классными приложениями которые делают люди на открытых данных и не только — в этому году мы тоже, обязательно его проведем, анонс широкий и большой будет уже вот-вот как скоро. Но я не буду забегать вперед — все будет.

Однако, кроме нашего большого проекта конкурса, мы занимаемся и другими интересными и большими проектами одним из которых является проект «Открытая Полиция» (http://www.openpolice.ru)

И, в рамках этого проекта, мы проводим еще один конкурс — тем кому не терпится сразу идите по ссылке — www.openpolice.ru/contest . Небольшой по времени — всего 2 месяца, отличный по содержанию — у нас очень много открытых данных собрано тут — data.openpolice.ru и доступно через API — api.openpolice.ru

Читать дальше →

Открытое правительство и все остальные госструктуры как платформы

Время на прочтение2 мин
Охват и читатели4.3K
Давайте ка я порассуждаю вслух.

Настоящее Открытое Правительство

Я считаю что самое настоящее Открытое Правительство буквальном значении — это API к сайту government.ru. Сделать его несложно, важно, нужно и можно. Но никто не сделал до сих пор. Идеально — если это сделает аппарат пр-ва, неидеально — это мы сами парсим его и делаем API. Я знаю как сделать второе и вообще-то мне ничто не мешает это сделать. И даже больше я — это сделаю, желательно, причем не своими руками — на все просто рук не хватит. Нужен квалифицированный разработчик желающий это сделать — бесплатно или за деньги.

Задача разбивается на 4 шага:
1. Провести анализ данных на сайте — набросать модели данных и архитектуру решения.
2. Распарсить данные на сайте согласно моделям и настроить регулярное обновление данных. Данные загрузить в NoSQL базу типа MongoDB или CouchDB
3. Сделать API веб-сервиса по предоставлению данных в JSON (возможно и в XML)
4. Сделать описание API.

Что дальше?

А дальше используем этот бесценный ресурс как тренировочного зверька для разработчиков мобильных и любых иных приложений.
Читать дальше →

Открытые данные, Росстат, Прокуратура и все-все-все

Время на прочтение2 мин
Охват и читатели16K
Вчера вечером, 11 апреля, завершилось заседание совета по открытым данным.

Оно шло весьма насыщенно и активно. Я о многом подробно рассказал вот тут, но, конечно, там не все.

У меня из-за долгого накопленного опыта бодания с различными ведомствами накопилось немало неконструктивного в адрес ряда из них, но неконструктивное делу открытых данных не помогает.

Так что не только ругаем, но и в чем-то хвалим, а если ругаем то с предложениями как и что исправить.

Вначале о самом главном:

1. Открытые данные стали состоявшимся трендом.

Что бы дальше не происходило — ими будут заниматься, их будут раскрывать, регионы будут поднимать их на флагшток, а федеральные ведомства бодаться за возможности, полномочия и то кто и что лучше понимает по этой теме. Это очень важно — когда в какой-то теме появляется конкуренция — значит она живая.
Читать дальше →

Неочевидное использование открытых данных

Время на прочтение5 мин
Охват и читатели23K
Я думал стоит ли писать этот пост или нет, потом решил что всё таки стоит —

Еще до того как я занялся плотно открытыми данными, я довольно много лет занимался и занимаюсь сейчас различными задачами по классификации, анализу текстов, полуструктурированных данных, очистке и обогащению данных.

Например, довольно давно еще я сделал алгоритм автоматического разбора ФИО в любом написании, определения пола и, возможно, этноса. Это не самая сложная задача, я привожу её не как нечто выдающееся, а как нечто рутинное и типовое. Однако решение этой, довольно типовой задачи, Вопрос в том как решать это нечто типовое.

И вот тут то и пригодились открытые данные.

Однако начну с начала.
Читать дальше →

Открытые данные из существующих государственных порталов

Время на прочтение4 мин
Охват и читатели16K

Когда мы говорим про открытые данные которые государственные органы должны раскрывать, мы, чаще всего, сталкиваемся с тем что данных в нужной нам форме нет. Или, по крайней мере, так утверждают те кто должен вести базы данных и реестры создаваемые государством.

И действительно, есть данные которых, скорее всего, просто не существует, например данее по границам участков почтовых отделений. В мире, например в переписи открытых данных Open Knowledge Foundation это один из важных наборов данных, но полноценно отсутствующий в России.

Но есть и другая сторона этой медали. Есть уже созданные государственные порталы и проекты в которых собраны большие базы данных недоступные в машиночитаемом виде для граждан. И это именно тот случай когда чиновники не могут сказать что данных нет, вопрос лишь в качестве данных и их доступности в удобном виде.

Далее я буду писать только о тех порталах и проектах что созданы и поддерживаются на государственные деньги. И тех которые содержат немало полезной информации.

ОБД Мемориал


Ссылка: http://obd-memorial.ru

С сайта мы можем узнать что:
На сегодняшний день в ОБД введено 13,7 млн. цифровых копий документов о безвозвратных потерях периода Великой Отечественной войны из 38 тыс. архивных дел ЦА МО РФ, ЦВМА, РГВА, ГА РФ, региональных архивов Росархива и 42,2 тыс. паспортов воинских захоронений существующих мест воинских захоронений в Российской Федерации и за ее пределами.

Дополнительно в ОБД загружено более 1000 томов Книги Памяти.

Всего в ОБД около 29 млн. записей из архивных документов (не путать с общим числом боевых потерь — 8,67 млн. чел.) и около 10 млн. записей из Книги Памяти.


Иначе говоря за государственный счет была проведена маштабнейшая работа по оцифровке данных и переводе их в базу данных онлайн, но при этом не предоставлено ни одного интерфейса для работы с данными — ни дампов базы, ни API с REST+JSON, ничего другого что позволило бы вести аналитическую работу над данными.

Зачем это нужно? То что не сделало государство — могут сделать желающие волонтеры и разработчики проведя геокодирование данных, создавая мобильные приложения и региональные проекты посвященные Великой отечественной войне.

Читать дальше →

Совет по открытым данным: террабайты Минкультуры, выше в рейтинге G8 и о том куда идет Минэкономразвития

Время на прочтение3 мин
Охват и читатели7K

21 октября выдался днём богатым на общественные мероприятия, об одном из них, заседании общественного совета при Росстате, я писал ранее. А вот про Совет по открытым данным вполне можно поговорить подробнее.

Прежде чем я перескажу всё своими словами — посмотрите на официальную новость там какие-то из вопросов раскрыты, а какие то я расскажу сейчас.

Итак, было 3 большие темы:
1. Открытые данные Минкультуры
2. Выполнение Россией требований хартии G8
3. Техтребования на портал открытых данных от Минэкономразвития России

Открытые данные Минкультуры


Выступал Михаил Городилов из Минкультуры и, если кратко, то его выступление можно свести к следующим тезисам:
  1. «Мы открыты» Они только-только начали открывать данные открытые данные и что-то уже разместили на сайте Минкультуры — mkrf.ru/opendata/
  2. «Цифровой контент — это тоже данные» Обещают очень много данных цифрового контента и то что планируют оцифровывать и создавать до 280 террабайт в год
  3. «Мы хотим денег» Это прозвучало совершенно недвусмысленно, о том что Минкультуры хочет чтобы работы по созданию ими открытых данных в том числе из цифрового контента были профинансированы из госпрограммы «Информационное общество».
  4. «Мы хотим чтобы бизнес платил» Посыл также очень простой. Чтобы бизнес который потенциально использовал бы их данные далее бы тоже участвовал в финансировании их создания. Прозрачно намекалось на Яндекс и Гугл и другие крупные интернет-холдинги


Вот такие нехитрые мысли прозвучали от Минкультуры. При этом у них, на самом деле, много есть данных которые давно пора открыть, но до сих пор ничего из них они не разместили. Ни государственный реестр фильмов, ни базу по культурному наследию, ни многое другое. Позиция та же что и у Росстата, только понимания пока еще меньше.

Дадут ли им денег? Не знаю. В этом году всем Минфин обрезает финансирование и не дает денег на новые инициативы. Надо ли их дожимать открывать то что уже есть? Я считаю что надо.

Хартия G8


Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Москва, Москва и Московская обл., Россия
Дата рождения
Зарегистрирован
Активность

Специализация

Десктоп разработчик, Администратор серверов
Младший
От 110 000 ₽
Java
Java Spring Framework
RESTful WebServices.
PostgreSQL
SQL
Hibernate
Linux
Базы данных
Microsoft SQL Server
Разработка программного обеспечения