
Хабр Курсы для всех
РЕКЛАМА
Большая витрина: от крупнейших школ до частных авторов. Сравнивайте по цене, длительности, формату и выбирайте самый подходящий курс!

Я правильно понимаю, что у вас нет готового продукта для Андроида, например, который можно добавить как один из TTS-движков в систему?

На данный момент мы не осуществляем публичную поддержку таких движков.
Публичной не надо, хватит приватной.

Знаю один активный проект на github, который может использовать разные движки в том числе silero.

Вспомнился Колосс из Дэдпула в русском дубляже

Ноутбук в коллабе сейчас не работает, поскольку ссылка на модель v5_v4_.ru.pt отдаёт 404 ошибку.
Так, ну во-первых такой v5_v4_.ru.pt модели нет, есть модель v5_4_ru.
Во-вторых проверил ссылки на v5_5_ru и v5_6_ru , всё качается.

Можно ли копировать голос по сэмплу, как в ace-step?

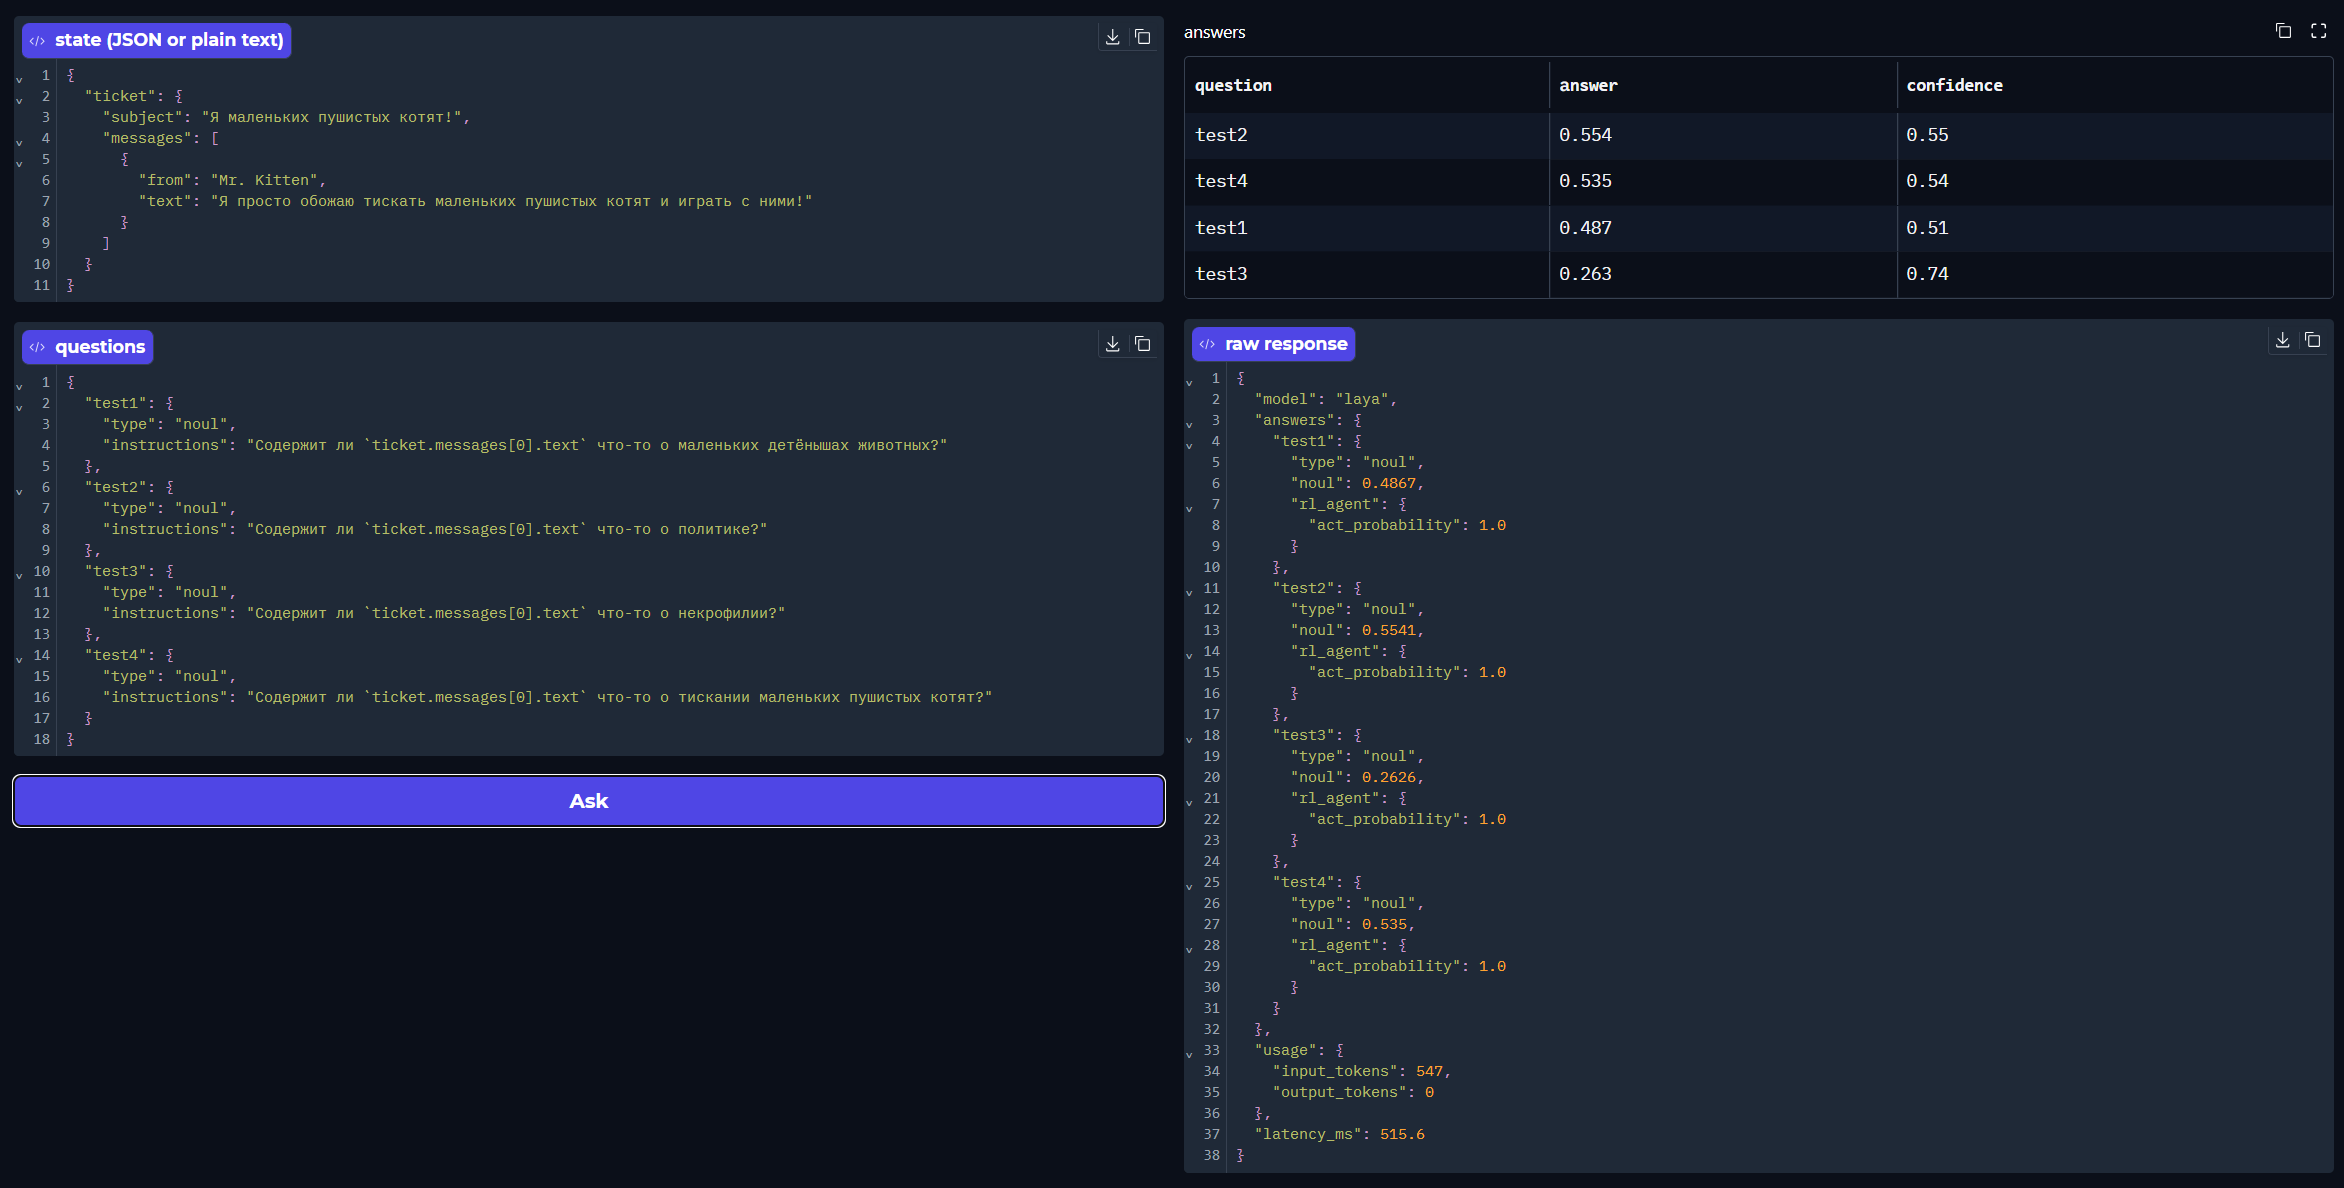
Интересно, как сочетаются эмфаза и вопросительная интонация, если они приходятся на одно слово. Например, в Ты **точно** отправил письмо? хочется и сохранить вопрос, и выделить «точно». Двойных звёздочек и вопросительного знака для этого достаточно или интонационный центр нужно размечать отдельно?
Было бы полезно добавить в примеры одну и ту же фразу в трёх вариантах: обычный вопрос, вопрос с указанным центром и вопрос с эмфазой. Так проще услышать разницу и понять, какую разметку выбирать для диалогов.
Двойных звёздочек и вопросительного знака для этого достаточно или интонационный центр нужно размечать отдельно?
Мы не прорабатывали одновременную поддержку и вопроса и эмфазы. Попробуйте, интересно что будет вообще.
Что касается вопросов:
Если вопрос общий, то для максимальной выразительности следует выделить интонационный центр одинарными звёздочками. Для альтернативных, специальных или вопросов-хвостиков можно не указывать интонационный центр (если указать, будет получше звучать).

Я немножко другой фичи ждал - это чтение чисел со склонениями по падежам в зависимости от контекста. Сейчас появились новомодные system-one классификаторы типо Jev. Может кто-то уже пытался запилить локальный нормализатор русского языка на базе laya или других Jev-подобных опенсоурс альтернатив?
Если я верно понял тут это yet another LLM за АПИ где-то в Амазоне, только которую тренировали отвечать на какие-то более конкретные запросы.
Плюс не совсем понял, а как её локально скачать?

Мы эту задачу у себя уже решили, причём ровно тем, о чём вы спрашиваете, но без Laya. Коротко про два слоя.
Чтение чисел с падежами. num2words даёт словоформу в именительном, дальше её нужно согласовать с контекстом. У нас это num2words + pymorphy3 (2.0.6 + dicts-ru), 15 стадий регулярных выражений в жёстко зафиксированном порядке - от частного к общему:
«у 3 котов» → «у трёх котов», «с 10 минутами» → «с десятью минутами»;
«21 год» → «двадцать первый год», «1 окно» → «одно окно» (род берётся из разбора parse.tag.gender, а не по окончанию);
«у 2000 рублей» → «у двух тысяч рублей», «до 18 лет» → «до восемнадцати лет»;
«на 5%» → «на пять процентов», «у 5%» → «у пяти процентов».
Пара мест, где линейного «склонения после цифры» не хватает:
Единицы измерения и проценты - справа ничего нет, контекста не даёт. У нас таблица предлог→падеж: предлог выбирает падеж, из которого берётся форма существительного, а не наоборот.
Даты - тут наоборот: падеж задаёт существительное, потому что месяц всегда в родительном («... июля»), и уже он определяет форму дня. День - порядковое числительное среднего рода, ему нужен свой набор форм, а не склонение существительного. Отдельный механизм: до пятнадцатого июля, к пятнадцатому июля, по пятнадцатое июля, по умолчанию родительный «пятнадцатого июля».
Телефоны - наоборот, склонять нечего, их читают по цифре. Международный и локальный форматы ловится разными регексами и обязательно раньше склейки разрядов, иначе «8 901» превращается в «8901».
Про Laya — кажется, вы не туда смотрите: это TTS-фреймворк, а не нормализатор. Вам нужен морфологический движок, и pymorphy3 - это в точности локальный open-source вариант с полным контекстом по OpenCorpora. Отдельный «нормализатор поверх него» не даёт ничего, кроме второй точки отказа.
Ударения в числах. Их в нормализаторе нет вообще - и это сознательно. num2words не возвращает меток, поэтому все словоформы, которые он породил («тысяча», «восемьдесят», «трех»), проходят ровно тот же путь ударений, что и обычный текст:
ё-слой до акцентора (это обязательно: ё меняет и ударный слог, и фонему: vosk-g2p мапит «ё» в «o» с палатализацией, без ё «слёзы» читается как «слэзы»). Словари RUAccent + eyo-kernel, на золотом наборе recall 93.9 % у одного акцентора против 95.0 % в связке «ё-слой → акцентор»; на редких и длинных формах разрыв больше - из 3000 случайных форм акцентор оставил без ё 27.2 %.
silero-stress ставит + перед ударной гласной, его homosolver разбирает омографы.
Аудит сверяет выбор нейросети со слоями нормы по приоритету: печатный словарь Агеенко → имена (ruwiki) → ручные правила phrases.json → омографный дамп → нормативный слой словаря омонимов ИРЯ им. Пушкина (132 пары) → лексикон RUAccent (3.19 млн форм, покрывает ~87 % токенов прозы). Расхождение не просто считается - оно подменяется перед синтезом, а аудит при этом продолжает честно показывать «что выбрал акцентор» (счётчики разъехались: X-Stress-Audit и X-Lex-Fixed).
То есть «ударение в числительном» у нас не таблица в коде и не ручное правило, а тот же слой, что и для прозы. Синтез идёт с put_accent=False — метки уже расставлены и выверены выше.
Про печатный словарь Агеенко. «Собственные имена в русском языке. Словарь ударений» (2001, НЦ ЭНАС, 376 с.) — источник самый авторитетный из доступных, но в виде DjVu-скана, и Tesseract в нём не читает знаки ударения вообще: ноль комбинирующих острых U+0301 во всех вариантах предобработки. Пришлось писать свой CV-детектор по геометрии плюс проверку нейросетью , в итоге 32 241 форма из 121 170 токенов, и печать в приоритете над всей автоматикой (ageenko → names → lex). Как это разбиралось — подробно здесь (надо бы написать статью на Хабр :) ).
Конвейер целиком: sanitize_punct → normalize_numbers → ё-слой → разбивка на предложения → и по предложению silero-stress → аудит+подмена одним проходом (слои names/lex батчатся один раз, а не два — экономия 1.6–1.8×) → синтез. Отчёт по запросу уезжает в заголовках (X-Stress-Audit, X-Lex-Fixed, X-Omographs, X-Yo), плюс есть POST /audit без синтеза: он отдаёт очередь на ручную правку словаря, чтобы не слушать аудиокнигу целиком. (Кроме правки ударений, можно также будет править и другие метки, например метки голосов разных персонажей).
Отдельно про тесты: нормализация чисел изначально жила внутри основного модуля, её нельзя было ни запустить без torch, ни проверить - ноль тестов на ~200 строк с пятнадцатью стадиями. Мы вынесли её отдельно именно ради этого, и теперь у каждой стадии есть тест.
P.S. Код всего этого дела пока что не открытый:)
Сообщение уж очень подозрительно похоже на автоматически сгенерированное, но тем не менее постараюсь тут "нанести пользу" сообществу:
num2words+pymorphy3
Основная проблема тут в том, что pymorphy во-первых имеет далеко не 100% точность, имеет сильно ненулевой оверхед (и не молодеет), и если уж заниматься слоповодством, то есть в принципе разной степени безобразности готовые библиотеки, которые делают практически всё на регулярках, очень быстро работают и решают базовые кейсы без "конвейера" и ещё цепочки внешних (устаревших) библиотек.
Словари RUAccent +
eyo-kernel, на золотом наборе recall 93.9 % у одного акцентора против 95.0 % в связке «ё-слой → акцентор»; на редких и длинных формах разрыв больше - из 3000 случайных форм акцентор оставил без ё 27.2 %.
Тут я бы советовал воспользоваться нашей недавней более качественной библиотекой для расстановки ударений в обычных словах, омографах и простановки буквы ё, которая не требует танцев с бубнами и работает из коробки. Плюс в последней версии можно вообще заливать свои словари и регулярки.
Сейчас насколько я понимаю проект - это уже abandoware, но когда мы снимали метрики RUAccent, его метрики точности, и precision и recall были на уровне просто простановки более популярного варианта омографа, а по потреблению ресурсов он кушал больше, чем даже наш синтез (именно простановка ударений де-факто не работала без GPU и кушала уже на два-три порядка больше вычислительных ресурсов, что для текстовой библиотеки - смерти подобно).
Пришлось писать свой CV-детектор по геометрии плюс проверку нейросетью , в итоге 32 241 форма из 121 170 токенов, и печать в приоритете над всей автоматикой (
ageenko → names → lex). Как это разбиралось — подробно здесь (надо бы написать статью на Хабр :) ).
А этот словарь где-то можно скачать?

Выступлю в защиту. PyMorphy это просто DAWG упакованный словарь русской морфологии, плюс некоторые эвристики для авторской фантазии. Шанс ошибки исчезающий. Единственная, с которой столкнулся в вопросах нормализации чисел, это ошибка парсинга из формы "сто". Приходится в словарь начальных/нормальных форм заносить "ста".
Парсинг цифр кешируется, а числа встречаются не настолько часто, чтобы получение формы исчисляемой сущности вызвали перегрузку. При этом логика обработки, с обращением к свойствам case, gender, number, намного проще чем их получение через матчинг и скорее всего заметно быстрее.
но когда мы снимали метрики RUAccent, его метрики точности, и precision и recall были на уровне просто простановки более популярного варианта омографа
Тест на 440 смысловых омографах, по корпусам с близким к естественному распределением форм, дал довольно схожие значения. RuAccent 0.92, prev Silero 0.926, cur Silero 0.937. Усреднение значения проводилось с учетом частотности каждого из проверяемых омографов.
При этом RuAccent действительно, ест кучу памяти и вычислительных ресурсов. Однако почему-то стал бест-практик. Именно он входит в зависимости многих других проектов.
Выступлю в защиту. PyMorphy это просто DAWG упакованный словарь русской морфологии, плюс некоторые эвристики для авторской фантазии. Шанс ошибки исчезающий. Единственная, с которой столкнулся в вопросах нормализации чисел, это ошибка парсинга из формы "сто". Приходится в словарь начальных/нормальных форм заносить "ста".
Мы использовали PyMorphy при обработке больших корпусов текста (сотни миллионов предложений), и на одни и те же слова на большой дистанции он зачастую выдаёт целый "пучок" рандомных тегов. То есть ответы не прямо строго детерменированы на большой датке. Что там внутри - не интересовался никогда, но скорее всего там должен быть парсинг структуры предложения и что-то типа CRF.
Тест на 440 смысловых омографах, по корпусам с близким к естественному распределением форм, дал довольно схожие значения. RuAccent 0.92, prev Silero 0.926, cur Silero 0.937. Усреднение значения проводилось с учетом частотности каждого из проверяемых омографов.
Ну во-первых, пришлите к нам в репку датасет, мы разберём ошибки, посмотрим что там, убран ли у вас дисбаланс вариантов и дисбаланс по частотности.
Тут учитывайте, что это не лучшая модель, лучшая приватная обычно лучше на 2-3 (иногда и даже 4-5пп), на разных доменах.
Важно отметить, что метрика accuracy ещё является отчасти неправильной, т.к. на некоторых доменах эвристика "ставить более популярный омограф" может давать 85%-90% accuracy, если не убирать частотность.
Что касается бест-практис, я бы поспорил, но лучше приведу известную цитату (мы чуть припозднились со своей публикацией, но давайте омографы теперь ещё нейросетками на триллион параметров разбирать будем, лол):
Да, я использую версию 1.5 от 2026-09-15, https://pypi.org/pypi/silero-stress/json
Используются вызовы из API : load_accentor(), accentor(text), accentor.homosolver.homodict, accentor.homosolver.load_phrases_dict(), accentor.to(device="cpu").
Но не используются авто-ударения внутри самой модели Silero. Синтез идёт с put_accent=False, потому что метки уже расставлены и выверены нашим слоем. Своя расстановка в Silero означала бы две разметки, которые могут разойтись на одной фразе, и put_accent=False это убирает.
Насчёт качества: это в целом хорошая штука, но не идеальная, например, он не ловит отличия зАмок и замОк, отсюда и пошла изобретаться вся эта многослойная система.
"А этот словарь где-то можно скачать? " - можно скачать на этом ресурсе: https://flibusta.is/b/310099
Распознанный словарь пока что нет смысла выкладывать, т.к. надо сначала полностью сверить вручную его электронный вариант со сканом в pdf.

не уловил разницу в логике преобразования двадцать первого года и одного окна. написание идентичное и должно бы получить первое окно. или двадцать один год.

Скрипт для синтеза речи Silero в MicroMamba портабельно. Для MicroMamba права админа необязательны.
https://github.com/ant3mc/runSileroMicroMamba
При запуске в консоли скрипт берёт текст, скопированный в буфер обмена и превращает его в один большой аудиофайл .wav . Настройки можно делать изменением данных в самом скрипте.
Производится (когда требуется) автоматическая очистка сложных текстов от символов и их комбинаций, ломающих синтез (это особенно актуально при SSML).

Круто! Движок подкупает тем что легко заводится на одном ядре без прожорливых видеокарт)

Мне для TTS всё советуют брать Qwen3-tts. Есть какое то сравнение с silero?

Примеры звучания
Из России https://samply.app/embed/Z1hFpaHgeFEyKoaC37iH даже через Tor не хочет работать.


Silero TTS v5 теперь умеет и в эмфазы, и в вопросы и восклицания