
Хабр Курсы для всех
РЕКЛАМА
Большая витрина: от крупнейших школ до частных авторов. Сравнивайте по цене, длительности, формату и выбирайте самый подходящий курс!

Спасибо за классный разбор! Очень ждал.
В оригинальном репозитори в целом немало информации. Но местами там адские водопады из итальянского национального блюда, особенно код RTL. Поэтому для понимания реально проще посмотреть, во что это всё превратил синтез.

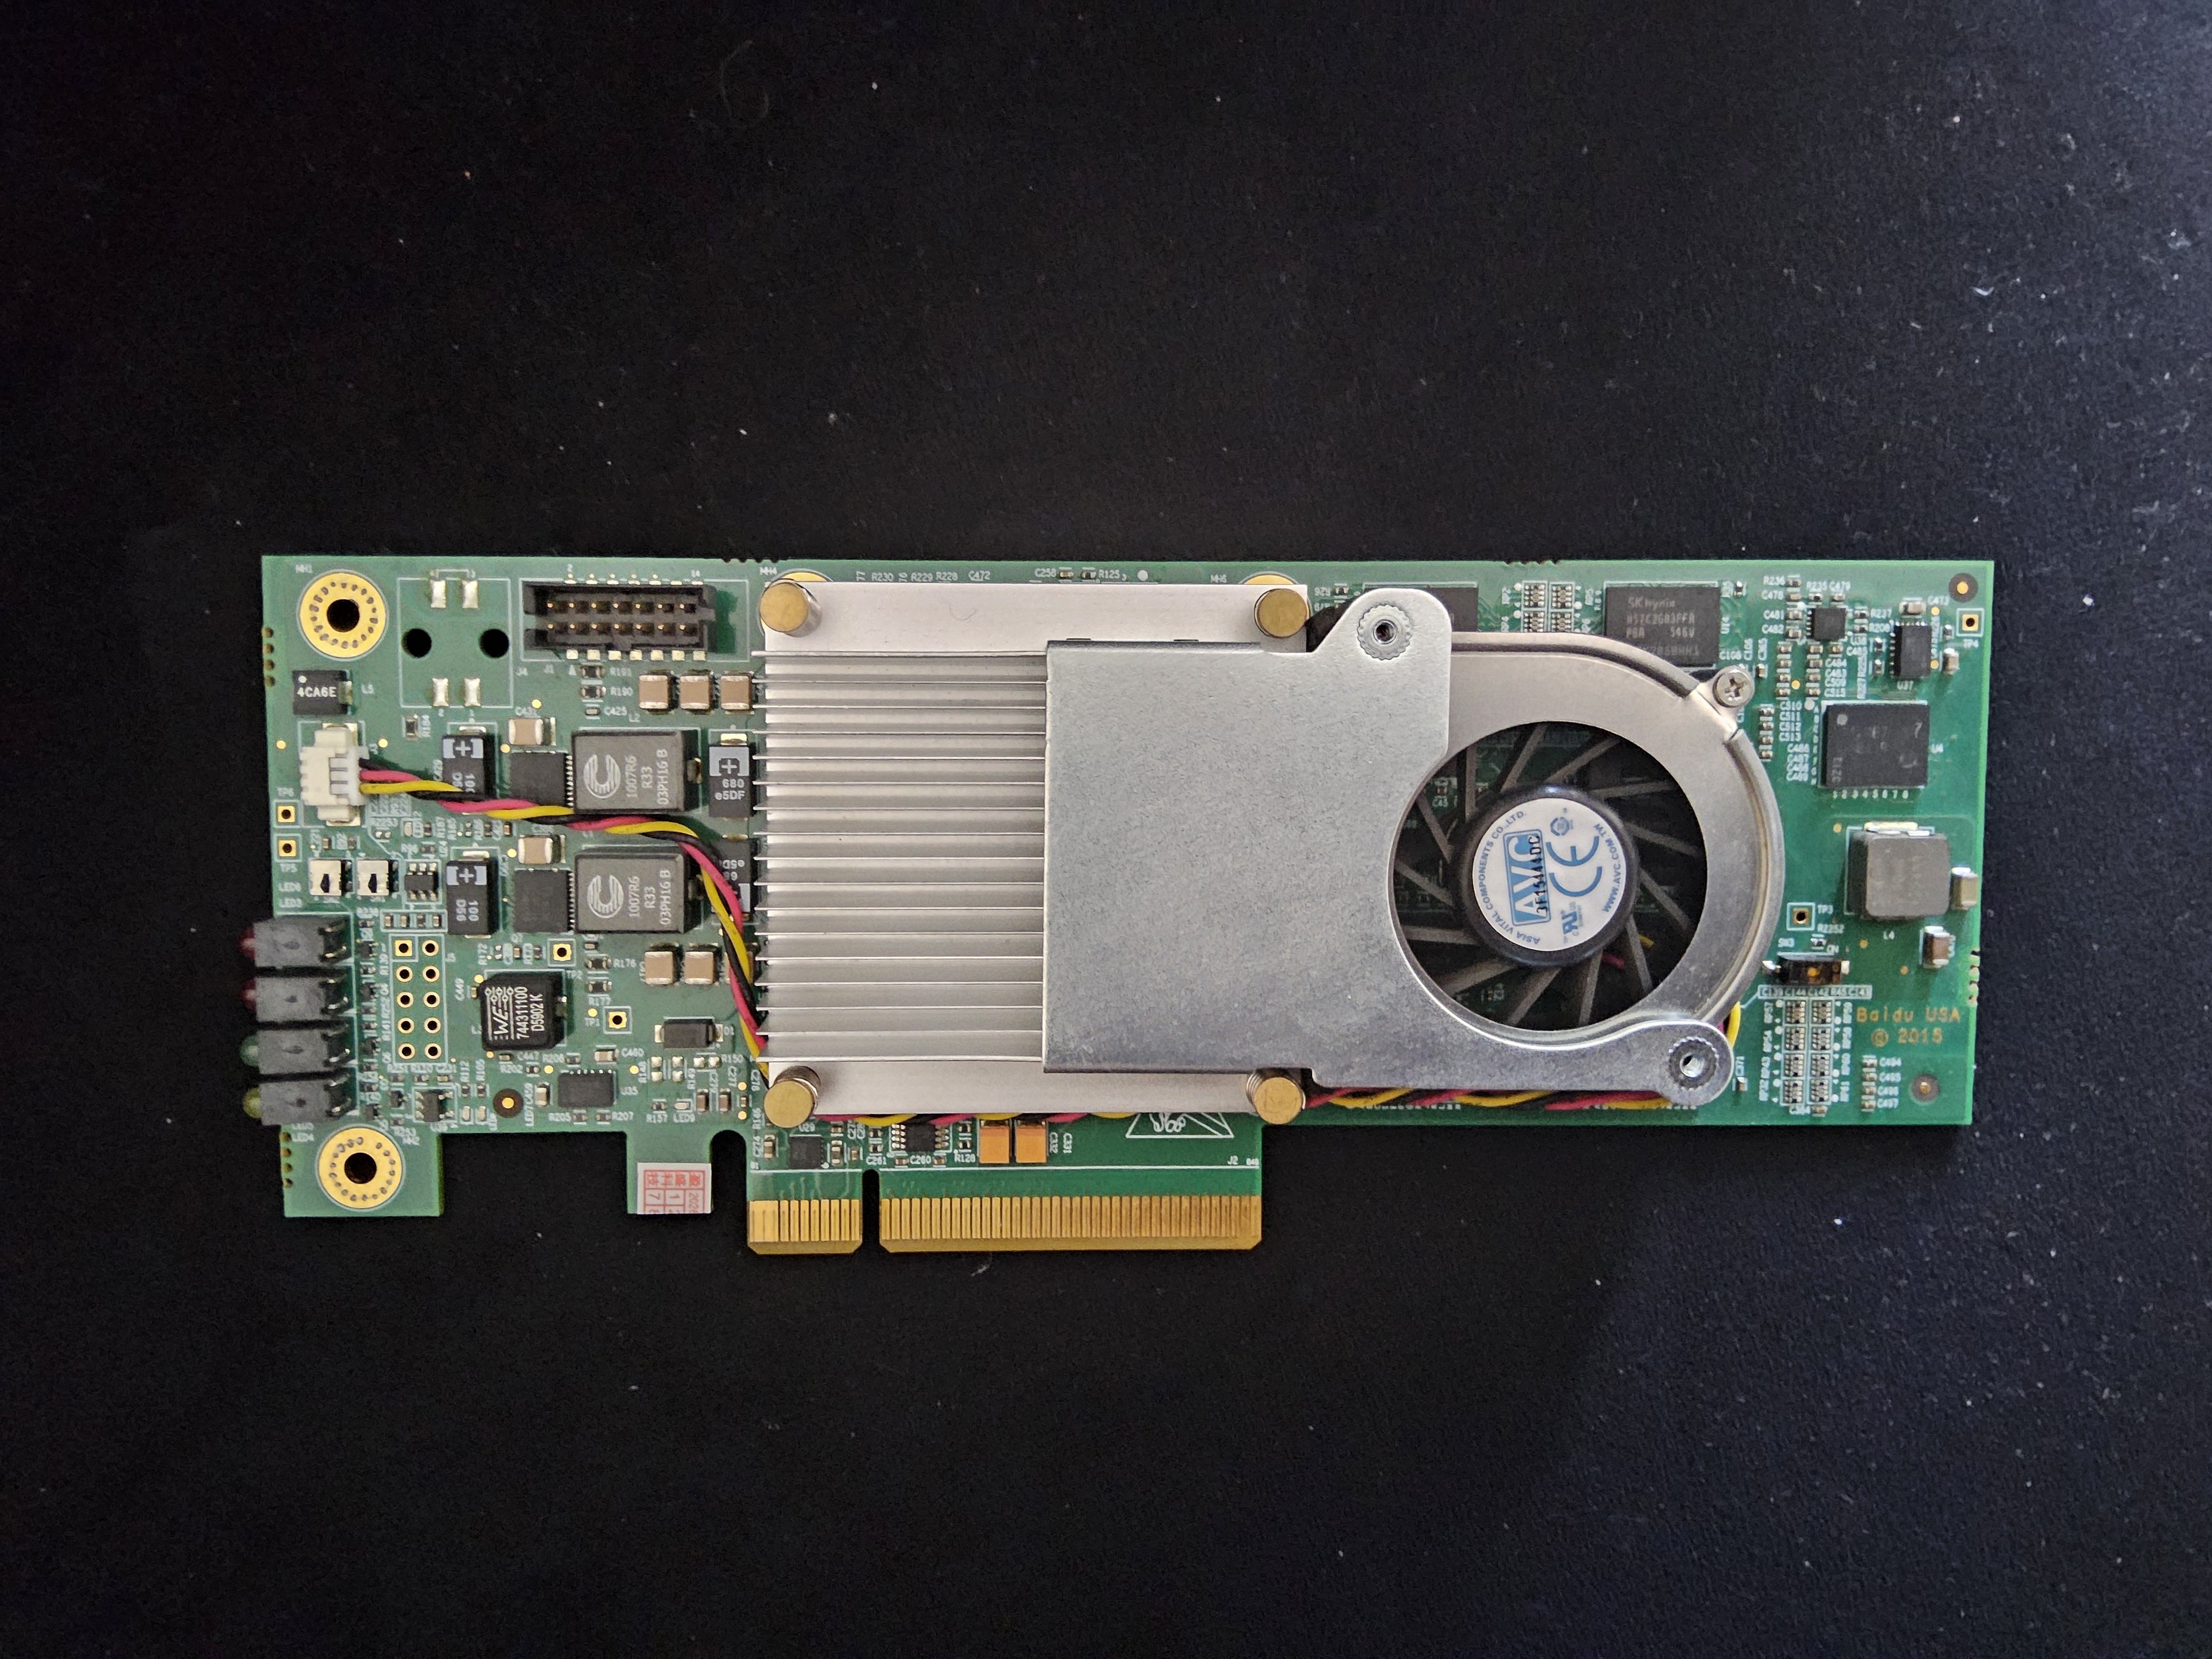
На Алике есть еще платы YZCA-00338, с виду братья близнецы, это тоже самое?

Да, у меня как раз эта плата - YZCA-00338 (Baidu/Celestica). Именно на ней я и запускал проект из статьи.
https://github.com/SergeRuff/DU-PCB-001-003?utm_source=chatgpt.com
Они близнецы)

запас по таймингу 19 пикосекунд
Результат конкретной сборки -- не приговор, это число мало что показывает само по себе кроме того, что тайминги сошлись. Vivado прекращает стараться по части оптимизаций, как только достигнет положительного слака.
В шести худших путях ядра нет ни одного уровня логики. Сигнал выходит из триггера и сразу идёт во вход DSP, BRAM или LUT-RAM - и 95–97 % времени занимает провод. Например, регистр задержки весов → вход умножителя ячейки № 46: 4,61 нс, из них 4,37 нс - дорога через кристалл.
А вот это уже похоже на плохое начальное размещение, тут можно было бы поиграться с pblock-ами, возможно гораздо лучше всё будет, если немного помочь среде. У Vivado бывают проблемы (тупёж) с размещением блоков по кристаллу, например, огибание пустот раньше не очень хорошо работало, человек бы так не раскладывал.
Но слайсы заняты на 76 %
Имхо, в resource utilization на слайсы слишком много внимания обращать не надо, часть из них уходит на разводку и прочее. Иногда Vivado не сильно старается (и не разводит слишком уж долго), когда место на кристалле есть и констрейнты не слишком жёсткие.

хороший комментарий, тоже хотел об этом сказать. Скажу тоже самое но своими словами:
1. в принципе, задача любого синтезатора(от xilinx, altera, Synopsys, и другие) - это построить такой маршрут от регистра к регистру чтобы время прохождения сигнала по этому пути укладывалось в период тактирующего сигнала(clk). Поэтому теоретически синтезатор должен стремиться к 0, чтобы плотность размещения была максимальной. Но тут есть много нюансов и вопросов, но не суть.
2. иногда действительно pblock решал вопрос таймингов.
3. Действительно, слайс это ячейка которая содержит в себе ресурсы(регистры, Lut и другие), и если хоть один ресурс использовался то этот слайс попадает в копилку использованных слайсов, а синтезатору просто было удобно использовать два слайса место одного(например у одного регистр использовал, а у другого lut, можно было бы объединить но у синтезатора свое мнение).
Спасибо за подробный разбор! Да, здесь есть большой простор для оптимизации как на уровне RTL и использования ресурсов FPGA (LUT, FF, DSP, BRAM, slices), так и на других. В рамках этого эксперимента я не выжимал максимальную производительность, а исследовал и проверил работоспособность архитектуры на дешёвой FPGA.
Если использовтаь несколкьо плат, получится ли разделить вычисления? первую половину нейронки считать на одной плис, а вторую на второй. тогда уже лучше раскрылся бы потенциал pcie x8.
Если бы места хватило. то насколько сложно размножить количество TPU? там ведь придется решать вопрос доступа к одной ДДР, разделение задач и работы с pcie. Видится что как будто бы это должно разруливаться через два независимых TPU если смотреть со стороны ЦП.
что такое КЕДР?
Что если все таки поднять частоту у ДДР, на какой частоте она перестанет адекватно работать? получится поднимать частоту по 10-50 Мгц или LiteX сразу на 1333 МГЦ требует переходить?
P.S. теперь есть повод купить эту плату) наверное щас цены на нее взлетят
P.S.S. Спасибо за материал, а то плата в прадаже есть а что с ней делать не понятно. А так хоть обрастает материалом как с ней работать и на что она способна.
Можно, разбить слои между платами. Гонять между ними надо только активации, это пара килобайт на токен. Накладки будут, но это скорее задержка через хост, чем объём. Главное ограничение скорость памяти, поэтому для одного запроса сильного ускорения не будет. Выигрыш появится при нескольких запросах сразу или если модель не влезает в одну плату. По ресурсам место есть, но все ядра будут делить одну DDR как вы упомянули. Если и так упираемся в память, второе ядро почти ничего не даст. Проще увеличить сам массив,поделючить больше памяти. А для хоста да, удобнее всего два независимых устройства.
«Кедр» позывной Гагарина. Первый полёт 🚀 и так решил назвать это проект/TPU и чип в своих влажных мечтах)
В LiteX частоту можно поднимать понемногу, сразу прыгать не обязательно. После каждого шага гоняешь memtest и смотришь, где начнёт сыпаться. Предел зависит от кристалла, разводки и самих чипов. Сейчас bitnet апаратно воткнуть интереснее.
P.S. Если цены взлетят, я тут ни при чём 😄 но тренд нехилый намечается ИИ fpga

разделение по слоям уронит скорость инференса в разы (по количеству плат) но позволит увеличить суммарное количество (пока хватает памяти для kv-cache) токенов в секунду для параллельных запросов (количество так же равно количеству плат).
в теории можно тенсорный параллелизм сделать, вопрос, хватит ли скорости шины pcie или городить что то между платами напрямую.
ну и будет очень дорого/медленно, для адекватных моделей (qwen3.8-27b) понадобится десяток карт минимум.
Про pipeline поправлю: для одного запроса он не замедляет в N раз. Каждая плата читает только свою долю весов, так что время на токен примерно как у одной большой платы, плюс пара килобайт активаций через хост. Ускорения нет, но и падения тоже. С throughput на параллельных запросах согласен.
Тензорный параллелизм интереснее: полоса памяти плат складывается, а обмен мизерный, так что важна задержка, а не скорость PCIe.
А с десятком карт для 27B вы правы. В 4 бита это около ~15 ГБ: на мою плату не влезет, а по скорости даже одна «большая» дала бы около 1 ток/с, потому что упираемся в те же 16 ГБ/с DDR3. Плюс линки едят ватты постоянно: PCIe по оценке Vivado 3,5 Вт, больше всего ядра TPU.
Поэтому для такого железа логичнее MoE (на BCU1525 с 64 ГБ это уже реально) или BitNet: 2-битные веса вдвое легче fp4.

Помнится, бывают чипы с аппаратными контроллерами памяти. Zynq там всякие... И доступ к памяти получается дешевым (не расходует блоки FPGA). А если еще всё, что требует сложной логики исполнения, закинуть на их процессорное ядро, может, кажется, совсем круто получиться.
Там всеравно вопрос скорости остаётся...
Мысль правильная, но половинчатая. Аппаратный контроллер экономит логику: у меня дорога к памяти (LiteDRAM, мост, каналы) съела 47 тыс. LUT, 16 % кристалла, больше, чем сама матрица. Но пропускную способность он не добавляет, она определяется шириной шины и частотой. У Zynq-7000 процессорная DDR3 - это 32 бита на 1066, около 4 ГБ/с, меньше моих двух каналов. У Zynq UltraScale+ уже 64 бита DDR4-2400, около 19 ГБ/с, примерно как у меня сейчас. Реально скорость меняет только HBM: у Alveo U280 и подобных карт около 460 ГБ/с. Вот это был бы интересный следующий стенд. А выносить нормы и softmax на ARM-ядро не выйдет: при генерации каждый токен проходит через них в каждом слое, и медленный процессор станет новым узким местом. Секвенсор и управление - да, туда им и дорога.

А для людей, которые FPGA последний раз видели на лабораторках, а ИИ используют только платные, можете пояснить: какие задачи можно решать на этом железе? От ChatGPT же отказаться не получится?
автор явно проводит исследование применимости.
сам факт что это в принципе возможно, уже говорит что в этом направлении можно копать.. например создание своей платы, напихать в нее по больше памяти, чипов... вдруг выгорит
локальный инференс - особая задача, одним она не нужна в принципе, но тогда вы должны смириться что в агентских задачах отдаете свой компьютер в руки облачного провайдера (один инжекнутый tool call и к вам заезжает троян, не говоря о том что данные вы и так отдаете добровольно, и да, те кто на windows и так такого трояна уже давно держат у себя, но это нелегально а в случае с ИИ - легально, отмазка всегда на уровне - сгаллюцинировало, сорян)
p.s. разработать свое железо для инференса это выход на очень вкусный на текущий момент рынок! особенно если решение будет хотя бы по цене и скорости конкурировать с имеющимися. Условный пример, без топовых решений (техпроцессов) можно собрать иференс на скоростях gpu но оно будет жрать энергию на порядок больше, быть больше размерами и... ну про цену это да, вопрос.
p.p.s. облачные решения даже слабые ИИ дороже чем своя gpu (сужу по qwen3.8-27b и glm5.3-flash облачный), одна средней паршивости задачка - миллионы токенов, могу даже дешевыми ИИ сожрать пару тройку баксов.... это ОДНА задача, за условный час другой. Если у вас агенты работают непрерывно, облачные решения сожрут весь бюджет.
разработать свое железо для инференса это выход на очень вкусный на текущий момент рынок!
Тут вы не упомянули, железо на fpga или чем-то ещё... Сам Кристал kintex 7 420t который используется в проекте, не маленький. Конечно есть гиганты и пожирнее но не в 100х раз. И на эту Плис влез только один TPU.
Так что сделать свое железо которое будетет конкурировать хотя бы с nvidia 3060 будет сложно.
Согласен на 100%: обогнать 3060 на FPGA не выйдет, и я этого не обещаю. Основная причина даже не в логике, а в памяти. У 3060 около 360 ГБ/с GDDR6, а у одного канала DDR3 на Kintex-7 максимум ~15 ГБ/с (при DDR3-1866). Декодинг LLM упирается именно в это. Но FPGA тут не конечная точка, а макетная плата. На ней проверяется архитектура, снимаются реальные цифры, а конкурировать по цене и энергоэффективности должен уже ASIC. Это и есть КЕДР из названия - влажные мечты, и первый шаг сделан. Мелкая поправка: у меня XC7K480T, но сути это не меняет.
Уточню по своей плате кристалл тянет до DDR3-1866, но у меня память работает как DDR3-1066, два канала, 17 ГБ/с суммарно. При генерации они загружены на 92-96 %, подробности во статье. И про "влез только один TPU": DSP заняты на 37 %, их хватило бы ещё на две такие матрицы. Упирается всё в разводку (слайсы 76 %) и, главное, в память.
разработать свое железо для инференса это выход на очень вкусный на текущий момент рынок! особенно если решение будет хотя бы по цене и скорости конкурировать с имеющимися
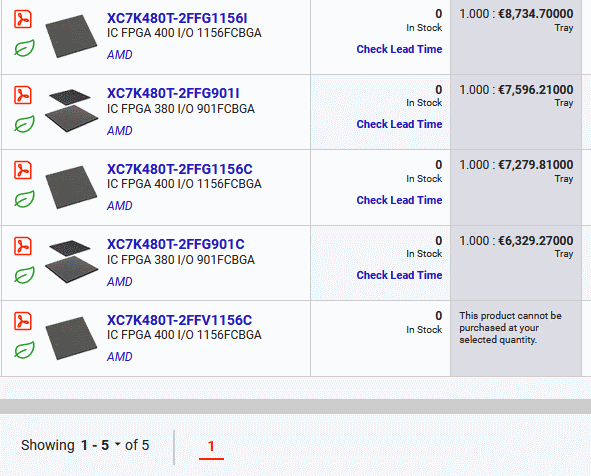
Важно не ошибиться с экономикой на пару порядков)) Следите за руками: автор использует б/у плату за 50$, с плисиной Kintex-7 XC7K480T-2. Новая такая плисина стоит порядка $5К-8К. Это даже не включая разводку, пайку, софт, труд и прочее.
да, цены на рынке fpga дикие... но надо смотреть не fpga dev board а сам чип и обвязку, оно точно должно быть дешевле, особенно если тысячами заказывать.
но надо смотреть не fpga dev board а сам чип и обвязку, оно точно должно быть дешевле
Туда и смотрю, да. Kintex 7 -- это достаточно производительные и достаточно жирные плисины, экономических чудес там ждать всё же не надо. Вот с digikey цены для чипов:
Спасибо, вы точно уловили суть: это исследование применимости и заодно повод всерьёз подумать о своём чипе. Про "напихать побольше памяти" следующий шаг как раз в эту сторону. У меня есть BCU1525 с 64 ГБ DDR4, попробую запустить на ней. Для LLM узкое место почти всегда пропускная способность памяти, а не вычисления, так что посмотрим, сколько удастся выжать. И тезис про стоимость облачных агентов на длинных задачах полностью разделяю.
Честно нет, ChatGPT это не заменит, и цели такой нет. Плата FPGA здесь не продукт, а испытательный стенд. На ней можно «пощупать» архитектуру ускорителя в железе, то есть как устроены вычислительные блоки, как ходят данные из памяти и где узкие места. И всё это без многомиллионного запуска чипа. Практический смысл локального инференса другой. Небольшие модели крутятся у вас, данные никуда не уходят, работает офлайн, и не надо платить за каждый токен. Для агентов, которые гоняют задачи часами, это существенно (rPman ниже хорошо расписал)
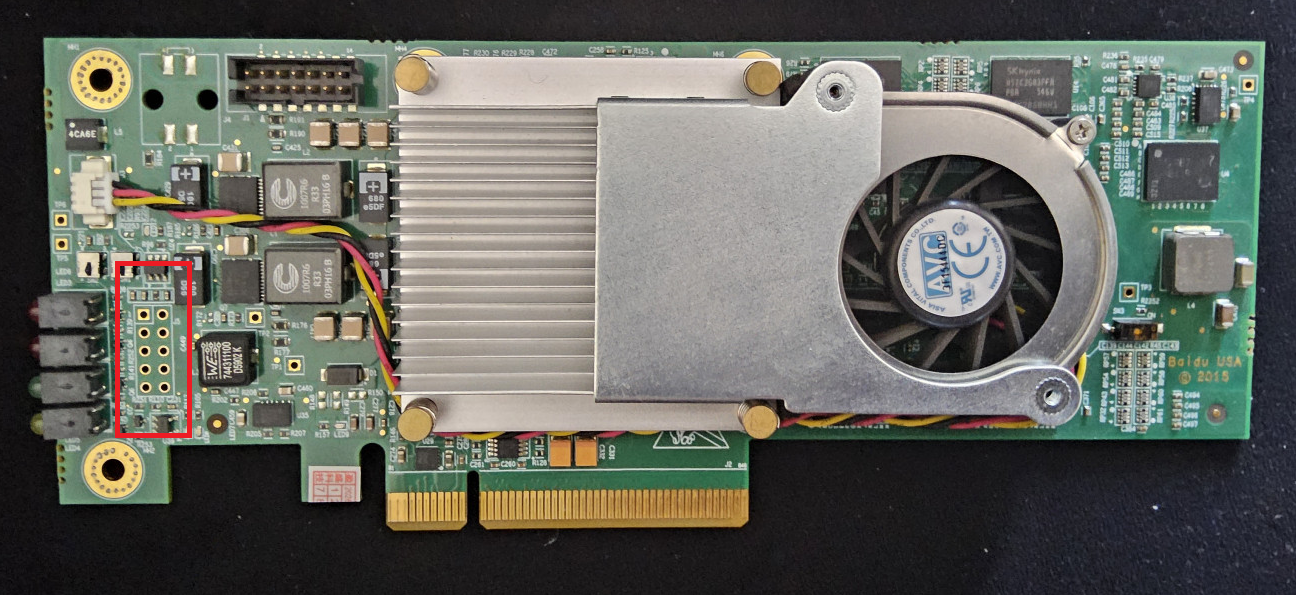
Нафиг NVIDIA! Часть 2. Запустил 8 нейросетей на FPGA за $50 — и упёрся в DDR3