Привет, Хабр! С вами Павел Мирошин, архитектор продукта «Графиня».
Сегодня мы поговорим не про очередной релиз и не про список новых фич. В статье — личная история о том, как растёт продукт, когда у тебя нет большой команды разработчиков, архитектура не высечена в камне, а требования меняются быстрее, чем успеваешь закрывать задачи в Jira.
«Графиня» начиналась как небольшой MVP, который делала команда из трёх человек. Мы хотели получить аналог Grafana, но быстро поняли, что просто повторить чужой продукт — не наш путь. Пришлось самостоятельно решать вопросы архитектуры плагинов, динамических форм, расширения фронтенда, кеширования, ФСТЭК и, наконец, алертинга.
В дальнейшем какие‑то первоначальные решения пришлось пересмотреть. И, конечно, были проблемы, которые мы создали себе сами.
Дано
Как говорил один автоблогер: «Чтобы понять, почему так вышло, для начала нужно понять контекст».
Немного обо мне — я в ИТ уже 16 лет: начинал как C++‑разработчик, потом был фуллстеком, а затем перешёл во фронт с лавандовым рафом и прочими атрибутами. До «Графини» отвечал за фронт нашей контейнерной платформы «Штурвал». В версии 2.1 мы выбрали React 18 и стали создавать различные компоненты для ускорения разработки, например, обёртку, позволяющую из определённого типизированного JSON‑объекта получить поле (причём отображаемый компонент зависел от параметра type в поле) с подключённым React Hook Form и указанными правилами проверки, — или динамическое дерево React Router, так как иерархия страниц «Штурвала» выходила за рамки привычного решения на React. После одного или двух релизов мы решили вынести все переиспользуемые компоненты в нашу дизайн‑систему.
Параллельно с этим наш будущий продакт‑оунер «Графини» Дима Унтила вовсю поставлял заказчикам продукт «Пульт» (аналог Zabbix). От заказчиков то и дело поступал запрос: «Вот смотрите, Zabbix мы импортозаместили, но он работает у нас в связке с Grafana. А есть ли, чем её заменить?». Вот так и появилась идея о создании «Графини», и заняться этим предложили нам.
«А давайте просто форкнем Grafana»
Признаться честно, на тот момент я практически ничего не знал о Grafana (неожиданно, но это сыграло только в плюс). Изначальная идея была максимально прагматичной: взять готовое решение и просто форкнуть, как мы сделали с «Пультом». Однако лично меня это смущало.
После изучения GitHub‑репозитория Grafana я ликовал — лицензия не позволяет её форкать и продавать, да и сам интерфейс Grafana мне казался очень разрозненным и устаревшим.
Если кто‑то говорит, что язык и фреймворки для проекта выбираются исходя из его потребностей, — это правда только процентов на 10. В основном технологии формируются исходя из ресурсов, которые доступны. Да, бигтехи в этом плане поворотливее.
Итого на MVP были: я, который мог React/Angular/Node.js, Java‑разработчик и джун на React. Исходя из «карт на руках» и возможности использовать наработки и дизайн‑систему «Штурвала», мы приступили к разработке MVP.
Выбор технологий зачастую зависит не только от потребностей проекта, но и от ресурсов, которыми вы располагаете.
Почему не микросервисы
А что же по архитектуре? Обычно она выбирается исходя из требований к нагрузке, расширяемости и прочему. Но так как требование было «Хочу Grafana, и желательно, чтобы их плагины подходили к нам», то начался полёт фантазии.
Я вернулся к изучению репозитория Grafana и заметил очень неприятную для нас вещь: плагины в Grafana — это какой‑то проект‑монолит, где и бэк, и фронт. Последний при этом привязан к определённому фреймворку, а также — что было печально с точки зрения совместимости с нашей системой — к их дизайн‑системе, то есть к их компонентам.
Осознав, что готовые плагины использовать не получится, я дал разработчикам плагинов в нашей системе больше свободы. Было решено, что плагины станут отдельными контейнерами и будут общаться с ядром по REST API. На момент MVP запросы можно было делать только в JSON, поэтому фронт плагина вообще не требовался. В дальнейшем мы расширили свободу: если фронт всё‑таки нужен для построения запроса с помощью полей, то это будет API с JSON‑полями. Итого у нас получился монолит 2.0 — есть ядро и модули в виде плагинов по бокам.
Архитектура не всегда должна быть микросервисной. Не стоит выбирать микросервисы просто потому, что «сейчас так принято», решение должно основываться на реальных потребностях команды и продукта.
Ещё мы затащили внутрь MongoDB — и да, отдельные разработчики нас постоянно спрашивают, почему так.
Тут стоит понимать: MVP — это то время, когда у тебя сжатые сроки, мизерный бюджет и ВОЗМОЖНОСТЬ (только возможность!) перерасти в полноценный продукт. Совокупность всех этих вводных плюс хорошая интеграция с Node.js в плане типизации и привели нас к этой СУБД. Мы спокойно могли менять состав полей в базе, расширять модели без каких‑либо сложностей, да и нагрузка планировалась минимальная — так как там не хранятся целевые данные, только конфиги.
В MVP важнее быстро проверять гипотезы и иметь возможность меняться, чем пытаться заранее построить идеальную архитектуру на много лет вперёд.
С этими вводными мы и успешно завершили MVP. Впереди был первый релиз, а значит, наша команда подросла. У нас появились тестировщик, новые разработчики плагинов, аналитик, менеджер и все атрибуты Scrum.
У разработчика нет цели, есть только путь
Первый релиз — это, по‑моему, самый сложный этап развития продукта: из MVP он должен превратиться в платформу, которую уже можно презентовать.
Нам предстояло решить три проблемы:
Добавить еще как минимум два плагина, на старте поддерживались только «Пульт» и Zabbix.
Расширить список типов виджетов.
Сделать конструктор запросов — раньше у нас был только JSON.
Прежде чем взяться за плагины, мы отдельно вынесли API, чтобы его можно было переиспользовать во всех последующих плагинах. Это позволило ускорить разработку.
С виджетами было проще. Под капотом мы использовали Recharts, поэтому по умолчанию добавлять их было просто. Сложнее было делать редактор с кучей ручек под каждый тип виджета. Причём у каждого из них есть свои пресеты: при переключении типа виджета редактор должен был удалить неактуальные поля, а недостающие добавить со значениями из пресета.
Самым трудным стало создание конструктора запросов.
Идея была простая: бэк присылает набор полей в JSON, фронт их отображает. Среди полей есть «триггерные»: при изменении значения в них отправляется запрос на бэк (когда я говорю «бэк», я имею в виду плагин, так как наш бэк тут играет роль прокси), а оттуда прилетает обновлённый список полей. Закавыка в том, что пользователь может поменять значение не последнего поля, а, допустим, корневого. Тогда все последующие поля должны это учесть и при необходимости сменить значение. С точки зрения контракта тут ничего сложного. Но попробуйте это сказать React Hook Form. Да, он может триггериться на изменение значений, но тут у нас динамические поля с неизвестной вложенностью. Поэтому пришлось добавить хитрое сравнение прошлых значений с текущими.
Ещё один головняк — массивы. Запрос в редакторе виджета уже сам по себе элемент массива, а внутри него ещё могут быть и другие. Я молчу про то, что у нас было ограничение: нельзя делать форму в форме. Массивы — это не просто поля: они не триггерятся, а обновляются вручную через методы React Hook Form.
Решив все эти задачи, мы наконец выпустили первый релиз!
Первый релиз — один из самых важных этапов развития продукта: важно уже не просто выполнять одну функцию, но и быть удобным для пользователя.
Что было дальше
В следующем релизе платформа обросла функционалом, в том числе enterprise‑инструментами, что для команды стало логичным продолжением уже выстроенного процесса разработки. А вот второй релиз 2025H2 заставил нас расширить архитектуру, добавив такое понятие, как «модуль». Как я говорил ранее, плагин общался с ядром по REST, и в принципе этого было достаточно. Но тут возникла потребность в уникальном виджете под уникальный источник данных, который должен был общаться с другими виджетами на дашборде.
Это сильно выбивалось из нашей концепции, поэтому мы потратили много времени на техническую реализацию. Модули стали уже больше похожи на плагины в Grafana. Нам всё ещё неважно, на каком языке написан бэк модуля, но фронт обязан быть на React 18 и использовать нашу дизайн‑систему. Для этого пришлось вынести часть наших компонентов в shared‑репозиторий, а дизайн‑систему сделать публичной библиотекой.
Смысл вот в чём: фронт модуля должен динамически подключаться к нашему фронту и отображаться в виде компонента. Обычно для этого идут в Module Federation, но тут есть две проблемы:
У нас используется не Webpack, а Vite.
Даже Webpack плохо умеет (по крайней мере, плохо умел) подключать компоненты именно в динамике. То есть подключить один компонент к другому можно, но обычно это делается на уровне сборки, а не тогда, когда проект уже собран и запущен.
Поэтому мы решили делать UMD‑модули. Решив все фронтовые проблемы, перешли к бэковым.
Напомним, наш бэк работает в виде прокси, чтобы разграничивать доступ к плагину и обогащать запрос данными конфигурации источника данных. Но у виджетов фиксированные API и конфиг, а у модуля — полная свобода и в конфиге, и в запросах. Решением стало делать proxy endpoint, который на вход может принять любой URL для проксирования и обогатить запрос нужными данными.
Архитектура, выбранная на этапе MVP, не обязана оставаться неизменной. Если у продукта появляется новая потребность, архитектуру можно и нужно расширять или менять.
Релиз 2026H1 по сложности был вторым после первого релиза. Во‑первых, пришлось опять наращивать архитектуру из‑за кеширования — тут не так интересно рассказывать: просто добавили in‑memory‑базу Tarantool и воркер, который складывает туда данные. Но сложность релиза была не в этом.
В середине разработки мы начали подачу «Графини» во ФСТЭК. Кто через это проходил, понимает, в чём боль; для остальных распишу. Представьте: у вас есть налаженный процесс разработки, вы выпускаете релизы один за другим, по сути, едете по рельсам из точки А в точку Б по прямой. А теперь вдруг появляется ответвление, и вы параллельно идёте уже по двум направлениям, причём на втором ветка разработки заморожена в том состоянии, в котором отделилась. По этому пути также надо делать доработки, которые требует регулятор (такой доработкой, например, стал журнал аудита, появившийся в релизе). А ещё в дальнейшей разработке приходится учитывать все ограничения, которые накладывает ФСТЭК, потому что рано или поздно сертифицированную версию придётся обновлять до актуальной.
Если есть вероятность, что продукт пойдёт во ФСТЭК, лучше узнать об этом как можно раньше и сразу заложить соответствующие требования в архитектуру и процессы.
Тут мы уже подобрались к самому свежему релизу, который был не столько напряжённым для всей команды, сколько сложным для меня лично. В нём, по сути, была одна большая фича — алертинг.
Примерно две недели мы с аналитиком вникали в ту мешанину, которую из себя представляет UX алертинга в Grafana. Основная проблема в том, как он устроен с точки зрения пользователя. Нам нужно было:
Разобраться в rules — именно здесь хранится процентов 80 всей логики алертинга, которая выведена на одной длинной странице со скроллом в один столбец — крайне нетривиальная задача.
Понять, как именно и по каким правилам пользователю в итоге приходят сообщения алертинга, тоже нелегко.
Хочется здесь также отметить, зачем нам вообще на данном этапе смотреть, что есть у Grafana. Только ради одной вещи — совместимости. Например, у нас есть импорт дашбордов из Grafana. Сами дашборды устроены в «Графине» совершенно по‑другому, но пользователь, который привык к виджету в Grafana, ожидает увидеть плюс‑минус такую же картинку и у нас. Так и с алертингом. Мы сразу заложили импорт конфигов из Grafana, но реализовать его, к сожалению, я не успел.
Разобрав весь этот хлам с UX, мы приступили к реализации и дальше делали уже по‑своему, не оглядываясь на Grafana. Тут сыграл мой опыт UX‑дизайнера на одном из проектов.
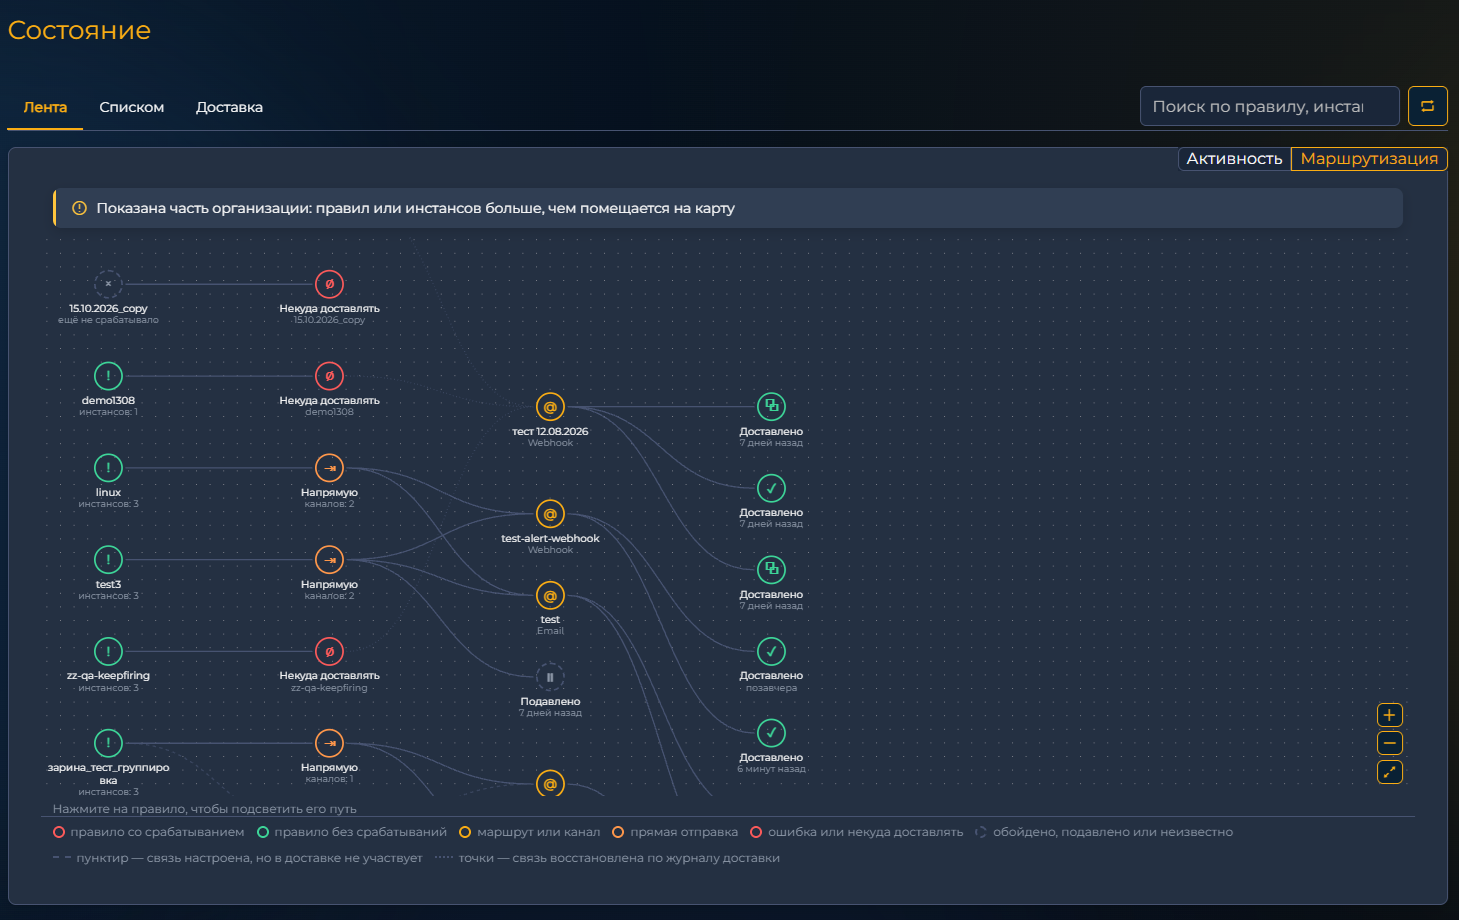
Когда мы реализовали задумки по алертингу, продукт набрал необходимый набор функций, чтобы мы могли считать его полноценным enterprise‑решением.
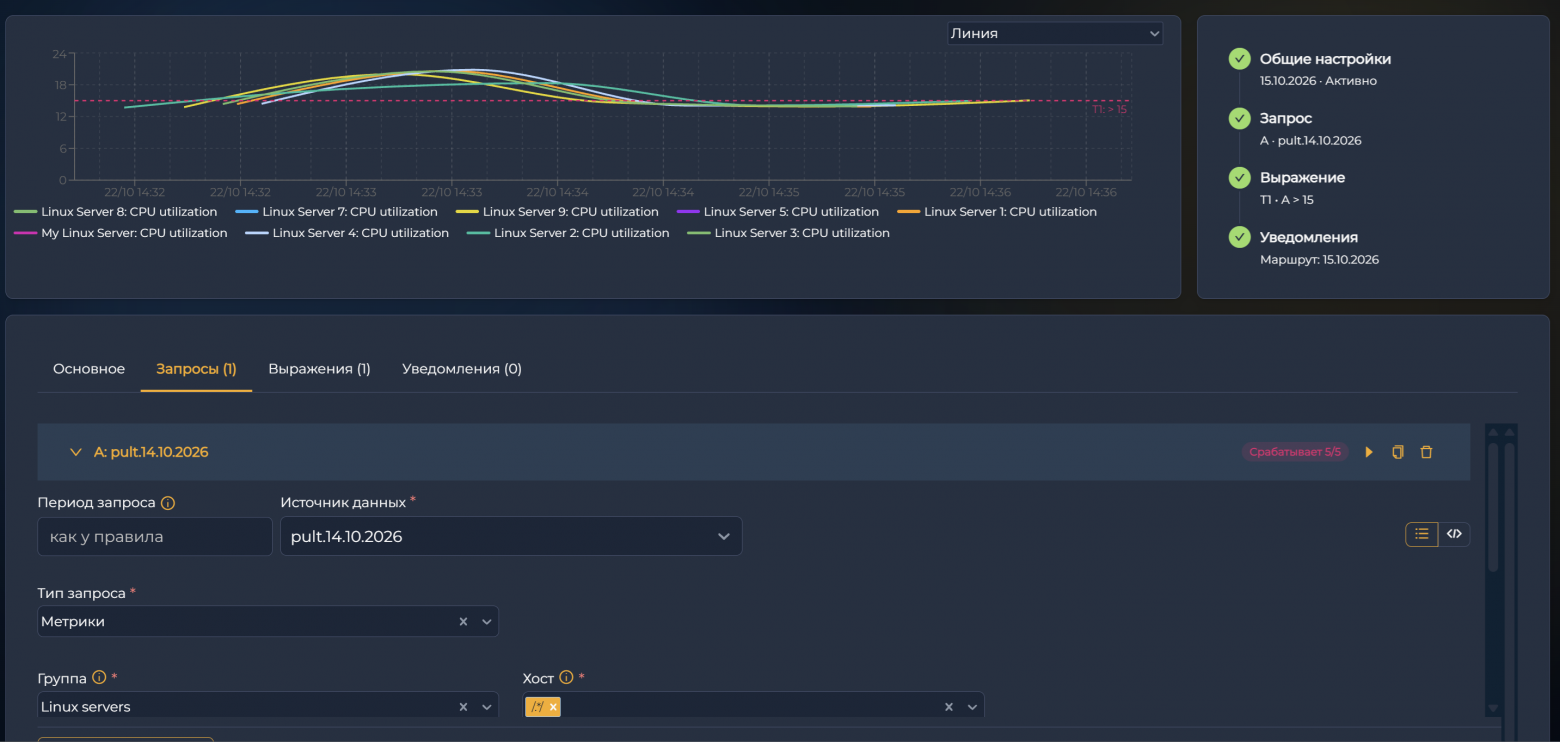
Вдохновляйтесь чужими решениями, но не бойтесь идти своим путём.
Рефлексия
И вот мы уже в нынешней точке — когда от момента MVP прошло почти два года. Теперь можно оглянуться назад и спросить себя: «Что бы я сделал иначе?». Наверное, заранее продумал бы всё так, чтобы пойти во ФСТЭК безболезненно. Но как? Тогда не было ни таких ресурсов, ни времени. Поэтому это не статья «Как надо делать», а наша история и наши решения.
А если отбросить все ограничения и сроки, то что такое «Графиня» лично для меня и чего я изначально хотел в ней добиться? Давайте честно: переплюнуть Grafana по функциональности — задача почти нереальная. Там целое сообщество и куча интеграций, это всё равно что пытаться обойти Linux. Да и надо ли? Grafana умеет очень многое, но удобна ли она в чистом виде — вопрос.
Моя основная хотелка: сделать удобный продукт с приятным оформлением — вспоминаем лавандовый раф — и при этом построить его с нуля. А проект с нуля, как ни крути, — мечта любого программиста. Хотелось сделать систему, которой действительно будет удобно пользоваться и которая при этом будет закрывать реальные потребности рынка.
Эпилог
Что же ждёт нас дальше, да и в целом любой коммерческий проект, который дошёл до такой стадии развития? Тут ничего, кроме разделения на Community и Enterprise, на ум уже не приходит.
Да, оно появится. Но пугаться не стоит: мы не собираемся вырезать из Community‑версии функциональность и превращать её в демку. Ограничения будут касаться, скорее, масштабов использования, а не возможностей самой «Графини».
В остальном — мы будем продолжать развивать продукт, пробовать новые идеи и постепенно двигаться туда, куда несколько лет назад даже смотреть было страшно.
Так что ждём вас в нашем Telegram‑сообществе — там самые свежие новости о проекте.