

В одной из прошлых статей я переписал простую нейронную сеть с Python’а на Java, что позволило мне начать подробнее изучать нейронные сети, а также ставить эксперименты с ними. Я решил попробовать нестандартный подход и алгоритмически решить задачу распознавания рукописных цифр из набора MNIST. Для этого сравнил образец со средним экземпляром класса, а также сравнил их моменты Ху. Полученные результаты сопоставил с решением на основе нейронной сети, и выбрал победителя.
Мне не нравится долгое обучение сети (но с этим можно бороться), а также я крайне недоволен тем, что сеть распознаёт хорошо только цифры из тестового набора, а цифры, написанные моей рукой, сеть распознаёт с точностью 50-60%, и то если я начинаю подстраиваться под неё, рисуя «нужные».
Я подумал, что задачу распознавания цифр можно решить проще — алгоритмически. Первое что приходит на ум: можно взять взять обучающее множество и создать для каждого класса некую среднюю картинку, с которой потом можно сравнить тестовый образец. В моём понимании это «алгоритм здравого смысла».
Чтобы получить среднюю картинку для класса, было бы неплохо разбить обучающее множество по цифрам, и каждое такое подмножество отсортировать. С разбиением обучающего множества на 10 подмножеств проблем нет, а для сортировки необходимо научиться сравнивать картинки. Для этого буду использовать евклидово расстояние, представив картинку как вектор с 784 компонентами. Чем меньше расстояние между картинками, тем ближе они друг к другу.
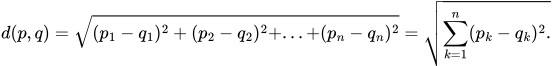
Начну сортировку с картинки с наименьшим количеством пикселей, буду считать её самой простой. Далее нахожу картинку с наименьшем евклидовым расстоянием от первой, ставлю её на второе место, затем ищу картинку с наименьшем расстоянием уже для второй картинки, найденное ставлю на третье место, и так далее. Таким образом можно получить полный порядок и сортировку.
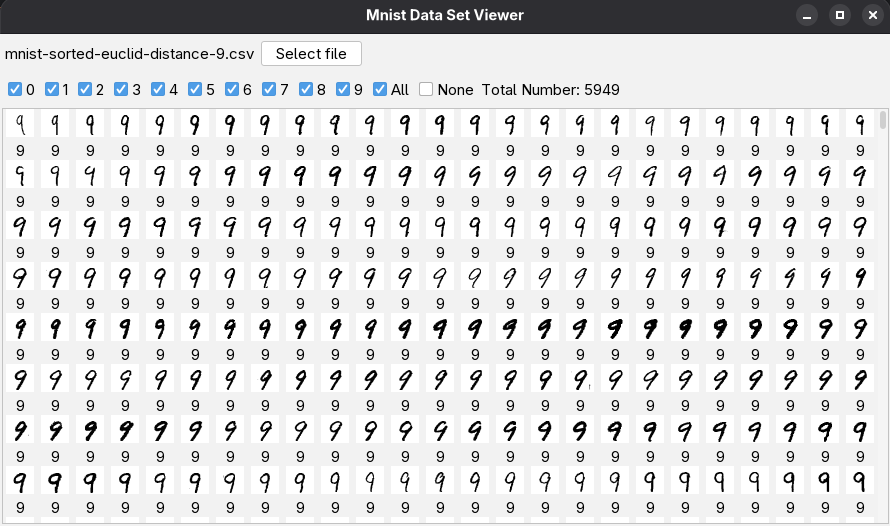
Как я и предполагал, в наборе очень много почти дублей, то есть разницы между соседями почти нет. Можно сделать некий reduce над набором, оставив только картинки с большой разницей, и переобучить сеть. Если результат будет тем же, то удастся кратно сократить длительность обучения. Тут нужны отдельные эксперименты.
Научившись сравнивать картинки между собой, можно перейти к реализации алгоритма сравнения со средним.
Алгоритм здравого смысла
Теперь для каждого класса нахожу как бы среднюю картинку, и в момент проверки вычисляю евклидово расстояние между образцом и средним по классу. Для подсчёта средней картинки прохожусь по всем картинкам класса и суммирую интенсивность каждого пикселя, затем нормализую. В итоге получил такие средние:
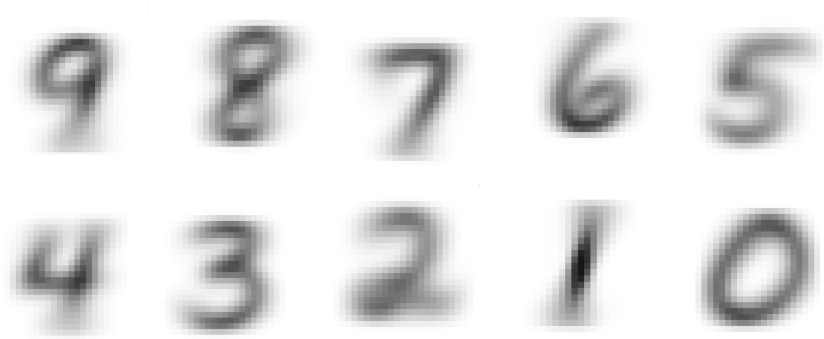
Здесь получается как раз то, что и предполагалась: сильно размытые, но узнаваемые силуэты цифр. Возможно, проблемы есть с единицей.
Теперь всё готово. Мимикрирую модель под нейронную сеть и прогоняю 10 000 тестовых картинок. Получаю точность лишь 77%, что гораздо меньше, чем в алгоритме настоящей нейронной сети (там было 98%). Если теперь попробовать этой моделью распознавать цифры, написанные мышкой, но моей рукой, то там провал полный: точность примерно 20-30%.
Я надеялся получить результат гораздо лучше. Тут можно поднять точность двумя способами: сменить алгоритм получения среднего или сменить алгоритм сравнения тестового образца с этим средним. Я попробую пойти по первому пути, для этого воспользуюсь моментами Ху.
Моменты Ху
Ming-Kuei Hu (Минь-Куэй Ху) — учёный, работавший на стыке оптики, теории информации и обработки изображений. Моменты Ху это некоторые набор чисел, которые можно получить для любой картинки. Такой набор инвариантен к масштабу, повороту, даже отражению. То есть, если картинку, например, поворачивать, то моменты Ху всё равно будут давать одни и те же числа. Выглядит очень заманчиво: я смогу распознавать сильно повёрнутые цифры, либо цифры, нарисованные в углу области.
Формулы для вычисления моментов:
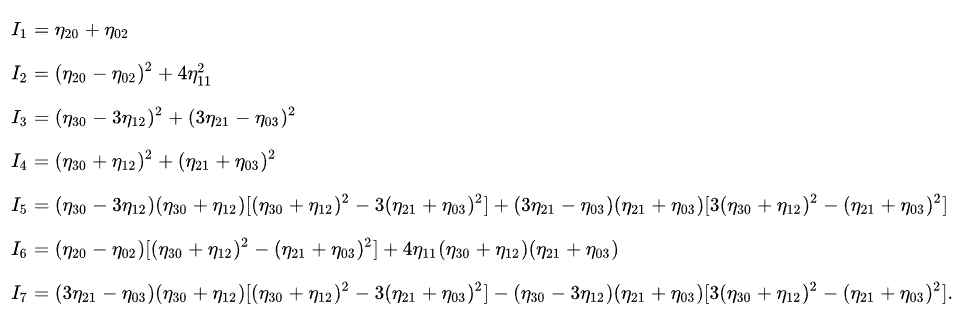
Вдохновился я вот этой статьёй. Алгоритм теперь такой: нахожу средние моменты для каждого класса, затем получаю моменты тестового образца и сравниваю полученные результаты через евклидово расстояние. Средний момент получаю просто как среднее арифметическое для каждого из компонентов.
Математика в исходной статье простая, но есть и очень длинные формулы. Правда, в одной из формул была ошибка, пришлось искать второй источник правды. Там для расчётов использовали OpenCV и есть исходный код на Python. Клонировав проект, я смог получать живые числа и отлаживать. Я удостоверился, что для картинок из статьи, используя свою математику, я получаю те же результаты, а значит я правильно считаю моменты Ху.
Вычислив моменты для каждого класса, проверил на выборке из 10 000 картинок и получил точность примерно 10%, то есть на уровне слепого угадывания 1 к 10. Проанализировав ситуацию, я увидел, что моменты Ху для картинок класса сами по себе сильно различаются, хотя, по идее, должны быть одни и те же числа. Там последние моменты даже могу менять знак, и это рушит всю идею. Видимо, моменты Ху не подходят для распознавания цифр.
Выводы
Скажу честно, я был крайне скептически настроен к нейронным сетям для решения подобных задач. Казалось, что если воспользоваться логикой и здравым смыслом, то получится решить задачу гораздо проще. Но нет, даже применяя на деле «высшую математику», не удаётся получить результат лучше, чем нейронные сети. Наверное, это было понятно заранее, ведь не зря же их придумали и используют, но мне было необходимо самому пройти путь отрицания, смирения и признания.