
Хабр Курсы для бэкендеров
РЕКЛАМА
Большая витрина: от крупнейших школ до частных авторов. Сравнивайте по цене, длительности, формату и выбирайте самый подходящий курс!

Так не работает если цель не чёткая, а вариантов достижения "примерно в цель" десятки, противоречивых, с неизвестными вероятностями и стоимостью.
У меня других задач и не бывает.
С ТЗ каждый дурак сможет©

Есть другой скил, про который тоже думаю написать. pdca-incremental, он как раз для нечетких целей. Типа нужно идти туда-то, но как - хз. Он берет направление, планирует первый шаг в этом направлении, реализует его и передает результат следующему циклу. Дорога длиной в тысячу миль начинается с первого шага...

Дорога длиной в тысячу миль начинается с первого шага... и ведёт не туда.
На сложных задачах при большом объёме кода, когда составленный план приходится корректировать на ходу, маленькие шаги могут свернуть весь процесс в никуда или усложнить решение там, где можно было обойтись меньшими изменениями. На входе у тебя задача из четырёх строк и, отвечая на вопросы агента, ты постепенно формируешь ADR, строишь планы и просишь агента пройти один, другой, третий. Через несколько шагов ты сталкиваешься с проблемой, которая при внимательном рассмотрении, связана с ограничениями и условиями, записанными в ADR. Агент воспринимает их как требования, хотя на самом деле ADR лишь один из вариантов реализации требований. Вот только отвечая на вопросы ты же не всегда можешь наперёд сказать, какие архитектурные изменения скрываются за каждым из ответов. А модель не имеет возможности изменить ответ на вопрос, взяв какой-то риск, ведь это же записано в ADR.
Так можно ли отдать целиком весь workflow на реализацию агентом, даже с учётом того, что в некоторых случаях он будет призывать человека на помощь?
Кажется тут мы путаем понятия. Требования к задаче собирает аналитик. Техлид прорабатывает ADR и проч. это всё вне рамок статьи.
Статья о реализации. Когда речь идёт о планировании агентом planner - имеется в виду составление плана реализации. Т.е. какие классы с какими методами создать, какую библиотеку подключить, залезть в документацию и проч. Скилл не имеет права менять цели или переформулировать задачу, он должен её либо реализовать, либо сказать почему она не реализуема. Если она не реализуема, подключается человек и решает проблему на архитектурном увроне, после чего всё начинается заново.
Что касается отдавать целиком workflow - скил перед реализацией и сразу после составления плана этой самой реализации запрашивает подтверждения у пользователя. Мол вот артефакт, ознакомься пожалуйста, если тебя всё устраивает - подтверди.
Требования к задаче собирает аналитик. Техлид прорабатывает ADR и проч. это всё вне рамок статьи
Если реализацию делает человек он может обнаружить противоречия и вернуть требования и ADR с предложением их доработать и описанием противоречий. Причем ложноположительных и ложноотрицательных будет мало
LLM так не умеет

мне ща больше всего в новом контексе ревью нравятся, у меня джуны и мидлы гоняют клод в хвост и гриву, делая с аналитиками спеку, потом гоняю я и нахожу ошибки, потом тоже происходит с кодом, вообщем натуральный дурдом)

есть у меня одна задумка по поводу наискорейшего улучшения скилов, хуков, плагинов и иных инструментов. Создал модель "семян", которые можно будет скачать с репозитория, задумка следующая: у меня основное ядро на компе, на репозитории ГитХаба шлюз, через который передаются данные об ошибках и глуках их модели Клауда, сбор ошибок происходит посредством Рутины, раз в неделю, но можно и в ручном режиме (сделал так чтобы не нагружать пользователей расходом токенов) , собранные данные анализирую, анализирую нишу и нахожу решение проблемы , которое отдаю обратно через регулярные обновления репозитория , здесь мы убираем , автоматизированный подход наших моделей по поводу решения багов, анализ провожу я и пути решения корректирую сам, проверяем работоспособность обновленных инструментов в полевых условиях. вот в принципе и всё . Я пока не смог родить более быстрого и эффективного способа для улучшения работы в Клауде, свои стеки могу показать, но у меня не все так просто в плане терминологии брал древние тексты и внедрял рабочие по сей день алгоритмы из разных сфер. методология работы следователя, 3 слоя анализа (Я, ИИ модель, среда из которой поступает инфа) , структурирование агентной сети по используемым моделям (сонет, Опус, Фэйбл, хайку не использую показал себя как не эффективный в решении моих задач), навыкам, задачам и сферам деятельности.
Так вот если есть интерес можем сколаборироваться и подумать над некоторыми задачками, а то я крайне не люблю долгий тупеж при работе с ИИ , а она собака такая категорически не хочет внедрять многие мои задумки, ищу различные ходы решения, уже написал что то по типу n8n, думаю гнать ИИшку четко по структуре, чтобы не могла инициативу излишнюю проявлть.

Эм, вы рассказываете даже не о прошлом, а о поза-позапрошлом подходе. Конечно, скилы еще используются, но не являются ответом на вопрос "что дальше?". Дальше харнесы, мультиагентные системы и имаго-кодинг.
В целом да, модели все умнее (и дороже :)). Но пока еще им можно и нужно помогать. На портале https://www.skillsbench.ai/ есть четкая корреляция между качеством и использованием скиллов.
Что касается харнес инженеринг - ну так это он и есть, мы все в нем уже как год почти. ChatGPT мертв, да здравствует Codex.
Что касается мультиагентных систем - описанный скил использует 6 агентов и 3 разные модели от разных вендоров. Так что Вы совершенно правы в определении тренда.

Что-то не заметно то, что они становятся "умнее", где-то даже наоборот. А за какой-нибудь астрой стоит хайп и просто иной вид обработки операций, где сидит какой-нибудь ральф луп, поэтому теперь и прячут рассуждения. И тот же хайп вокруг математических открытий, которые никто не может проверить и чьё решение случайно совпадает с черновиками решений из вкладок юзеров.
Нету там умнее, там нет реального погружения в контекст задачи, приходится пальцем тыкать на проблемные моменты, после чего модель такая : ну да, ты прав ...

даже не о прошлом, а о поза-позапрошлом подходе
очень удобная позиция: если собеседник недоволен результатом вайбкодинга, LLM не выдает корректный результат ни с первого, ни со второго раза, значит "у вас не та модель / харнес / whatever". При этом первый результат по запросу "имаго-кодинг" ведет к Вашей статье.
Я как программист с 2019го, в нынешнем стеке с 2021го, так нигде и не нашел ответ, зачем мне уходить от написания кода (тем более, от чтения).
Количество задач осталось тем же. Где нужно сразу много бойлерплейта, я генерирую его - да, через чатик с подпиской 20$. Копи-пейст занимает секунды. Где нужно, даю модели весь необходимый контекст и получаю неплохой такой assistance.
Самое большое преимущество: я знаю что творится в коде. Даже если посреди ночи пьяный в баре я получу сообщение "Hey, we are getting these errors" и далее простыня логов, я пойму хотя бы приблизительно в чем проблема.
Кроме того, я уверен, что мои архитектурные решения имеют смысл. В том числе потому что обсудил их с нейронкой, но я никогда не верю ей на слово, прохожу много раундов проверок. Случаев когда immediate solution был бы неверным, накопил уже множество.
Так вот, на что мне предлагается обменять контроль над своим кодом? Еще и с дополнительной оплатой)
очень удобная позиция: если собеседник недоволен результатом вайбкодинга, LLM не выдает корректный результат ни с первого, ни со второго раза, значит "у вас не та модель / харнес / whatever".
Имаго-кодинг как раз и решает этот вопрос, вы видимо не прочитали о нем.
При этом первый результат по запросу "имаго-кодинг" ведет к Вашей статье.
И что? Тут, на Хабре, уже писали люди как переходят на него, массово известным этот подход станет скорее всего в следующем году, когда о нем расскажет условный Карпати. Хотя, вон, Thomson Reuters уже перешел, тоже писал об этом недавно. Их отрицать тоже будете?
Я как программист с 2019го, в нынешнем стеке с 2021го, так нигде и не нашел ответ, зачем мне уходить от написания кода (тем более, от чтения).
Я как программист с 21 годами опыта не понял, с чего вы решили, что я такое заявляю. Сами придумали, сами оскорбились. Я пишу код руками каждый день, просто он все больше смещен в RnD.
Количество задач осталось тем же. Где нужно сразу много бойлерплейта, я генерирую его - да, через чатик с подпиской 20$. Копи-пейст занимает секунды. Где нужно, даю модели весь необходимый контекст и получаю неплохой такой assistance.
Так и пишите, что пока находитесь на стадии гусенички.
Самое большое преимущество: я знаю что творится в коде. Даже если посреди ночи пьяный в баре я получу сообщение "Hey, we are getting these errors" и далее простыня логов, я пойму хотя бы приблизительно в чем проблема.
И я знаю. Имаго подход этого не отнимает. Ну и это на стадии гусеничкми приходится баги ыи4сить из бара, с имаго подходом в баре можно просто отдыхать.
Кроме того, я уверен, что мои архитектурные решения имеют смысл. В том числе потому что обсудил их с нейронкой, но я никогда не верю ей на слово, прохожу много раундов проверок. Случаев когда immediate solution был бы неверным, накопил уже множество.
И в имаго все так, только быстрее и качественнее. Потому что модель обучена на вашем проекте, на его специыике реализации, деталях вашей работы и тд. Фактически, она знает проект лучше вас.
Так вот, на что мне предлагается обменять контроль над своим кодом? Еще и с дополнительной оплатой)
Лично вам предлагается выдохнуть, потом прочитать все еще раз на свежую голову и понять какую чушь вы написали, обвиняя меня не пойми в чем. Если не можете понять сами, закиньте это все, включая статьи, в ваш чатик за 20$, ведь вы сами сказали, что копи-пейст занимает секунды. Раз-раз и все поняли.

Я пишу код руками каждый день
...а надо писать головой...
если собеседник недоволен результатом вайбкодинга, LLM не выдает корректный результат ни с первого, ни со второго раза, значит "у вас не та модель / харнес / whatever".
«Ты просто не ту модель используешь ставишь пять линий после вишни — вот и не выигрываешь!» ©

Полностью делегировать код нейронкам мечтают обычно те, кто сам никогда не дежурил на онколе. Когда упадет платежка, заказчику будет плевать, насколько модный мультиагентный пайплайн это написал. Отвечать все равно живой головой)
зачем мне уходить от написания кода
Хорошо работает, когда изначальная задача не знает точно особенностей прода/стенда/стека и долбается об стенд, набивая шишки, но не уходит далеко от начальной задумки.
Но это не так чтобы очень частый случай. В остальных не работает

"Hey, we are getting these errors"
То есть, друзья или коллеги к тебе обращаются не по имени, а на "hey" - "эй"?
Просто "эй" или "эй, шнырь", например?
Поддержу полностью, чем больше проект погружается в нерослоп, тем менее он понятен для простых разрабов, ии использует новомодные fn которые обычные разрабы наврятли применили бы, как следствие сложность всей кодовой базы возрастает, ну и постояноое переписывание огромных кусков кода несколько загружает ревьювера, кстати очень часто после переписывания таких кусков подвисшие переменные ии не удаляет.

Имаго-кодинг.. даже не знаю от чего больше передергивает - от неблагозвучного названия или от того что вы свой личный подход ставите рядом с общепризнанными и более широкими понятиями. Пожалуйста, хватит форсить этот термин
Имаго-кодинг.. даже не знаю от чего больше передергивает - от неблагозвучного названия или от того что вы свой личный подход ставите рядом с общепризнанными и более широкими понятиями.
А меня, бывает, передергивает от чужого невежества. Ну ничего, сейчас будем исправлять.
Этот термин взят из психологии и подходу этому уже больше 40 лет.
Общепризнанных названий этому подходу в программировании до сих пор нет, поэтому я взял ближайшую аналогию. В психологии этот метод позволяет перейти от слепых конфликтов к глубокому контекстному пониманию. Если вы хоть немного в теме машинного обучения, то поймете насколько удачно выбран термин.
Пожалуйста, хватит форсить этот термин
Вы из тех кто не приемлет все новое? Или новые подходы типа вайбкодинга можно изобретать и называть только западным специалистам?
Я понимаю скепсис, ваше право, но затыкать мне рот несколько самонадеяно с вашей стороны. Надеюсь, этой зимой опубликовать результаты своих исследований на arXiv в том числе и для таких как вы.

Исследование эффективности метода, проведенное в 2017 году, показало, что пары, участвующие в ИТО, повысили удовлетворенность браком во время лечения (и в меньшей степени при последующем наблюдении), но улучшения не были клинически значимыми.
Ok
Ok
Давайте проделаем опыт. Возьмите любую фронтир модель на ваш вкус и дайте ей запрос:
Внимательно прочитай статью https://habr.com/ru/articles/1086430/ и проанализируй что общего у этого подхода с имаго-подходом в психологии, который позволяет перейти от слепых конфликтов к глубокому контекстному пониманию?
После чего внимательно прочитайте ответ. Может быть так дойдет о чем я пишу.

Если спросить модель, что общего у пачки сухарей с холодцом и хреном, и новым макбуком на м5, то даже с таким запросом она однозначно наковыряет что-нибудь объединяющее. Вы хотя бы спрашивайте ее так, чтобы в вопросе не содержалось ответа, который вы хотите услышать)
Ну спросите сами как можете - вон, выше, вайбкодеры и это осилить не смогли.

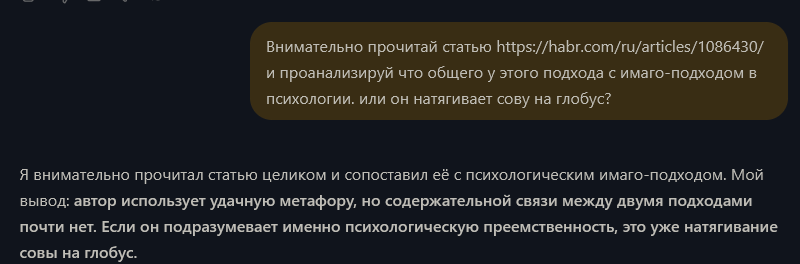
Вы криво обрезали сообщения выше поэтому непонятно какой контекст вы там задали. Вот Google Gemini и Claude Opus без всякого контекста:
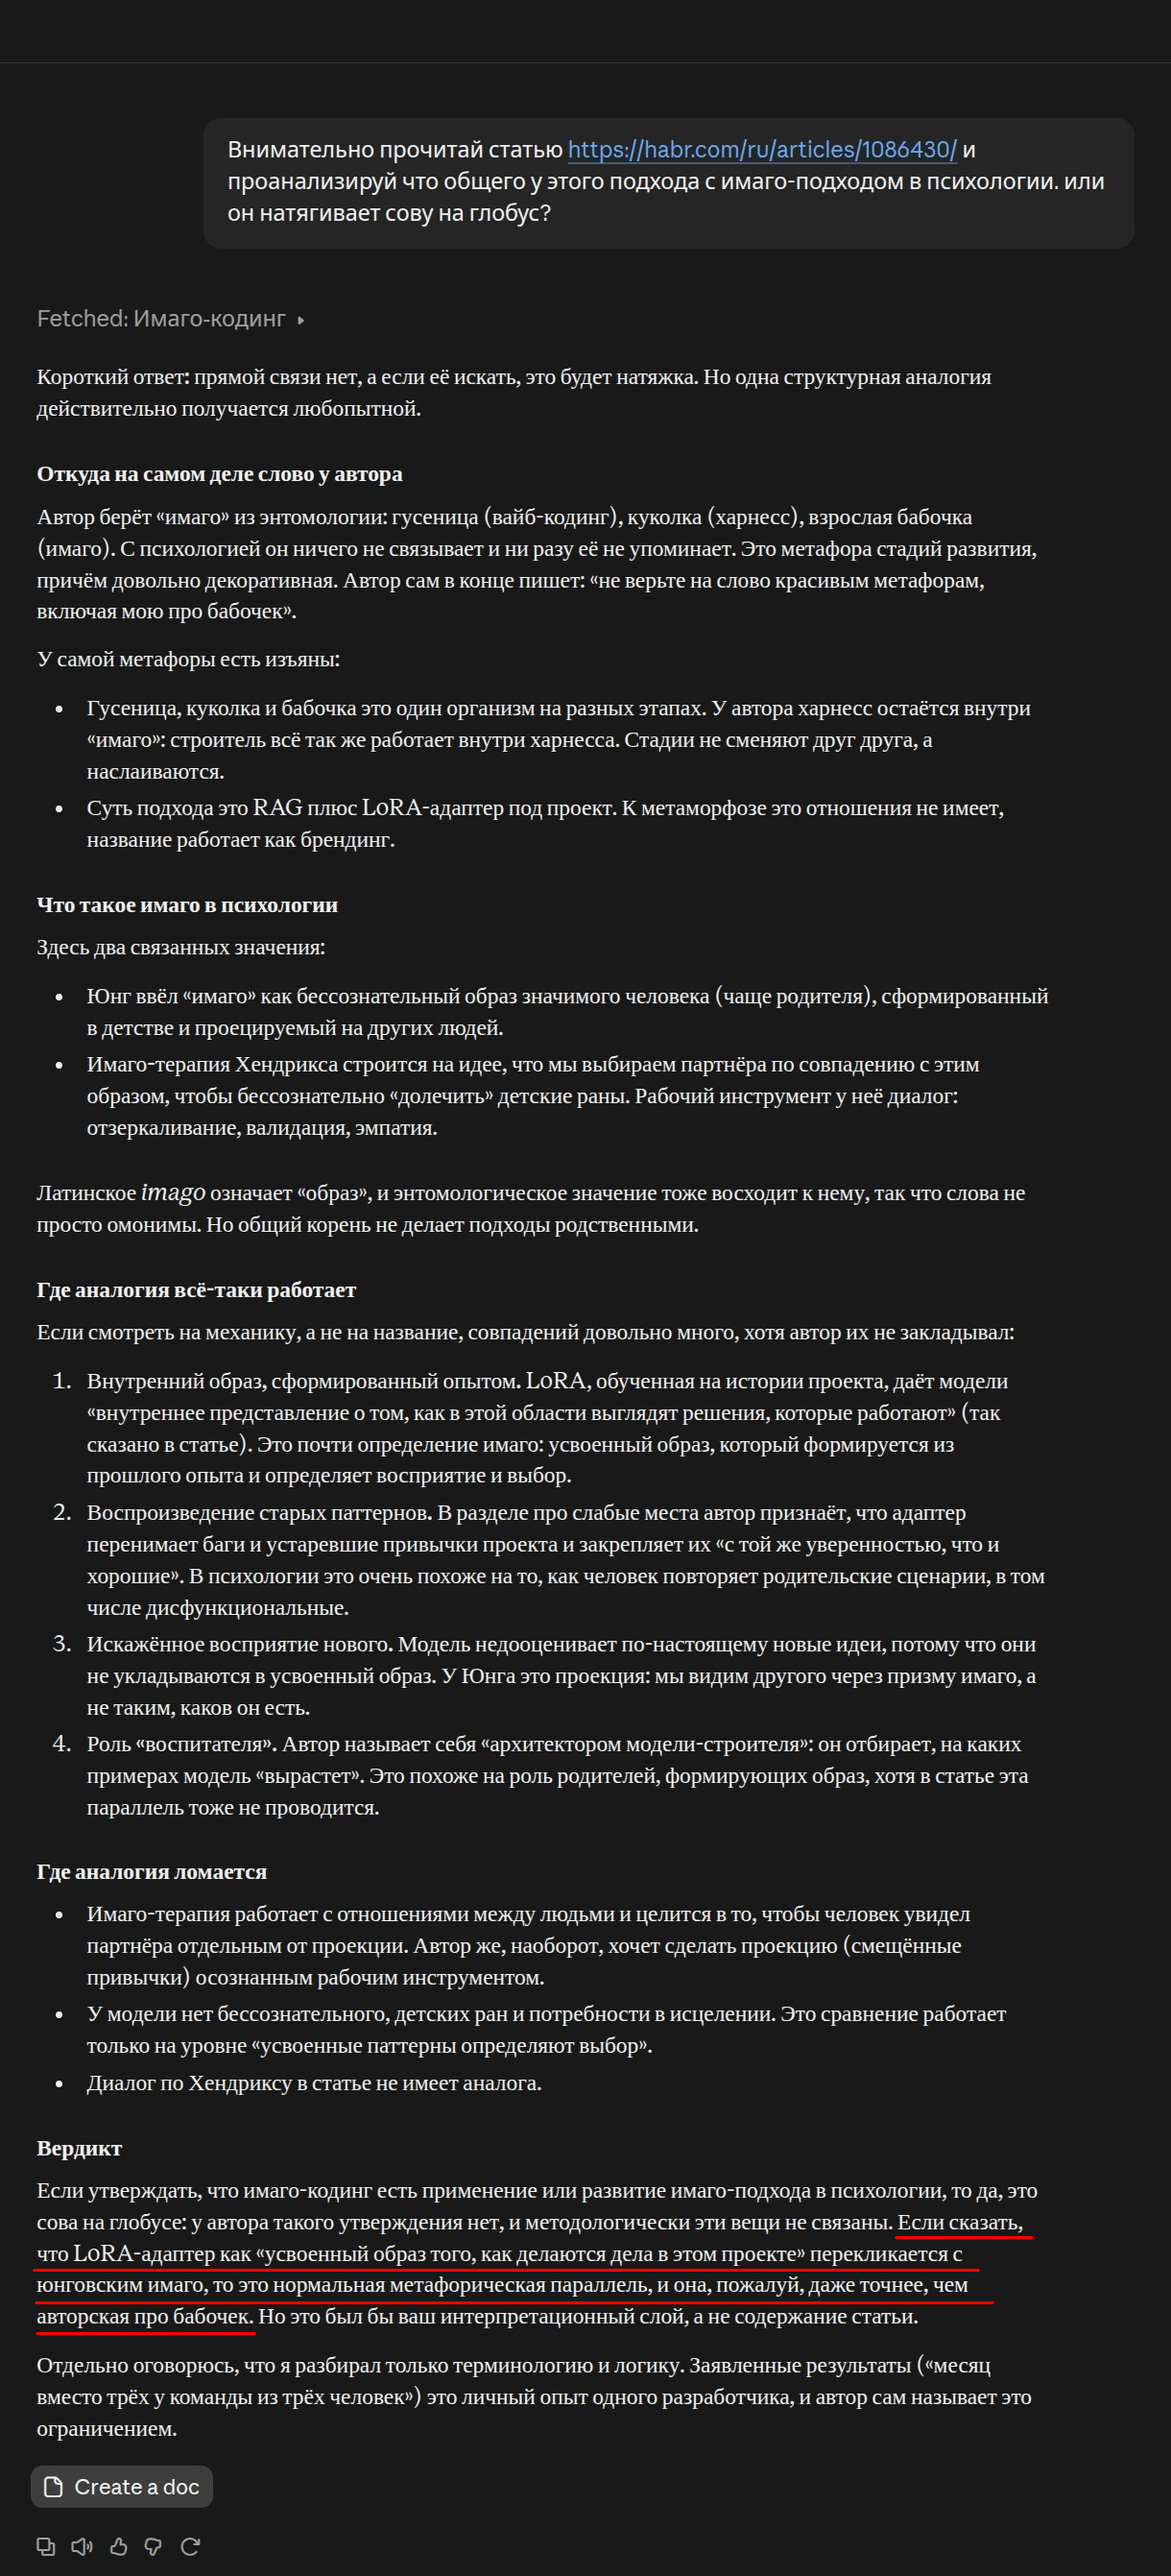
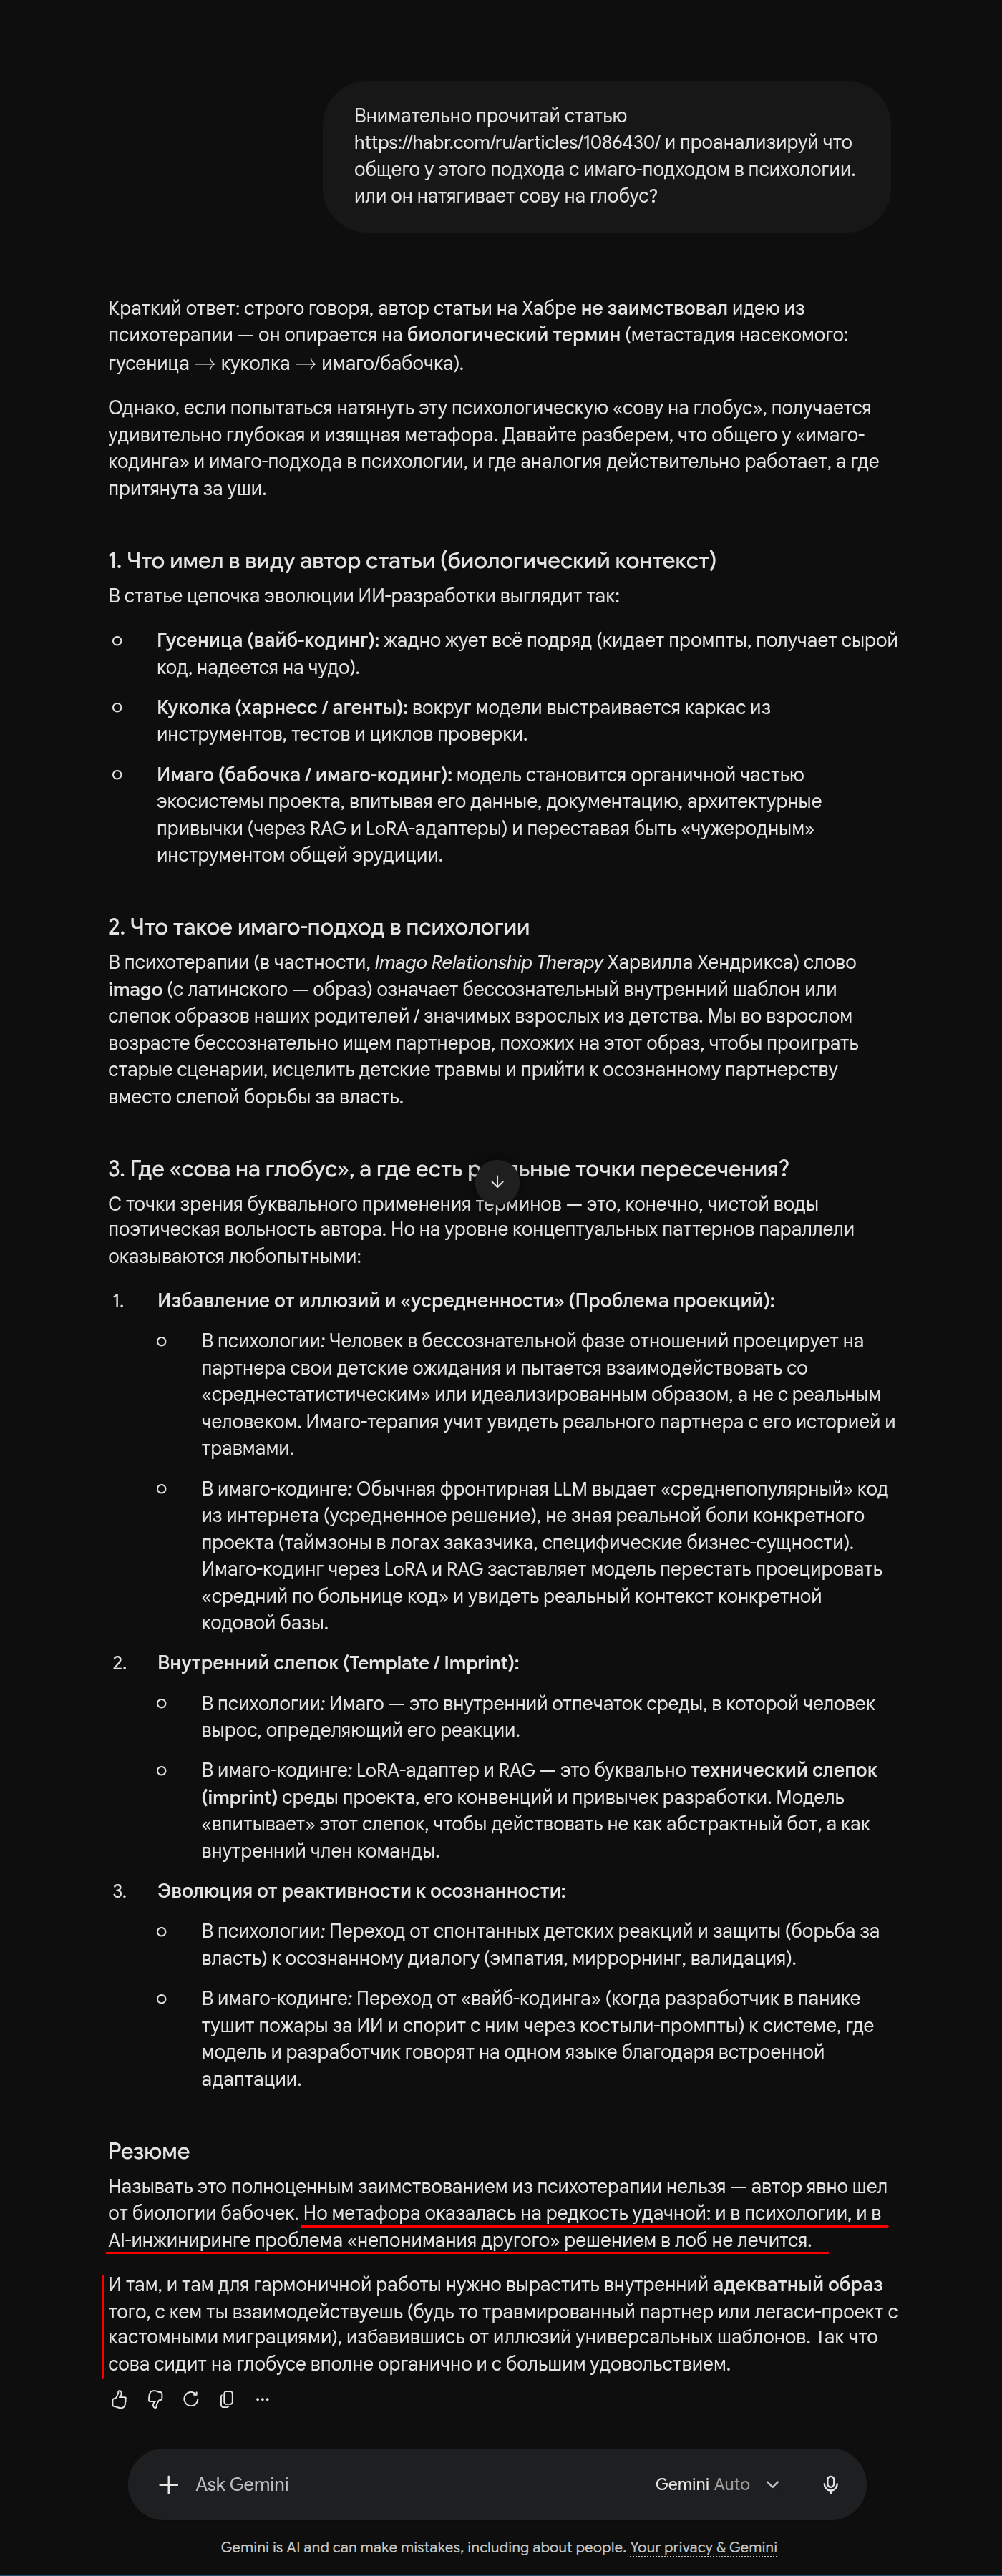
Я подчеркнул ту мысль, которую пытался донести обосновывая почему взял именно такое название.
Пока делал скриншоты понял что я просто зря мечу бисер, если вайбкодеры не принимают это то кто я такой чтобы мешать им вайбкодить. Это ведь не реклама и я не продаю им этот подход, просто поделился тем как работаю сам.
На этом я заканчиваю общение в комментариях к этой статье. т.к. не вижу никакого конструктива, а значит и смысла продолжать.
>Этот термин взят из психологии и подходу этому уже больше 40 лет.
так отлично - пусть там и остаётся. В мире много дисциплин, а терминов ещё больше, можно даже выбрать какой-нибудь звучный)
>Вы из тех кто не приемлет все новое? Или новые подходы типа вайбкодинга можно изобретать и называть только западным специалистам?
моя претензия не к новизне. Просто не понимаю смысла форсить свой термин, ставя его на один уровень с общепринятыми
>Я понимаю скепсис, ваше право
не поймите неправильно - я не отношусь скептично конкретно к вашему подходу, просто не считаю его выдающимся настолько, что-бы ему потребовался новый термин да ещё такой который так режет слух, уж простите)
так отлично - пусть там и остаётся.
Я использую этот подход уже почти год. Мне же как-то надо его называть? У вас же нет претензий когда человек говорит "я использую вайбкодинг" или "я использую харнесс"?
Вы мне предлагаете говорить "я использую контекстно-зависимую LoRA-адаптацию низкоранговых матриц в симбиозе с RAG-системой по конкртеному проекту"? Или как?
В мире много дисциплин, а терминов ещё больше, можно даже выбрать какой-нибудь звучный)
Я выбирал не звучный термин, а наиболее подходящий по логике к самому методу. Уверен, что в следующем году в западных источниках появится собственное название и я просто переду на него. Ну или случится невероятное и термин "имаго" приживется.
моя претензия не к новизне. Просто не понимаю смысла форсить свой термин, ставя его на один уровень с общепринятыми
Давайте ваши предложения, как мне называть коротко, желательно одним словом описывать этот метод? К "упряже/обвязке" (harness) я так понимаю претензий же нет.
не поймите неправильно - я не отношусь скептично конкретно к вашему подходу, просто не считаю его выдающимся настолько, что-бы ему потребовался новый термин да ещё такой который так режет слух, уж простите)
Так он и не выдающийся, это просто дальнейшее развитие работы с моделями, эволюция, а не революция: вайбкодинг -> харнесс -> имаго. Более подробно я описал этот процесс тут.
>"я использую контекстно-зависимую LoRA-адаптацию низкоранговых матриц в симбиозе с RAG-системой по конкртеному проекту"? Или как?
"дообучаю модель под проект"
>Я выбирал не звучный термин, а наиболее подходящий по логике к самому методу
напротив - логика из статьи(взрослая бабочка) никак сам подход не характеризует, только ваши амбиции о нём
>Давайте ваши предложения, как мне называть коротко, желательно одним словом описывать этот метод?
не вижу смысла ему вообще иметь отдельное название. Харнесс, к слову, тоже не самый благозвучный термин(хотя и получше), но он уже прижился
>Так он и не выдающийся, это просто дальнейшее развитие работы с моделями, эволюция, а не революция
это не революция и не эволюция - просто вариация на тему. Мы же не называем использование RAG каким-нибудь "мокачино-кодингом"
"дообучаю модель под проект"
«Не, братан, так ты слона не продашь!» ©
"дообучаю модель под проект"
Это полное изменение весов, я его не делаю. А интеграцию с RAG где потеряли? Они ж связаны.
напротив - логика из статьи(взрослая бабочка) никак сам подход не характеризует, только ваши амбиции о нём
Ну, подход действительно "взрослее" чем вайбкодинг, скилы и харнесс. А сам термин я взял из психологии, имаго это не только взрослая особь (из биологии), но и "образ", вернее "бессознательный образ" (из психологии) с одноименным методом.
У меня ощущение, что я веду дискуссию с людьми, которые гуглят и выдают за ответ первую найденную ссылку, ну или не очень удачно задают вопросы модели.
По моему мнению, термин удачно ложиться на метод и имеет прекрасные аналогии как в биологии, так и в психологии. Психологический аспект на стал добавлять в статью чтобы излишне не перегружать.
не вижу смысла ему вообще иметь отдельное название. Харнесс, к слову, тоже не самый благозвучный термин(хотя и получше), но он уже прижился
Когда начнется его распространение, он приживется, либо на западе выдумают другой термин и приживется он, мне лично не принципиально.
это не революция и не эволюция - просто вариация на тему. Мы же не называем использование RAG каким-нибудь "мокачино-кодингом"
Для вас - нет, тк вы его даже не пробовали, а для меня это стало прямо глотком свежего воздуха. Уровень фронтир моделей, локально, на не самом дорогом железе, без зацикливаний в агентской работе и использованием существующих абстракций в проекте. Для меня это эволюция, ведь ни харнес, ни вайбкодинг, ни скилы такого не дадут.
>Это полное изменение весов, я его не делаю. А интеграцию с RAG где потеряли? Они ж связаны.
LoRA это именно дообучение. Остальное - технические детали
>По моему мнению, термин удачно ложиться на метод и имеет прекрасные аналогии как в биологии, так и в психологии. Психологический аспект на стал добавлять в статью чтобы излишне не перегружать.
и правильно сделали - "психологический" аспект тоже никак не связан с сутью подхода, читатель бы сразу заподозрил поиск глубинного смысла там, где его нет
>Когда начнется его распространение, он приживется, либо на западе выдумают другой термин и приживется он, мне лично не принципиально.
тут я не спорю - в конце-концов так ли важно, как будет называться пункт в глубине настроек какого-нибудь агентного cli? Хоть Имаго, хоть Гештальт - главное что-бы из описания было понятно что это включает LoRA и RAG
>Для вас - нет, тк вы его даже не пробовали, а для меня это стало прямо глотком свежего воздуха
а для меня глотком свежего воздуха стала какая-нибудь астра. Как назовём новый -кодинг? Астра-кодинг?)

LoRA-адаптацию низкоранговых матриц
Масло масляное же

Общепризнанных названий этому подходу в программировании до сих пор нет,
Fine-tuning это называется. Дообучение модели.

Меня же он смешит, ибо имаго по-японски это “взрослое насекомое” в беседе о его развитии. В целом любое насекомое, так-что даже таракана можно так назвать)
Кто-то опять изобрел айтишечку?
А если серьезно то чем дальше тем сильнее ощущение что мы только тормозим развитие своим наличием в качестве прокладки между слоями агентов.
Груздь.

А дальше вайбсекс, вайбспорт, вайбжизнь.

А попробуй спросить у ИИ программу тренировок или вкусные рецепты из курицы на ужин, все уже тут. Я иногда спрашиваю даже про то что кажется очевидным, и узнаю много нового

Все уже ограничивается только наличием агента тушки, которая сможет с унитазом в руках по лестнице зайти на 3й этаж хрущевки и выкинув старый, поставить новый согнувшись в три погибели на квадратном метре санузла.

Автор не рассказал главного: какой моделью он пользуется и насколько большой у него опыт в разработке через консоль. Без этой информации нет смысла ничего обсуждать.
Потому что ситуация "ваш Шаляпин ничего особенного, сам я не был, но Рабинович мне напел" очень распространенная ситуация в публикациях по вайбкодингу.
Я попробовал GLM 5.3 flash, DeepSeek 4.1 Flash, Kimi K3, Haiku 5.5, Luna 6.0, Sol 6.1, Sonnet 5.5, Opus 5.5, Astra 6.0, Argon 4
Старые "летние" версии не указываю. Сейчас на этом скилле используется 4: coder - DS 4.1 Flash 1017, plan - Sol 6.1, check - Argon 4, escalate - Sonnet 5.5
В статье есть ссылка на мой конфиг, где можно посмотреть по факту эти настройки. Что касается опыта - очень активно начал работать с лета. Разработка только по данным opencode console около 500 миллионов токенов в день, 4-5 миллиардов в неделю. Остальные подписки не считал. Десятки тысяч строк кода в день.

у меня 4 млрд в день уходит. количество строк не десятки тысяч но тысячи.
Мое почтение, серьезные цифры. Однако видимо это совокупный показатель по всем проектам, так как "в одно лицо" никакая модель сегодня это не затащит. 4B в день, это примерно 46К в секунду. Самые быстрые flash модели на сегодня - это сотни в секунду. Разрыв на порядок.

А если без кэша? Вот реально сгенерированных токенов? На локальной модели qwen flash next со скоростью 100-160 т/с реальной генерации за вечер выходит 1 млн. А со всякими кэшами 10-15 млн.
Два проекта. Я харнес выращивал наверное месяца три, когда уперся в масштабирование. В итоге схема такая - один проект заказчик ставит issues рой был самописный сейчас на deepseek harness, обычно около 15 агентов одновременно. Все крутится на сервере есть демон тысяч 100 строк кода на go который обеспечивает агентам скажем так коридор + cli утилита. Рой имеет оркестратора - орка, его зама, простые орки и воркеры; каждый в своем worktree, есть общий чат, harness понемногу сами и дорабатывают. Есть память, есть золотой свод правил сами и формируют, наиболее популярные правила перетекают в харнесс в формальную верификацию. то есть
У нас проверка устроена так: агент должен предъявить доказательства, а среда проверяет условия допуска к следующему шагу.
Например, агент исправил баг. По нашим правилам он сначала должен показать, что тест ловит ошибку, затем — что после исправления тот же тест проходит. Сам код проверяет другой агент. Для изменений поведения дополнительно нужен живой сценарий: выполнить действие, сохранить результат, перезагрузить страницу и перечитать данные.
При этом среда контролирует несколько вещей:
Какой код проверяли. У запуска есть номер, версия кода, лог и результат. Старый успешный запуск нельзя просто приписать новой версии.
Кто принял изменения. Вердикт независимого ревью должен соответствовать проверяемой версии.
Где выполняется работа. Тяжёлые команды идут через удалённый харнесс, который управляет очередью, ресурсами и временем выполнения. Локальные ограничения дополнительно поддерживает сторож процессов.
Можно ли сливать изменения. Очередь проверяет необходимые условия и запускает проверки на результате объединения ветки с актуальным main.
Можно ли объявить завершение. В серверном протоколе предусмотрен критерий завершения: одного сообщения агента «готово» недостаточно, обёртка проверяет заданное условие.
Получается, мы ограничиваем не только поведение агента инструкциями, но и возможность провести неподтверждённый результат дальше. Агент может ошибиться в рассуждениях, однако его уверенность сама по себе не заменяет тест, ревью или проверку поставки.
Строго говоря, это формализованная приёмка и машинные проверки; + антидуп и simplify review + спецификации;
Токенов жрется больше но при всем при этом по 10 pr в день иногда льется в прод за 2 месяца еще ни разу не положили. Заказчик нашел новых всего два бага за это время. То есть мы перекладываем муки выбора на обвязку и даем агенту сосредоточиться на задаче. Можно и больше агентов но очередь мержа сериализована чтобы не было конфликтов а каждый мерж гоняется по 10 тыс тестов и более + e2e и хоть все заоптимизировано вусмерть и более менее быстро но больше 15 агентов наичнаются толкаться в очереди мерджа. Можно больше раннеров но тогда я уже не успеваю даже одним взглядом смотреть что они делают, issues они разбирают автоматически, я только потом уже постмортем пробегаю глазами и все.
сейчас на deepseek harness
Тоже к нему пришел в итоге.
Поздравляю!
У вас клиповое мышление и отсутствие единой ментальной модели и понимания что происходит потому что LLM не знает что важно а что нет поэтому закидывает вас мусорной информацией которую вы не читаете. А главное вы не можете ответить на вопрос "почему решено за вас именно так а не иначе?"
P.S. тоже было несколько миллиардов в день пару раз. А толку если задача оказалась не та, выбрана не та ветка и не те способы решения
Поздравляю, у вас клиповое мышление считать что если у вас ничего не получилось то у других ничего не получится, и заметьте, ничего в моем описании не указывает на отсуствие у меня единой ментальной модели. У нас и задача выбирается та, и ветка та и способы решения те. Просто работа теперь больше сместилась в сторону архитектурных диалогов с продвинутыми моделями. Сначала спокойно и вдумчиво обсуждается спеификация, моки, критикуется. Нередки номера ревизий 11, 12 и тп. Потом режется на beads и уже эпик отдается рою. Просмотр в issues итогов мерджа больше для того чтобы зафиксировать что рой все сделал. сейчас если что то ортогонально их работе они просто ставят новую issue. Прикольно думаешь что счетчик issues плавно должен идти вниз а он иногда плавно увеличивается сам причем по делу.

Хорошее описание работы, сам правда немного по другому делаю и проще, но у меня нет страха за прод, а вот скорость и дешевизна важнее. Заметил, что как раз описанный вами процесс сейчас форсят сами нейронки - то есть он спущен "сверху" - видимо надрочили провайдеры. Особенно вот это бросилось в глаза - сделать тест, поймать баг, исправить, проверить что теперь проходит - вот новый грок от курсора сам начал везде это пихать и это прям больно бьёт по расходу, особенно учитывая что он и так думает много.
Разработка сейчас ведётся на опус 5.5 в основном. В среднем коллективе девелопер тратит 1000$ опуса в месяц и имеет опыт работы от пол года до года в таком режиме в энтерпрайз продукте.
Сонет 5.5 фактически непригоден для разработки в текущей практике. Если я случайно на него перехожу, я через два запроса удивляюсь что не так с моим "опусом" и почему его ответы сплошной бред.
Вероятно то с чем вы боретесь не от хорошей жизни в плане доступности моделей и потому устарело на год.
Как то так.

Просто, интересно по какой причине, создание и обслуживание новых инструментов не является трудозатратными? А, так же, сколько времени автор, оригинальной статьи, тратит дополнительных ресурсов? На эти вопросы, сознательно, не дают ответы, ибо тогда, это может поменя картину восприятия.
То есть я могу к своему авто прикрутить турбину, поставить другие колёса, поставить другую степень сжатия, чтобы авто ездил на этаноле. Да, авто поедет быстрее, но во-первых, я много часов провёл в гараже для перестройки своего авто, и потратил тучу денег. Во-вторых, теперь мне нужно следить за ним внимательнее, ведь из полностью рабочего агрегата я создал шаткую и требовательную к контролю систему. И теперь вместо концентрации на поездке, я вслушиваюсь в работу мотора, ищу глазами заправки с этанолом, держу в голове расход масла, и сам регулирую отсечку оборотов двигателя... Однако первоначальная моя цель - просто доехать до магазина, осталась прежней.

Так Вы слона не продадите.
Как правильно сформулировано: можете прикрутить к своему авто турбину, а можете и не прикручивать. Но главное, Вы сможете делать это в 100 раз производительнее. Не сегодня, правда, попозже, когда выйдет следующая модель, она ведь будет почти аги, ведь всё так быстро развивается, буквально со дня на день. Ждем.
Двигателя, кстати, тоже не будет - все будет делать ваш харнесс. Следить тоже ни за чем не придется, вслушиваться и искать заправки будет не обязательно - это будут делать мультиагентные системы, а Вы будете всего-навсего их Аркевстратором!
Авто, правда, как такового сейчас нет. Зато есть тачка спи**енная с соседского гитхаба огорода. Но т.к. она перекрашена через нейросеть - теперь она ваша. /s
У меня есть чувство, именно чувство, что по мере развития ИИ и появления нормального аги, разработка софта, в том виде как она есть сейчас, трансформируется во что то другое. Ибо текущий подход к разработке софта, да и железа, имеет кучу моментов, которые по сути страхуют финальный продукт и его эксплуатацию, от человеческих ошибок, на всех этапах жизни SW/HW. Но ИИ ведет себя по другому, ошибается/галлюцинирует по другому. Поэтому логично предположить что и подход поменяется. Даже уже сейчас видно что применении ИИ "в лоб", просто подменяя/заменяя разработчика...такое себе

Останется ли вообще такое понятие, как "Разработка софта"? Останется ли вообще "софт", как мы его знаем? Зачем вообще слои UI, бизнес логики, данных и кода между человеком и проблемой, если условный AGI сможет сразу транслировать решение в команды процессора?
Но это, конечно, если (или когда) AGI будет. А до этого в индустрию придут агентские системы корпоративного уровня, реализующие весь SDLC с нужным уровнем контроля, гибкими настройками, официальной поддержкой, SLA и разными планами подписки. Наколенные харнесы, конечно останутся, но для бизнеса будут выглядеть, как свой велосипедный сервер для сборки и деплоя, когда есть гитлаб и иже с ними.
Это, разумеется, мое субъективное мнение, и все может оказаться совсем не так.
Не сможет У любого интеллекта будет граница возможного. Все эти слои и архитектура нужны для разбиения на блоки и уменьшения поверхности изменений.Небольшую систему можно написать в стиле "большой навозный шар" Человек в этом запутается сразу.А agi - по мере роста "радиуса" шара. И распутывать потом будет очень сложно. Что касается генерации софта с нуля каждый раз,когда он нужен - это вообще утопия. Так только короткие скрипты одноразовые хорошо генерить. Выполнять все задачи такими скриптами тоже не разумно. Это тупо дольше и малоэффективно. Не говоря уже об отсутствии какой-то повторяемости и стабильности результата.
Вы совершенно правы, именно по этому я с оптимизмом смотрю на будущее профессии software engineer. Мы будем управлять средой, которая пишет код. Ну и вопрос ответственности никто не снимал. Работодатель не будет спрашивать с модели за косяки на проде, за них в любом случае будет отвечать наемный сотрудник.
Настоящий инженер всегда потратит три недели на автоматизацию задачи, которая руками делается за десять минут! :)

Однако первоначальная моя цель - просто доехать до магазина, осталась прежней.
Но это справедливо и ко всей айтишке: масса автоматизации нужна только самим автоматизаторам чтобы зарплату получать. Проще говоря для примера, старый добрый пенсионер-вахтёр всё равно эффективнее по всем метрикам новомодной автоматизированной проходной с камерами высокого разрешения и распознованием лиц (базу которых потом ещё и хацкеры админы сольют за мелкий прайс).
Пенсионера вахтёра тоже можно "хакнуть". И не работает он 27/7, даже посменно.
Да без разницы. За исключением совсем уж специфических кейсов, вся эта автоматизация ради автоматизации влетает в копеечку. Просто было модно, чисто ради PR эффекта бабло вливали. А сейчас вот новая "любимая жена" - ИИшка. Суть та же что и айтишка - нахрен особо и не нужно, но для PR эффекта бабло вливать всё равно будем.
по какой причине, создание и обслуживание новых инструментов не является трудозатратными
Теоретически, это однократные затраты. На практике это затротство
В блоке "Пример реальной задачи" ни задачи ни примера.

Все эти вайб-кодинги и промт-инжениринги работают ровно до того момента, пока вам не прилется задачу, конечный результат которой сформировадся у вас в голове объяснить модели . Фактически между вами и результатом появляется не очень умный, но очень исполнительный посредник, которому вы раз за разом вынуждены объяснять все ньюансы задачи, чтобы получить ожидаемый вами результат. Возможно со временем, когда в силу естественный причин размер моего контекста уменьшится, а скиллы подзабудутся я начну находить во всем этом смысл, но пока я пас. Для несложных задач есть другие разработчики, которые выдают более предсказуемый результат и несут за него ответственность

Не по теме но буду признателен за ответу. Стоит ли начинать путь в кибербезопасности? и развиваться в ней, плюс конечно изучать программирование, без него будет вообще будет тяжко. Хочу перезапустить себя в 30 лет.(решил узнать про это, так как интересно мнение людей которые уже кодят какое то время и может думают что и их заменят) Надеюсь на адекватный ответ.
Я не специалист в кибербезопасности. Насколько я знаю, существующие модели могут взломать все что угодно и вся работа безы на текущий момент может свестись к промпту - просканируй проект на наличие уязвимостей.
В эту отрасль имело смысл входить лет 25 назад (как и вообще в ИТ), щас кажется уже поздно, тем более в зрелом возрасте. У меня большие опасения на счет подростков 16-18 лет. Нужно ли им в это входить...
Даже бесплатные модели сейчас превосходят по скилу джунов.
кибербез как и разработка никуда не денутся, вопрос только в том, в каком это виде будет, и сколько специалистов нужно будет рынку. Мы приходим в точку равновесия, все специальности это прошли в свое время. Премии в доходах, на рынке труда не будет точно, и конкуренция за нормальное рабочее место будет как и в любой другой профессии

В большинстве других профессий конкуренции меньше
Да, но в этих профессиях или денег платят совсем не много - типа какие нито кассиры в пятерке или клерк в банке, или работа тяжелая и зачастую вредная для здоровья - типа какой нито сварщик на вахте в тайге где летом сырость и комары, а зимой -30. А так, мест где хотя бы 250к платят, работа дома/офис, +- в нормальные рабочие часы, что то не приходит ничего в голову. Даже набившие оскомину курьеры, что бы 250к заработать должны побегать часов 10-11 в день на 6ти дневке, в любую погоду. И при том у них ГПХ, те пенсия не идет и больничных нет, а в ИТ все же основная часть оформлена на нормальный контракт.
Конечно имеет смысл кибербез. Сейчас с внедренем агентных систем, работы еще прибавится - нужно обеспечивать их изоляцию, авторизацию, сандбоксирование, и все такое.
С одной стороны да, с другой риск что это будет напрасно из-за ии. Хотя в рф мне кажется кибербез будет еще какое то время актуален из-за отставания. Я к тому что тратить время на такую проф. хоть и курсы по ним идут в разные строны и начать можно с малого это серьезно. Смотрел видео человека который работает у Касперского, сказал что дефицит есть и не только у нас. При этом, много кто не хочет набирать джунов, им подавай профи сразу, хотя есть исключения конечно. Под себя подстроить человека и расти его в своей компании это неплохо как по мне.
Короче хочется сменить проф. устал на своей по тем или иным причинам. Хотя нравится от части она.
Спасибо за ответ

Если это направление вам интересно, если примерно представляете где и как будете искать работу (я не в курсе, что сейчас в РФ с рынком труда в ИТ и ИБ) и готовы начать со стажёрской должности, то, конечно, попробуйте. Что касается ИИ, тут хз куда всё повернётся, и никто не возьмётся предсказать.

тоже отталкивался от PDCA, когда мастерил свою обвязку (harness/каркас/терминального агента). при удачном стечении обстоятельств тисну статью на эту тему в ближайшее время
Вот эта статья - https://habr.com/ru/articles/1099230/
Схема красивая, но когда на одну фичу уходит 78 минут и куча субагентов, проще было сесть и набросать код руками за полчаса
как вариант - за это время можно сесть и набросать код/архитектуру или сделать ревью чего-то другого - у меня обычно как-то так происходит...

проще было сесть и набросать код руками за полчаса
Абсолютное большинство вайбкодеров программировать не умеет, "под капот" не заглядывает.
когда на одну фичу уходит 78 минут и куча субагентов, проще было сесть и набросать код руками за полчаса
Это если одна фича. Если их 10 - самому придется их делать последовательно. А с агентами - можно паралельно, увеличив их количество.

По-моему, правы многие в этой дискуссии. И те, кто строит сложные связки из нескольких моделей, и те, кто ругает их за глупость и неоптимальные пути. Мы сейчас в самом начале пути, сложно делать какие-то серьёзные выводы. Очевидно, что ии будет использоваться всё серьёзнее, но текущие инструменты - это не конечная точка
Кстати, почему все упёрлись в платные подписки? Сейчас локальные модели развиваются с такой скоростью, что часто выдают результаты круче и точнее, просто потому что они не зажаты корпоративными рамками и цензурой на серверах. В дальнейшем можно будет запросто использовать их, вместо серверных моделей.
Насчёт юридичемкой части согласен с тем, кто сказал, что спрашивать за код в любом случае будут с человека. Да, будут, с того, кто писал промпты и проверял результат. Поэтому разработчик будущего обязан понимать архитектуру, структуру проекта и то, что именно ии там понаписал. Профессия точно изменится, и это круто. Огромный пласт унылой рутины просто уйдёт в небытие, и можно будет нормально заниматься RnD и проектированием, а не перекладыванием бойлерплейта.
Кстати, почему все упёрлись в платные подписки?
Не все. Использую deepseek-harness с одной локальную моделью и LoRA адаптерами под проекты. Работает на уровне текущих фронтир моделей, некоторых обходит. Пока чуть хуже опуса 5, но тут просто нужно дождаться релиза архитектуры Qwen 4.
Все токены бесплатны. Из минусов, для такого подхода нужно от 48Gb VRAM, лучше 96. У меня с этим проблем нет тк занимался ML еще до того как это стало модным и железо было куплено по адекватным ценам.
Этот подход еще ждет свой пик популярности, когда за текущие облачные модели взвинтят неприличный ценник в подписке, чтобы перестать работать в убыток.
Автору: Спасибо! (вместе со статьей про имаго - образуется что-то, из чего уже можно выбирать, и даже кажется, что уже осознанно)

То есть нужно сначала написать хороший код чтобы потом не писать коды
Мне кажется обилие архитектур, языков программирования и прочего это жуткий легаси. Сделано, что бы человеку было удобно. По хорошему для эффективного ии кодинга надо создавать новый процессор, новый язык программирования и новые интерфейсы, которые должны быть удобным для ии, и не обязательно удобным для человека. ИИ наверное это все и напишет.
Новое железо уже давно есть, новый интерфейс - md или html, язык - я так понимаю все будут переходить на rust.
Так что всё уже сделано.
Вообще не факт что RUST. Это просто одна из опций, которая имеет адептов) Я вижу что скорее всего это должен быть компилируемый язык программирования с четкой типизацией (гораздо проще оптимизировать под конкретную платформу), с минимумом языковых конструкций (размер кода и его читаемость не важна, если принять что код написанный ИИ будет в дальнейшем поддерживаться только ИИ и ИИ не делает ошибки за которые мы все так "любим" С))))). Скорее всего С подобное, с сильно урезанным синтаксисом.
Я не имел ввиду вообще человека. У нас все железо, протоколы сделаны для удобства человека. Человек пишет на java, а машина исполняет байт код. Ассемблоер сделан понятным для человека из-за этого внутри cisc появились свои микрокоманды risc. Напрямую такой код человек написать не сможет. Куда не копни, всё сделано для удобства человека, а не для скорости.
ИИ наверное это все и напишет.
Я не раз ловил себя на мысли, что вот эту задачу я бы точно сделал сам быстрее.
Уже сейчас абсолютное большинство вайбкодеров в принципе не знает, что "под капотом". Им надо свою задачу запилить — она пилится. Наверняка в десятки раз менее оптимально, чем возможно, но для опять таки абсолютного большинства это абсолютно не критично, железо который год мощное, дешевое.

А разве Codex или Claude code не делают это все автоматически? Даже при полном отсутствии каких-то agents.md они вполне себе справляются разгребать Авгиевы конюшни легаси на 100 клок.
Но для самопального харнеса, наверное, актуально.

Что дальше? Ку(колдо)кодинг

Дальше апокалипсис.
Дальше — идиократия.

Что дальше? Дальше mcp REA и банкротство производителей софта.
Почему все думают, что чем современнее модель, тем она, обязательно, лучше? Та, которая вышла, например, вчера, может запросто уступать и быть хуже той, которая вышла полгода назад.

Как то сложно выглядит. Работаю с агентами через кабан, как здесь описано, только с ролями разработчика, архитектора и т. п. Со времен ещё sonnet 4.5 https://tutor.diworld.pro/ и процесс полностью управляемый, решения успешно выходят в прод, поддерживаются и развиваются. На одном сложном инженерном проекте больше 600 закрытых задач,полет нормальный, хаос не ощущается.
ИИ агенты просто помощники, которые закрывают задачи как люди-специалисты.
Пример кабан доски с проекта хакатона:
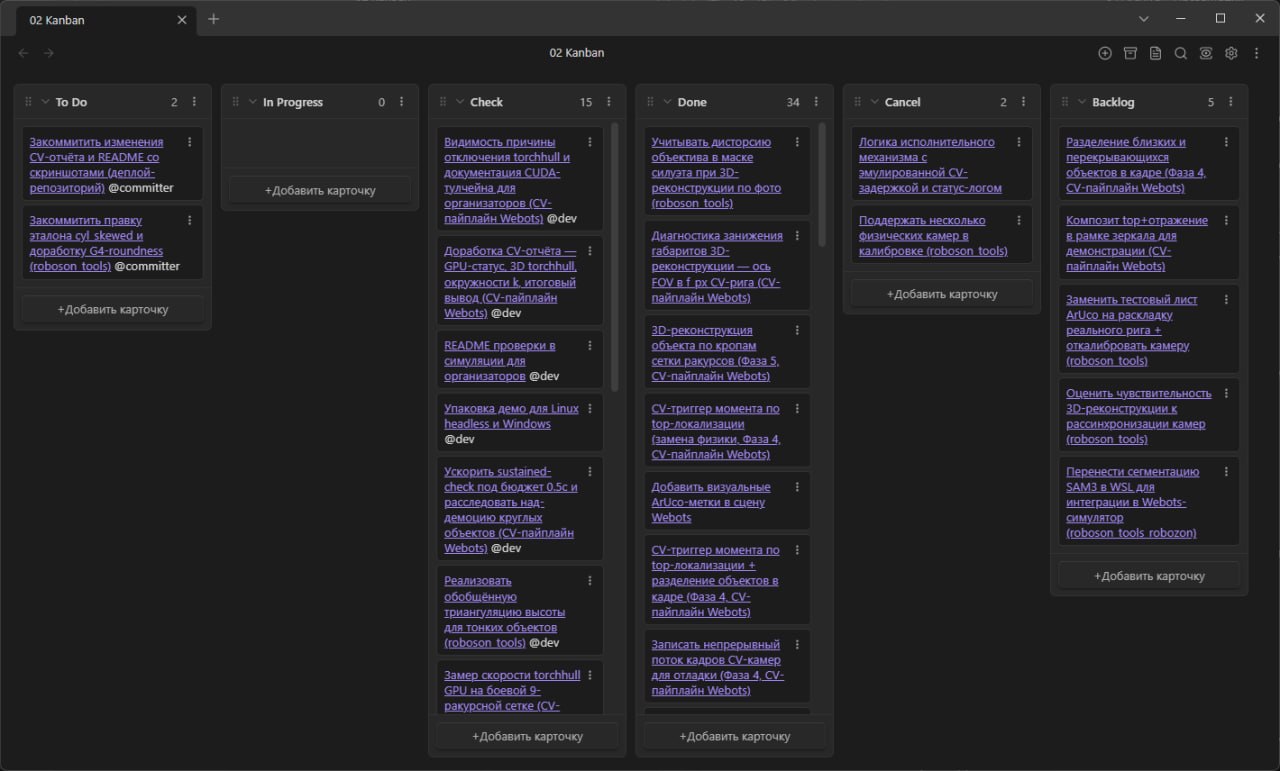
Сознательно не делаю тонкую настройку отдельных терминалов (скилы, субагенты и т. п), чтобы все работало в любом терминале. Есть и роли и скиллы. Доволен в общем. Реально имба
Проекты живут в MD заметках obsidian. У каждого своя локальная вики получается. И ещё между проектами агенты тоже могут подсматривать решения и ставить задачи.
Вся конструкция держится на одном допущении: критерии приёмки пишет тот же цикл, который потом по ним отчитывается. Пока критерий измеримый, вроде покрытия или скорости, это работает. Проблема начинается на критериях вида «задача решена»: их и придумывает, и проверяет один и тот же контур, просто разными ролями, и эскалация к Эксперту после трёх отказов ничего не меняет, потому что спорить он будет с теми же критериями.
Снаружи остаётся только пользователь, и если он принимает работу на слово, цикл сам себя и закрывает.
Не очень понял вопрос. Разные модели занимаются планированием, реализацией и приемкой. Они не будут друг с другом "договариваться". Если критерий приемки в принципе недостижимы - задача будет не выполнена. Пользователь должен будет вручную перепланировать или уточнить эти критерии. Но это крайний случай, так как внутри цикла есть механизм перепланирования и, обычно, его хватает.
Я, видимо, криво спросил. Извиняюсь, за неточность. Дело не в том, что модели договариваются, а в том, откуда Аудитор берёт, что именно проверять: по статье он получает критерии от Аналитика, то есть из того же плана, который эти критерии и породил. Независимость у него по свидетельствам, а не по постановке.
Может, это и правда исключение. Только критерий, который провалил ревизию, на третьем круге убрали не Эксперт и не Аудитор, а вы сами, руками, с записью в статус-файл. Дальше цикл поехал, а критерий не выполнили, его сняли.
У себя я поэтому стараюсь фиксировать критерий до старта: нет критерия, задача не поставлена.

Интересный подход. А как у вас решается ситуация, когда аудитор дал PASS, а после этого код в ветке ещё изменился? Проверка как-то привязана к конкретной ревизии/commit SHA или цикл просто запускается заново?
В режиме с автокомитом, код автоматом комитится. Без этого режима все изменения копятся в ворктри и за их дальнейшую судьбу скил не отвечает.
У меня есть скил для коллекции, который занимается оркестрацией нескольких задач и согласованного применения изменений. У него отдельный свой check, который проверяет всю реализацию.
Понял. Я немного про другое: сам результат PASS сохраняет связь с конкретным commit SHA?
Те если аудитор проверил commit A и дал PASS, а потом в ветке появился commit B, старый PASS автоматически становится недействительным? Или скил сам этого не отслеживает и нужно просто ещё раз запускать чек?
Нет, такой связи нет. Если в процессе работы скила кто-то будет параллельно работать с ворктри, то он будет пытаться этого не замечать. Если это становится невозможно (правки в общие файлы) он остановится и попросит продолжить себя после завершения параллельной задачи. Я частенько забивал на это и просил его продолжать работать даже не смотря на параллельные правки из других сессий в общую кодовую базу.
После PASS скилл завершает работу и все что происходит с ворктри и апстримом - вне его компетенции.
Но еще раз подчеркну - это логика базового скила PDCA. Для коллекций там всё по другому и SHA действительно попадают в статус файл и являются эведенсом для проиемки.





Вайбкодинг: что дальше?