
Хабр Курсы для всех
РЕКЛАМА
Большая витрина: от крупнейших школ до частных авторов. Сравнивайте по цене, длительности, формату и выбирайте самый подходящий курс!

#самавиновата
Архитектура резервного копирования ряда систем опиралась на тяжелые еженедельные полные дампы (Full Backup) вместо непрерывной потоковой отгрузки журналов предзаписи (Continuous WAL Archiving) во внешний контур
Здесь и далее: всё от нищеты. Непрерывная WAL это дорого и падение производительности.
А про микросервисы ну ССЗБ, товарищи любят resume driven development и cargo cult

Про карго-культ микросервисов и RDD абсолютно в точку, об этом как раз писала в главе про разорванные саги. Когда простой монолит с транзакцией в одной БД заменяют десятком асинхронных сервисов ради моды, при первом же шторме сети получают ад сверки.
А вот тезис про то, что непрерывный WAL это падение производительности» - это популярный миф. Любая реляционная СУБД (тот же Postgres) уже пишет WAL последовательно на диск при каждом коммите ради ACID. Асинхронная отгрузка закрытых сегментов журнала (через wal-g или pgBackRest) во внешний S3 не блокирует транзакции и создает ничтожный оверхед по CPU/сети. Напротив, именно классический недельный Full Backup (тяжелый дамп в выходной день) создает дикую нагрузку на дисковую подсистему и часто не успевает завершиться в окно бэкапа. Так что проблема тут не в производительности, а в банальной экономии на внешнем холодном хранилище и исходящем трафике.
Я умел используя WAL восстановить и накатить ReDo логи поверх холодного бэкапа БД на произвольный момент времени или произвольный номер транзакции уже 27 лет назад. Потом перестал заниматься БД. Каково моё удивление через 20 лет что это сейчас никто не делает, только снапшоты и всё, лапки
P.S. а, да, ещё логическая репликация на горячий резерв. Но горячий резерв это дорАгА!

Про карго-культ микросервисов
В чём тут карго-культ? Нет ли тут непонимания микросервисной архитектуры, которая даёт возможность легко выносить что-то в отдельные сервисы, без серьёзных потерь в observablity и простоте отладки, но совершенно не заставляет это делать?

Вот когда позволяет, это нормальное использование нормальной техники. А когда заставляет это и есть культ.

Весьма часто микросервисы применяются в режиме распределенного монолита. В итоге выпадание одного двух микросервисов приводит к полной деградации сервиса, просто потому что а мы не подумали.

Жёстко плюсую. Архитектурой на уровне всего предприятия в крупных компаниях (системных банках) обычно никто не занимается, отдавая все на откуп самим командам. А те в свою очередь самостоятельно, не видя общей картины, выстраивают хаотичные связи с другими сервисами, образуя большой ком грязи, где падение одного сервиса приводит к сбою непредсказуемого количества систем.
Там основная проблема в такой системе, что внесение изменений в нее сильно дороже становится относительно монолита. Ну соберите лучше монолит.
Тоже плохая идея для крупных систем с множеством команд. У каждого сервиса свои заказчики, свой релизный цикл, свои технологии, свои требования к производительности, надёжности. Проблема в том, что наслушавшись про независимость микросервисов и автономные команды многим показалось, что система как-то сама себя построит и централизованно архитектурой заниматься больше не нужно.

На самом деле с тем же pgbackrest есть некоторые проблемки, которые ЕМНИП решены в wal-g например.
pgbackrest выключит postgres, если от s3 получит ошибку 403 (не верные логин/пасс например). Далее пока ошибка 403 не будет устранена postgresql не сможет включится.
Если s3 не доступен то pgbackrest будет переодически выключать postgresql, но postgresql будет подыматься работать какое-то время (наверное до следубщей архивации).
Т.е. не всё там гладко. Но честно говоря это не причина отказываться от таких вариантов бэкапа.

Как я понимаю, все выводы статьи основаны не на реальной информации, а на некоторых предположениях, которые яндекс не подтвердил?

Вне зависимости от того, как было на самом деле, статья полезна широкой аудитории разработчиков и архитекторов. И действительно может стать дополнительным аргументом/мотивацией строить настоящую отказоустойчивость, а не вестись на удобство managed k8s, managed db, без возможности репликации в другие регионы.

А что Яндекс подтвердил? О чем подробно рассказал?
Было 3 суток между ударами? Было. (Были ли предпосылки ударов? Последний год бьют зеркально, считаем что были) Легли сервисы? Легли. Легло облако? Легло. Они начали переносить сервисы к другим хостерам? Начали.
А первым что у них стабильно заработало, по моим наблюдениям, был бот в тредс, который успокаивал всех, кто упоминал Яндекс
В любом случае это риски бизнеса который как раз таки должны просчитывать менеджеры. Объективно - яндекс практически монополист во многих сферах, особенно сейчас, когда всё что можно порезали. Люди потеряли данные к своим деньгам, файлам, да даже музыке и возможности пользоваться алисой (а всякие плюсы и колонка кстати по подписке работают, за деньги). Бизнесу сломали рекламные кабинеты, и есть новости что их нельзя было даже выключить, что б не сжигать бюджет, пока ничего не работало. Клиенты облака понесли репутационные и финансовые потери из-за недоступности своих сервисов. Это большой прокол и "сплотиться вокруг сильного лидера IT гиганта" всячески его оправдывая - не вариант и даже смешно. Как бы яше этого не хотелось
Так что это просто дорогой, но очень важный урок для всех. И освещать как такого не допускать в будущем - однозначно правильно, даже с небольшими допущениями
Могу понять минусы за "Неконструктивное общение", могу за "Придерживаюсь другой позиции". Но "Политика или пропаганда"? Серьезно?... Ладно, с 8 по 22 октября ничего не произошло

Но "Политика или пропаганда"? Серьезно?

Карма на Хабре - инструмент для управления репутацией корпоратов.
Чем они успешно пользуются.

Мне кажется, это может быть преувеличением. Сообщество Хабра достаточно сильно поляризовано, чтобы по будоражащему вопросу нашлось достаточное количество недовольных любой чётко артикулированной позицией для слива кармы.
Мне слили карму за высказывание мнения о том, что срочной необходимости расписывать детали про то, что ДЦ был именно атакован БПЛА не было, и таким образом я не вижу проблем с тем, что Яндекс упомянул БПЛА только через несколько часов после аварии, а не сразу. И тоже в том числе и с пояснением "Политика или пропаганда".
Полагаю, минусующие в целом мало заморачиваются фактологической корректностью претензии, описывающей "минус к карме" - просто выбирают по своему внутреннему ощущению.

...можно еще фото хлопнувшего кондиционера запостить.....

Серьёзно. Меня вот обвинили в рекламировании услуг Яндекса. Т.е. фактология развёрнута на 180 - и всем начхать. Привыкайте ;)
Именно так. И история с рекламными кабинетами Директа, где бизнес не мог остановить открутку бюджетов при лежащей аналитике и сайтах, это еще один яркий пример того, почему в архитектуре критических систем обязаны быть автоматические стоп-краны (kill switch) при деградации контура. Спасибо за точное дополнение!

"... риски бизнеса который как раз таки должны просчитывать менеджеры "
как уже написал автор: у бизнеса мирного времени ДРУГИЕ РИСКИ в приоритете.
у них СВОЯ шкала ценностей.
если заказчики/арендаторы сами себе придумали, что она должна быть какая-то другая (пусть даже идеальная) - это их личные фантазии.

Ну вы как дети при коммунизме ;-) "...должны менеджеры", какие менеджеры? которые финансисты или (условно) технические менеджеры по управлению инфраструктурой. Отсюда и танцуем. Капитализм. Можно сэкономить и поднять показатели "прибыли" за счет несовершенства (явного) архитектуры - так и будет сделано. А вот усвоен ли урок - это бы показал бы процесс разбирательств, инициированный кем? вплоть до государственных представителей, так как Я - все-таки не лавочка, и инфраструктурный системообразующий субъект экономики (как-то так). будет ли что-то подобное? Почти уверен что нет. Пчелы против меда... И до сих пор не поняли что время крупных монолитов прошло... Как-то так, могу ошибаться...
Архитектурный анализ тем и хорош, что опирается на математику распределенных систем и объективную телеметрию, а не на пресс-релизы.
Все ключевые точки в статье, это официальные данные самой статус-панели Yandex Cloud (https://status.yandex.cloud/ru/timeline) и публичная хроника восстановления сервисов:
Зона b (Сасово) упала 8 октября в 01:31, а штатный инструмент отвязки мастеров K8s и вывода мертвых хостов БД из зоны b дали 9 октября в 15:42. Разница ровно 38 часов.
Перевод квот в ручной режим 10 октября и официальное предложение переезжать к конкурентам 9 октября, это прямое подтверждение дефицита свободного Capacity в оставшихся зонах.
Уход кластеров БД и S3 в readOnly утром 11 октября (после падения Владимира, зона a) с математической неизбежностью означает одно: за 74,5 часа между авариями кластеры не пересобрали кворум до 3/3 и встретили второй удар в конфигурации 2/3. Иначе потеря одной зоны 11 октября не привела бы к потере кворума.
Чтобы сднлать вывод, почему система с кворумом 2/3 сложилась при отказе второго узла, не нужно ждать внутреннего отчета компании, достаточно знать, как работает консенсус.

за 74,5 часа между авариями кластеры не пересобрали кворум до 3/3
Вы же сами пишете, что у них не было на это ресурсов, чтобы поднять полноценную зону взамен Сасово - и для объяснений наблюдаемой аварии в их архитектуре, когда в кворуме участвуют только полноценные узлы (в данном случае - зоны), достаточно только этой причины. Конечно, не все архитектуры отказоустойчивых кластеров требуют для кворума не менее 3 полноценных узлов: например, в MS FT cluster роль одного из узлов для исключения split-brain может играть легковесный ресурс-свидетель - общая папка, доступная по SMB, и, к примеру, MS Exchange 2010, который пользуется именно этой архитектурой, такую последовательность отказов своих узлов-серверов бы пережил (если не считать проблем с capacity из-за того, что один сервер обязан был бы тянуть нагрузку, изначально лежащую на трех). Но Яндекс такую архитектуру не использует - возможно, как раз, из-за этой самой capacity.
Но ещё хуже IMHO другое, что сделал Яндекс: излишняя централизация. Например, возьмем службу такси, которая по своей природе вполне может быть децентрализованной: ибо даже в соседнюю область на такси ездят редко, и координация даже между областям уже мало что дает. И лет десять назад такси бы такую аварию практически не заметило, потому что большинство локальных таксопарков были бы доступны пользователям. А сейчас отказ Yandex Go реально нарушил работу такси практически по всей России (люди заметили, хорошо что хоть починили его быстро), и это - как раз результат излишней (IMHO) централизации.

Не согласен с главой 2 п.1.
Невозможно собрать в 2 ДЦ кворум, устойчивый к потере 1 ДЦ. При выбивании 1 оставшегося ДЦ из 2 кворум разрушится с вероятностью 50%
Так надо успеть собрать устойчивую конфигурацию.
Rebuild RAID 5
Невозможно собрать в 2 ДЦ кворум, устойчивый к потере 1 ДЦ. При выбивании 1 оставшегося ДЦ из 2 кворум разрушится с вероятностью 50%
Для размещения ресурса-свидетеля полновесного ДЦ не требуется. К примеру, MS, помнится, предлагала (в документации) размещать такой ресурс для кластера Exchange в двух ДЦ у себя в Azure, за очень недорого и без требования высокопроизводительного канала связи к Azure.
Ну, а Яндекс мог бы разместить свидетель где-нибудь на арендованной площадке.
Концентрацию региональных физических угроз трудно было предусмотреть заранее. И новый ЦОД быстро не построишь. А вот заранее договориться с другими компаниями о быстрой плановой продуманной эвакуации на чужие мощности можно было вполне. И после второго ЦОД начать её немедленно. А частично и после первого - по нынешним неспокойным временем надо

После всех событий в у меня в голове родился термин "пост Сасовский уровень отказоустойчивости".

у нас масштаб на порядки меньше, один сервер и пара сервисов. Но кусок про бэкапы, которые некуда развернуть, прям про нас. Дампы каждую ночь увозим на другую машину. А вот поднять их с нуля у другого провайдера, с его квотами и лимитами, честно ни разу не пробовали, видимо пора.
И вопрос по 38 часам на перенос мастеров k8s из мёртвой зоны: это ограничение самой платформы или просто готового runbook не было? Снаружи не очень понятно.
Согласна, самое время проверить)
А по 38 часам на вынос мастеров K8s и хостов БД из зоны b - там сошлись две проблемы:
У многих кластеры K8s были созданы с зональным мастером в зоне b (а не региональным на 3 зоны), то есть их etcd физически остался в погасшем Сасово.
В самом Control Plane облака возникло зацикливание в автомате состояний оркестратора (при монопольной блокировке метаданных кластера). Штатный пайплайн вывода ноды или смены топологии перед закрытием операции обязан: достучаться до агента и сторидж-контроллера в зоне b, отмонтировать сетевые диски и получить подтверждение остановки хоста (это жесткая защита от split-brain при обвчном флапе сети). Когда случился инцидент, воркеры оркестратора ушли в бесконечный цикл ретраев по таймауту, продолжая держать лок на объекте кластера (статус UPDATING/DELETING) и не давая поменять конфигурацию даже в живых зонах. Инженерам пришлось на живую выкатывать обходной механизм принудительного отстрела мертвых ресурсов в метаданных, игнорируя проверки доступности зоны b.

А мне что-то вдруг стало интересно, что Яндекс писал в оценке критериев КИИ, и как эта документация повлияла, когда жареный петух клюнул

После «архитектуры NewSQL» можно дальше и не читать: человек не понимает, о чём пишет. После четырех «честно» на статью закрадываются подозрения в том, человек ли это. Ну а ничем не подкреплённая уверенность в корректности своего анализа и выводах просто поражает.

Ну хоть натужный пафос статьи вы оценили?
За стилистическую тавтологию со словом «честный» - справедливый укол, глаз у вас наметан отлично, вычищу при редактуре. Про «архитектура NewSQL» - инженеры Яндекса сами используют этот термин в публичных материалах по YDB.
Списать весь разбор на непонравившийся термин в скобках - прием удобный, но к архитектуре отказоустойчивости отношения не имеет. Давайте отделим филологию и терминологический пуризм от инженерной сути инцидента. Если вы считаете анализ и выводы некорректными, или есть возражения по существу работы кворума и таймлайну, с удовольствием обсужу предметно.

Тоже обратил внимание на "честно" и неестественный слог, вчитываться больше не стал, проскроллил статью.
уверенность в корректности своего анализа и выводах просто поражает
Автор занимается косалтингом. Будет говорить неуверенно — это никто не купит.

Тоже возник вопрос, не писала ли / не редактировала ли статью нейронка:
«Современный финтех и BNPL‑сервис (Buy Now, Pay Later, коим является „Сплит“) — это не одна база данных. Это сложнейший граф микросервисов», — оборот «это не А: это Б». Но это ещё не всё: здесь же — оценочное суждение (и в превосходной степени сравнения!) — «сложнейший». Но ведь это статья для Хабра, а не отрывок из детской энциклопедии, где нужно предупреждать читателя, что «нечто является сложным, поэтому не страшно, если он не поймёт». На Хабре не привыкать читать в режиме «ничего не понятно, но очень интересно». Так что подобные оговорки здесь неуместны. Похоже на нейронку, добавляющую оценочные суждения, чтобы раздуть объём заметки до масштаба статьи.
Куча пояснений в скобочках на английском. Это уместно, когда версия термина на английском более известная, перевод неочевидный или английская версия точнее характеризует концепцию. Например, уместно пояснить, что под «ядром» имеем в виду «kernel», а не «core». Но как объяснить такое: «Корень катастрофы лежит на уровне корпоративной архитектуры (Enterprise Architecture)»? Слова общеизвестные, дословный перевод через словарик будет таким же. Я бы ещё понял, если бы написали наподобие «смысловая согласованность (semantic cohenernce)»: через словарик так и переведётся, но слова не особенно известные. Но переводить «корпоративную архитектуру» смысла скорее всё же нет. Снова похоже на раздувание объёма нейронкой.
Как уже отметили, свойственная нейронкам сверхуверенность: «Если препарировать поминутную хронику событий с 8 по 22 октября, становится очевидно: физическое поражение площадок стало лишь триггером». Прямо так очевидно, что причина перебоя на 11 дней — это в большей степени недостатки архитектуры, чем война? Я не архитектор ПО. Допускаю, что какой-нибудь профессиональный архитектор, разобравшийся в этом вопросе, может прийти к такому же выводу с ~90 % уверенностью. Но, кажется, обычно в сложных вещах (архитектура сразу кучи ЦОДов, — наверное, достаточно сложная штука) даже эксперты не оказываются уверены в правильности выводов на ~90 %. А вот нейронки даже в самых сложных вопросах часто уверены «на 1 000 %» — уверены даже тогда, когда их суждения на проверку оказываются галлюцинациями. В общем, снова больше похоже, что к выводам пришла нейронка или её попросили прийти к таким выводам.
Ещё в статье есть опечатки. Если статью правда писала нейронка, то это особенно забавно. Возможно, они появились при редактировании текста человеком, но что, если их намеренно попросили добавить? Тогда получится газлайтинг: «пусть читатель думает, что статью написал человек». Если нейронку правда попросили добавить опечаток (или добавили самостоятельно), то получаем «бинго» сразу из 4 «зашкваров»:
По-хорошему лучше писать самому, ведь слог нейронок «палится», из-за этого такие статьи ощущаются как халтура, потенциально меньше лайков собирают. То есть для самого автора в перспективе выгоднее писать самому. Но допустим, мы всё же применили нейронку.
По-хорошему об этом нужно предупредить, чтобы не вводить читателей в заблуждение о том, кто автор. Однако предположим, нам стыдно, что статью написала нейронка. Тогда придётся не предупреждать, отмолчаться.
Но даже если мы не будем предупреждать, вообще-то публиковать нейроночные статьи на Хабре запрещено! Даже если статья хорошая.
И наконец, мы просим нейронку намеренно испортить текст, чтобы усилить видимость того, что статью написал человек.
То есть вдумайтесь: мы не просто не написали статью сами, мы ещё об этом умолчали, но ведь не только умолчали, а ещё и на Хабре опубликовали, но и не просто опубликовали, а ещё и с опечатками! Просто забавно, как один поступок приводит к каскаду других поступков, которые призваны смягчить последствия первого. Похоже на то, как работает ложь: «Стоит однажды солгать, и правда навсегда становится твоим врагом».
P. S. Не утверждаю, что статью написала нейронка. Даже если так, не утверждаю, что опечатки добавили намеренно. Просто наблюдения.

Нейровайб от статьи сразу чувствуется. У меня нет сомнений, что статья либо написана нейронкой, либо хорошо так отредктирована ею же.
использование списков - 146% нейрослоп

Куча пояснений в скобочках на английском
Так любят делать очень давно. Привычка, въевшаяся в пальцы.
Как уже отметили, свойственная нейронкам сверхуверенность ...
У меня этой Вашей сверхуверенности выше крыши! Да, у меня есть ещё кое-как ворочающаяся нейронка. Только, живая. ;-)
Но как объяснить такое: «Корень катастрофы лежит на уровне корпоративной архитектуры (Enterprise Architecture)»?
А очень просто! Все менеджеры и маркетологи (что, по сути, одно и то же) постоянно жонглируют терминами. Они очень любят всякие словосочетания. Здесь мы видим попытку указать конкретно на тот термин, на который обычно ссылаются.

У нейронок есть характерный стиль, но и кожаные раньше писали плохой текст с плохим стилем, от которого глаза кровоточили. Поэтому, ну, наслопила нейронка, ну, и что? А если бы человек, у которого нейронка училась, сам бы написал такой плохой текст, вам бы стало легче?
Да мне просто нравится высматривать признаки нейротекста и пытаться угадать, нейронка писала или нет. Так-то мне кажется, что нейронки пишут даже лучше среднестатистического человека.
Тем не менее бесит, когда нейротекст пытаются выдать за свой. Когда не просто умалчивают об использовании LLM, а даже опечатки специально добавляют.
Всему своё место. Мне приятно слушать нейромузыку на сайте Suno, но бесит, когда она попадается на YouTube. Нормально смотреть на нейрокартинки на CivitAI, но бесит, когда они попадаются на Render.ru. Нейротекст нормально читать в Google AI Studio, но бесит видеть его на Хабре (где он вообще-то запрещён). Тем более, когда опубликовавший как только не извивается, лишь бы сделать вид, что написал он.
Если человек напишет сам и ещё хуже нейронки, он хотя бы не нарушит правила. И так будет честнее (никто никем не притворяется). Может, читать станет неприятнее (за счёт более кривого изложения и как следствие сниженной беглости обработки текста), зато компонента бесящести в этом неприятии будет точно меньше.

Вы сами то пробовали хотя бы 100 петабайт скопировать за 72 часа? А под нагрузкой? Это задача из разряда нерешаемых.

Так главная суть статьи в том, что копия этих 100 петабайт уже должна была находиться в другом дата центре, а лучше в двух.
А если два атакуют, то потом в обзоре напишут, что нужно в трех, а если атакуют три — в четырёх. А ещё на одно популярном ресурсе советовали строить подземные ДЦ :) Такие советы конечно формально верные, но основаны на постзнании и совершенно не учитывают экономику.

Не надо их отмазывать, не надо

Сколько, где и какого должно быть резервирования - известно всем (кто этим интересовался) очень давно. Равно как и про подход к бэкапам. По крайней мере лично я ничего принципиально нового из статьи не узнал.
Да, это дорого. Но тут, уж простите, или крестик снять или трусы надеть: или вы экономите на резервировании или вы обещаете пользователям "надёжный облачный сервис". Тем более, что конкретно для Яндекса это хоть и дорого, но вполне подъёмно, выбор (с учётом экономики) "или мы врём пользователям про надёжность или разоримся и закроем бизнес" у них не стоял.

Вот тоже не понимаю этого прикола с ДЦ в обычных зданиях. В России куча всяких закрытых советских бункеров ещё со времён холодной войны.
Вложитесь в инфраструктуру и будет вам ДЦ, который переживёт атомную войну )
"Для того чтобы доказать что у бабуина красный зад - необязательно предъявлять свой собственный" (с)
Что за уровень аргументации "сам смоги"? Назвался груздем...
И нет. Это не нерешаемая задача.
Модно требовать того что реально. Трех копий данных, например. А того что нереально требовать странно.
Нерешаема за тот бюджет который под это хотя бы в теории можно получить.

Модно требовать того что реально
Или под что подписались авторы обещаний)
Меня как пользователя вообще не интересует техническая сторона! Им за это и платят - чтобы они брали эти вопросы на себя. Это как с региональными бюджетами - любая районная администрация вам прекрасно объяснит какие у них проблемы с финансированием и почему невозможно выполнить ваши хотелки. Только выбирают их не для того чтобы отмазы слушать (с этим справится и любой человек с улицы!), а чтобы выбивать это самое финансирование и рационально им распоряжаться.
Я понятия не имею какие у них бюджеты - и это вообще не моя головная боль. У них есть куча топ-менеджмента - вот пусть у них голова болит. Пусть ставят ограничения на объём хранимых данных, если бюджетов не хватает... Почему я должен входить в положение некомпетентных исполнителей? И парадокс - чем крупнее компания, тем сильнее надо войти в положение? А то как зарплаты по верху рынка грести - первые, как отвечать за свой фронт работ "ну у нас даже в теории таких бюджетов нет".. Так зачем вы делали вид, будто они у вас есть?
UPD: Я делаю интерфейсы лучше Яндекса. По крайней мере, менее глючные - я имею право Яндекс критиковать?

Есть такая тема называется форсмажор, им так же все равно на твои проблемы возникшие с ними как и тебе на их проблемы. Я яндекс и его "интерфейсы" сам не люблю до дрожи, и понятно что шарага зажралась и чутка гниет, но все же валить на них все грехи тоже не конструктивно.

Даже если не умеете делать интерфейсы лучше имеете право критиковать.

Гражданка не делает, она рассказывает как надо делать правильно, консалтинг ведь. Ну или, как надо было делать правильно, она ведь ревизор против навязанных технологий и ей виднее как нужно строить инфру на масштабах Яндекса.

И зачем я прочитал этот нейрослопный дистиллят?)))

В пункте про Ledger стоит разделить уникальность ID и идемпотентность операции. UUIDv7 в RFC 9562, §5.7 — идентификатор с временной меткой и случайными битами (возможны счётчики), а не детерминированная функция от платежа: https://www.rfc-editor.org/rfc/rfc9562.html#section-5.7
Спасибо за уточнение по RFC 9562. В статье для краткости схлопнуты два разных механизма, которые лечат две разные болезни этого сбоя:
UUIDv7 (вместо автоинкрементных SERIAL/IDENTITY) нужен для первичных ключей записей. Он сохраняет локальность индекса B-tree за счет префикса таймстемпа, но при этом спасает от коллизий и переназначения ID, когда систему поднимают из старого дампа или сливают разъехавшиеся шарды.
А сам Idempotency-Key для защиты от шторма ретраев, разумеется, должен быть детерминированным от бизнес-операции (например, UUIDv5/хэш от связки client_id + order_id + payment_step или токен, сгенерированный один раз на клиенте при создании намерения платежа).

Вам не кажется что тупо лепить нейронкой ответы в посте, который также был слеплен нейронкой - верх неуважения?

мне кажется ей уже всё равно. как в анекдоте - "не прокатило". но биться надо до последнего.
и ведь всё же это найти можно потом в интернете и такого консалтера я бы в жизни не взял, но вдруг "прокатит" кажется ему.
А вы не находите забавным, что комментарий @kreout, на который отвечают тоже смахивает на написанный нейронкой?

Почему бы к этому тексту не сделать пару схем, чтобы было понятнее?
Metro‑Cluster выдавали за Disaster Recovery
Что нужно добавить к Metro‑Cluster, чтобы он стал Disaster Recovery?

Это какой-то фанфик по яндексу?

вы написали: “Если бы этот механизм отработал 8 октября за 3–4 часа, то к утру 11 октября (удар по Владимиру) все кластеры встретили бы атаку в полной конфигурации 3/3”, а автоматика обязана начать “фоновую дорепликацию 3-й копии данных на зарезервированные мощности резервной зоны”, для чего, по вашим же словам, нужно “перелить сотни петабайт данных из погибшего Сасово” (остановка которого описана словами “полностью останавливается ЦОД в Сасово”).
уточните, пожалуйста, значения, которые использовались в расчёте:
сколько именно сотен петабайт подлежали фоновой дорепликации?
какая устойчивая пропускная способность сети и дисковой подсистемы (чтение с уцелевших реплик и запись новых) нужна, чтобы завершить фоновую дорепликацию за “74 упущенных часа”?

Я думаю, все слова "если бы" и "надо было" в ответ на аварию там следует воспринимать в контексте некоего идеального мира, в котором продумывать сценарии начали бы не позднее прошлого года, а бегать аки ошпаренные кошки, в авральном порядке завершая подготовку к варианту "мы можем быть следующими" - не позднее июля.
Часть о "копии в Сибири" требует еще более долгосрочного планирования, причем с учетом того, что и это может не помочь, потому что там тоже случается.
Ну и полностью упущен самый важный момент - "за чей счет банкет", потому что все риски тут вообще не коммерческие.

Жили-были мыши и все их обижали. Как-то пошли они к мудрой сове и говорят:
— Мудрая сова, помоги советом. Все нас обижают, коты разные, филины. Что нам делать?
Сова подумала и говорит:
— А вы станьте ёжиками. У ёжиков иголки, их никто не обижает.
Мыши обрадовались и побежали домой. Но по дороге одна мышка сказала:
— Как же мы станем ёжиками? — и все побежали обратно, чтобы задать этот вопрос мудрой Сове.
Прибежав, они спросили:
— Мудрая Сова, а как же мы станем ёжиками?
И ответила Сова:
— Ребята, вы меня ерундой не грузите. Я стратегией занимаюсь.

Ну там не с одного диска читается. Сейчас сетевуха (каждого) приличного сервера (25GbE) выдаёт 10 терабайт в час. Самый тонкий (у меня такой по деревне идёт) кабель (не считая "лапши") может передать 40 (CWDM) в каждом из 48 волокон. Т.е. без малого 20 петабайт в час. Ну пусть 10 с учетом загрузки. Таких кабелей очевидно должно быть несколько. Т.к. всё расположено достаточно компактно, то соединения должны быть хотябы каждый с каждым. Итого для 4 ДЦ, округлим вниз - 50 ПБ в час.
Если правильно приоритезировать, не катать в первую очередь мусорные логи и т.п. то за час наверное самое важное раскатается. Ну за два.
Это всё уровень средненького энтерпрайза.
Другое дело, что невозможно себе представить яндекс у которого мощности эквивалентные хотябы одному ЦОД сасово будут годами просто стоять ждать прилёта.
Что реально можно было - не использовать горючие и неогнеупорные материалы в цодах вообще. Там прям совсем "на спичках" экономия. И актуально оно в любые времена.
Но проблема вообще не в яндексе, конечно. И никакими манипуляциями с цодами её не решить.
Ниже в ветке RTFM13 уже прикинул пропускную способность оптики и сетевух, но дело вообще не в скорости света и не в каналах было.
Во-первых, сам оркестратор 38 часов висел на локах, ожидая ответа от погасшего Сасово (инцидент 2092), а пока управление лежит - никакие рекуорумы не едут.
Во-вторых, Яндекс 9 октября сам официально отправил клиентов переезжать в Selectel и VK Cloud, то есть свободных стоек и дисков в живых зонах под прием всей этой репликации тупо не хватило.
вы сослались на оценку RTFM13, но я спрашивал о значениях из вашего расчёта, на основании которого сделан вывод о том, что “все кластеры встретили бы атаку в полной конфигурации 3/3”.
какие значения использовали вы?
Да, извините что опять встреваю. Я там обсчитался чуть-чуть. Каналы дуплексные, при правильной архитектуре будут загружены в обе стороны. Итого 100Пб в час (те самые мифические?). И это, напомню, кабели которые в деревне на столбах висят и самые дешевые железки с алиэкспреса (последнее поколение на вторичке). Т.е. это нижняя граница хоть сколько-нибудь разумной экономии. Для взрослых ДЦ думаю есть решения и получше.
Так что если сервера не совсем под планку загружены, то с учетом не 100% заполнения и зеркалирования минут 30-60 им отдать содержимое максимум. Если под планку, то в ЧНМ оно в любом случае раскатается. Т.е. к началу слудующего рабочего дня.
Тут дело явно не в физических ограничениях.

Мне кажется вы не то считаете. Если в сервере диски например по 16Тб, то с средней скоростью в 160MiB/s отдача содержимого займёт не менее 27 часов. Но на практике могу сказать что к концу дорожки скорость падает больше чем в два раза, а реалистичные значения в начале с учётом оверхеда файловой системы/raid-а ближе в 80+-5, что доводит ограничение уже на уровне диска до ~70 часов, с какими угодно сетевыми картами, каналами и прочим.
Запись надо считать. HDD пишут заметно медленнее чем читают. Запись на большом объеме, когда кеш уже все. Про оверхед на райд5 при записи тоже надо не забывать.
Вот кстати таки да... Отдать мало (хотя и там можно упереться в производительность дисковой подсистемы, которая будет ниже сетевого интерфейса, если это не ssd/nvme какие-нибудь - но на hdd тоже наверняка много всего лежит), надо ж еще записать...
Тоже зависит от нюансов.
Если это ФС, то чтение может быть сильно фрагментированным, а запись почти линейная особенно с учетом кэша. Если запись медленнее условно в 2 раза то фрагментация может давать просадку в 10-100 раз легко.
Можно писать на несколько дисков одновременно разные фрагменты.
В любом случае это какие-то бэкапы бэкапов отсутствие которых снаружи вообще никак не должно быть заметно.
Речь про 72 часа. Это все увеличение сроков. Особенно под нагрузкой когда толпа пользователей параллельно бросается что-то делать и спасать.
Был бы там месяц или хотя бы три недели я бы вас поддержал. Что надо было и можно было скопировать куда-то.
Mission critical данные на таких носителях это профнепригодность. Без вариантов.
Другое дело если они вдруг решили что "телеметрия" для них это mission critical, то что вы вообще от них хотите? Но пусть скажут тогда об этом.
Ну размер базы поиска можно прикинуть на пальцах. Размер базы рекламы тоже (без нее поиск не имеет смысла).
Там много, очень много. И это все критикал данные.
Вот это точно мимо.
Эти явно за балансировщиком стоят стопицот копий, они сдампятся за минуту. Тем более они порезаны и вдоль и поперёк т.к. хранить поисковую и тем более рекламную базу на огромном медленном харде нет ни малейшего смысла.
Другое дело, что это вообще не нужно. Поисковую базу вообще можно удалять в моменте, хотя она наверное в топе по количеству копий и геораспределению.
Зависит от типа носителя. Если NVMe или там иной SSD - то скорость будет одна, если HDD - другая.
Но всё может стать еще медленнее, если часть данных вытаскивали из бэкапа, а не живых сторажей.
Кто-то в 2026м году держит рантайм на хардах, да еще на таких медленных? Это же только для бэкапов годится. Они на чтении из-за фрагментации умрут куда раньше.
Опять же, делите на 2 - у вас 2 рабочие копии. Заполнение не 100% - делите еще на сколько-то. Раид тоже может давать примерно удвоение скорости, если это зеркало.

когда-то меня учили руководитель СБ обязан быть параноиком, генерировать даже невозможные способы воздействия на структуру и способы и методы противодействия событиям. А ну да?! Конечно он не дает спокойно жить окружающим. Тогда сорри получите и распишитесь.

Если бьі бьіло падение другого Владимира - ничего бьі єтого не бьіло:)

Статья, никак не бьющаяся с реальностью, в том плане что большая часть советов/предположений/упрёков/"а надо было так, а так сказал!"/"ну было же очевидно прямо таки всем!" никак не связано с реальными событиями и принятыми решениями в тот момент. Конечно, оно когда подождёшь, всё обдумаешь, рассмотришь ситуацию с разных сторон, сразу становится понятно где нужно было поступить иначе и тд., но суть не в этом.
...и главное — как должна выглядеть архитектура, способная пережить подобный шторм.
А может пора называть всё таки вещи своими именами?
Ладно, черт с ними, с наименованиями погодных явлений. Просто раз уж тут таакой шторм, то нужно откуда-то брать дополнительное финансирование (всё-таки полноценная защита от штормов нынче не из дешёвых). Может пора закладывать затраты на внешний защитный контур, поднимать стоимость тарифов, вообще уберём кнопочку отказаться от подписки, выбьем послабления в налоговом обложении, переложем всю ответственность на потребителя, уменьшим расходы путём сокращения штата в других областях (например, которые охраняют пляжи или строят бунгало). А шторм какой силы мы будем закладывать в риски? Если фантазия достаточно хорошая, то можно предположить, что поднимуться настолько сильные космические ветра, что сотрут всё. Будем выстраивать архитектуру под такой случай? Первая в мире архитектура в мире, выдерживающая космический шторм! Патенты, инфоповод, заголовки, признания, государственные премии.... Ну и что, что все вокруг крутят пальцем у виска - зато мы тогда точно не пропадём, ведь точно?

А может пора называть всё таки вещи своими именами?
А вот кстати, как правильно, но при этом кратко, назвать ситуацию, когда из-за отключения одного из датацентров в системе начинаются каскадные аварии? Причина отключения именно для этого вопроса вторична.
Если отвлечься от всего и сфокусироваться чисто на определении, я бы предположил, что по результатам отключения одного из датацентров возникнет "каскадный отказ инфраструктуры". Если мы рассматриваем только с точки зрения возможности этой ситуации в вакууме, и её обнаружили во время сферических тестов в сферической среде, а в ТЗ такого быть не должно (если есть, то всё ок), то это уже "нарушение в построении и/или реализации системы" (может у вас есть другие варианты и мой недостаточно хорош? можно конечно более ёмко, даже одним словом, но у меня нету каски прораба).
Интереснее становится, когда вовзращаешься в нашу неидельную систему и начинаешь добавлять переменные в уравнение, а именно "кому нужно сообщить о данном событии" и "с какой целью". А дальше начинается разминка для мозга: "случай", "косяк", "недоразумение", "инцидент", "причина технических работ", "срочный alert, требующий фикса", "временные трудности", "причина сплотиться", вынесем в целом за скобки "причина чего-то", "серьёзный просчёт", "недоглядели", "авария".................
В условиях 2026 года все площадки в одном радиусе досягаемости и на одном энергетическом и сетевом узле образуют единый коррелированный домен отказа (Single Domain of Correlated Failure). Отсутствие второго, физически изолированного региона (например,
ru-siberiaилиru-uralза тысячи километров) превратило локальную региональную аварию в общенациональный блэкаут.
Тут возникает несколько вопросов.
В каком году это превратилось в "единый коррелированный домен отказа"?
Какие риски вызвали это превращение?
Кто и почему должен выделять финансирование для покрытия этих рисков?
Есть ли у вас на руках финмодель с двумя вариантами - "дублируемся в Сибири" и "не делаем этого, просто пытаемся оптимизировать текущую схему", причем с учетом (подтвержденного практикой, прошу заметить) риска "в Сибири тоже может что-то случиться либо прямо в тот же день, либо через несколько"?
дублируемся в Сибири
Тут ещё вопрос законности — персональные данные запрещено хранить за границей. А до Урала вполне себе долетает, буквально позавчера были новости на этот счёт.

В каком году это превратилось в "единый коррелированный домен отказа"?
Примерно в 2005 https://ru.wikipedia.org/wiki/Авария_в_энергосистеме_в_Москве_(2005)
Владимир там упоминается только как имя, а не как город.
Не нашел подтверждений, что конкретные районы (не "область в целом"), в которых стоят ДЦ Яндекса, были вообще затронуты этой аварией.
Это пример, что даже московское энергентическое кольцо может выйти покурить на несколько суток и все, кто будет в этом кольце окажутся в "едином коррелированном домене отказа". Плюс от ДЦ в вакууме толку тоже мало - "в связи с нарушениями работы каналов связи до 80 % участников (по оценке ММВБ) не могли получить доступ к торгам". И это все-таки 2005 год, интернет не относился к жизненноважным предприятиям.
и все, кто будет в этом кольце
А вдруг именно поэтому датацентры Яндекса построены там, куда эта авария не дотянулась, и ни в какое единое кольцо не попадают? Не говоря уже о том, что за 20 лет могло много чего поменяться (в частности, из-за этой аварии тоже). Иными словами, чтобы с такой уверенностью что-то утверждать, надо немножко больше фактических, а не предположительных, знаний об инфраструктуре и процессах, чем есть у автора и, судя по всему, у вас.

По его словам, «последние 10 лет российской электроэнергетики — сплошная череда аварий, подобных которым в советской электроэнергетике не было»
Проблемы индейцев шерифа не волнуют. В советской экономике отключения - это экономический ущерб самому себе. А в нынешние времена блэкаут - это чужая проблема. Выгоднее платить штрафы, чем тратить деньги на инфраструктуру - акционерам нужна прибыль, а не надежность. Собственно как и описано в этой статье про яндекс.
Энергетическую компанию в Тюменской области оштрафовали на 600 тысяч рублей за массовые отключения электричества в Нижнетавдинском районе во время сильных ветров. Об этом сообщает пресс-служба ФАС по региону.
Проблемы, давно выявленные на ключевых центрах питания, не решаются, несмотря на колоссальные инвестиции «Россетей Тюмень» – в 2025 году компания обещала направить несколько миллиардов рублей на реконструкцию семи подстанций и десятков километров линий, но проблемные узлы все еще остаются в зоне риска. Источники в отрасли предупреждают: зимой при минусовых температурах ситуация может повториться, и жители вновь окажутся без электроотопления и базовой инфраструктуры. Масштабный риск блэкаутов стал системным, а критические объекты продолжают работать в условиях перегрузки, что делает население заложником долговременных просчетов менеджмента и неэффективных инвестпрограмм, которые, по мнению экспертов, не дают ощутимого эффекта, пока руководство компании не примет радикальных мер по реальной модернизации сети.
Проблемы индейцев шерифа не волнуют.
Ну сейчас для того, чтобы волновали, государство приняло закон, который позволяет ему ввести внешнее управление и самому начать распоряжаться на критически важных для экономики объектах, если их владелец не хочет или не может обеспечить их функционирование.
И да, принцип нерушимости частной собственности такая мера, конечно нарушает - ибо лишает владельца неотъемлемого в соответствии с этим принципом права творить со своей собственностью что угодно.
Кто же его отберёт если капитал и власть слились в единую систему, называемую олигархией. Акционеры прибыльных частей экономики, банков являются те же люди, что законы придумывают.
Кто же его отберёт если капитал и власть слились в единую систему, называемую олигархией.
Это в вашем мире они слились. А в реальности кдиная система состоит из людей. У каждого источника благ есть тот, кто с него выгоду имеет. Всегда есть - и в демократическом обществе с “нерушимой” частной собсттвенностью, и при монархии, и при диктатуре. И в СССР тоже так было. Разница в степени институционализации - насколько всё это формально закреплено: записано в законах, в привилегиях, данных монархом, в обычаях - она есть, но она в первом приближении несущественна.
И у этих распорядителей благ есть свои интересы, мягко говоря, друг с другом неслвместимые в той или иной степени. Но в той или иной степени общие. Вот они друг у друга и отнимают, используя нарушение общих интересов и прочие косяки как повод.
Как пример, недалеко от нас около двух лет назад владельцы местного заводика допустили пролюбили отопление в домах, от котельной этого заводика обогревавшихся - ну, так было сделано в СССР, обязанность топить в этих домах ещё с тех времен осталась на них в качестве обремменения - и был большой, на всю страну, скандал, и заводика своего владельцы в результате лишились.
Как-то так оно всё устроено. Желающие забрать себе источник благ завсегда найдутся, при любой системе.

я так понимаю это правило ввели чисто для галочки и всем на него с большой колокольни?
4. Размещение сгенерированных материалов
Не следует размещать тексты:
частично или полностью сгенерированные нейросетями или написанные и отредактированные при помощи нейросетей;
состоящие из одних только сгенерированных изображений;
являющиеся вашими диалогами с нейросетями;
целиком состоящие из ответов нейросетей.
Если ваши тексты похожи на творение нейросети, модератор может скрыть публикацию в черновики и ограничить права учётной записи.
Исключение: допускается использовать нейросети для создания КДПВ и изображений, которые будут дополнением к публикации.
Допустим небольшой процент сгенерированного содержимого в больших и интересных профильных, технических статьях, как дополнение к авторскому тексту.

Понаберут по "объявлениям на остановках" в Яндекс. Пальцы веером, а толку никакого. Держалось на заделе инженеров ветеранов - поувольняли их, все уничтожили, понабрали вайтишников слоператоров 😆

А если бы не жлобились и закопали бы 1 центральный датацентр где-нибудь в уральских горах, то тогда такие сервисы пережили бы любые катаклизмы, и яндекс можно было бы смело назвать реально бронебойно-надежным хостом и сервисом, который сможет пережить любой катаклизм. А так понастроили офисные датацентры и и начали стричь капусту рекламируя себя как крайне надежного поставщика услуг, во всю используя свой аппарат при по сути монопольном положении на рынке во многих сферах, являясь компанией государственного значения. А на деле - до первого серьезного шухера.

бери дальше. Что уж не в Тофаларии или горах Бырранга сразу?

Расскажите, пожалуйста, про свои каналы до уральских гор. Как резервируете, какая ёмкость? Самое главное, как много денег попросите за 1Tb канал от Москвы до Урала?
Классика - "вначале сам продемонстррируй")) Ну камрад вроде и не занимается предоставлением услуг облачного хранилища - довольно непоследовательна ваша претензия, не находите?
Или это такой "яндексовский десант" тут высадился? В соседней теме про мэйл.ру я что-то не вижу комментариев типа "ну ты сам попробуй основать компанию с такой капитализацией и дисковой квотой, а мы с удовольствием послушаем ваши лекции на тему как надо". Там однозначное мнение - "контора сами знаете кого".
P.S. Глянул в ваш профиль - кто бы мог подумать)))
мы обязаны смотреть на факты без розовых очков
следствие фундаментальных просчетов в проектировании распределенных систем, управлении мощностями (Capacity Management) и оценке рисков на уровне C‑level
Отсутствие резерва мощности (Capacity Buffer): Чтобы перелить сотни петабайт данных из погибшего Сасово в уцелевшие зоны и поднять там новые реплики БД, нужно свободное железо, диски и пропускная способность сети. А свободного железа не было — утилизация ЦОДов в мирное время была выкручена под завязку ради экономии CAPEX
Как тут не вспомнить "любимый" анекдот консультантов, про мышек, которым сова предлагает стать ёжиками? Или про мысль "почему бы бездомным людям просто не купить себе дома"?
Когда в следующий раз C‑level спросит вас: «Зачем мы платим за простаивающий резервный контур в Сибири, за 35% пустого железа и за сложные механизмы мгновенной блокировки транзакций?» — просто положите перед ними хронологию событий 8–22 октября 2026 года и посчитайте стоимость 11 дней простоя банка. Архитектура безопасности и катастрофоустойчивости стоит дорого ровно до того дня, пока не прилетает первый «черный лебедь».
И я, как мне кажется, сняв розовые очки, прекрасно понимаю эту логику. Потенциальных чёрных лебедей бесконечное количество, а бюджет один. Если на каждый маловероятный риск закладывать +35% расходов, то, даже если убрать очевидный внешний контекст (а что случилось?), менее замороченные по гипотетическому риску конкуренты просто сотрут с рынка, буде этот чёрный лебедь к ним тоже не прилетит.

В условиях регулярных прилетов по всевозможным объектам в европейской части РФ называть этот конкретный риск маловероятным?
Омск, по объектам в котором недавно били, находится вне европейской части РФ. Так что, размещение ДЦ за Уралом, что уже инфраструктурный и логистический вызов, не является гарантией.
До 2026 индустрия не знала о нападении на ДЦ и не учитывала такой риск при проектировании. И до 2026 ни одна компания в мире не теряла несколько далеко расположенных ДЦ сразу за короткий промежуток времени.
Так же можно кому угодно сказать: почему вы не превратили свою квартиру в укрёплённый бункер? Почему не ходите по улице в каске и бронежилете?
И я понимаю, что легко рассуждать в духе "глупое руководство, надо было просто взять откуда-то дополнительный CAPEX, нагрузить на себя дополнительный OPEX. мало ли, что компания и так испытывает естественные сложности вместе с остальной экономикой РФ. надо было волшебным образом пережить удары по трём крупным ДЦ", но я лично смотрю на устранение последствий ударов с восторгом и благодарностью.
Так же можно кому угодно сказать: почему вы не превратили свою квартиру в укрёплённый бункер? Почему не ходите по улице в каске и бронежилете?
Можно. Если этот кто-то брал с вас абонентскую плату за обеспечение вашей безопасности.

Так же можно кому угодно сказать: почему вы не превратили свою квартиру в укрёплённый бункер? Почему не ходите по улице в каске и бронежилете?
Простой вопрос «какой у вас дома огнетушитель и когда у него истекает срок годности?» отсеет процентов восемьдесят участников любой дискуссии о том, как правильно строить датацентры.
Так уж вышло, что что знаком с системой пожаротушения в некоторых ДЦ Яндекса. Она, скажем так, креативная. Во всяком случае, раньше была таковой. Надеюсь, нынче чуть более консервативная.
В деревянном доме было штуки 4. Срок годности без разницы, углекислотный по весу ощущается. Плюс был кубометр воды и насос от генератора. В планах было спринклерное пожаротушение на чердаке, но я продал раньше. Нынешний дом не имеет в составе горючих материалов вообще. Если его облить бензином и поджечь, он просто закоптится. Но пару кубов автономной воды всегда есть, но это побочка от других нюансов.
в доме (постройка 2008) штатные датчики дыма.. Проверяли. Пищат
в квартире наверно огнетушитель не слишком поможет, а вот в частном деревянном доме - пожалуй да, совсем не помешает
Не понимаю к чему это подмена предмета обсуждения, но допустим:
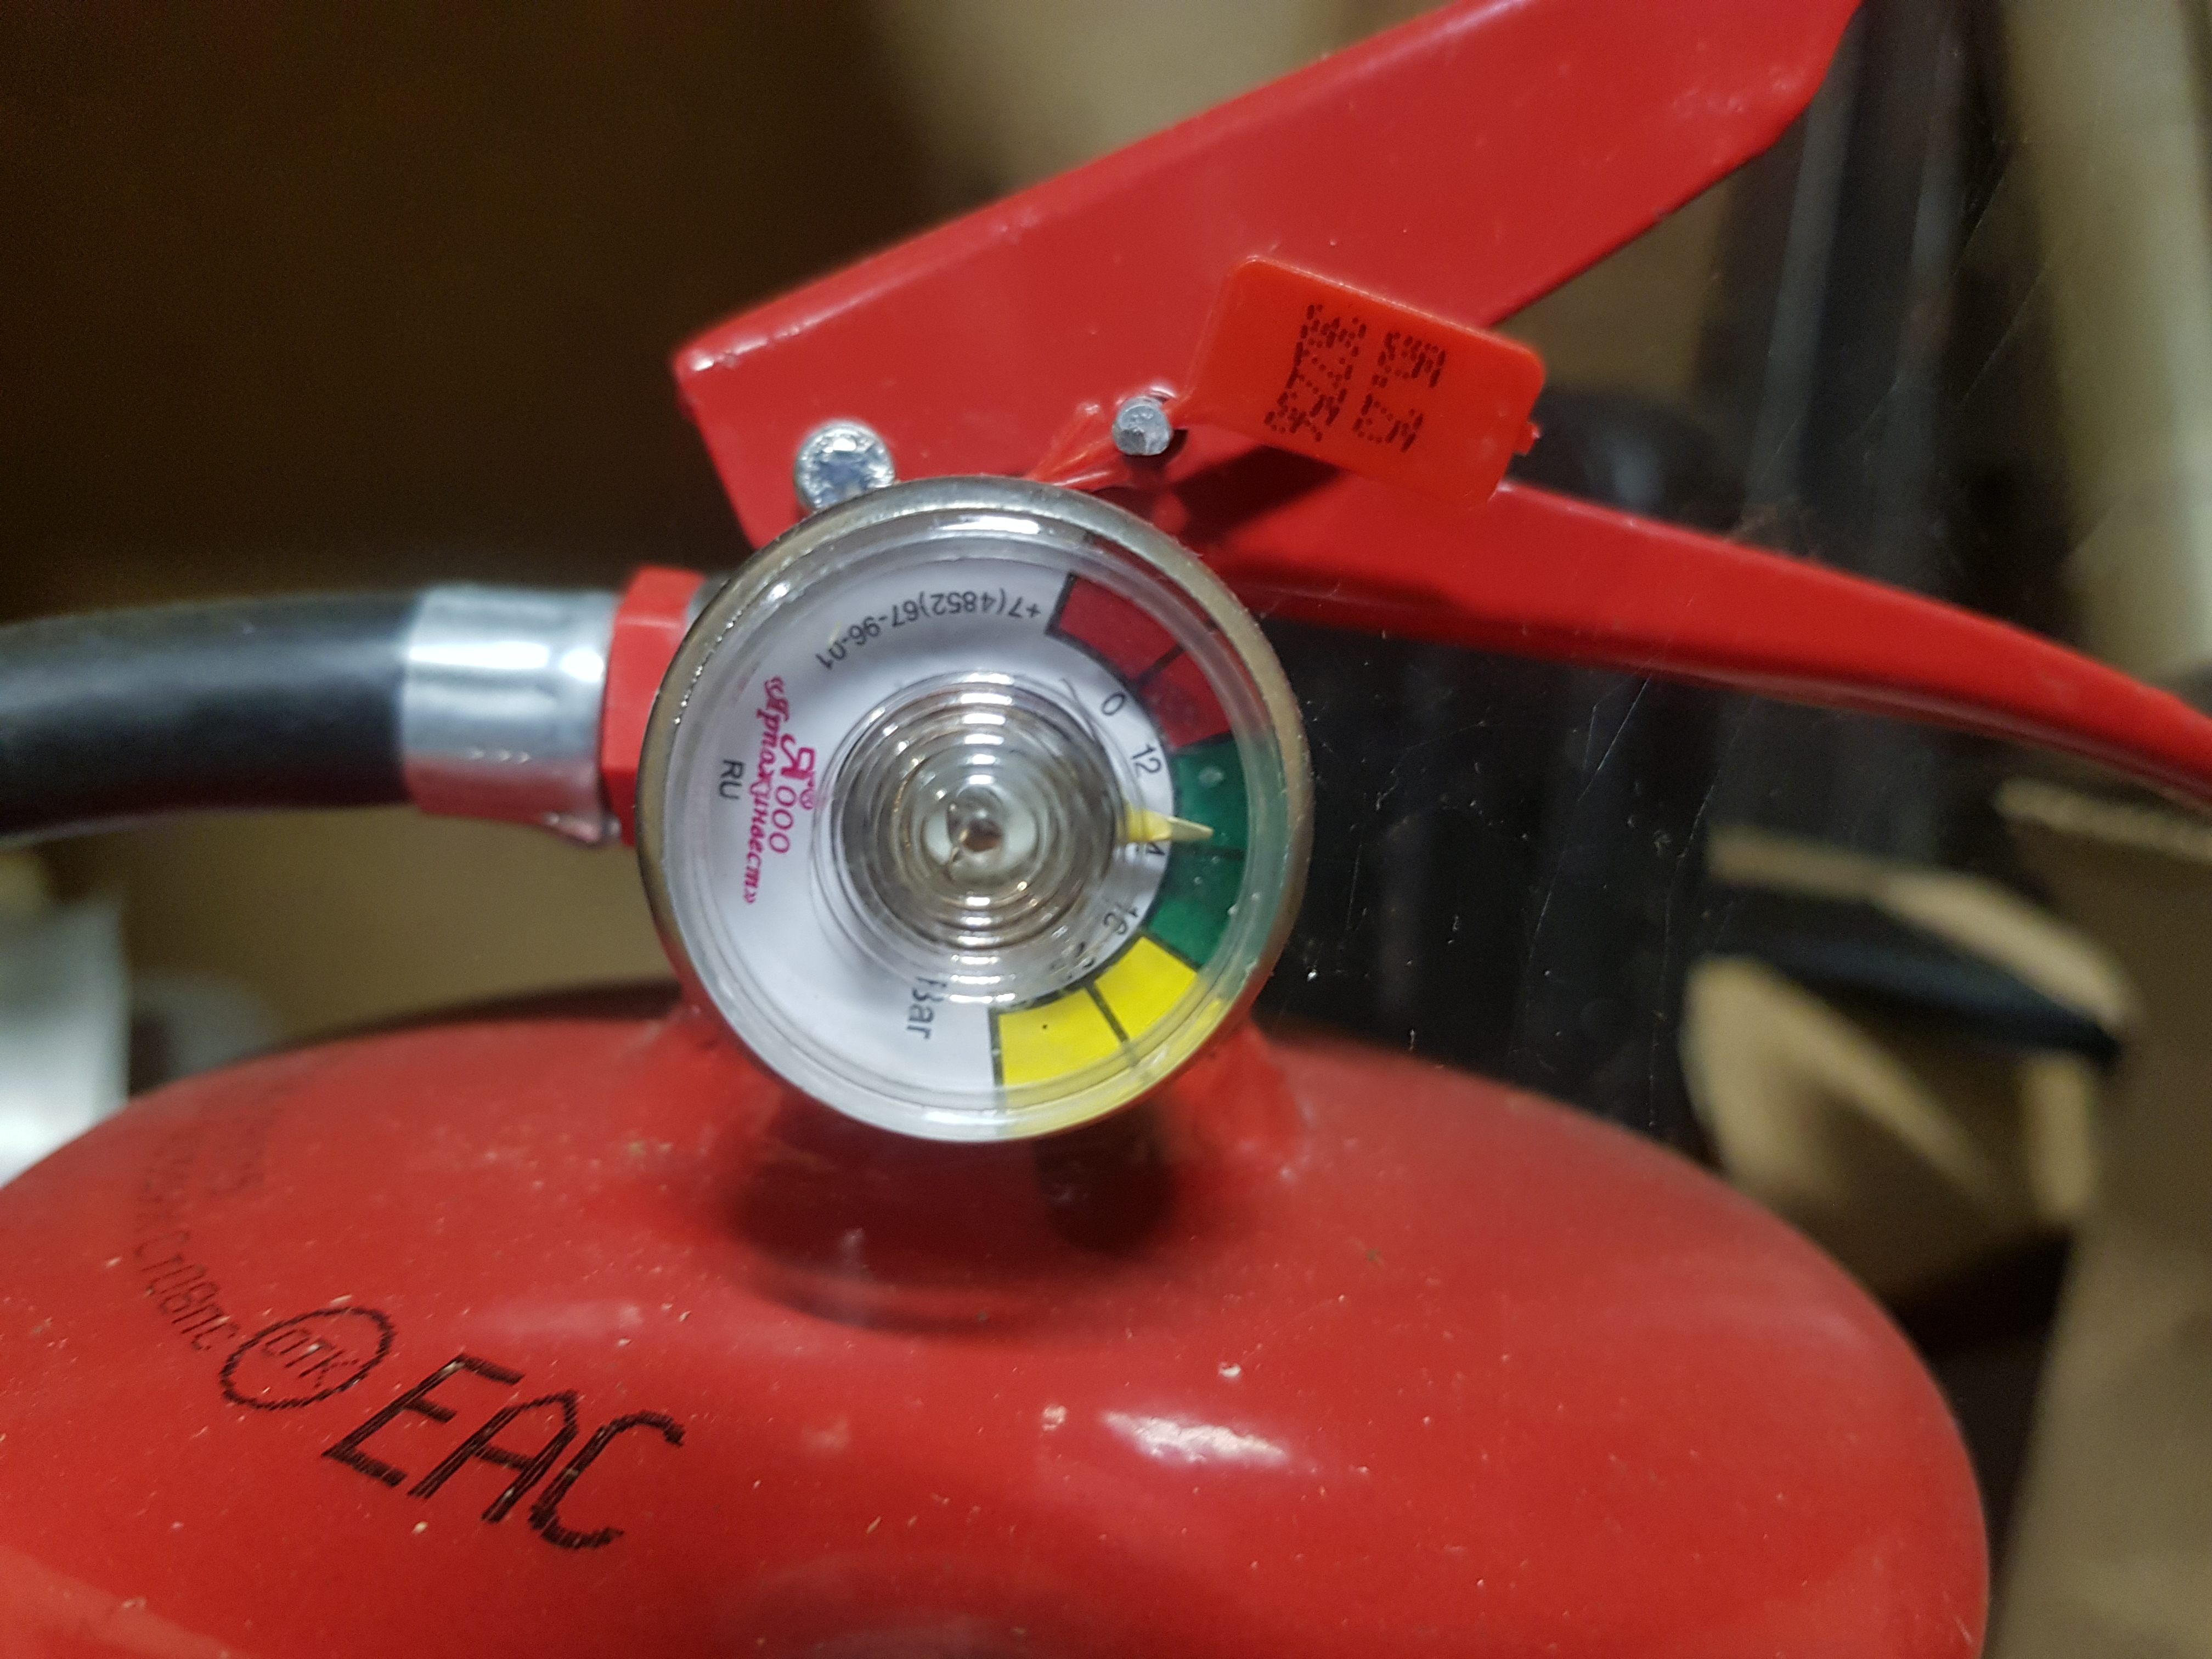
Можем продолжать?

Почему только 35% я не понимаю. Тут опять автор передергивает. 35% покрывают вам потерю только одного ДЦ из условных трех. И то при условии, что они равнозначны по мощности и железу. А ДЦ были явно не равнозначны. Для защиты от потери 2 полных ДЦ и немного от еще одного, вам уже нужно около 70% лишней мощности в простое.
Тут экономика перестает быть такой интересной, но ведь это уже нюансы, правда?)
Если на каждый маловероятный риск закладывать +35% расходов, то, даже если убрать очевидный внешний контекст (а что случилось?), менее замороченные по гипотетическому риску конкуренты просто сотрут с рынка, буде этот чёрный лебедь к ним тоже не прилетит.
Не, объяснить "почему не получилось" может каждый - shit happens ;)
Вопрос - топ-менеджменту и архитекторам платят 6-значные суммы за то, чтобы они давали неверную оценку рисков, а потом разводили руками "ну что поделать, а то конкуренты бы стёрли"? А уж если взять в расчёт тот момент, что пользователи платили как раз за добросовестную оценку рисков и их минимизацию, то такое объяснение выглядит как издевательство! Ну пусть бы цены вздули тогда. Но брать деньги и объяснять потом "нам не профитно было полный аудит рисков делать"...
P.S. Про каких "конкурентов" вы ведёте речь?
P.S. Про каких "конкурентов" вы ведёте речь?
Тут надо оговориться, что я тут рассматриваю, прежде всего, Яндекс Облако. И в структуре доходов Яндекса это действительно не такая большая доля, в отличие от Amazon и Microsoft, где облако делает кассу, а торговая площадка и софт идут на сдачу.
Если говорить про IaaS в России. то есть сloud.ru , РТК-ЦОД / «Турбо Облако» (Ростелеком), Selectel, МТС и ещё много кто. И Яндекс Облако даже первые два места на рынке не занимает, насколько я знаю, по выручке IaaS.
Но даже если подняться на уровень всего Яндекса, то на большинство направлений продуктовых тоже конкуренты найдутся. Внутренний рынок, мягко говоря, не растёт. Внешний почти недоступен.
Но и вообще считать чужие деньги в контексте "вам надо было вложить вот в это" -- так себе затея
а если добавить PaaS и SaaS?
Но и вообще считать чужие деньги в контексте "вам надо было вложить вот в это" -- так себе затея
This! Так почему же все "защитники" призывают оценить именно финансовую целесообразность предупреждения рисков? Почему вообще предлагается смотреть на ситуацию изнутри компании и руководствоваться мотивацией управленцев? Вам за это платят?
Почему вообще предлагается смотреть на ситуацию изнутри компании и руководствоваться мотивацией управленцев? Вам за это платят?
Платили. Но сейчас я издалека с грустью наблюдаю, как люди массово пилят сук, на котором сидят. И ругают последних атлантов, которые ещё, с трудом, но держат свод.
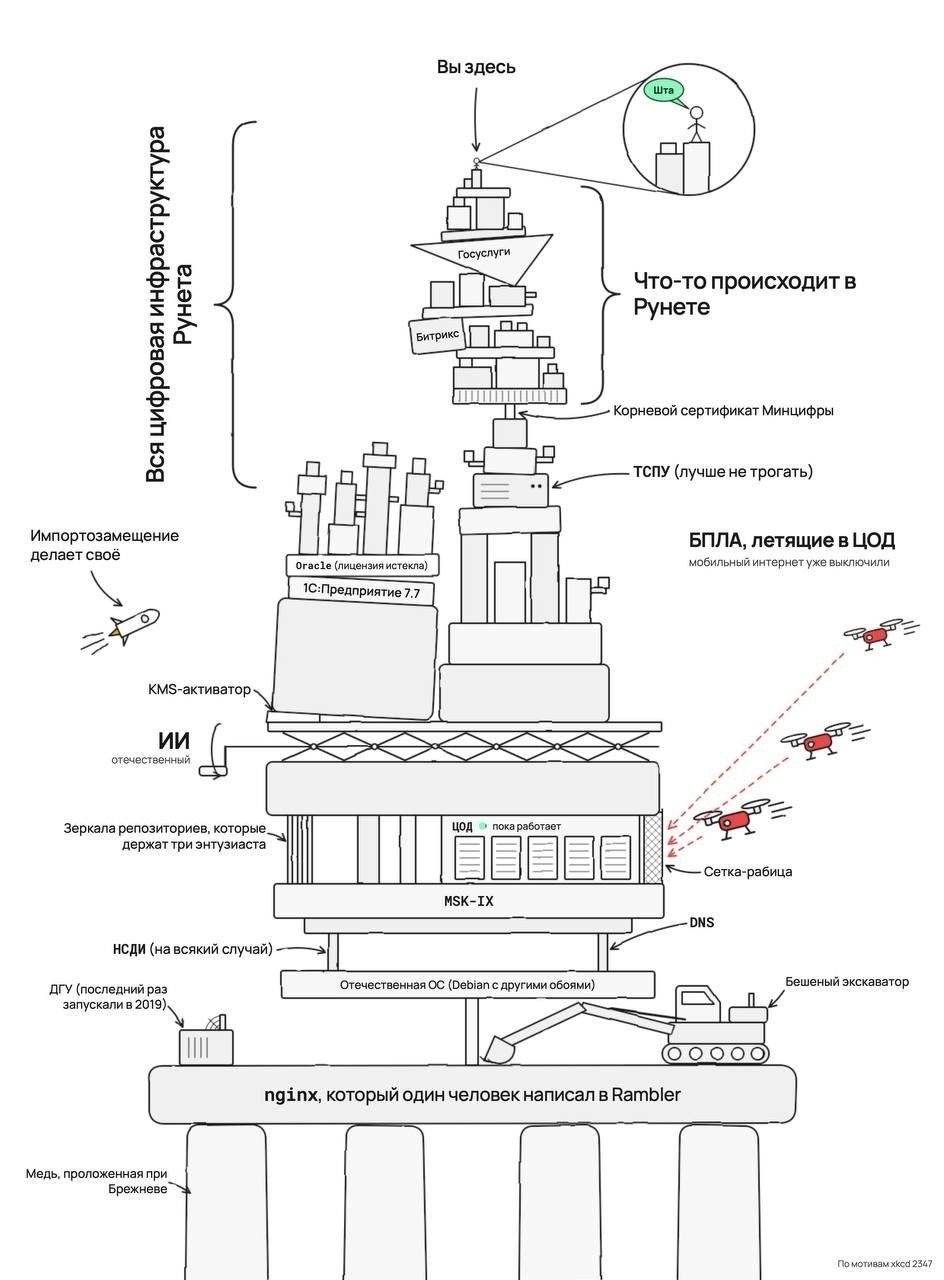
Я что-то вообще нить беседы потерял:
как люди массово пилят сук, на котором сидят. И ругают последних атлантов, которые ещё, с трудом, но держат свод
Позвольте расшифровать - "у людей пропали данные и они стали ругать компанию допустившую это". Вы утверждаете что это "пиление сучьев"? Т.е. "атланты" обидятся на "неблагодарных юзеров" и разойдутся восвояси? Вы уж извините, но я вынужден довольно скептически относиться к подобной "лирике"!
И вы не отвечаете на вопрос - почему я должен рассматривать ситуацию с точки зрения зафакапившихся "атлантов"? Регалии их вы перечислили, ок. Дальше что? Бесплатный проезд в общественном транспорте им предоставим?
Когда вы в магазине бракованный товар от именитого бренда купите - вы тоже поцокаете языком "атланты!" и войдёте в их сложное финансовое положение или же потребуете вернуть деньги за некачественный товар?
UPD: Картинка, кстати, очень спекулятивная. Причём вот тут Сысоев со своим nginx? Биты со дня на день протухнут?
у людей пропали данные и они стали ругать компанию допустившую это
Там были и мои данные. После ударов доступность была около 42%, сейчас больше 97%. Хорошая работа команды по восстановлению данных, как мне видится.
Когда вы в магазине бракованный товар от именитого бренда купите - вы тоже поцокаете языком "атланты!" и войдёте в их сложное финансовое положение или же потребуете вернуть деньги за некачественный товар?
Это действительно кажется хорошей аналогией?
И вы не отвечаете на вопрос - почему я должен рассматривать ситуацию с точки зрения зафакапившихся "атлантов"?
Не зафакапившихся, а пострадавших.
Потому, что они такие же люди. Это базовая солидарность.
Можно так же игнорировать проблемы аграриев и демотивировать их критикой и потом удивляться, откуда же берутся проблемы с продовольствием.
Потому, что они такие же люди. Это базовая солидарность.
При капитализме базовой является не солидарность, а, наобоот, конкуренция. Homo homini lupus est, каждый за себя и так далее. Да, некрасиво и как-то негуманно. Но часто работает лучше солидарных обществ - что традиционных, что модернистских, типа советского социализма.
Может потому, что так работает бизнес?)
Я, например, в прошлом продакт и считал экономику проекта, людей, железо и риски. Это называется PnL. Можно нанять экспертов рынка, закупить самое дорогое железо в 6-ти кратной устойчивости и закопать все в бункер. В итоге на рынке ваш продукт никто не купит, так как ценник его будет стремиться к бесконечности и бизнес прогорит.
Сейчас я строю сложные системы ИБ. Но в 2026 году, когда есть LLM, уязвимости каждый день и так далее, часть компаний все еще готова принять риски взлома и потери данных. так как у них нет бюджета. И выбор стоит между закупкой материалов для производства товаров или защитой от хакеров. И собственники выбирают товары, без которых бизнес просто перестаёт существовать. Риски ИБ принимаются, с пониманием возможных репутационных рисков и штрафов. И так было всегда, даже тогда, когда просил второй резервный сервер для маленькой сети предприятия. Так работает любой бизнес, умеющий считать деньги и живущий больше пары дней.
Может потому, что так работает бизнес?)
Ну так это проблемы бизнеса! ))
В итоге на рынке ваш продукт никто не купит, так как ценник его будет стремиться к бесконечности и бизнес прогорит.
См. выше. Мне может донатить Яндексу начать? Почему меня должно волновать его финансовое благополучие, если его моё категорически(!) не волнует???
Простите, но за потоком негодования я потерял нить рассуждения.
Бизнес строится на взаимных договоренностях, это может быть оферта или договор. В них прописаны условия, в том числе и ограничения этих условий, называемые форс-мажором. Если вы завтра закажете уникальный чайник из -за океана и он утонет по дороге по внезапным причинам, то, в зависимости от условий договора, вы либо получите деньги обратно, либо извинения. Если чайник был бы стандартный и от крупной компании, то вам бы выслали новый. А еще можно застраховать эти риски.
Так абсолютно со всем в этом мире, отдавая деньги Яндексу, ВБ, Озону (как селлер), вы подписываете определенные бумаги в которых есть условия обслуживания. Все дальнейшее обязательства идут в рамках этих условий. Поэтому жаловаться, что кто-то не оправдал ожиданий можно сколько угодно, но бизнес регламентируется договорными отношениями. Поэтому вам обязаны ровно то, за что вы заплатили и что прописано в оферте, за исключением форс-мажора.
И да, у меня тоже есть 2тб на Я.Диске и локальная копия этих данных. поскольку эти риски я закрываю сам.
Зато как красиво лежал s3 и некоторые другие сервисы у "конкурентов", когда к ним начали переносить нагрузки из Облака. Они внезапно оказались не готовы к такой нагрузке.

В текущей веселой реальности, ЦОДы надо зарывать под землю, строить их в защищенных бункерах по типу бункеров ГО. Это дорого, но не дороже чем потом с горящей жопой ликвидировать последствия
В первые дни мне за такие предложения вынесли всю карму. Спустя недельку до некоторых хомячков стало доходить, а теперь и на правительственном уровне подняли эти вопросы. Следующий датацентр они точно будут строить под землей, иначе народ не поймет уровень их надежности.

А системы охлаждения и электропитания как защищать?
Вам прямо технические подробности нужны?
Бункеры были (и есть) не только для ГО, во многих использовалось оборудование, требующее мощного питания и охлаждения, с этим успешно справлялись уже в 50-60-е годы.
Энергию подведут подземным кабелем от электростанции, плюс резервное питание от дизеля. Тепло сбрасывать можно в атмосферу с помощью вентиляции ,при необходимости и градирни можно использовать. В бункере связи где я срочку служил такие были.
А градирню тоже в бункере под землёй разместить? Вы не сравнивайте тепловыделение бункера связи и ЦОД. Современный ЦОД потребляет под сотню Мегаватт. И вся эта энергия в итоге переходит в тепло. Так что, если у Вас есть технические подробности, как рассеять 100 Мегаватт в подземном компактном объекте, чтобы нельзя было вывести это из строя несколькими ракетами, то я бы почитал.
Не вижу тут никаких непреодолимых технических проблем, тем более что такие ЦОД строят под землей.
Понятно что отвести 100 мегаватт тепла не просто, но вполне реализуемо.
Реализуемо, да, но, это может быть не рентабельно. Допустим, у Вас есть имущество на 1 тысячу рублей рыночной стоимости. Приобретать сейф стоимостью 10 тысяч рублей для его защиты от уничтожения будет нерентабельно. Дешевле при уничтожении имущества просто купить новое на рынке.
Подземные ЦОД, которые существуют, имеют маленькие мощности (несколько Мегаватт). И расположены рядом с массивными источниками грунтовых вод или водоёмами для охлаждения. И все они расположены в бункерах, оставшихся от "холодной войны", то есть, достались частным компаниям бесплатно. Часто это бункеры в естественных пещерах в скалах. Строят ли сейчас частные компании с нуля такие ЦОД вот прямо в чистом поле - не знаю. Слышал, что такие проекты актуальны в Израиле.

А не надо туда тащить 100 Мегаватт. Надо делать хранилки, а для вычислительных мощностей закладывать только под mission critical / business critical.
Условно, я работал в компании, у которой мегаватты спускались на генерацию рекомендаций, причем не только зарегистрированных пользователей, а вообще всех, кто когда-либо заходил на сайт в последние 6 месяцев, в качестве ключа используя fingerprint. Нужно ли это бизнесу? Нужно. Нужно ли это дублировать в подземный ЦОД? Сомневаюсь. Базы с рекомендациями (посчитанными) весили около 30 ТБ. Их тоже можно не тащить под землю. База с платежами за 15 лет была чуть больше 1 ТБ =)
Надо делать хранилки
Но "хранилки" сами по себе все равно дофига тепла выделяют. Я как-то был в относительно небольшой серверной одного банка - несколько шкафов HDD на которые транзакции пишутся, плюс их бэкапы (поэтому "на горячую" можно диски менять). Мне объяснили что если выключить кондиционер, то тут через 10 минут будет +40...
Но "хранилки" сами по себе все равно дофига тепла выделяют
HP 3PAR 7400 по спеке требует 760 Ватт, а по факту в районе 400 жрет на 4 юнита.
На шкаф выйдет 3,5 кВт.
Сколько таких стоек надо, чтобы сохранить самое ценное?
Ну и да, охлаждение в любом случае нужно. Тут вопрос скорее в том, что охлаждать GPU ускорители сильно сложнее, чем CPU, а CPU сложнее, чем диски.
Ну и просто, раньше (до GPU бума), на стойки подводили два ввода по 4-5 кВт обычно.
1 Вт/ТБ примерно. Это вообще ноль по современным меркам.

Переложили с больной головы на здоровую. Строили ведь в мирное время, на то и рассчитано.
И про ключи идемпотентности видимо в Яндексе ничего не знают - отсюда антипаттерн dual write ✍️ который привёл в двойным списаниям 😆 в финтехе. Это не CRUD сервисы лабать на коленке.
В Яндексе средний возраст погромистов 32 года. Молодежь недавно пришла вот и не получается ничего. Потеряна инженерная культура. Ветеранов вытурили и в Яндекс на работу не берут 40+ поэтому салагам неоткуда перенять боевого опыта.
Я всё-же считаю, что некорректно обвинять гражданскую коммерческую компанию в том, что она не была готова на случай масштабных боевых действий с дальнобойными ударами. Это примерно, как удивляться, почему купленный в автосалоне автомобиль оказался не броневиком.

Нейро RCA. Даже в открытых источниках по базам через ресерч можно было найти больше инфы про работу NLB на котором все живет, про устройство баз, кворумов, зукиперов и прочего. У каждого сервиса свой control plane и data plane и свои команды разработчиков, которые по своему логику HA/DR писали все эти годы. По итогу испытание мало кто выдержал и для того, чтобы переписать сервисы под новые требования рынка, которые разом поменялись за одни выходные надо полностью переделывать логику сервисов. Где теперь только взять на это деньги и время.

По итогу испытание мало кто выдержал и для того, чтобы переписать сервисы под новые требования рынка, которые разом поменялись за одни выходные надо полностью переделывать логику сервисов. Где теперь только взять на это деньги и время.
ИИ все перепишет за минуту час день и 10 100 1000 баксов, достаточно только запромптить и оплатить подписку! Разве не так?
Если бы это так работало, то в Managed Kubernetes в Яндексе были бы версии Cilium посвежее, чем deprecated 1.15. И так на каждом шагу. Большие фичи, которые меняют логику тестируются и выпускаются гораздо медленнее. Я бы сказал, что местами слишком медленно. Настолько медленно, что другие уродливые облака, куда сейчас все съехали во многих смыслах стали диктовать новый уровень требований к тому же Яндексу, если когда нибудь через года три туда кто нибудь захочет вернуться.
Забавно, что вы начали с ярлыка про нейро-RCA, а в следующих двух предложениях сами же подтвердили главный вывод статьи - единой рабочей архитектуры DR не было, каждая команда городила свой огород, и при реальном каскадном отказе эта лоскутная схема не выдержала.

Новенький аккаунт. Приглашена вчера в 19:53 по приглашению от НЛО
100% вброс, чтобы пощупать реакцию. Только от кого?

Спасибо за качественный обзор, приятно читать настоящего системного архитектора.
По поводу самой ситуации, перефразируя Джефферсона:
Архитектуру больших систем нужно время от времени освежать настоящими форс-мажорами. Это её естественный нагрузочный тест
Cын ошибок трудных особенно бодро растёт в продакшене.
Антон, спасибо, рада что вам понравилось. Всегда открыта для коллег)
Сегодня это легко: региструем ипешку, просим ИИ состряпать лендинг на несколько страничек (домен от июля 2026) и создать статейку с кликбейтным заголовком про "катастрофу", размещаем ее на Хабре (юзер приглашен вчера) – профит, ты уже системный архитектор.
Непонятно одно – на Хабре в песочнице жестко проверяют на нейрослоп, а тут как-то проскочило.
Сегодня это легко: региструем ипешку, просим ИИ состряпать лендинг на несколько страничек (домен от июля 2026) и создать статейку с кликбейтным заголовком про "катастрофу", размещаем ее на Хабре (юзер приглашен вчера) – профит, ты уже системный архитектор.
С моей точки зрения, автор - архитектор с опытом, это сквозит в тексте, да и суть написанного полностью адекватна.
Непонятно одно – на Хабре в песочнице жестко проверяют на нейрослоп, а тут как-то проскочило.
Сейчас практически все используют нейронки для помощи в написании статьи, в данном случае выдает шаблонная структура. Но сам фактаж нейронка бы так не выдала. При прочтении глаз не цеплялся, лично мне этого достаточно.

Скажите, а вебвизор в яндекс-метрике у всех сейчас не работает? Пустоту показывает. В справке написано "с ограничениями", но как-то неоднозначно.

Боже, какой стремный ИИ-текст. Вам не стыдно такую галиматью публиковать ?

Завидую автору, быть таким глубоким экспертом во всех этих областях. Прямо на уровне ChatGPT и Claude. Еще и столько инсайдерской информации удалось как-то достать. Яндекс обязан взять вас на работу главным архитектором или хотя бы его помощником.

Как говорил Марк Твен «Сообщения о моей смерти сильно преувеличены». Яндекс жив, Яндекс будет жить как впрочем и многие другие. Три суперкомпьютера уже перевезены на новые площадки и уверен что места и безопасность их усилены как территориально так и технически. К тому же государственный административный ресурс никто не отменял , таким компаниям никто просто так "умереть" не даст. Везде есть дублирование ресурсов оных на других площадках других компаний подчиненных гос-ву. Взломать же их изнутри учитывая что уже несколько дет существует изолированный национальный домен не представляется возможным никому. Надо делать работу над ошибками а не стонать и причитать. В Европе в свое время не даром многие критичные IT инфраструктуры перевели под землю , некоторые даже в противоядерные отреставрированные бункеры. Что мешает сделать так же России, благо даже в той же Москве таких куча. Как и в дальних регионах что было бы логичнее, конечно глубоко под землей для надежности. Главное что структура выдержала даже такие атаки. Это радует. В конце концов ни одними маркетплейсами и заказами такси и еды живет IT мир.

Спасибо за разбор, но в статье много неточностей. Мы традиционно опубликуем постмортем от Yandex Cloud.
постмортем
Первоначальный смысл выражения начинает играть новыми красками (от лат. post mortem — после смерти).
Значит, будут ещё неприятности. :-(
Спасибо, что заглянули в тред. Понятно, что при взгляде снаружи по открытым статус-логам и внешним симптомам часть выводов это реконструкция, всей внутенней кухни мы видеть не можем.
Очень ждем официальный технический постмортем, всей индустрии сейчас будет полезно почитать честный разбор изнутри.
А ребятам из инженерных команд и SRE в любом случае сил и уважение за то, что вытащили такую аварию🙏🏻

Обязательно упомяните как вам помог в этом всём деле leetcode и алгоритмы. Иначе же не берут на работу в яндекс, хочется понять как вам это помогло

Суммарная утилизация трех зон никогда не должна превышать 65%, чтобы при мгновенном испарении любой зоны оставшиеся две гарантированно приняли на себя 100% нагрузки и третью реплику данных без введения «ручных квот».
А зачем разворачивать упавшую третью реплику на базе оставшихся двух? Это же никак не повышает устойчивость. Выбивают любую из оставшихся двух - остается все равно только одна. Логичнее иметь договоренности / отработанную процедуру с тем же Ростелеком на аварийное задействование его мощностей. Гарантированную / негарантированную - это уже вопрос денег, но тут они хотя бы в теории могут принести пользу, нежели впустую резервировать свои же мощности.
Это борьба со split brain.
В ситуации потери связи между 2-мя репликами наличие 3-й - мощнейший предохранитель от этой беды
Если третья реплика разворачивается независимо, отдельно, от оставшихся двух - это полезно. Либо если бы она разворачивалась на базе одной из двух оставшихся - еще какой-то смысл был бы (лотерея). Для этого, правда пришлось бы иметь в резерве 50% мощностей в каждой зоне. Но когда третья реплика зависит от одновременной устойчивой работы обеих оставшихся зон, какую дополнительную устойчивость она обеспечивает? Выбиваем еще одну зону и все равно остаемся только с одной репликой.
Путин обязал владельцев частных дата-центров зарезервировать 10% площадей и мощностей для поддержки российских информационных ресурсов. При необходимости их должны будут предоставить в течение суток
А ну вот на уровне государства принудительно этот вариант реализовали.
Шикарный разбор, спасибо ! Тот факт что KPI на некорректные показатели ведет в тупик было показано ярко и выпукло
Инвестиции в строительство удаленного DR‑региона в Сибири
тут вынужден возразить - удаление проблемы не решает
решает проблему на низовом уровне - только защита самого ДЦ.
ДЦ должен быть под землей, под хорошим слоем бетона, спец входы/выходы и прочее.
это ж какой тогда повышающий коэффициент в Яндекс.Такси будет, чтоб отбить такие капитальные затраты...
гораздо меньше того, который будет применен после потери значительной части оборудования из ДЦ
причем в условиях когда новое просто так взять неоткуда - цены запредельные, сроки поставки длительные, ограничения и прочее
Вы видели сколько ОЗУ стоит? Дороже золота в пересчете на грамм! Да и золото за тройскую унцию тоже дофига стоит.
За такие деньги можно и нору вырыть, и забетонировать, и остальную инженерку провести.
А клиентам предложить разделение.
Дешево, надежно, выбрать переключателем можно что-то одно.
Вероятно, такой вариант развития событий - когда все гражданские сервисы (доставка, такси, музыка) нужны под полной нагрузкой и одновременно требуется устойчивость к ежедневным бомбежкам - не был самым очевидным при оценке рисков. Примерно как сейчас кажется, что для бесперебойной работы КиноПоиска устойчивость датацентра к повышенной радиации - избыточная мера.
тут вынужден возразить - удаление проблемы не решает
Да. Социальные проблемы технически не решаются.
Затронуты 85 сервисов облака.
Если это так, то более всего впечатляет беспредельная самонадеянность и неунывающая бесшабашность Яндекса. Как Вы можете так сильно разбрасываться??! И это всё вместо того, чтобы взять лишь малое число сервисов и глубоко их проработать, предъявить сообществу результаты фундаментальных исследований (теоремы), оформить соответствующие спецификации и подготовить стандарты (ГОСТы). И, уже на основании всего этого, годами строить и развивать инфраструктуру.
P.S. Те же критики, которые всюду видят "нейрослоп" (иногда справедливо, а,иногда, и бессмысленно), почему-то сами не торопятся писать (вручную) статьи с разбором. Единственный способ что-то противопоставить "нейрослопу" — это писать собственные статьи. Где же наши профессионалы и их статьи? Или с профессионализмом стало что-то не то?
Какие бы технические меры, предусмотренные для мирного времени, ни применялись бы - схожий результат был бы достигнут с затратой чуть большего количества времени и/или ресурсов. И даже ПВО, которое должно обеспечивать не защиту, а только лишь прикрытие, тут принципиально ничего бы не решило (см. НПЗ, Wildberries и т.д.). Выводы здесь должны быть сделаны в виде конкретизации термина "критическая угроза суверенитета", к которым стоит отнести такой вот масштабный вывод из строя ключевых дата-центров.

Если бы этот механизм отработал 8 октября за 3–4 часа
Эх, если бы “механизм” отработал в 2012 все в России могло бы сложиться по-другому…
А что было в 2012-ом?
Неокрепшее российское гражданское общество не смогло отстоять своих интересов и позволило стране скатиться в автократию, последствия которой мы наблюдаем сегодня и будем расхлёбывать ещё много лет.
А вот политота на Хабре запрещена. Вы не знали?
Это не политота, это обсуждение заданной в посте темы. Заявляется, что в ситуации с падением сервисов виноват бизнес, но это не так. Никто не закладывается на падение метеорита, высадку пришельцев или войну. Это просто экономически нецелесообразно.
Вообще использование термина “политота”, эдакая попытка принизить собеседника, намекнуть, что он делает что-то недостойное, очень красочно вас характеризует. Для полноты картины еще назовите меня либерахой и вшивым нтюльгентом.
Просто проблема в чем. Выборность власти как таковая, не только как концепт, но даже как реализация, таких проблем, к сожалению, не исключает.
Можете спросить у Джеффа Безоса в Х, что он думает про отрицательное масштабирование своих ЦОДов на Ближнем Востоке. Вдруг ответит. Вместе почитаем.
Поэтому можно пытаться за уши притащить политический процесс (куда входят и выборы, и протесты, и все остальное), а можно не пытаться, и честно сказать: если в регионе есть вооруженный конфликт, то шанс утери ЦОДов далеко не нулевой. А дальше это задача управления рисками. Ниже уровнем - набор инженерных задач. И если управление рисками не особо целевая для Хабра тема, то вот набор инженерных задач - таки целевая. Поэтому интересно читать именно про инженерию.
Пункт 2 Правил:
Политические дискуссии. Для рассуждений на политические и околополитические темы есть куда более подходящие сайты, чем «Хабр».
Исключение: никаких исключений. Политики не должно быть ни в каком виде ни в публикациях, ни в комментариях, ни на аватарах, ни в профиле пользователя, ни в личных сообщениях.
Неокрепшее российское гражданское общество не смогло отстоять своих интересов
Мне до их интересов дела нет. Я, с точки зрения того “гражданского общества”, которое тогда ремейк Фронды устроила, к нему не принадлежу (со своей, кстати, тоже, но это не важно), я для них - анчоус и быдло гнилозубое (помните такие слова того времени, да?). То есть интересы у меня с ними разные. Мой интерес - чтобы власть смогла отстоять общие интересы России, в том числе - находящие в непримиримом противоречии с интересам “сада” европейцев и американцев (ибо Россия для них - это часть “джунглей”). А такие интересы есть, и они - часть моих. И у меня есть серьезные сомнения, что эти самые “норковые шубы” хотя бы захотели отстаивать эти интересы, не говоря уж о том, чтобы смогли.
и позволило стране скатиться в автократию, последствия которой мы наблюдаем сегодня и будем расхлёбывать ещё много лет.
Автократия, как показывает пример хотя бы Китая - это не всегда плохо для страны и рядовых ее жителей. Конечно, это всегда плохо для контрэлиты (вспоминаем, к примеру, товарища Бо из того же Китая), но мне до интересов элиты и контрэлиты дела, вообще-то нет, далёк от них я.
А если бы он отработал году в 1990-91, то в России и не только все могло бы сложиться ещё более по-другому. К лучшему или к худшему - неведомо.
А вот другой исход “революции норковых шуб” в 2012 был бы явно к худшему. Если чо, Россия (тогда ещё “единая и неделимая”) такой вариант проходила - в феврале-октябре 1917: как показывает история с “координационным комитетом оппозиции”, управленческая импотенция тогдашних оппов была как бы не больше, чем у “временных” в 1917, ну а результат работы Временного Революционного правительства России - доведение страны до ручки - он известен.
PS А вообще, это - политота. И на Хабр ее тащить, наверное, не стоит.
Хабр, он IMHO - для разговоров за технические и околотехнические вопросы. Спасла бы Яндекс от хотя бы части проблем архитектура с ресурсом-свидетелем - это, по-моему, тема для Хабра. Как и тема стоит ли так централизовывать сервисы, по самой своей природе децентрализованные (к примеру, такси) - IMHO тоже для Хабра.
Не технические проблемы не решаются техническими средствами. Эта статья была бы технической, если бы были хотя бы примерные оценки объёмов данных, требуемых резервных мощностей и т.д. Сейчас это попытка голословно обвинить яндекс в том, что они дураки и не лечатся и самопиар. Кмк, это не очень правильно. Это при всём при том, что я в яндексу особой любви не испытываю, но огульно их технарей поливать тоже как-то странно.
Не технические проблемы не решаются техническими средствами.
А я не вижу тут нетехническую проблему. Падение инфраструктуры - это проблема техническая. Управление рисками - строго говоря, не техническая, но стоящая именно на техническом фундаменте: вероятные риски, меры их предупреждения и стоимость этих мер.
но огульно их технарей поливать тоже как-то странно.
Полемчиеский прием. В контексте их пиара - условно допустимый, для компенсации этого самого пиара и отказа от кое-чего сделанного ими под прикрытием этого пиара - к примеру, от монополизации и, как следствие, необоснованной централизации вызова такси.

Ладно, с военными рисками и чёрными лебедями всё понятно, это очень дорого. Но почему у них не отработана базовая авария: одна нода полностью умерла? Они вообще хотя бы готовились к такому? Какой был план в отсутствие резерва по мощностям? Остаёмся на 2/3 хз сколько пока не развернём новый ЦОД и молимся чтобы ничего не случилось плюсом?
Да, в этом и прикол большинства таких учений. Выключаем одну ноду из трех, проверяем работоспособность, в конце дня (или на следующий) включаем обратно. Все молодцы, все получают премию.
Нет такого, чтобы вот ЦОД взял и умер, безвозвратно. Закладываются временные аварии: свет, связь.
А вот когда ЦОД взял, и умер, безвозвратно, очень многие начинают реально уже думать о DR. Потому что мало кто закладывает вполне реалистичный сценарий выхода из строя чиллеров, например.
После атаки на первый ДЦ у Яндекса вообще ничего не сломалось.
После атаки на второй ДЦ у части сервисов начались трудности.
После атаки на третий ДЦ сломались Облако и Банк. Такси, Поиск, Маркет и прочие сервисы до сих пор работают.

главный вывод - РАЗНОСИТЕ ТЕРРИТОРИАЛЬНО !
и не отвечен вопрос, а что стало с яндекс диском? сейчас и на будущее
«Зачем мы платим за простаивающий резервный контур в Сибири, за 35% пустого железа и за сложные механизмы мгновенной блокировки транзакций?»
Ну там же не дураки сидят. Если за экономию на инфраструктуре дают премию, а за последствия отвечает форс-мажор, то система мотивации работает безупречно.

В интересном мире мы живем!
Сначала учили нейросети писать как человеки, теперь учим человеков писать НЕ как нейросети...
".....банковского ядра в радиусе 300 км от Москвы — это профессиональная халатность риск‑комитета. Сценарий «потеря 2–3 площадок в одном макрорегионе за неделю» обязан был лежать на столе у CTO и CEO как базовый риск (Tier-1 Risk), а не как фантастический «черный лебедь». "
А откуда вы знаете, что такой сценарий на столе у них не лежал?
Для нас, архитекторов, этот кейс — главный аргумент в разговорах с советом директоров и бизнесом. Когда в следующий раз C‑level спросит вас: «Зачем мы платим за простаивающий резервный контур в Сибири, за 35% пустого железа и за сложные механизмы мгновенной блокировки транзакций?» — просто положите перед ними хронологию событий 8–22 октября 2026 года и посчитайте стоимость 11 дней простоя банка. Архитектура безопасности и катастрофоустойчивости стоит дорого ровно до того дня, пока не прилетает первый «черный лебедь».
Бизнес всегда выберет рискнуть и сэкономить. Память как у гуппи. Вот сейчас случилось с Яндексом и все резко думают только про дроны и ракеты, как будто шифровальщики и хаккеры исчезли и от них уже не надо защищаться
Удивительное дело! Настоящий бизнес никогда не будет экономить. Всякая экономия обязательно приводит в будущем к убыткам. Таков закон жизни. А бизнес, не просчитывающий последствий, плохой бизнес.
Весь вопрос в том, является ли Яндекс бизнес-компанией. Сегодня практически всё так или иначе управляется государством: всё должно быть под контролем государства. Вот у государства и имеется постоянная привычка экономить. А в бизнесе принято вкладываться: не будет вложений не будет и всходов.
В этом смысле, с высоты нынешних лет, можно хорошо понять, почему Дмитрий Мендрелюк закрыл в 2007 году вполне себе успешный журнал "Компьютерра".

Нейрослоп.
Удивительное дело. Приходится видеть, как люди сами превращаются в ботов, постоянно выдавая примитивную автоматическую реакцию. Трудно разговаривать по существу, когда основной вопрос (для большинства) — это вопрос о том, является ли текст (статья/комментарий) "нейрослопом".
Почему-то хочется вспомнить из Райкина: "К пуговицам претензии есть?" (с) ;-7

Что-то меня пугает подобная самоуверенностью
Все мы умеем поучать не разобравшись в деталях.
Любое движение денег фиксируется только через иммутабельный журнал проводок с глобальными детерминированными UUIDv7 (содержащими временную метку и криптографическую уникальность)
Это кто вам такое сказал?
В леджере требуется детерминированная последовательность операций, в том числе, если он распределён по разным партициям.
Временная метка на клиента? В браузере что ли? Я могу себе деньги под проценты задним числом положить?


Черный октябрь «Яндекса»: анатомия архитектурной и управленческой катастрофы, которую списали на форс‑мажор